
推出 Eleven v4认识 Eleven v4:迄今情感表现最丰富的模型。

跳至内容

JavaScript 语音识别教程:构建语音 UX

发布时间
最近更新

收听收听本文

借助 Web Speech API 等浏览器原生语音转文本(STT)API,将语音识别引入网站和浏览器应用变得更加简单。开发者无需搭建本地自动语音识别服务器,只需调用 API,即可轻松流式传输麦克风输入、分析音频数据并处理转写文本。

Web Speech API 是常用于在 JavaScript 中实现语音命令的语音识别 API。它提供方法、参数和属性,让你能在浏览器中进行实时转写。不过,对于复杂的 Web 客户端,开发者可能会觉得 Web Speech API 功能有限。


本指南将介绍如何使用 Web Speech API 搭建简单的 JavaScript 语音识别 Web 应用、它的局限性,以及构建更稳健的实时转写客户端有哪些替代方案。
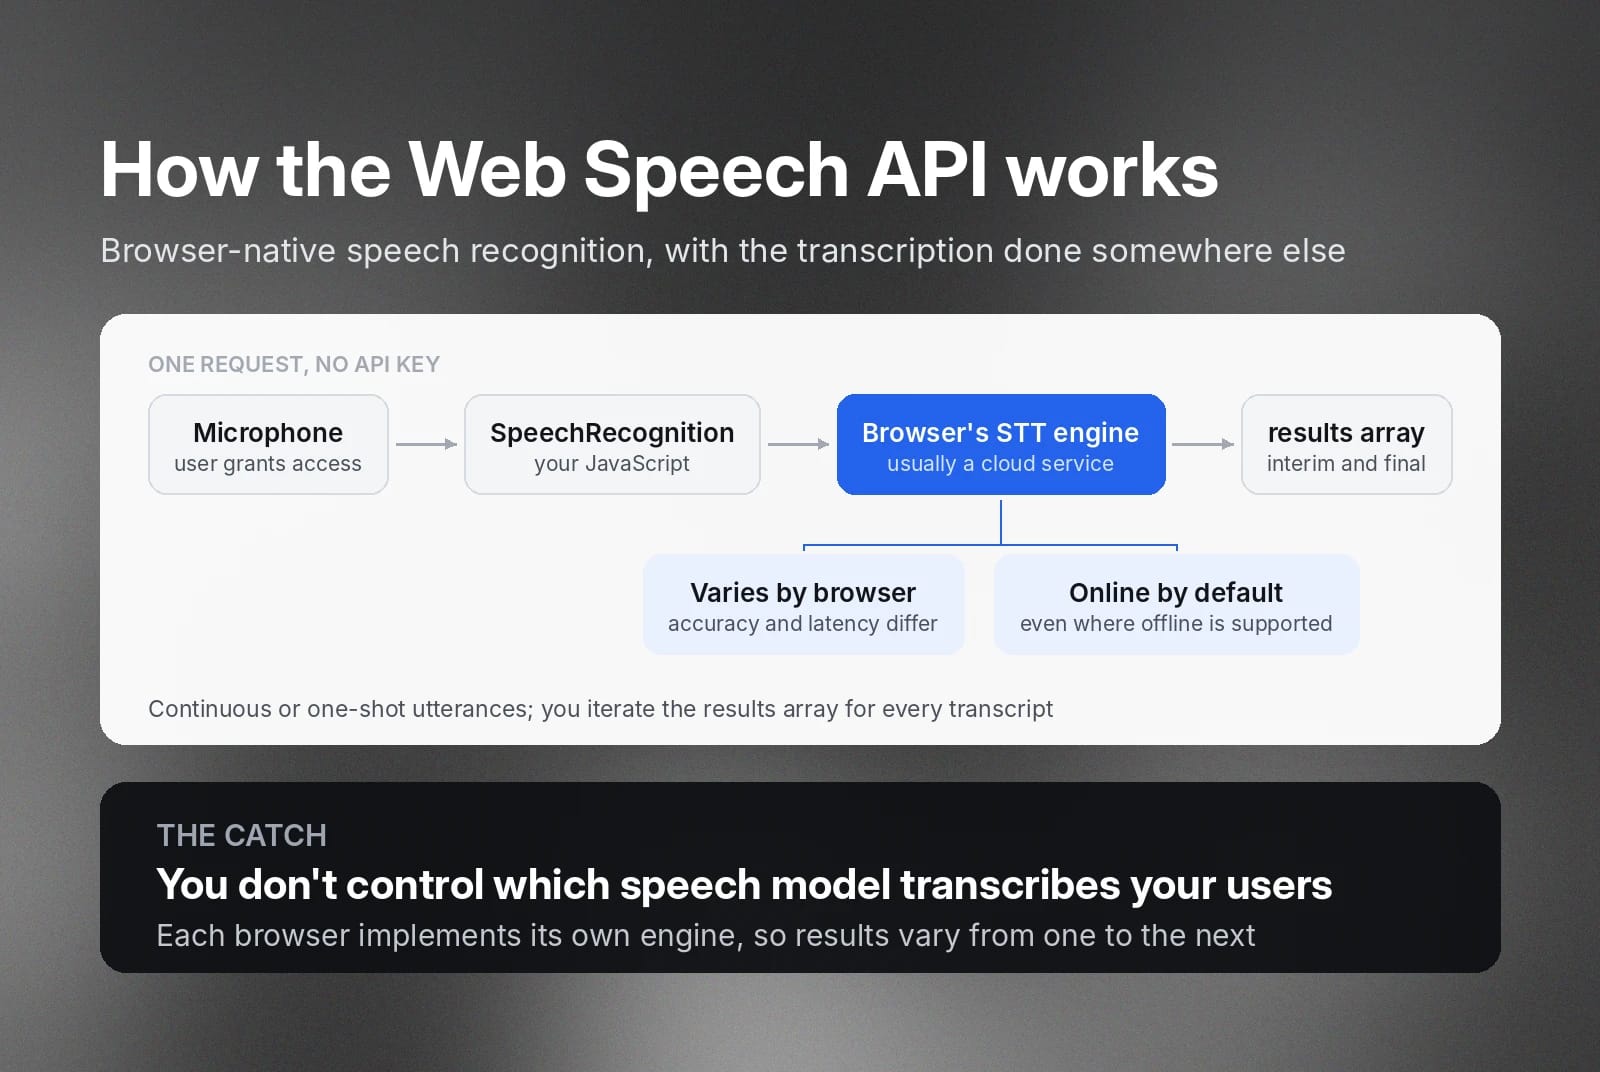
Web Speech API flow from microphone to results; browser STT engines vary and are usually online.

摘要

  • Web Speech API 是浏览器原生的语音转文本 API,可将麦克风音频发送到后端云服务处理。
  • 开发者使用 SpeechRecognition API 类构建 JavaScript 语音命令应用。
  • 构建语音识别应用时,应通过提示音频正在录制来保护用户隐私。
  • Web Speech API 存在多项限制,包括转写结果不一致、依赖浏览器,以及缺乏意图理解能力。
  • ElevenLabs 提供高准确率、生产级语音转文本 API,支持客户端和服务端流式传输。

Web Speech API 的工作原理

Web Speech API 为 Web 开发者提供浏览器原生语音识别,无需本地服务器。它会将浏览器中的音频流发送到后端云服务,进行处理、分析并转换为转写文本。由于转写依赖浏览器的后端引擎,不同浏览器的结果会有所不同。


通常,Web Speech API 需要有效的网络连接才能转写音频流,尤其是在为 Chrome 和 Safari 开发时。不过,部分浏览器现在支持离线转写。进行离线转写时,浏览器充当语音转文本引擎,识别音素并将其转换为连贯文本。

无论使用哪种浏览器,API 的基本原理都相同。

  • 发起 API 请求无需 API 密钥。
  • Web Speech API 支持连续语音或单次语音。
  • 它会返回临时和最终转写文本。

不过,由于不同浏览器对 STT 引擎的实现可能不同,准确率和延迟也会有所差异。

要使用 Web Speech API,需在 JavaScript 代码中初始化 SpeechRecognition 接口。之后即可在编写代码时访问方法、属性和事件处理程序。以下是构建语音搜索 Web 客户端时会用到的部分内容。

  • SpeechRecognition.continuous: 设为 语音引擎 会处理连续音频流,当其设为 true 时。
  • SpeechRecognition.lang: 设置音频语言。
  • SpeechRecognition.interimResults: 指示引擎返回临时转写文本。
  • SpeechRecognition.start():开始语音识别过程。
  • SpeechRecognition.onresult: 接收一个事件处理程序,API 完成转写时会触发它。

Web Speech API 会以字符串数组形式返回转写结果。无论 STT 引擎返回的是临时还是最终转写文本,都可以在 results 数组中找到。它可能返回一个或多个字符串,因此需要遍历结果字符串以获取全部转写文本。

注意: 如果启用了临时转写,可检查 isFinal 属性来判断文本是否为最终转写结果。
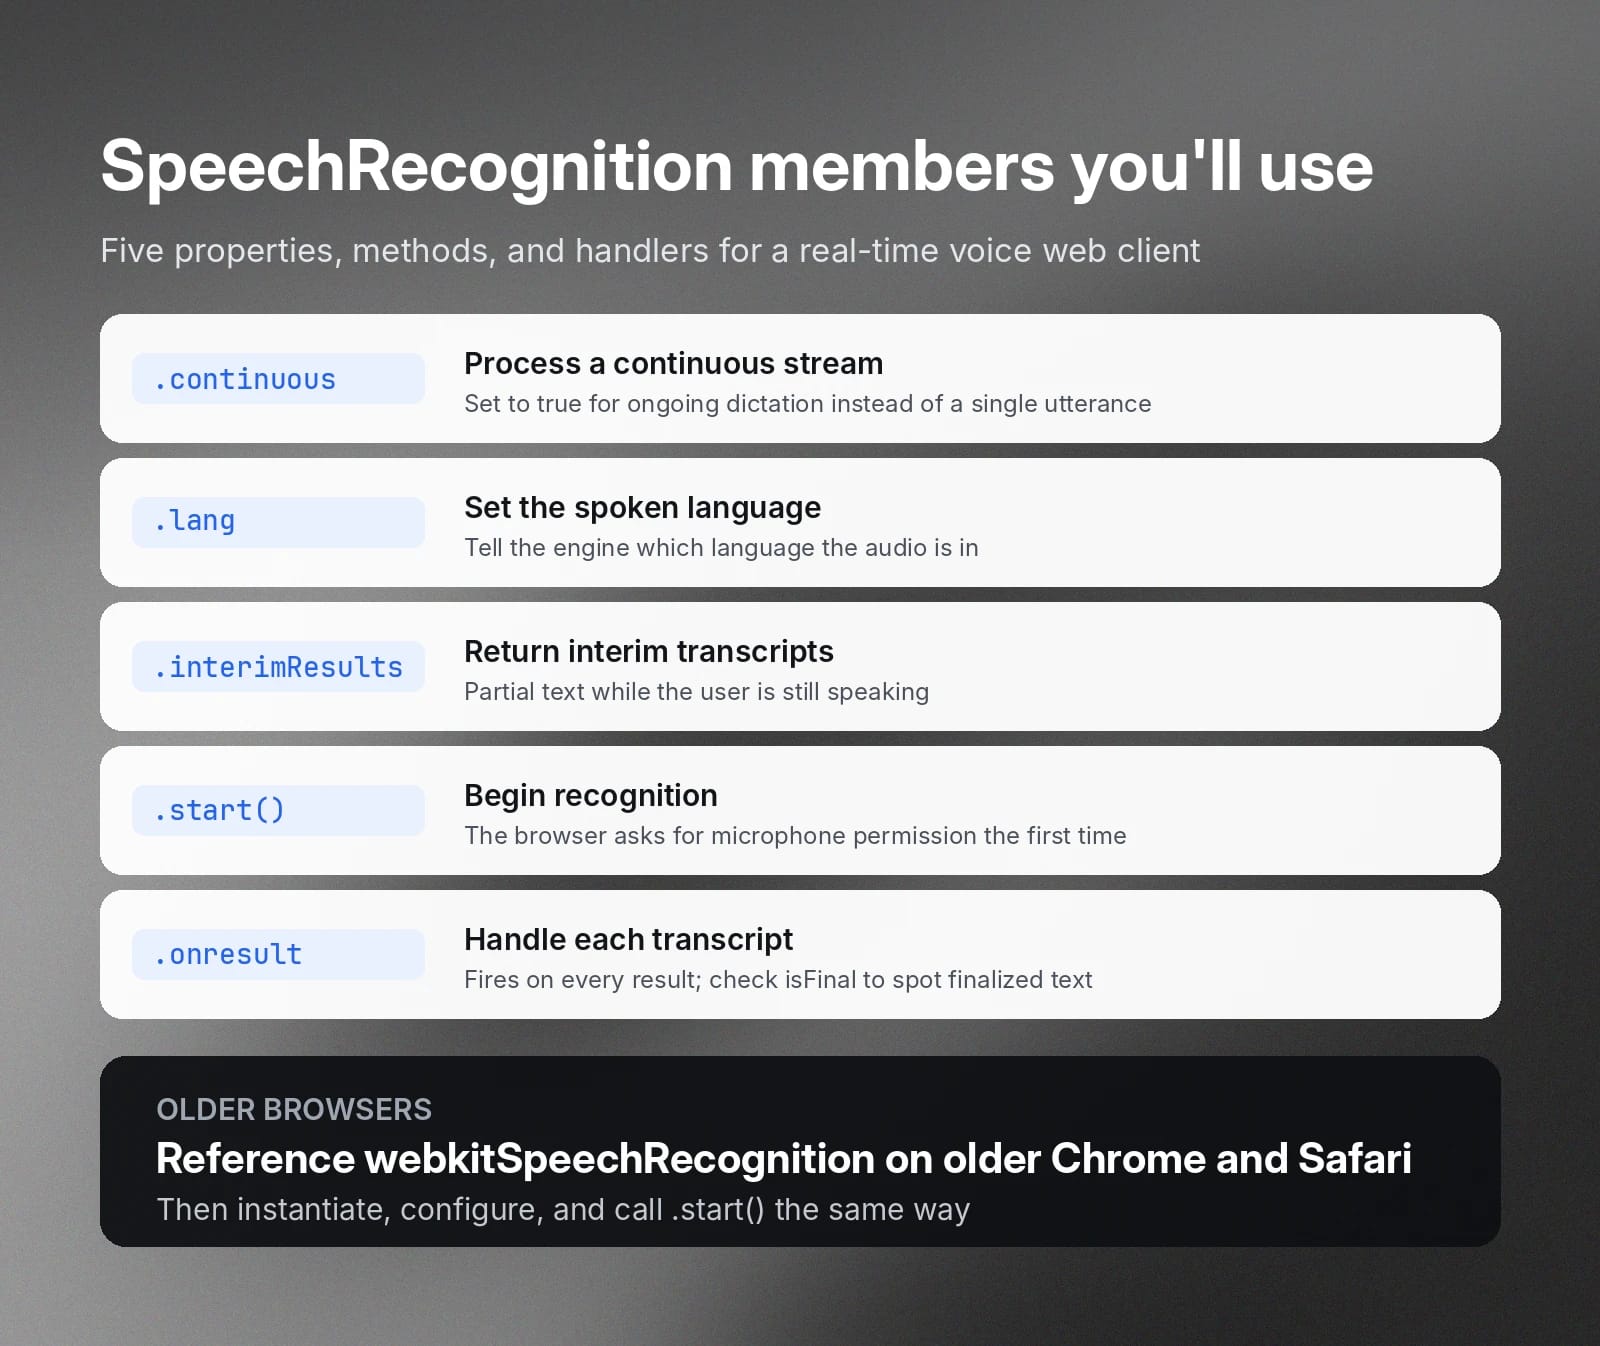
SpeechRecognition API reference: continuous, lang, interimResults, start(), and onresult.

构建 JavaScript 语音识别示例

本示例使用 JavaScript SpeechRecognition 接口构建实时转写 Web 应用。下方截图展示了完成后的页面。
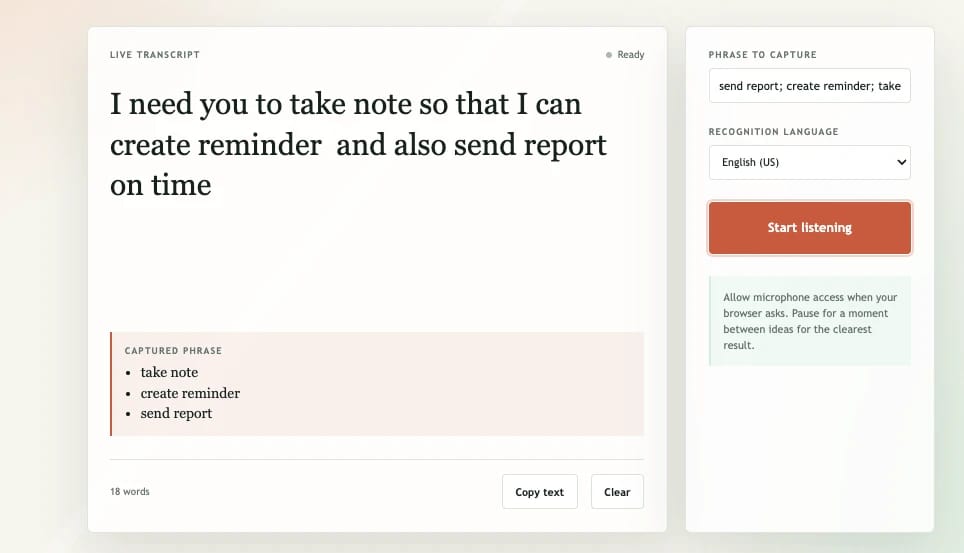
Speech capture interface showing a transcript and captured phrases for reminders and reports.

示例页面中,点击“开始聆听”按钮即可开始录音。用户说话时,浏览器会将音频发送到 STT 引擎,等待转写完成,并显示临时和最终文本。


该示例还包含语音命令功能,用于捕获用户列出的特定词语。它会在代码中将转写文本与预设短语列表进行比较,这不同于 语音转文本 API 中的关键词提示。
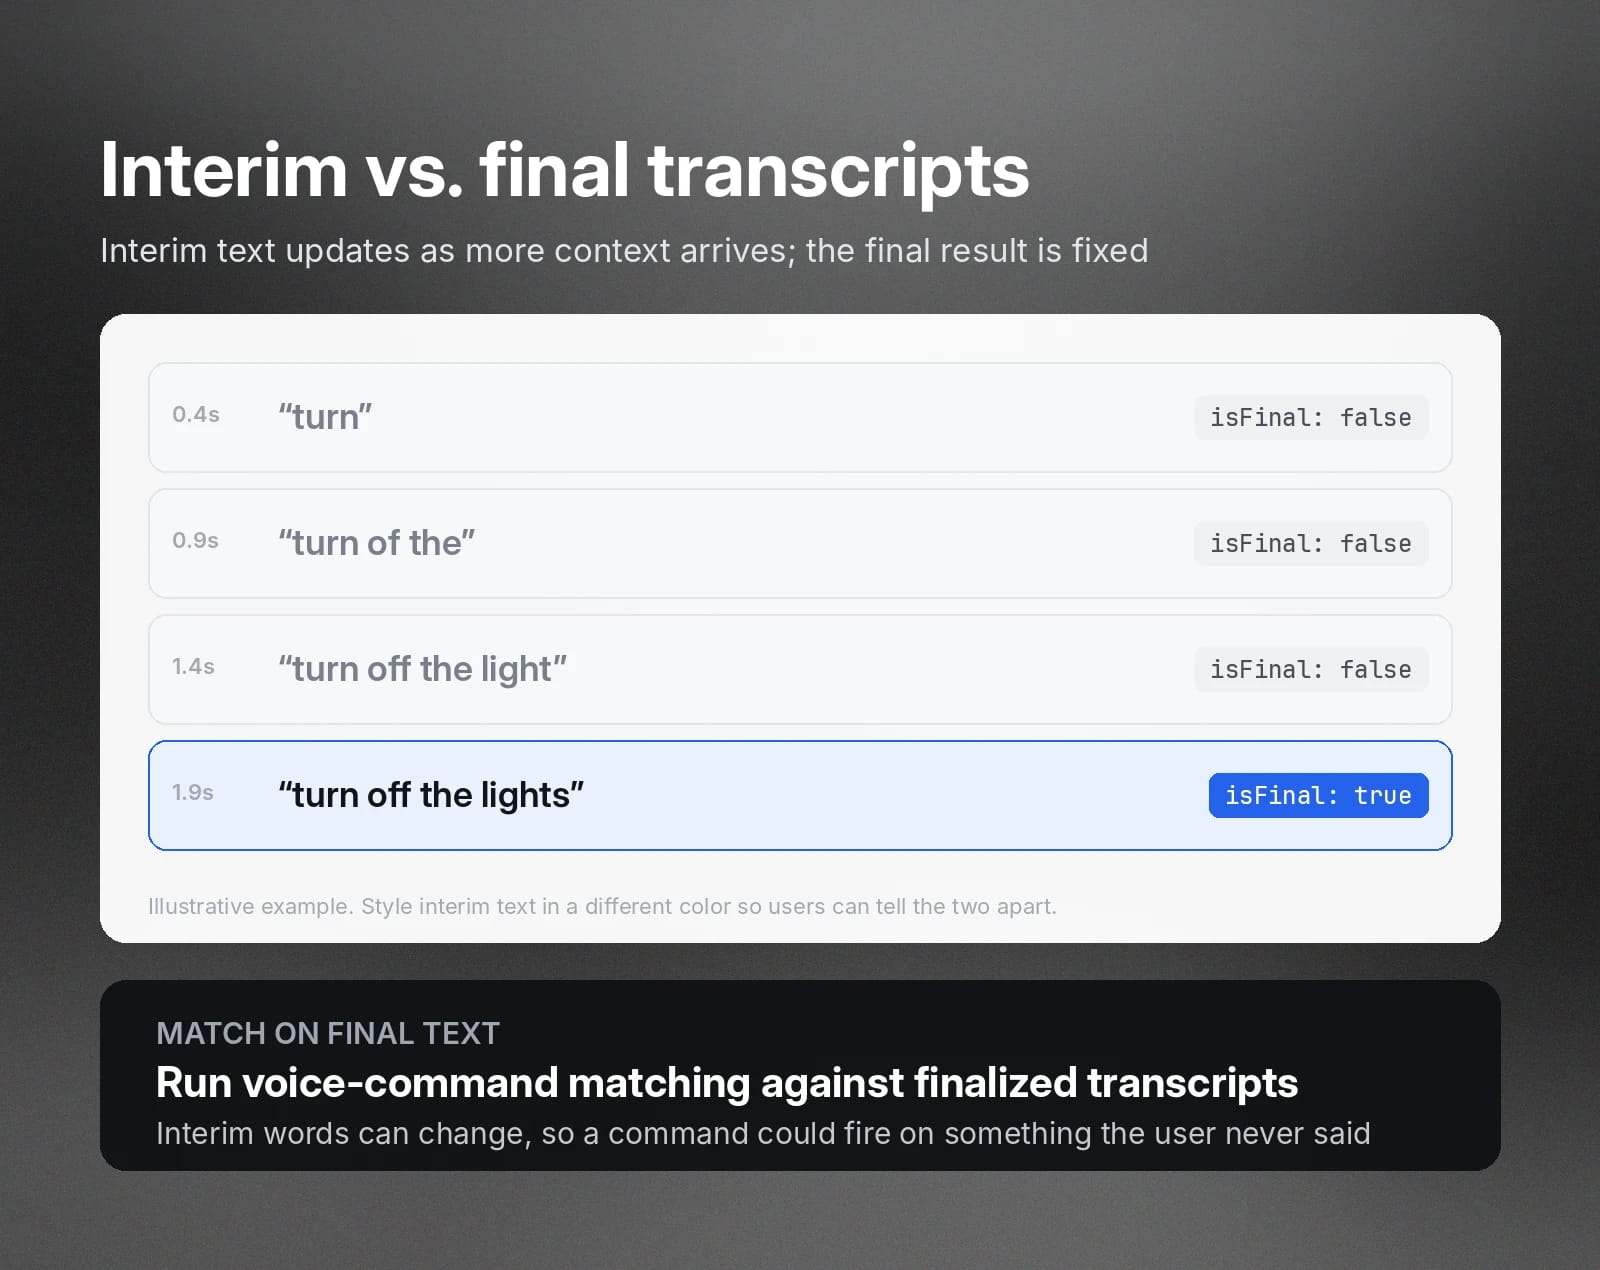
Interim transcript evolves to final “turn off the lights”; match commands on final text.

以下代码片段展示了该示例的关键部分。

设置 SpeechRecognition API 并请求麦克风访问权限

要在代码中使用它,首先需要实例化 SpeechRecognition 类。如果使用较旧版本的 Chrome 或 Safari,则需引用 webkitSpeechRecognition。

const SpeechRecognition = window.SpeechRecognition || window.webkitSpeechRecognition;

接着,创建 SpeechRecognition 实例,并配置流式模式、临时转写支持和语音语言。

recognition = new SpeechRecognition();
recognition.continuous = true;
recognition.interimResults = true;
recognition.lang = language.value;

然后,调用 .start() 方法即可开始转写。

recognition.start();


首次启动语音识别时,浏览器会请求用户授权。用户必须点击“允许”才能开始转写。否则,API 会在 SpeechRecognitionErrorEvent 处理程序中返回 “not-allowed” 值。

显示实时转写和最终结果

本示例会在用户对着麦克风说话时显示转写文本。为此,我们将函数附加到 onresult 事件。

recognition.onresult = (event) => {
  let interim = "";

  for (let index = event.resultIndex; index < event.results.length; index += 1) {
    const result = event.results[index][0].transcript;
    if (event.results[index].isFinal) text += `${result.trim()} `;
    else interim += result;
  }

  capturePhrases();
  render(interim);
};

临时转写尚未最终确定,因此显示的文本可能并非你实际说出的准确内容。随着 STT 引擎从后续词语获取更多上下文,它会修正转写结果并以字符串形式返回。

还可以为临时文本设置不同颜色,使其与最终转写文本区分开来。以下 CSS 可实现这一点:

#transcript .final { color: var(--ink); }
#transcript .interim { color: var(--accent); }

在 JavaScript 中添加语音命令

添加一个文本框,让用户输入想检测的短语,并用分号分隔。(也可以将短语存储在 JSON 文件中,再加载到代码中。)
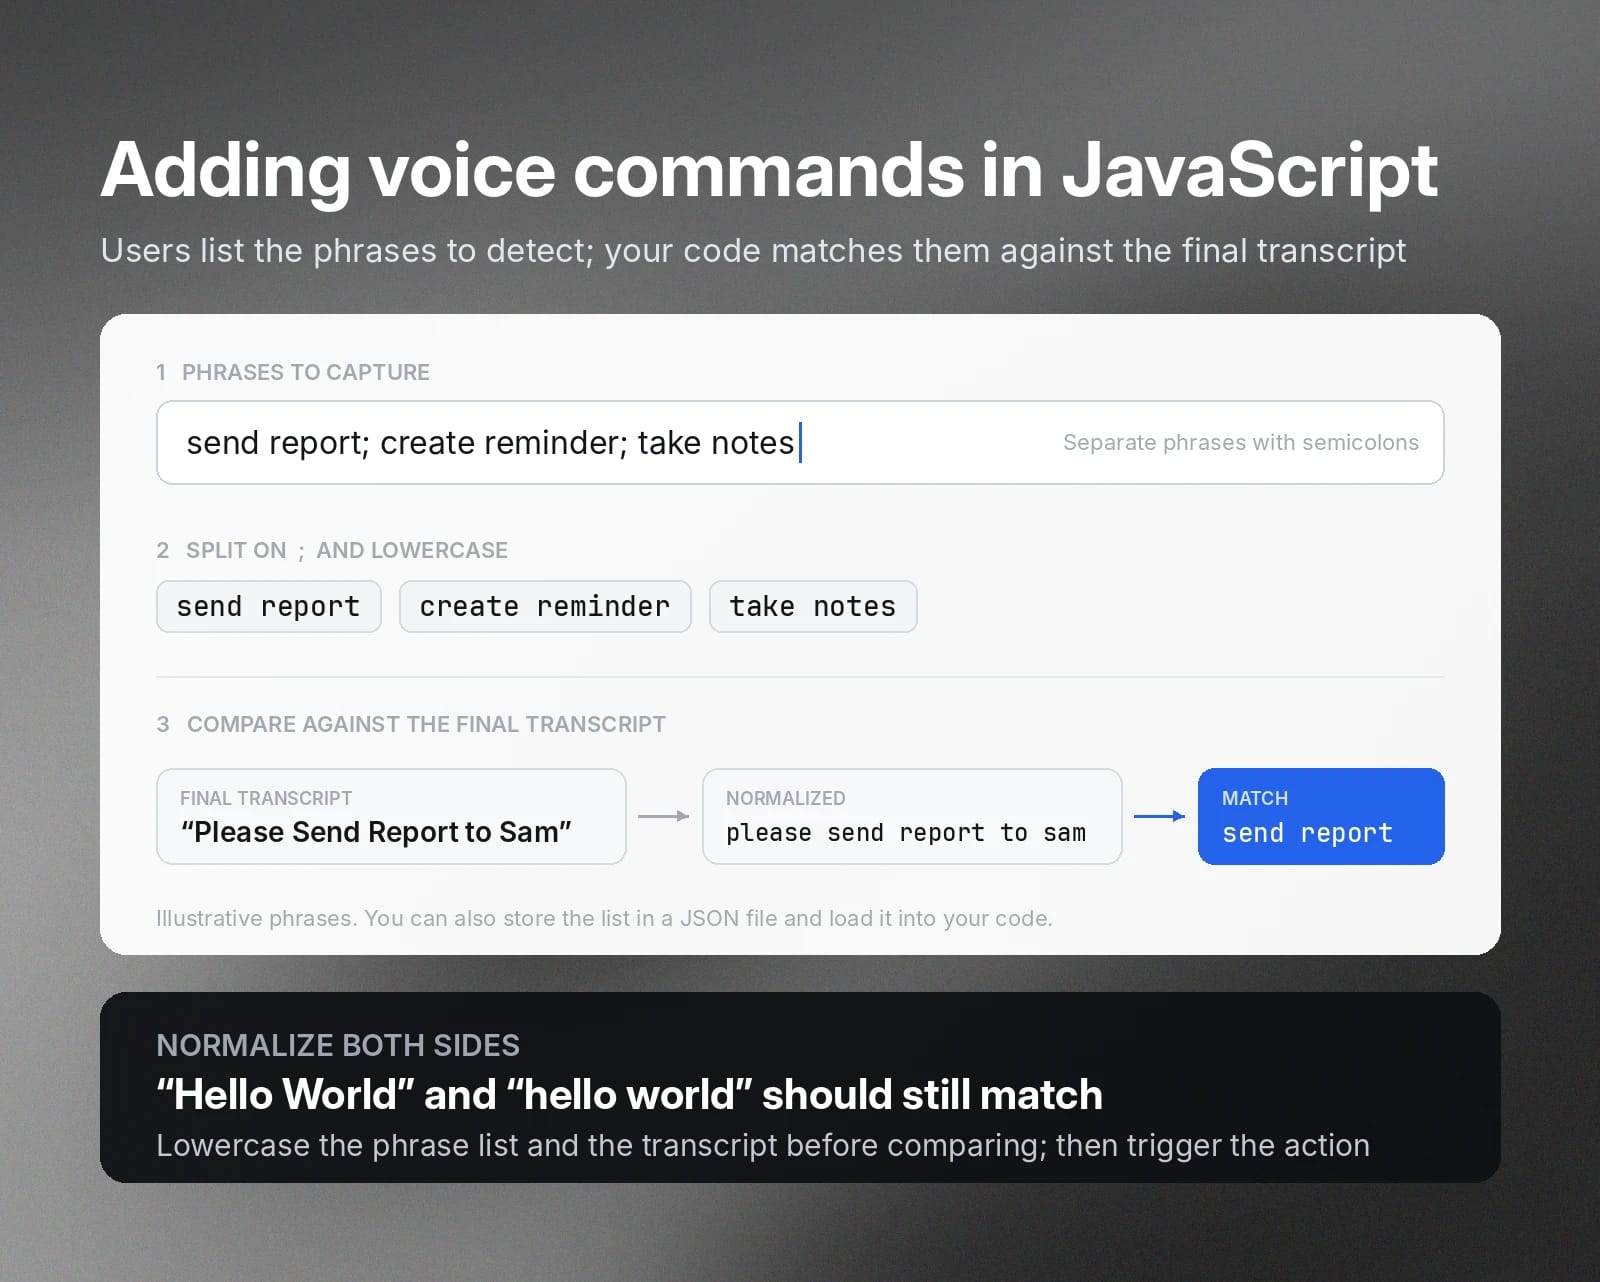
Voice command UI splits phrases, normalizes text, and matches them to a transcript.

然后,创建一个函数,将最终转写文本与短语列表进行比较。进行文本匹配时,应将两个列表都转换为小写进行标准化。这是因为用户可能会将单词首字母大写,即使是同一个词也可能导致不匹配。例如,即使大小写不同,“Hello World”和“hello world”也应视为匹配。

function capturePhrases() {
  const lowerText = text.toLocaleLowerCase();
  getTargetPhrases().forEach((phrase) => {
    if (lowerText.includes(phrase.toLocaleLowerCase()) && !capturedPhrases.includes(phrase)) {
      capturedPhrases.push(phrase);
      const item = document.createElement("li");
      item.textContent = phrase;
      capturedText.append(item);
    }
  });
  capturedResult.classList.toggle("visible", capturedPhrases.length > 0);
}

代码每次收到转写文本时,都会遍历短语列表。如果匹配成功,就触发相应操作,例如启动应用,或像本例一样在独立面板中显示匹配的短语。
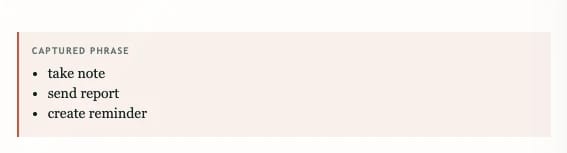
Captured phrase list: “take note,” “send report,” and “create reminder.”

处理浏览器支持、权限和识别错误

Web Speech API 让在 JavaScript 中进行语音转文本识别变得容易,但并非总是稳定无误。用户可能使用对 SpeechRecognition API 后端支持有限或完全不支持的浏览器。在某些情况下,网络问题会导致转写失败。

因此,代码需要处理这些情况,并向用户提供相应提示。

例如,可以提示用户使用已验证支持 SpeechRecognition API 的 Chrome 或 Edge。

if (!SpeechRecognition) {
  toggleButton.disabled = true;
  notice.textContent = "Speech recognition is not supported. Try Chrome or Edge.";
  notice.classList.add("visible");
} else {

同时,为处理错误,可将错误处理函数关联到 onerror 事件处理程序,并处理相应的错误代码。

例如:

错误代码

操作

not-allowed

显示提示用户检查浏览器设置的文本。

no-speech

提示用户靠近麦克风说话

network

提示用户检查网络连接

aborted

告知用户语音识别过程已停止。


recognition.onerror = (event) => {
  const messages = {
    "not-allowed": "Microphone access was blocked. Allow it in browser settings and try again.",
    "no-speech": "No speech was detected. Try speaking closer to the microphone.",
    network: "The speech recognition service could not connect. Check your internet connection.",
    aborted: "Speech recognition was stopped."
  };
  notice.textContent = messages[event.error] || `Recognition error: ${event.error}.`;
  if (event.error !== "aborted") notice.classList.add("visible");
  listening = false;
  toggleButton.textContent = "Start listening";
  statusText.textContent = "Error";
  status.classList.remove("listening");
};

让 JavaScript 语音识别更易用并注重隐私

集成 Web Speech API 时,应注意隐私。Web 客户端开始录音前,务必显示视觉或语音提示。例如,当 JavaScript 语音识别代码正将麦克风信号发送至语音转文本引擎时,可显示聆听图标作为视觉提示。
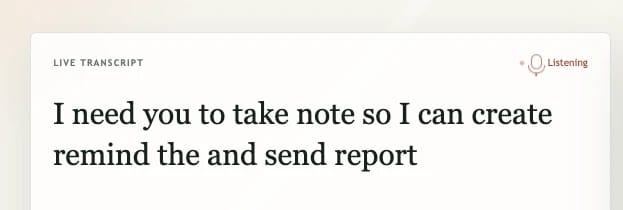
Live transcript reads: “I need you to take note so I can create remind the and send report.”

开发者还应关注数据隐私。使用 SpeechRecognition API 进行转写时,API 默认会在线完成转写。即使浏览器支持离线语音转文本,API 也会先尝试在线转写。

当构建对数据驻留、治理和合规有严格要求的转写服务时,这些技术规范至关重要。

了解浏览器语音识别何时不足以用于生产环境

我们已介绍如何使用 Web Speech API 为浏览器语音应用构建 自动语音识别。该 API 让 JavaScript 开发者能够使用语音转文本功能。但它的多项限制会约束应用场景,尤其是商业 Web 产品。

  • 依赖浏览器: 转写高度依赖用户的浏览器。开发者无法控制其使用的具体语音模型,因此转写性能不一致。
  • 语言支持有限:该 API 支持超过 40 种语言,但具体数量可能因浏览器而异。
  • 说话人分离:无法检测说话者身份,也无法在转写文本中区分不同说话者。
  • 自定义词汇:SpeechRecognition API 对自定义词汇缺乏可靠支持。例如,它无法准确转写“ElevenLabs”。(官方 SpeechRecognition API 通过 SpeechGrammarList 提供自定义词汇接口,但现代浏览器通常会忽略它。)
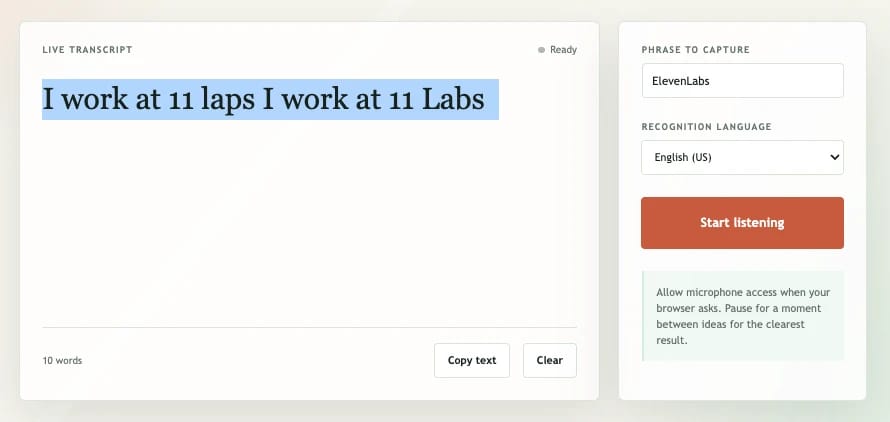
Limitations of JavaScript speech recognition when using Web Speech API. Speech-to-text interface showing a transcript and controls to listen for “ElevenLabs.”
  • 准确率:当说话者处于嘈杂环境、口音较重或距离麦克风较远时,转写准确率会下降。
  • 服务端流式传输:Web Speech API 不支持服务端流式传输或手动上传音频文件,因此只能从麦克风进行流式传输。

如果这些限制阻碍了语音识别产品的商业化,建议使用 ElevenLabs Scribe v2 Realtime。

ElevenLabs Scribe v2 Realtime 是一款语音识别模型,可提供高准确率的 实时转写,延迟低于 150 ms。它支持 90 多种语言、跨浏览器一致性和自定义词汇。使用 ElevenLabs Scribe v2 Realtime,可进行客户端或 服务端流式传输,以适配 Web 应用架构。
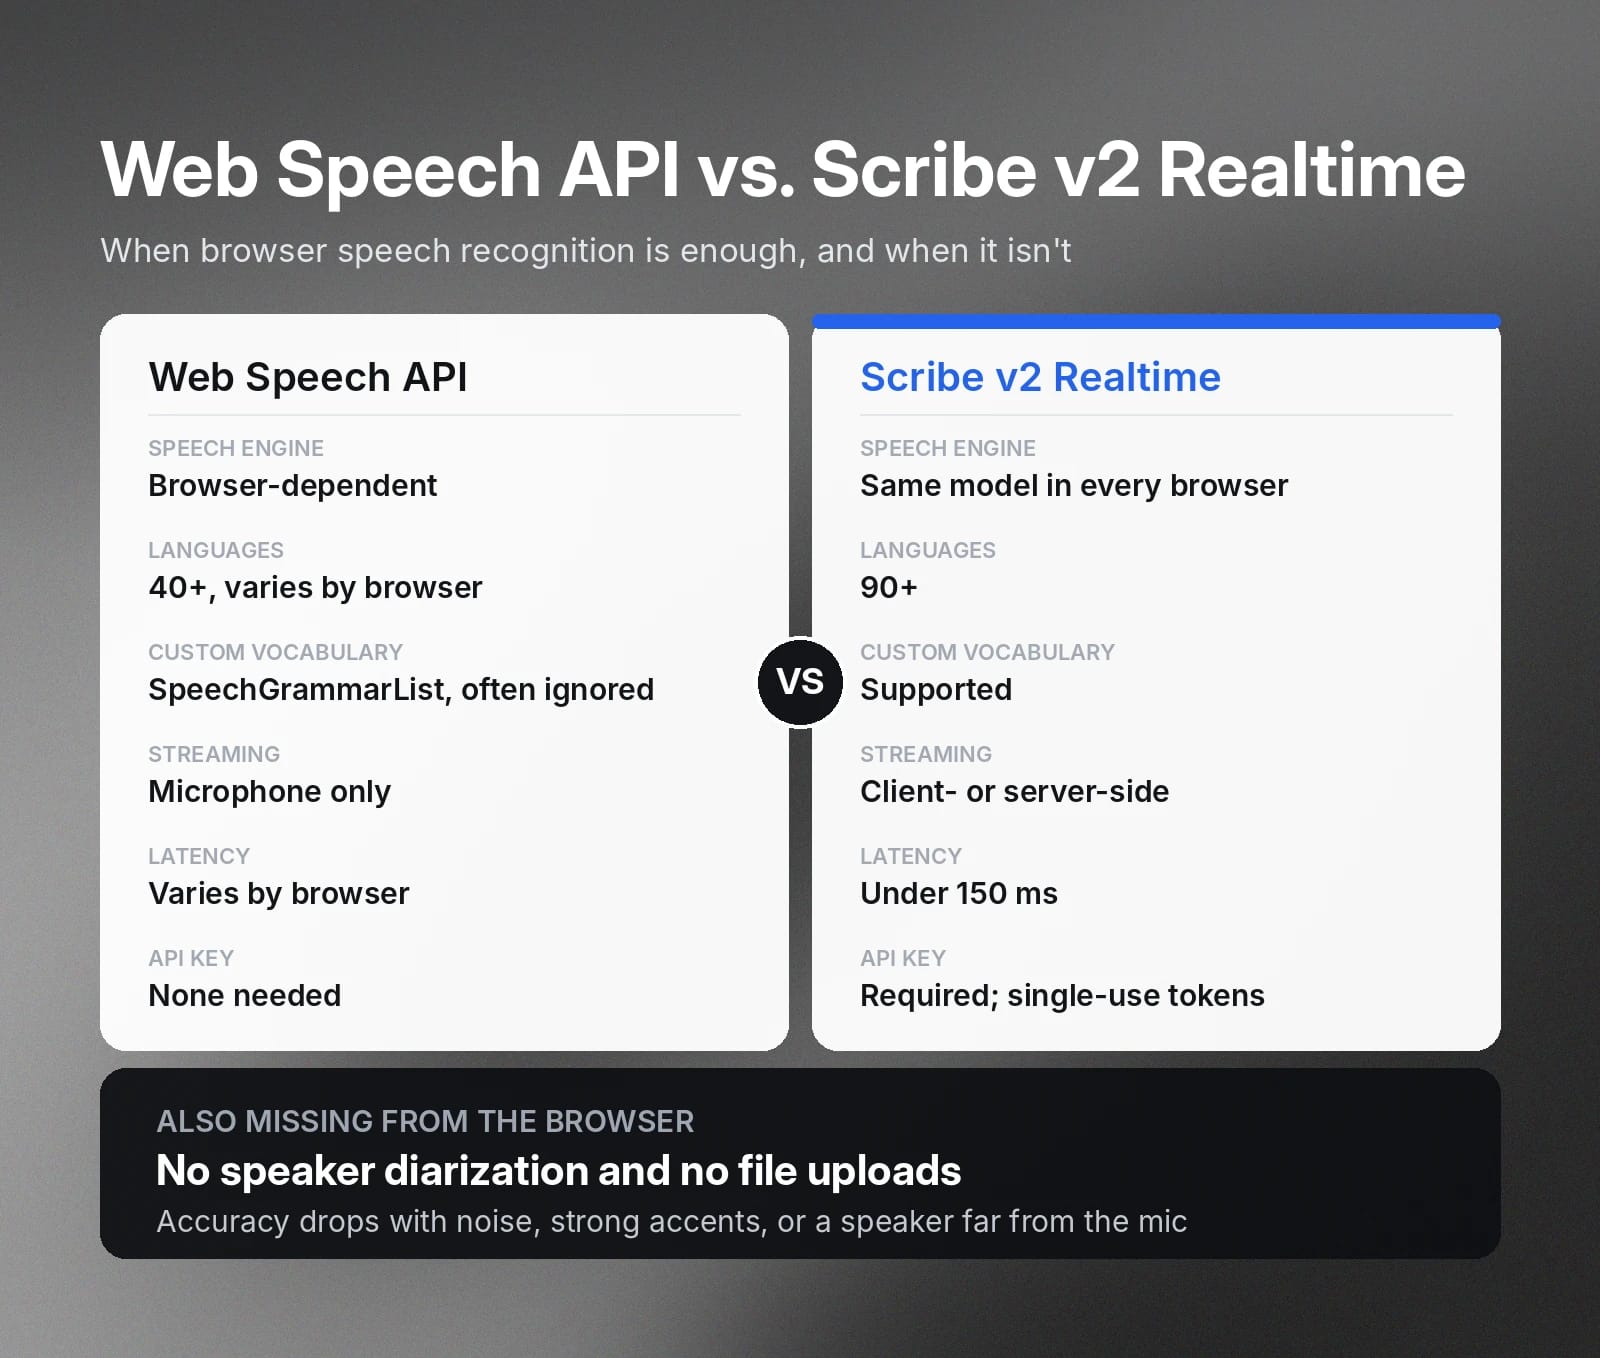
Web Speech API versus Scribe v2 Realtime: browser limits versus consistent, richer features.

使用 ElevenLabs Scribe v2 Realtime 的 JavaScript 语音识别教程

使用 ElevenLabs 在 JavaScript 中构建语音命令的方式类似。不过,需要创建 ElevenLabs API 密钥来授权 API 请求。以下是构建从麦克风进行流式传输的 Web 客户端的快速步骤。

  1. 安装 ElevenLabs SDK
npm install @elevenlabs/client @elevenlabs/elevenlabs-js
  1. 创建一次性令牌,以传递 API 密钥而不暴露它
// Node.js server
import { ElevenLabsClient } from "@elevenlabs/elevenlabs-js";

const elevenlabs = new ElevenLabsClient({
  apiKey: process.env.ELEVENLABS_API_KEY,
});

app.get("/scribe-token", yourAuthMiddleware, async (req, res) => {
  const token = await elevenlabs.tokens.singleUse.create("realtime_scribe");

  res.json(token);
});
  1. 使用所需参数配置并连接 Scribe v2 Realtime 模型
// Client side
import { Scribe, RealtimeEvents } from "@elevenlabs/client";

// Ensure you have authentication headers set up
const response = await fetch("/scribe-token", yourAuthHeaders);
const { token } = await response.json();

const connection = Scribe.connect({
  token,
  modelId: "scribe_v2_realtime",
  includeTimestamps: true,
  microphone: {
    echoCancellation: true,
    noiseSuppression: true,
    autoGainControl: true,
  },
});
  1. 创建事件处理程序以处理转写结果和异常
// Set up event handlers

// Session started
connection.on(RealtimeEvents.SESSION_STARTED, () => {
  console.log("Session started");
});

// Partial transcripts (interim results), use this in your UI to show the live transcript
connection.on(RealtimeEvents.PARTIAL_TRANSCRIPT, (data) => {
  console.log("Partial:", data.text);
});

// Committed transcripts
connection.on(RealtimeEvents.COMMITTED_TRANSCRIPT, (data) => {
  console.log("Committed:", data.text);
});

// Committed transcripts with word-level timestamps. Only received when includeTimestamps is set to true.
connection.on(RealtimeEvents.COMMITTED_TRANSCRIPT_WITH_TIMESTAMPS, (data) => {
  console.log("Committed:", data.text);
  console.log("Timestamps:", data.words);
});

// Errors - will catch all errors, both server and websocket specific errors
connection.on(RealtimeEvents.ERROR, (error) => {
  console.error("Error:", error);
});

// Connection opened
connection.on(RealtimeEvents.OPEN, () => {
  console.log("Connection opened");
});

// Connection closed
connection.on(RealtimeEvents.CLOSE, () => {
  console.log("Connection closed");
});

// When you are done, close the connection
connection.close();

如需详细了解 Scribe v2 Realtime,请查看官方文档。

使用 ElevenAPI 开始构建生产级语音转文本应用

ElevenAPI 提供生产级语音转文本模型,适用于 Web 客户端和服务端开发。除实时语音识别外,开发者还可使用 ElevenAPI 语音转文本模型实现批量转写,包括说话人分离、词级时间戳和异步处理。

无需持续轮询语音转文本引擎,可以在 ElevenLabs 控制面板中创建 webhook 并提供回调 URL,由 API 将完成的转写文本发送至该地址。

无论要构建基于自动语音识别的 Web 客户端还是服务端应用,ElevenAPI 都提供可轻松集成到代码中的音频模型。

获取 ElevenLabs API 密钥 并查看 API 文档,开始构建。

使用 ElevenLabs 构建企业级 STT 应用

需要其他帮助?前往 帮助中心

常见问题

作者

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。


相关内容

用高质量 AI 音频创作

