
什么是说话人分离?工作原理及应用场景
- 发布时间
- 最近更新
说话人分离会处理说话人数未知的音频流,并生成带标签片段的时间线:说话人 A 从 0:00 到 0:42,说话人 B 从 0:42 到 1:15,之后再次是说话人 A。系统不知道说话人是谁,但能识别他们是不同的人,并在整段录音中保持标签一致。
这一过程让多人音频变得可用。会议纪要、呼叫中心分析、访谈转录、播客编辑和法律记录,都不仅需要知道说了什么,还需要知道是谁说的。
本指南将介绍说话人分离的工作原理、它与分段和识别等相关技术的区别、可处理此任务的开源工具,以及如何评估说话人分离系统的表现。
摘要
- 说话人分离会按说话者对音频录音进行分段,生成带标签的说话轮次,但不会按姓名识别任何人。
- 说话人分离不同于说话人分段(用于找出说话人何时切换),也不同于说话人识别(用于将声音匹配到真实姓名)。
- 说话人分离性能可通过说话人分离错误率(DER)衡量整体准确性,并通过 Jaccard 错误率(JER)检查每位说话人的准确性是否都能保持一致。
什么是说话人分离?它如何工作?
说话人分离是按说话者将音频流划分为不同片段的过程。带说话人分离功能的转录会为每段音频标注说话人身份。简单来说,它回答的是“谁在什么时候说话?”
原始会议转录只提供文字;而经过说话人分离的转录会告诉你,说话人 1 提出了问题,说话人 2 作出回答,说话人 3 中途打断了对话。
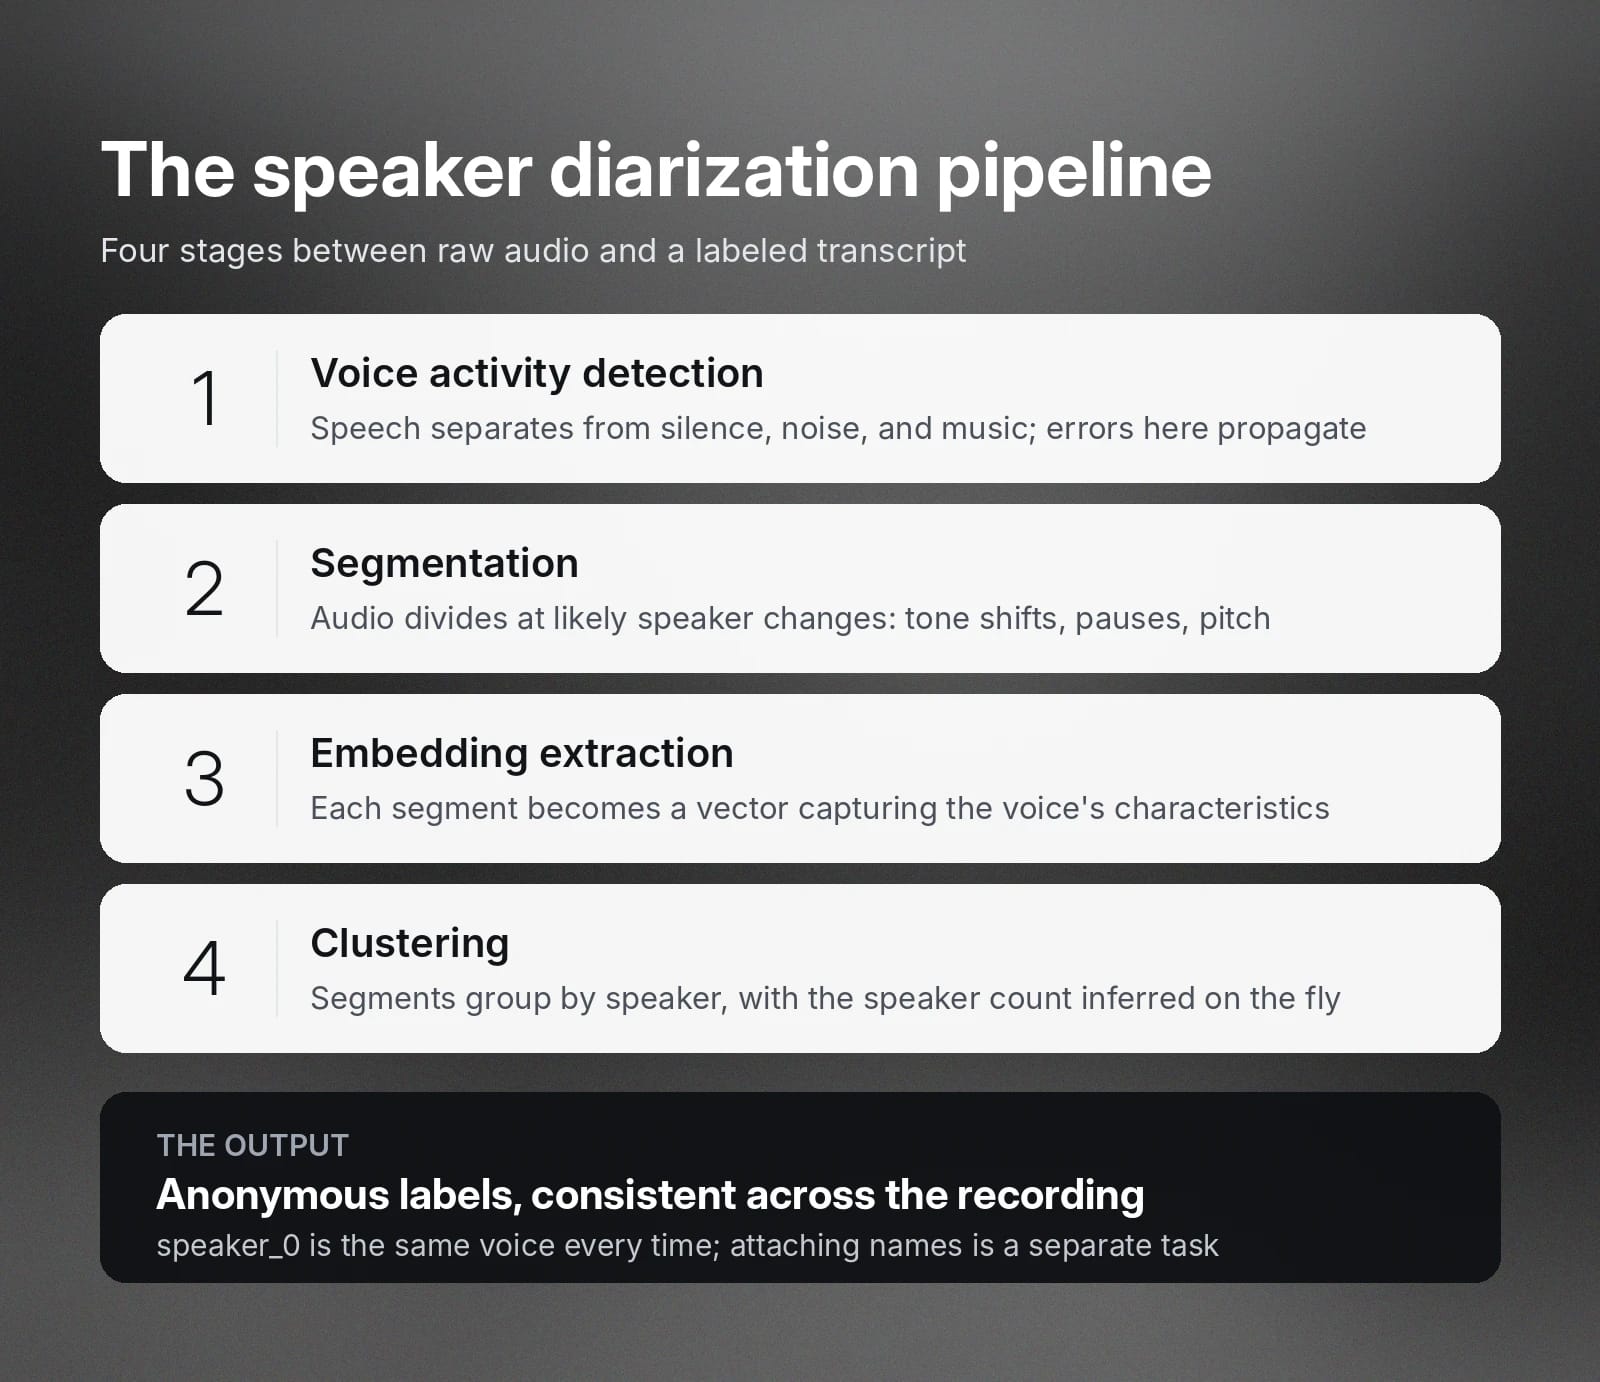
大多数说话人分离系统都采用包含 4 个阶段的流程:
下面详细介绍这些阶段。
语音活动检测(VAD)
语音活动检测会将语音与其他声音分开:静音、背景噪声、音乐或键盘敲击声。只有包含实际语音的音频片段才会进入下一阶段。
这一阶段的任何错误都会传递到后续各阶段。
分段
接着,会在说话人可能切换的位置划分这些含语音的片段,例如音色变化、轮次之间的停顿或音高模式变化。大多数系统会比较候选边界两侧的声学特征,直接检测这些变化点。
有些分段工具会将音频切成短小且长度一致的窗口,例如每段 2 秒,再在聚类阶段合并属于同一说话人的相邻窗口。
嵌入提取
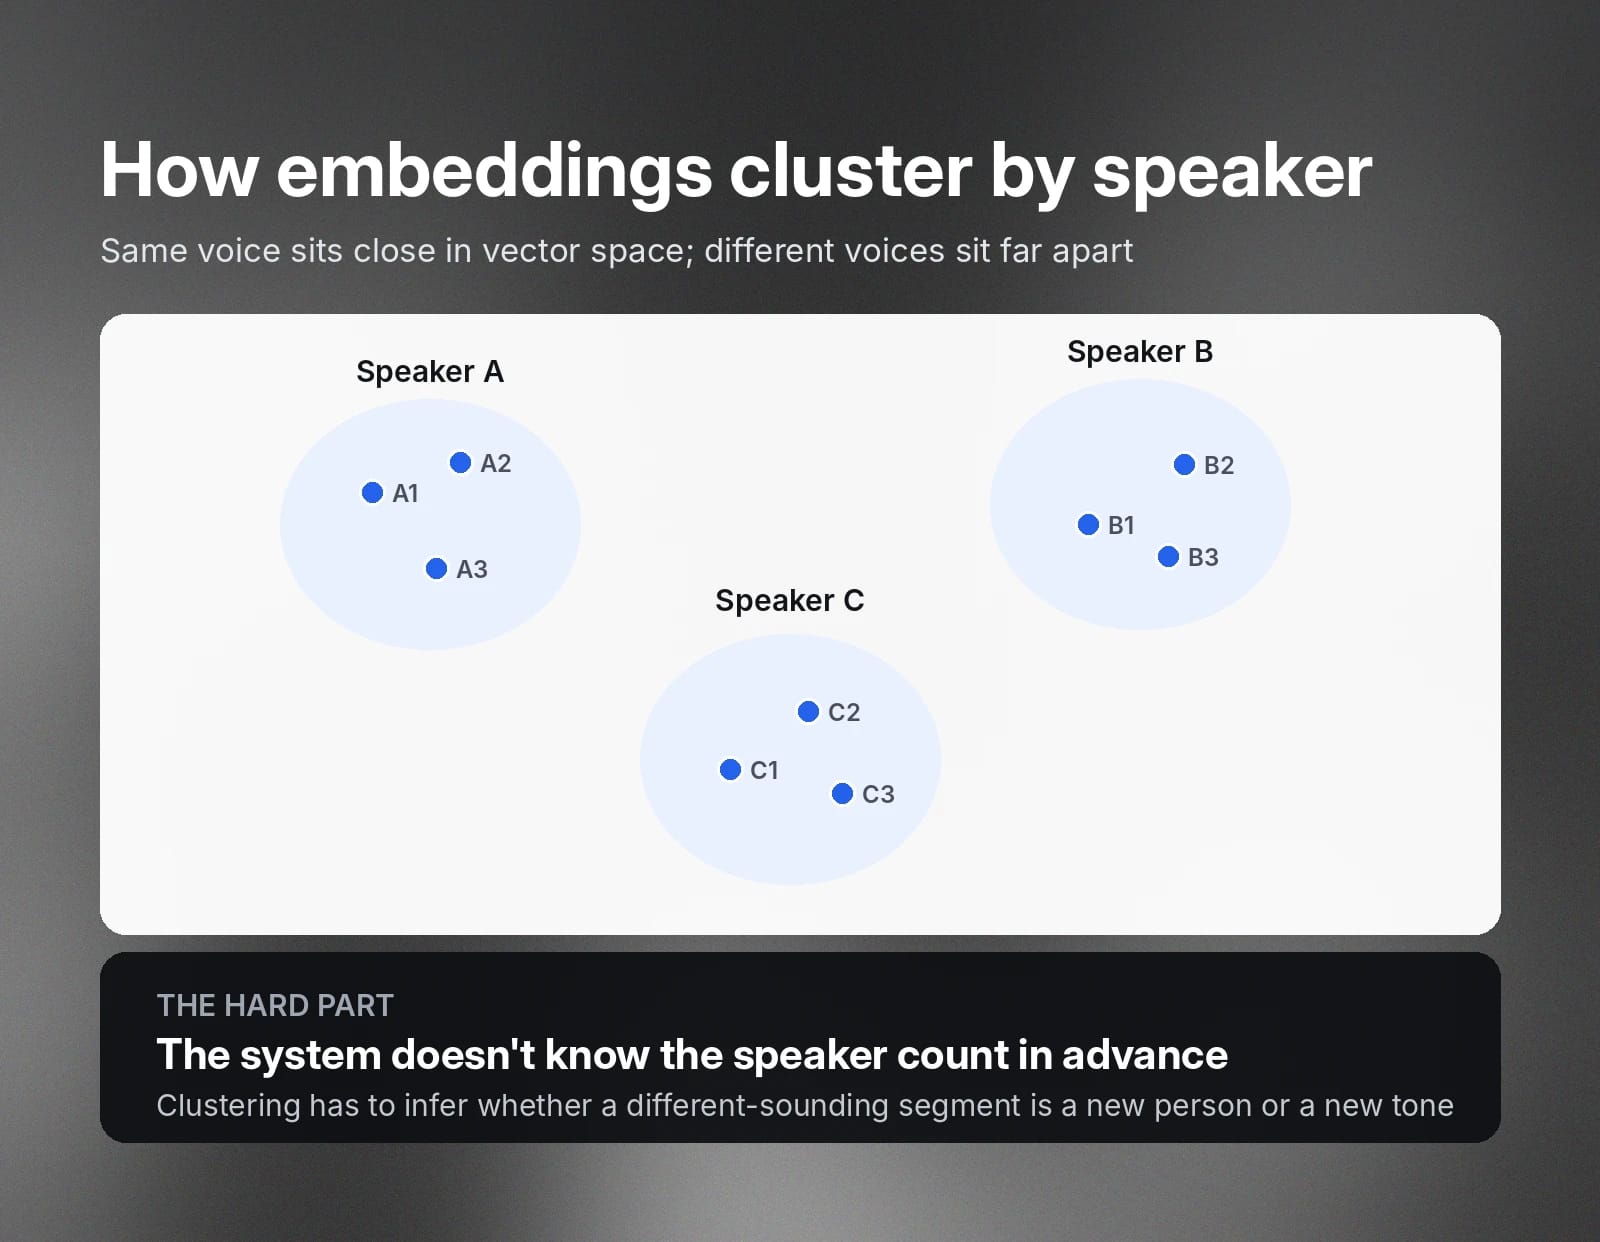
每个语音片段都会转换为说话人嵌入,即一个捕捉该片段说话者声音特征的数值向量。同一说话人的嵌入在向量空间中会聚集得更近,不同说话人的嵌入则相距更远。
聚类
随后会对嵌入进行分组,让来自同一说话人的片段共享一个标签。系统通常事先不知道说话人数,因此聚类算法必须自行推断:这个声音略有不同的片段是新说话人,还是同一人换了一种语气。
输出是一组附带时间范围的说话人标签,通常会与转录文本配对。例如,双人通话经过说话人分离后的转录如下:
- [speaker_0] 感谢来电。有什么可以帮你?
- [speaker_1] 你好,我想咨询上个月的账单。
- [speaker_0] 好的,我来查一下。
这些标签是匿名且内部一致的。每次出现的 speaker_0 都是同一个声音,但系统不知道 speaker_0 名叫 Fergal。关联真实身份是另一项任务,下面会介绍。
说话人分段与说话人识别的主要区别
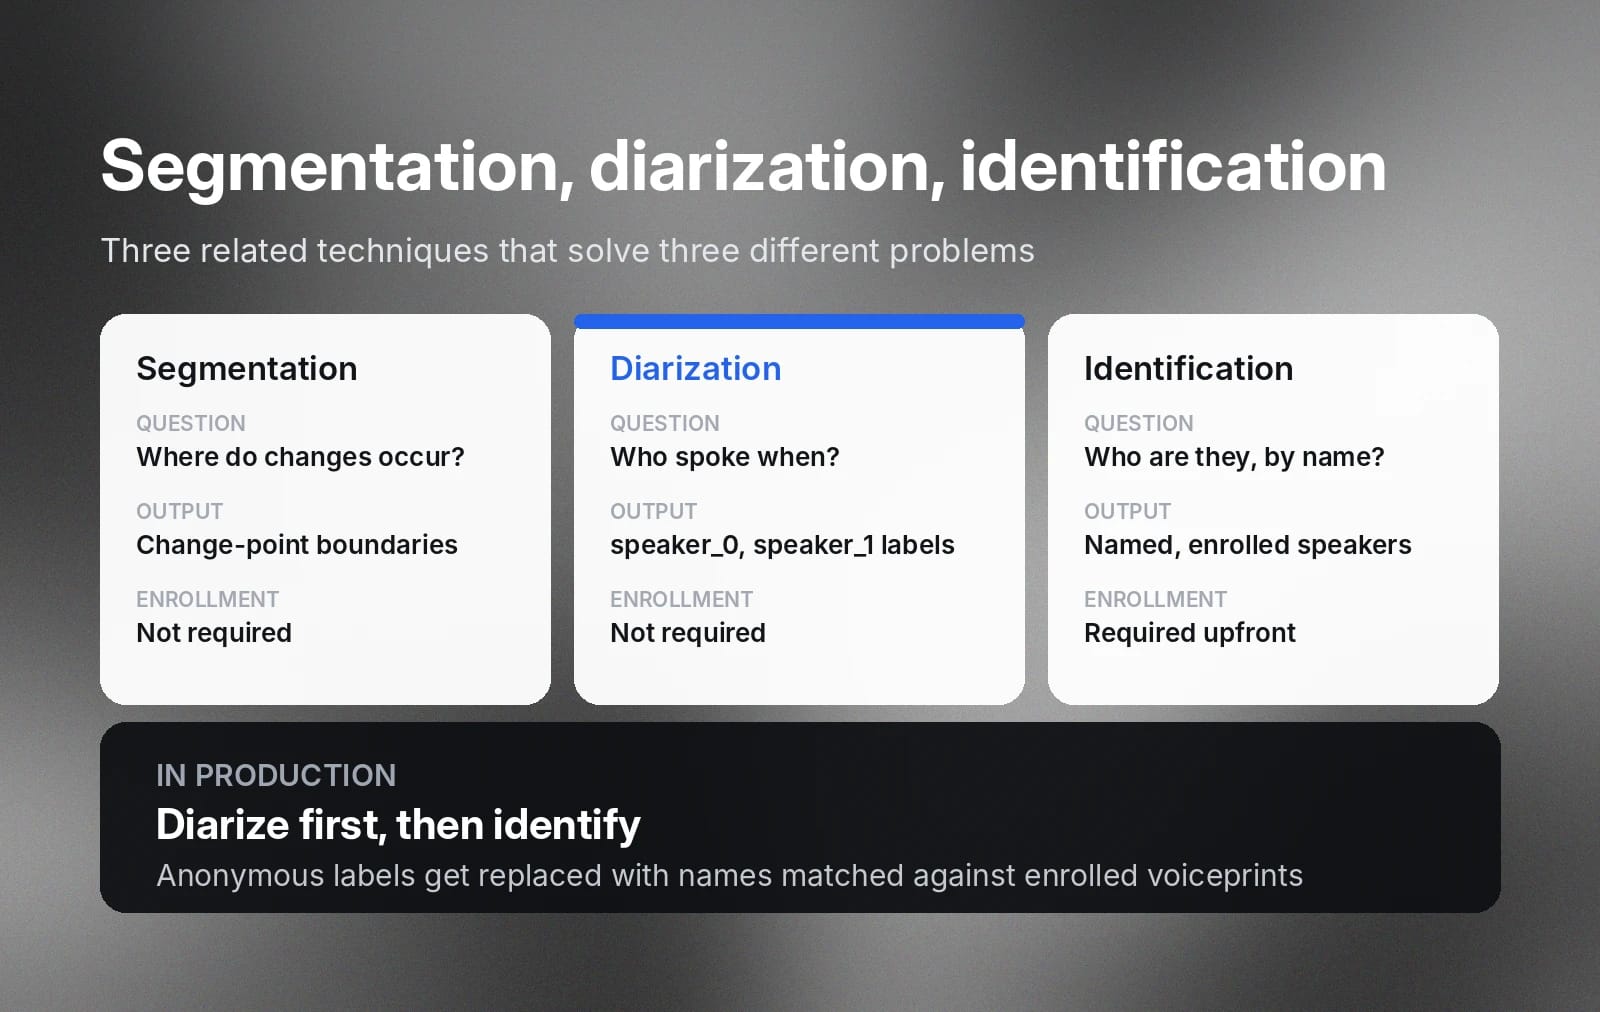
说话人分段和说话人识别都与说话人分离密切相关,因此三者经常被混为一谈。
它们解决的问题略有不同,因此评估工具时理解其中区别很重要。
如前所述,说话人分段是说话人分离流程早期的一个步骤。它找出说话人从一个声音切换到另一个声音的边界,但不会分配标签。分段会告诉你在 0:42 发生了变化。说话人分离则在此基础上对生成的片段进行分组,并输出完整标签,让你知道 1:15 的声音与录音开头说话的声音相同。
说话人识别是独立于说话人分离的能力,但经常与其结合使用。识别用于确定这些说话人的真实身份。识别系统会将声音与已注册的声纹进行比对,并以已知说话人参考库返回身份。识别后,speaker_0 和 speaker_1 会变成“Fergal”和“Eric”。
许多产品会结合这些工具,生成更完整的最终转录。会议工具可能会自动完成此操作(甚至可能提取某人在 Teams 或 Meet 中设置的名称等字符串),从而无需人工审核即可按姓名标注每位参会者的发言。
热门开源说话人分离工具和库
如果你需要控制力、灵活性或本地部署,开源说话人分离工具值得考虑。最佳选择取决于处理的音频类型(电话、会议、播客、广播)、延迟要求,以及可投入多少工程时间。
以下是一些最受欢迎的选择。
Pyannote.audio
Pyannote.audio 是一款基于 PyTorch、专为说话人分离构建的工具包,也是最常用的开源选择之一。它提供覆盖完整说话人分离技术栈的预训练流程,包括 VAD、分段、嵌入和聚类,也提供了在自有数据上训练或微调模型的基础组件。
其预训练模型通过 Hugging Face 发布,常被用作大型转录项目中的说话人分离层。
WhisperX
WhisperX 将 OpenAI 的 Whisper ASR 与说话人分离和强制对齐相结合。Whisper 本身能生成高质量转录,但不会分配说话人标签,其时间戳也只是近似值。WhisperX 增加了词级时间戳对齐,并集成基于 pyannote 的说话人分离功能,生成的转录中每个词都带有准确时间戳和说话人标签。
NVIDIA NeMo
NVIDIA NeMo 将说话人分离纳入其更广泛的对话式 AI框架。它提供可训练的说话人分离模型,包括可处理重叠语音的端到端方法,适合在 GPU 基础设施上大规模构建自定义语音系统的团队。
这些工具都要求你管理说话人分离基础设施,包括模型部署、扩缩容、监控和更新。对于不想承担这些运维开销的团队,托管式说话人分离 API 提供了更简单的替代方案。它们既可集成到现有 workflow,也可处理整个说话人分离流程,适合用于生产环境,例如客户支持分析、会议转录和播客处理。
实时说话人分离:挑战和应用场景
实时说话人分离比处理已完成录音的说话人分离难得多,因为系统必须在上下文不完整的情况下作出决策。
离线系统会在作出任何判断前查看整段录音。它可以比较第 2 分钟和第 40 分钟的声音,并确信地判断它们属于同一说话人,因为两个时刻的信息都同时可用。实时系统没有这种条件:语音一到就必须立即标注,无法获知后续内容,且一旦作出决策,几乎没有机会或根本没有机会修改。
正是缺少未来上下文,使以下 3 个问题在实时场景下更难解决:
- 延迟与准确性:无法在整段对话中前后比对时,满足更严格响应时间预算会直接牺牲准确性。
- 重叠语音:当人们同时说话时,能够重新处理音频的系统或许可以将其分开。实时系统必须将其归为单一标签,或即时依靠专门的重叠感知模型。
- 短语句:简短的“是”或“请说”几乎无法为系统提供足够的声音信息;没有周围上下文可参考时,它仍必须立即确定标签。
尽管存在困难,有些应用无法等到录音结束。实时字幕用于会议和广播时,需要在人们说话的同时提供说话人标签。呼叫中心软件需要在通话过程中向智能体提供指引,因此必须实时知道客户说了哪些话。语音智能体处理多方通话时,需要毫不延迟地追踪谁在问什么。在每种情况下,稍微不够准确但即时的系统都优于更准确却有延迟的系统。
对于确实不需要实时标签的工作负载,例如分析、合规审查和生成转录,批量说话人分离仍是更好的选择,因为它的准确性高得多。
如何评估说话人分离性能
衡量说话人分离准确性时,最重要的两个指标是说话人分离错误率(DER),用于衡量整体准确性;以及 Jaccard 错误率(JER),用于检查每位说话人的准确性是否都能保持。
DER 专门计算被错误归属的语音时长占总语音时长的比例。它包含 3 类错误:
- 误报语音:无人说话时,系统将某个片段标记为语音。
- 漏检语音:有人说话,但系统将其标记为静音。
- 说话人混淆:检测到了语音,但归属给了错误的说话人。
DER = (误报 + 漏检语音 + 说话人混淆)/ 总语音时长
DER 为 10% 表示这 3 类错误合计占总语音时长的十分之一。数值越低越好,且只有在相同条件下基于相同数据测量的分数才可比较。DER 会因音频质量、说话人数和录音中的重叠程度而有很大差异。
Jaccard 错误率(JER)会分别衡量每位说话人的说话人分离准确性,再对所有说话人的结果取平均值。对于每位参考说话人,评估器会匹配系统中最接近的说话人标签,并将正确重叠时长与归属于任一说话人的总时长进行比较。
例如,设想一场 60 分钟的会议:说话人 A 发言 50 分钟,说话人 B 发言 10 分钟。某个说话人分离系统正确标注了说话人 A 的 50 分钟中的 48 分钟,却只正确标注了说话人 B 的 10 分钟中的 4 分钟。由于会议大部分时间属于说话人 A,其整体 DER 仍可能看起来相对不错。JER 会让说话人 B 的较差结果得到同等权重,因为它会先独立评估说话人 A 和 B,再对分数取平均值。
JER_speaker = 1 - (correct_overlap / (ref_time + sys_time - correct_overlap))
最终 JER 是各说话人错误率的平均值:
JER = (1 / N)* Σ[JER_speaker_i],其中 i = 1..N
同时跟踪 DER 和 JER,能更全面地了解说话人分离的准确性:DER 衡量整体准确性,JER 衡量这种准确性是否适用于每位参与者,包括发言较少的人。
使用代表生产环境的音频进行测试
评估说话人分离系统时,应在与实际部署条件相符的音频上计算 DER 和 JER:典型说话人数、音频质量和串话量。
已发布的基准测试分数可能基于干净、受控的数据集测量,例如录音室录音,但它们很少与真实通话录音或现场会议的声音相符。基准测试得分高的系统,在嘈杂、语音重叠的真实环境音频中仍可能表现明显不佳。选择说话人分离产品前,请先使用自己的数据测试。
使用 ElevenAPI 开始进行说话人分离
如果你准备构建支持多说话人的转录功能, Scribe v2 让 ElevenLabs 通过单个说话人分离功能提供文本转语音 API。将音频连同 diarize=true 发送至端点,JSON 响应会为每个词标注说话人 ID,最多支持 32 位说话人、90 多种语言,以及最长 10 小时的文件。
两个选项可扩展标准说话人分离输出。对于通话录音,detect_speaker_roles=true 会将说话人标注为智能体和客户,而不是匿名编号。如果工作区已注册说话人档案,use_speaker_library=true 可将检测到的说话人与已注册声音匹配,在一次请求中结合说话人分离和识别。
一个说话人分离阈值参数可让你调整过度拆分与合并说话人之间的取舍。如果说话人已被隔离到不同音频通道中,例如立体声通话录音,多通道转录会按通道分配说话人,并完全跳过说话人分离。
文本转语音快速入门会逐步介绍首次集成。对于受监管的部署,平台符合 SOC 2、ISO 27001、PCI DSS L1 和 HIPAA 标准,并提供 EU 数据驻留和零保留模式。
准备好在系统中构建说话人分离功能了吗?先获取 API 密钥,或查看ElevenLabs 文档了解更多。
常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。


