推出 Scribe v2
- 发布时间
Scribe v2 专为批量转录、大规模字幕制作和字幕添加而打造。相比 Scribe v1,它在稳定性和准确性上有所提升,能更好地处理长音频、停顿、语调变化和长时间静音。

Scribe v2 Realtime 针对超低延迟和智能体使用场景进行了优化,而 Scribe v2 则专为长且复杂的录音优化,在不同说话人、口音和表达风格下均能保持准确。无论实际音频条件如何,都能持续提供可靠的转录文本。
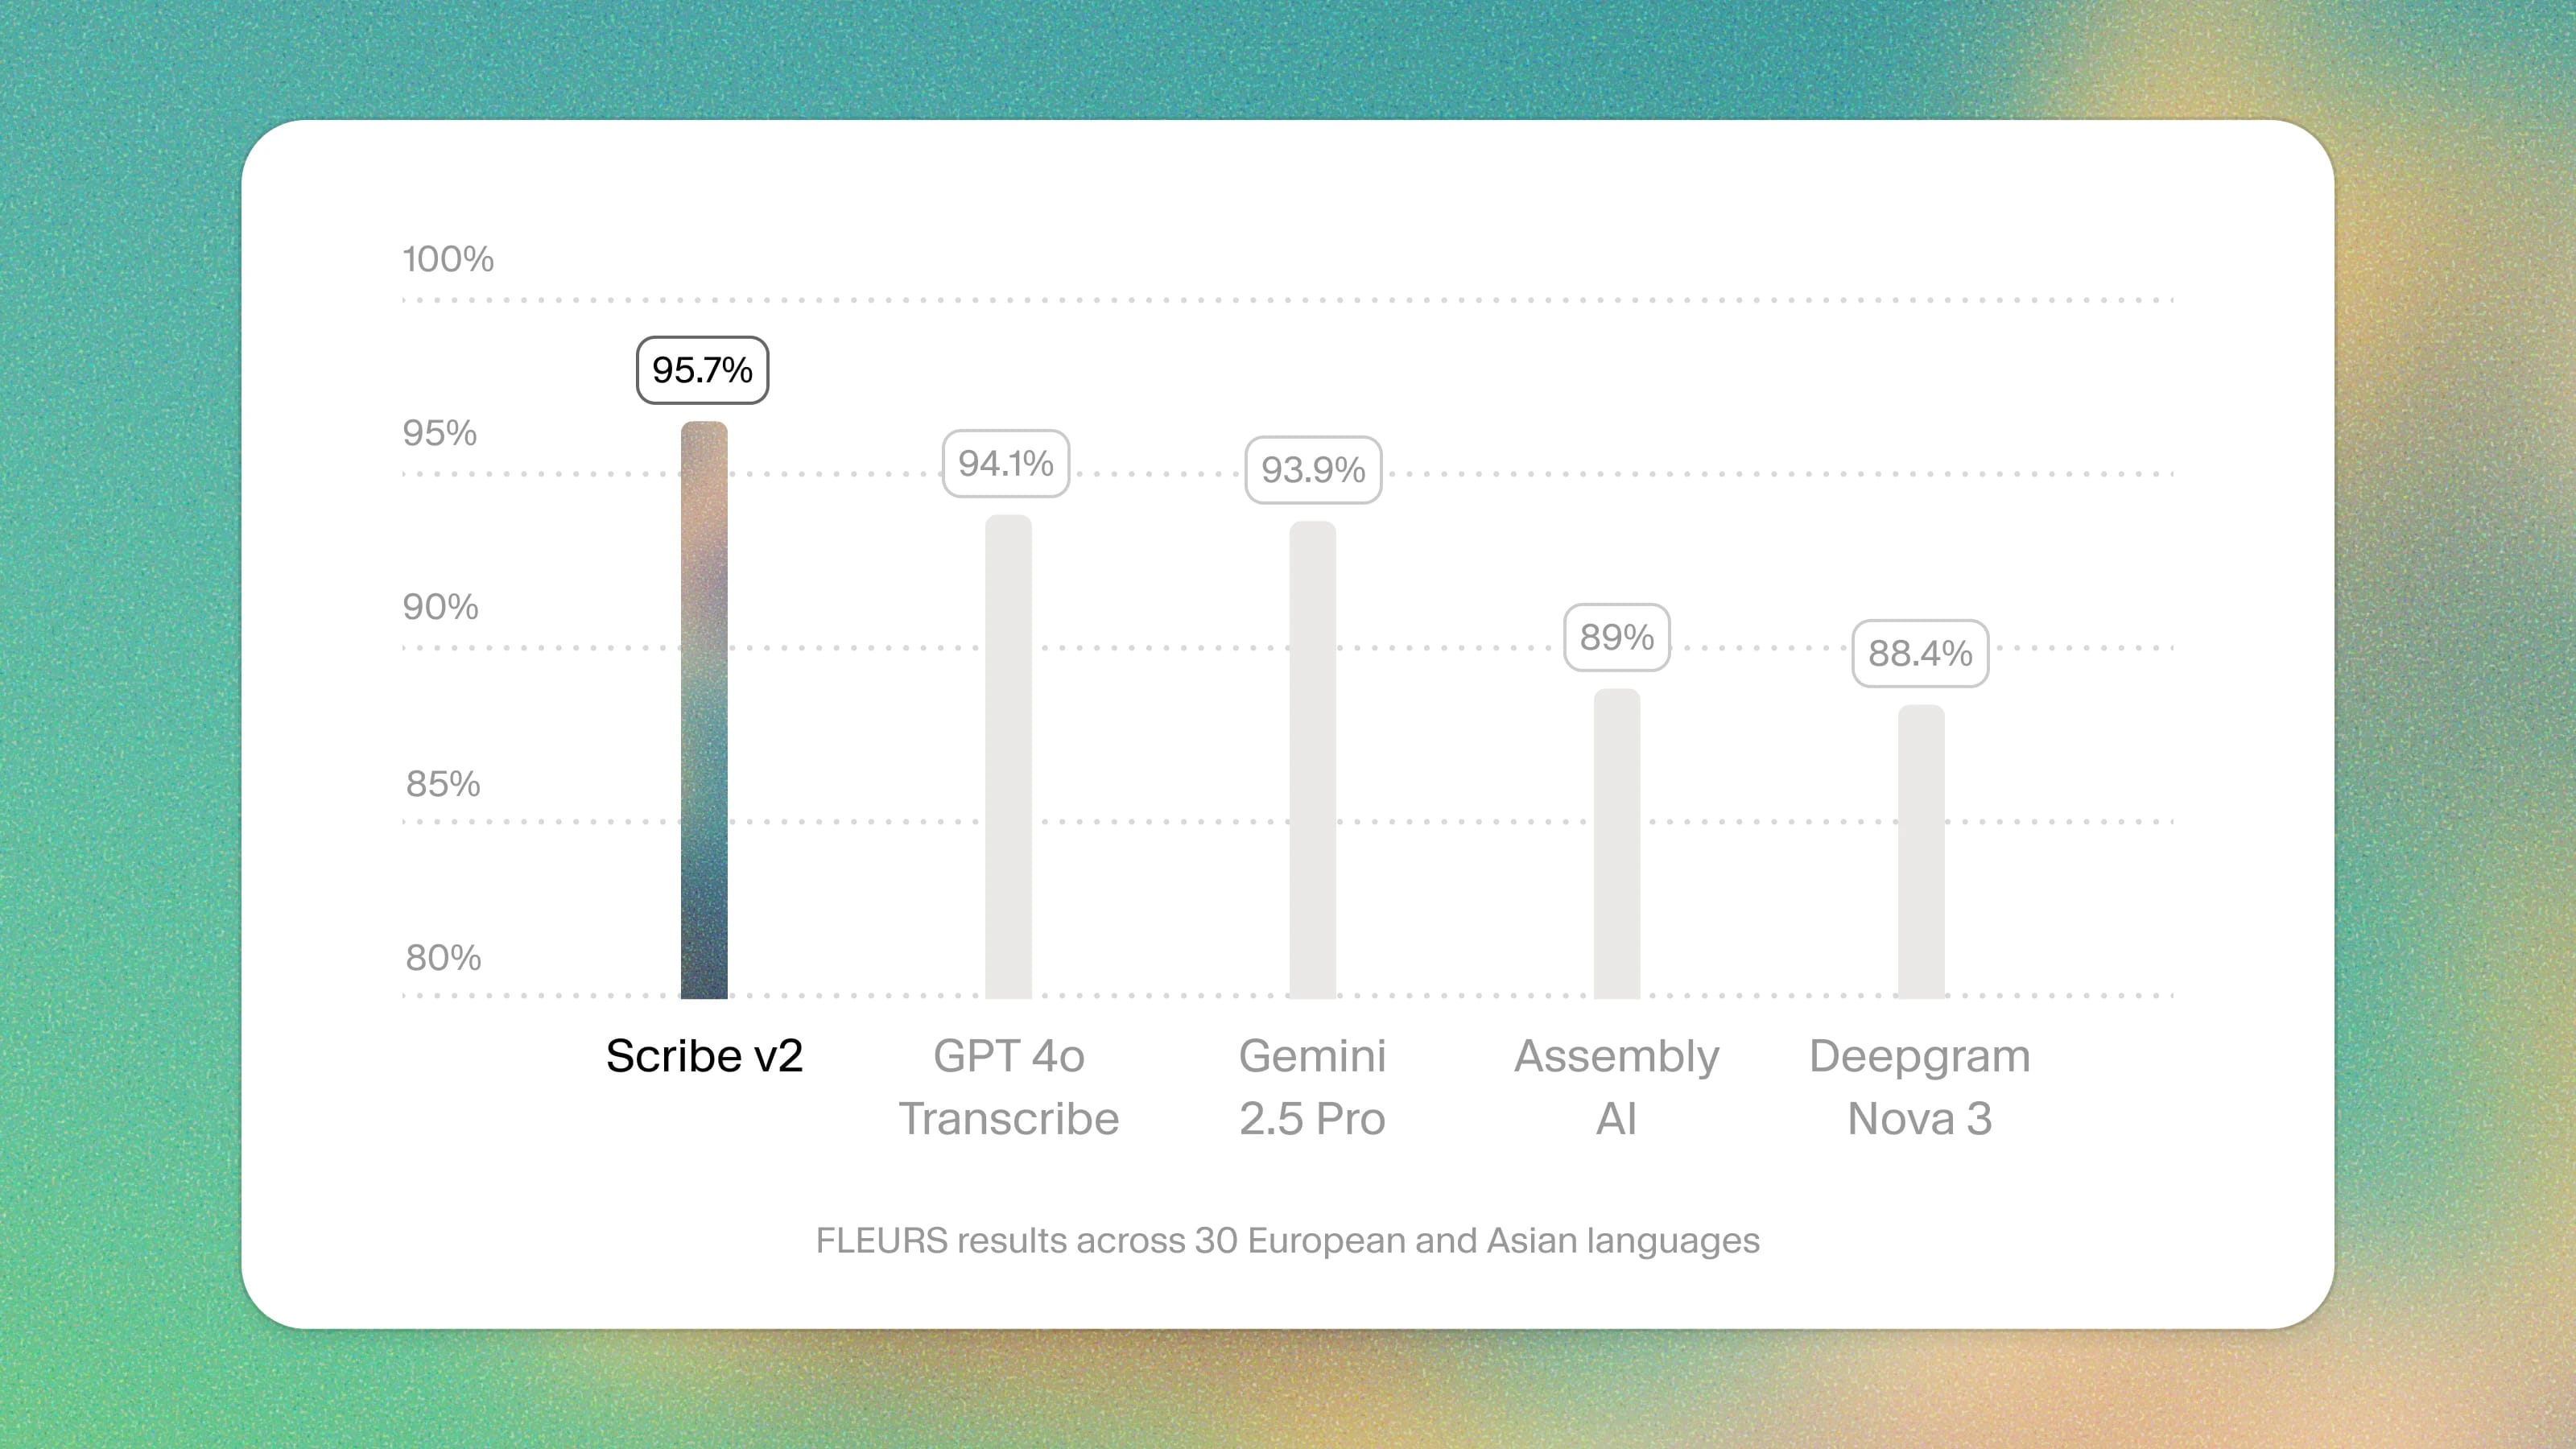
Scribe v2 在行业标准基准测试中取得了目前最低的词错误率。
基于上下文的关键词提示转录
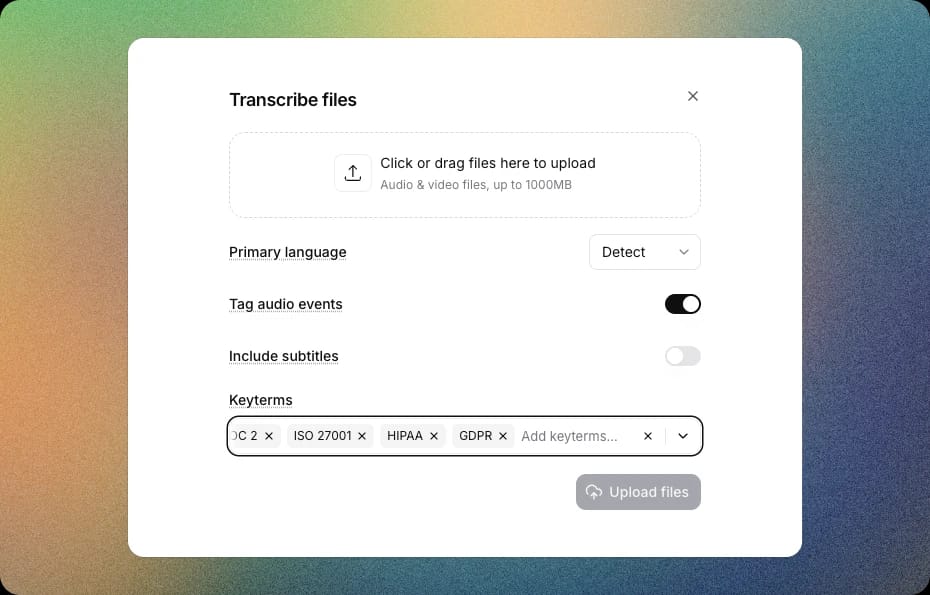
关键词提示会利用转录文本的上下文,超越标准自定义词汇的能力。最多可选择 100 个单词或短语,Scribe v2 会准确判断何时转录这些术语。特别适合技术领域、品牌名称和行业专用语言。
内置实体检测,提供精确时间戳
Scribe v2 内置原生实体检测功能,可用于结构化音频分析。
最多可从个人身份信息、健康数据和付款详情中选择 56 个类别。Scribe v2 会自动在转录文本中检测这些内容及其精确时间戳,便于大规模审核、脱敏或处理敏感信息。
在 API 文档中了解更多:https://elevenlabs.io/docs/developers/guides/cookbooks/speech-to-text/batch/entity-detection
自动多语言转录
Scribe v2 开箱即支持智能多语言 workflow。
可在单个文件中上传包含多种语言的音频。模型会自动识别每种语言并正确转录,无需手动分段或配置。
适用于生产 workflow 的更多功能
Scribe v2 提供一系列面向企业和开发者使用场景的功能:
- 智能说话人分离,提供清晰直观的说话人标签
- 精确到单词级别的时间戳,实现准确字幕对齐和交互体验
- 动态音频标签,可检测笑声、脚步声等非语音事件
- 具备企业级支持,包括符合 SOC 2、ISO 27001、PCI DSS L1、HIPAA 和 GDPR 标准,支持欧盟和印度数据驻留及零保留模式
Scribe v2 现已集成 ElevenLabs Studio
Scribe v2 现已用于 ElevenLabs Studio,提供更准确的字幕、说明文字和转录,支持团队管理营销、媒体、研究、培训和合规等场景中的大量音频和视频资料。
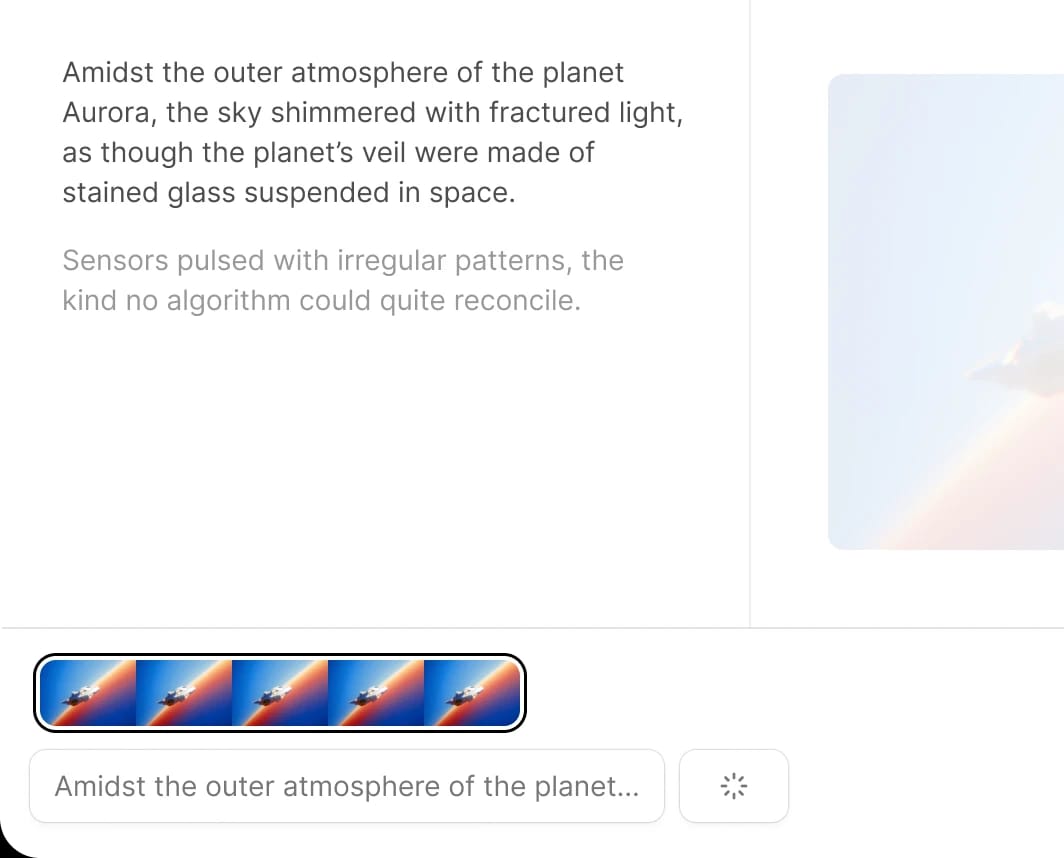
立即试用:https://elevenlabs.io/app/studio
使用 API 构建
借助 Scribe v2,开发者和企业可自动化复杂的音频处理流程,提高全球内容 workflow 的准确性,并通过完整的合规和数据驻留控制安全扩展。
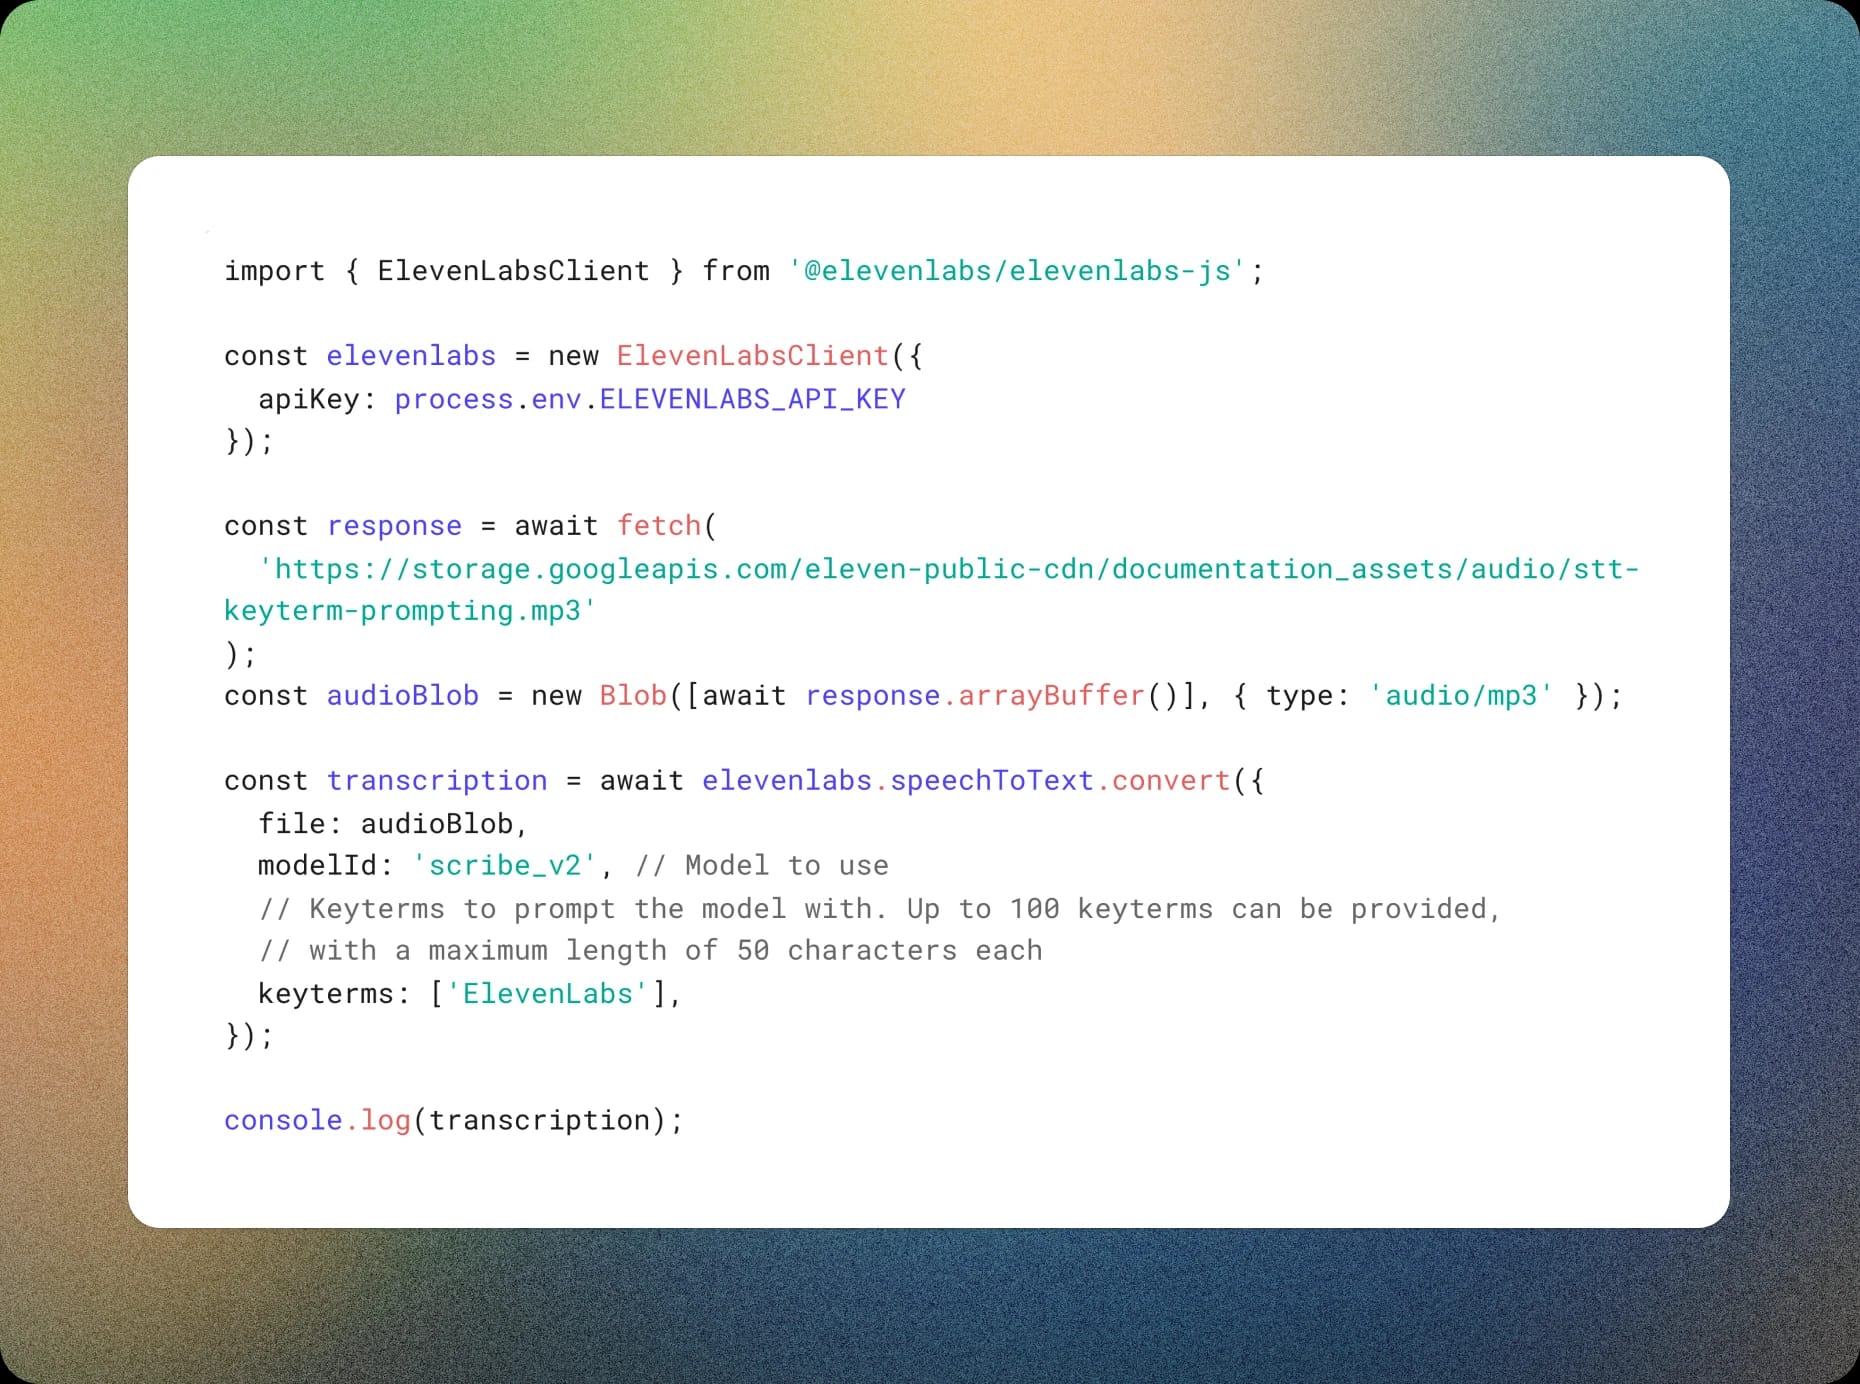
Scribe v2 现已通过我们的 API 和 Creative 平台提供。
立即试用:https://elevenlabs.io/app/speech-to-text