词错误率(WER):核心概念、公式及应用
- 发布时间
- 最近更新
理论上,词错误率(WER)是衡量自动语音识别(ASR)工具准确性的指标。WER 越低,最终转录越准确;错误率越高,则表示转录错误的信息越多。
实际应用中,WER 可能决定医疗转录软件会把患者处方写成需要“15 毫克”还是“50 毫克”。它也决定了客服工具能否准确转录客户需求,还是会让用户感到挫败。
本文将介绍 WER 是什么、如何计算,以及如何用它评估自己的 ASR 服务商。
摘要
- 词错误率统计替换、删除和插入这 3 类错误,再除以参考转录中的词数。
- WER 公式为 WER = (S + D + I) / N。
- WER 分数越低,最终输出越准确。
- WER 低于 5% 是不错的基准,但法律或医疗转录可能需要更低的词错误率。
- WER 将所有错误视为同等严重,因此并非衡量上下文可读性的完美指标。语义词错误率(SWER)等新指标尝试通过衡量话语含义是否保留来解决这一问题。
什么是词错误率?
词错误率(WER)是衡量文本转语音模型中语音识别准确性的标准指标。它以 0–1 表示 STT 系统转录出错的程度(0.8 代表 80% 的错误率),并根据替换、删除和插入进行计算。
替换指一个词被错误的词取代。删除指完全漏掉一个词。插入则是转录中出现了从未说出的词。WER 综合这 3 项,再除以正确转录的词数,得到可与其他供应商比较的数值。
WER 公式如下:
WER = (S + D + I) / N
其中:
- S:替换(词错误)
- D:删除(词缺失)
- I:插入(存在额外词)
- N:参考转录中的总词数
WER 可以用小数或百分比表示。WER 越低,说明模型转录时出错越少,得分越好。
实际中,10% 的 WER 意味着会议转录中大约每 10 个词就有 1 个需要复核。
为什么词错误率对语音识别系统很重要?
词错误率为团队比较不同服务商提供了客观指标。它能排除营销宣传的干扰,清晰展示语音识别模型的准确度。以证据为依据,正在评估方案的企业便能明确了解哪些模型目前处于领先地位。
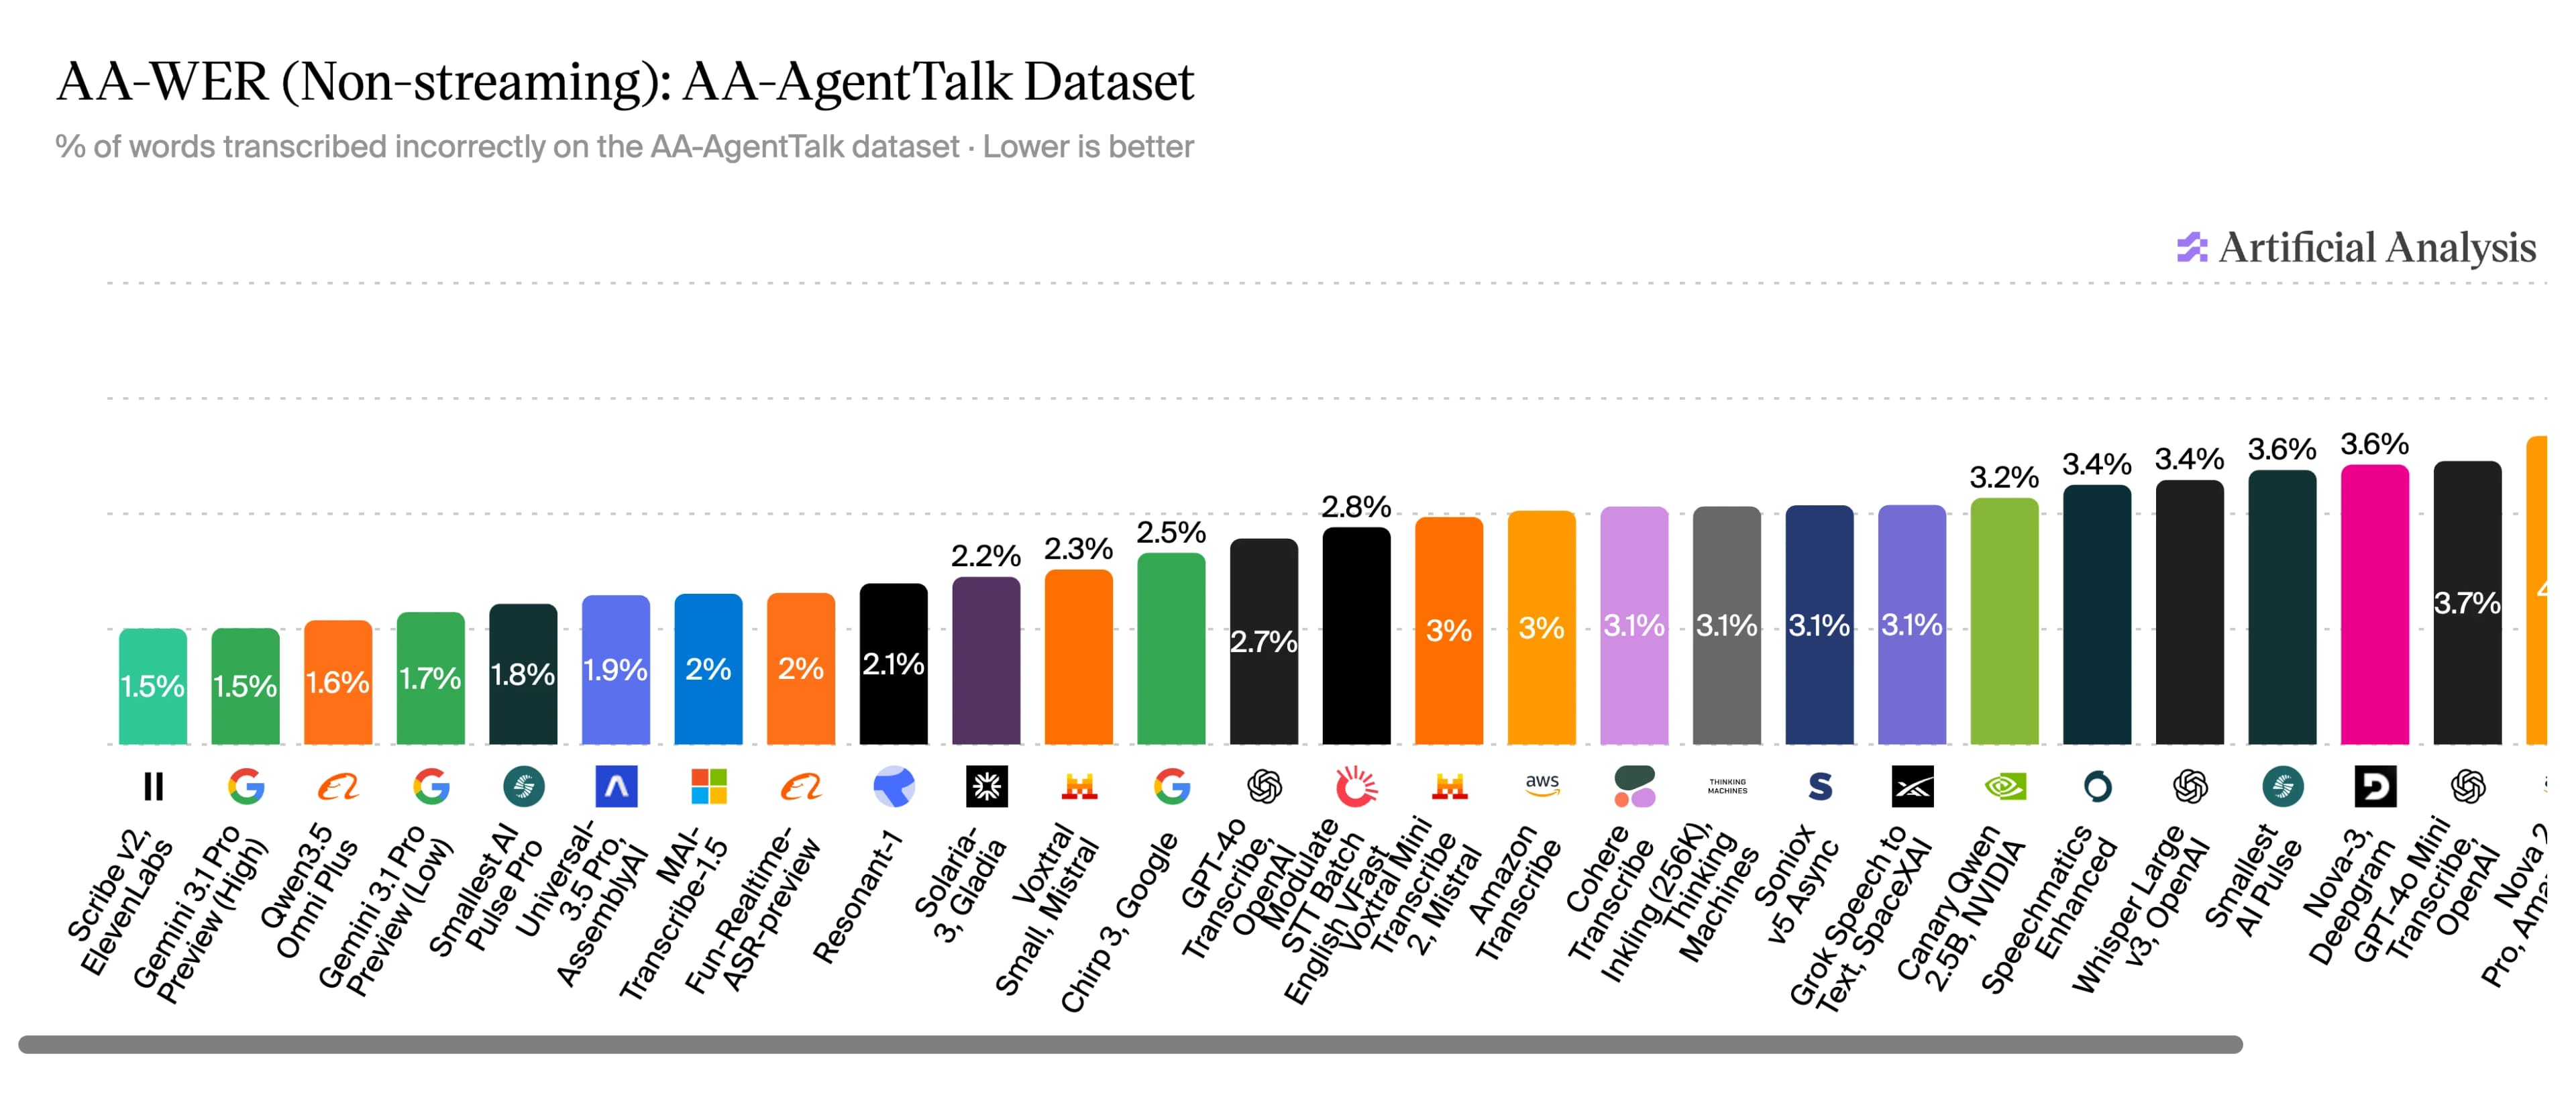
来源:Artificial Analysis,访问于 2026 年 7 月 10 日。
截至 2026 年 7 月,独立研究机构 Artificial Analysis将 ElevenLabs 的 Scribe v2 评为非流式转录模型中,在 AA-AgentTalk 数据集上 WER 最低的行业产品,得分为 1.5%。
除了评估服务商,WER 还会在产品层面带来实际影响。WER 为 12% 的医疗转录软件可能在患者病历中引入关键错误。客户支持通话中的转录错误,可能导致后续故障,例如情感分析不准确或分类不佳。
除这些特定用例问题外,ASR 系统失效时,受影响最大的人往往是只能通过转录内容获取语音信息的人。万维网联盟提供了丰富文档,进一步说明无障碍倡议所要求的最低标准。
如何计算词错误率:公式与示例
了解步骤后,计算词错误率并不复杂。如前所述,公式为 WER = (S + D + I) / N。上文已解释所有术语,简而言之,分别是替换、删除、插入,以及代表转录总词数的 N。
计算 WER 的方法如下:
- 创建参考转录:使用人工转录和验证,生成准确的音频片段转录。
- 使用 STT 工具:使用 ASR 平台转录音频片段,生成用于测试的 AI 转录。
- 对齐两个版本:使用动态规划(具体来说是 Levenshtein 算法)找出最少编辑次数。后文会进一步介绍该算法。
- 应用公式:统计 AI 生成版本相对于人工验证版本的总错误数,再用 WER = (S + D + I) / N 算出准确的 WER。
看起来技术性较强,但实际操作简单得多。下面通过一个示例说明。
参考转录:Dalloway 太太说她会亲自买花。
ASR 输出:Dalloway 小姐说她会亲自买花。
计算总错误数,可得 9 个词中有 1 个 S 和 1 个 D。
套用公式:WER = 2 / 9 = 0.222 = 22.2%。
使用 Python 计算词错误率
手动方法虽有效,但也可以用 Python 计算 WER 来节省时间。jiwer 库可以完全自动处理这些步骤。
根据 jiwer 文档,可以安装这个专为评估 ASR 系统并生成 WER 等核心指标而构建的软件包。下载后,可用以下代码快速通过 Python 计算 WER:
注意,此示例中 ASR 输出与原始参考文本有两处不同。“jumps”被错误转录为“leaps”(替换),并且在“lazy”前插入了“last”(插入)。参考转录共 9 个词,出现 2 个错误,因此词错误率(WER)为 0.222,即 22.2%。
比较词错误率与其他识别指标
WER 是计算 ASR 准确性的标准指标,但也可以使用其他工具。例如:
- 字符错误率(CER):与 WER 类似,它衡量字符层面而非词语层面的转录准确性。最适合没有明确词边界的语言(连续书写)或对拼写敏感的任务。
- 匹配错误率(MER):衡量转录错误比例,但对替换、插入和删除的处理方式与 WER 略有不同。它关注句子中错误所占的比例。
- 词信息丢失率(WIL):估算转录过程中丢失的原始信息量,衡量的是可理解性,而非 WER 的直接错误计数。
- 嵌入错误率(EmbER):对不同转录进行语义分析。它超越 WER,可深入了解正确词与错误转录之间的语义距离。
每项指标都适用于不同场景。可参考下表:
Levenshtein 距离示例:WER 背后的数学原理
词错误率本质上衡量原始文本与假设输出之间的距离。要从数学角度理解这一差异,可以使用 Levenshtein 距离。
Levenshtein 距离计算将一个序列转换为另一个序列所需的最少单元编辑次数。对 WER 而言,具体就是替换、插入和删除操作。例如,若要将 Cat 转换为 Mat,需要将字母“C”改为“M”,因此 Levenshtein 距离为 1。
这在 CER 计算中更常见,但 WER 将 Levenshtein 距离扩展到词语层面。每个单元是完整的词而非字符,实际距离衡量的是将 ASR 输出转换为准确原文所需的词语编辑次数。
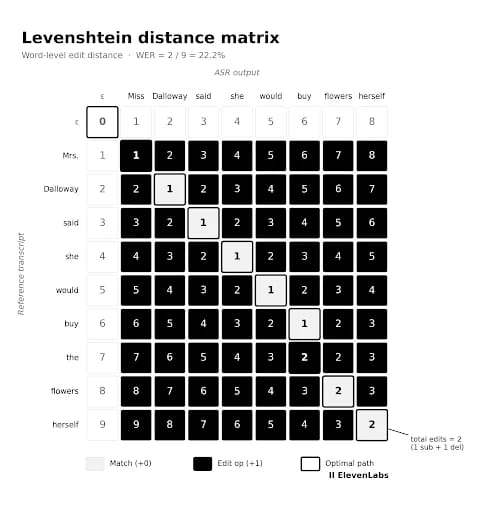
我们构建一个矩阵,其中每个单元格表示原始转录与 ASR 转录之间的总距离。Levenshtein 距离从左上角填充到右下角,最后一个单元格给出词语层面的总编辑次数。将该数值除以 N 即为 WER。
该矩阵通常按单个字符计算,为简单起见,下面展示前述示例的扩展版本。
词错误率的常见误区与陷阱
随着STT API日益普及,ASR 软件也逐渐成为更广泛智能体技术栈的常见组成部分,我们将看到更多不同工具之间的比较。
在计算自己的词错误率前,需要了解几个常见问题和误解。
- 所有错误都同等重要:WER 将每个错误视为同等严重。在许多场景中这或许没问题,但某些用例无法接受。例如在医院,5% 的错误率虽可算是不错的 WER,却仍可能令人无法理解,因为哪怕一两个错误都可能让患者面临风险。这一局限促成了语义词错误率(SWER)等新指标的发展,它尝试衡量句子含义是否保留,而非每个词是否完全匹配。
- WER 可以超过 100%:虽然前面说过 WER 在 0 到 1 之间,但它也可能超过 100%。这是因为插入错误可能使词数超过原始转录总词数。常见例子是将“I’m”转录为“I am”,一个词变成两个词。
- 从技术上说,WER 越低不一定越好:从表面看,5% 的 WER 优于 10%。但如果造成 5% 的错误显著改变了句子上下文,而 10% 中的错误没有,那么这个指标就无法呈现全貌。上下文依然非常重要,因此开发 SWER 等指标正是为了捕捉这种语义影响。
2024 年,Apple 发表了一项有趣的研究,探讨了上述最后一点。当人们根据 ASR 是否可读来评估 9.4% 的 WER 时,他们给同一段文本评出了仅 2.2% 的 WER。在测试示例中,人们在很多情况下认为这些“错误”并不重要,因此人类 WER 比机器 WER 宽容超过 4 倍。
WER 的行业基准
理想 WER 很大程度取决于使用 ASR 技术的行业或用例。尽管低于 5% 是 WER 的行业基准,但医疗或法律转录等特定行业需要低得多的错误率。
在Artificial Analysis于 2026 年 7 月开展的研究中,ElevenLabs 的 Scribe v2 取得了 1.5% 的 WER。不过,需要注意的是,这类统计通常以英语为主要语言开展,其他语言的 STT 技术可能没这么有效。
ElevenLabs 文档详细介绍了通用 WER 分级,涵盖 Scribe v1 和 Scribe v2 支持的所有语言。
使用 ElevenAPI 提升识别准确性
构建重视转录质量的应用或产品时,精心选择的 ASR API 与普通 API 之间的差距,首先会体现在 WER 上,随后体现在用户体验中。
ElevenLabs Scribe 是可通过文本转语音层访问的ElevenAPI。除了支持 90+ 种语言和行业领先的 WER,还提供说话人分离、词级时间戳、关键词提示和实体检测等功能。
查看ElevenLabs 文档,了解更多 ElevenAPI 信息,或立即注册开始使用。