什么是自动语音识别(ASR)?
- 发布时间
- 最近更新
1952 年,世界上最先进的语音识别系统只能准确理解 9 个词。
约 75 年后,自动语音识别(ASR)已能实时转写数十种语言,支持从手机语音助手到直播视频自动字幕等各种应用。
本指南将介绍连接 1952 年技术与现代技术的关键发展,包括 ASR 是什么、如何将语音转为文本,以及它至今仍在如何演进。
摘要:
- ASR 指自动语音识别,即将语音音频转换为书面文本的技术。
- 最早的 ASR 出现在 1952 年,深度学习系统在 2010 年代末达到人类基准水平。
- 现代 ASR 使用基于数百万小时音频训练的端到端神经网络。
- 词错误率(WER)是标准准确率指标,但在生产级 ASR 中,延迟、说话人分离质量和上下文理解同样重要。
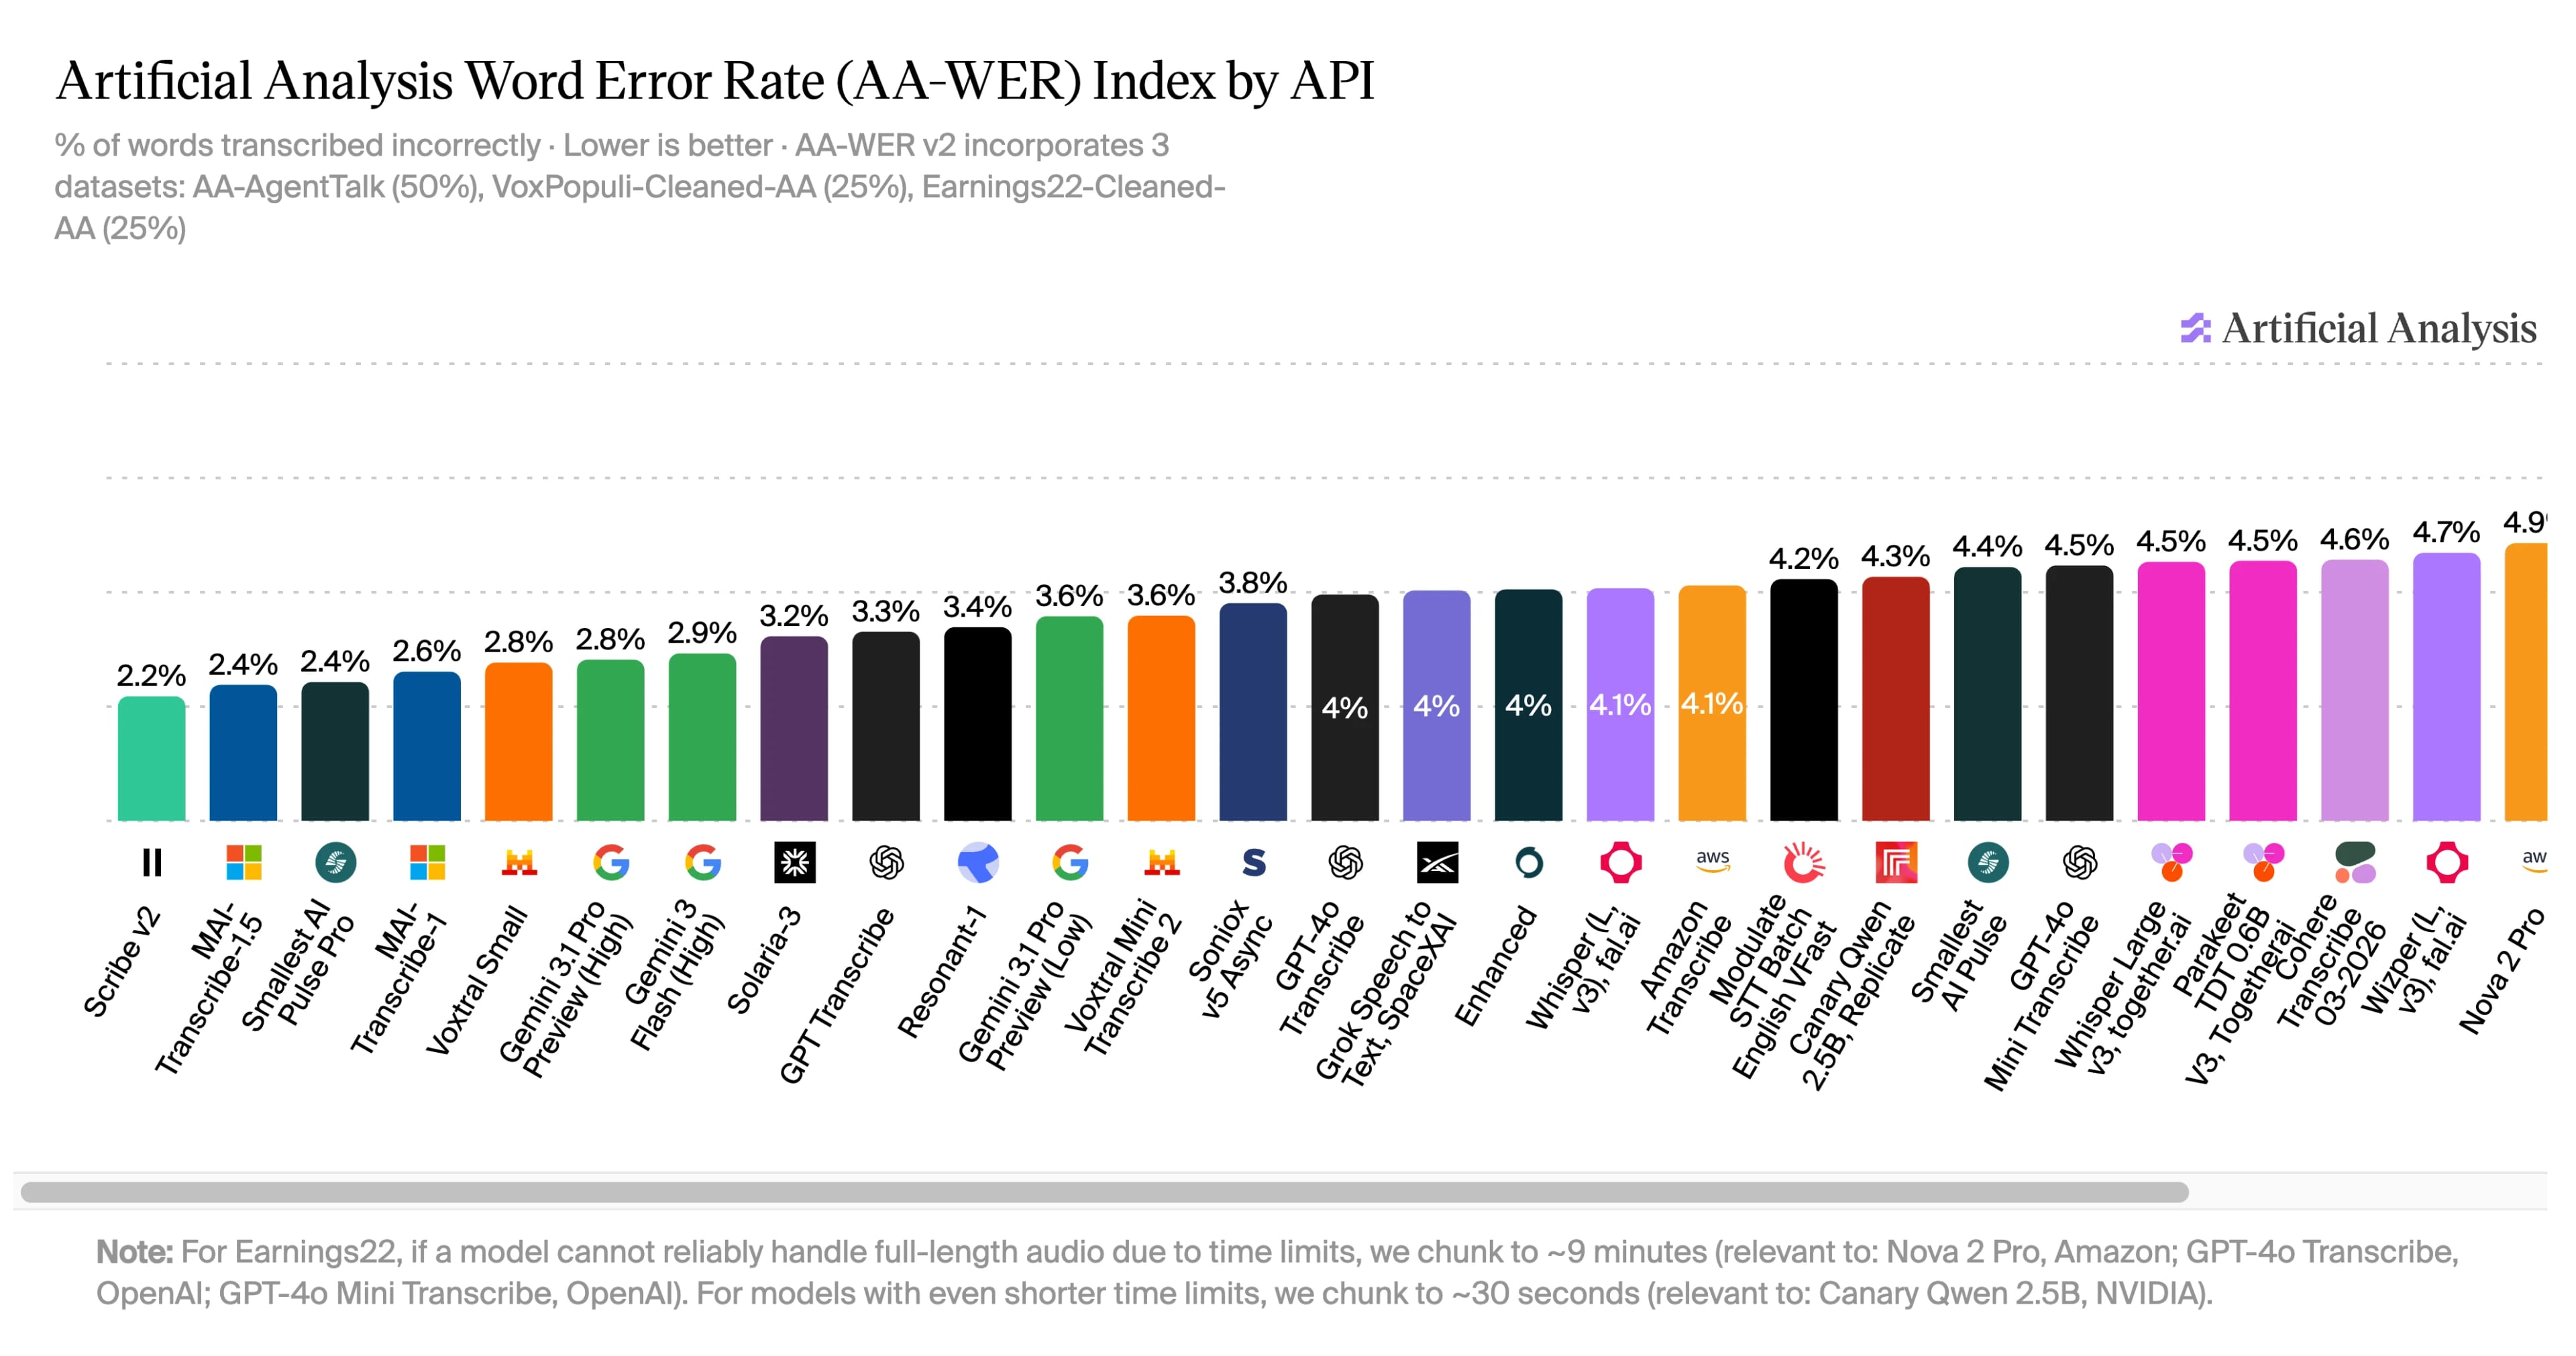
- ElevenAPI 为开发者提供生产级 ASR,经Artificial Analysis独立评测,词错误率为 2.2%,在其指数中最低(2026 年 7 月)。
什么是自动语音识别(ASR)?
自动语音识别通常简称为 ASR,是指能够监听人类语音并将其转换为准确、机器可读文本的软件。它也常被称为文本转语音和语音识别,有时也称为计算机语音识别。
ASR 已无处不在,你每天都可能在不知不觉中使用它。无论是口述消息、向语音助手提问、观看直播时阅读字幕,还是通过交互式语音应答电话系统导航,都在使用 ASR。
文本转语音与 ASR 常被视为同义词(且密切相关),但两者并不完全相同。ASR 是识别说话内容的技术,STT 则是将该技术作为工具的实际应用。语音识别软件建立在 ASR 之上,用于识别某个词是谁说的,这是说话人分离功能的基础。
这些区别虽小,但如果你想将 ASR/STT/语音识别系统集成到应用或网站中,仍值得了解。
自动语音识别技术简史
自动语音识别技术的历史远比大多数人想象得久远,最早可追溯至 20 世纪 50 年代。自诞生以来的 70 多年间,ASR 经历了多个重要阶段,奠定了其持续进步的基础。
ASR 技术主要经历了以下几个时代:
- 1952 年与首个 ASR:1952 年,贝尔实验室研发了名为AUDREY的自动数字识别器,用于识别从 1 到 9 的数字。该工具准确率仅约 90%,且只能由其发明者使用,局限性极大。尽管与如今的现代能力相去甚远,但仅能识别 1 至 9 在当时已是令人瞩目的成就。
- 20 世纪 60 至 70 年代与不断扩大的 ASR 词汇量:随后几十年间,IBM、伦敦大学学院及日本 NEC 等全球实验室都在不同场景中开发出类似 AUDREY 的模型。斯坦福大学来自印度的研究生 Raj Reddy 为博士项目构建了元音识别器,为连续语音识别奠定基础,无需在每个词之间停顿。DARPA(美国国防高级研究计划局)在这一时期资助的研究催生了 Beam Search,这种句子构建和解码方法对识别词汇量的发展至关重要,到 1976 年已可识别超过 1,000 个词。
- 20 世纪 80 年代至 2010 年代初的统计学进展:1987 年,Raj Reddy 的一名学生(当时已任教授)将隐马尔可夫模型与 Beam Search 结合,使 ASR 无需针对单一说话人训练。这一突破大幅缩短了语音识别系统的训练时间。Dragon Systems 在 1997 年发布首个商业化 ASR 产品 NaturallySpeaking Preferred。它每分钟可识别 100 个词,销售表现良好。
- 现代时代与深度学习:2010 年代,研究人员证明,在音频和转录文本上端到端训练的单个神经网络,优于纯统计流水线。随着深度神经网络出现,ASR 的错误率可降至 5% 至 10%,达到接近人类的水平。Alexa、Siri 等语音助手也在这一时期进入市场。
自此,ASR 的准确率和普及度持续提升。截至 2026 年 7 月,Artificial Analysis 的独立研究认定 ElevenLabs Scribe v2 的词错误率(WER)仅为 2.2%,处于行业领先水平。
ASR 如何工作?文本转语音技术基础
ASR 首先采集音频样本,将其转换为数值表示,再利用训练好的模型预测这些数值最可能对应的词序列。现代 ASR 能在实时场景中完成这一流程,端到端处理时间不足 1 秒。
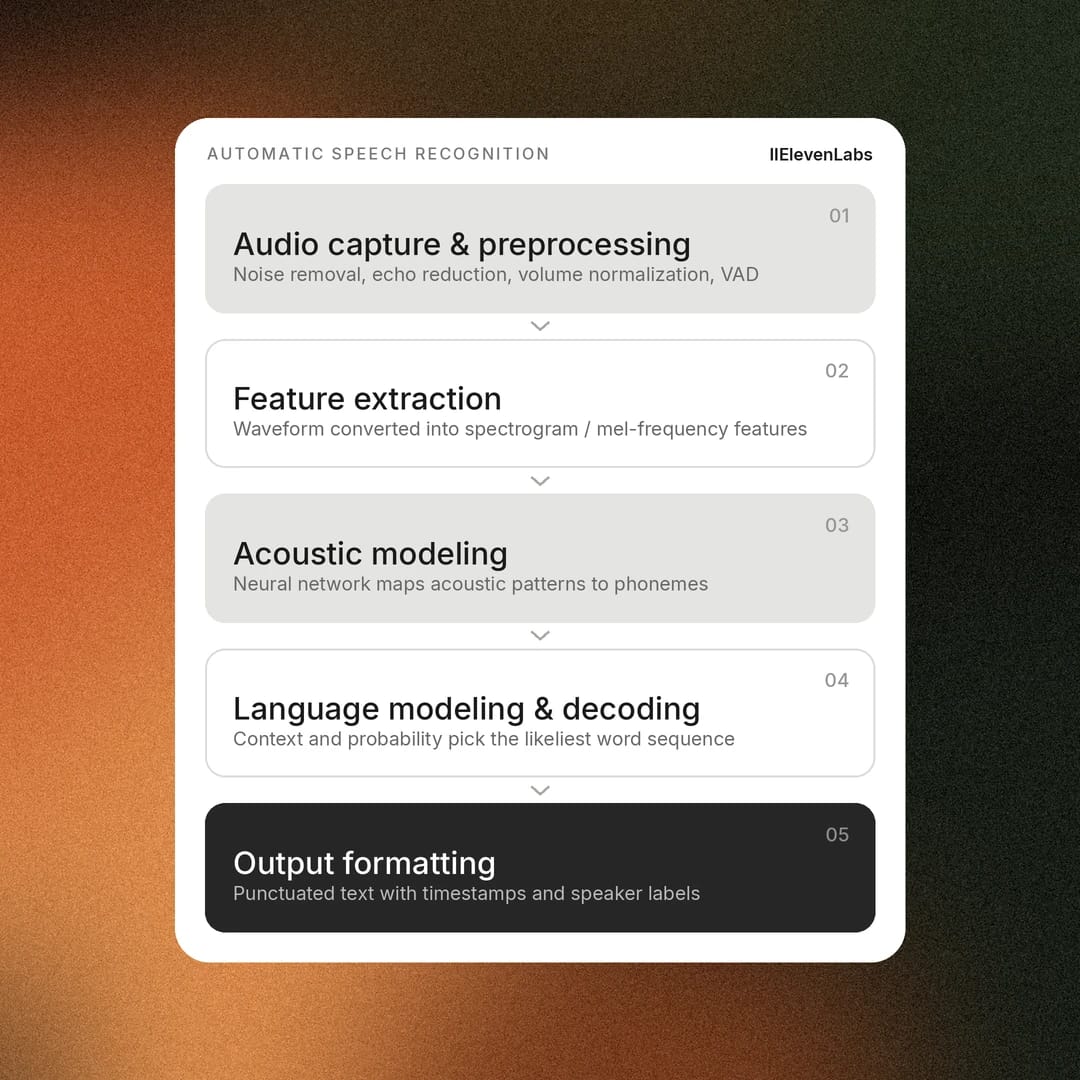
ASR 流水线主要包含 5 个阶段:
- 音频采集与预处理:系统录制音频信号、消除背景噪声、降低回声,并标准化音量以提升一致性。具体取决于模型,转录开始前还可能使用语音活动检测(VAD)来区分语音、静音和背景声。
- 特征提取:音频会转换为数值表示,通常是频谱图或梅尔频率特征,可精准呈现人类语音中的频率和模式。该步骤本质上是将原始波形转换为机器学习模型能高效处理的数据。
- 声学建模:神经网络分析上一步的特征,预测音素或其他语音单元,并学习声学模式与口语之间的关系。现代端到端模型通常将这一步与语言理解联合执行,而非作为完全独立的阶段。
- 语言建模与解码:系统根据语法、上下文和数学概率等规则,判断最可能的词序列。后两者尤为关键:两句话的 IPA(国际音标)转写可能相近,但上下文却截然不同。例如,“Recognize Speech”和“Wreck a nice peach”听起来可能相同,含义却完全不同。若仅凭精度无法确定,上下文将帮助系统做出正确判断。
- 输出格式化:确定语音内容后,系统会输出带有标点和大小写的最终转录文本。词级时间戳、说话人标签等额外元数据可生成更详细的转录稿。
通过这些主要阶段,模型将输入的音频数据转换为书面转录稿。
传统混合系统与端到端深度学习 ASR
上述流水线说明了 ASR 的工作方式,但其中的中间环节实际上可采用两种技术路线。
传统系统会串联多个组件:编码词语发音方式的词典模型、将音频映射为音素的声学模型,以及预测可能词序列的语言模型。每个组件都需要人工专业知识构建,从手工编写发音词典的语言学家,到将每个词与其音频精确位置对齐的标注人员。
端到端深度学习将所有这些组件整合为一个神经网络。该网络直接将音频映射为文本,并从数百万小时的配对音频和转录文本中隐式理解发音、声学和语言概率统计。
下面来看看传统与现代 ASR 技术方法之间的差异。
如何衡量 ASR 准确率:词错误率(WER)基准
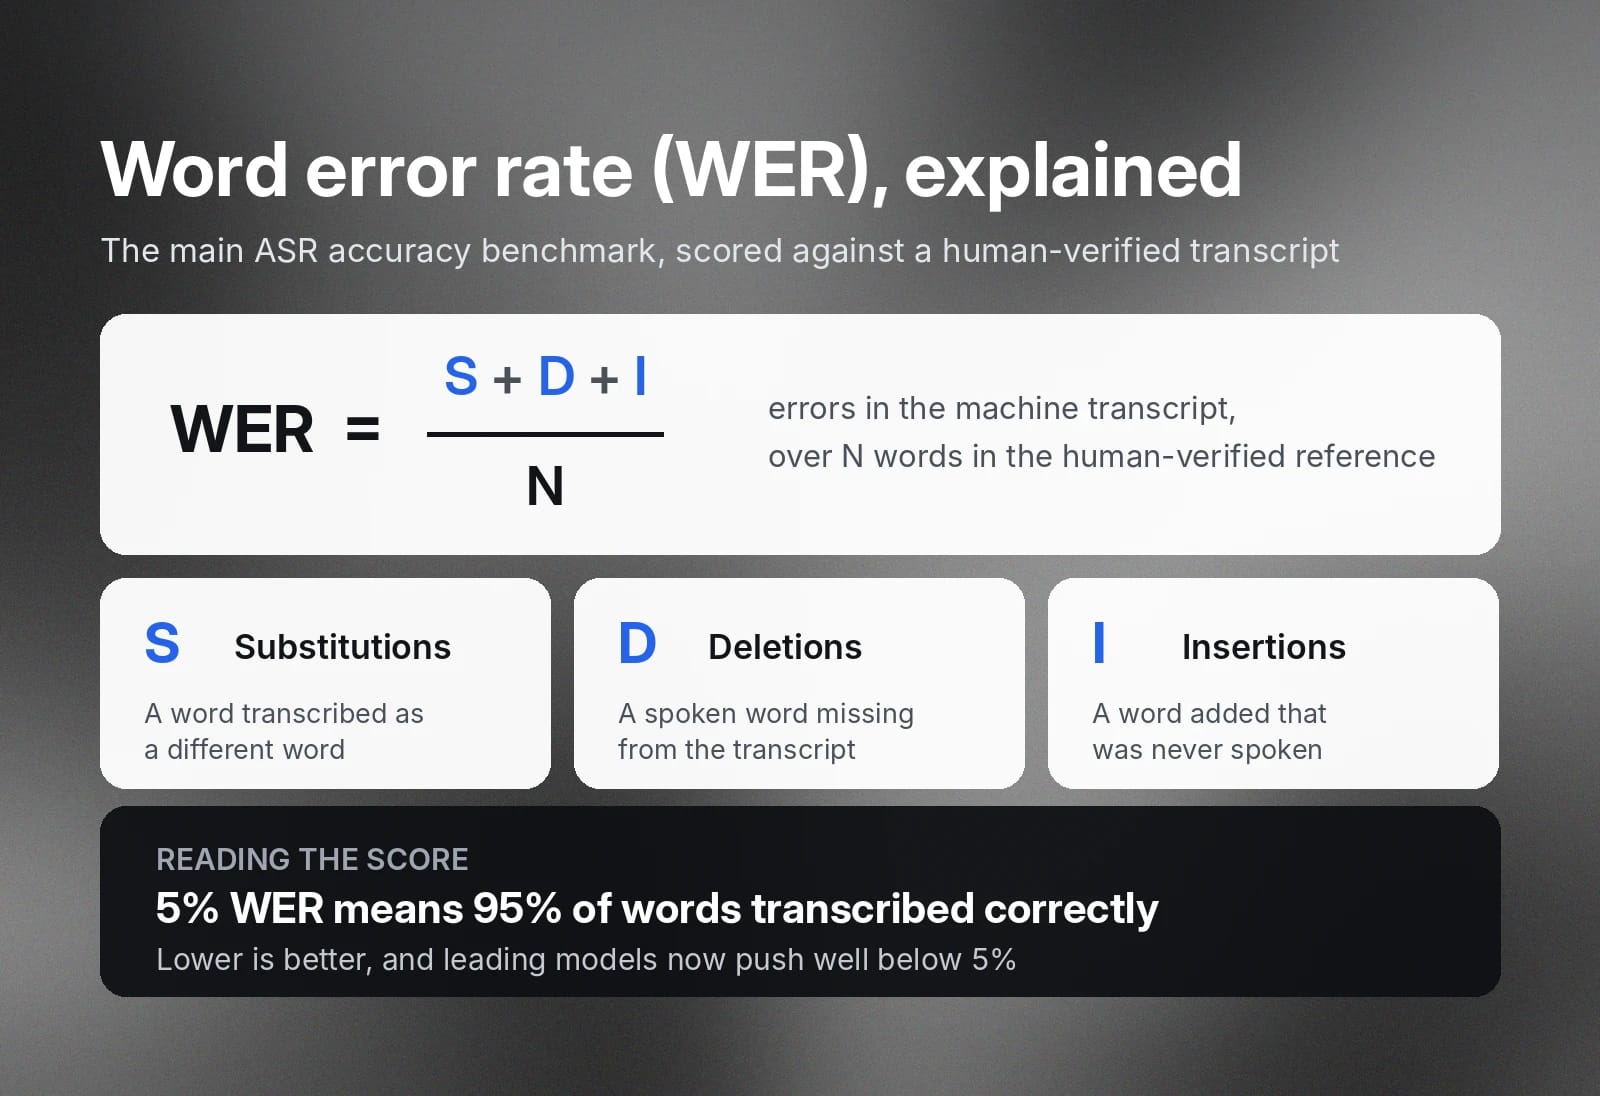
在所有文本转语音和 ASR workflow 中,词错误率(WER)是企业使用的主要准确率指标。它将 ASR 生成的机器转录稿与人工验证版本进行比较,主要统计替换、删除和插入 3 类错误。
WER 的计算公式是用错误总数除以参考转录稿中的词数。WER 为 5% 表示系统可准确转录 95% 的文本;如今多数领先模型正将这一数值降至远低于 5%,不断接近完美。
WER 是实用的基准,但评估 ASR 工具效果时还应考虑其他因素:
- 格式准确率:系统能否正确格式化非标准字符串?例如,$1,225 这样的金额会原样显示,还是拼写为“1,225 美元”?
- 延迟:准确率固然重要,但若生成一份简单转录稿需要几分钟,工具就无法使用。即便准确率极高,也需要兼顾低延迟,才能提升实用性。
- 鲁棒性:即使 在浓重口音或嘈杂背景等使用场景中,模型准确率也不应显著下降。
- 说话人分离质量:多说话人场景依赖于将每个词正确归属给相应说话人。识别不同说话人并准确标记,有助于提升 ASR 效果,尤其适用于法律庭审等多说话人密集的行业。
了解更多,请阅读我们的词错误率完整指南。
ASR 为现代企业带来的主要优势
预计到 2030 年,全球语音和声音识别市场规模将超过231.1 亿美元。市场 19.1% 的复合年增长率反映出该技术在商业设备中的广泛普及。每部现代手机都配备听写键盘和语音助手,多数新车都能响应语音指令,智能音箱和助手也已进入世界各地的家庭。
通过语音与技术互动,如今已成为客户的默认选择。对企业而言,ASR 可用于客户通话转录、语音智能体辅助等场景,并能融入业务流程、提升生产力。
以下是 ASR 为现代企业带来的几项主要优势:
- 更快输入与记录:早在 10 多年前,斯坦福大学发表的一篇论文就证明,语音识别技术比键盘输入快近 3 倍,同时错误率更低。对绝大多数人而言,ASR 可加快转录 workflow 中的文档记录和语音优先笔记记录。
- 降低运营成本:在许多过去需要数小时人工记录的场景中,ASR 技术可大幅降低高质量转录的成本。如今,法庭案件、呼叫中心、医疗诊所和商务会议都可借助准确的 ASR 系统,生成详细笔记和完整的说话人分离对话转录稿。
- 提升无障碍体验:世界卫生组织预测,到 2050 年,25 亿人将患有某种形式的听力损失。先进 ASR 工具提供的实时字幕可让数字会议和媒体更易于用户访问。
- 可搜索的语音数据:使用 ASR 自动转录语音后,每一次客户与企业的互动都会被完整记录。每通销售电话、支持工单、潜在客户通话或会议都会变为可搜索、可审计的文本。尤其在 AI 时代,以机器可读格式呈现上下文有助于构建广泛的知识库。无论出于功能需求还是合规要求,这都有助于让信息保持可见。
- 全天候客户体验:ASR 是语音智能体的基础技术之一,可支持自动化服务场景,解决客户来电,全年 24/7 不间断服务。
自动语音识别之所以在技术领域如此普及,源于其带来的诸多优势及广泛适用的场景。无论你从事医疗行业,还是希望转录客户通话以进行情感分析,ASR 都是一项会融入并使用的基础技术。
ASR 在各行业的常见应用
自动语音识别是无数 workflow 和产品的核心技术。它已普及到用户往往不会留意自己所用技术中嵌入了它的程度。
以下简要介绍 ASR 在全球的一些常见使用场景。
客户服务与呼叫中心
呼叫中心是较早采用 ASR 的领域之一,利用它转录通话以进行质量保证和合规管理。如今,ASR 可实时运行,在对话中向客服人员提供建议,并将数千次客户互动转化为团队可分析的数据。
媒体与娱乐
广播机构和流媒体平台可利用 ASR 生成对话字幕,其规模远超人工转录人员的能力。它支持实时转录,同时让视频和音频资料库完全可搜索。
医疗保健
临床人员每天有相当多的时间花在文档记录和病历填写上。ASR 可帮助节省这些时间,为医生提供可实时口述笔记的医疗 STT平台。
虚拟会议
会议平台通常提供某种形式的数字笔记功能,可在对话进行时完成转录,让每个人都无需在参与讨论和记录笔记之间取舍。Google Meet 等服务甚至会在每次会议后发送标注行动项的转录稿,帮助创建可搜索的信息索引。
法律与合规
在法律场景中,准确记录说了什么以及谁说的是法庭的核心要求。律师事务所会使用 ASR 平台转录会议、听证会、客户通话和庭审,并提供精确时间戳以供日后查阅。
教育
大学教授可提供讲座录音的转录稿,帮助学生建立所修课程的记录。在理解和记忆信息时,学生可借助这类全面资源开始学习。
ASR 在语音智能体流水线中的位置
ASR 是多种技术部署的标准组成部分。在语音智能体技术中,它是持续循环的 3 个主要阶段中的第一个。
- 听(ASR):智能体采集传入的音频流并实时将语音转为文本。现代 ASR 会在音频到达时持续处理,过滤背景噪声、处理打断、生成部分转录稿,并识别每个人何时发言。
- 思考(语言模型):大语言模型解读转录稿,理解用户意图,从连接的工具和知识库中检索信息,维护对话上下文,并确定最合适的回复或操作。
- 说(文本转语音):一个文本转语音模型将生成的 LLM 回复转换为自然、富有表现力的音频。现代 TTS 系统可在生成音频并将其流式传回给来电者时,调整语速、语调、情绪和重音,无需等待完整回复生成。
对话延迟会在每个阶段累积。为降低延迟,流式 ASR 会在词语说出后立即开始输出,而非等到一句话结束。ElevenAgents将此作为实时语音智能体的标准,帮助打造高效的智能体体验。
ASR 的挑战与技术演进
尽管 ASR 技术自 1952 年诞生以来已取得长足进步,仍有多种挑战可能降低其准确率。
以下是 ASR 工具如今仍会遇到的一些问题:
- 口音与方言:现有训练数据通常集中于少数语言和口音,因此较少见的口音或使用人数较少的语言,对 ASR 工具而言更具挑战。丰富且多样的训练数据集是解决之道。
- 背景噪声与说话人重叠:音量变化大或背景噪声较强的环境,会使录音中的单个词更难识别。说话人重叠也可能造成类似影响,降低 ASR 转录准确率。
- 领域专用词汇:包含特定术语或缩略词的领域,需要领域级词典和参考资料来提升准确率。医疗和法律是 ASR 工具需获得额外支持或接受专项训练的两个领域。
- 隐私与安全:在许多司法辖区,语音数据属于个人数据。企业需要制定明确的保留政策和防护措施,以保护语音数据处理过程,并确保遵守更广泛的法规。
使用 ASR 技术时,还需更全面地考虑延迟与准确率之间的关系。部分场景需要平衡两者,而医疗等领域通常会将准确率置于首位。
使用 ElevenAPI 开始生产级 ASR 集成
ElevenAPI通过 ElevenLabs 文本转语音模型 Scribe v2,为产品提供生产级自动语音识别。Scribe v2 提供词级时间戳、说话人分离、音频事件标记,以及实时应用所需的准确率和可靠性。
浏览ElevenLabs 文本转语音页面了解更多,或创建免费账户,几分钟内即可启动 API。