
什么是对话式 AI 延迟,哪些因素会影响它?
- 发布时间
- 最近更新
对于 对话式 AI,延迟是区分优秀应用与卓越应用的关键。
对话式 AI 的本质是追求更高的交互体验,旨在复现与人交谈的感受,并模拟相同的 情感范围、音高和节奏。再加上从你停止说话到 AI 智能体开始回应之间“自然”的停顿时间,就得到了基于人类实际沟通方式的延迟目标。
想要大规模部署 对话式 AI 智能体的企业,若想实现这种自然体验,就需要尽可能降低延迟。本文将介绍什么是对话式 AI 延迟、整个流程中造成延迟的原因,以及降低延迟的总体方法。
摘要
- 对话式 AI 延迟是指从用户停止说话到听到智能体第一个词之间的端到端总延迟。
- 延迟超过 700 ms 的智能体可能显得不自然;超过 1,200 ms 时,用户放弃率较高。
- 延迟会在对话式 AI 流程的每个阶段累积。
- ElevenAgents 通过单一统一架构处理完整流程,让企业能够使用低延迟对话式 AI。
什么是对话式 AI 延迟?
对话式 AI 延迟是指你说完话后,系统做出响应所需的总时间。现代 AI 模型的延迟以 ms 衡量。实际上,总延迟由多个独立流程组成,每个流程都构成端到端流程的一部分。
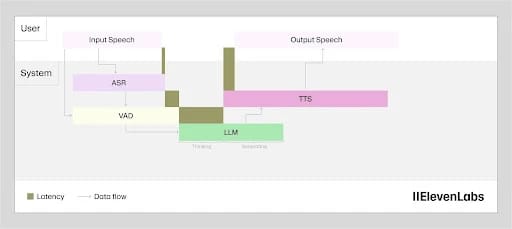
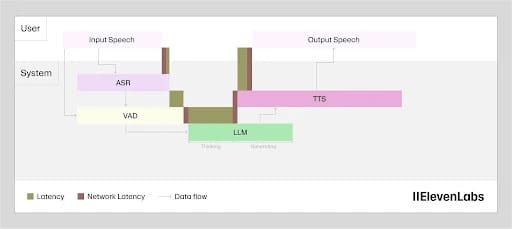
典型的对话式 AI 流程如下:
每个阶段都会为对话式 AI 系统增加延迟。因此,在讨论延迟时,需要厘清几个不同的缩写。
模型推理延迟
模型推理延迟是模型生成输出所花的时间,在内部测量且不包含任何外部因素。它是衡量引擎处理典型输入速度的模型专属指标。例如,Flash v2.5 的模型推理延迟约为 75 ms。了解这一指标后,就能比较不同厂商模型的速度。
不过要注意,这不是用户实际感受到的延迟,而是模型生成输出所花的总时间。
LLM 首 token 时间
大语言模型(LLM)首 token 时间(TTFT)是指大语言模型处理提示词并生成第一个可用输出 token 所需的总时间。
当 LLM 的第一个 token 到达时,TTS 就会开始生成。因此,这项指标衡量的是 LLM 需要多久才能开始触发 TTS 模型运行。对于大多数端到端对话式 AI 系统,LLM TTFT 占总延迟的很大一部分。
TTS 首音频时间(TTFA)
TTS 首音频时间(TTFA)衡量从首次发出 TTS 请求到第一个音频块实际离开模型的时间。它描述的是模型推理延迟,但专门用于 TTS 引擎。
端到端首音频时间(TTFA)
端到端 TTFA 就是对话式 AI 的总延迟。它是流程中每个环节的总和,包括 语音识别、LLM TTFT、TTS、TTFA,以及各步骤之间的所有网络传输。整体讨论对话式 AI 延迟时,这就是用户实际感受到的指标。
用户说话后,必须等待端到端 TTFA,才能听到智能体的回应。这是一项 整体指标,也就是说,改进流程中的任何部分都能改善它。
为什么对话式 AI 延迟很重要
用户与 AI 智能体交谈时,延迟会成为影响其体验评价的核心因素。低延迟能缩短等待回复的时间,让对话更自然,也让智能体显得更可靠。
即使回复质量相同,高延迟的智能体仍会显得生硬、能力不足。对企业而言,哪怕只相差几百 ms,也会让人感觉漫长无比,使 客户支持智能体 显得笨拙又低效。
以下场景说明了对话式 AI 延迟为何重要:
- 低于 500 ms:对话智能体响应迅速、流畅。用户可能察觉不到从停止说话到首次收到回复之间的延迟,对话得以顺畅进行。
- 500 ms 至 1000 ms:用户停止说话到收到回复之间的延迟可能开始变得明显。时间只是略长了一点,但用户可能会提前调整,比如重复说一遍,或暂停下来确认智能体是否真的理解了。
- 超过 1000 ms:延迟开始让人觉得缓慢,停顿会使部分用户感觉 AI 智能体没有完全跟上对话节奏。转录记录中可能偶尔出现打断或要求转接人工客服的情况。有时,用户会直接放弃通话。
这些阈值都会转化为实际业务结果。
在延迟较低时,客服智能体可以自然地处理咨询,帮助用户解决问题,无需额外协助。这能减轻人工客服的压力,并保持较高的客户满意度。在延迟较高时,智能体似乎犹豫过久,会让客户感到沮丧。
我们在另一篇文章中定义了 语音智能体延迟预算基准,说明在 P50 和 P95 指标下,良好延迟应是什么样。
对话式 AI 延迟由什么导致?
对话式 AI 延迟概括了多个不同流程,每个环节都会影响整体延迟。因此,低延迟的瓶颈更像是系统层面的问题,不能只靠选择更好的模型解决。毕竟,流程中有多个模型协同工作。
我们为开发者编写了一份关于 语音智能体延迟优化 的深入技术指南,可用于改善端到端首音频时间(TTFA)的每个阶段。
除核心流程外,电话系统和函数调用等因素也会增加延迟,尽管它们并不属于模型基础设施内部。
以下概述了影响对话式 AI 延迟的所有因素。
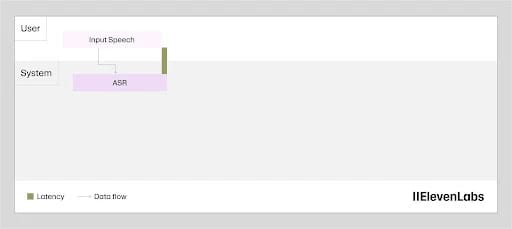
自动语音识别
语音识别的延迟并不是生成转录文本所需的时间。用户说话时,转录流程会在后台运行,因此说话结束时,文本基本已经准备就绪。
这里的延迟实际是从说话结束到转录文本完成并传到下一阶段之间的间隔。Scribe v2 Realtime 将这一间隔缩短至约 150 ms,并持续流式传输,因此轮次结束时输出即可就绪。
轮次交接与终点检测
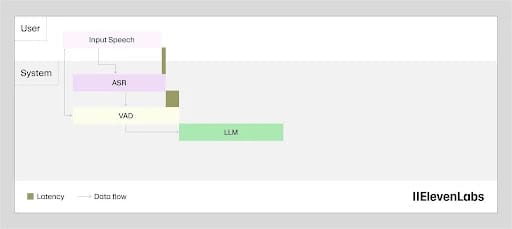
语音活动检测器(VAD)位于语音识别与语言模型之间。它的职责是判断用户是否真的说完了。
为避免出错,VAD 会等待达到持续静音阈值后,才判定当前轮次结束。这段等待会在语言模型处理内容前增加延迟。虽然这点额外延迟确实会耗时,但也能避免用户仍在说话时系统就开始回应。
从技术角度看,如果其他所有对话式 AI 组件的延迟都为零,那么归因于 轮次交接 的延迟反而是好事。人类听完话后也会稍作停顿再回应;机器采取相似的停顿能让交互更真实。但由于其他对话式 AI 组件已经会产生延迟,因此理想状态是将这部分延迟降至最低。
语言模型处理
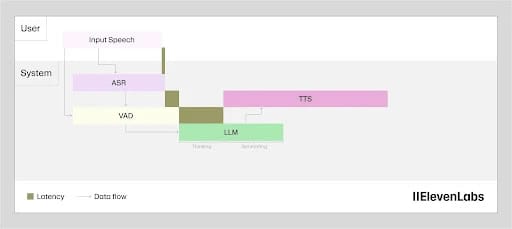
当 语音转文本(STT)引擎准备好转录文本后,语言模型会生成回复。这里的延迟是开始生成 token 所需的时间,而不是生成完整回复所需的时间。这些 token 一到达就会直接流入 TTS 阶段,因此最关键的是 TTFT。
除模型选择外,提示词长度和知识库大小也会影响这一阶段。LLM 需要考虑的上下文越多,所需时间就越长。在大规模设计此类系统时,需要在实用的知识库与精简的提示词之间取得平衡,以保持速度。
语音合成
TTS 延迟是从接收语言模型的首批 token 到音频开始播放之间的时间。由于 token 到达速度快于人类语音播放速度,合成模型无需等待完整回复。TTS 延迟仅指生成第一个音频块所需的时间。
过去,这一阶段是对话式 AI 延迟最大的单一来源,旧模型需要 2-3 秒才能开始生成语音。ElevenLabs 的 Flash v2.5 直接解决了这个问题:其语音合成延迟约为 75 ms,将这一瓶颈从数秒缩短到不足 1 秒。
网络延迟
将数据从一个地点传到另一个地点总会增加延迟,而地理距离只会加剧网络往返延迟。
由于多个组件需共同生成端到端回复,经过多次网络跳转后可能累积显著延迟。
函数调用
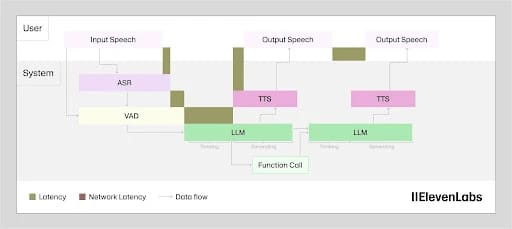
函数调用会在 LLM 阶段增加 API 往返时间。快速的内部查询会增加数十毫秒,而支付处理器或库存系统可能增加数秒。延迟量完全取决于所调用的服务,因此这是最难直接优化的阶段。
最有效的做法是提示 LLM 在工具调用完成前先作出回应。比如“我来帮你查一下”,能在等待外部调用返回时让用户保持参与,而不是一片沉默。工具并行运行时,语音回复便可开始。
如何降低对话式 AI 延迟
降低对话式 AI 延迟,需要按影响程度处理流程的各个阶段。单项改进确实能减少延迟,但若要获得最大改善,必须从整体上优化整个流程。
以下原则可从整体层面指导你降低对话式 AI 延迟:
- TTS 模型选择:像 Flash v2.5 这样针对速度优化的 TTS 模型,其架构不同于针对质量优化的 Eleven v3 和 Eleven v4。对于实时 语音智能体,正确的选择是满足延迟目标的最高质量模型,而这几乎总是针对速度优化的模型。
- LLM 模型选择:更小、更快的 LLM 通常比大型 LLM 有更低的首 token 时间。选择既能满足任务质量要求又最快的 LLM,与选择 TTS 模型同样重要。
- 流式传输:流式 TTS 会在合成过程中分块返回音频,因此模型仍在生成剩余内容时,用户就能听到第一个词。这一理念同样适用于 LLM 输出:当语言模型生成后续句子时,基于第一句话开始 TTS 合成,可以从流程中挽回部分延迟。
- 系统提示词设计:用户可以通过 精简系统提示词,将指令移至程序或 workflow,而非保留在每个决策步骤中。这样能减少模型在每一轮需要推理的上下文量。
- 安全护栏:在流式模型中运行安全护栏,可让输出在安全护栏检查完成前就开始播放,而不是等检查结束后才播放。
- 模型共置:尽可能使用共置模型,例如 ElevenLabs Agents 技术栈,让组件彼此靠近,避免在不同托管模型之间跳转而增加延迟。
- 地理位置:让服务器靠近用户可显著降低延迟,因为这会直接减少网络对端到端 TTFA 的影响。
除这些因素外,还可以参考这份 延迟优化技术指南,了解更多细节。
开始使用 ElevenAgents 构建低延迟对话式 AI
构建和部署智能体时,对话式 AI 延迟是必须重点考虑的问题。使用 ElevenAgents,延迟优化已内置于流程中。从通过重叠技术挽回时间,到降低各个组件的模型推理延迟,ElevenAgents 可为企业构建低延迟对话式 AI 技术栈。
归根结底,目标是打造真实感。用户既要感受到与人交谈的轻松,也要获得计算机程序的优势。通过缩短各个子流程,现在已经可以做到这一点。
了解更多 ElevenAgents 信息,或 联系销售团队,立即开始。
对话式 AI 延迟常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。



