转录文本如何知道每个词的发音位置
- 发布时间
如果你曾在电视上看电影时遇到播放故障,演员对白与字幕完全不同步,就知道这有多让人分心,甚至会让你脱离剧情。使用语音模型的视频和软件也有同样的问题:晚出现 1 秒的字幕,或高亮错误词语的转录文本,都会让人觉得出了故障。
ElevenLabs 从事对齐研究的研究员 Danila Kozlov 表示:“人类其实很擅长对齐媒体,至少在词语层面如此。我们通常能凭直觉判断一个词从哪里开始,但要精确到字符级和亚毫秒级,就难得多。”
今天,ElevenLabs 将进一步介绍 Cue——一款强制对齐模型,可将音频文件中的每个字符定位到精确时间线上。Cue 为 ElevenLabs 的 Scribe 模型系列提供支持;在真实录音中,它在基准测试的全部 29 种语言上都比 ElevenLabs 测试过的所有对齐器更准确。它还能单次处理任意时长的录音,并在不到 1 秒内完成 1 小时音频的对齐。
什么是强制对齐?
想象有人交给你一段视频和一份转录文本,让你把每个词与其说出的时刻对应起来。这就是强制对齐。当你点击 ElevenLabs 转录文本中的某个词,播放器跳转到对应位置时,背后就是对齐器在工作。
不过,强制对齐不同于更宽泛的 AI 对齐概念。后者是指设计 AI 系统,使其行为符合人们的价值观和业务偏好。强制对齐说的只是让文本与声音对应起来。
Cue 是语音转文本流程的最后一步。ElevenLabs 的 文本转语音模型 Scribe 负责转录音频,再由对齐器设置时间戳。每个 Scribe 请求都会经过它。同一模型还支持字幕、配音和音乐歌词时间对齐,也可通过强制对齐 API 单独使用。
由于许多产品都依赖它,对齐器必须在每种支持的语言中保持精确、速度极快,并且能够同时处理大量请求。
传统对齐器的不足
在新模型推出前,团队打造了此前所有 ElevenLabs 产品使用的对齐器模型。尽管它已很强大,团队仍知道可以打造更出色的新版本。Kozlov 加入后,他和团队先访谈了 ElevenLabs 的客户及内部用户,了解他们使用旧版对齐器时遇到的困扰。这些反馈与团队测试的开源工具局限一致。
时长是首要问题。如今许多对齐器能很好地处理约 30 秒的片段,但更长的文件必须切分成多个片段。每增加一个片段,都可能带来少量时间误差;拼接片段交界处还会产生更多误差。对于完整录音,Cue 的平均时间误差仅为 179 毫秒,而开源工具则介于 283 ms 至超过 6,000 ms。
真实录音音频更具挑战。背景噪声、重叠语音和环境音乐,会让许多工具在匹配文本与音频时失去定位。但这恰恰是很多人真正想转录的文件,因为我们生活的环境往往并不完全安静。在存在背景干扰的英语录音中,Cue 的平均误差为 57 ms,而其他工具为 65 ms 至 920 ms。
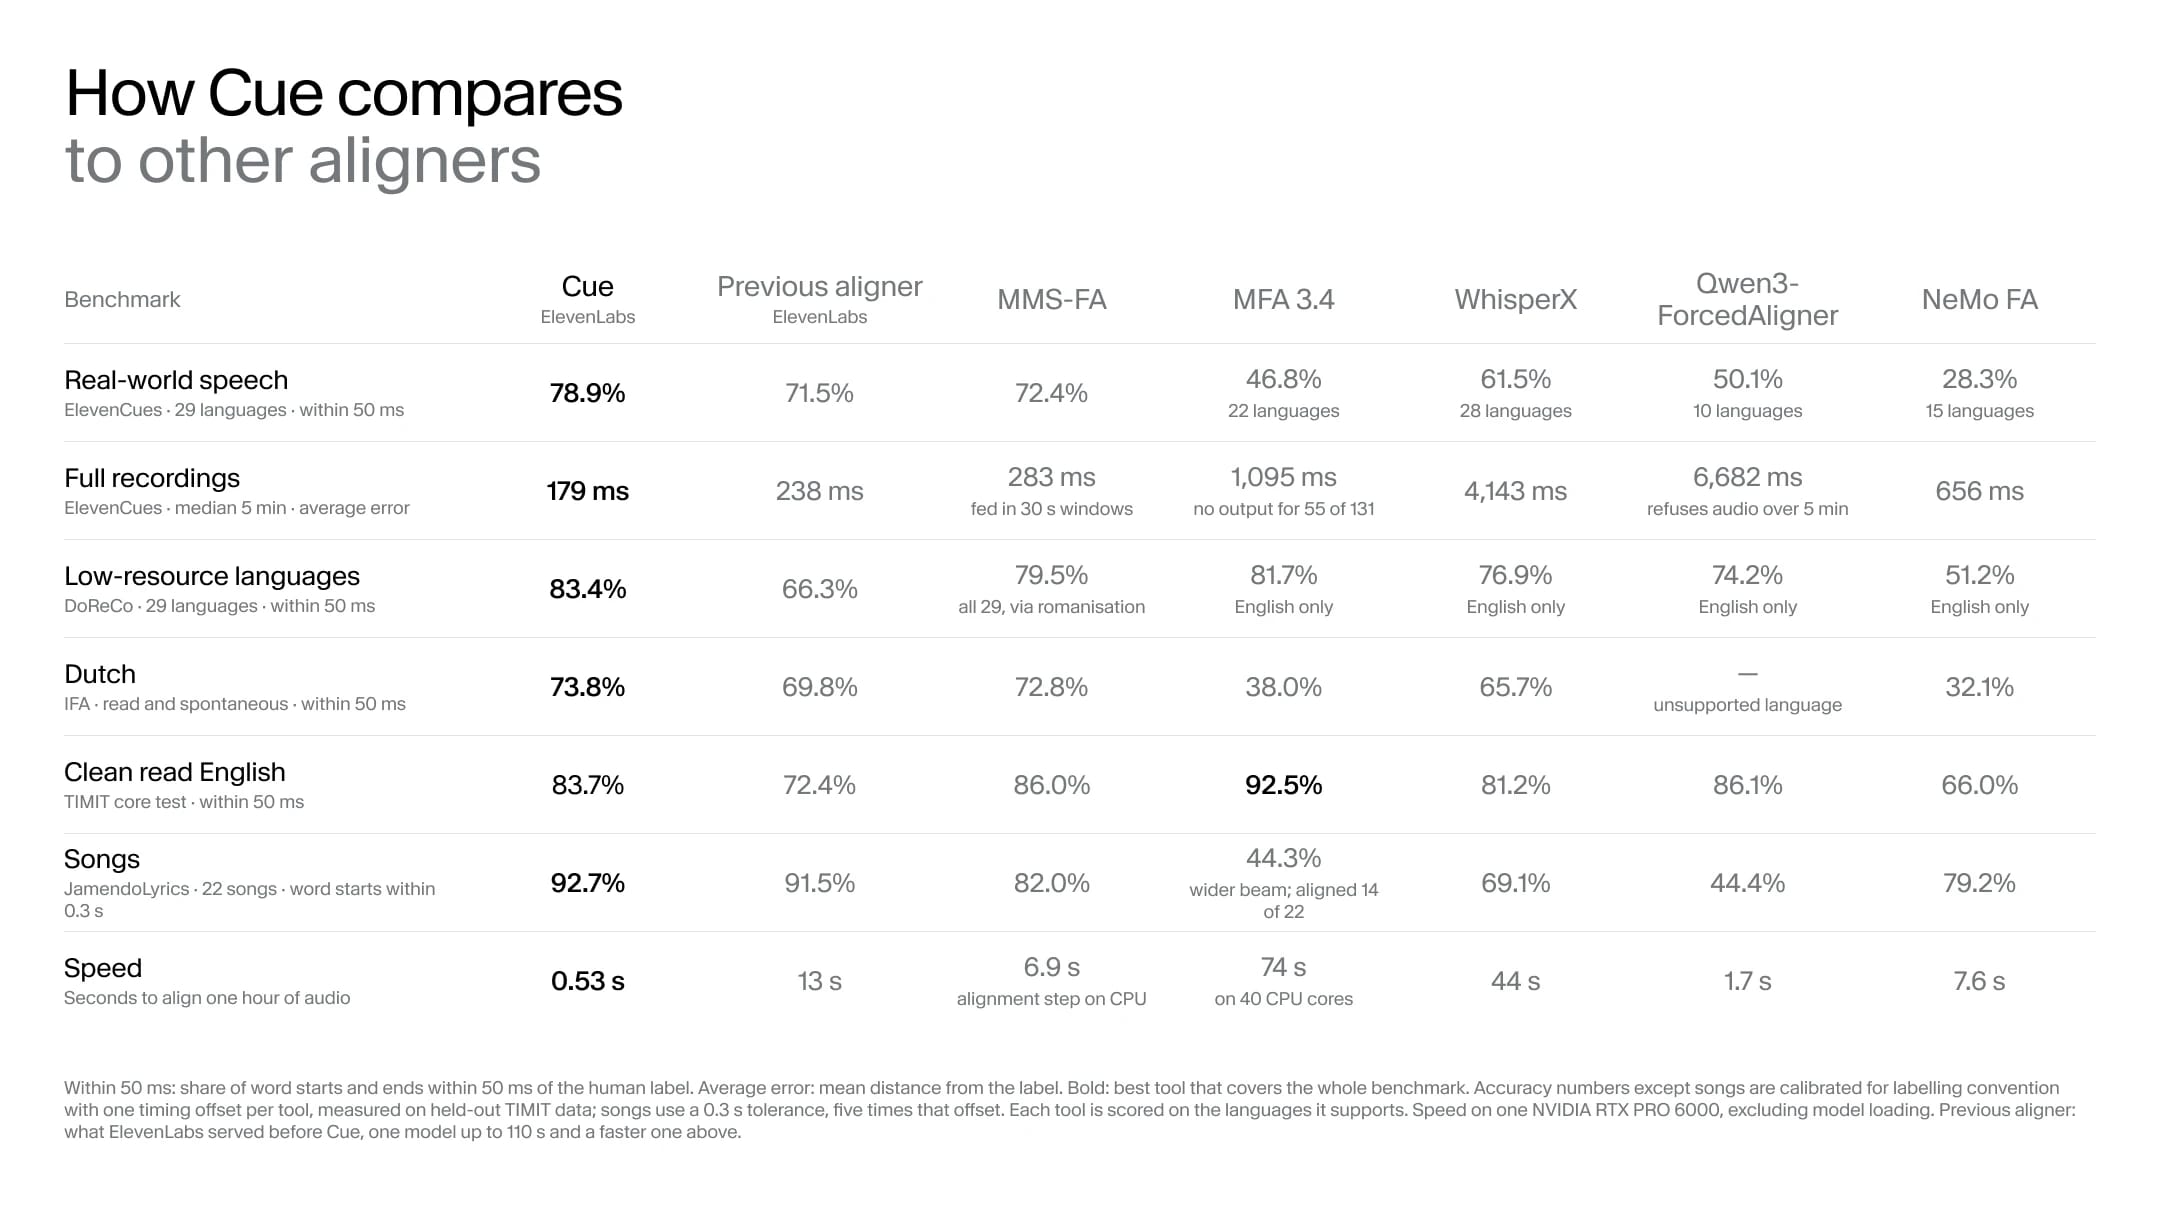
语言支持是另一项限制。大多数开源对齐器都需要为所支持的每种语言配备独立模型,因此训练数据较少的语言通常表现不佳,甚至根本不受支持。MMS-FA 是唯一同样支持全部 29 种基准测试语言的工具;相比之下,Cue 通常能更快确定词与词之间的边界。
速度也是这些模型面临的问题,因为对齐大量音频的成本会迅速上升。Cue 在我们的生产 GPU 上约半秒即可对齐 1 小时音频。第二快的工具 Qwen3-ForcedAligner 接近需要 2 秒,而测试中最慢的工具则远超 1 分钟。
Cue 的不同之处
与大多数竞品不同,Cue 是一个覆盖超过 90 种基准测试语言的单一模型。它也能单次处理任意时长的录音,避免了长文件因切分而不断累积时间误差的问题。
双指捏合或按住 Control 滚动可缩放。水平滑动或按住 Shift 滚动可平移。选中词后,使用加号和减号缩放,或按住 Shift 并使用左右方向键平移。
选择一个词以查看其中的字符
Kozlov 表示,大多数模型会随着性能提升而变得更大,但 Cue 比此前 ElevenLabs 的对齐器更小。它仍在 GPU 上运行,但约半秒就能对齐 1 小时音频。
团队根据用户实际上传的音频类型构建 Cue。他们以旧版对齐器为基准,基于真实请求建立测试集,并以相同方式为每个工具评分:工具未能定位的任何词都记作错误。Cue 在字符级运行,比大多数基准测试采用的词级标签更精细,因此这些分数可能低估了它的精度。
Kozlov 谈及对齐器模型时说:“到了一定阶段,模型会达到人类能力水平。我们当前的对齐器已超越这一水平,因此要验证它是否完全正确、或到底有多精确,都会难得多,因为没有可作为金标准的基准。我们不得不用词级基准来评估字符级系统,这未必能充分展现 Cue 的全部潜力。”
Cue 的质量也体现了 ElevenLabs 响应用户反馈的速度。Cue 推出不久后,一位客户提醒团队,格鲁吉亚语及其他几种资源较少的语言表现不如预期。ElevenLabs 让研究团队贴近使用产品的团队和客户,因此能够迅速发现问题、研究可能的模型改进方案、训练并发布新版本——从客户首次提出问题起,整个过程不到 24 小时。
歌曲对齐
音乐很难处理,因为演唱会拉长并模糊词语,很少有模型能做好。团队没想到 Cue 的表现会如此出色。Cue 能够对采用 Creative Commons 许可的 JamendoLyrics MultiLang 数据集中的部分歌曲进行对齐。它能以单次处理方式,在英语、法语、西班牙语和德语中实现惊人的准确度。92.7% 的词被定位在标签时间点 0.3 秒以内,而第二名工具为 82.0%。
Cue 的平均起始误差为 0.82 秒,约为最接近竞品的一半。在 22 首歌曲中,它至少在 19 首上的准确度超过其他所有工具。新歌发布当天就能在卡拉 OK 演唱喜爱的歌曲,潜力巨大。
立即试用 Cue
Cue 已支持 ElevenLabs 上所有 文本转语音 转录。要直接使用它,可试试 强制对齐 API。
致谢
ElevenLabs 的对齐器模型研发离不开公司许多同事的贡献。团队感谢所有参与旧版和新版模型研发的成员,包括联合创始人兼 CTO Piotr Dąbkowski,研究员 Danila Kozlov、Luca Lanzendörfer、Flavio Schneider、Max Levi、Tim von Känel 和 Angelos Perivolaropoulos;数据运营团队的 Ani Janelidze、我们的驻场工程师和支持团队;以及为本文可视化内容作出贡献的 Lorenzo Dossi。
Mike Murphy 是 ElevenLabs 博客的主编兼撰稿人,致力于将复杂的研究和技术转化为清晰、引人入胜的故事。加入 ElevenLabs 前,他曾多年担任科技记者,包括在 Quartz 任职,并负责 IBM Research 的内容工作。他拥有西北大学新闻学硕士学位。