推出 Eleven v4:迄今情感最丰富的模型
- 发布时间
- 最近更新
收听收听本文
一句话的含义会因说法不同而大不相同。“我需要你保持冷静”这句话,若是医生温和地对受惊的患者说,和游戏角色跳入战场前对小队高喊,听起来应截然不同。
今天,我们发布 Eleven v4,这是迄今情感表现力最强的文本转语音模型,以及其低延迟版本 Eleven v4 Turbo。
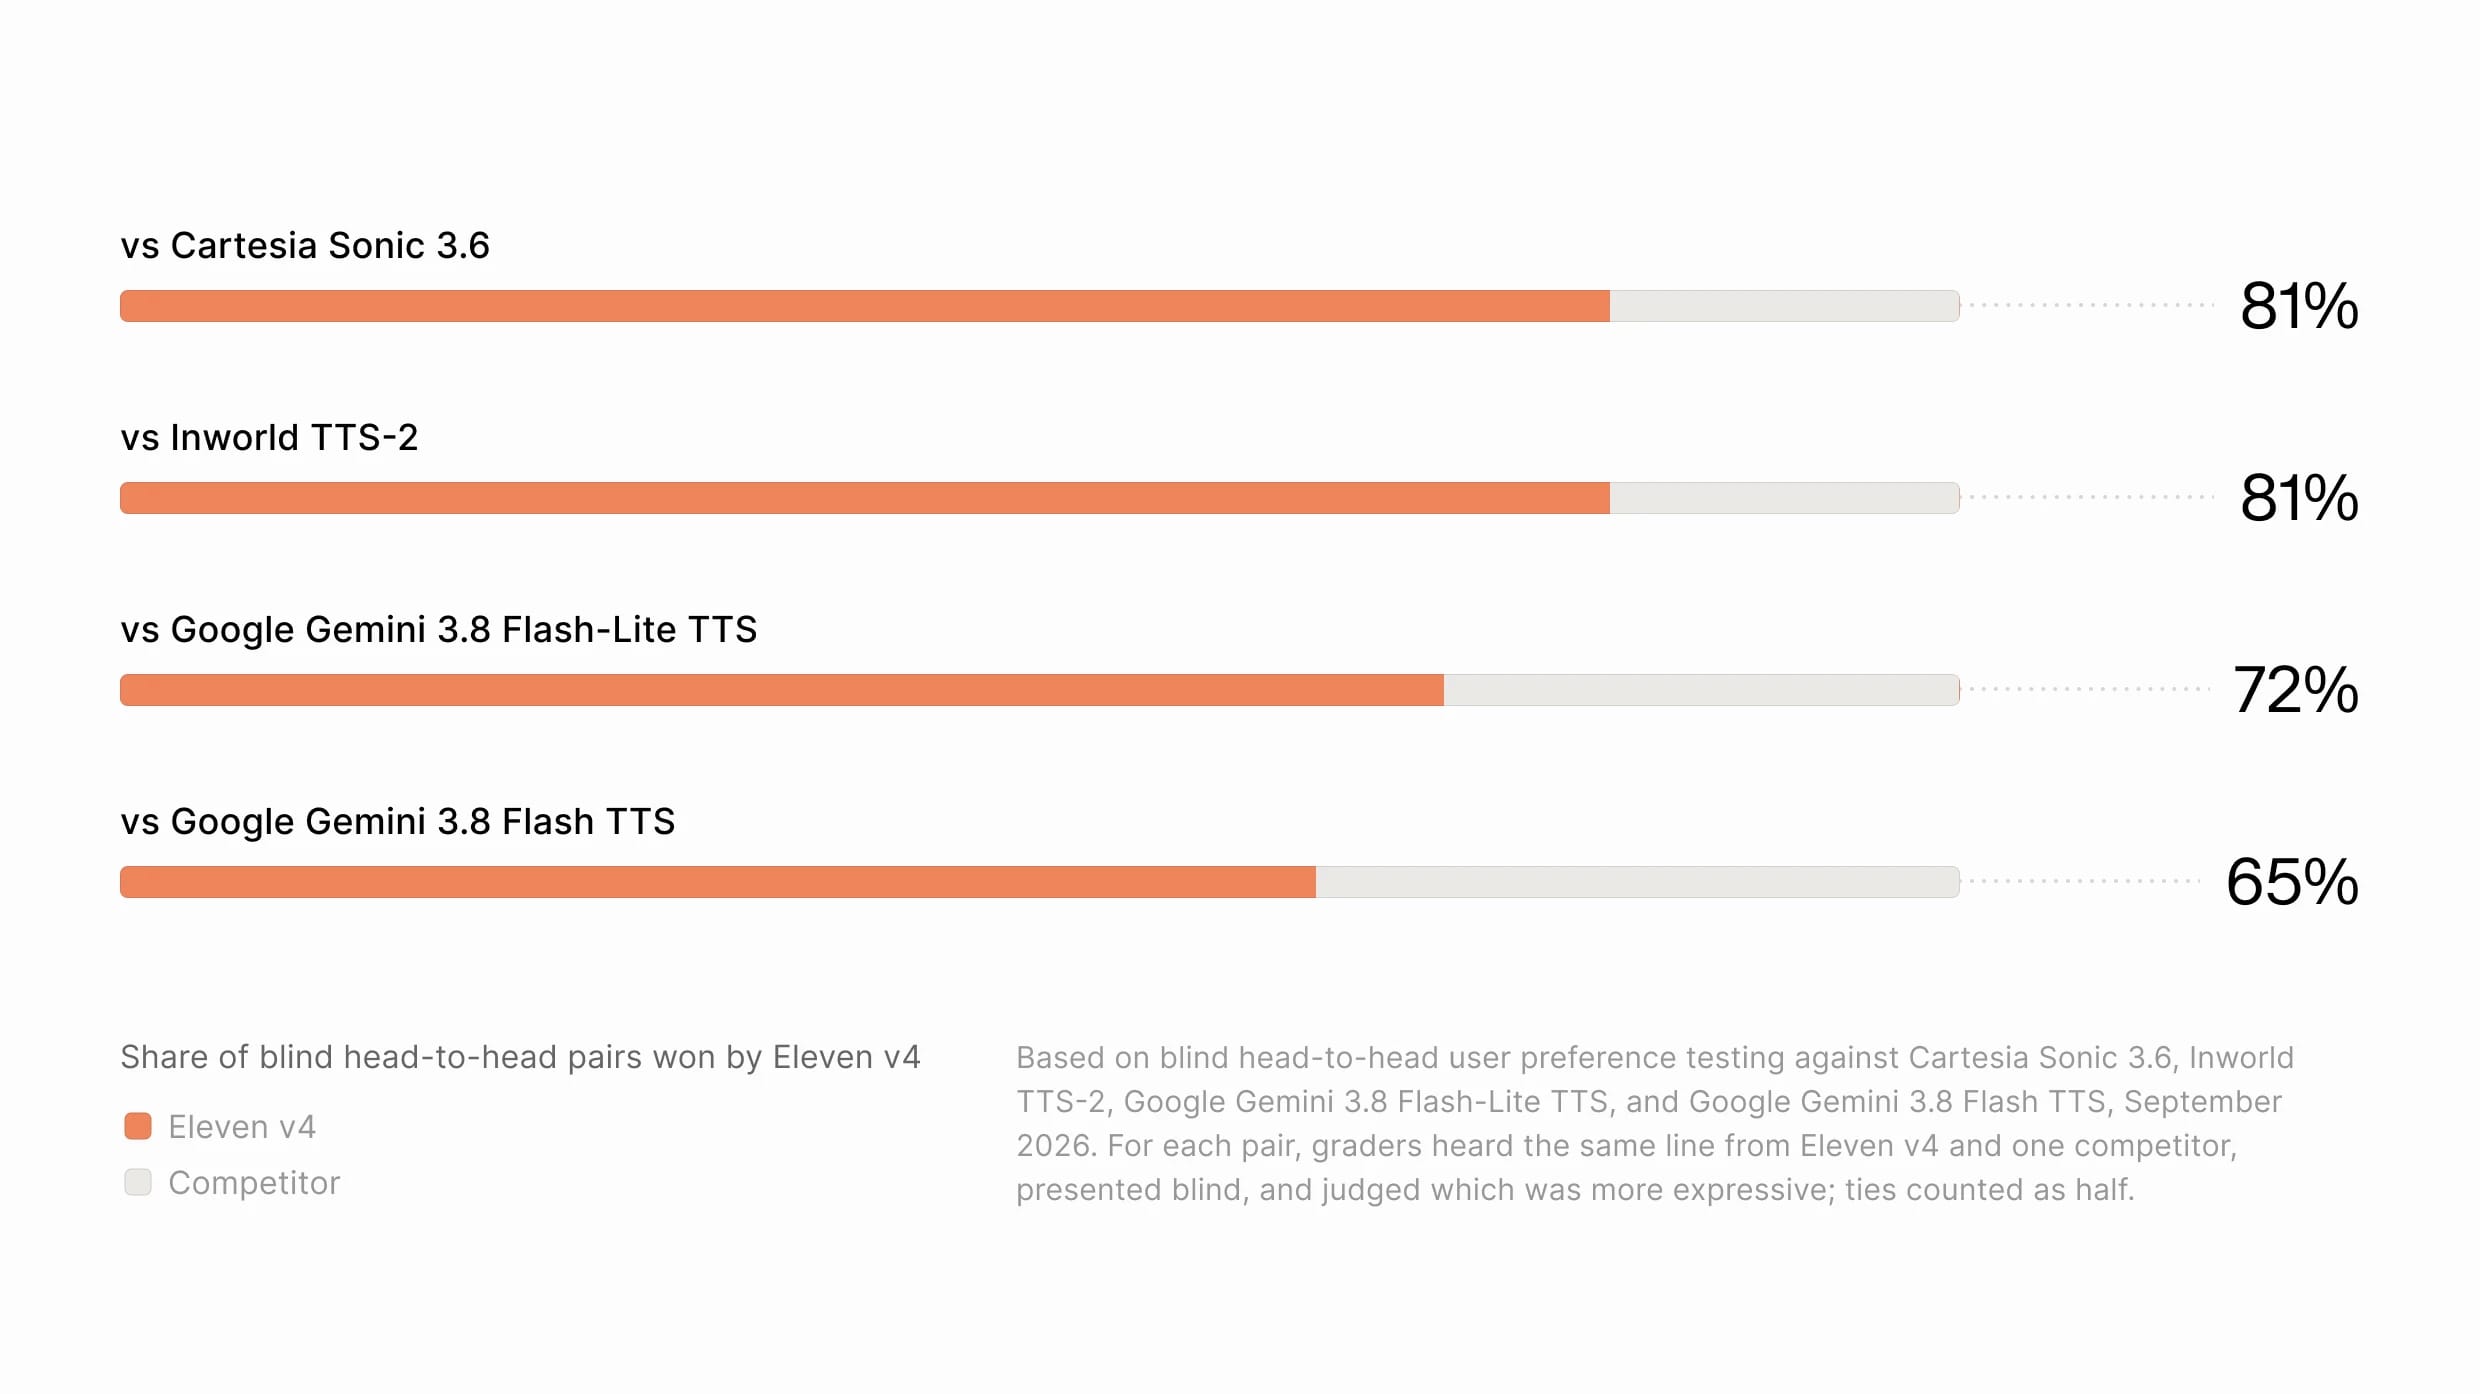
获 Artificial Analysis 评为第 1 名1,在与竞品模型的盲测一对一对比中,约 75% 的听众更偏好它2。Eleven v4 专为理解语气、节奏、情绪、角色和上下文而设计。它能在保持说话者身份特征的同时,生成戏剧化、温柔、紧迫、诙谐或自然交谈式的语音。更自然的多说话者互动,让对话更具即时回应感,而非由各自独立的台词拼接而成。说话者会结合对话上下文做出回应,生成更自然的对话和角色互动。
为性能打造的全新架构
基于全新架构打造,Eleven v4 是我们情感表现力最强的 文本转语音 模型,获 Artificial Analysis 评为第 1 名1。Eleven v4 Turbo 将同样的技术带入智能体等低延迟场景。其推理延迟中位数约为 100ms,响应速度比两人交谈时的平均停顿更快。
两款模型都能生成富有情感、而非机械生硬的语音。整体音频保真度也更高,输出更干净、更自然。
早期文本转语音模型能朗读文本,但 Eleven v4 赋予语音更自然的情感深度。模型可以理解预期语气、语音节奏、文字风格和文本上下文,生成能引起情感共鸣的语音。
用户还能精细控制输出,用自然语言描述一句话该如何表达。也可以借助内联标签添加具体指令,例如特定短语的说法、应传达的情绪,甚至音效,如 [laughs]、[said angrily in French accent]、[light rain] 或 [phone buzzing]。与以往模型相比,Eleven v4 能更准确地遵循这些音频标签和提示词,因此你描述的表达效果就是最终生成的效果。这让旁白指导、角色及其对话塑造,以及其他重视表达方式的场景都更轻松。
ElevenLabs 开发者文档 详细介绍了完整的标签语法,以及如何通过 API 应用这些标签。对国际音标(IPA)音素的支持也显著提升,自定义发音更加可靠。
Eleven v4 还提升了多说话者之间的一致性和动态对话表现。通过一种新的说话者身份捕捉方法,Eleven v4 能保留每种音色的独特特征。在智能体对话、有声书或广告中,也能保持语音一致。由于模型理解整个场景的上下文,它能生成自然的对话,让说话者回应刚刚说过的内容,而不是拼接孤立的台词。
面向低延迟场景的 Turbo 模型
高质量语音模型往往生成较慢,用户不得不在速度和富有表现力的语音智能体之间取舍。许多人选择了能力出色但语调单一的智能体;对于只想解决问题的焦急客户而言,这类智能体可能显得很机械。
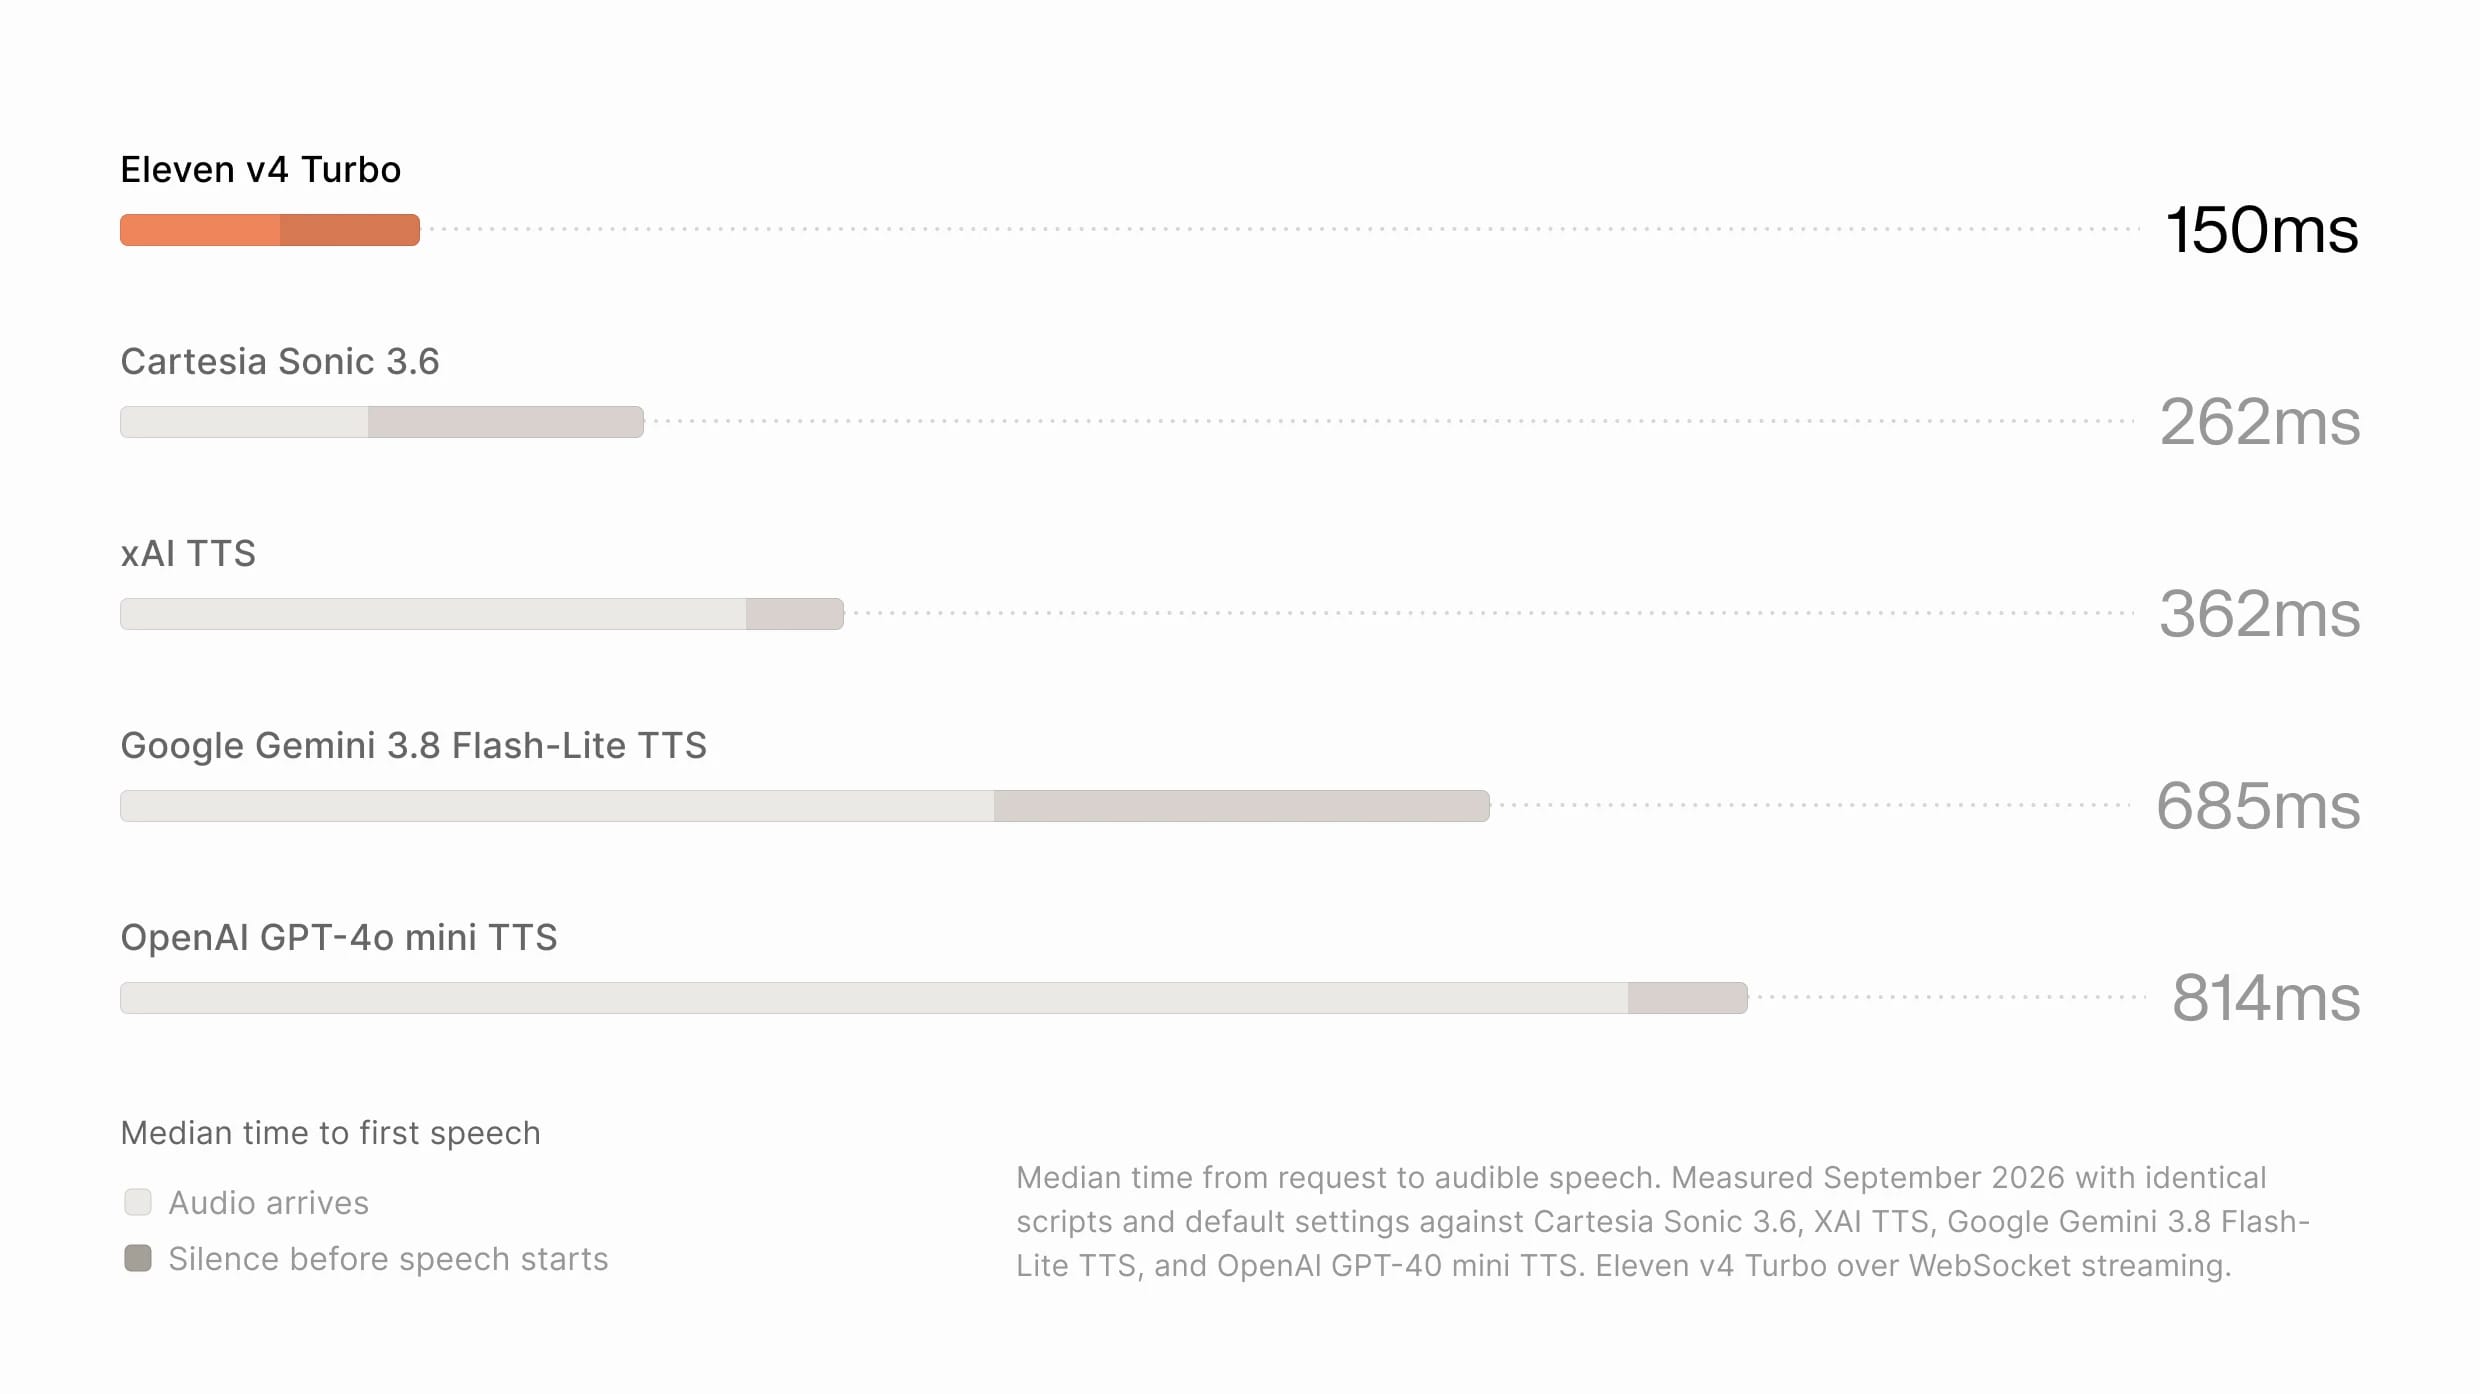
Eleven v4 Turbo 兼具速度与情感,首次出声时间中位数约为 150ms3,可将强大的智能体部署到众多行业:从医疗领域能准确发音医学术语、语气温暖且令人安心的智能体,到游戏中语速快、善用俚语来娱乐玩家的智能体。
Eleven v4 Turbo 专为与 ElevenLabs 的对话式智能体平台 ElevenAgents 协同工作而打造。其他智能体构建平台会拼接不同供应商的模型和软件,用户难以针对自身场景优化或改进模型输出。ElevenLabs 的研究与工程团队将 Eleven v4 Turbo 和 ElevenAgents 作为一个系统协同优化,带来更具表现力、更可靠且低延迟的智能体。
一种音色,多种语言
我们的沟通方式会因情境、地点,甚至一天中的时段而变化。要在多种语言中构建与之相符、富有表现力的语音,仍是 AI 音频领域最难的挑战之一。
Eleven v4 在这些方面都有提升,改进不止于模型对短语的发音。Eleven v4 能更好地捕捉不同语言中的节奏、情绪和表达方式,帮助创作者生成符合语言和语境的自然语音。例如,你在日本与陌生老人说话的方式,与在意大利时会很不一样。
Eleven v4 和 Eleven v4 Turbo 均支持超过 90 种语言。现在,用一种语言录制的音色也能流利说出其他任何语言:采用母语者口音,同时保留原始身份特征。对口音的遵循明显强于以往,因此生成过程中音色不会再逐渐偏回原始口音。
加泰罗尼亚语
西班牙语
对于配音和本地化,这意味着你选定的品牌声音——无论是合作的知名演员,还是最符合公司风格的语调——都能在 Eleven v4 支持的任何语言中表现出色。
更真实、一致的语音克隆
Eleven v4 和 Eleven v4 Turbo 的语音克隆更加真实、强大且一致,与原始源音色的说话者相似度显著提升。现在,Instant Voice Clones 仅需 10 秒音频即可高保真捕捉音色。
真实语音
Eleven v4
Eleven v4 还能在多次生成、对话、旁白和重新生成的台词中,更可靠地保留说话者身份特征。这意味着在长篇项目中,角色、旁白和克隆音色能在整个作品中保持一致。Eleven v4 还新增对专业语音克隆(PVC)的支持,满足最高保真度的克隆需求。
请求拼接——将多次生成串联为更长的内容——在 Eleven v4 中也显著更加可靠,提升了在 ElevenLabs Studio 和 ElevenLabs Reader App 中的使用体验。
亲自听听差异
Eleven v4 和 Eleven v4 Turbo 凝聚了我们最新的表现力语音生成研究成果。它们专为表达方式与文字本身同样重要的内容而打造,包括有声书、角色表演、旁白配音、配音,以及对话式智能体本地化。
两款模型现已在 ElevenAgents、ElevenCreative 和 ElevenAPI 中提供。创建免费账户,立即使用 Eleven v4 或 Eleven v4 Turbo 开始生成。
- Artificial Analysis,Provider Voice Arena 排行榜,2026 年 9 月
- 基于 2026 年 9 月针对 Cartesia Sonic 3.6、Inworld TTS-2、Google Gemini 3.8 Flash-Lite TTS 和 Google Gemini 3.8 Flash TTS 开展的盲测用户偏好测试。每组测试中,评测者在不知道来源的情况下试听 Eleven v4 和一款竞品生成的同一句文本,并判断哪一个表现力更强、听起来更自然;平局按半票计算。
- 从请求发出到可听到语音的中位时间。2026 年 9 月,使用相同脚本和默认设置,与 Cartesia Sonic 3.6、xAI TTS、Google Gemini 3.8 Flash-Lite TTS 和 OpenAI GPT-4o mini TTS 进行测量;所有系统均已测量并剔除网络延迟。Eleven v4 Turbo 通过 WebSocket 流式传输。