如何创建自然流畅的合成语音?
- 发布时间
- 最近更新
如今,先进的 AI 模型能够创建听起来如自然人声般的合成语音。这些模型基于海量真实人声数据集训练,利用先进神经网络识别并复现真实语音模式。创建合成语音也称为语音合成或声音合成,而生成的音频则称为合成语音。
要创建新的合成语音,用户需要录下自己说话的声音。同时,AI 模型会分析其独特的语音模式和语调,并利用这些数据复现声音。之后,用户可以调整口音、音调和语速等语音特征,得到最终效果。有些合成语音是对某个人声音的直接克隆,另一些则融合了多种声音。也可以根据文字描述设计声音,完全无需录音。
合成语音为播客、有声书、电子游戏和广告带来丰富的创作可能。本文将介绍合成语音如何创建、为何听起来自然,以及如何通过 ElevenLabs 创建自己的合成语音。
摘要
- 合成语音由神经 AI 模型创建,这类模型会分析并复现人类语音模式。
- 合成语音可用于有声书旁白、生成电子游戏对白、规模化制作播客和旁白配音、创建客户服务智能体,甚至保护可能消失的声音。
- 语音克隆会分析特定个人的声音录音,并复现其独特口音和语音模式。
- 现代 AI 语音之所以自然,是因为它们能复现人类韵律并理解上下文,而非只复现单个词语或音节。
合成语音的创建步骤
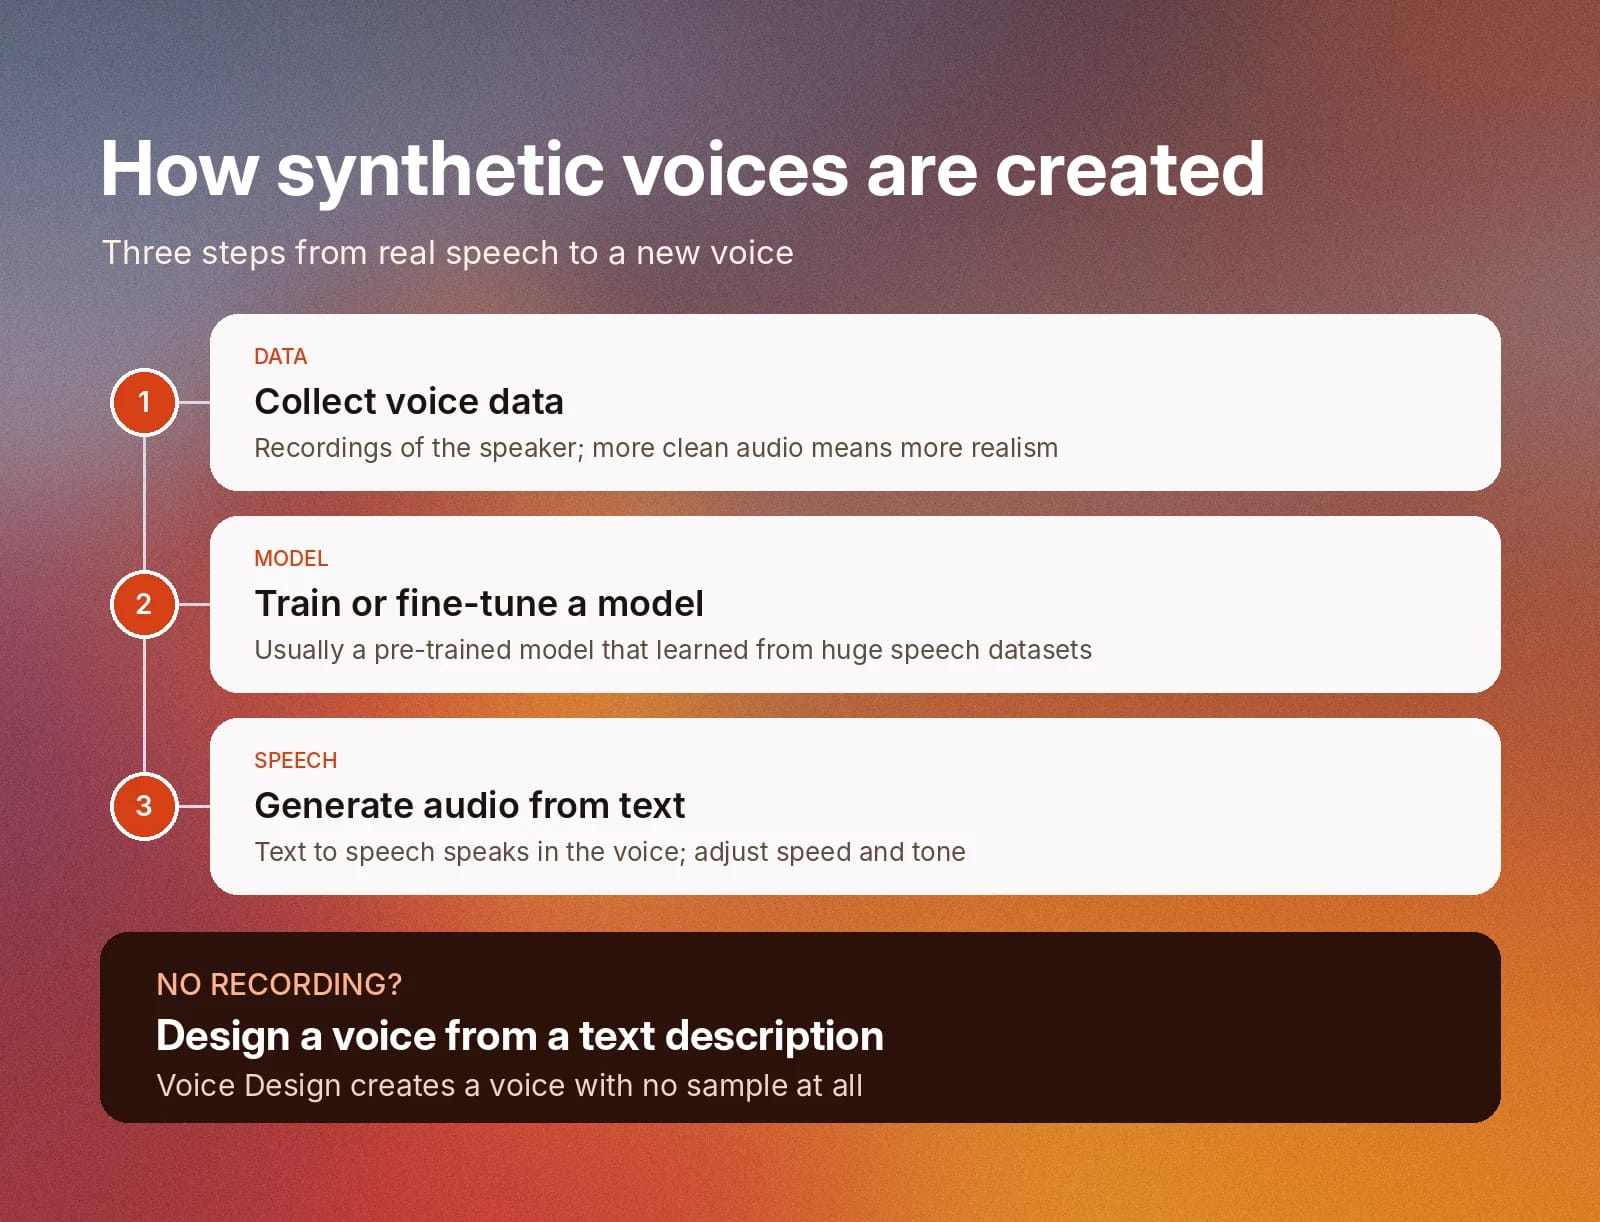
创建合成语音分为 3 步。
具体流程如下:
- 第 1 步:收集语音数据:合成语音始于真实人声。要创建新声音,需要录制想复现的说话者音频。提供的数据越多,最终的声音就越准确、逼真。以下是一些语音克隆最佳实践。
- 第 2 步:训练或微调 AI 模型:要创建合成语音,AI 模型首先会分析包含丰富多样语音录音的大型数据集,并借此理解人类语音模式。模型训练完成后,只需一段语音录音便可克隆真实声音。大多数情况下,使用预训练模型即可,无需从头构建自己的模型。
- 第 3 步:根据文本生成音频:合成语音通过文本转语音生成音频。你可以调整语速、音调等因素,使其符合偏好。想深入了解,可阅读我们的文本转语音技术原理指南。
从语音数据到神经文本转语音
神经文本转语音模型通过大量真实语音录音数据集训练。这些数据集包含不同语言、口音、情绪和音高的录音。如今,神经文本转语音是广泛使用的一种语音合成形式。
传统模型会拼接现有的词语、音节和音素录音。由于无法复现让语音听起来像人声的音高、节奏和表达变化,生成效果非常机械。
现代神经文本转语音模型不只学习字母和音节的发音,还会学习自然的人类发音模式和语音节奏。在将文本转换为语音时,模型会分析文本,将其转换为声学特征,再利用这些特征生成波形。
由于音高、节奏和音调等声学特征已融入神经 AI 模型,生成的语音比过去的模型更加自然、真实。
生成结果也可自定义:你可以调整语速、情绪甚至口音,获得所需的准确声音。例如,品牌可以在整个网站中使用同一种合成语音,但为营销内容赋予兴奋和紧迫感,为客户服务互动采用平静的语调。
标准、神经和生成式文本转语音
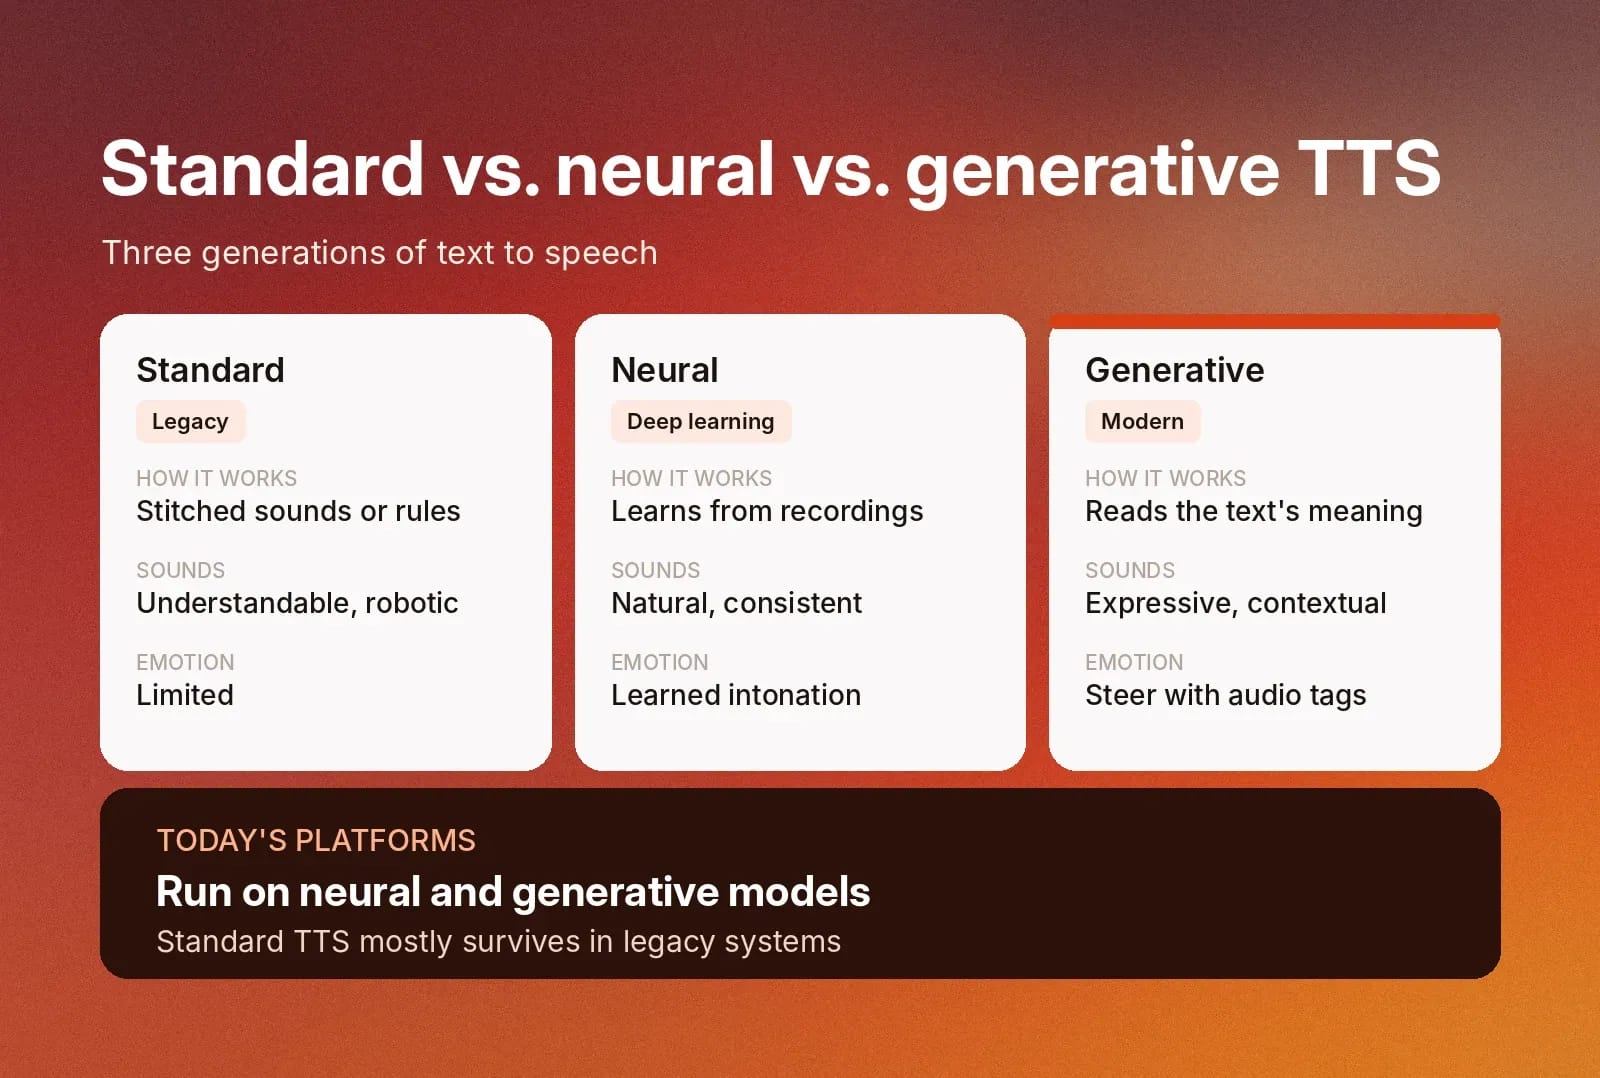
文本转语音模型大致经历了 3 代发展。
了解它们之间的差异,有助于理解为什么像 ElevenLabs 文本转语音这样的现代模型能如此自然。
- 标准文本转语音:这类系统会拼接预先录制的声音,或遵循规则和统计模型朗读文本。输出内容可以理解,但较为机械,情感有限。
- 神经文本转语音:深度学习模型从大量录音中学习发音、节奏和语调,生成听起来更自然、更连贯的语音。
- 生成式文本转语音:生成式模型基于规模更大、更多样的语音数据训练,并根据文本含义决定情绪、语速和重点。你可以通过指令控制其表达方式,例如音频标签。
现代语音平台依赖神经模型和生成式模型,而标准文本转语音主要仍存在于旧有系统中。
AI 语音生成为何听起来自然?
AI 生成的合成语音与人声十分相似。实际上,如果不仔细听,很难分辨两者的区别。
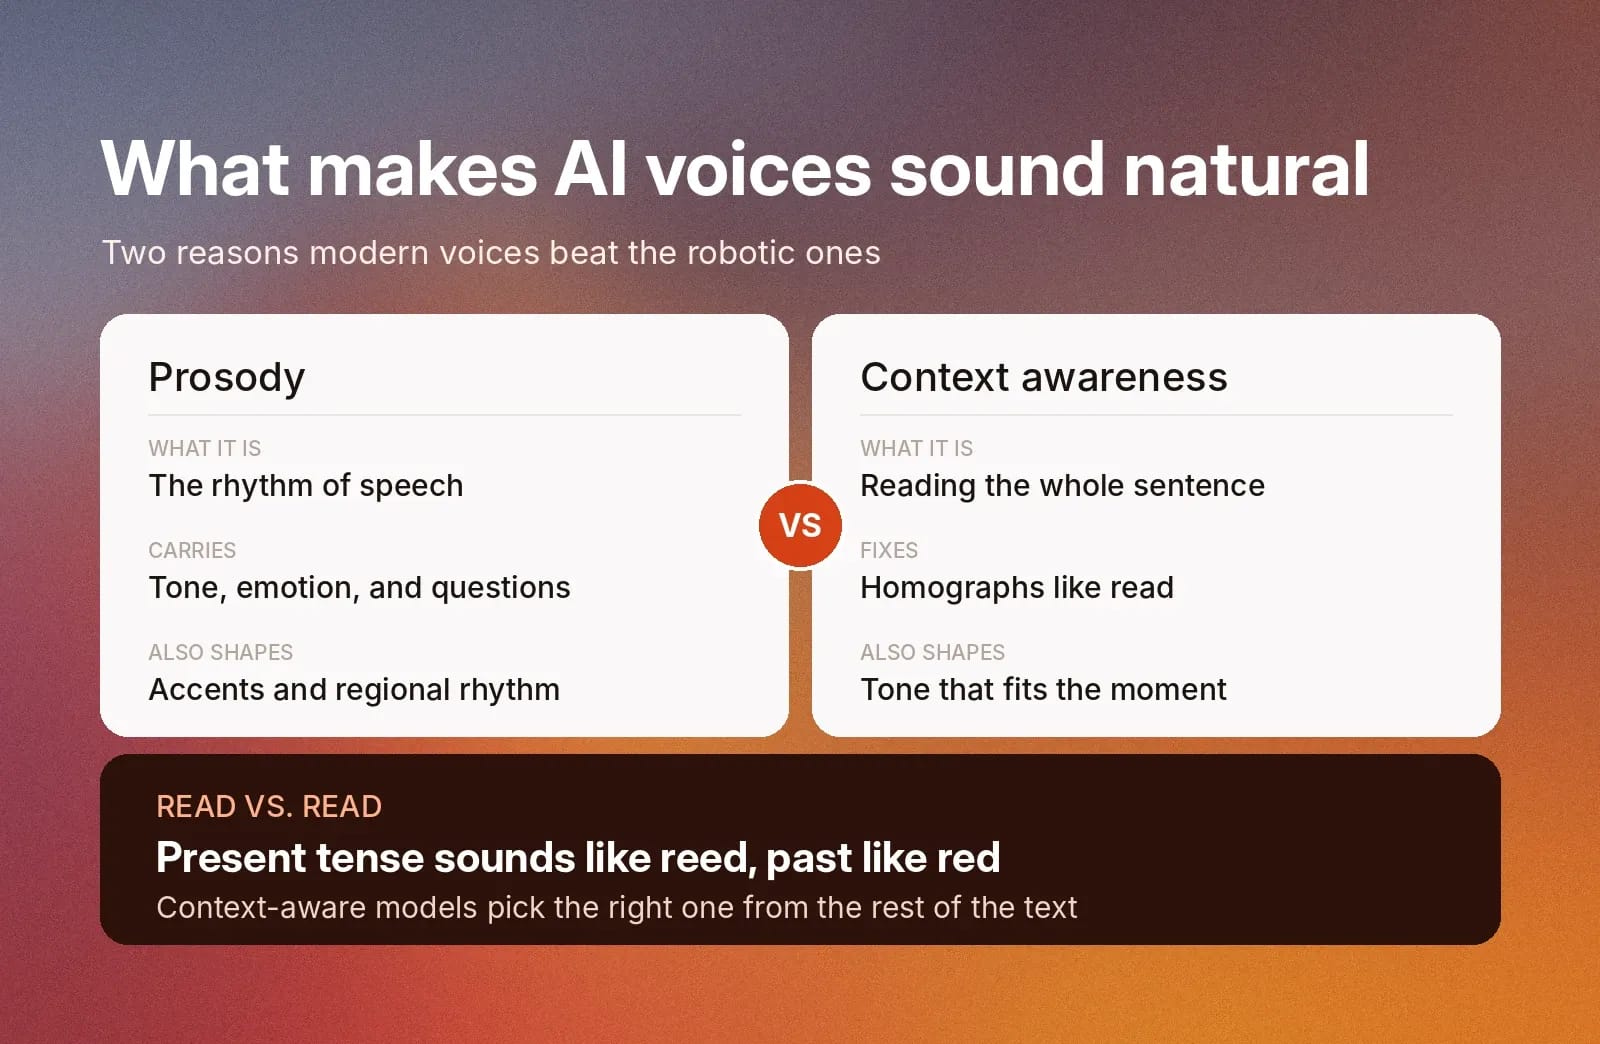
AI 生成的语音比过去机械的语音更自然,主要有两个原因:韵律和上下文感知。
韵律
韵律是自然人类语音的节奏。说话时,语调和语速的细微变化能传递语气和情绪。例如,说得很快可能表达压力或兴奋,而在句末提高音调,会将陈述句变成疑问句。
如今的 AI 语音模型经过训练,能够理解并复现韵律。这意味着输出语音会呈现自然人类对话的流畅感,而非僵硬或平淡。
如果使用合成语音为有声书配音或创建电子游戏对白,它会通过韵律展现角色的情绪。如果要为教育内容制作旁白配音,或创建客户服务智能体,AI 模型则会调整韵律,以平静、富有同理心的方式表达。
通过理解韵律,AI 模型还能复现独特口音。例如,尽管使用同一种语言,北美英语的节奏与英国、苏格兰或爱尔兰英语口音明显不同。
上下文感知
AI 驱动的 TTS 模型不会逐词处理,而是会分析整个短语、句子或对话,并根据上下文调整表达。
例如,许多单词拼写相同,但会因时态和上下文不同而有不同发音。以 “read” 为例,表示现在时时发音类似 “reed”,表示过去时则发音类似 “red”。
由于 AI 语音能够感知上下文,它会依据其余文本识别正确发音,也会调整表达方式,确保语气和情绪符合具体情境。
语音克隆如何运作?
语音克隆通过 AI 分析真实人物的声音,再将其声音特征应用到合成语音中。
首先,克隆声音的人必须提供一段简短音频样本。AI 模型会利用该样本识别此人的口音、音高、音调和节奏,并用这些特征创建其声音的数字副本。用户可通过文本转语音技术,用这种声音生成新的语音。
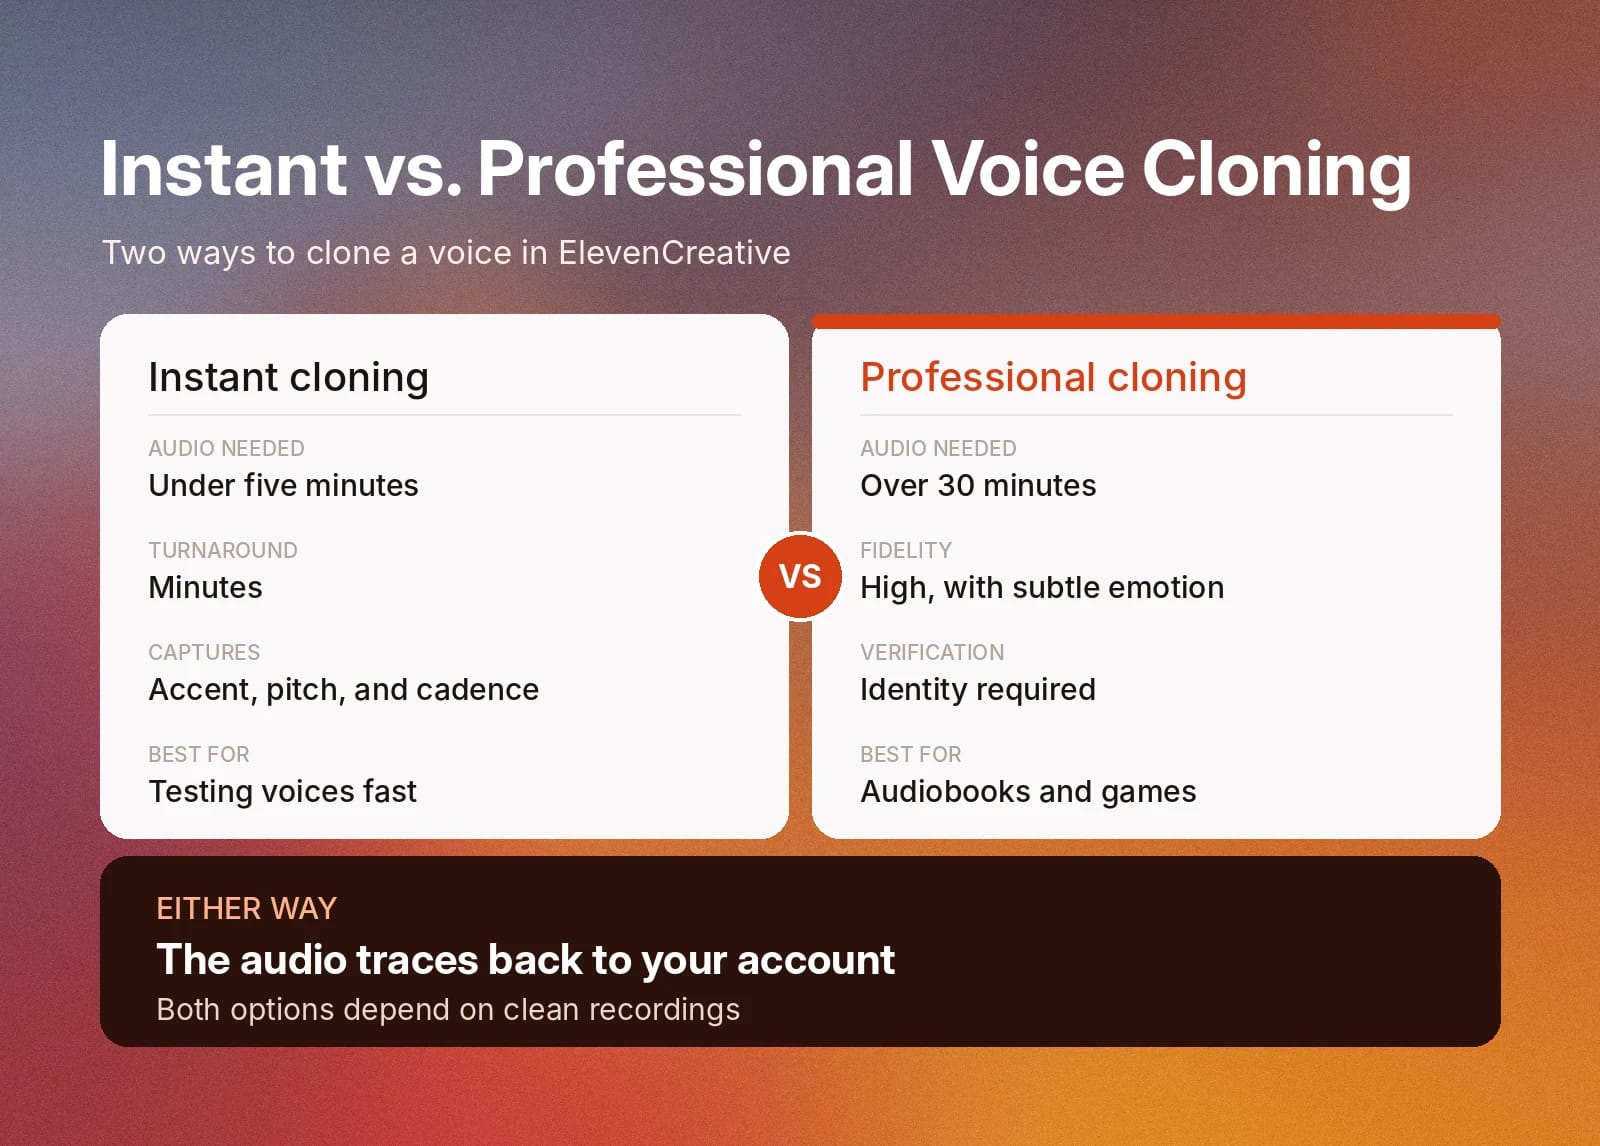
语音克隆分为两类:即时和专业。即时克隆使用不足 2 分钟的样本音频创建声音副本,便于在投入大型项目之前测试声音选项。
专业克隆使用 30 分钟至 3 小时的音频样本,创建高保真语音克隆。专业语音克隆能保留即时克隆没有的情绪、语调等细微细节,还需要进行身份验证。
语音克隆有多种应用场景,从快速生成旁白配音到保护声音,避免它们消失。
如何为语音合成录制优质声音样本
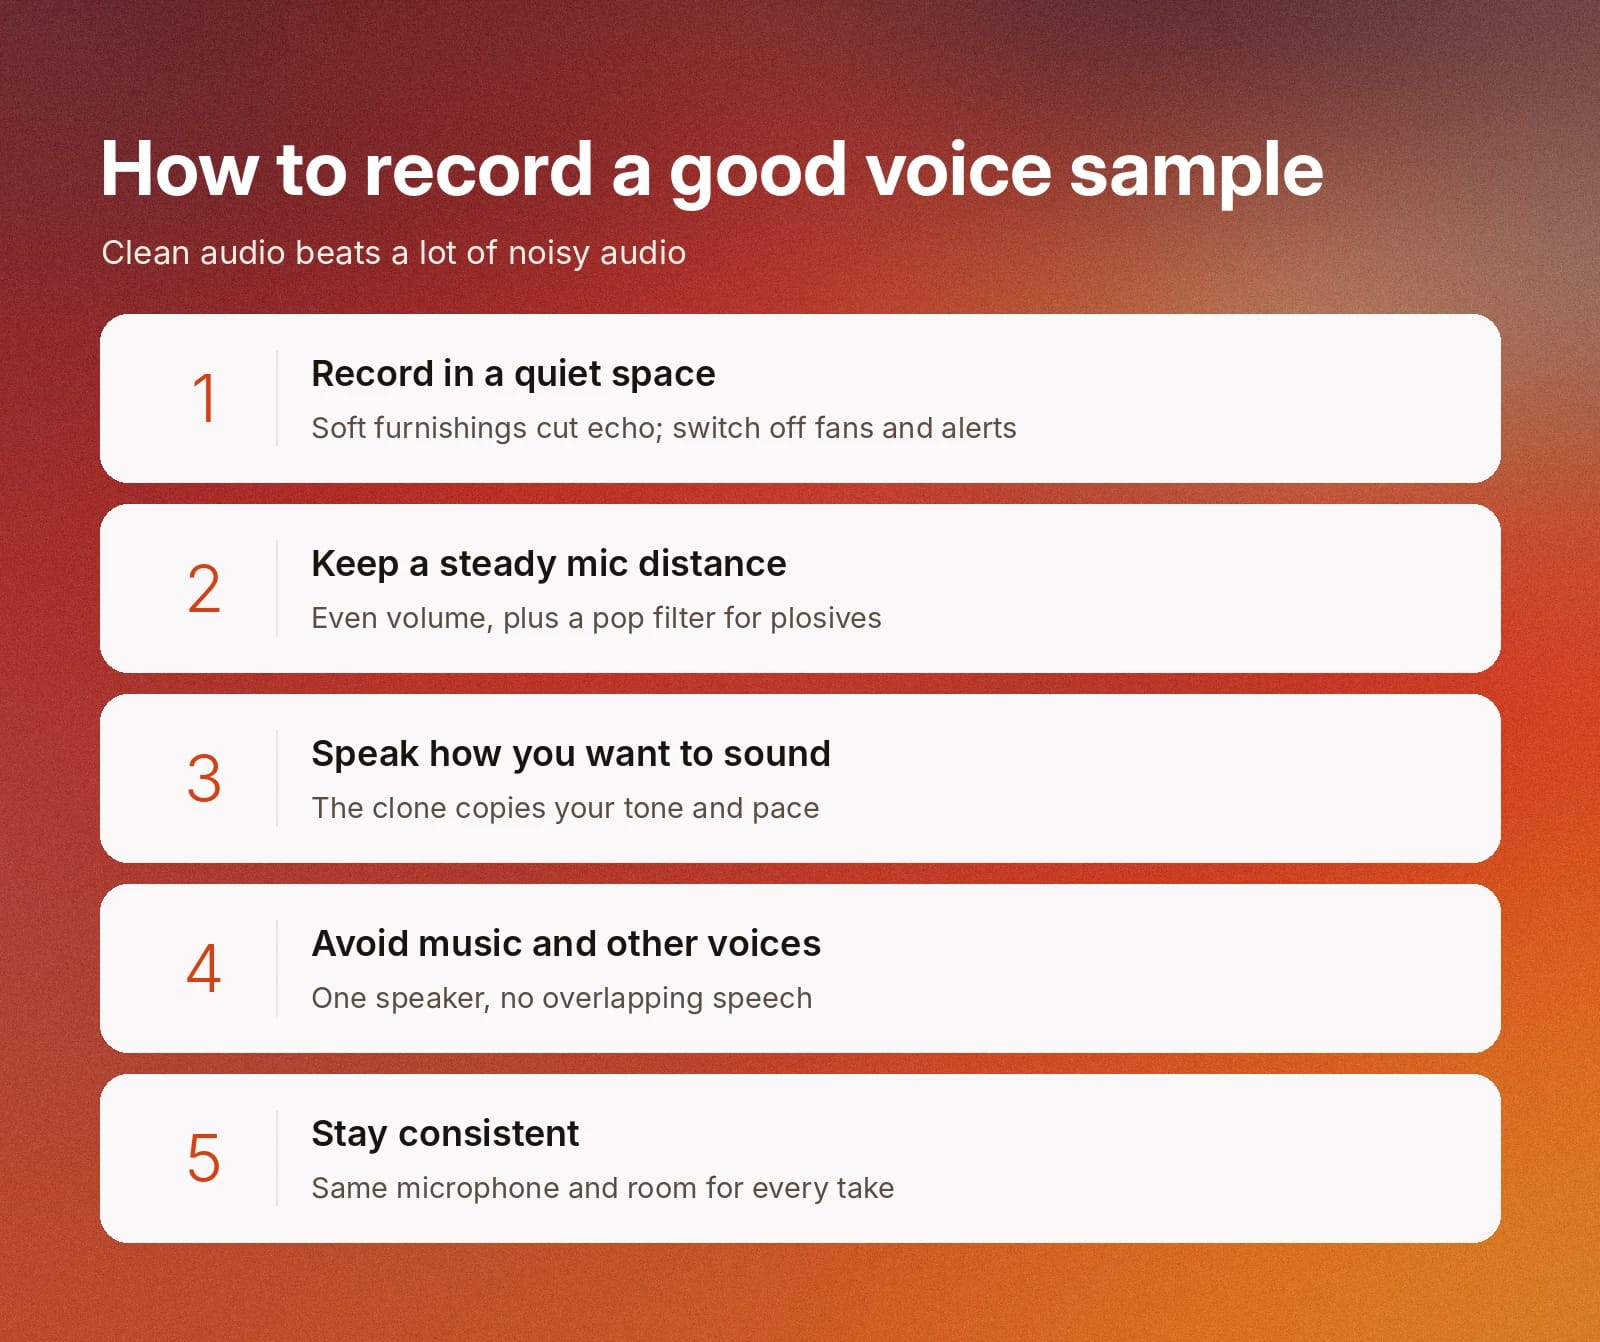
语音克隆的质量取决于录音质量。即使没有昂贵的录音设备,也能通过许多小细节改善语音克隆效果。
以下习惯有助于录制清晰的样本:
- 在安静环境录音:窗帘、地毯等软装可减少回声,关闭风扇和通知则可消除背景噪音。
- 保持麦克风距离稳定:稳定的距离能让音量保持均匀,防喷罩可减少刺耳的爆破音。
- 按照希望克隆呈现的方式说话:克隆会复制你的表达方式。请用计划使用的语气和语速录音。
- 避免音乐和其他人声:只使用一个说话者,不要有背景音乐或重叠语音。
- 保持一致:所有录音使用同一支麦克风和同一个房间。
即时克隆所需音频较少,专业克隆需要更多,但两者都依赖清晰录音。时长合适的清晰音频比大量嘈杂音频效果更好。
无需录音即可创建声音:声音设计
并非每种合成语音都从录音开始。使用声音设计,你可以通过文字描述所需声音,包括年龄、性别、口音、音调和语速等细节,AI 模型会生成符合描述的声音选项。你可以试听这些选项,选择喜欢的声音并保存到声音库。
当你需要为角色、品牌或产品创建声音,却没有真人可供克隆时,声音设计非常实用。阅读声音设计文档,了解如何编写有效的声音描述。
如何判断语音是否由 AI 生成
没有任何单一特征能证明语音由 AI 生成。与其只依赖其中一种方法,不如结合仔细聆听、检测工具和核查音频来源,效果更好。
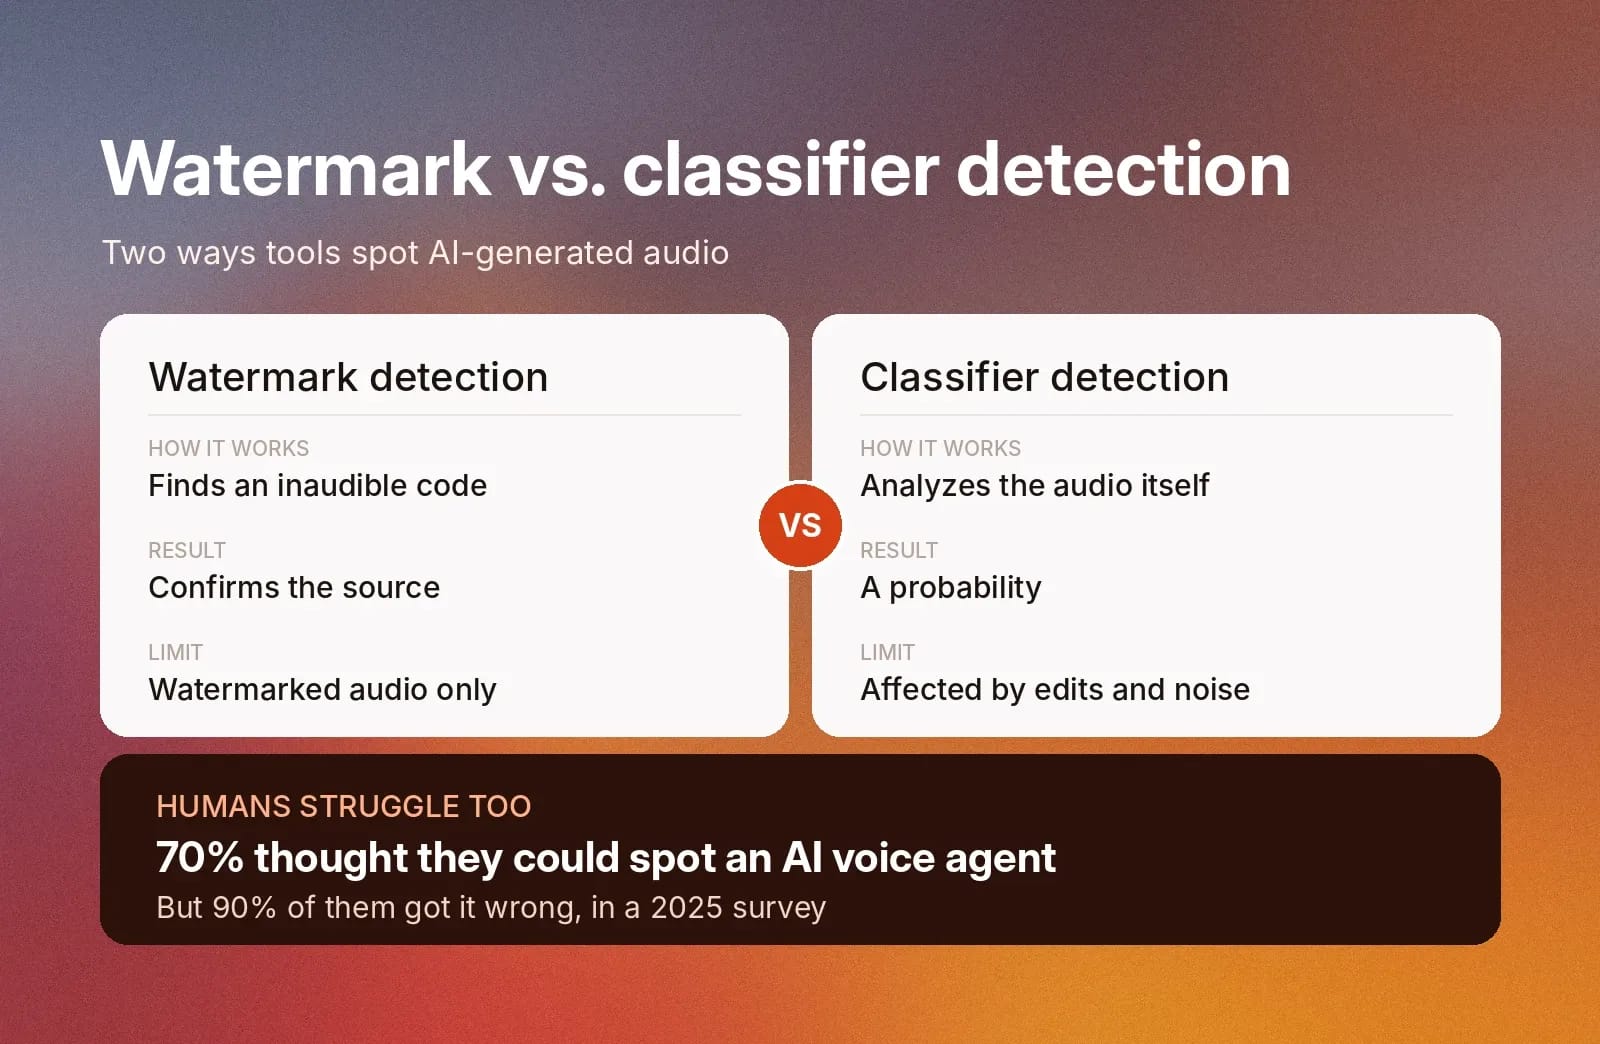
许多人认为自己能分辨真实语音与 AI 生成语音,但并不总是判断正确。一项 2025 年调查发现,70% 的消费者认为自己能正确识别AI 语音智能体,但其中 90% 未能正确识别。
与其依赖人耳,不如使用检测工具。检测工具主要通过两种方式工作:
- 水印检测:一些 AI 提供商会在生成的音频中嵌入人耳无法听见的代码水印。检测器可以找到水印并确认音频来源。这种方法仅适用于带有水印的音频。
- 基于分类器的检测:分类器会分析音频,并估算其由 AI 生成的概率。它可以标记没有水印的音频,但结果只是概率,并可能受压缩、背景噪音或编辑影响。
两种方法都不完美。应将检测结果视为一项证据,并结合你对来源的了解进行核查。我们撰写了音频深度伪造检测指南,其中有更详细的说明。
ElevenLabs Speech Classifier 是一款用于识别音频样本由 ElevenLabs AI 语音模型生成概率的工具。ElevenLabs 还与 Reality Defender 合作开展深度伪造检测计划,识别并防范语音欺诈。
需要留意什么
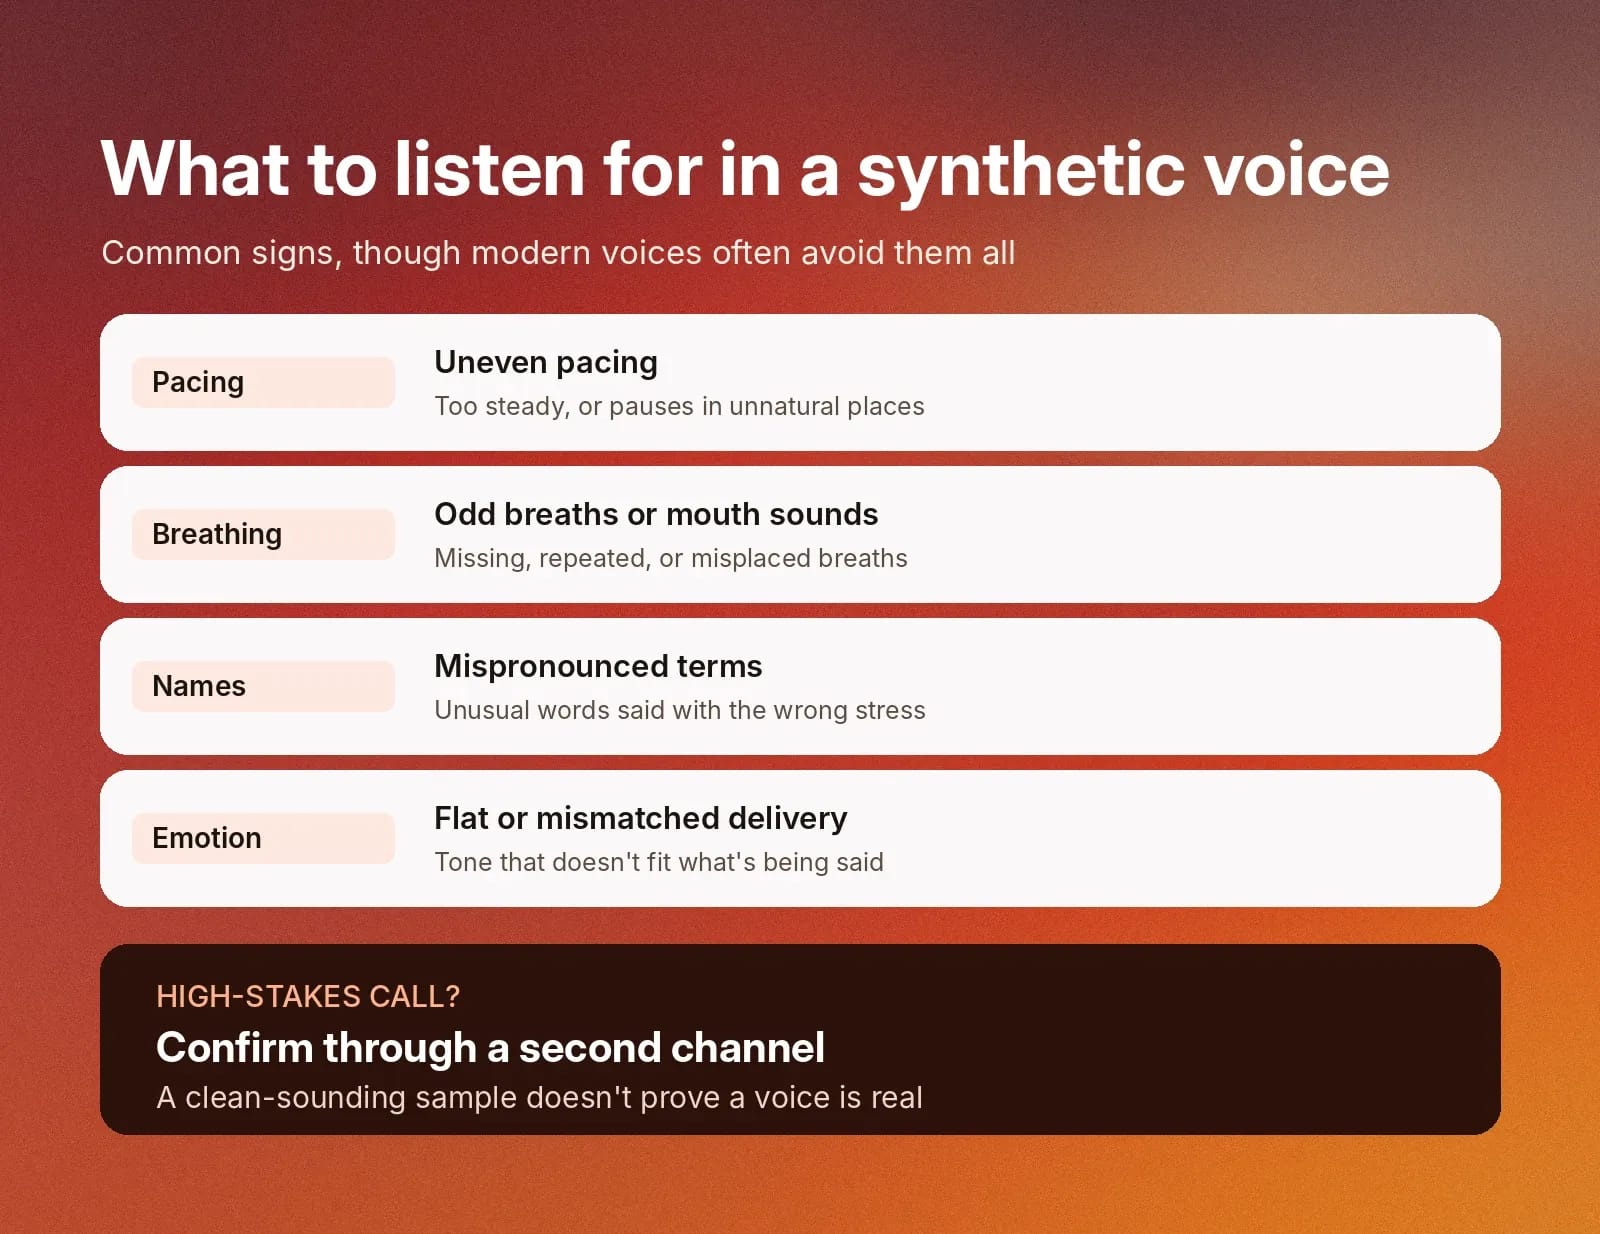
检测工具并不总在手边,因此了解合成语音的常见迹象也很有帮助。
请留意:
- 语速不均:语音过于匀速,或在不自然的地方停顿。
- 异常的呼吸声或口腔声:呼吸声缺失、重复或位置不当。这可能表明模型无意中生成了音频伪影。
- 人名或术语发音错误:不常见词语的重音不正确。在西班牙语等使用重音符号强调词中某些音节的语言里,这种情况更常见。
- 情绪平淡或不匹配:表达方式不符合词语含义。这表明对文本本身缺乏理解,是旧式 TTS 模型的常见问题。
现代合成语音通常能避免这些问题。听起来清晰的样本并不能证明声音真实。对于涉及重要事项的情况,例如索要钱财的来电,应通过第二个渠道确认。
使用 ElevenCreative 打造自定义语音体验
ElevenCreative 可帮助你为创意项目打造自定义语音体验。可从包含超过 20,000 种预制声音的丰富声音库中选择,或通过精准、安全的语音克隆创建自己的声音。
使用 ElevenCreative,通过即时语音克隆或专业语音克隆复现声音。即时语音克隆可在数分钟内完成,帮助你测试声音选项或快速启动个人项目。专业语音克隆使用更长的音频样本,创建高质量声音,适用于有声书、电子游戏或播客等长期项目。无论选择哪种方式,出于安全考虑,音频均可追溯至账户。
ElevenCreative 的可自定义声音库和语音克隆工具可助你实现创意项目。注册 ElevenCreative,探索标志性声音或创建自己的声音。
常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。