音频深度伪造检测:原理及如何验证 ElevenLabs 音频
- 发布时间
音频深度伪造检测是通过分析语音音频,判断语音是否真实的过程。能生成深度伪造内容的 AI 语音合成器越来越容易获取。无论在公共生活还是商业领域,快速识别听到的语音是真实的,还是遭不法分子篡改,已变得非常重要。
本文将介绍音频深度伪造检测的工作原理、不同检测类型及其优缺点,以及如何将深度伪造检测整合到大规模反欺诈技术体系中。
摘要
- 仅靠人耳越来越难识别深度伪造合成语音。它对公共生活和商业领域都构成重大风险。
- 深度伪造检测软件有多种类型。传统工具通过统计分析,评估音频样本由 AI 生成的概率。
- 新型水印技术可明确判断语音样本是否由合成生成。
- 水印的准确性很高,但检测器只能检测各提供商自己的音频。例如,ElevenLabs 的 Audio Detector 能高准确度识别自家产品生成的水印,但无法识别其他公司的水印。
- 对于需要大规模检测深度伪造内容的组织来说,水印是一项重要资源,但应只是其深度伪造检测体系中的多种工具之一。
什么是音频深度伪造检测?
音频深度伪造检测是判断语音音频是否由人工智能生成或篡改的过程。
深度伪造是指由生成式 AI 应用创建的任何形式媒体(最常见为图像、视频或音频),目的是歪曲某人的言行。音频深度伪造有许多恶意用途,可用于诈骗、试图访问个人账户、政治宣传,或在家庭纠纷中秘密冒充配偶或家人。
根据当前趋势,最可能遭受音频深度伪造诈骗的对象包括:
- 政治人物和其他公众人物:网上有大量可用于训练的语音样本的人,其声音可能被对手或第三方深度伪造,以误导公众。
- 家庭成员:不法分子可能利用找到的语音录音,伪造索要钱财的请求来诈骗年长家庭成员。
- 企业高管:伪造的采访、演讲和财报电话会议可能被用来损害公司品牌。
- 客服团队:诈骗者可能利用收集到的语音样本,诱骗客服团队授予私人账户访问权限。
遗憾的是,人类并不擅长检测深度伪造内容。在受控研究环境中,人们识别它们的能力并不优于随机猜测,而这项研究早在 2024 年就已完成。此后,生成式媒体已经变得复杂得多。
教育和立法有助于增强社会抵御深度伪造影响的能力,但可靠的检测方法仍不可或缺。
音频深度伪造检测如何运作?
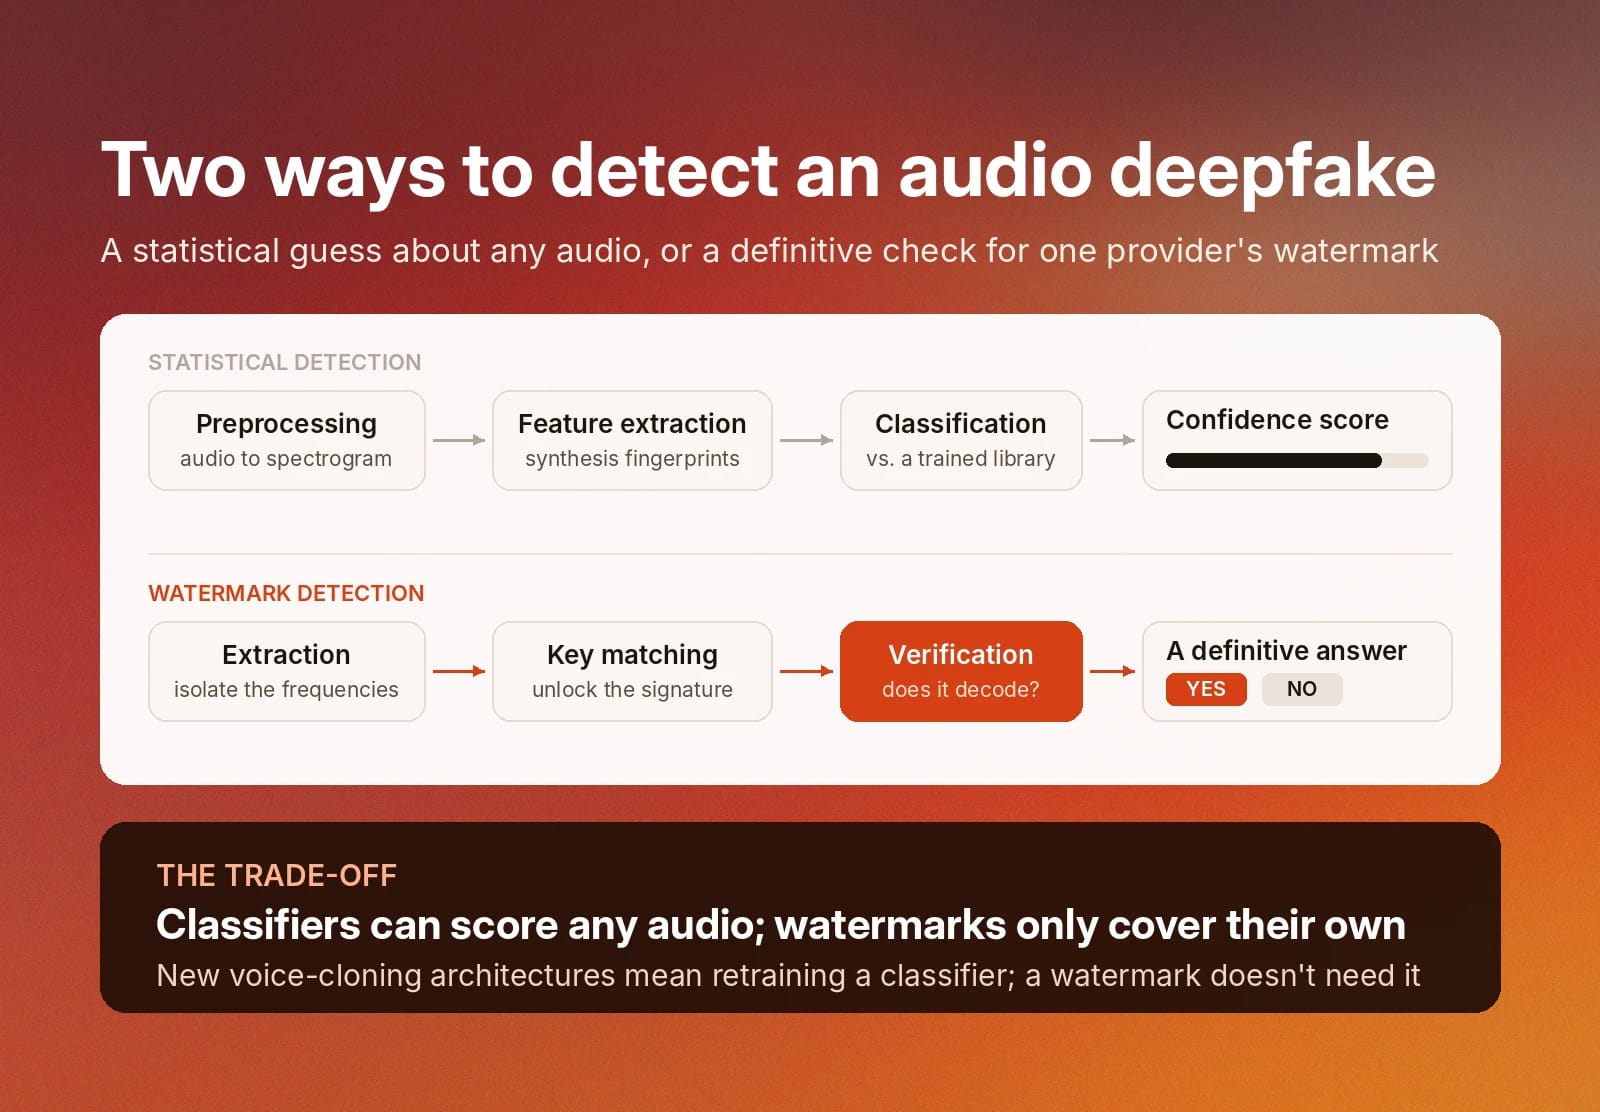
传统深度伪造检测通过统计分析,衡量媒体由 AI 生成的概率。检测工具利用机器学习技术识别不同类型合成语音的底层模式。
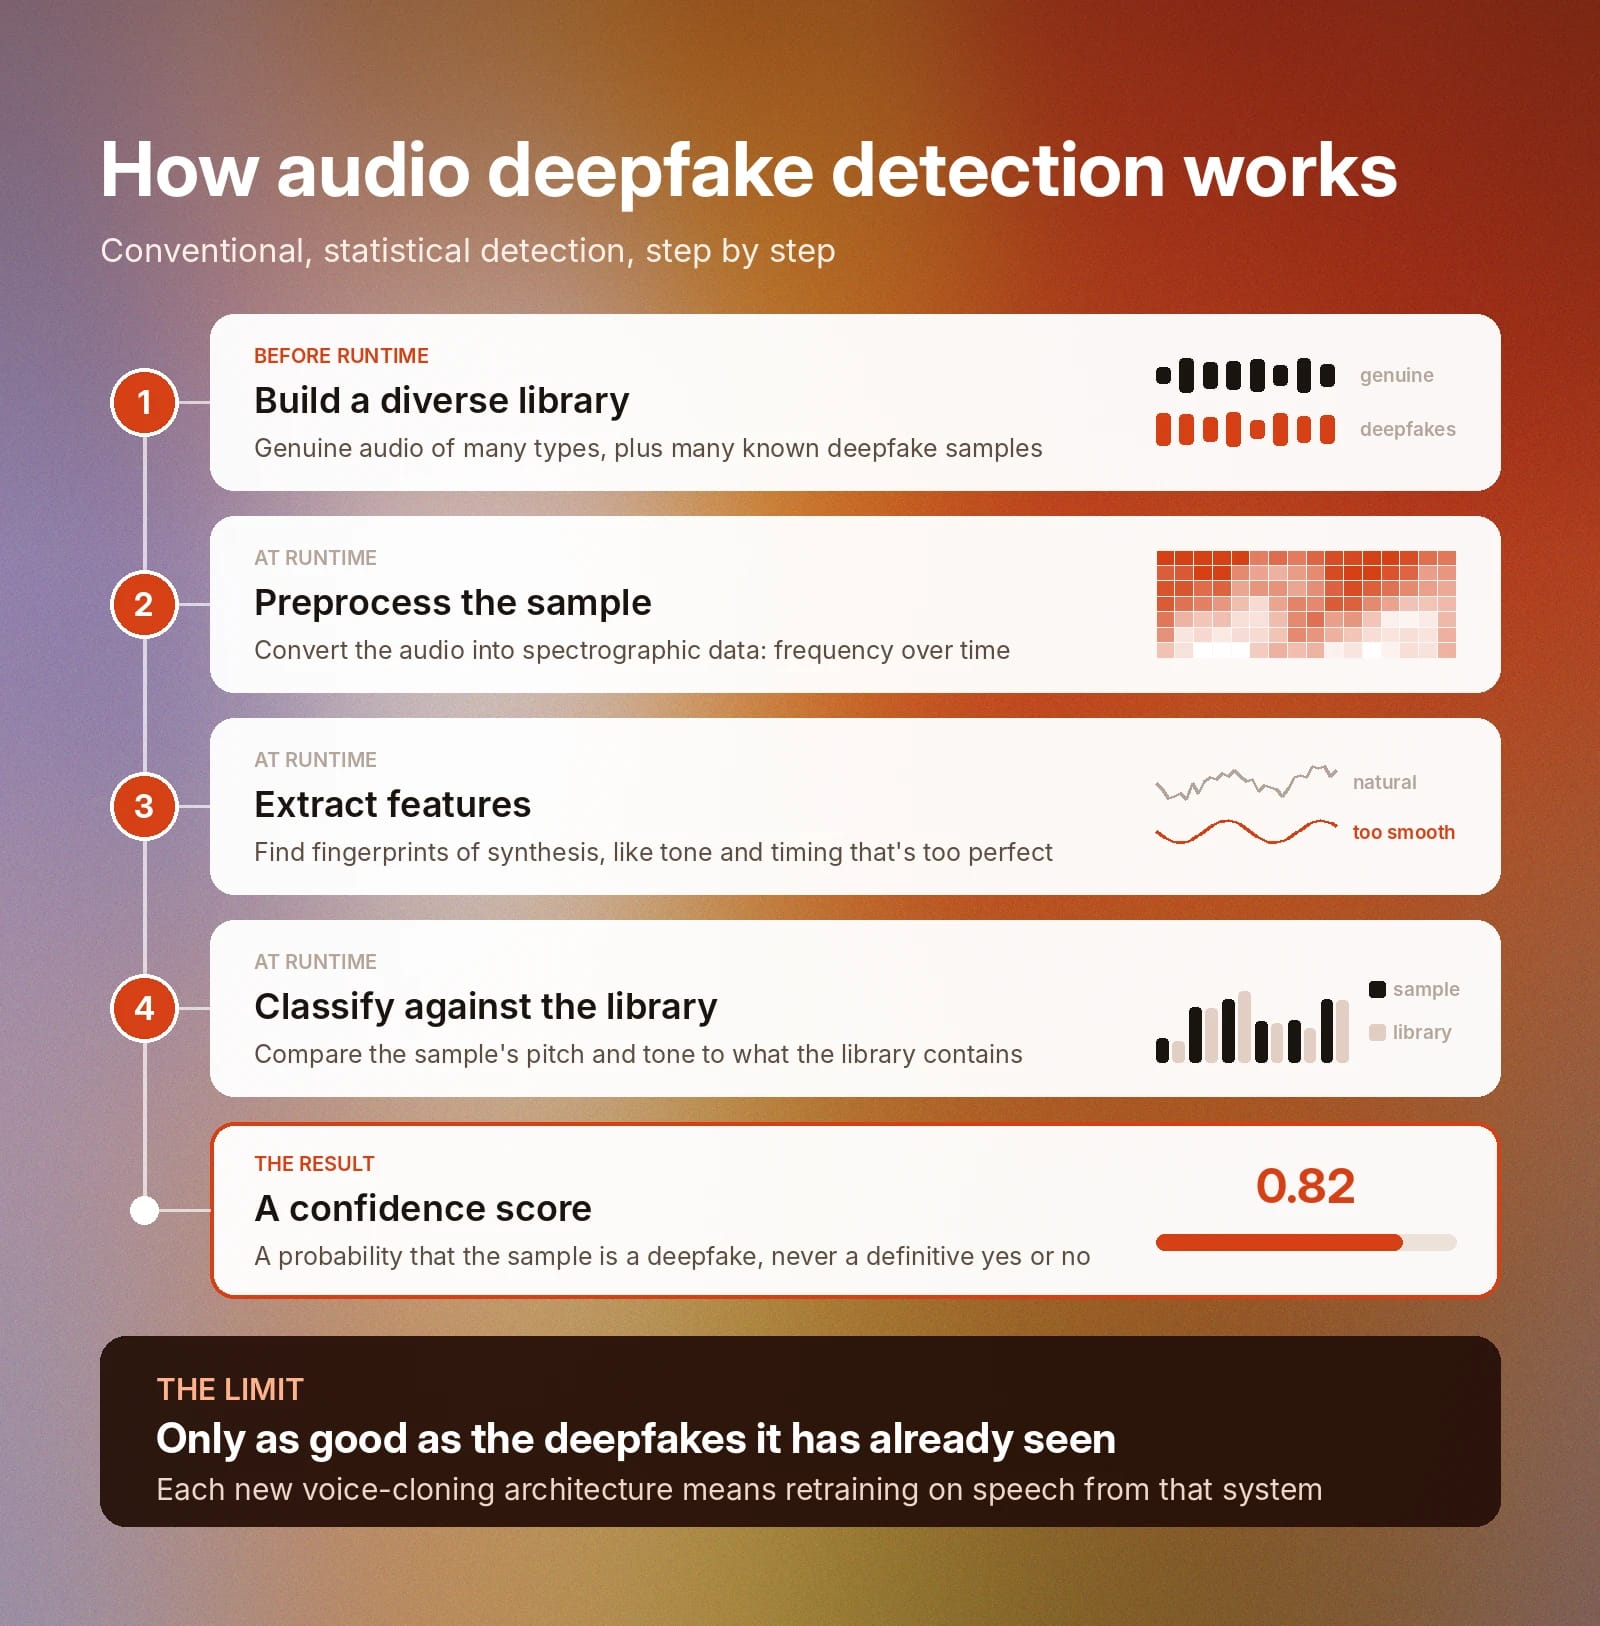
第一步是建立音频内容库,用于比对疑似深度伪造内容。该数据集应具备多样性,包含各种类型的真实音频样本和大量已知深度伪造样本,以帮助做出准确检测。
运行时,它会经过三个阶段:预处理、特征提取和分类。
音频预处理
将音频样本提供给训练完成的检测工具后,工具会将其转换为频谱数据,即频率随时间变化的数学表示。
特征提取
接着,检测工具从样本数据中提取类似合成语音指纹的特征。例如,AI 语音有时过于完美,缺少自然语音中存在的音调和时序不规律。将说话者的音高和音色与其库进行比较,也有助于工具识别其他风险信号。
分类
由于传统深度伪造检测依靠统计分析,无法明确回答样本是否为深度伪造的“是”或“否”。相反,它会生成置信度评分,即该样本为深度伪造的概率。
传统工具衡量样本与现有音频库之间的相似度,因此会受限于可用的已知深度伪造样本。每当有人发布新的语音克隆架构,都需要用该新系统合成的语音重新训练检测工具,才能准确检测。
水印与统计检测有什么区别?
水印是一种完全不同的语音分类方法。机器学习分类器会根据训练数据中对自然语音的了解,概率性地判断样本是否真实,例如频谱数据中真实的情感力度和重音是什么样,以及哪些音调和时序变化属于自然表现。
水印具有确定性。水印是合成器嵌入音频数据中的数学签名,其强度低到人耳无法听见。水印检测器会明确验证是否找到了该隐藏签名。
检测器通过三个简单阶段运行:
- 提取:工具提取频谱数据,并分离出预计包含水印的频率。
- 密钥匹配:尝试使用密钥解锁该签名。
- 验证:如果信号正确解码,工具会确认相关AI 语音生成器生成了该音频。
ElevenLabs 的水印检测流程
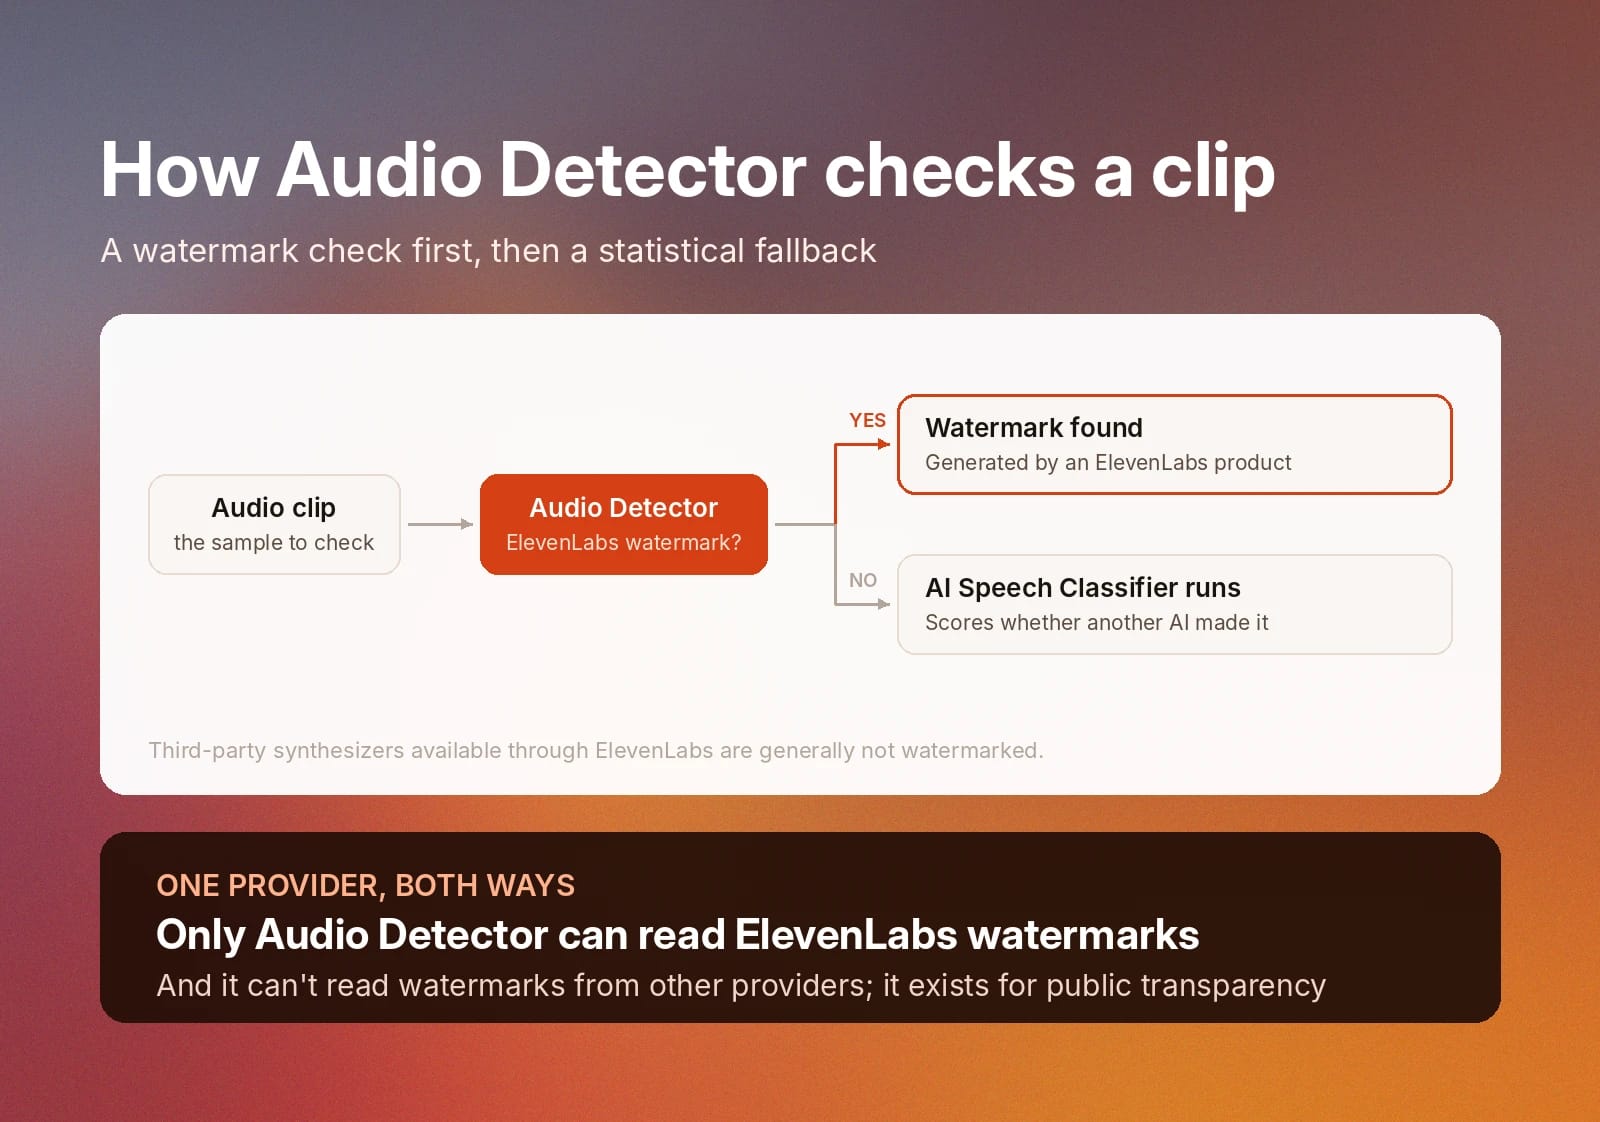
ElevenLabs 的水印工具是 Audio Detector。它会扫描音频样本,并验证内容是否由 ElevenLabs 产品生成。如果未找到水印,随后会运行统计型 AI Speech Classifier,评估音频是否由其他来源的 AI 生成。
由于水印的工作方式,ElevenLabs Audio Detector 只能检测由 ElevenLabs 生成的音频。目前无法识别其他 AI 语音提供商的水印。
反过来,也只有 ElevenLabs 的 Audio Detector 能检测 ElevenLabs 水印。
还请注意,通过 ElevenLabs 提供的任何第三方合成器生成的内容通常不带水印。
检测 ElevenLabs 生成音频的其他方式
ElevenCreative AI Speech Classifier可免费使用,无需登录。它会分析音频样本的前 1 分钟,并提供该音频由 ElevenLabs 模型生成的可能性置信度评分。
请注意,它无法可靠地分类 Eleven v3 音频。它最适合分类由较早版本 ElevenLabs TTS模型生成的音频。分析经过大量压缩或编辑的语音内容时,准确率也会下降。
如何大规模检测合成语音?
一些商业团队需要近乎实时地大规模检测深度伪造内容。以某家全国性银行的客服团队为例。其客服代表每天要与数千名客户沟通,团队成员必须定期共享和更新私密账户数据。
该团队的管理层非常关注能多快识别欺诈来电者,同时响应合法客户。他们需要一套语音检测体系,能在客户通话期间实时识别所有主流语音生成引擎生成的音频。
构建完整的语音检测体系
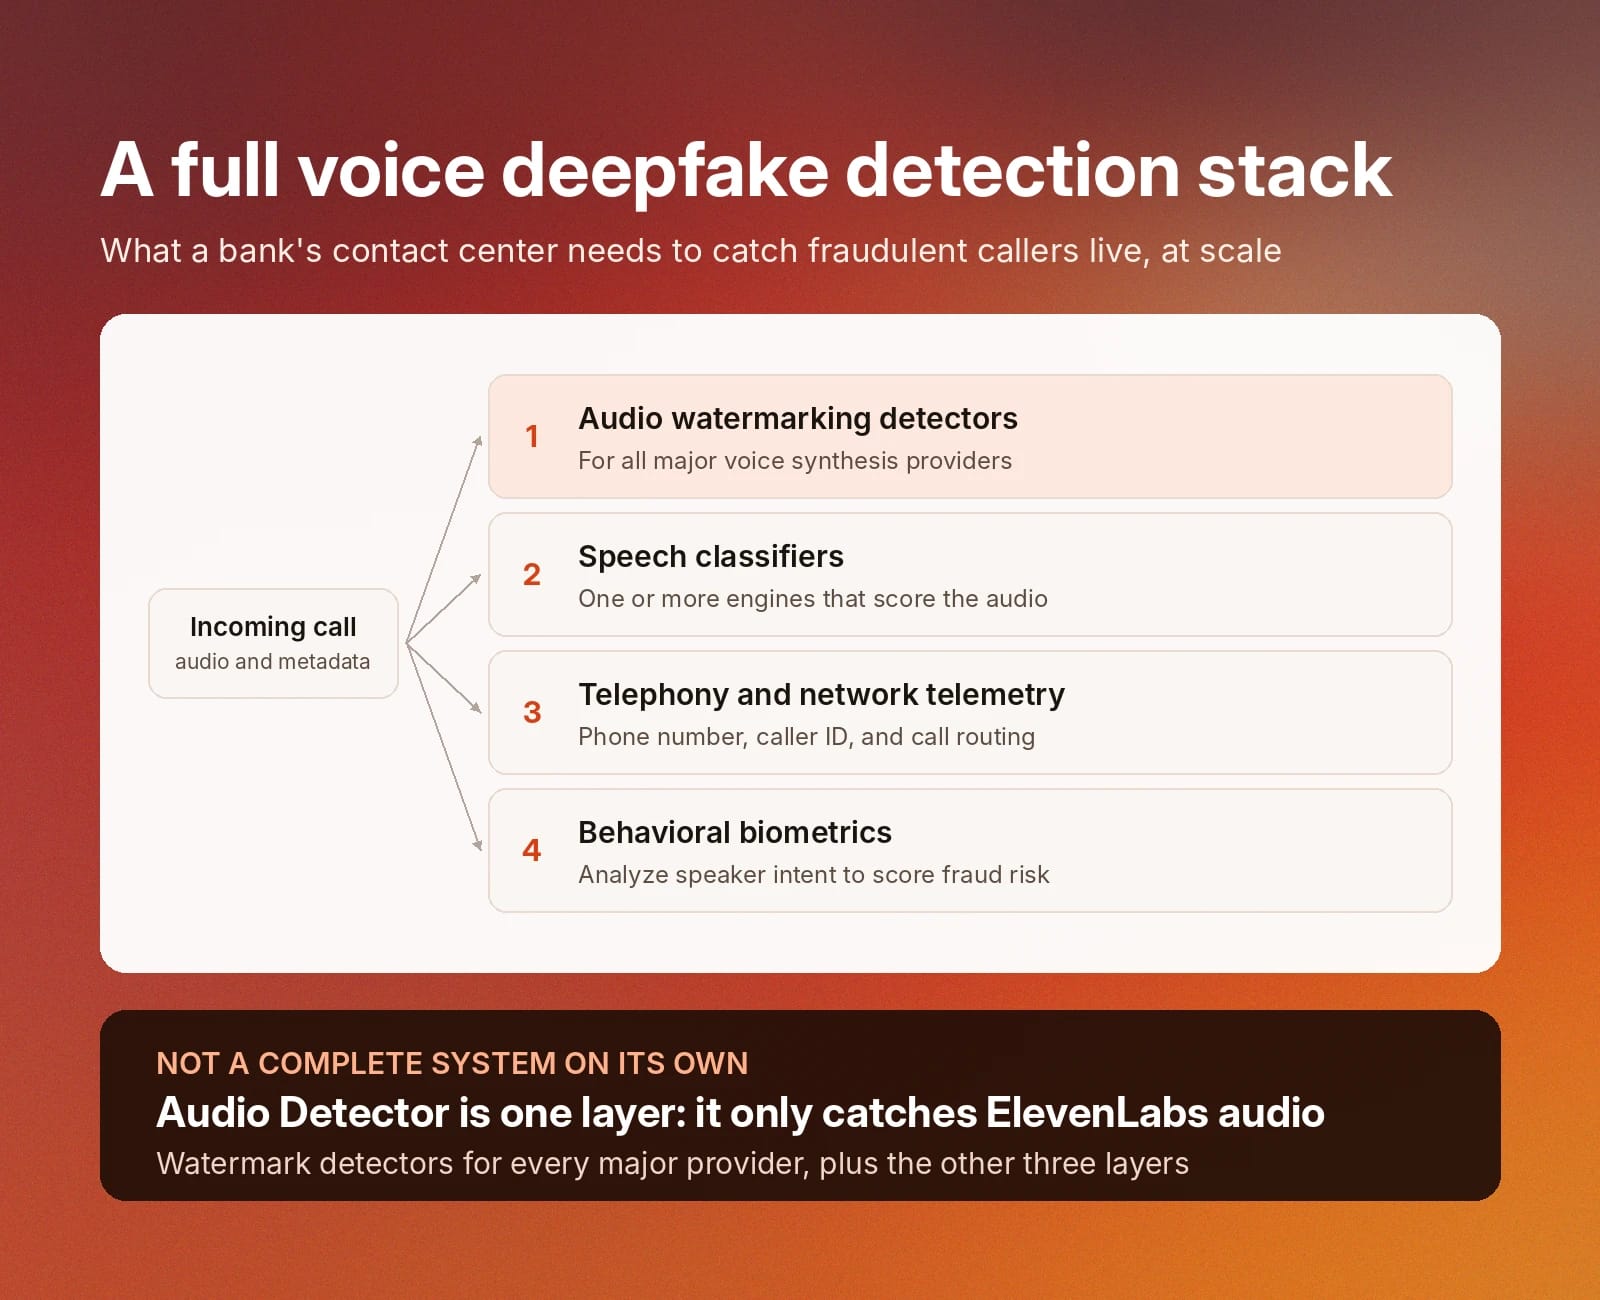
ElevenLabs 的 Audio Detector 在此发挥重要作用,但再次强调,它只能检测带有 ElevenLabs 水印的音频。仅靠它并不是完整的语音检测系统。希望获得全面语音检测能力的组织,需要组合多种不同工具:
- 音频水印检测器:覆盖所有主流语音合成提供商。
- 语音分类器:一个或多个可为音频数据评分的分类引擎。
- 电话和网络遥测:用于分析电话号码、来电显示和通话路由等通话元数据。
- 行为生物识别:分析说话者意图、评估欺诈风险的软件。
开始使用 ElevenLabs 深度伪造检测
ElevenLabs 致力于通过实用的语音生成服务,以及为公众提供识别深度伪造和其他恶意使用 AI 生成音频的工具,为公共生活作出积极贡献。
有想检测是否为深度伪造的音频片段吗?立即注册试用 ElevenLabs Audio Detector,或开始使用 AI Speech Classifier。
常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。