文本转语音技术原理:从文本到自然语音
- 发布时间
文本转语音(TTS)技术可将书面文字转换为语音音频。系统先理解文本内容及其应有的发音方式,再由 AI 模型生成音频。
首先,TTS 引擎会规范化文本输入,并将其转换为计算机系统可处理的数学 token 和向量表示。随后,模型将这些数学结构转换为声音的数字表示,最终输出音频。
本文将介绍不同文本转语音工具的工作原理,以及新一代生成式 AI 神经语音合成如何带来更自然的语音。
摘要
- 文本转语音系统分两步将书面文字转换为音频:先将文本转换为 token,即语言的数学表示;再将 token 转换为声学表示,并输出为声音。
- 新一代神经 TTS 引擎使用 AI 模型生成自然语音。业务团队可将其用于内容创作、字幕制作,以及为客户支持智能体提供语音能力。
- 发音词典和音标标记可微调 TTS 输出,使语音尽可能自然,并确保专业术语和名称发音正确。
- 通过文本转语音 API,可将业务应用连接至高质量语音生成能力。
什么是 TTS?文本转语音技术如何工作
文本转语音会分析书面文本,决定每个词的发音方式,再借助神经模型和声码器生成语音音频。
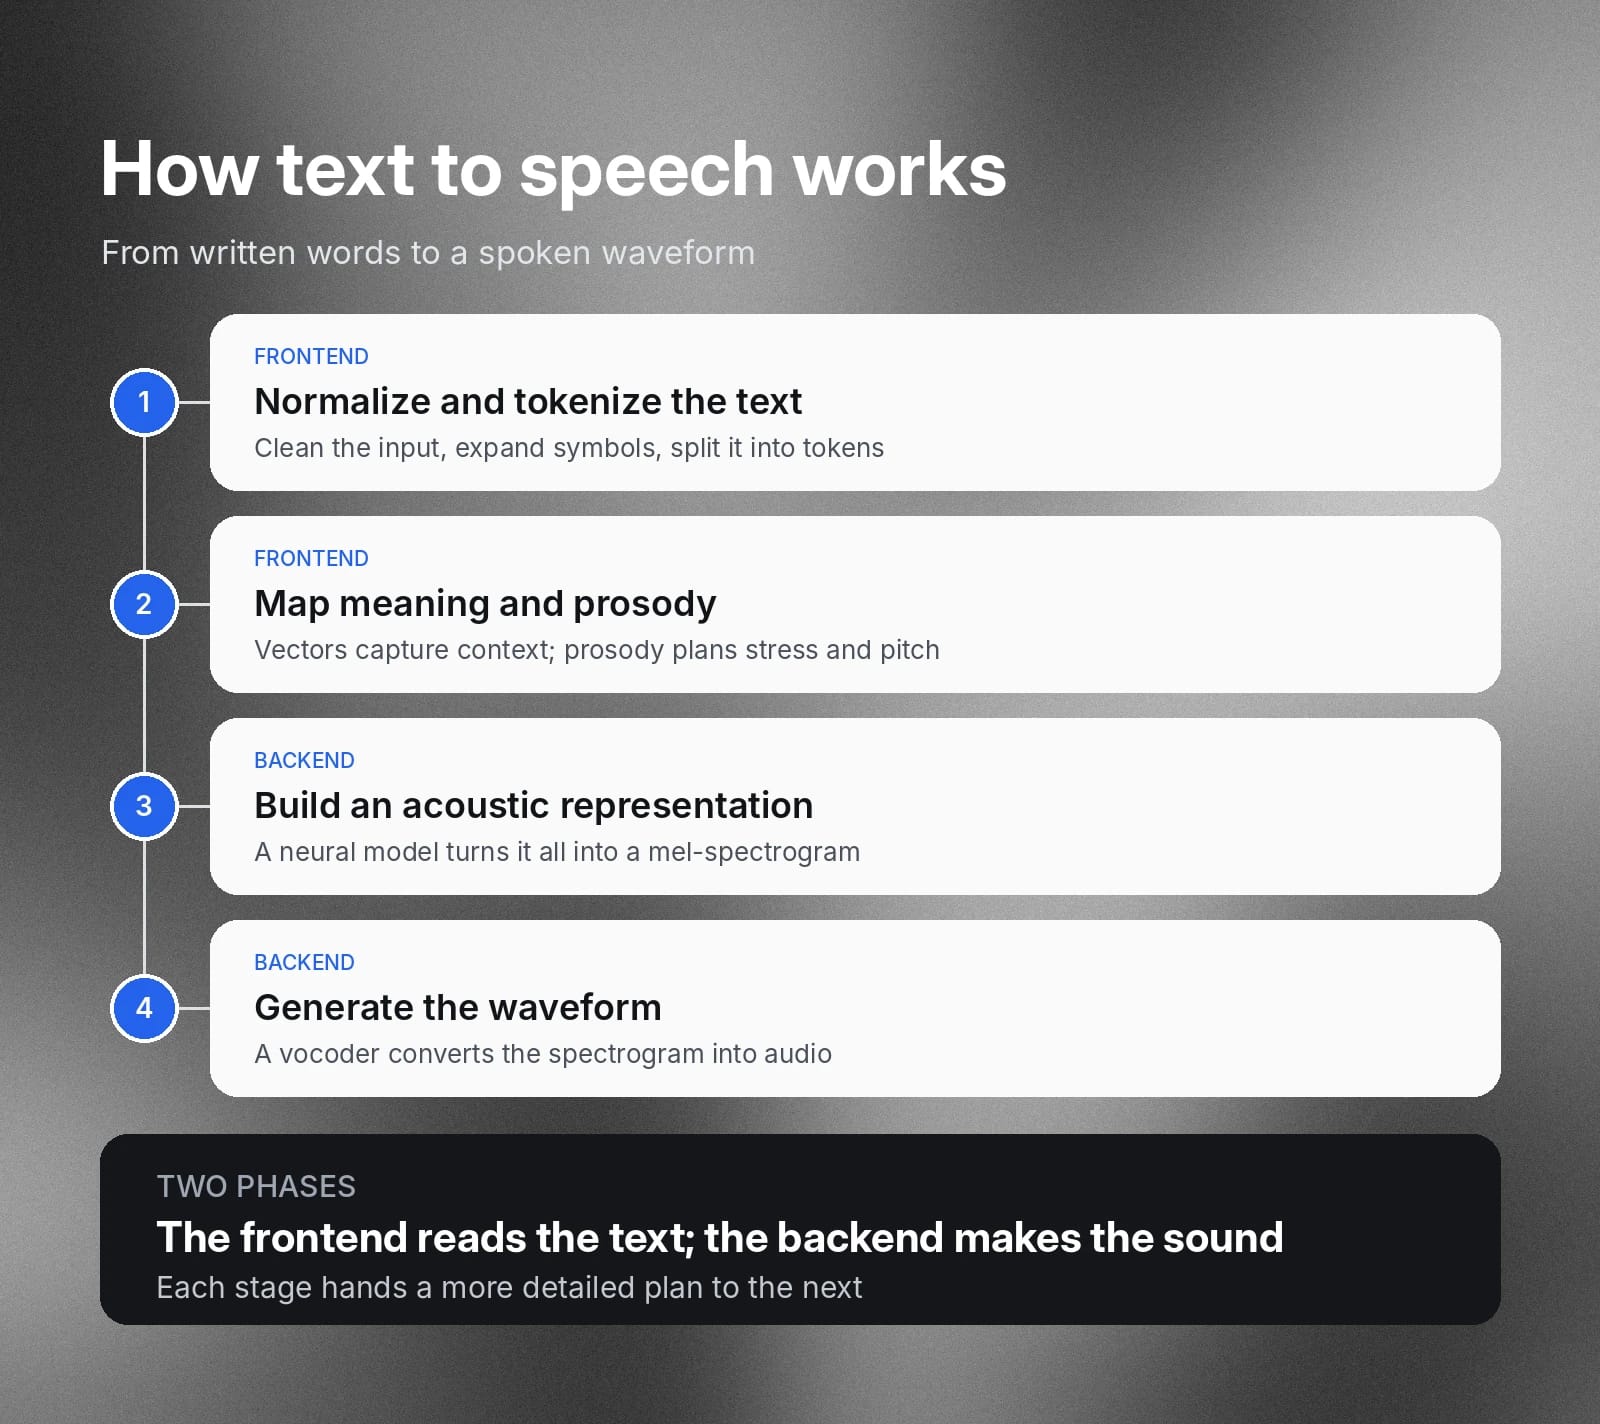
TTS 大致分为两个阶段:
- 前端:系统将文本转换为 TTS 引擎可处理的数学形式。
- 后端:系统接收第一阶段的输出,并将其转换为模拟语音的波形。
下面详细拆解 TTS 的工作组件。
文本规范化与语言分析
TTS 流程的第一步是自然语言处理(NLP):清理、分词并消除原始文本输入中的歧义。它将文本拆分为 token,即 TTS 引擎可处理的书面语言基本单位。一个 token 可以是完整词语、“子词”单元或标点符号。
文本常包含缩写、数字等非完整词语的符号。TTS 引擎还需确定这些内容的读法。例如,引擎会读取“$11”,并将其转换为“十一美元”的声音。
语义与韵律
韵律指语音的音高和节奏,是让 TTS 听起来自然的关键。处理文本时,引擎还会生成一层韵律信息,将重音和语调变化映射到文本上,使语音更自然。
TTS 引擎还需根据上下文调整文本转语音的发音。它会将这些信息组织为向量表示,即用于映射词语和短语之间语义相似性的数值数据。可以把它想象成 X-Y 图中的一条线经过多个点,但映射维度远不止二维。
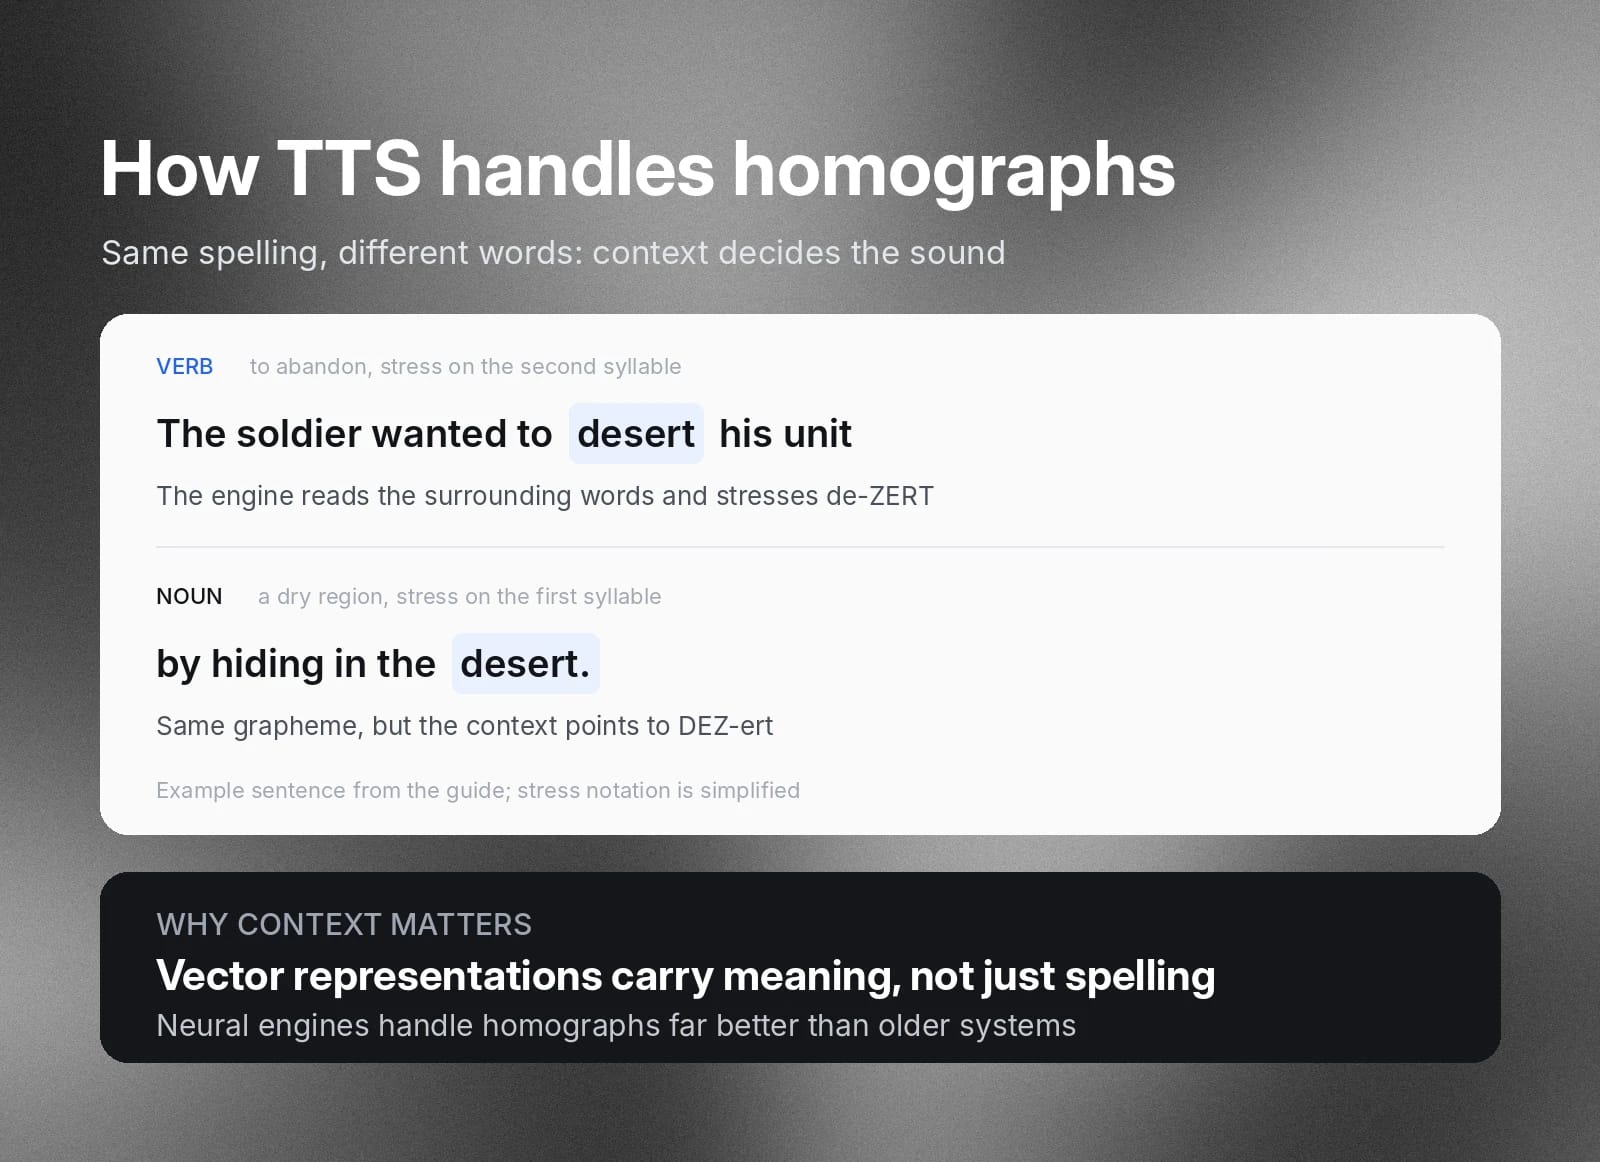
一个具体例子是同形异义词。拼写相同但含义不同的词,有时需要不同的读法。TTS 引擎需识别朗读时各词应使用的语调和重音。例如,句子“The soldier wanted to desert his unit by hiding in the desert.”中,字形“desert”应如何发音。
观看Eleven v4如何呈现这个示例。
声学建模与波形(语音)合成
TTS 引擎会将已 token 化的信息和上下文向量(现均为数值数据)转换为声学表示,例如梅尔频谱图。其中包含不同频率、能量水平,以及大脑会解读为情感的声音。过去曾使用多种系统完成此功能,如今神经模型是最有效的方法之一。
最后一步使用声码器,将这些频谱图转换为人类听众可识别为语音的音频。这个过程称为波形生成。
TTS 实际工作流程:一个示例
要了解 TTS 各阶段如何衔接,最简单的方法是跟随一个句子走完整个流程。
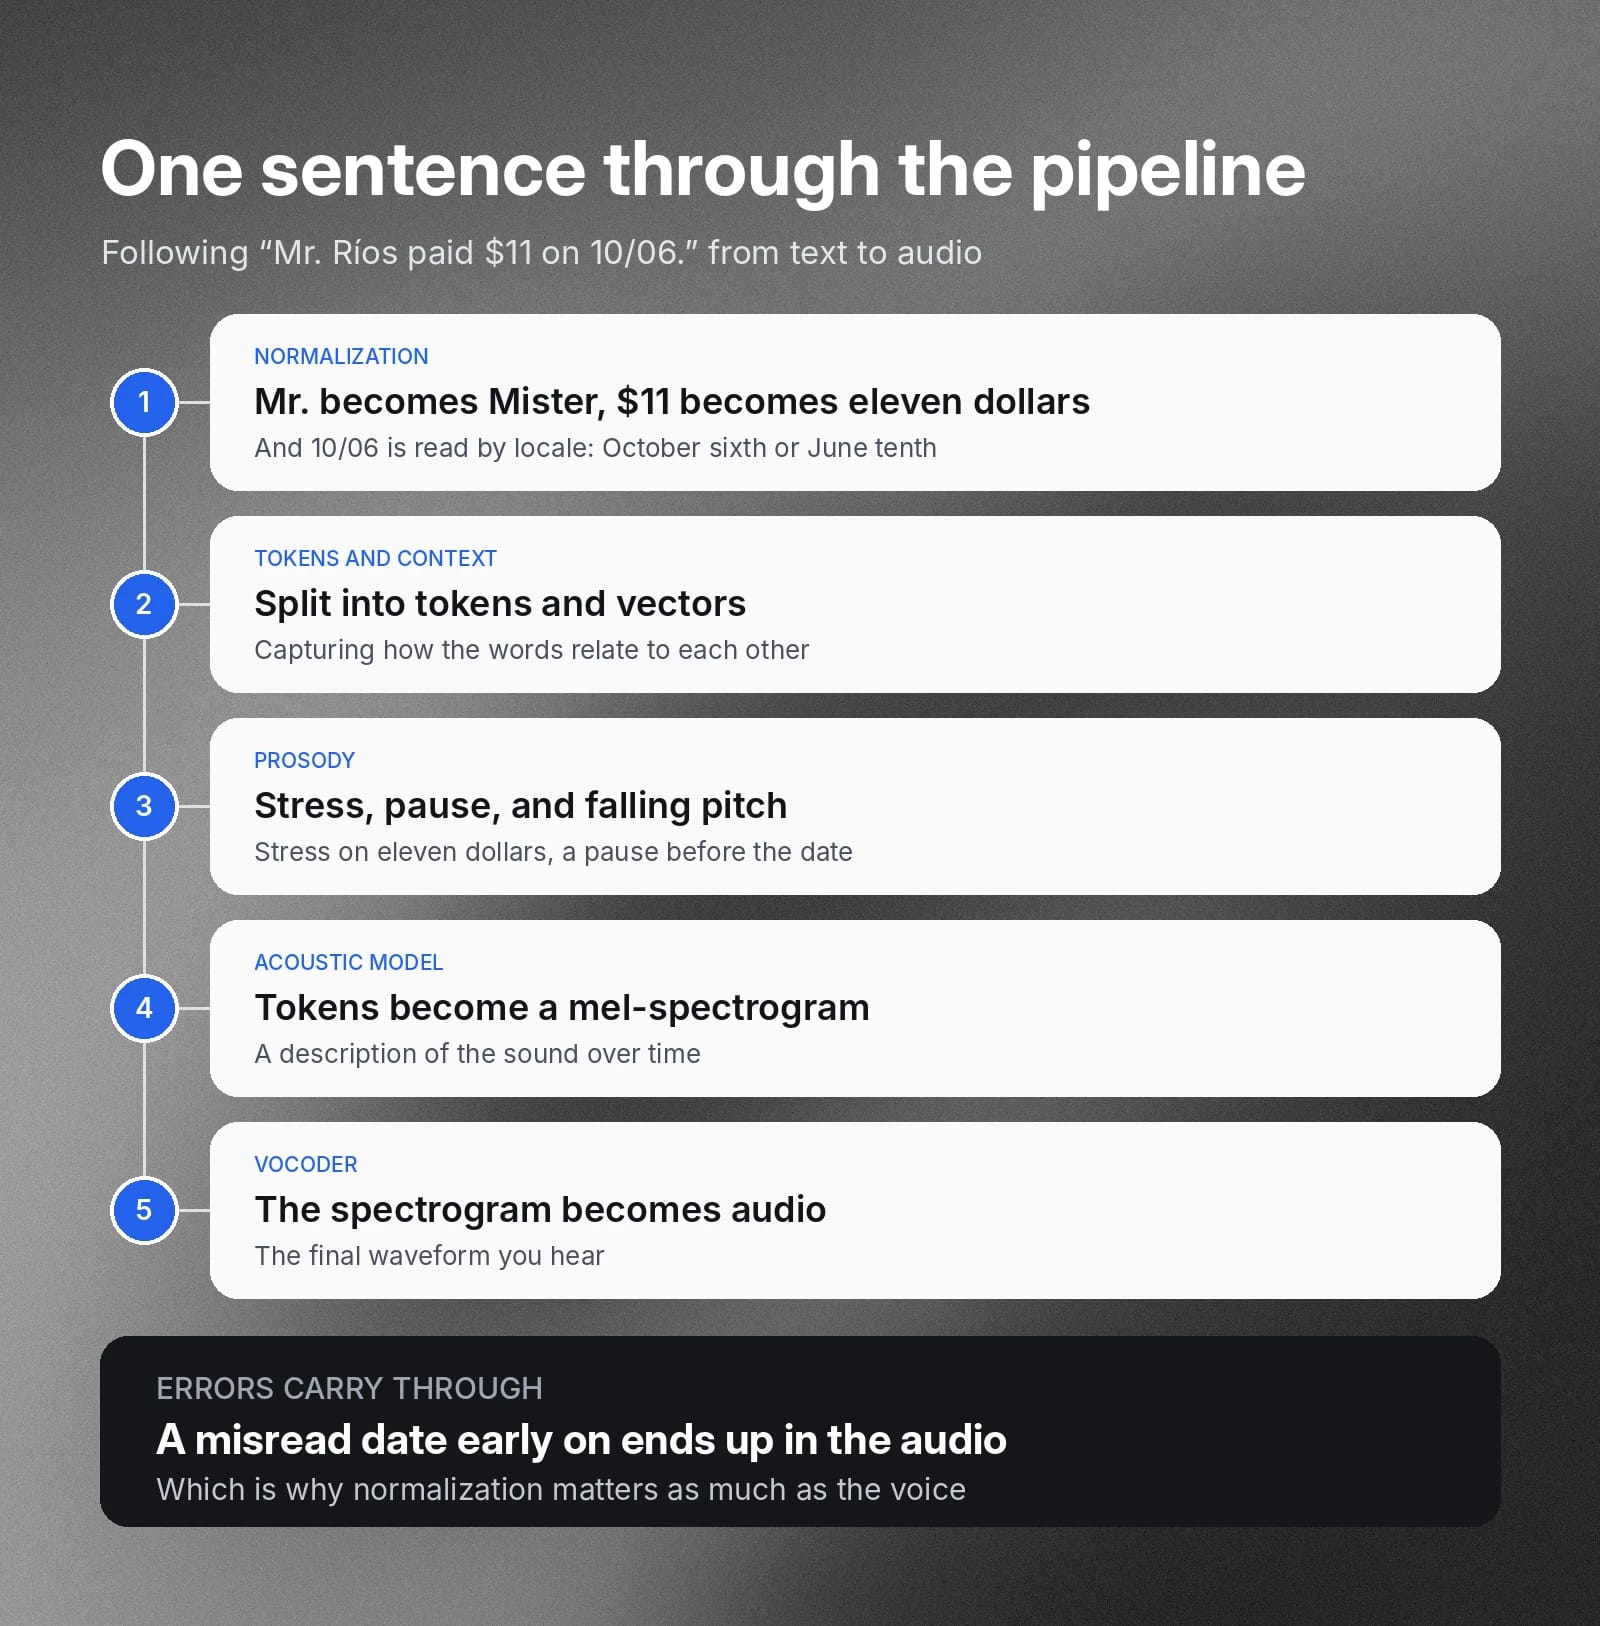
以文本“Mr. Ríos paid $11 on 10/06.”为例。
- 规范化:引擎将“Mr.”扩展为“Mister”,将“$11”读作“eleven dollars”,并根据地区和上下文判断“10/06”是“October sixth”还是“the tenth of June”。
- 分词与上下文:清理后的文本会被拆分为 token,并转换为捕捉词语关系的向量。
- 韵律:引擎会强调“eleven dollars”,在日期前短暂停顿,并在句末降低音高。
- 声学模型:神经模型将 token 和韵律方案转换为描述声音随时间变化的梅尔频谱图。
- 声码器:声码器将频谱图转换为最终听到的音频波形。
每个阶段都会向下一阶段传递更详细的方案,因此流程早期的错误(例如误读日期)会延续到最终音频中。
为什么神经文本转语音听起来更像人?
神经语音合成擅长生成自然、清晰的语音,这正是工程师评估 TTS 引擎的两项指标。神经 TTS 通过训练深度神经网络(DNN),使其根据文本输入生成语音。DNN 使用大量录音语音及对应文本进行训练。
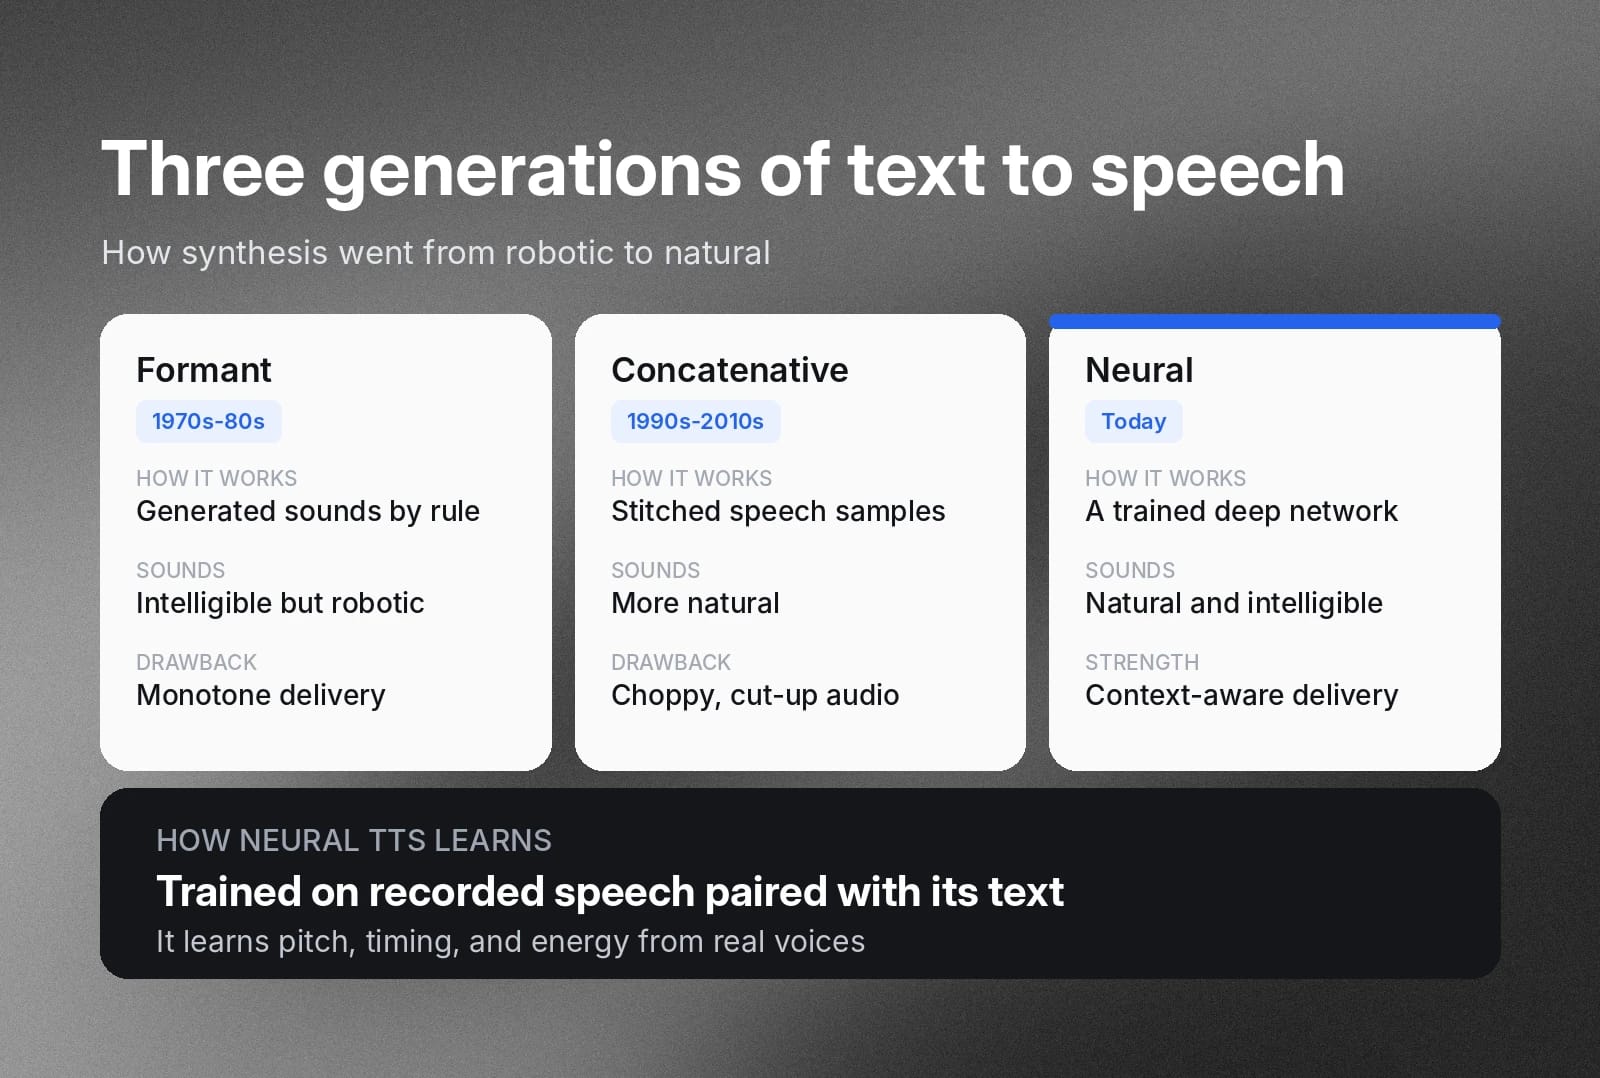
神经语音合成引擎只是企业级 TTS 的最新一代。在此之前,商业合成技术已历经两代发展。
共振峰合成在 20 世纪 70 和 80 年代占主导地位。它不采样人声用于运行时输出,而是生成模拟语音的合成声音。它虽然清晰可辨,但单调且听起来像机器人.
拼接合成在 20 世纪 90 年代至 2010 年代占主导地位,比早期共振峰系统更自然。它不根据数学规则生成音调,而是将人声的小段样本拼接起来。这些系统使用语言查找表,将规范化文本匹配至声音,再从庞大的库(即“语料库”)中提取拼接语音的小单元输出。尽管比共振峰引擎的语音自然,拼接语音仍可能显得断续、生硬。
AI 语音生成器与文本转语音有什么区别?
“AI 语音生成器”是营销中常用的术语,用于描述包括文本转语音在内的广泛语音技术。文本转语音特指以书面文本为输入,对其语义和韵律建模,并输出音频波形的系统。
AI 语音生成器是一个由相关语音技术组成的完整生态系统,包括 TTS 和用于声音设计、语音克隆和语音风格迁移的其他生成式系统。虽然营销中常将其与文本转语音互换使用,但 AI 语音生成器更适合作为一个更广泛的生成式语音工具类别,TTS 是其中的一部分。
如何将文本转语音用于内容、无障碍与支持服务
文本转语音模型已成为全球个人和商业领域工作流程的重要组成部分。
以下是文本转语音的一些主要应用场景。
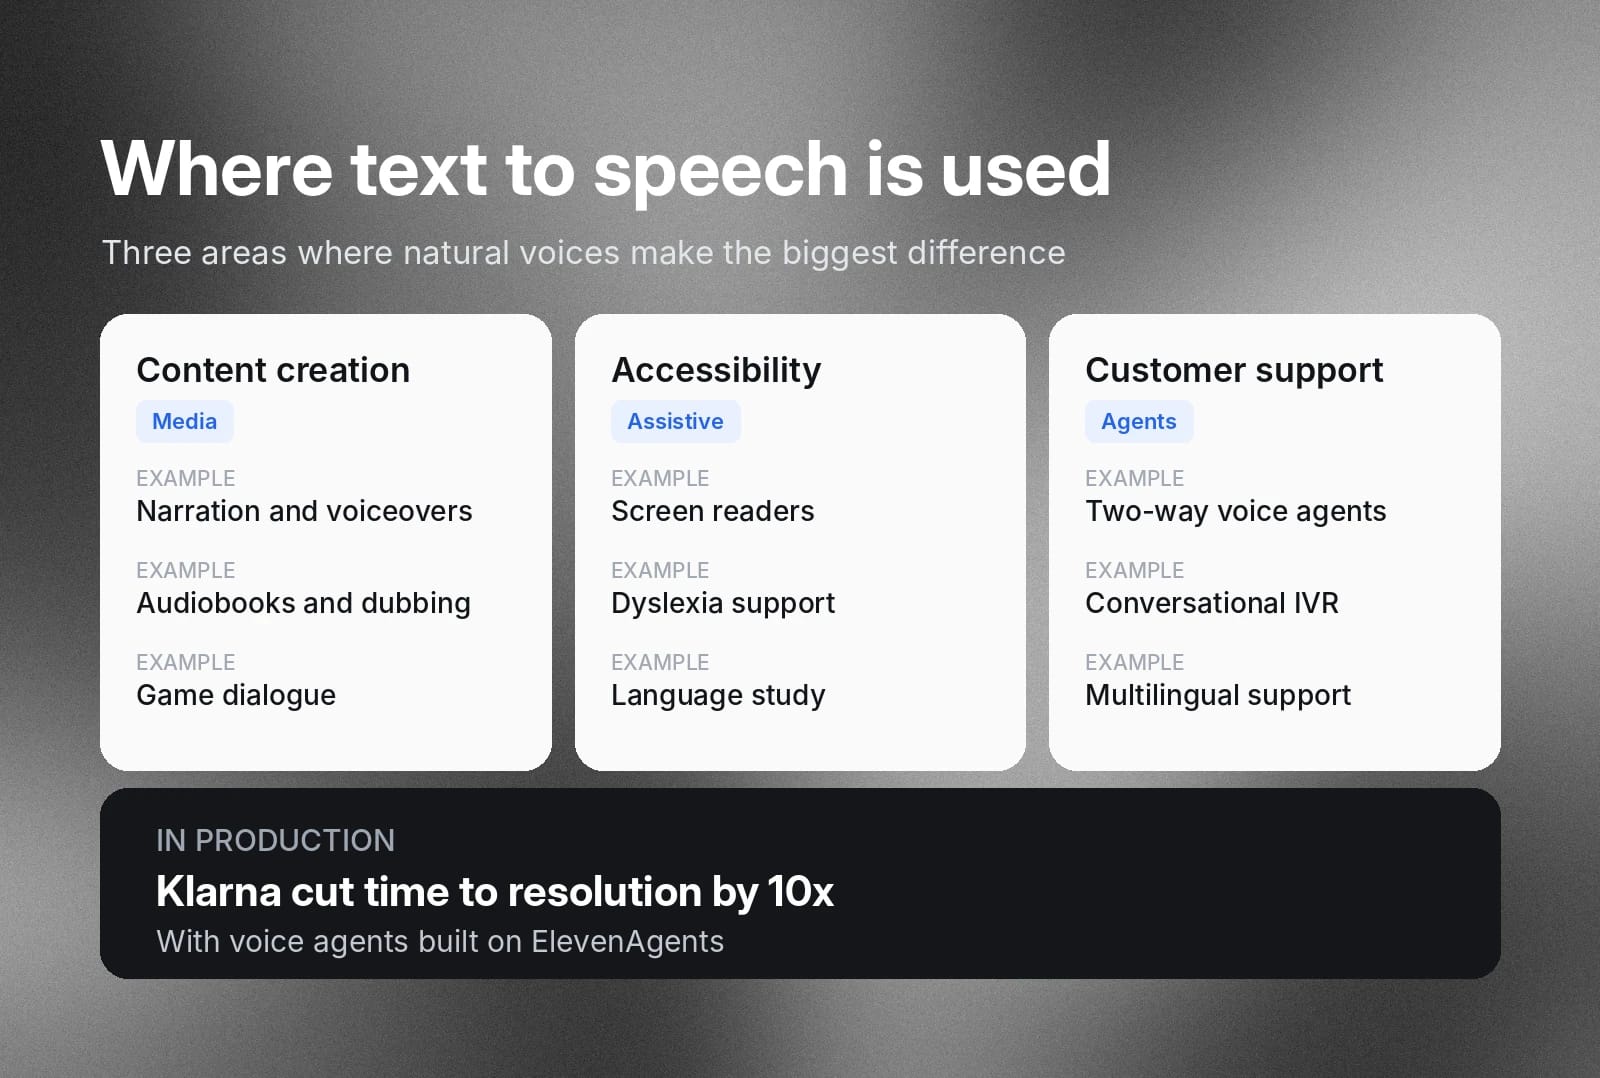
内容创作
文本转语音工具可降低大规模媒体制作成本,并减少录制旁白和后期补录所需的录音室时间。
典型应用包括:
- 旁白
- 旁白配音
- 配音
- 有声书制作
- 游戏对白
例如,TAP 使用 ElevenLabs TTS 扩大教育内容规模,服务印度各地学校。
无障碍
文本转语音是应用最广泛的辅助技术之一,因为它让人们能通过聆听获取书面内容。自然语音可提高听众参与度,并减轻聆听长篇内容时的心理疲劳。
常见的TTS 无障碍应用包括:
- 屏幕阅读器:通过屏幕阅读器和 TTS 朗读整个页面。
- 阅读障碍与读写支持:在阅读时搭配 TTS 语音,减轻阅读负担。
- 低视力与失明:屏幕阅读器会朗读界面元素和页面内容,使人们无需看到屏幕也能浏览软件和网站。
- 认知与注意力差异:聆听文本可减少阅读长文档的负担,也更容易保持专注。
- 学习与语言学习:学生能听到新词汇的正确发音,并可在通勤或学习时收听教材。
屏幕阅读器是完整的无障碍工具,能描述屏幕上的所有内容,包括按钮和菜单。朗读工具则专注于朗读内容本身,通常会同步高亮显示。由于用户会长时间使用它们,朗读工具尤其受益于更自然的声音。
客户支持
神经语音合成与可进行智能体交互的 LLM 搭配时,可提供高质量客户体验。ElevenAgents 等平台将语音层与语音识别、LLM 和连接工具结合,让智能体理解来电者需求,并以自然语音回应。
使用 ElevenAgents 构建的智能体可覆盖电话、网页、WhatsApp、电子邮件和 SMS,让客户跨渠道继续对话而无需重复说明。典型应用包括:
- 双向语音 AI 智能体:通过回答知识库问题,或将客户引导至退款、购买等特定流程,处理实时对话。
- 交互式语音应答(IVR)系统:用客户可自然说话的对话,替代过时的“按 3 转销售”菜单树。
- 多语言支持:通过单一智能体配置,以客户的语言提供服务。
例如,Klarna 使用ElevenAgents 将解决问题所需时间缩短 10 倍
文本转语音引擎如何控制发音?
现代神经语音合成引擎可以生成非常自然的语音,但面对人类语言这样广泛、复杂且不断变化的事物,始终会有边缘情况。你可能希望生成的语音保留口音、俚语或地区发音;也可能在技术术语有独特读法的行业制作音频;或者只想让品牌名称始终以特定方式发音。
发音词典与音素覆盖
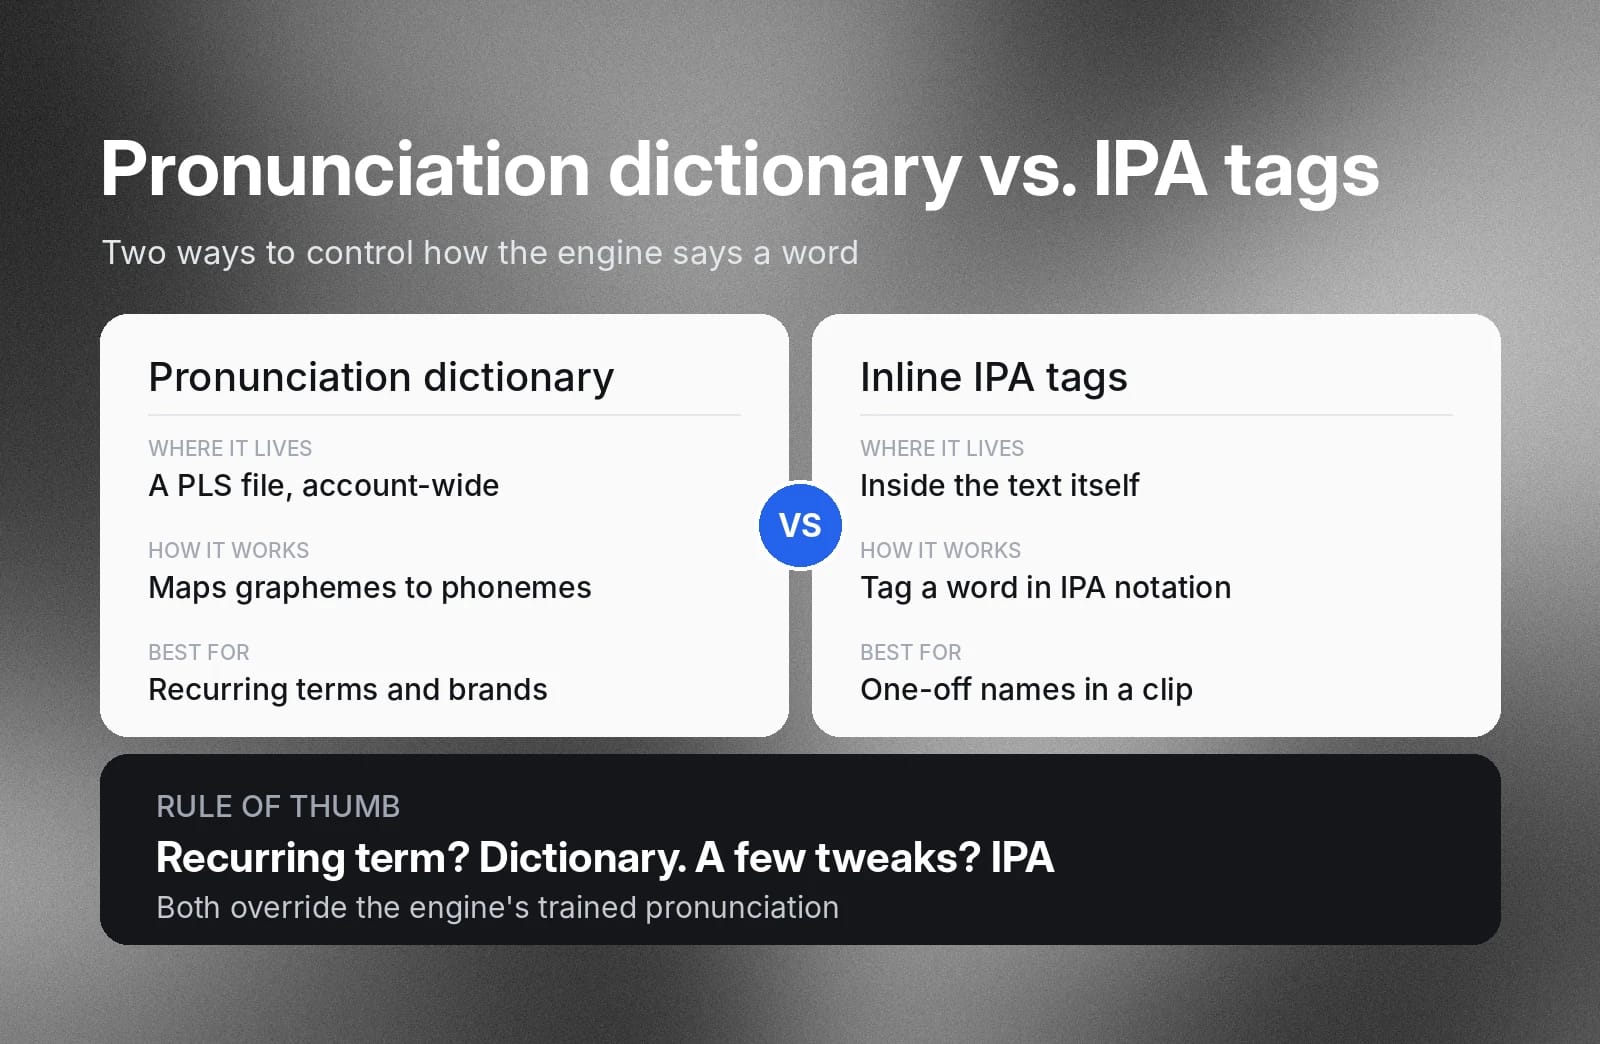
ElevenLabs 的 ElevenAPI 包含发音词典,可自定义引擎的发音方式。你可以使用符合 W3C 标准的发音词典规范(PLS)文件创建词典,将字形(文本中的符号)映射到音素(分解为声音的口语词)。当 TTS 引擎遇到词典中列出的字形时,会覆盖其训练出的发音,改用词典中的音标发音。
你可以在使用发音词典文档中了解如何在 ElevenAPI 中创建发音词典。
原生 IPA 与音标提示
部分 TTS 模型还可识别直接嵌入文本输入中的行内发音标签。因此,如果只想微调一两段音频中的发音,无需创建全账户词典,只需使用标准 IPA 标记在文本中标记词语即可。例如,录制有声书时想让虚构角色的名字按特定方式发音。
常见文本转语音挑战及应对方法
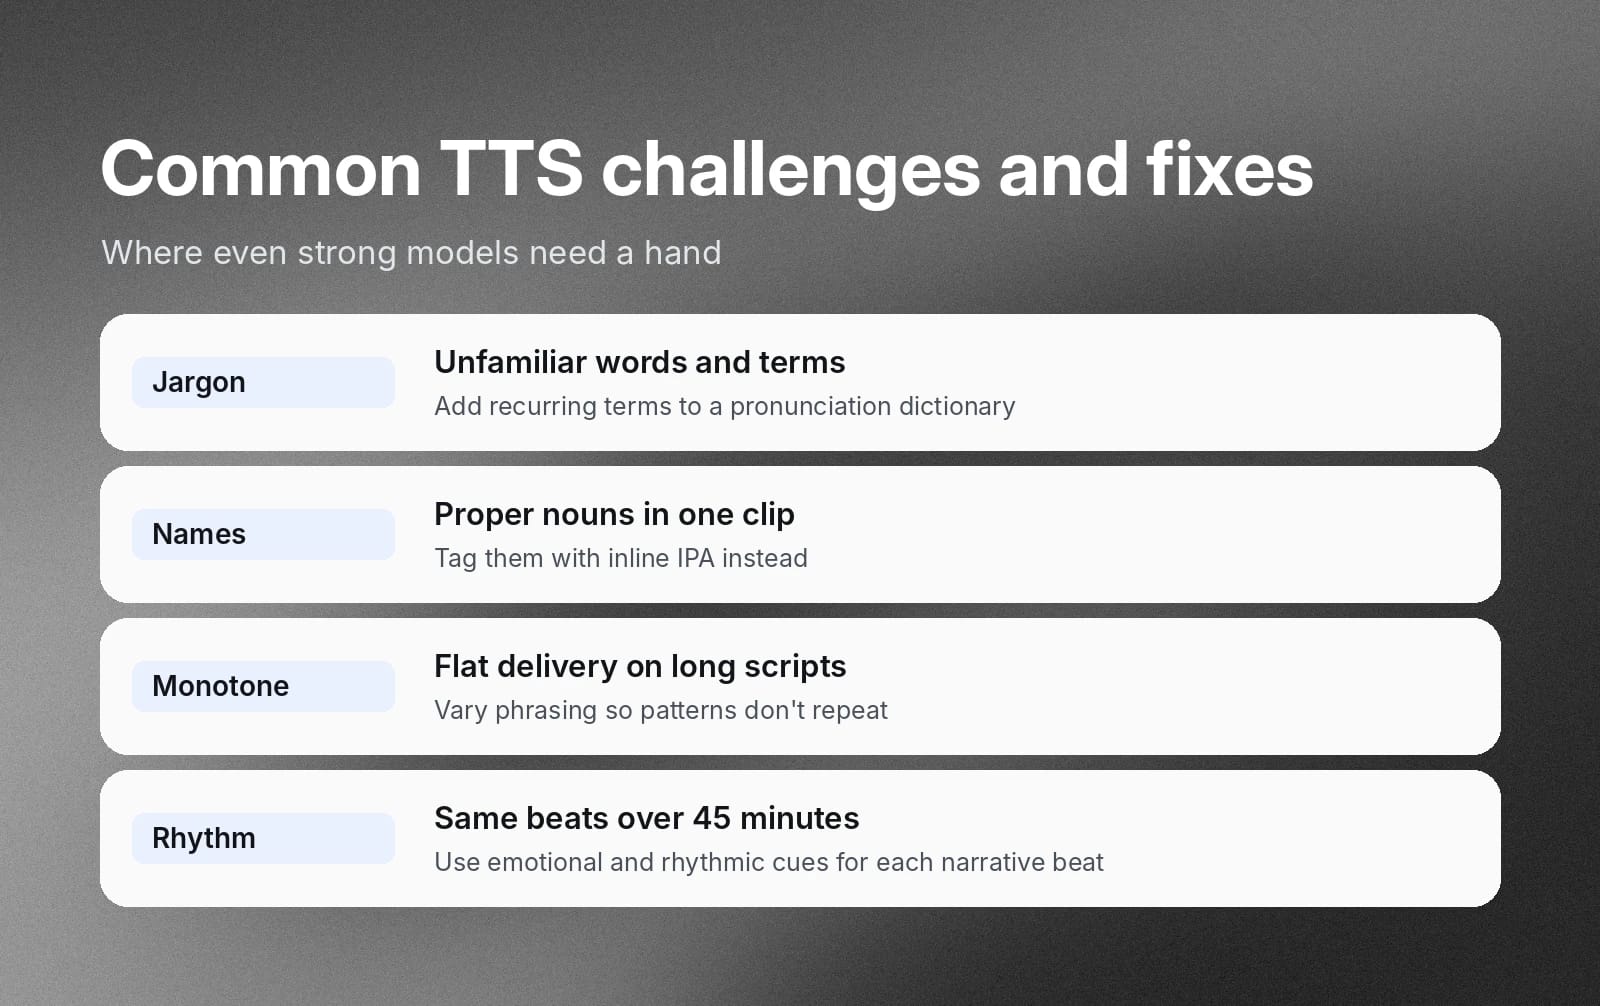
即便是最强大的 TTS 模型,也可能难以处理人类语言的细微差异。两个最常见的问题是生词误读和语调单一。以下是应对方法。
陌生词、术语和专有名词的误读
TTS 引擎根据训练数据中字形与音素的映射关系,使用算法预测规范化文本的发音。它会基于已摄取的文本和上下文做出最佳判断。但如上一节所述,仍有许多边缘情况需要特定发音。
发音词典或针对性的 IPA 标签是处理这些边缘情况的最佳工具。如果希望某个经常出现的术语始终保持一致发音,词典是最佳方案;若只需微调少数术语,请使用音标 IPA 标签。
语调单一
处理较长脚本时,反复出现相同词语或短语最容易产生这些问题。引擎合成语音在 10 秒片段中可能表现很好,但在 45 分钟讲座中持续听到相同、刻板的发音和节奏模式,会很快让听众感到疲劳。
变换脚本中的措辞,并适度使用音标标签,定期改变发音。利用情感和节奏提示,让语音输出更有变化,随不同叙事节奏起伏。
通过文本转语音 API 构建自然语音体验
轻量级网页工具很适合制作小型音频片段,但难以满足更大规模的业务需求。如果需要每分钟处理数千次客户互动,或生成高质量长篇音频内容,就需要更强大的 TTS 工具。
ElevenAPI 等文本转语音 API 可将软件直接连接至神经语音合成模型。你可以使用 REST 请求或持久 WebSockets,为智能体或其他大规模用途按需生成音频。
文本转语音 API 请求如何工作
虽然模型很复杂,但开发者流程易于理解和上手。
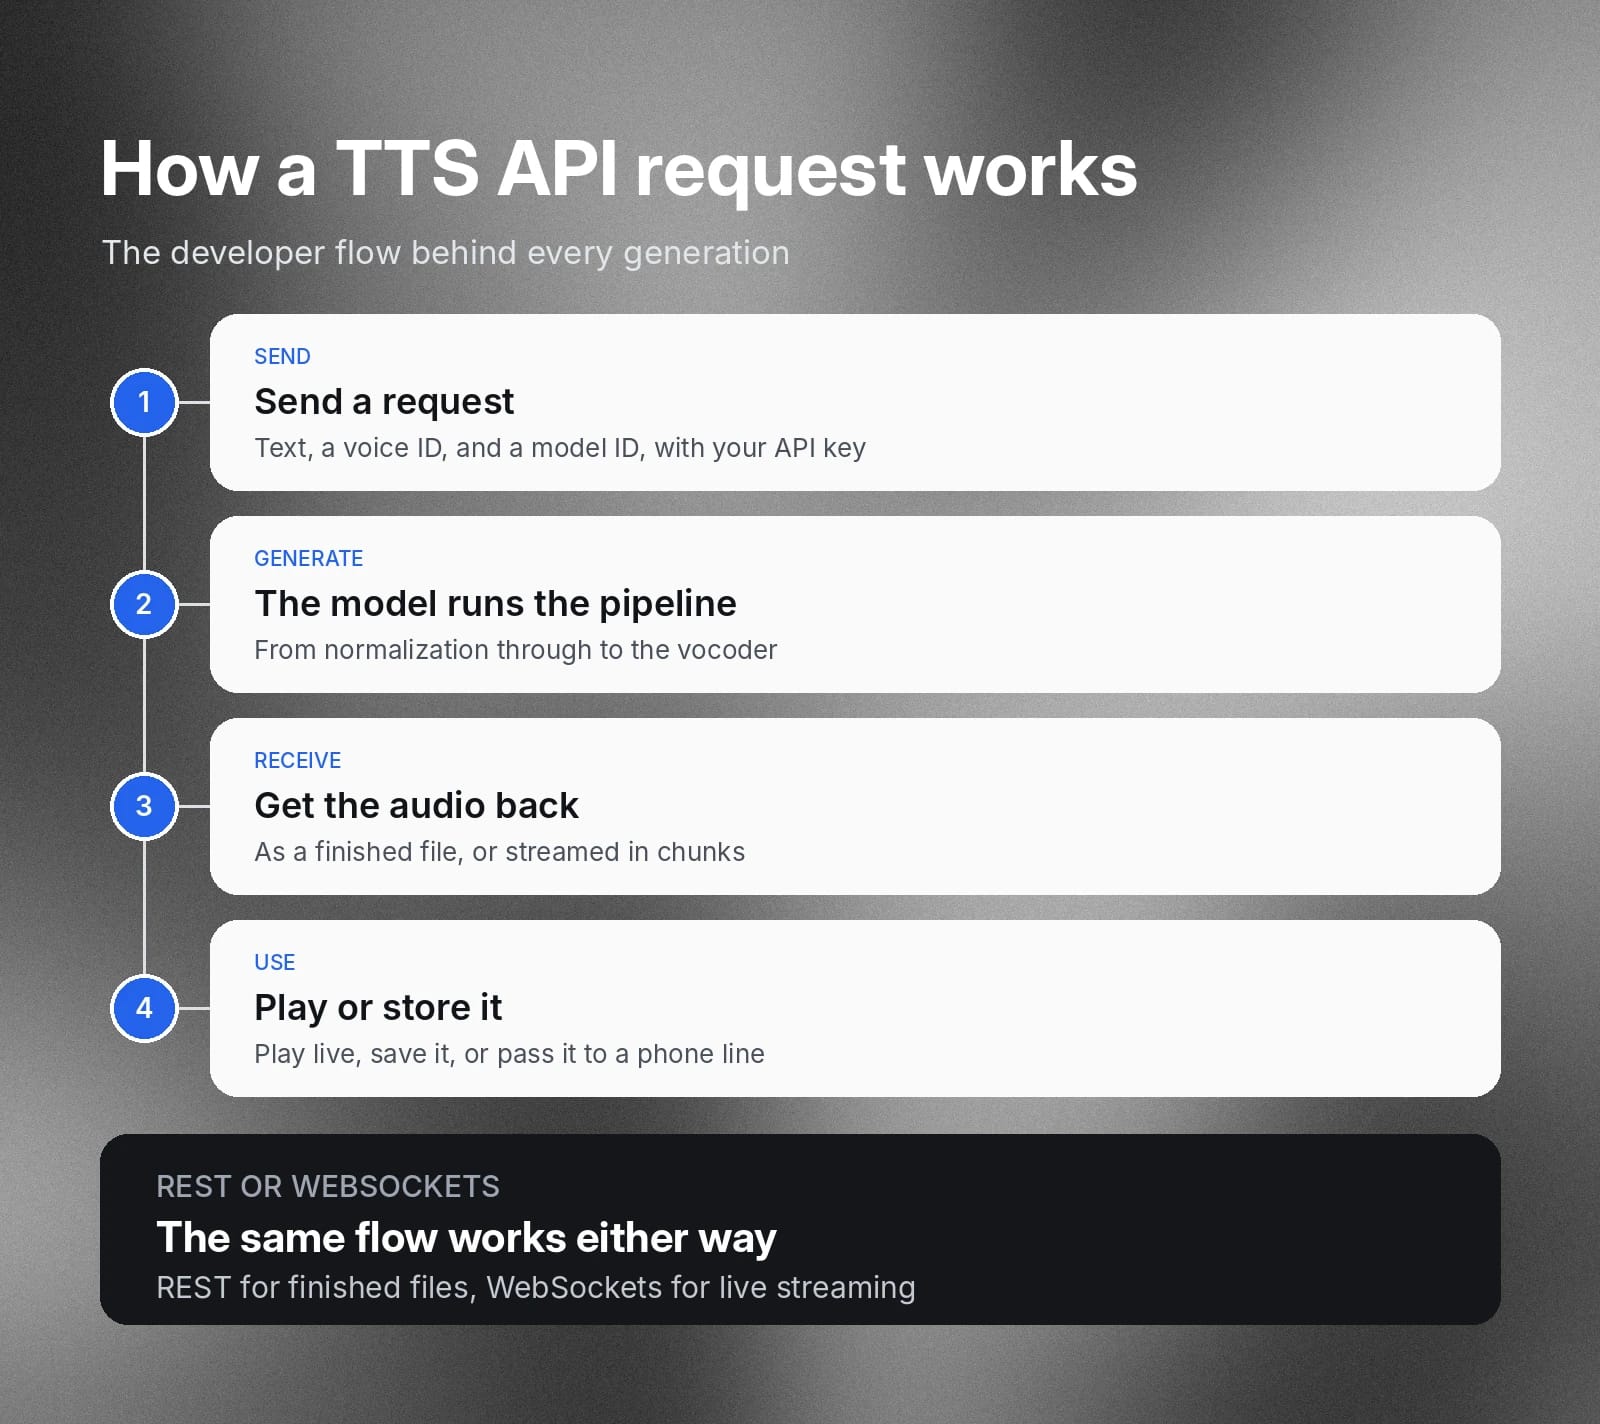
使用 ElevenAPI,可在几分钟内将文本转语音集成到应用中:
- 发送请求:应用通过 API 密钥,将文本、音色 ID 和模型 ID 发送至 API。
- 生成:模型运行上述流程,从规范化直至声码器。
- 接收音频:API 返回完成的音频文件,或以分块形式流式返回,使播放可在生成完成前开始。
- 播放或存储:应用可实时播放、保存音频,或将其传递至电话线路等其他系统。
无论使用 REST 获取成品文件,还是使用 WebSockets 实现实时流式传输,流程都相同;下文介绍的 SDK 可为你封装这些调用。
开发者的架构考量
根据使用场景,可能需要在处理速度、音频保真度、网络延迟与协议以及集成能力之间权衡。
延迟与保真度
要让对话式智能体听起来自然,应力求实现约 100ms 的首音频时间,这意味着要尽量降低网络和 TTS 引擎的延迟。关键是在这一限制下,智能体架构能够提供怎样的音频输出质量。
相反,制作播客或讲座等长篇音频时,延迟的重要性较低。与其最小化延迟,不如最大化高保真输出。
流式传输协议
API 连接所用协议也会影响延迟和性能。WebSockets 支持真正的双向音频流式传输,即可以逐块处理文本,而无需等待整段内容渲染完成。TTS 引擎处理后续内容时,前几个分块即可开始播放。
SDK
ElevenAPI 等企业级文本转语音 API 提供完整的软件开发工具包(SDK),支持 Python 和 TypeScript/JavaScript,以及 REST API,可帮助你快速搭建新架构。使用它们可减少开发团队的集成开销。
开始使用 ElevenAPI 进行文本转语音
领先语音模型提供的自然 TTS 合成,可生成让智能体和音频作品吸引听众所需的高质量音频输出。无论需要高质量对话式智能体来支持客户工作流程,还是希望在应用中构建 TTS,ElevenLabs 都能提供解决方案。
立即使用ElevenAPI,生成自己的高保真音频,或了解更多ElevenAgents.
常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。