神经文本转语音(TTS)详解:AI 语音如何工作
- 发布时间
- 最近更新
神经文本转语音(TTS)是支撑各类 AI 语音的技术。新闻网站上朗读文章的小按钮、自动客服来电、TikTok 和 YouTube 等平台的视频旁白……应用不胜枚举。神经 TTS 已取代传统生硬的文本转语音。
2026 年,TTS 市场规模已超过 48 亿美元,并以 22.4% 的复合年增长率(CAGR)增长。随着更多应用场景涌现,创作者和企业纷纷采用这项技术,市场正逐年快速扩张。
本指南将介绍神经 文本转语音是什么,以及它为何成为行业快速增长的核心。还会说明它与传统 TTS 的差异,以及将 TTS API 集成到应用时应关注什么。
摘要
- 神经文本转语音利用深度学习从零生成语音。
- 神经语音捕捉 韵律、语调、重音模式和节奏,从而理解人声的特征。
- 传统拼接式和参数式 TTS 仍存在于旧系统中,但在重视语音质量的场景,神经合成已取而代之。
- 开发者可通过 API 集成神经 TTS,流式延迟现已足够低,可用于实时对话。
什么是神经文本转语音?
神经文本转语音(神经 TTS)是一种利用深度神经网络生成自然人声的语音合成技术。AI 中的神经网络由多层互联处理单元构成,因其与人脑神经网络有一定相似性而得名。
早期文本转语音模型依赖人工编写的规则和录制音频片段来解析语言,并从文本样本中学习生成语音。神经 TTS 模型会自行推导规则,从上下文中学习处理更复杂的语音问题,例如在哪里停顿、句中哪个词需要重读。
对韵律和情感的理解,是神经 TTS 区别于传统模型的关键。
神经 TTS 如何工作:技术概览
从表面看,神经 TTS 将文本转换为音频,同时保留承载语义的特征:发音、情感意图、节奏、重音和语气。底层则由一系列模型协同工作,将文本转化为自然人声。
不同提供商的具体架构各异,但神经 TTS 通常包含以下核心阶段。
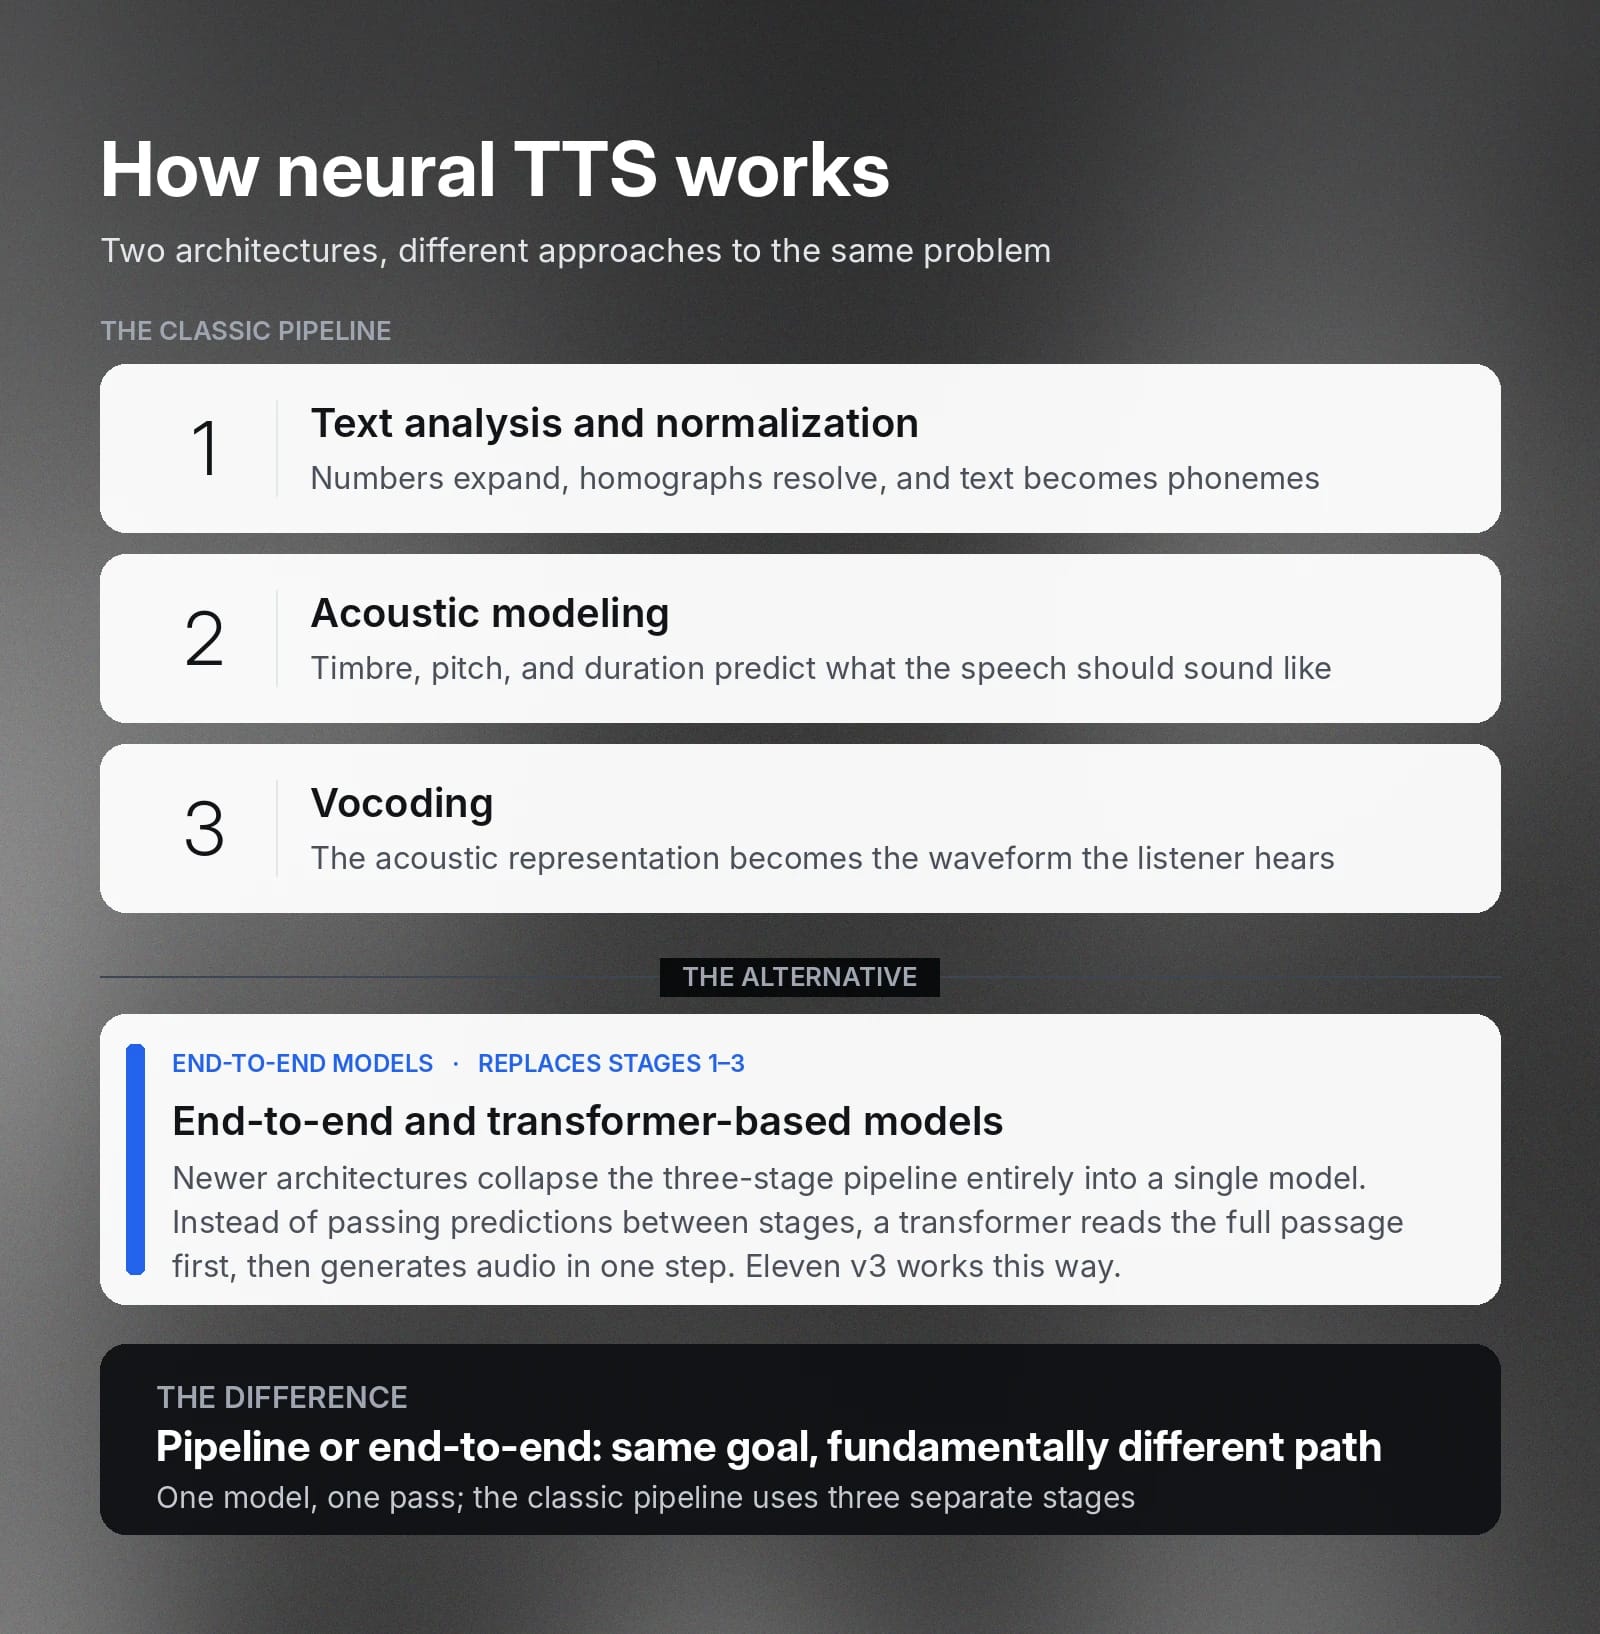
文本分析
书面文本充满歧义。英语中有一个经典例句,对短语中不同词加重音会改变含义:“I didn't say he stole the money.”重读 “I”,表示是别人说的;重读 “he”,表示是别人偷的;重读 “money”,则表示被偷的是别的东西。
文本分析会在生成音频前消除这些歧义。它会展开缩写,并将日期、数字、符号等常见文本元素转换为口语形式。“read”“lead”和“bass”等同形异义词也会根据完整句子的上下文被识别并正确发音。系统还会预测韵律标记,找出最需要强调的词;下一阶段的声学模型会将这些标记呈现出来。
随后,规范化文本会通过字素到音素转换,变为独立的音素。这一步可确保最终音频稳定、准确,即使是英语等发音规则 notoriously 不可靠的语言也是如此。
我们还撰写了音素指南,深入解析这一层。
声学建模
声学模型是系统的神经核心:它接收音素序列,预测语音应有的声音。
声学层主要包含三个维度:
- 音色:让人能辨认出特定说话者的声音质感,有时也称为个人的“声纹”。
- 音高:贯穿整句的音调轮廓,包括短语语调,以及疑问句的上扬和陈述句的下降。
- 时长:模型延长每个音素的时间,控制句子节奏,并避免将 “jump” 读成 “jjjjump”。
这些特征共同决定句子的韵律。神经 TTS 利用它们生成更不 机械的朗读。模型通过学习数小时的真实语音,以接近人类的方式安排停顿和重音。这种基于上下文的学习从训练数据中获取规律,而非依赖开发者制定的具体规则。
FastSpeech 和 Tacotron 2 等架构是这一阶段的支柱,能够将音素序列转换为梅尔频谱图。梅尔频谱图展示音频频率随时间的变化,它描述语音,但并非可播放的音频,只是声音的数字表示。
声码器
声码器是经典流程中的最后一个网络。它将上述声学表示转换为实际波形,也就是最终用户听到的声音。
行业在开发和使用声码器时曾面临一个问题:其速度通常远不足以用于实际生产流程。直到 HiFi-GAN 等迭代方案改进了 DeepMind WaveNet 等早期声码器,速度才足以满足真实生产场景。
这一环节的创新让实时神经 TTS 成为可能。
端到端与基于 Transformer 的模型
传统 TTS 模型需经过上述三个阶段才能从文本生成音频。新一代模型则完全整合了这条流程。基于 Transformer 的模型(采用与大语言模型相同的架构)通过单一端到端流程将文本映射为音频,无需在独立的声学网络与声码器网络间传递预测结果。
流水线模型一次只能处理一句话,而 Transformer 会先读取整段内容,再根据更广泛的上下文决定某一句该如何朗读。同一句话在喜剧和戏剧中的读法可能截然不同。
ElevenLabs 的模型,例如 Eleven v3,可适应这类细微差别,并接受 内联音频标签,如 [whispers] 或 [nervous],让用户更好地控制脚本的呈现效果。
神经文本转语音与传统 TTS 对比
神经网络普及前,TTS 系统主要采用两种方法。它们如今仍可见于 旧版 IVR 菜单和屏幕阅读器中。
两种传统 TTS 类型如下:
- 拼接式 TTS:录制配音演员朗读数千个句子,再将其切分为微小片段。需要生成语音时,系统将这些片段拼接起来。虽然单个词可能听起来像人声,但片段间的接缝会造成断续、机械的节奏,这也是人们至今对计算机生成语音的印象。
- 参数式 TTS:基于语音参数的统计模型生成音频,而非使用录音。它比拼接合成更小巧灵活,但因简化模型舍弃了真实语音的细节,音频往往听起来闷、带嗡声。
相比之下,神经 TTS 从学习到的语音模型生成完整波形,一次消除了这两类问题。
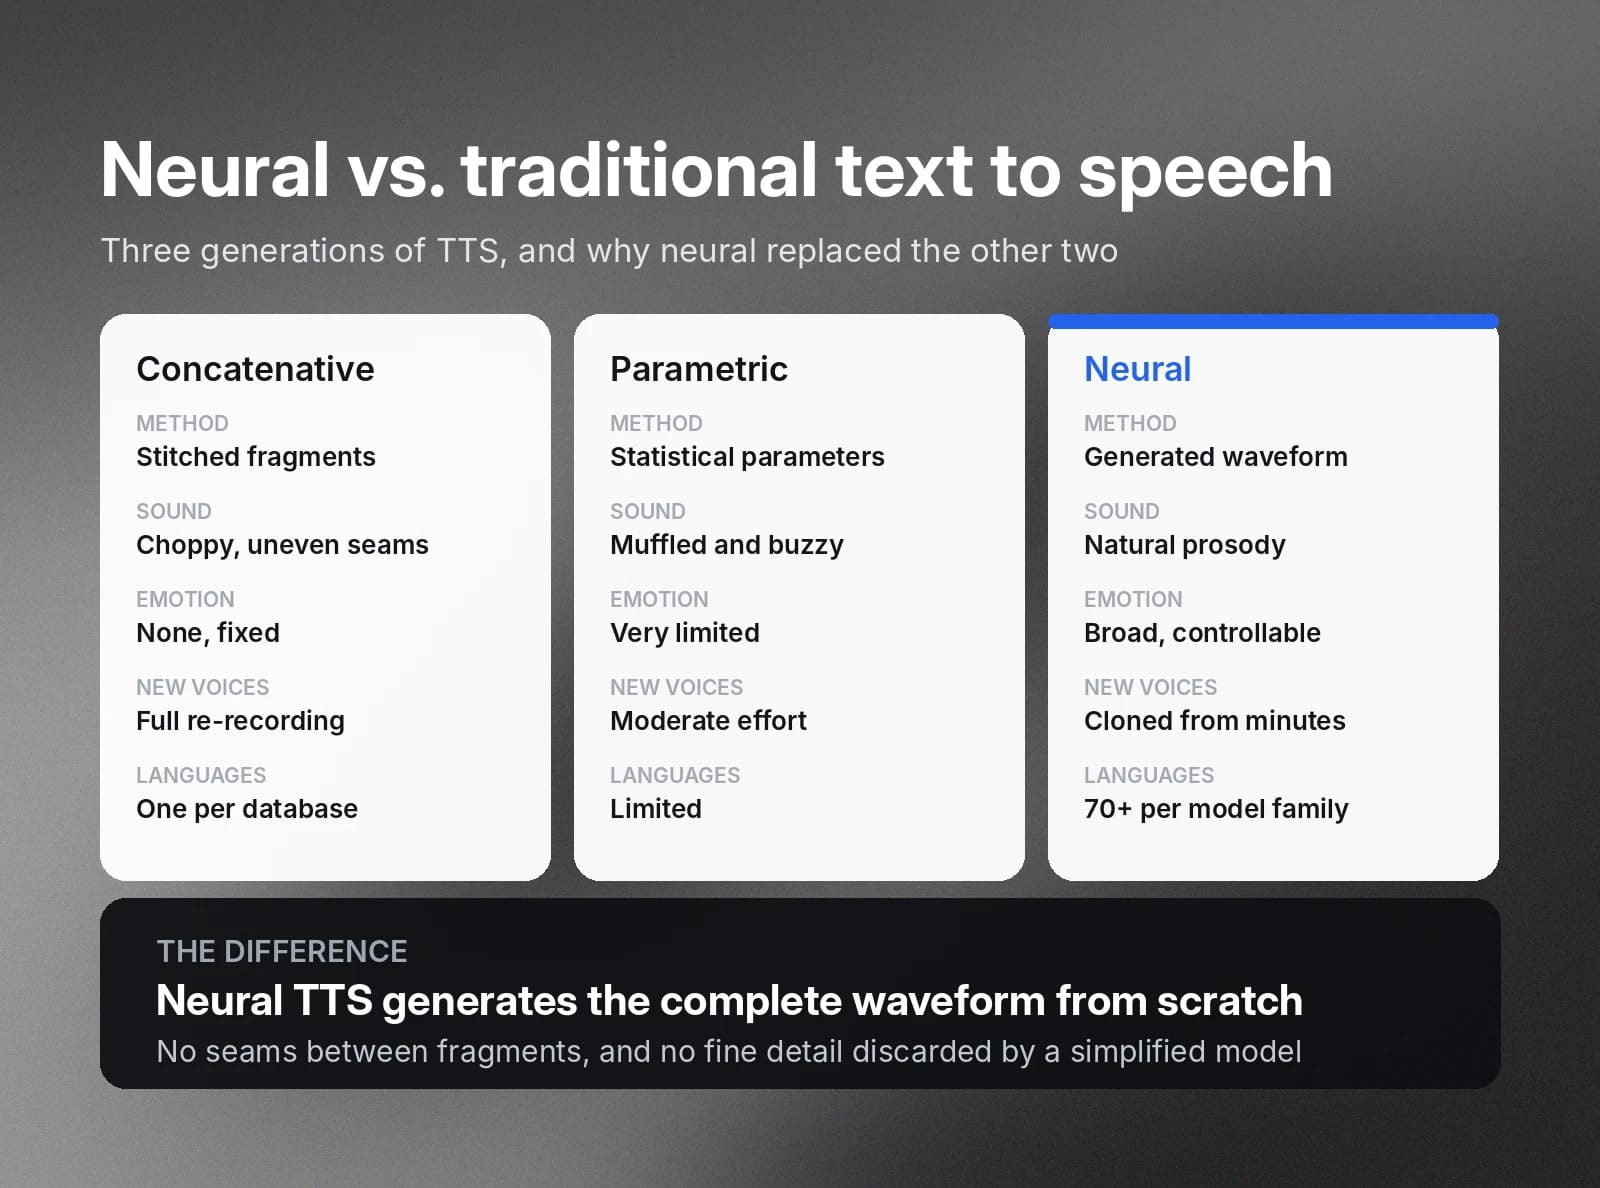
以下从各方面对比神经文本转语音和传统 TTS。
神经 TTS 的主要功能和优势
神经 TTS 生成流畅、自然的人声音频,可支持多种应用场景;自然度的提升也带来了传统 TTS 无法实现的新能力。
以下是神经文本转语音的主要功能和优势:
- 自然韵律:语音会像人类说话者一样安排重音、停顿和语调,让听众能持续投入长篇内容,而不会感到烦躁或疲劳。
- 情感表达:现代模型可呈现富有表现力的语音,无论是戏剧独白还是平静朗读。使用 Eleven v3 时,创作者可直接在脚本中通过音频标签进行控制。
- 语音克隆:神经模型可从短样本中学习特定说话者的音色和风格。你可以使用 语音克隆(即时或专业版),让所有 TTS 部署保持一致的声音。
- 多语言覆盖:神经模型可说数十种语言,语音克隆也能在各种语言中保留身份特征。品牌可确保选定声音在伦敦和罗马听起来保持一致。
- 实时速度:神经文本转语音模型生成语音的速度可快于播放速度,流式延迟也足够低,适用于实时对话。
- 规模化:训练神经 TTS 后,一个音色可轻松朗读数百万字,包括新的产品名称和描述,大幅降低录音棚成本。
总体而言,神经文本转语音彻底改变了 TTS 的运作方式,也为 无障碍访问、业务覆盖和情感表达带来新机会。
神经 TTS 解决方案的主要应用场景
文本转语音模型的底层架构变革,以及速度和表达能力的提升,推动了多种新应用场景。
以下是如今最具价值的一些应用。
对话式 AI 和语音智能体
客户支持智能体、虚拟接待员、电话助手和 AI SDR,都依赖听起来可信、几乎即时响应的语音。
对话式 AI 是神经 TTS 要求最高的应用场景,同时要求极高的质量和极严格的延迟预算。
有声书和出版
神经旁白让制作旧书目录的音频版本更具经济性,即使这些作品通常无法承担 录音棚录制成本。借助神经文本转语音,你可在数小时内 生成完整有声书。
ElevenCreative让这一过程尽可能简单,通过 角色选角自动为角色匹配最佳音色,并将其台词填入整部稿件。
游戏和互动媒体
动态对话、程序化生成内容和 NPC 对话,若在录音棚中人工录制,都是庞大项目。神经 TTS 可让工作室大规模为其配音,并通过编辑文本修正错误,无需增加录音棚时长。
本地化和配音
神经 TTS 结合翻译,可将视频和音频内容带入新市场,同时保留原说话者的声音身份。
麦德林的创作者受众听到的仍是与波士顿受众相同、易于辨认的声音,只是改说西班牙语。
如何将神经文本转语音集成到应用中
对开发者而言,神经 TTS 只需一次 API 调用。
以下是使用 Python SDK 和 ElevenAPI 将文本转换为语音的完整示例。
同一端点也可通过 REST 或 Python、JavaScript 等语言的 SDK 使用。以下三种集成模式可覆盖大多数应用:
- 批量合成:发送文本,接收完整音频文件。适用于文章、IVR 提示、有声书和视频等预制内容。
- HTTP 流式传输:音频片段生成后即会传输,因此可在合成完成前开始播放。适用于朗读长文档或按需生成播客风格内容。
- WebSocket 流式传输:对于对话式 智能体,持久 WebSocket 连接可增量接收文本,例如从 LLM 流式输出的 token,并以尽可能低的延迟返回音频。
生产环境中的 集成还需要重试逻辑、请求超时设置和合理的错误处理。更多信息请参阅我们的 文本转语音 API 集成模式指南。
选择文本转语音 API:关注要点
文本转语音 API 看似相似,但其底层功能差异很大,可能决定哪一个更适合你的具体场景。
以下虽非完整清单,但选择 TTS API 时应关注这些方面:
- 音频质量:最重要的是,如果神经 TTS API 返回的音频不好听,该提供商就不适合你。应进行盲听测试,尤其是长篇旁白,因为问题最容易在这里暴露。
- 延迟:对于 对话式 AI流程或应用,应关注首字节时间。区域基础设施同样重要。我们通过将流量路由至更靠近用户的数据中心,将全球 API 延迟降低了 最高 40%。
- 流式支持:确认是否支持并记录了 HTTP 和 WebSocket 流式传输。仅支持批处理的 API 无法用于实时场景。
- 语言和音色覆盖:选择语言覆盖广泛的神经文本转语音 API,尤其应覆盖应用中常用的语言。
- 表现力控制:选择可定制神经 TTS 实际发声方式的控制工具。ElevenLabs 音频标签可细致控制语音。
- 说话者相似度:如果使用语音克隆,请检查模型在较长内容中保留克隆音色表达和韵律的程度。角色较多的脚本可能会随时间出现质量下降,导致声音与原始样本不同。
- 许可和伦理:确认你获得输出内容的商业使用权,并了解提供商如何处理语音同意、数据保留和滥用防范等问题。企业买家应询问 SOC 2 合规性以及第三方 AI 安全认证,例如 AIUC-1 和 ISO 42001。
- 文档和开发者体验:花一小时仔细阅读 开发者文档,就能了解产品的完整程度。应优先参考文档和工程师建议,而非销售话术。
- 定价模式:许多 API 按字符数或积分收费。应估算每月用量,并按该用量比较套餐,而非只看入门价格。
使用 ElevenAPI 开始体验高质量神经 TTS
ElevenAPI让开发者直接使用 ElevenLabs 的神经文本转语音模型,支持 70 多种语言和数千种音色。我们提供 HTTP 流式传输和 WebSocket 支持,以及适用于实时对话的低延迟。
浏览 文本转语音 API产品页面,试听模型;或者注册并 创建免费 API 密钥,立即开始。