
文本转语音 API 集成:流式、批量、重试
- 发布时间
- 最近更新
集成文本转语音 API 并不复杂……前提是先做出几个关键决策:选择哪种传输模式、如何选择模型和输出格式、如何流式传输、如何在不超出并发限制的情况下处理大量请求、如何缓存和重试以避免为同一段音频重复付费,以及如何与其他服务商对比首字节时间。
为帮助你集成文本转语音 API,我们将逐一拆解这些架构决策及相应做法。本指南将帮助你集成 ElevenLabs 文本转语音 API 并实现扩展,还提供可直接用于生产环境的代码片段。
如需全面了解这里提到的概念,请参阅我们的了解音频流式传输、优化延迟以及ElevenLabs 模型概览。
摘要
- ElevenLabs 只有一个文本转语音 API 端点,可通过三种方式访问:批量转换、HTTP 流式传输和 stream-input WebSocket。
- 通过 HTTP 时,每个进行中的请求都会占用并发额度;通过 WebSocket 时,只有正在生成的请求才会计入。
- 将并行度设在略低于套餐限制的水平,并缓存所有影响输出参数的哈希值,避免为相同文本重复计费。
- 对 429 和 5xx 使用指数退避与完全抖动重试,在触及并发上限前降低请求速率。
集成文本转语音 API 的三种方式
文本转语音只有一个端点,但集成方式会影响延迟、复杂度和成本。
同一个 POST /v1/text-to-speech/{voice_id} 调用可采用三种形式,分别适合不同场景。以下是集成文本转语音 API 的三种方式:
- 批量(convert)是最简单的集成方式:发送一个请求,即可收到一个音频响应。它的复杂度最低,但首段音频时间最长,因为必须先合成完整音频片段,才会返回任何字节。
- HTTP 流式传输(stream)使用相同请求,但会分块返回响应:在路径后追加 /stream,调用 stream 方法,音频便会以分块响应返回。代码几乎相同,但感知延迟低得多。
- WebSocket(stream-input)会保持持久连接:你可以逐步发送文本,并持续接收音频块。它专为交互式智能体设计,也可在 LLM 逐个生成 token、句子尚未完成时,将输出直接转为语音。
流式传输不会让模型生成音频更快;推理时间不会改变。流式传输改变的是收到第一个音频块的时机:完整音频生成前便会发送首块,因此总工作量相同,但用户感受到的等待时间更短。
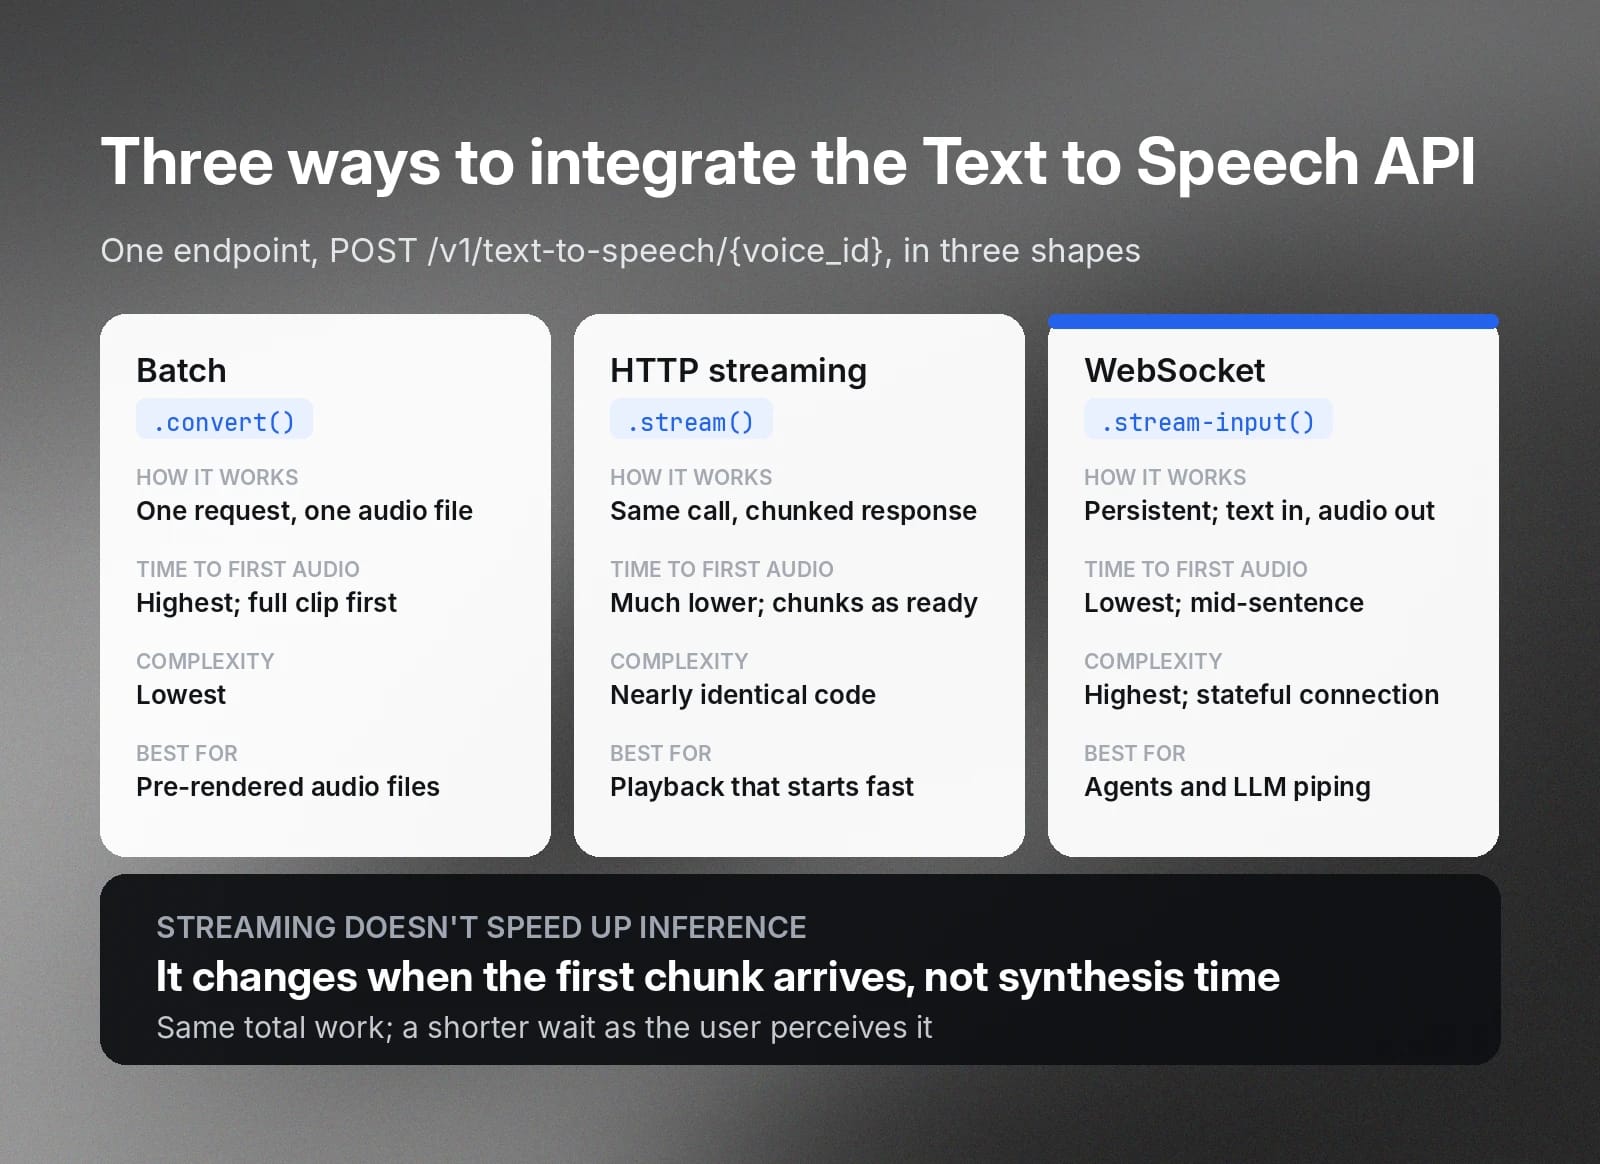
批量、流式传输与 WebSocket 决策表
在这三种方式之间做选择时,需要考虑多个因素。
简单来说:离线渲染选择批量处理;用户等待已知文本时选择 HTTP 流式传输;智能体和实时 LLM 转语音则选择 WebSocket。
下表按大规模使用时的关键维度,列出了各方案的取舍。
无论是批量还是流式传输,通过 HTTP 的每个进行中请求在整个持续期间都会占用套餐的并发额度。通过 WebSocket 时,只有模型正在生成音频的时间才会计入;已打开但空闲的 socket 基本不产生费用。
对于级联式语音智能体,它会在整段对话中保持连接,但仅在智能体发言时生成音频,这种差异就非常明显。这也是构建智能体时使用 WebSocket 的主要原因。完整协议请参阅实时文本转语音 WebSocket 指南。
选择模型和输出格式
TTS API 集成返回的音频由两项选择决定。第一是模型,决定质量和速度;第二是输出格式,决定封装格式、比特率和采样率。
从一开始就选对这两项设置,后续的延迟、电话系统兼容性等问题便会顺利解决。
模型
我们提供多种文本转语音模型。它们并非从优到劣排序;每种模型都有不同取舍。
需要说明的是,约 75 ms 指的是代表性条件下的模型推理时间,不包含网络和应用延迟。输入更长或负载更高时,这个数值会增加。应始终从自己的应用中测量,而非依赖基准测试数值。
Flash 模型更小,并采用更激进的近似方法来缩短推理时间。Eleven v4 和 Multilingual v2 是更大的模型,会在每个字符上投入更多时间,以生成更丰富的输出。
实时或智能体场景请使用 eleven_flash_v2_5;它是延迟最低的多语言选项。旁白、有声书或营销旁白配音则可选择 eleven_multilingual_v2,以获得稳定的高保真效果;如需最强表现力和情感范围,则选择 eleven_v4。
当电话号码、日期或货币等发音很重要时,应在文本到达 API 前,在应用中自行进行数字规范化。请直接写出希望听到的读法。
自行规范化可确保不同模型的发音可预测,也能避免依赖可能变动的模型特定默认设置。
输出格式
output_format 参数控制返回音频的封装格式、采样率和比特率。最常用的值包括:
音色设置
以下设置控制生成语音的表达方式:
- Stability:控制稳定性与表现力之间的平衡。较低值会产生更多变化、更有表现力的语音;较高值则让表达更稳定、更可预测。
- SimilarityBoost:控制输出与参考音色的贴近程度。
- Style:提高该值会加强音色的自然说话风格。
- useSpeakerBoost:以少量延迟为代价,增强与原始说话人的相似度。
- Speed:围绕默认值 1.0 调整语速。
在这些设置中,Stability 通常对感知质量影响最大。较低值能生成更有表现力但一致性较低的输出;较高值则优先保证一致性和可预测性。
选择音色时,延迟最低的组合是 Flash 搭配即时语音克隆或默认音色;专业语音克隆的效果出色,但会增加每次生成的额外开销,需要纳入考量。
本指南中的示例音色 ID 为 JBFqnCBsd6RMkjVDRZzb(George)。
流式传输集成(HTTP 和 WebSocket)
本节介绍文本转语音 API 集成的实操核心,包括安装 SDK、打开流,以及在音频到达时进行处理。HTTP 路径适用于大多数网页和应用播放,WebSocket 路径适用于智能体和实时 LLM 输出。
这两种方式都假定你已按如下方式初始化 ElevenLabs 客户端。
流式路径会打开一个流,并在音频块到达时进行处理。voiceId 是第一个位置参数,后面是使用 camelCase 键名(modelId、outputFormat、voiceSettings)的选项对象:
对于 WebSocket 方式,请连接至 wss://api.elevenlabs.io/v1/text-to-speech/{voice_id}/stream-input,先发送一条包含音色设置和前导空格的消息,然后在文本可用时发送文本消息,并读取 audio 字段包含 Base64 编码音频块的 JSON 帧。
高吞吐量的批处理与并发限制
高吞吐量集成受并发数控制,即同一时刻正在生成音频的请求数。每种套餐针对不同模型系列均有相应限制。
每种套餐都有不同的并发限制:
- 免费版:4 个并发 Flash 请求。
- Starter:6 个并发 Flash 请求。
- Creator:10 个并发 Flash 请求。
- Pro:20 个并发 Flash 请求。
- Scale 和商业版:30 个并发 Flash 请求,企业版限制可定制。
Multilingual v2 的限制约为上述数值的一半。
可通过限制同时运行的请求数量来缓解这一问题:
MAX_CONCURRENCY 应设为略低于套餐限制,而非恰好等于限制。这样可为使用同一密钥的其他流量留出余量,并避免达到返回 429 的阈值。
字符限制与长文本拆分
每个模型都会限制单个请求可接受的字符数。任何长文本集成都必须拆分文本,再将音频拼接起来。
以下是各模型每个请求的字符限制:
- Flash v2.5:每个请求最多接受 40,000 个字符。
- Flash v2:每个请求最多接受 30,000 个字符。
- Multilingual v2:每个请求最多接受 10,000 个字符。
- Eleven v3:每个请求最多接受 5,000 个字符。
- Eleven v4:每个请求最多接受 10,000 个字符。
超过限制的文本必须拆分为多个请求。应尽量按句子边界拆分,以保留音频块衔接处的韵律。
按顺序渲染各音频块并拼接音频。对于每个音频块相互独立的长篇旁白,这两部分可直接组合:将 splitText 输出传入上面的受限池,其余工作由它完成。
缓存与幂等性
文本转语音输出具有足够的确定性,因此用相同音色、模型和设置重复渲染相同文本会造成浪费。应按影响音频的输入参数哈希值缓存结果,同一密钥也可在重试时用作幂等令牌。
以下介绍如何同时实现这两点。
要实现这一点,关键是将所有会改变音频的参数都纳入密钥,包括 outputFormat 和音色设置。正确实现后,同一密钥也可作为幂等令牌。客户端重试已成功的请求时,返回缓存的字节即可,无需再次生成。
错误处理与速率限制(429)
生产环境客户端需要采用带退避和抖动的重试策略,并根据状态码做不同处理,因为有些失败值得重试,有些则不值得。
下表列出每种状态对应的正确操作,本节还会说明为什么 429 是软限制,而非硬性阻断。
429 并不是硬性阻断,了解其机制会有所帮助。当超出并发限制时,请求会先按优先级排队,通常会增加约 50 ms 延迟。只有之后仍超出容量时,才会收到 429。
响应还包含 current-concurrent-requests 和 maximum-concurrent-requests 标头,用于显示当前可用余量,因此可读取它们并在达到限制前降低请求速率。
如果需要更多余量而不是更好的重试行为,请升级套餐。企业版客户可通过客户经理申请提高限制。
延迟与首字节时间基准测试
延迟取决于所在地区、输入内容和当前负载,因此唯一值得依赖的延迟数值,是从自己环境中测得的结果。
本节提供 Flash 流式端点的首字节时间(TTFB)测试方法,其结构支持将相同测试工具用于其他服务商,并在相同条件下进行比较。
应将其视为一种测试方法,而非已发布的结果。单次运行不能保证任何结果。
对文本转语音 API 集成进行延迟基准测试时,以下注意事项很重要:
- 包含网络往返时间:TTFB 取决于你的地理位置及服务商最近的集群,因此应从服务器通常运行的位置进行测试。
- 丢弃一次预热运行:首次向冷连接发出的请求更慢,可能使测试数据产生偏差。
- 固定输入:输入长度、音色、模型和负载都会影响结果,因此各服务商之间应保持一致。
- 报告分布情况:每次运行的数值都会变化,因此应发布中位数和 p95,而非单一数值。
考虑以上因素后,就可以开始进行基准测试了。
若要与其他服务商比较,请编写一个具有相同结构的函数。然后通过一个小型运行器驱动两者:丢弃一次预热调用,获取约 20 个间隔足够远、不会相互冲突的计时样本,并以毫秒报告中位数和 p95。
公平比较的关键在于控制变量。
应从同一台机器和网络测试两家服务商;理想情况下,应使用实际部署地区的服务器,而非住宅宽带上的笔记本电脑。使用相同输入文本,并保持音频简短,让模型推理而非生成长度主导测试结果。由于单次测量只是噪声,应报告多次运行的中位数和 p95。
请注意,通过公网测得的 TTFB 包含 20–200 ms 的网络往返时间,这与模型无关。我们在北美、欧洲和东南亚部署了集群,并路由至最近的集群,因此应相应地将测试客户端部署在附近,否则测试的大多是到数据中心的距离。
文本转语音 API 集成要点
生产环境的文本转语音 API 集成,取决于几个影响重大的决策。
只要做好这些,其他问题就会迎刃而解:
- 按场景选择模型:交互式场景使用 Flash v2.5;对于延迟要求较低的离线渲染,则使用 Multilingual v2 等更高保真模型,或Eleven v4。
- 只要用户在等待就使用流式传输:已知文本使用 HTTP 流式传输,智能体使用 WebSocket,让空闲时间不占用并发预算。
- 将并行度限制在套餐上限内:将并发请求数设为略低于套餐限制,并按所有影响输出的参数哈希值进行缓存,确保不会为同一段音频重复计费。
- 对 429 和 5xx 使用指数退避与完全抖动重试:遇到 429 和 5xx 时采用完全抖动退避,并监控并发标头以了解距离限制还有多远。
- 按句子边界拆分长文本:在每个模型的字符限制内按句子边界拆分,以便韵律能在衔接处保留。
如需进一步了解,请查看流式传输操作指南、音频流式传输概念、身份验证以及客户端使用的一次性令牌。
使用 ElevenAPI 构建文本转语音集成
阅读完本指南后,你已掌握生产环境文本转语音 API 集成所需的全部模式。无论是流式传输、批处理、缓存、重试,还是基准测试,现在都可以投入实际应用。
开始之前,可以进一步了解文本转语音 API,或注册,立即通过ElevenAPI 发起第一次调用。
文本转语音 API 集成常见问题

Tadas Petra 是一名开发者关系工程师,致力于帮助开发者使用 ElevenLabs 产品。他还是开发者教育平台 Hungrimind 的创始人。此前曾任 Agora 首席开发者布道师和 Zero To Mastery 讲师。



