级联与融合模型:架构如何决定语音智能体是否适合企业应用
- 发布时间
- 最近更新
收听收听本文
大多数人认为,语音智能体要么采用级联架构,要么采用融合架构。实际上,智能体设计介于两者之间,会根据应用场景采用 5 种常见架构。
智能体的架构决定了它能否在生产环境中稳定运行、适应具体业务需求,以及在对话中听起来自然。像 OpenAI Realtime 模型这样的融合架构,在简短交流中可能听起来极具真实感。但当团队需要落实合规护栏、调试失败的响应,或在下个月有更强 LLM 发布时进行替换,单一融合网络几乎无路可走。
在 ElevenLabs,我们采用先进的级联架构。通过语音识别、推理和语音生成等专用组件,实现高智能性和可靠性。再结合上下文韵律、低延迟优化和智能轮次管理,让对话自然流畅。之所以这样设计,是因为我们服务的企业和政府需要既真实自然,又能在生产环境中可靠处理复杂任务的智能体。
本文将介绍 5 种主要架构、各自的优势和局限,以及我们如何看待部署在关键工作流程中的智能体基础架构。
团队选择架构时会评估什么
团队通常会从 3 个方面进行评估。
能处理复杂任务吗?
- 推理能力与模型灵活性:能否为应用场景选择最佳模型,包括当前最强的 LLM,并在有更优选择时升级?
- 智能体逻辑:能否定义和控制智能体遵循的对话流程、决策规则及升级路径?
- 工具使用:架构能否支持多步骤工具调用,以及与外部系统集成?
听起来和感觉上像人吗?
- 韵律:智能体能否呈现自然的节奏、语调和情感?
- 延迟:响应速度是否足以让人感觉在自然对话?
- 轮次管理:智能体知道何时该说话、暂停或让对方说话吗?
能在生产环境中信任它吗?
- 可靠性:智能体的行为是否可预测且一致,还是会随时间漂移?
- 护栏:架构能否防范意外响应或对抗性用户?
- 透明度:架构是否会产生中间输出,还是一个黑盒?
级联与融合架构之间的权衡
级联架构通过串联专用组件构建:语音转文本(STT)、大语言模型和文本转语音(TTS)。每个阶段都可独立优化、测试和升级。
级联架构
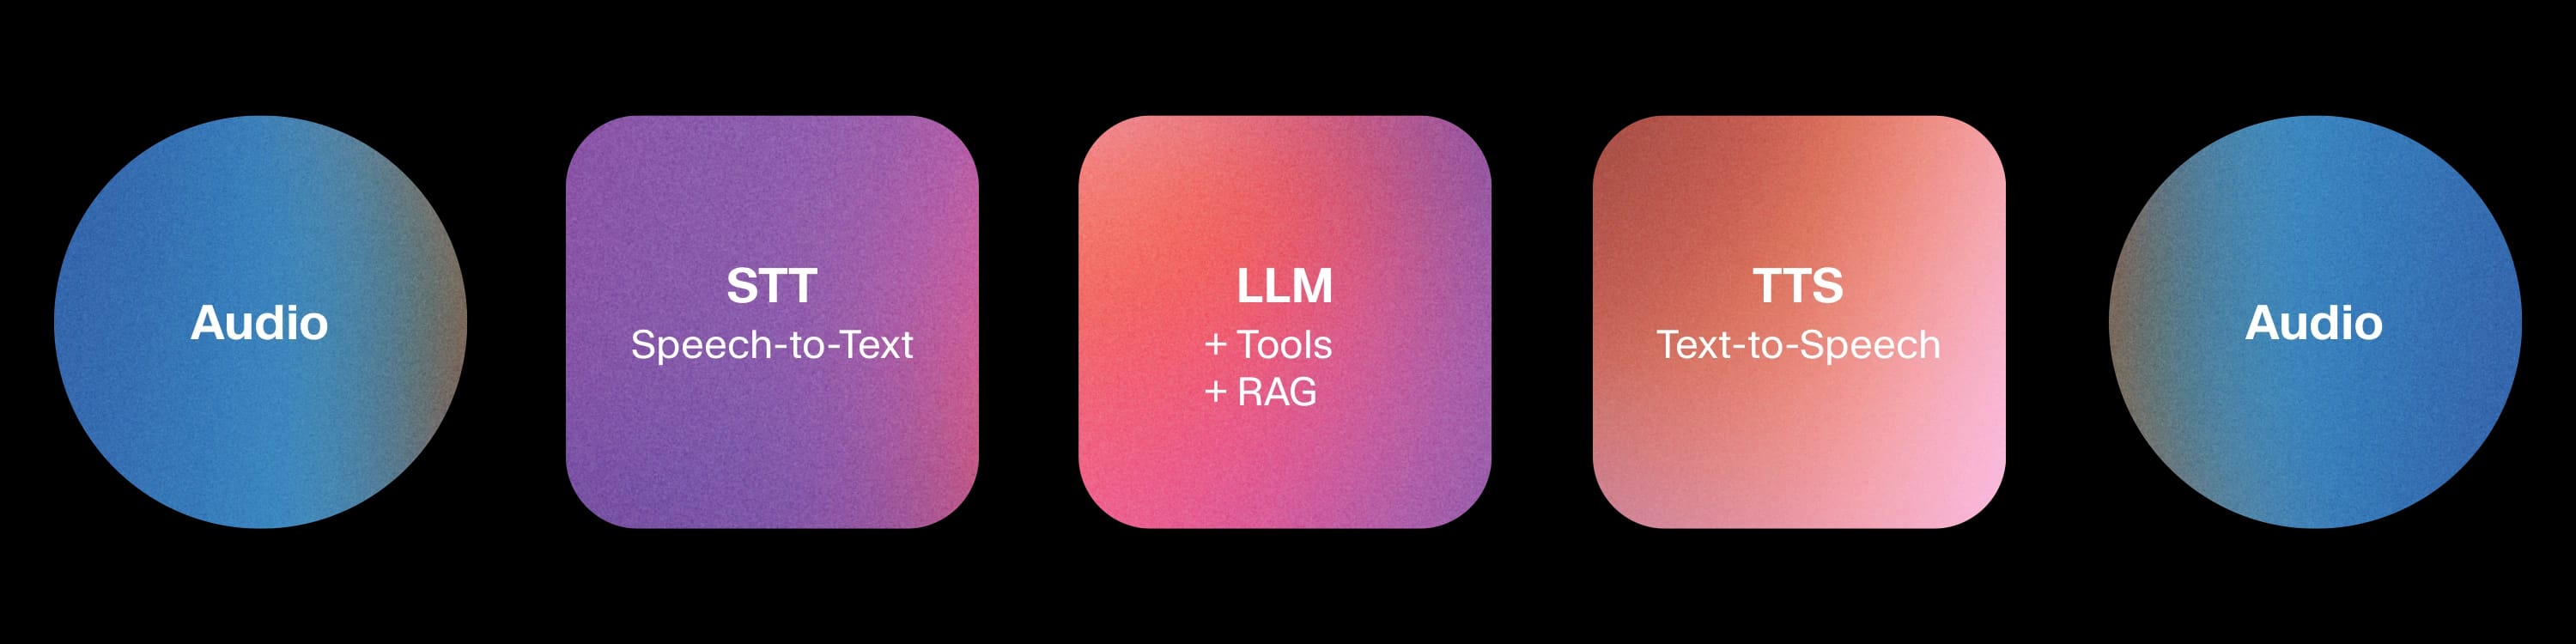
这种模块化正是级联架构成为大多数企业级智能体基础的原因。每个阶段都会产生可检查的输出:STT 与 LLM 之间、LLM 与 TTS 之间都有可读文本。可在文本层实施护栏,无需修改语音模型即可集成最新的前沿 LLM;出现故障时,通常也能定位根源。
级联架构长期受到的批评是会丢失韵律线索。语音被简化为文本,语调、节奏和情感必须在输出端重建。这些线索可通过显式建模部分恢复,但不如融合方法那样自然捕捉。延迟和轮次管理等其他维度,通常可在两种方法中优化到相近的性能水平。
融合模型
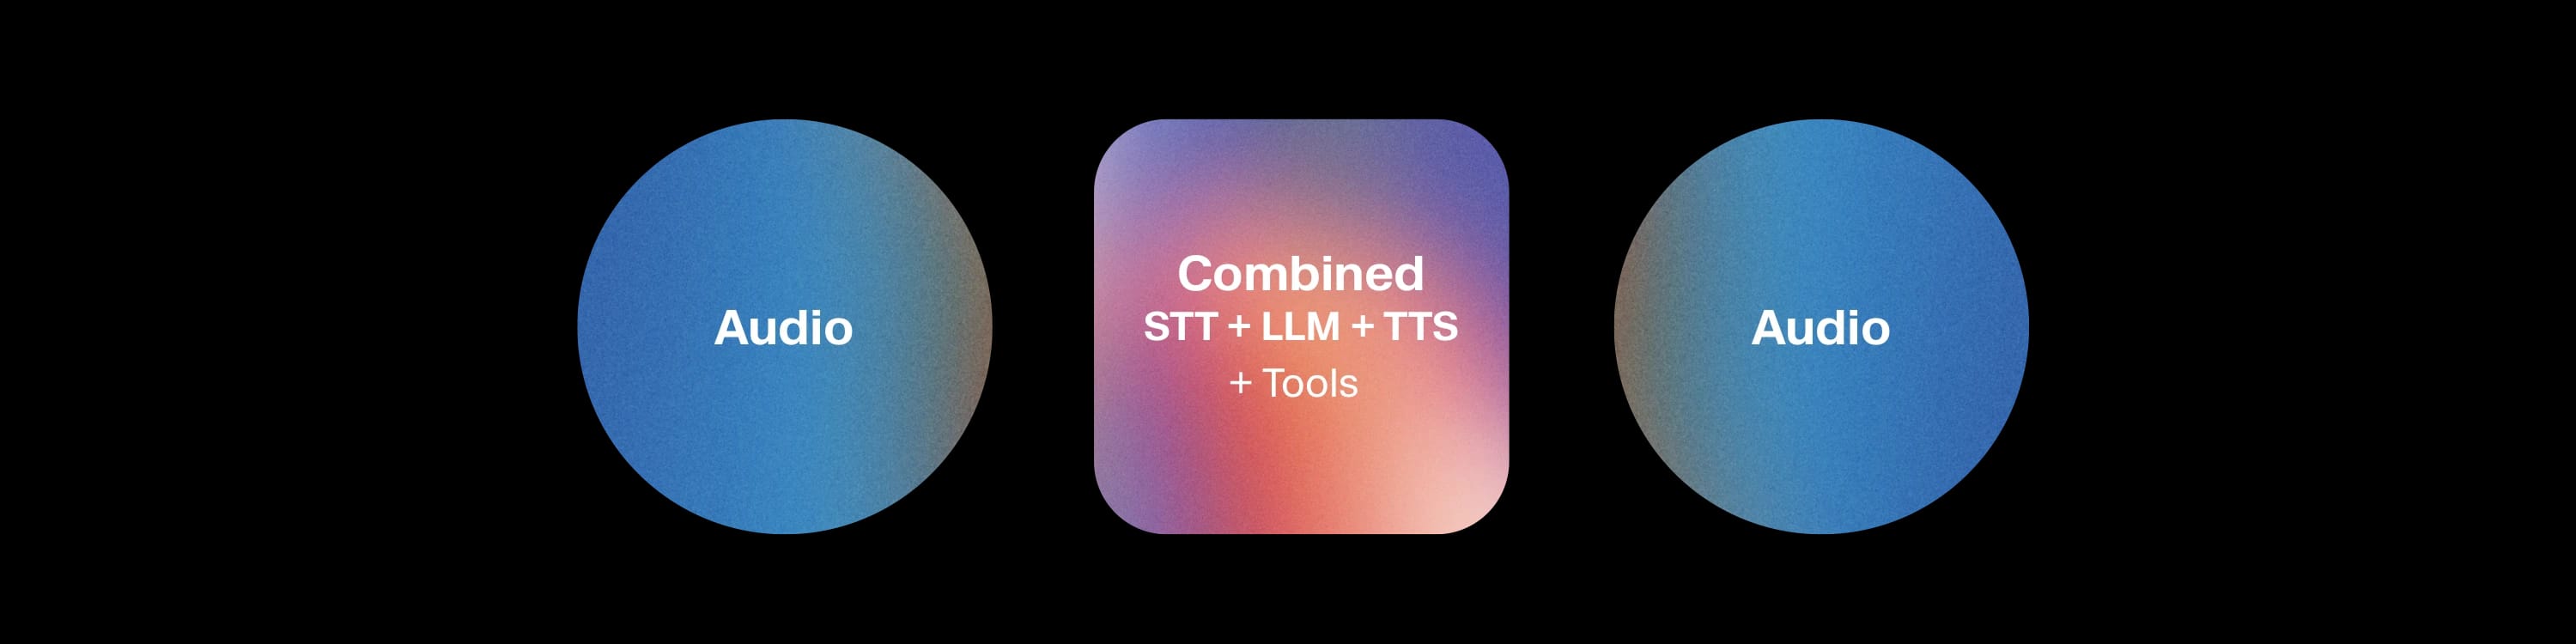
融合架构采用截然不同的方法。识别、推理和生成全都在单一多模态网络中完成。音频输入、音频输出,中间没有可检查的层。
没有中间阶段既是其吸引力,也是其局限。融合架构可以自然保留韵律线索,因为语音从未被拆解为文本。不过,它在实施护栏、替换单个组件或检查中间输出以进行调试方面能力有限。针对行业术语微调 STT,或集成不同 LLM 来增强推理和工具调用的能力也受到限制。系统是一个网络,团队只能使用其内置的推理能力;目前这通常意味着较轻量的核心,无法在复杂任务上匹敌前沿 LLM。
5 种架构
1. 基础级联
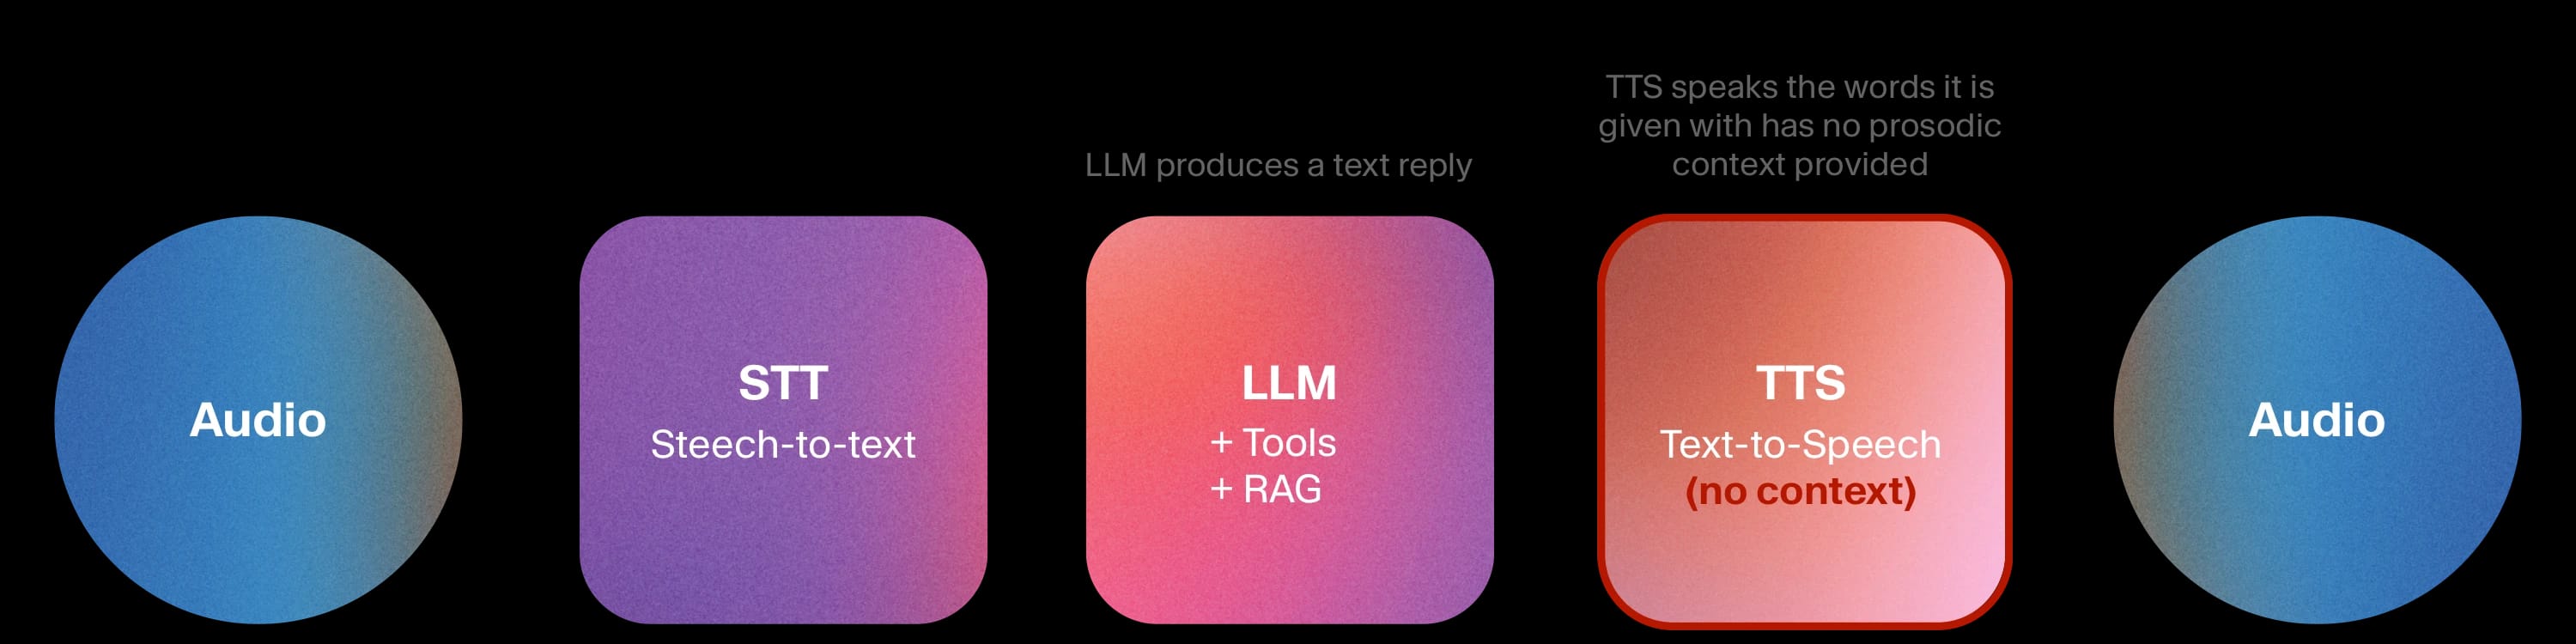
音频先被转写,LLM 生成文本回复,再由 TTS 朗读。每个阶段都基于纯文本运行,因此一切都可查看、测试和控制。
其可信优势很明确:文本层护栏、确定性的对话流程和完整审计轨迹。由于 LLM 是独立组件,可为智能体搭配推理或工具调用能力最强的前沿模型,并在更好的模型发布时立即升级。弱点在于对话质量:没有上下文 TTS,智能体虽能正常工作,但声音缺乏层次。它无法适应情感或产生韵律变化,适合播报账户余额,却不足以应对沮丧的客户。
示例用例:
- 电信和公用事业领域的 IVR 替代方案
- SaaS 入门流程中的 FAQ 处理
- 预约确认、处方提醒和配送通知等外呼通知,此类场景中一致性比亲和力更重要
2. 高级级联
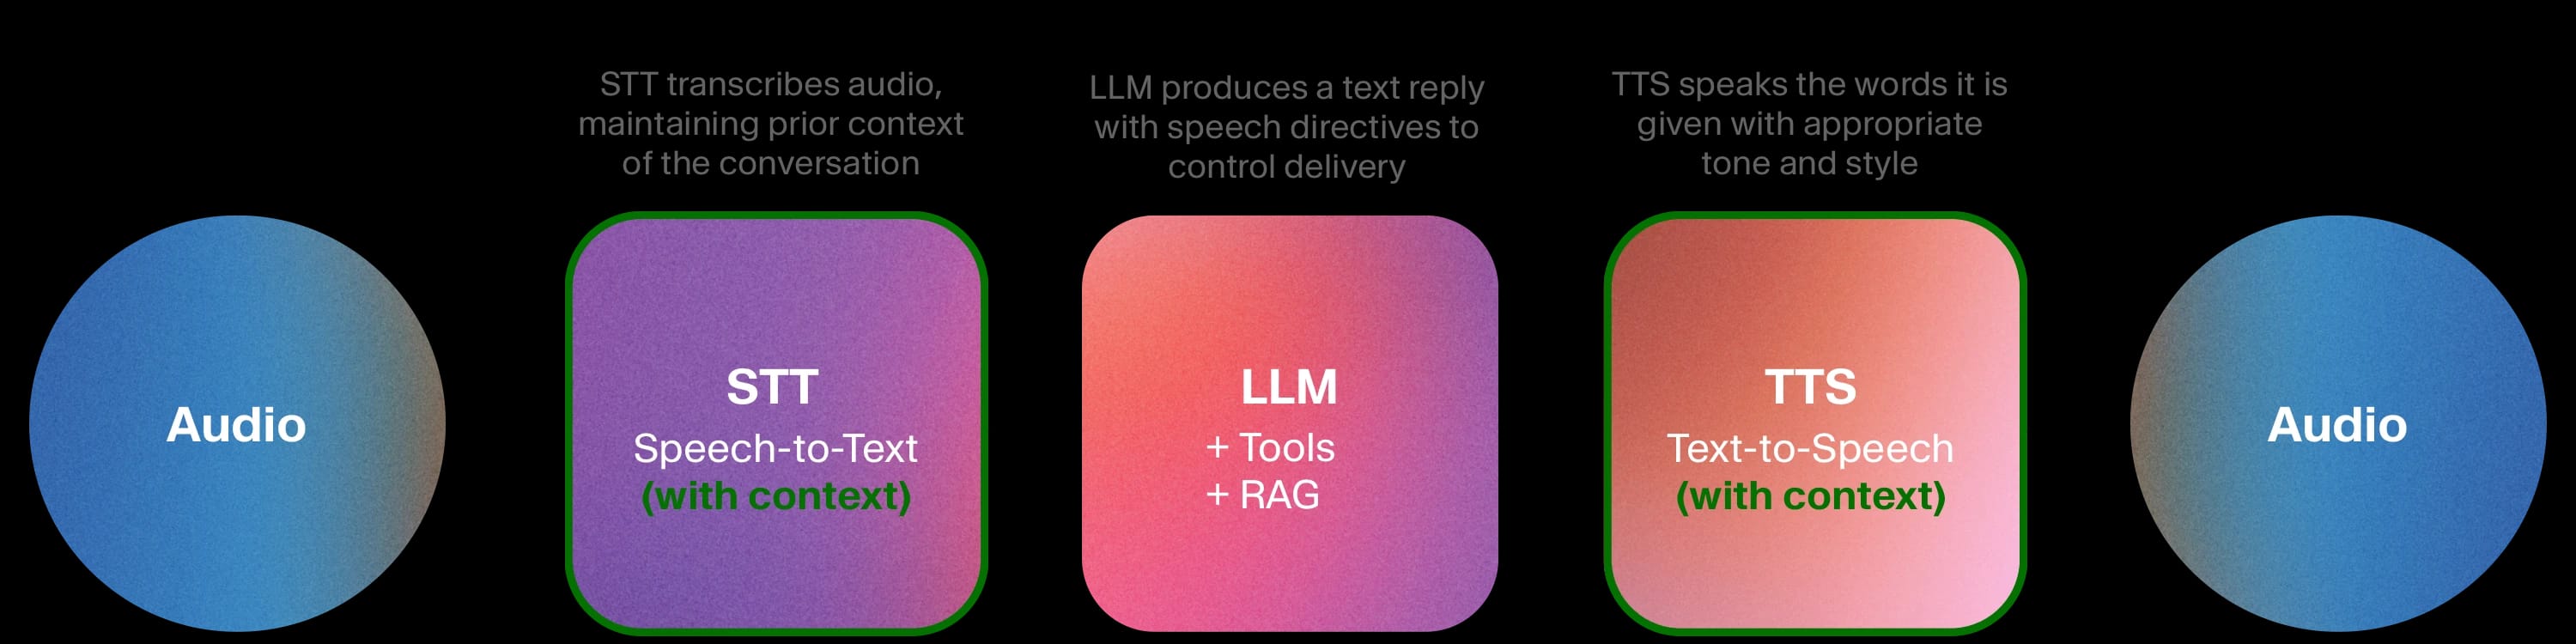
同样的模块化架构,但现在多个组件可利用更丰富的上下文协同工作。这正是 ElevenAgents 中的 Expressive Mode,以及最新 语音转语音 模型 Eleven Realtime 的基础。
Scribe v2 Realtime STT 模型会结合对话的先前上下文,快速准确地生成转录文本。LLM 根据文本指示 TTS 如何表达语音,而不只是说什么,例如“令人安心地”“加重语气地”“紧迫地”,并在整个对话中动态调整语气。轮次交接系统利用相同信号,让智能体判断何时回应、何时让对方继续说话。语音模型集中部署在同一技术栈中,组件之间无需网络跳转,因此延迟保持较低。
该架构保留了基础级联的全部优势:完全透明、文本层护栏、组件可替换、领域微调,以及可使用最强的工具调用和推理模型。它还显著提升了韵律、延迟和轮次管理。团队可在新的前沿 LLM 发布当周完成集成,或针对医疗保健领域的 STT术语进行微调,而无需重建其他组件。
示例用例:
- 客户支持,适用于金融服务;在争议扣款通话中提供共情表达,同时配合严格的合规护栏和完整交互日志
- 医疗接待员以适当的紧迫感分诊患者来电,遵循 HIPAA 合规流程,并通过领域微调的语音识别处理医疗术语
- 销售助手在遵循结构化策略手册并将更新推送至 CRM 的同时,保持温暖、有说服力的语气
3. 混合级联与融合
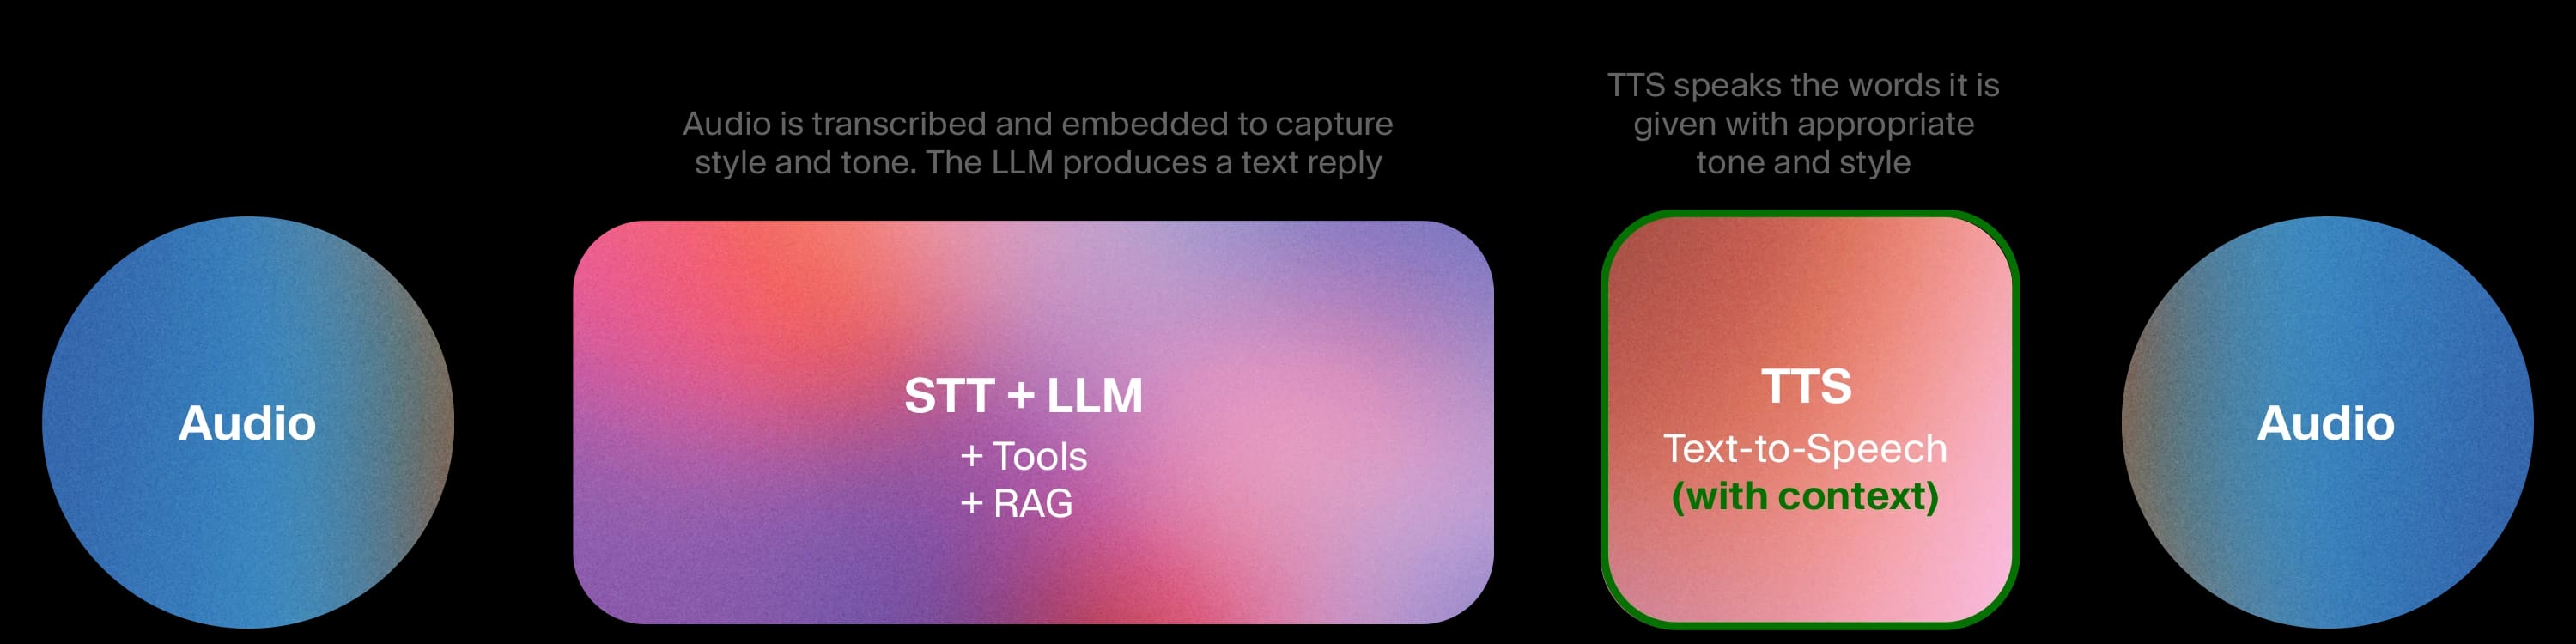
有些架构会将输入语音的声学特征(发音、情绪、语气)以嵌入向量形式直接输入 LLM,而不是先转换为文本。TTS 仍保持模块化。
这让 LLM 能更丰富地理解一句话是 如何 说出来的,而不只是说了什么,这对特定应用很有价值。融合的 ASR+LLM 模块比清晰的文本交接更难审计,因为中间表示是嵌入向量,人无法直接阅读。LLM 也不再容易替换,因此推理和工具调用能力受限于构建该融合模块时所采用的模型。
示例用例:
- 语言学习和发音辅导,其中听出学生如何说话与理解他们说了什么同样重要
- 低复杂度、对语气敏感的支持场景,检测沮丧情绪很重要,但任务本身很简单。
4. 顺序融合
单一多模态模型一次完成识别、推理和生成,每次处理一个对话轮次。
韵律表现可能很强。由于语音从未被拆解成文本,模型能自然保留语速、语调和情感线索。简短对话听起来会非常流畅。
但没有文本层时,实施护栏的能力有限;可用于调试的中间输出有限;替换更好的 LLM 或为领域微调 STT 的灵活性也有限。其推理核心往往比前沿 LLM 更轻量,因此复杂的工具调用和多步骤任务表现受限。当任务需要解决复杂问题时,仅有韵律并不够。
示例用例:
- 个人陪伴应用、娱乐聊天机器人,以及以表现力推动互动、合规要求较低的应用。
5. 双工融合
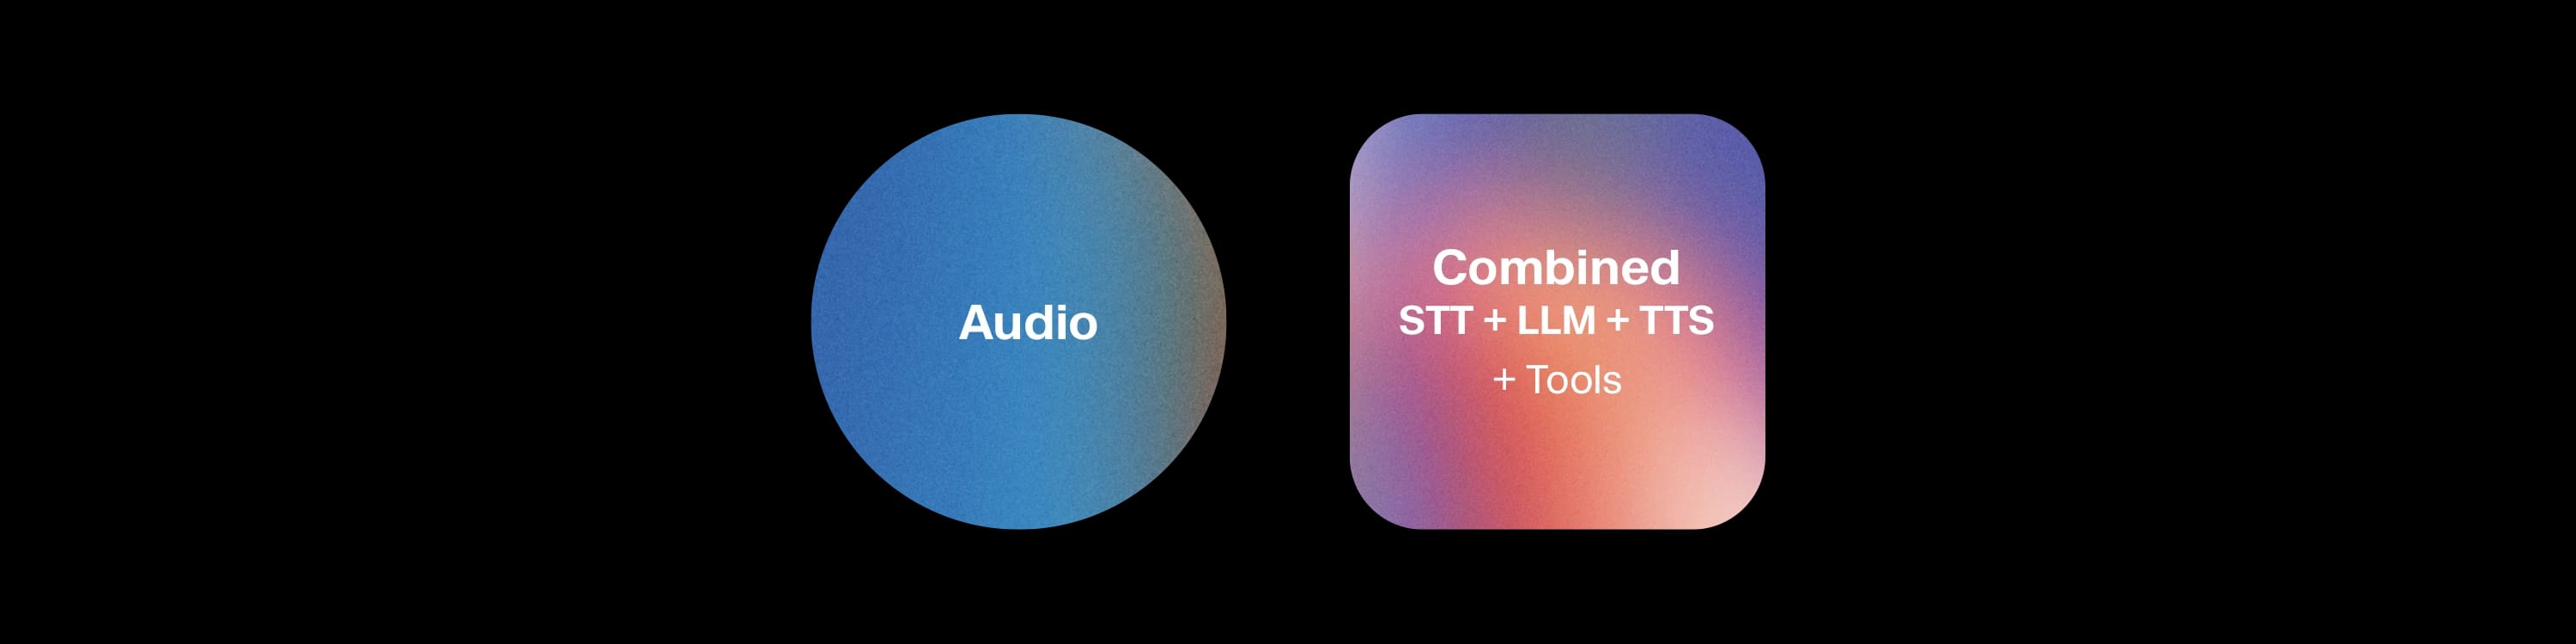
输入和输出会同时处理,模型一边听一边说。这能让简短交流显得格外自然,呈现真实的重叠说话和流畅的轮次切换。
这也是最难控制的架构,护栏极难实施,串音会带来不可预测的错误。检查、记录或调试极其困难,系统大多是封闭的,几乎无法替换组件、进行领域微调或自定义。由于同时处理为复杂逻辑留下的容量更少,推理和工具使用比顺序融合模型受到更多限制。而让短暂交流听起来自然的这种同时处理,也会让较长对话变得不稳定。
示例用例:
- 实验性陪伴应用、社交语音平台和研究演示,其中可接受不可预测的行为。
为应用场景选择合适的架构
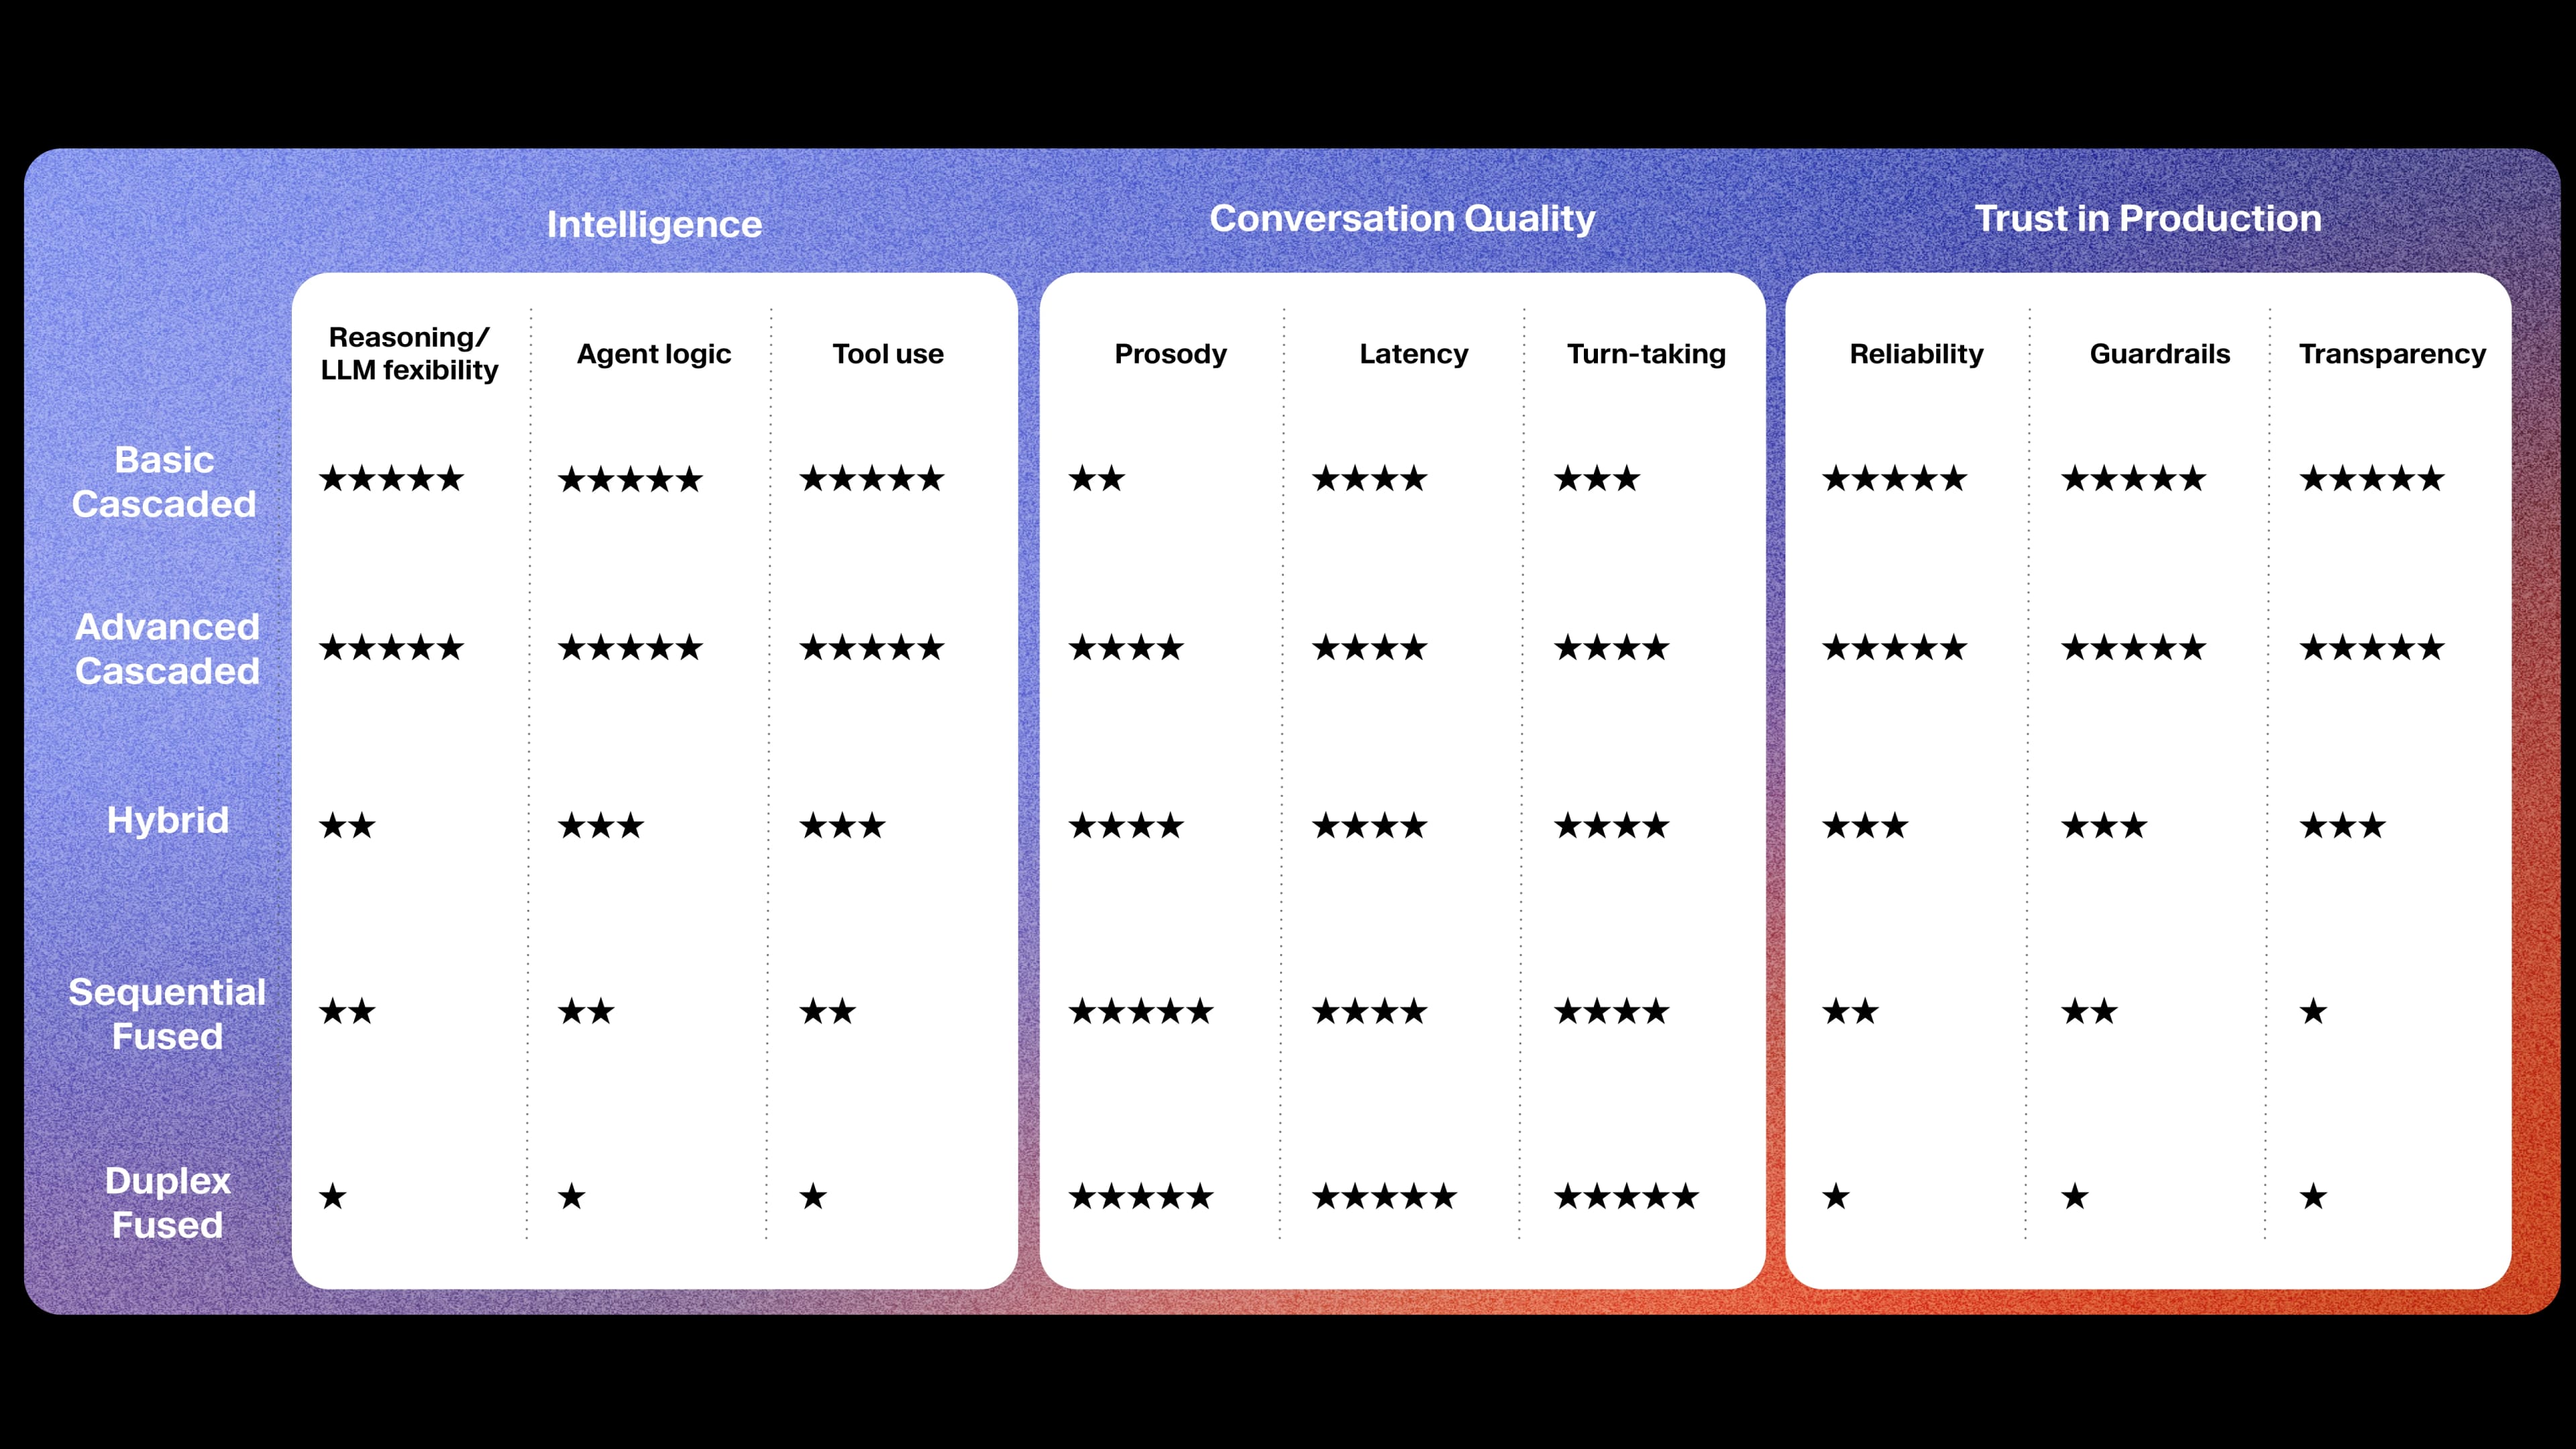
合适的架构取决于具体应用的需求。若构建的是以自然语音为核心功能的体验,只要愿意在前沿推理、护栏和透明度上做出妥协,融合架构确实具备优势。虽然融合模型在韵律上领先,高级级联系统每个季度都在接近;但受架构层面限制,融合模型在复杂推理或可信性上尚未取得实质进展。
对大多数企业和政府而言,最佳架构应当既音质出色,又具备能力、可定制、可信赖,并可大规模部署。因此,我们选择使用先进级联架构构建ElevenAgents,并投入研发Expressive Mode以及经过协同优化的一流语音转文本和文本转语音模型。这让团队能够构建智能体,兼具高智能性、可靠性和可控性,以及自然、类人的语音。
随着 AI 智能体不断扩展至客户支持、教育、个人助理等更多领域,成功的智能体将建立在适合其具体应用场景的架构之上。