SSML 标签详解:如何控制文本转语音中的停顿、发音和语速
- 发布时间
语音合成标记语言(SSML)是一种基于 XML 的标记语言,可将文本包裹在标签中,告诉 文本转语音 模型应如何朗读,包括何处停顿、如何发音,以及强调哪些短语。
你已经听到的许多 AI 语音背后都有这一控制层。例如,朗读确认号码的交互式语音应答(IVR)系统,以及在章节结尾停顿的 AI 有声书 旁白,都依赖某种形式的它。如果你曾自定义 AI 生成的语音,很可能接触过 SSML。
SSML 已成为 TTS 技术的一部分超过 20 年,至今仍是许多服务商提供 TTS 的重要方式。本指南将介绍 SSML 的定义、它在 ElevenLabs 各模型中的具体适用范围,以及经过改进的 Audio Tags 系统,Eleven v3 和 Eleven v4 借此提供业界领先的自然文本转语音。
使用 Audio Tags 查看 Eleven v4 的实际效果
探索 Eleven v4摘要
- SSML 是一种 源自 W3C 的标记语言,用于控制合成语音的停顿、强调、发音和节奏。
- 除 Eleven v3 和 Eleven v4 外,ElevenLabs 模型均支持 SSML <break> 标签,可实现最长 3 秒的停顿。
- Eleven Flash v2 和 Eleven Turbo v2 支持 <音素> 标签,用于自定义英文发音。
- Eleven v3 和 Eleven v4 完全不支持 SSML。它们改用 Audio Tags,通过 [whispering] 和 [sighs] 等方括号内的自然语言指令控制合成语音的表达。
- WebSocket API 通过 enable_ssml_parsing 参数控制 SSML 解析,并将 SSML 标签作为完整消息发送,以避免增加延迟。
- ElevenLabs 模型不支持 <prosody>、<say-as>、<sub>、<lang>、<voice> 和 <audio> 等标签,但每种都有替代方式:音色设置、文本规范化、发音词典、多语言模型、独立的 音色 和 音效。
什么是 SSML?
SSML 是一种标记语言,让你能在书面文本中添加合成引擎应如何朗读的指令。万维网联盟(W3C)将其制定为标准,以扩展纯文本转语音模型的能力。SSML 为段落发音提供明确、机器可读的指令,而非依赖纯文本解释模型。
SSML 并非某一家服务商独有的标记语言。Amazon Polly 和 Microsoft Azure Speech 都将 <break> 和 <emphasis> 等 SSML 标签作为主要控制机制。大多数云端文本转语音平台都接受某种版本的该标准。早在生成式语音模型出现之前,SSML 就已是标注语音的默认方式。
SSML 仍是基础标准,同时,针对特定模型的新型控制方式也随现代生成式语音技术不断发展。SSML 背后的供应商中立规范让服务商能够实现通用核心标签,并在其上添加各自的扩展和限制。
改善语调的常见 SSML 标签及其作用
各类 SSML 实现都共享一组核心标签,人们在尝试控制合成语音时通常会搜索这些标签。
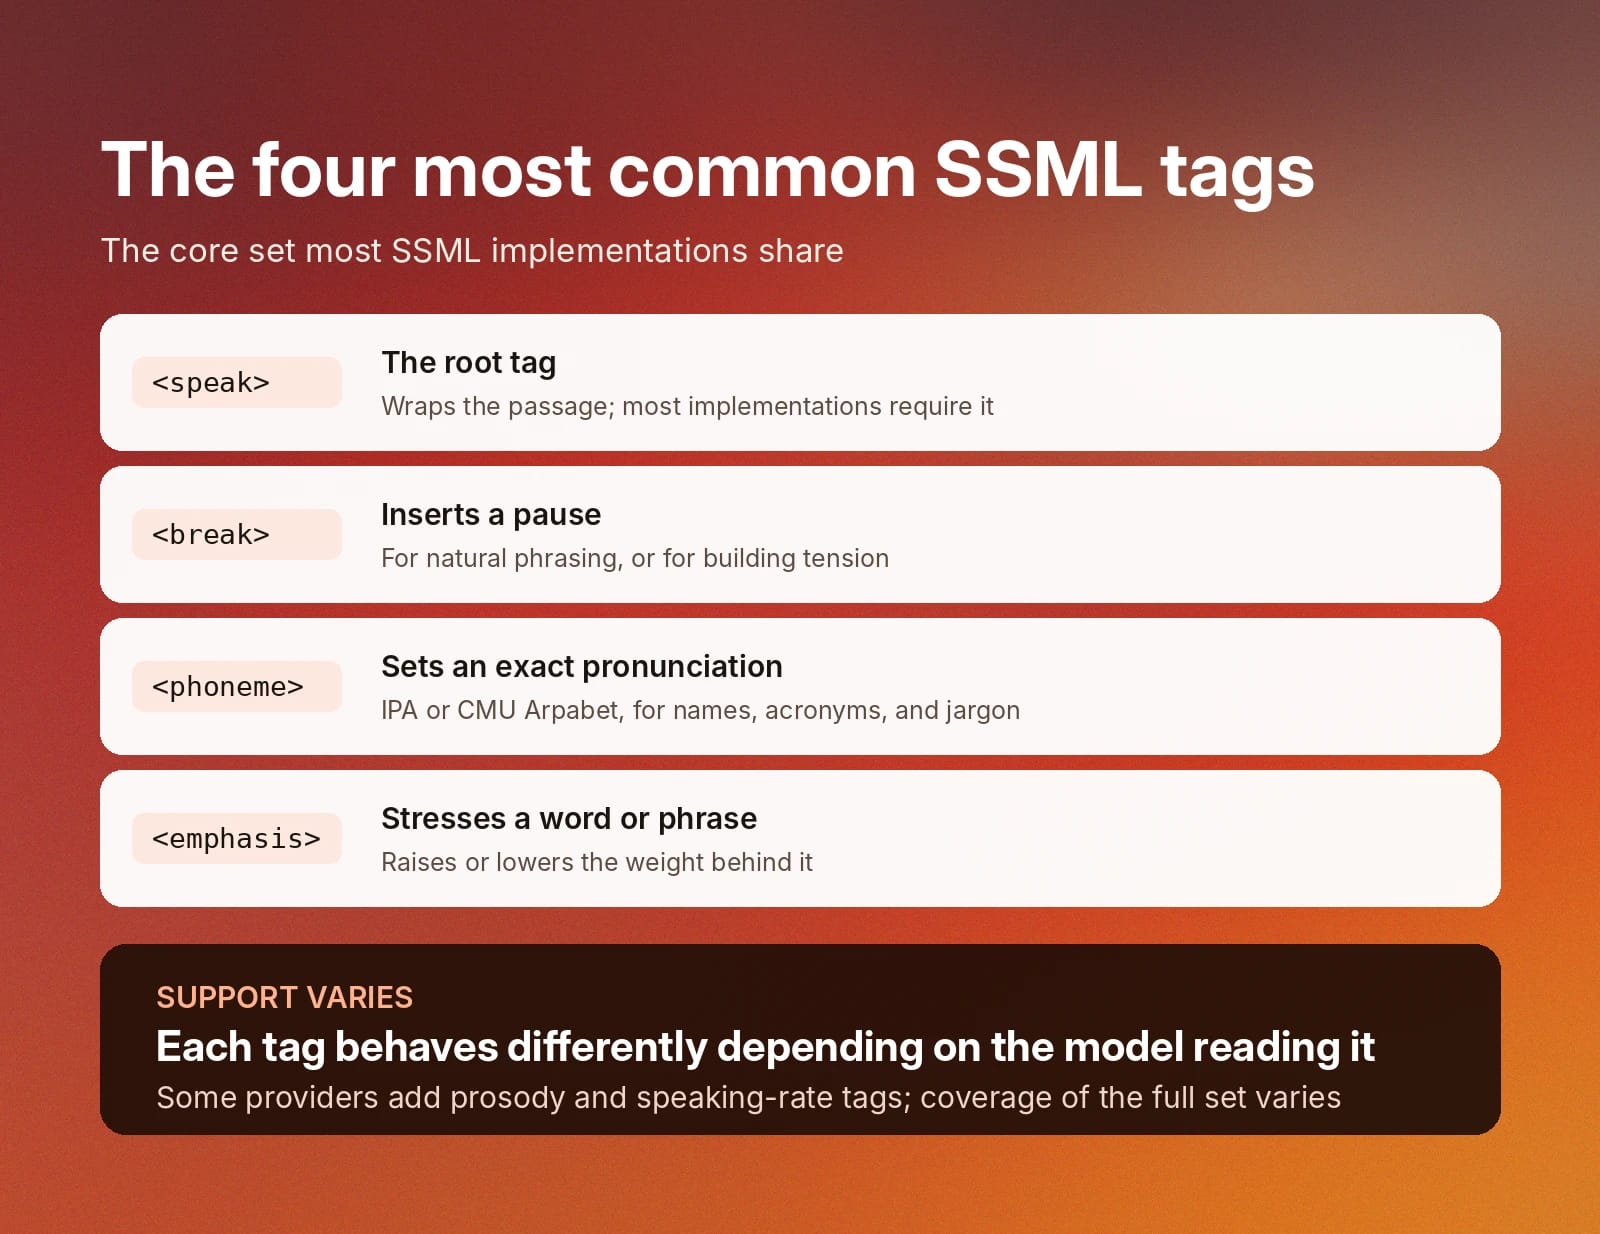
这些常见的 SSML 标签包括:
- <speak>:用于包裹完整段落的根标签。大多数实现需要它来识别其中内容为 SSML。
- <break>:插入指定时长的停顿,适合在分句或句子间实现自然停顿,或为文本营造悬念。
- <phoneme>:使用 IPA 或 CMU Arpabet 等音标字母指定单词的准确发音,适用于缩略词、名称或技术术语。
- <emphasis>:强调某个单词或短语,模拟说话者自然加强或减弱其语义分量的方式。
这 4 种标签在不同 TTS 模型中的表现各不相同。一些服务商还支持控制韵律或语速的额外标签。即使两个服务商都宣称支持 SSML,为一个 TTS 服务商编写的脚本也不会在另一个服务商中有相同表现,因为完整标签集的支持范围不同。
差异最大的部分在于,某个文本转语音模型实际会处理哪些标签,这正是 ElevenLabs 实现方式的具体之处。
在 ElevenLabs 中使用 SSML
ElevenLabs 对 SSML 的支持并不完全一致,具体取决于你选择哪个模型生成音频。<break> 是支持最广泛的元素,<phoneme> 则仅适用于较少的模型。
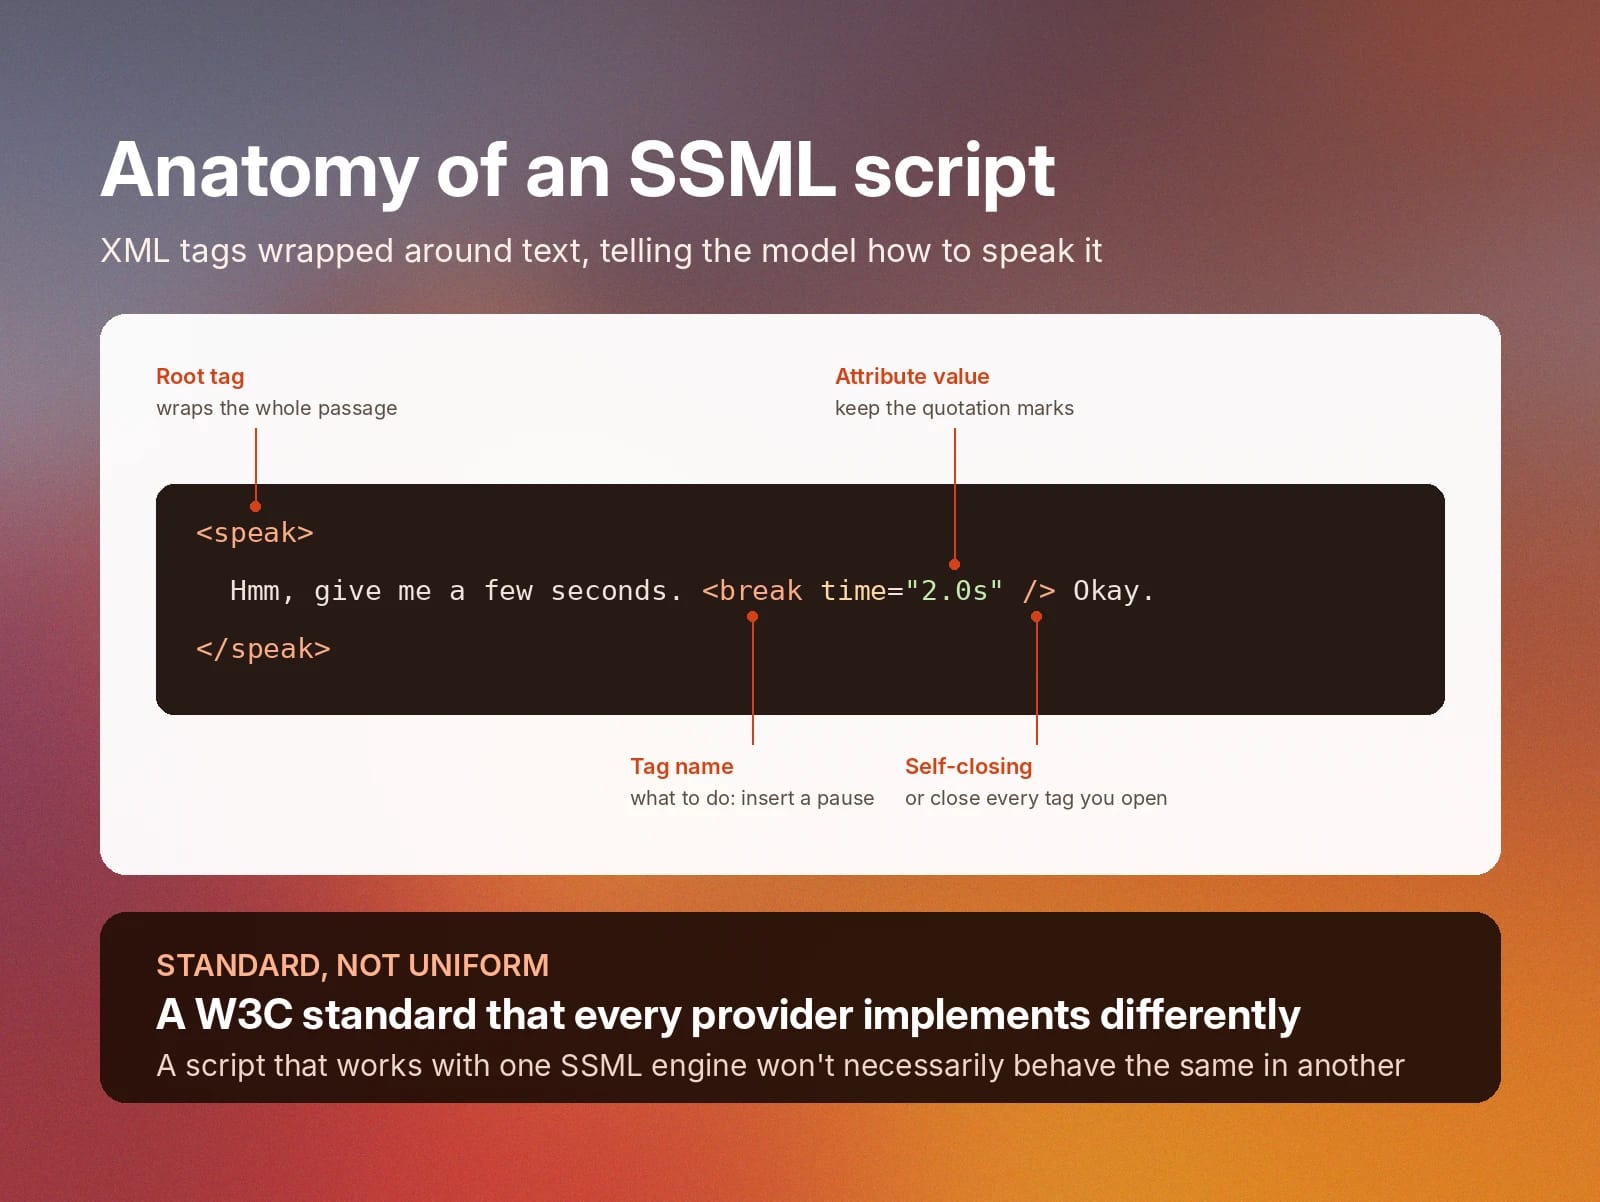
较早的 ElevenLabs TTS 模型,例如 Multilingual v2,支持 <break> 标签,停顿最长可达 3 秒。例如,某个 AI 智能体 可能会说:“稍等,让我想想”,然后使用 <break time="2.0s" />,在继续说“好的,我知道该怎么帮你了”前产生可听见的停顿。这是许多 workflow 中最常用的标签,因为它有助于模拟更自然的对话风格。
使用 SSML 标签时,最好一次只使用少量标签。在一个句子或段落中使用太多标签,可能导致模型意外改变语速或出现各种音频伪影。不同音色处理停顿的方式也不同,尤其是训练样本中含有“uh”或“um”等填充词的音色。
ElevenLabs 中的 SSML 实践
ElevenLabs 的 Flash v2 和 Turbo v2 模型更进一步,还支持 <phoneme> 标签来自定义发音,但仅限英文。这使该标签适合纠正模型对名称、缩略词、技术术语或其他业务用语的发音,前提是脚本运行在这两个模型之一上。
相反,Eleven v3 和 Eleven v4 完全不同。它们使用 Audio Tags 控制表达。此外,Eleven v4 引入原生内联 IPA 支持,可直接读取文本中以斜杠包裹的 IPA 符号。下文将介绍替代 break 标签和表达控制的方式。
如需了解 ElevenLabs 文本转语音控制功能的完整说明,包括发音词典和文本规范化,请查看 最佳实践指南。
ElevenLabs 的 SSML 代码示例
以下示例展示如何在脚本和 API 调用中使用 SSML。请记住,除 Eleven v4 和 Eleven v3 外,<break> 适用于所有模型;<phoneme> 仅适用于 Flash v2 和 Turbo v2(仅英文)。
使用 SSML 语音控制添加停顿
将文本和标签包裹在 <speak> 块中,并保留属性值两侧的引号:
了解更多有关停顿及 通过 ElevenAPI 使用 SSML phoneme 标签的信息。
使用 <phoneme> 修正发音
使用 IPA 或 CMU Arpabet 精确拼写单词的发音。这里名称“Siobhan”使用 IPA 指导发音,而“Madison”使用 CMU Arpabet 标注:
在 Python 中使用 SSML 生成语音
此调用将包含 break 标签的脚本发送至支持该标签的模型:
在 JavaScript 中使用 SSML 生成语音
下面是一个类似的 SSML 语音生成示例,但使用 JavaScript 编写。
SSML 与 WebSocket API:在 TTS API 中使用 SSML
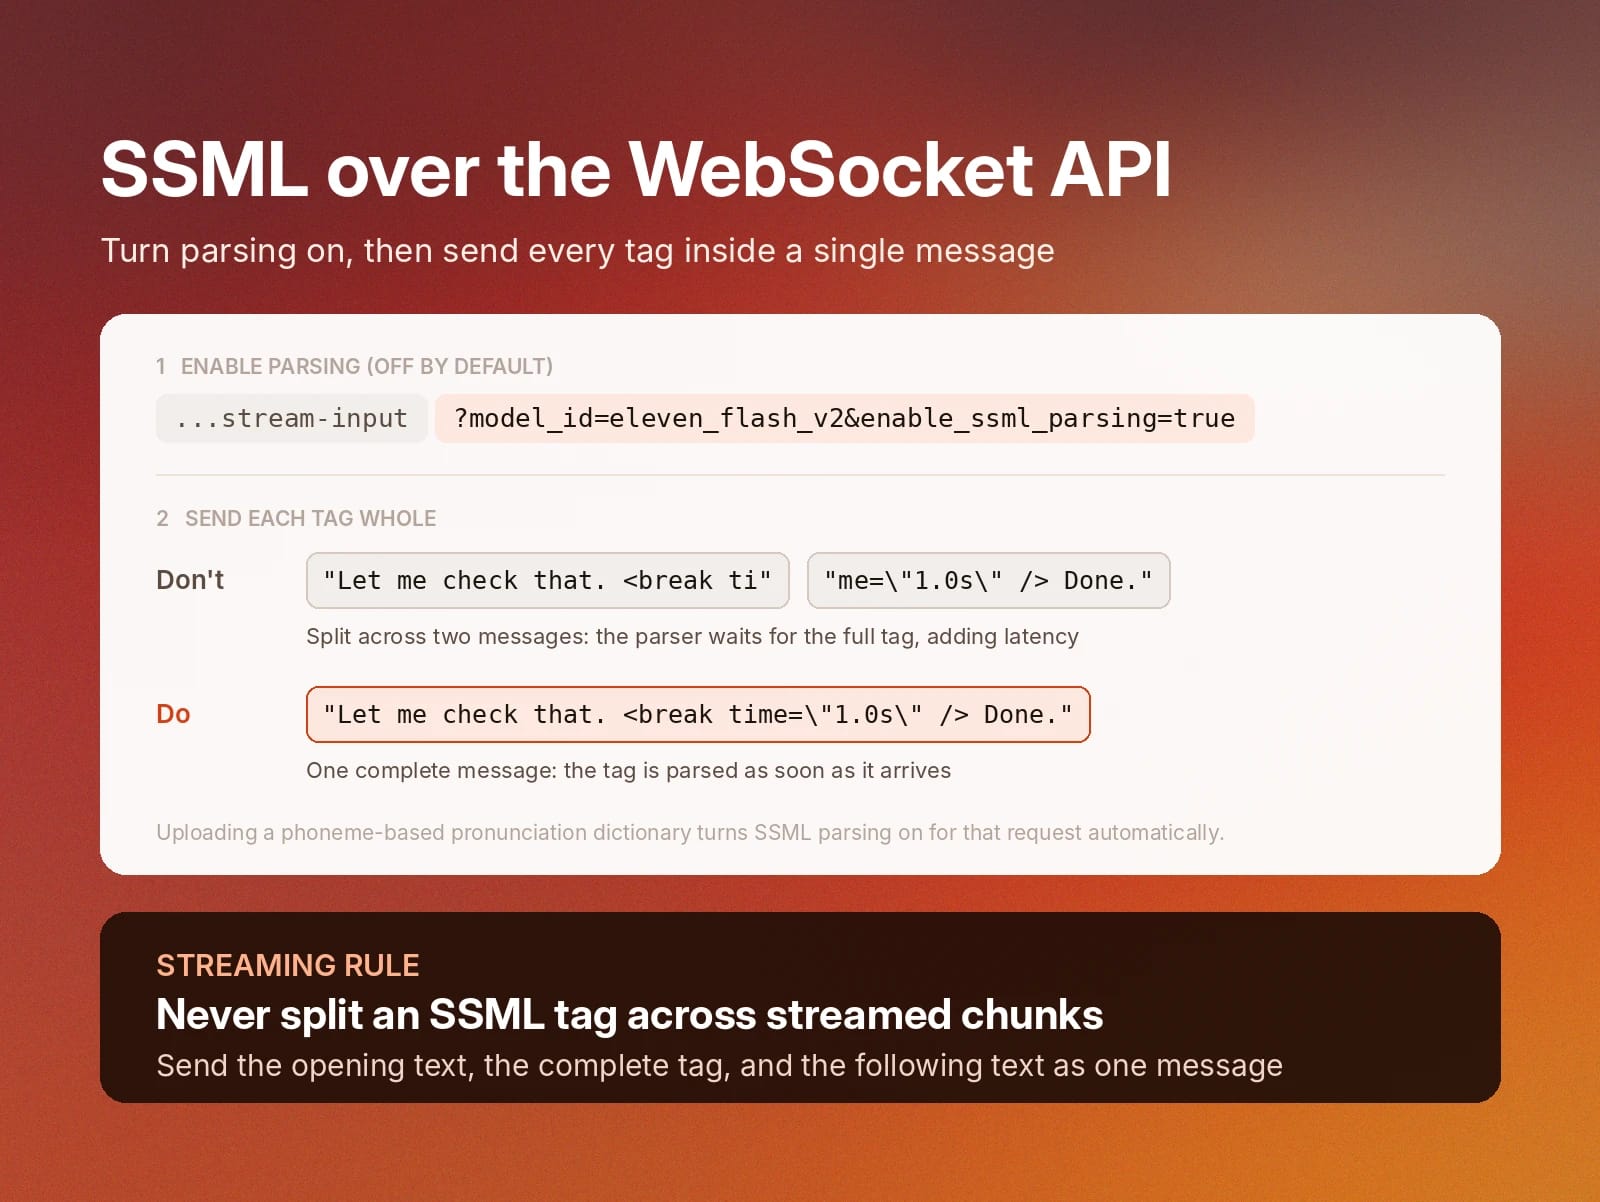
通过 ElevenLabs 的 WebSocket API 流式传输音频,而非使用标准 HTTP 请求时,需要显式启用 SSML 解析。该功能默认关闭,可通过 enable_ssml_parsing 参数控制。
为获得最佳效果,建议将每个 SSML 标签作为完整独立的消息发送,而不要拆分到多个流式区块中。由于解析器需要先获得完整标签才能处理,在消息中途拆分标签会增加延迟。
上传基于音素的 发音词典 后,即使未明确设置 enable_ssml_parsing 参数,也会自动为该请求启用 SSML 解析。有关 WebSocket API 可用的完整参数详情和消息格式,请查看此文档指南:实时生成音频。
以下示例在连接 URL 中启用 SSML 解析,并在单条消息中发送完整的 break 标签:
ElevenLabs 不支持的 SSML 标签及替代方案
改用 Audio Tags 系统后,ElevenLabs 文本转语音模型为用户提供了更灵活、更精细的音频输出控制。Audio Tags 完全以自然语言编写,因此非常容易添加到脚本中。
如果你使用的是较早的 ElevenLabs 模型,了解支持哪些 SSML 标签会很有帮助。由于有许多更优的替代方案,早期 ElevenLabs 模型现在只处理 <break> 和 <phoneme>,其他 SSML 标签可通过其他方法实现。
你可能从 W3C 规范中了解的其他 SSML 标签不会被作为标记读取,因此每种都需要采用不同方法。以下是在 ElevenLabs 中替代其他 SSML 标签的方式:
SSML 标签
作用
替代方案
<prosody>
设置音高、语速和音量
速度和稳定性音色设置。在 Eleven v3 和 Eleven v4 中,可使用 [slowly] 或 [rushed] 等表达 Audio Tags
<emphasis>
强调单词或短语
使用大写或标点进行强调。在 Eleven v3 和 Eleven v4 中,可使用 [shouts] 等标签
<say-as>
控制数字、日期和缩略词的读取方式
文本规范化、将值拼写成文字,或使用发音词典规则
<sub>
替换书面单词的朗读形式
发音词典别名规则
<lang>
切换短语的语言
使用多语言模型,并以目标语言写出该短语
<voice>
在脚本中途切换说话者
为每个音色单独生成,或在 Eleven v3 和 Eleven v4 中使用多说话者对话
<audio>
插入录制的音频文件或声音
在 Eleven v3 和 v4 中使用音效 Audio Tags、ElevenLabs 音效工具,或在生成后混音
韵律:使用 SSML 控制音高、语速和音量
SSML 的 <prosody> 标签可调整一段文本的音高、语速和音量。在较早的 ElevenLabs 模型中,可通过速度音色设置控制节奏,通过稳定性设置控制表现力;两者均应用于整段生成内容,而非单个短语。
若要在脚本中改变节奏,可将文本拆分为多次生成,或在句子之间添加 <break> 标签。在 Eleven v3 和 v4 中,使用上表中的 Audio Tags,例如 [slowly]、[rushed] 和 [whispers],直接将其放入文本行中。
发音:SSML 中的 <phoneme>、<say-as> 和 <sub>
ElevenLabs 提供 3 种方式来控制 TTS 输出的发音。
主要方法如下:
- 如上例所示,在 Flash v2 或 Turbo v2 中使用 <phoneme> 进行一次性修正。
- 对于在多个脚本中反复出现的术语,使用发音词典。词典可包含音素规则和类似 <sub> 的别名规则,例如将“UN”映射为“United Nations”。
- 对于 <say-as> 所处理的数字、日期、货币和电话号码等内容,可依赖文本规范化,将书面值转换为口语化词语。若某个值必须以唯一方式读取,例如确认号码,请在脚本中拼写出来或将数字分开写。
语言和区域设置
SSML 的 <lang> 标签用于标记属于另一种语言的短语。ElevenLabs TTS 模型不会读取此标签。请改为选择多语言模型,并以应朗读的语言写出该短语。
Flash v2 和 Turbo v2 仅支持英文,因此混合多种语言的脚本需要使用 Multilingual v2、Flash v2.5、Eleven v3 或 Eleven v4 等多语言模型。Eleven v4 和 v3 还支持 [French accent] 等口音标签,以及覆盖 70 多种语言的 IPA 转写。
音频和音效
SSML 的 <audio> 标签可在语音回复中播放录制片段。ElevenLabs 不支持该 SSML 标签,因为我们的 TTS 模型可以根据自然语言提示词生成全新的音效。
要在语音中添加声音,只需写入音效标签,例如 [applause] 或 [door slamming],Eleven v4 和 Eleven v3 就能将其呈现出来。如需更长或更精细的声音设计,可 生成音效,然后在编辑器或制作 workflow 中将其与人声音轨混合。
ElevenLabs 的 SSML 最佳实践
如果你使用的是较早的 ElevenLabs TTS 模型,仍可部分使用 SSML 标签。记住,你随时可以切换到 Eleven v4,充分利用 Audio Tags;这样就再也不必查找 SSML 标签的精确写法。
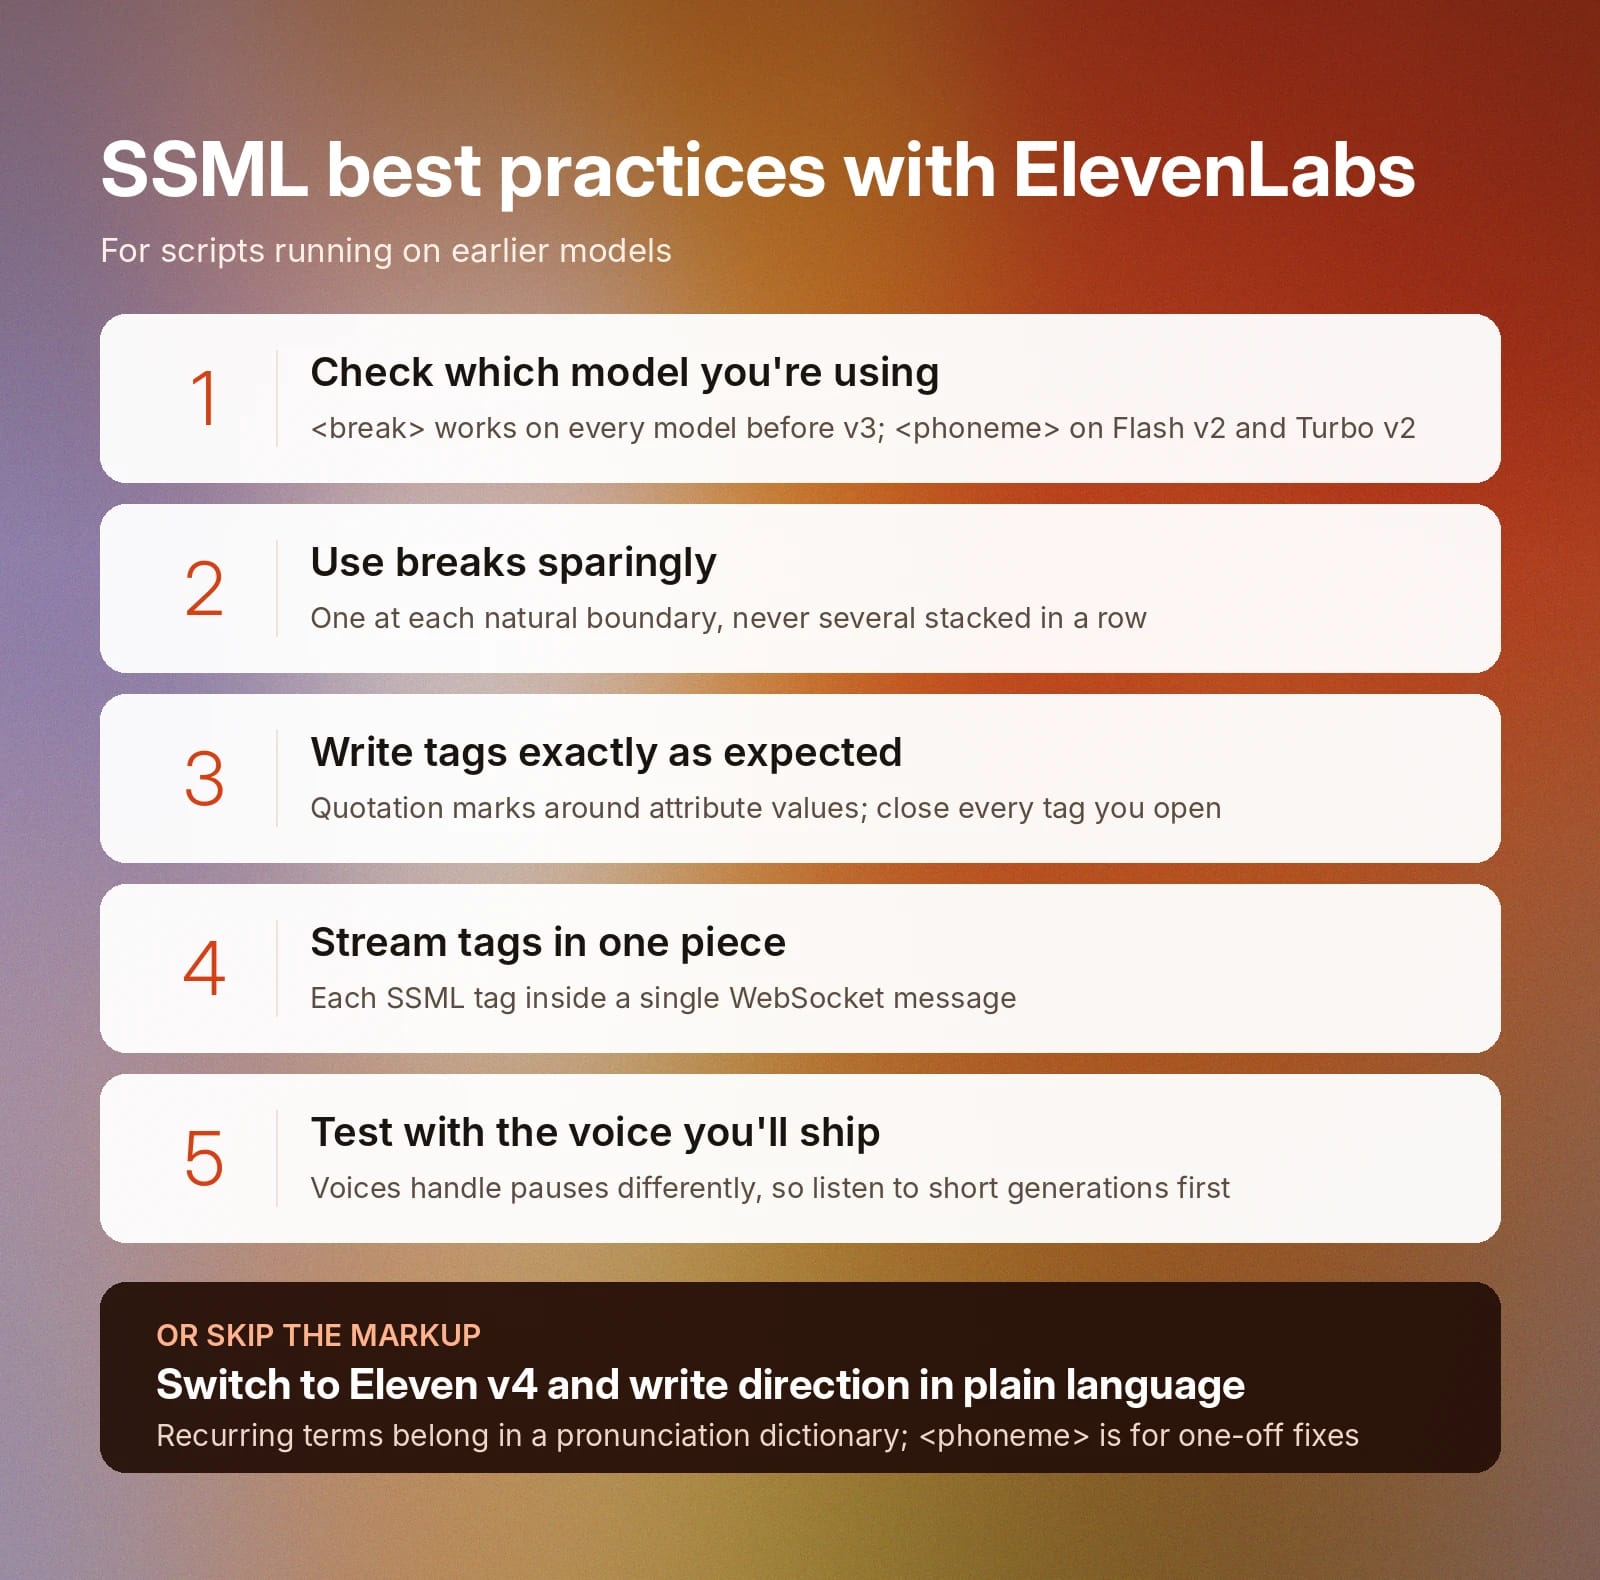
在 ElevenLabs 中使用 SSML 时,以下建议可帮助你快速上手:
- 确认所用模型:除 Eleven v3 外,<break> 适用于所有模型;<phoneme> 仅适用于 Flash v2 和 Turbo v2;Audio Tags 仅适用于 Eleven v4 和 Eleven v3 等较新模型。
- 适度使用停顿:在每个自然断点放置一个,而非连续堆叠多个。
- 按规范编写 SSML 标签:保留属性值两侧的引号,例如 <break time="2.0s" />,并关闭每一个已打开的标签。
- 完整发送标签:将每个 SSML 标签放在一条 WebSocket 消息中发送。
- 使用最终交付的音色测试:不同音色处理停顿的方式不同,因此运行完整脚本前请先试听较短的生成内容。ElevenLabs 的 声音库 中共有超过 17,500 种音色。
除这些 SSML 最佳实践外,对于会频繁出现的术语,建议使用发音词典。对于一次性修正,<phoneme> 是最佳选择。
SSML 的主要应用场景有哪些?
语音合成标记语言主要用于控制或微调 TTS 引擎生成音频片段的方式。它适合插入停顿、优化特定单词的发音,也能为 AI 生成的语音加入 韵律。
以下是该标准特别实用的一些 SSML 应用场景:
- 交互式语音应答(IVR)系统:当 IVR 系统 需要在提示和菜单之间停顿,或清晰朗读数字时很有用。
- 对话式 智能体:在回复前添加短暂停顿,让交流听起来更自然。
- 有声书 和长篇旁白:在章节结尾和场景之间停顿,清晰区分不同段落。
- 在线学习和培训:修正产品名称、技术术语、缩略词和特定业务术语的发音。
- 通知和提醒:控制日期、时间和参考代码的读取方式。
虽然 SSML 确实有多种应用场景,但通过 Audio Tags,无需记忆并在脚本中插入通常复杂的 SSML 标签,也能实现所有这些功能。Eleven v4 和 Eleven v3 创建了 Audio Tags 系统,让用户无需 SSML 的繁琐操作即可完全控制 AI 生成的语音输出。
为什么 Eleven v4 使用 Audio Tags 而非 SSML
Eleven v4 使用 Audio Tags 作为控制表达和优化发音的另一种机制。它可读取直接写在脚本文本中的内联方括号指令,让你用自然语言创建特定输出。这些 Audio Tags 可涵盖多种指令,包括:
- 情绪或感受,例如 [sad] 或 [excited]
- 表达和节奏,例如 [whispers] 或 [rushed]
- 人类反应,例如 [sighs] 或 [laughs]
- 口音和角色声音,例如 [French accent]
- 音效,包括 [applause] 或 [door shutting]
采用这一设计的原因在于该模型读取对话上下文的方式。Eleven v4 的架构比早期模型更深入地读取上下文,无需单独的参数或设置,即可理解情绪提示、语调变化、说话者转换和上下文线索。
SSML 会在文本固定位置提供具体指令,使表达显得生硬、断续。尽管底层模型质量很高,SSML 仍是 AI 文本听起来机械的主要原因之一。
[whisper] 这样的提示会为 Eleven v4 提供一项诠释指令,它会应用于周围文本行,并受周边内容整体韵律的影响。
大多数 SSML 元素都有直接对应的 v4 替代方案:
SSML 标签
作用
Eleven v4 对应方式
<break time="1s">
插入停顿
[pause]、省略号或换行
<prosody rate="slow">
放慢语速
[drawn out] 或 [slowly]
<prosody rate="fast">
加快语速
[rushed]
<emphasis>
强调特定单词
[shouts] 或将单词大写
<prosody pitch="high">
提高音高
[excited] 等情绪标签
<prosody pitch="low">
降低音高
[sorrowful] 等情绪标签
发音也遵循相同的替代模式。Eleven v4 原生支持 IPA,覆盖 90 多种语言的转写。团队可直接在文本中用斜杠添加转写,无需使用 XML 标签即可控制发音。
在 ElevenCreative 中开始创建自然语音
Audio Tags 可将配音演员会直接读出的停顿、情绪、节奏和发声风格添加到脚本中。Eleven v4 将这种表现力带入完整的制作 workflow,结合 ElevenLabs 的语音、图像和视频模型,让脚本在一个工作区中成为完成的音频或视频作品。
查看 Eleven v4 如何将 Audio Tags 转化为成品音频,或 创建免费账户,立即在自己的脚本中试用 SSML 和 Audio Tags。
常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。