如何在应用中集成文本转语音
- 发布时间
要将 文本转语音 集成到应用中,请创建 API 密钥、安装 ElevenLabs SDK,将文本连同音色和模型发送至 TTS 端点,然后播放返回的音频。
本指南将用 Python 和 TypeScript 讲解上述每一步,说明如何选择最适合的 TTS 集成方式,并提供常见错误的解决方法。
什么是文本转语音 API?
文本转语音 API 可让开发者通过编程将书面文本转换为自然的音频,无需自行托管 TTS 模型。将 TTS API 集成到应用后,只需向 API 发送请求并接收返回音频,即可轻松为应用添加语音层。
优秀的文本转语音 API,例如 ElevenAPI,可精细控制最终音频的效果,包括选择朗读文本片段的音色,以及其传达的 情感。你还可根据应用场景,在 批处理和流式处理选项 之间选择,以创建音频样本。
文本转语音 API 请求如何运作
调用 TTS API 时,后台会经过几个步骤来交付音频。
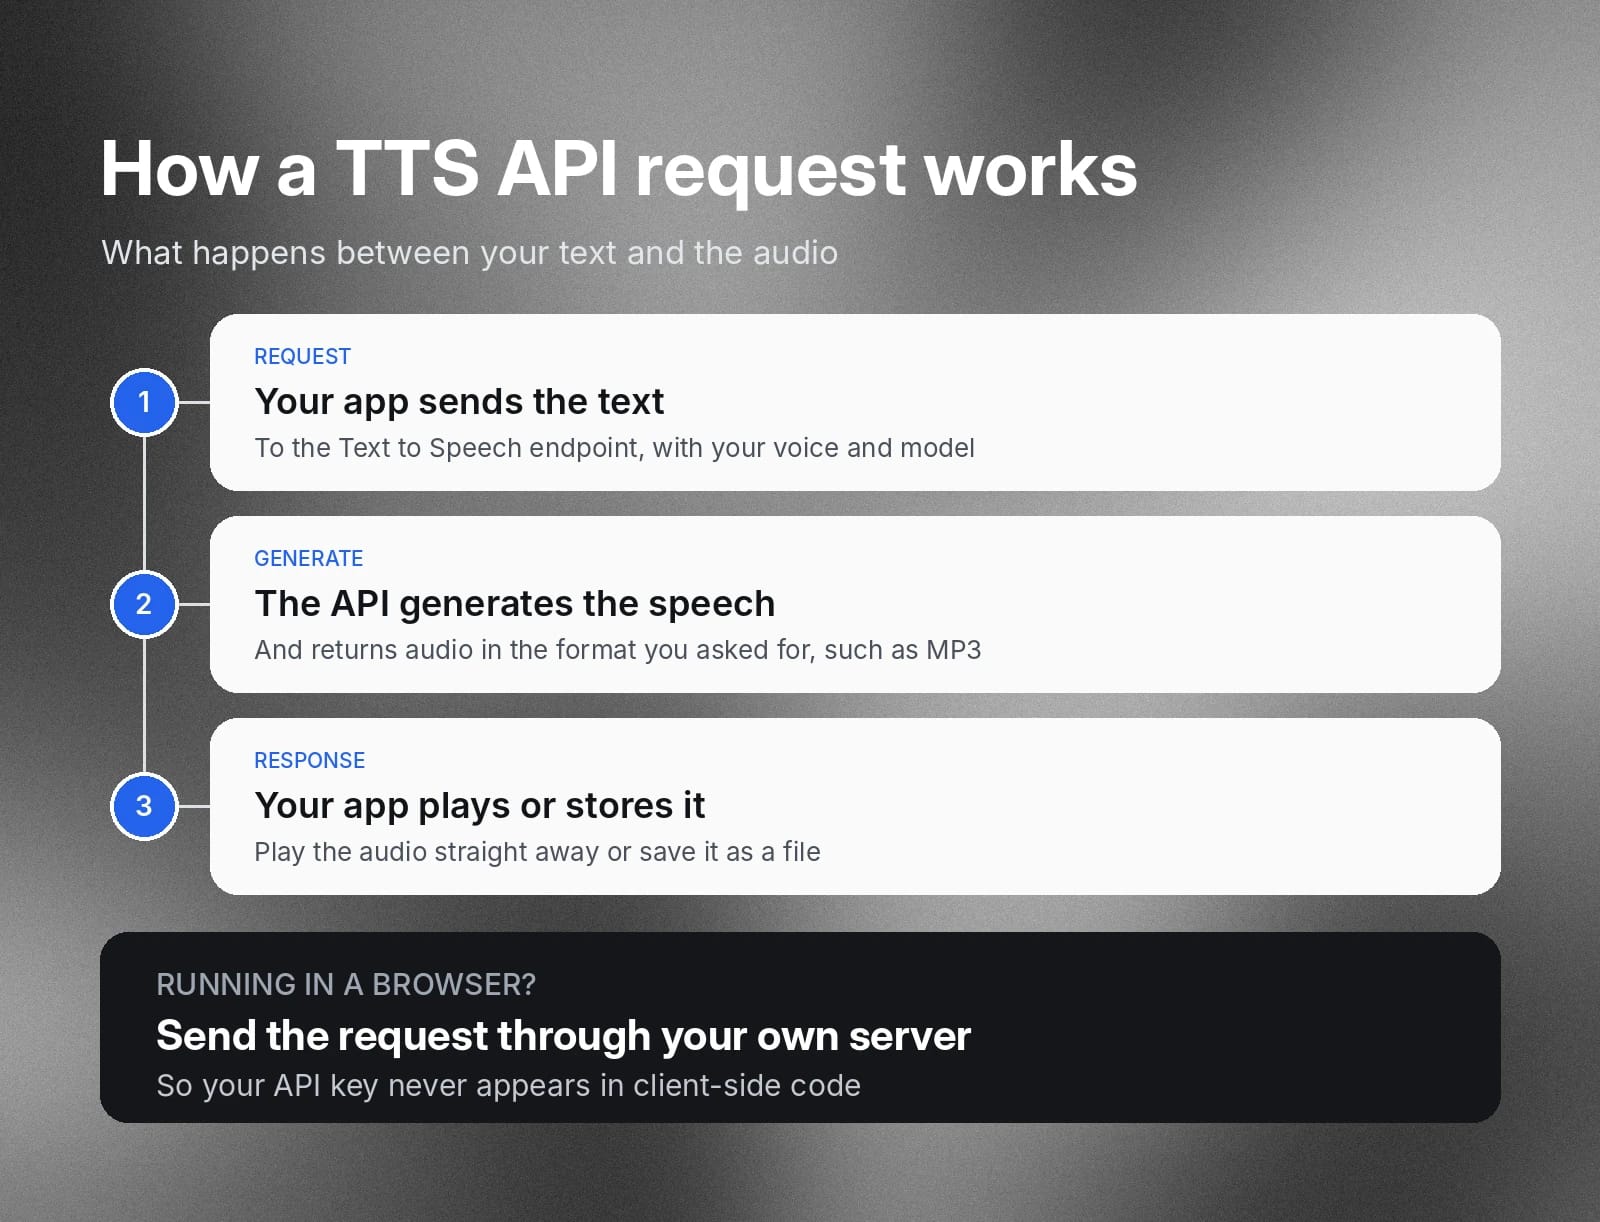
文本转语音 API 请求的运作方式如下:
- 应用将文本以及所选音色和模型发送至文本转语音端点。
- API 生成语音,并以所请求的输出格式返回音频,例如 MP3。
- 应用播放音频,或将其存储为文件。
还有一点:如果应用在浏览器中运行,应通过自己的服务器发送请求,确保 API 密钥不会出现在客户端代码中。
在应用中集成 TTS 前的准备清单
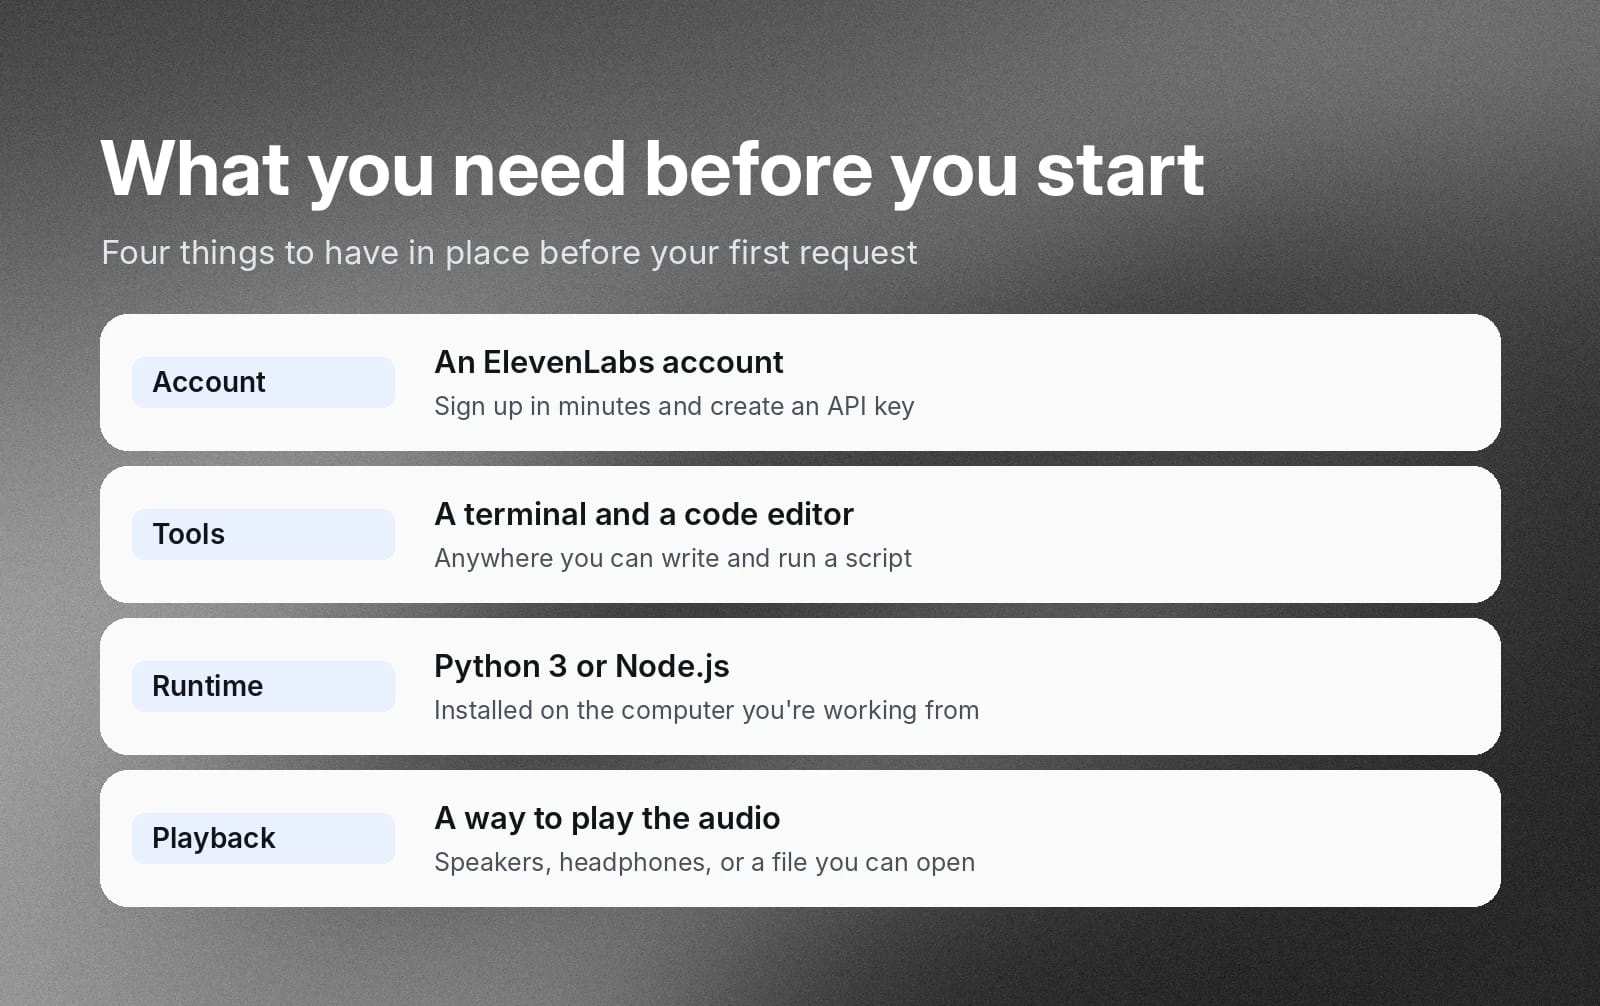
将文本转语音集成到应用前,请先确认已准备好以下内容:
- 一个 ElevenLabs 账户。几分钟即可 注册。
- 终端和代码编辑器。
- 工作电脑已安装 Python 3 或 Node.js。
- 可播放所接收音频的方式。
准备就绪后,即可在应用中构建 TTS 功能。
如何在应用中集成文本转语音
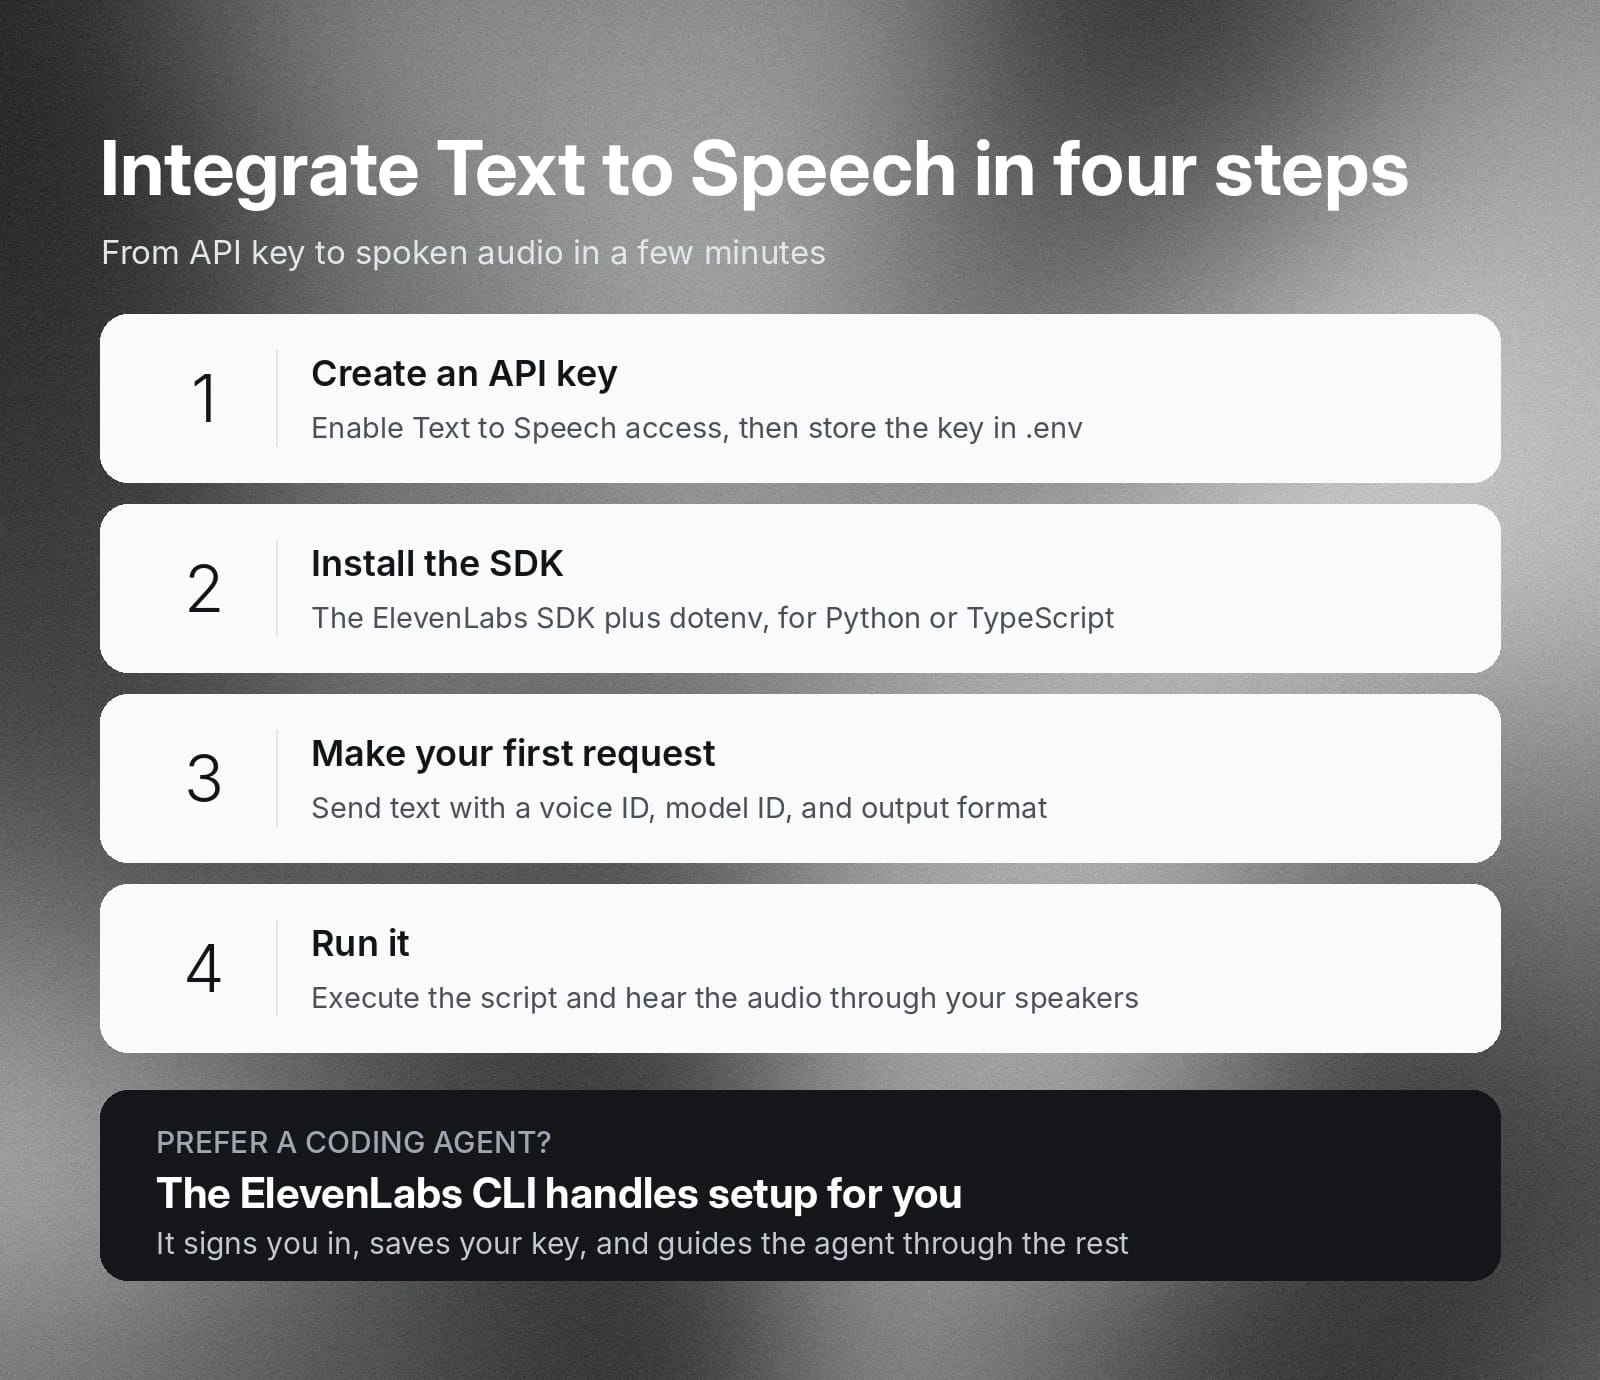
使用 ElevenAPI,只需几分钟即可将 TTS API 集成到应用中。若已注册账户,可直接进行以下步骤。否则,请先 注册 以开始使用。
步骤如下:
- 创建 API 密钥
- 安装 SDK
- 发送首次请求
- 运行
下面逐一详细说明。
创建 API 密钥
在 ElevenLabs API 控制台 获取 API 密钥。点击“Create Key”后,即可配置要设置的 API 类型。对于此场景,请确保已为 TTS 启用“Access”。
复制 API 密钥,并将其作为环境变量粘贴到 .env 文件中(或者视应用架构直接添加到应用配置)。将密钥存储在 .env 文件中,既能保持密钥私密,又允许脚本在运行时加载。
想让编码智能体完成设置?将以下内容粘贴给智能体:npx -y @elevenlabs/cli@latest onboard init。ElevenLabs CLI 会打开浏览器让你登录,将密钥保存到项目的 env 文件,并引导智能体完成剩余步骤。npx 需要 Node.js。详见 快速入门。
安装 SDK
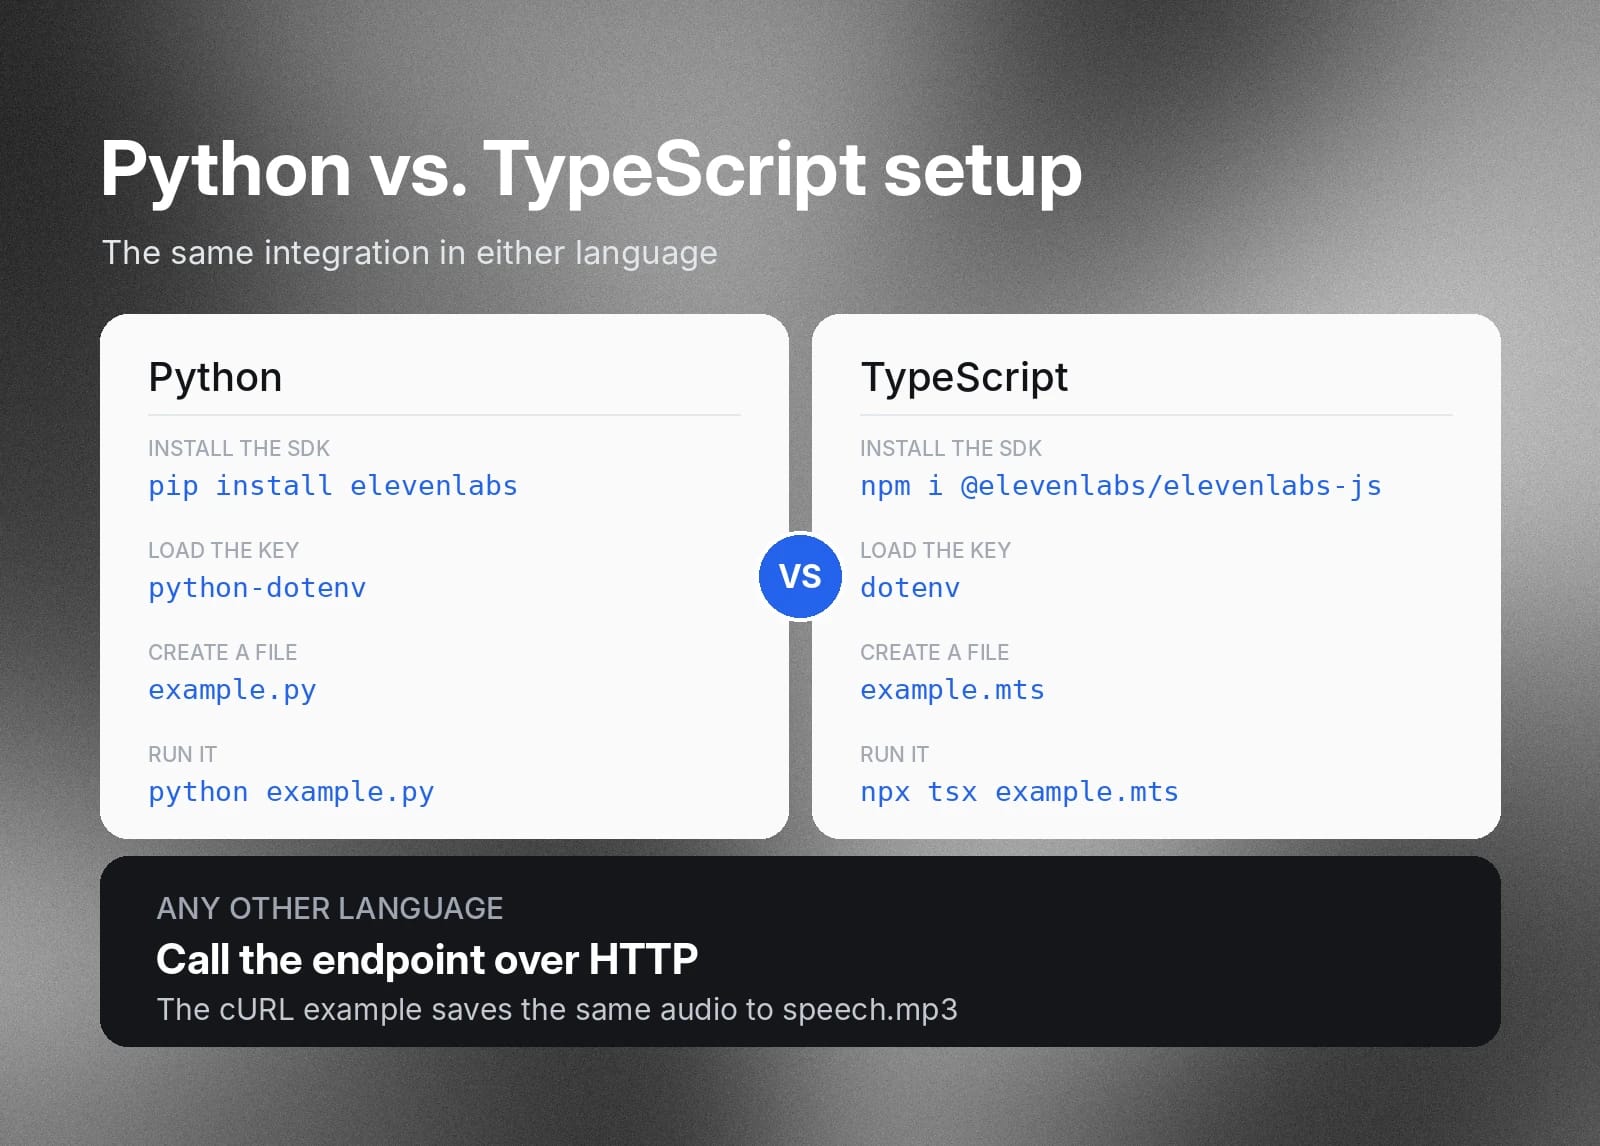
设置文本转语音 API 时,需要安装两个主要软件包。第一个是 ElevenLabs SDK,用于处理 API 调用。第二个是 dotenv,用于从第 1 步配置的 .env 文件中加载 API 密钥。
如果使用 CLI,请查看我们的 TTS API 文档,其中提供了更具体的说明和可用选项。
以下是在 Python 和 TypeScript 中为 TTS API 安装 SDK 和 dotenv 的方法。
Python
TypeScript
发送首次请求
接下来,创建客户端。客户端是对 ElevenAPI 的封装对象。根据所使用的编程语言,创建 .py 或 .mts 文件。
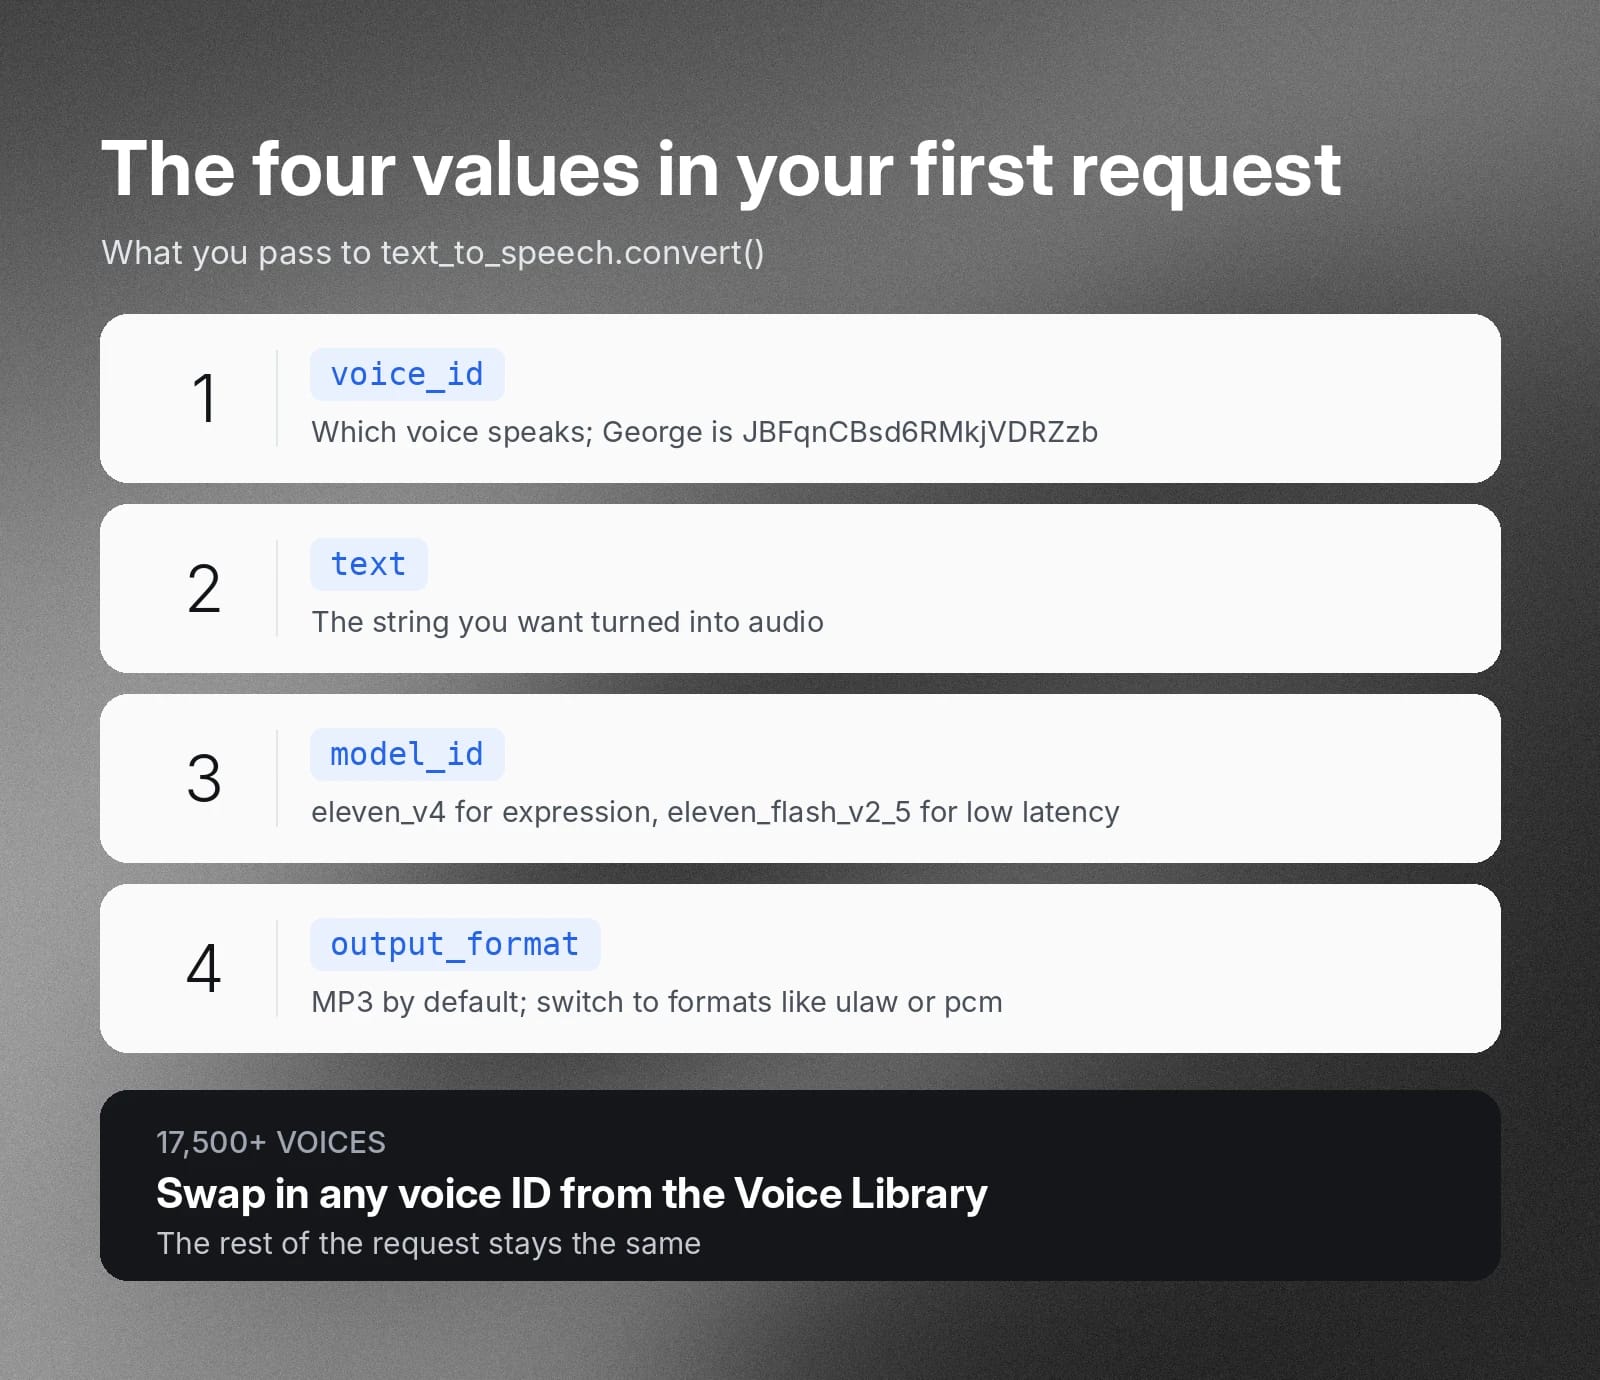
有 4 个主要参数会影响输出:
- 音色 ID:ElevenLabs 的 声音库 提供超过 17,500 种音色可供选择。选择最能代表应用的音色,或按使用场景匹配音色。以下快速入门代码块使用的是“George”,其音色 ID 为“JBFqnCBsd6RMkjVDRZzb”
- 文本:希望由 ElevenAPI TTS 模型转换为音频文件的文本字符串。
- 模型 ID:用于生成音频的具体模型。以下示例使用 eleven_v4,但也可以选择任意 文本转语音模型,如果其中某个更适合场景。例如,若需要低延迟,可选择 Eleven Flash v2.5(在模型 ID 字段中填入 eleven_flash_v2_5)。
- 输出格式:定义希望从 TTS API 接收的音频编码格式。默认输出 mp3,也可以切换为 ulaw 或 pcm 等格式。
以下是 Python 和 TypeScript 中 TTS API 文件的示例。两个示例都使用 eleven_v4 模型。
Python
TypeScript
cURL
也可以从任何能发起 HTTP 请求的语言调用该端点。这个 cURL 示例会发送相同文本,并将音频保存为文件:
运行
现在可以运行 TTS API 文件了。根据使用 Python 还是 TypeScript,执行以下相应命令:
Python
TypeScript
应该会听到音频通过扬声器播放。使用 cURL 示例时,请改为打开 speech.mp3。
排查常见 TTS 集成错误
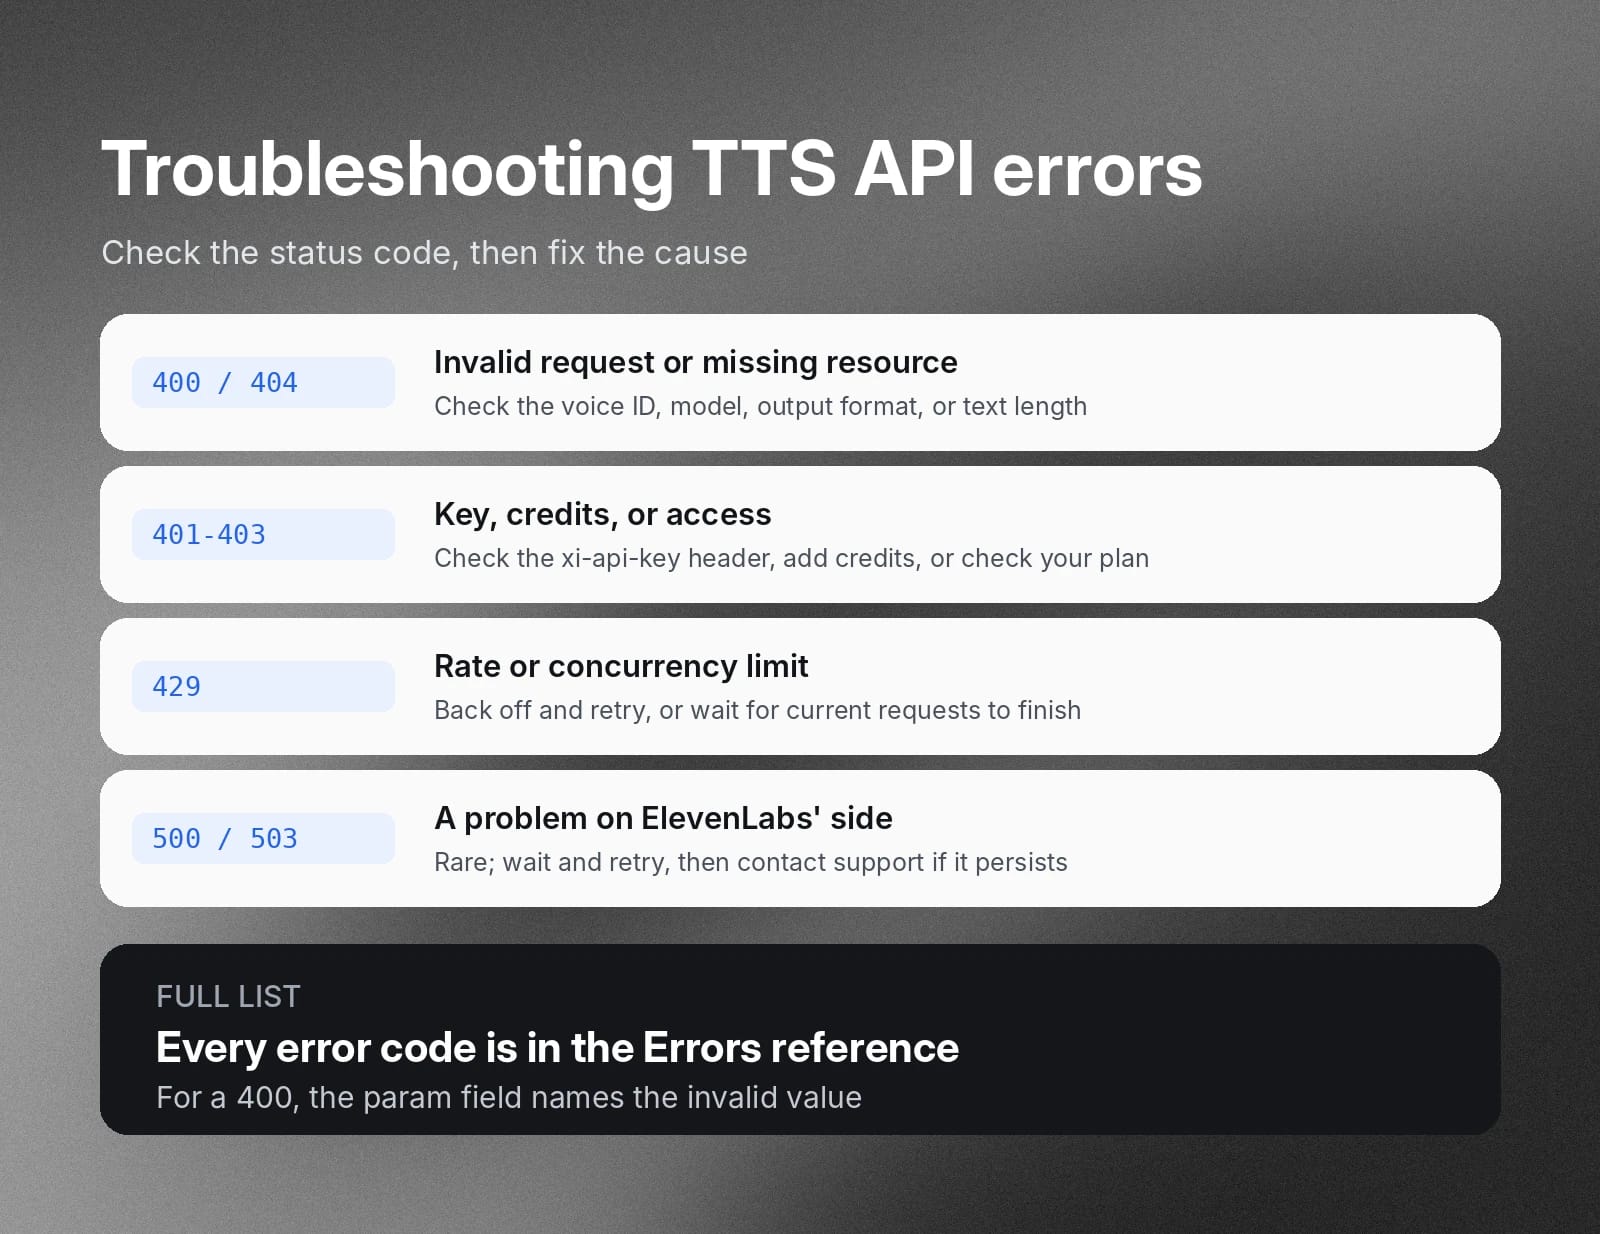
如果首次请求失败,请根据以下潜在错误列表检查收到的状态码。
状态码
含义
处理方法
400 或 404
validation_error、invalid_request 或 not_found:请求无效,或音色或其他资源不存在
重试前先修正请求。错误中的 param 字段会指出无效值。常见原因包括无效音色 ID(invalid_voice_id,或不存在 ID 对应的 voice_not_found)、不支持的模型或输出格式,或文本过长(text_too_long)。
401、402 或 403
authentication_error、payment_required 或 authorization_error:API 密钥、积分或访问权限存在问题
对于 401,请检查 API 密钥和 xi-api-key 请求头。对于 402,请添加积分(insufficient_credits)。对于 403,请确认套餐包含该功能或模型(feature_not_available 或 model_access_denied)。
429
rate_limit_error:超出速率限制(rate_limit_exceeded)或并发限制(concurrent_limit_exceeded)
遇到 速率限制 时,请采用指数退避重试。遇到并发限制时,请等待当前请求完成后再发送新请求,或升级至并发上限更高的套餐。
500 或 503
internal_error 或 service_unavailable:ElevenLabs 端出现问题,此类情况应较少发生
稍等片刻后重试。如果持续出现 500,请联系支持团队。
如需完整错误列表,请查看 错误参考 页面了解详情。
集成文本转语音 API 的优势
为应用添加语音界面,可为用户提供新的交互方式。对于视障人士等一些用户,这可能是使用应用的唯一实用途径。
在应用中集成 TTS API 的优势包括:
- 无障碍:语音音频提供了 与应用交互的新方式,让难以在屏幕上阅读的用户也能使用。
- 参与度:朗读和边听边读功能让用户在做其他事时也能获取内容,这正日益成为人们浏览内容的主要方式。
- 语音优先体验:语音回复让聊天机器人和应用内引导能够以自然的方式回应用户。
- 多语言覆盖:Eleven v4 支持 90 多种语言,让集成方案可服务全球受众。
考虑到设置如此简单,将 TTS API 集成到应用中,是让应用更具交互性和表现力的有效方式。
选择合适的集成方式和模型
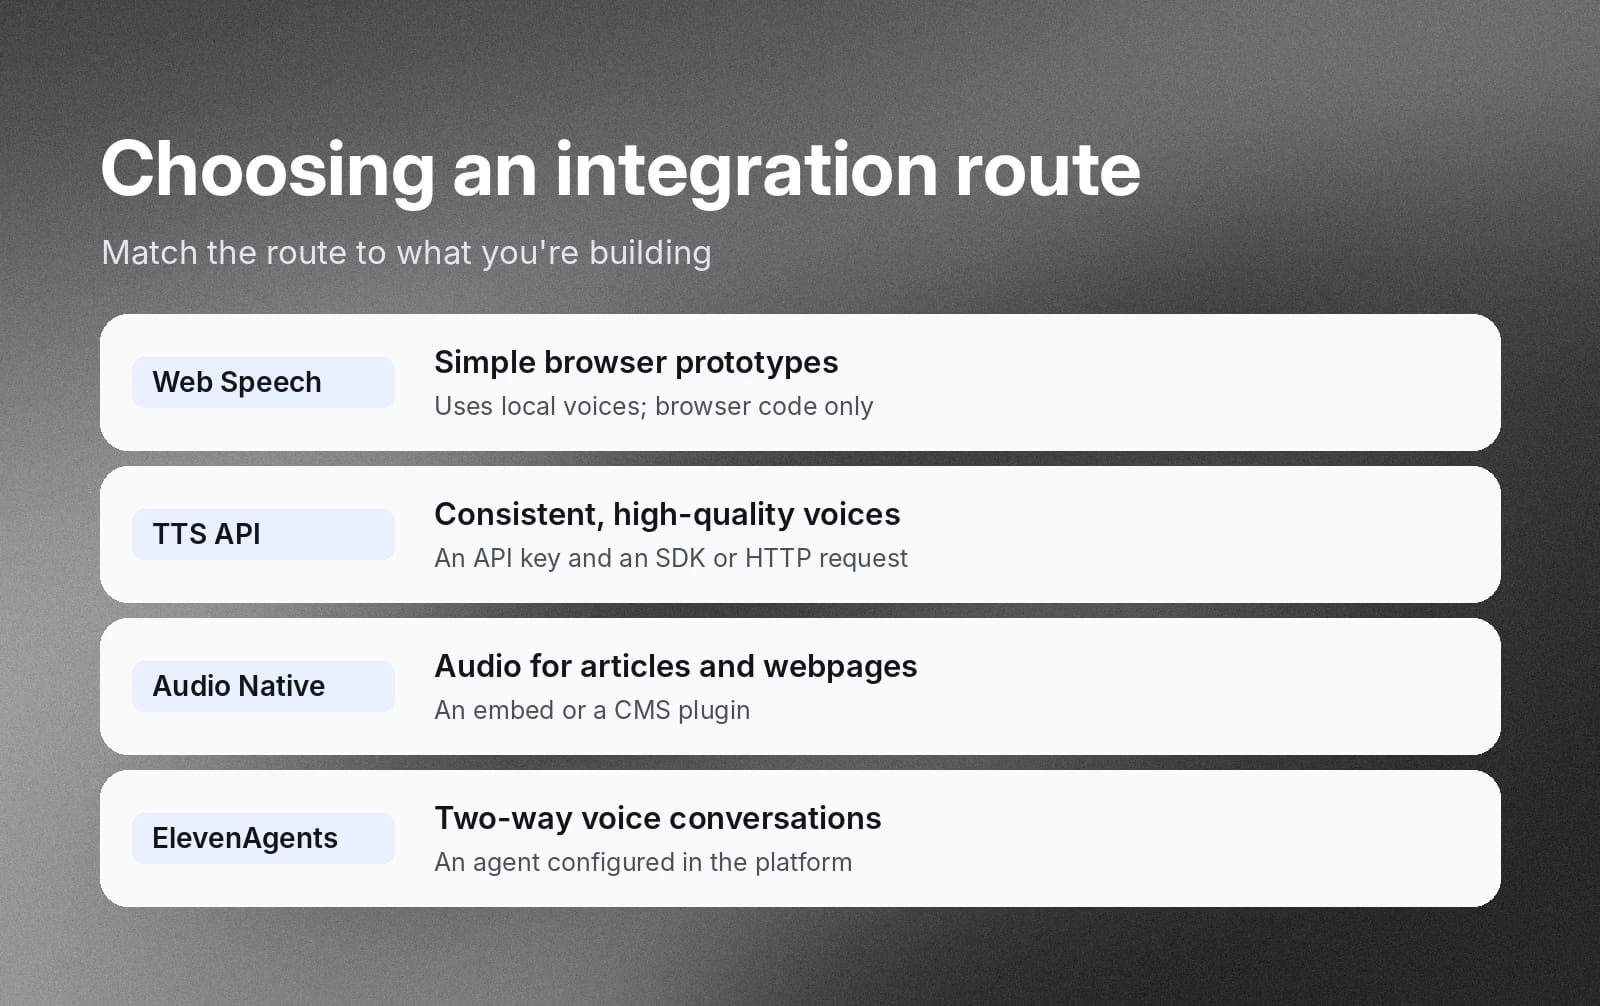
ElevenAPI 是为应用添加语音最快、最简单的方法之一,但也可根据需求选择其他方式。
以下是几种可选的 TTS 集成方法:
方式
最适合
所需条件
浏览器语音合成(Web Speech API)
使用本地音色的简单浏览器原型
仅需浏览器代码
如果选择 ElevenAPI,还需确定请求中使用的模型。以下是可用 ElevenLabs TTS 模型的快速指南:
模型
最适合
语言
eleven_v4
表现力最丰富的语音
90+
eleven_flash_v2_5
实时使用、智能体和高吞吐量工作负载
32
eleven_multilingual_v2
稳定、高保真的旁白配音
29
还可从 声音库 的超过 17,500 种音色中选择。只需将代码片段中的示例 ID 替换为偏好的 ID。
文本转语音 API 在应用中的常见用途
首次请求成功后,同一个调用即可支持许多功能。
以下是在应用中使用 TTS API 的一些示例:
- 应用内阅读:将文本分段发送,并按顺序播放音频。更多信息请查看 API 批处理集成指南。
- 聊天机器人语音回复:将聊天机器人的每条回复传入 API,并将 音频流式传回 给用户,打造更具交互性的体验。
- 电话系统:针对电话通信,请请求 ulaw_8000 输出格式。请查看我们的 Twilio TTS 集成指南 了解更多。
如果想 构建语音智能体 来实现双向对话,ElevenAgents 正是为此而设计。无需自行组装整套语音管线,只需在平台中配置并 部署智能体。探索 ElevenAgents,了解更多。
使用 ElevenAPI 在应用中构建 TTS API
集成文本转语音只需 4 个主要步骤:创建 API 密钥、安装 SDK、发送首次请求,然后运行。无论是 TypeScript、Python,还是任何能发起 HTTP 请求的语言,都可使用相同调用。还可以选择适合应用的模型和音色。
准备好在应用中构建 TTS 功能后,立即 注册,使用 ElevenAPI 发送首次请求,或了解更多关于 文本转语音 API 的信息。
常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。