
AI 配音 API:如何大规模为音频和视频配音
- 发布时间
- 最近更新
几十年前,为视频配音意味着预订录音棚、聘请目标语言的配音演员、录制(并反复重录)每句台词,然后等待数周才能交付成品。
AI 配音 API 可将这一流程缩短为几次 REST 调用。发送音频或视频,即可获得保留原始时序和情感表现的新语言配音成品。
本指南将介绍 AI 配音 API 的工作原理,以及生产级 API 与拼凑式流程的区别。我们还会讲解如何集成 ElevenLabs 全新的配音 API,它现已将 Dubbing v2(最新配音模型)带入每个 workflow。
摘要
- AI 配音 API 接收源音频或视频,并输出新语言的配音内容。
- Dubbing v2 是一种音频转音频模型,直接基于原始表演生成,因此情感、语气和表达方式都会保留在每个配音版本中。
- ElevenLabs Dubbing API 支持 90 多种语言,并提供时序感知翻译。
- 开发者只需几次 REST 调用,即可创建配音项目、添加目标语言并下载完成的配音。
- 企业客户可以编辑源转写和译文,然后仅重新生成修改过的片段。
什么是 AI 配音 API?
AI 配音 API 是一种编程接口,可接收一种语言的音频或视频,并返回目标语言的配音音频。它能自动完成整个本地化链路:转写源内容、翻译对话、克隆每位说话者的声音、生成目标语言语音,并使输出与原始时序对齐。
虽然开发者可以将 语音转文本、机器翻译和 文本转语音 服务串联成临时配音流程,但它们无法可靠应对大规模工作负载。
说话者身份会在各阶段间断裂,时序可能偏移,原本情感丰富的台词也会变得单调。
专为配音打造的 API 提供一系列额外功能,可解决这些问题。从说话者分离、声音保留,到内部同步和语音克隆,高质量 AI 配音 API 能让输出听起来像原说话者,而非生硬的翻译。
AI 配音如何运作:音频转音频与级联流程
大多数自动配音系统采用级联流程:先转写源音频,再翻译转写文本,最后基于文本合成新的语音。除了原始文本以外的所有内容,例如迟疑、紧张感、讽刺或低声插话,都会在合成前丢失。
ElevenLabs 的 Dubbing v2 采用了不同的方法。
Dubbing v2 提供音频转音频模型,输出直接以原始录音为条件,而不是依赖其转写文本。模型会聆听表演,而非阅读表演描述,因此语气、情感和情绪基调都能传递到配音中。
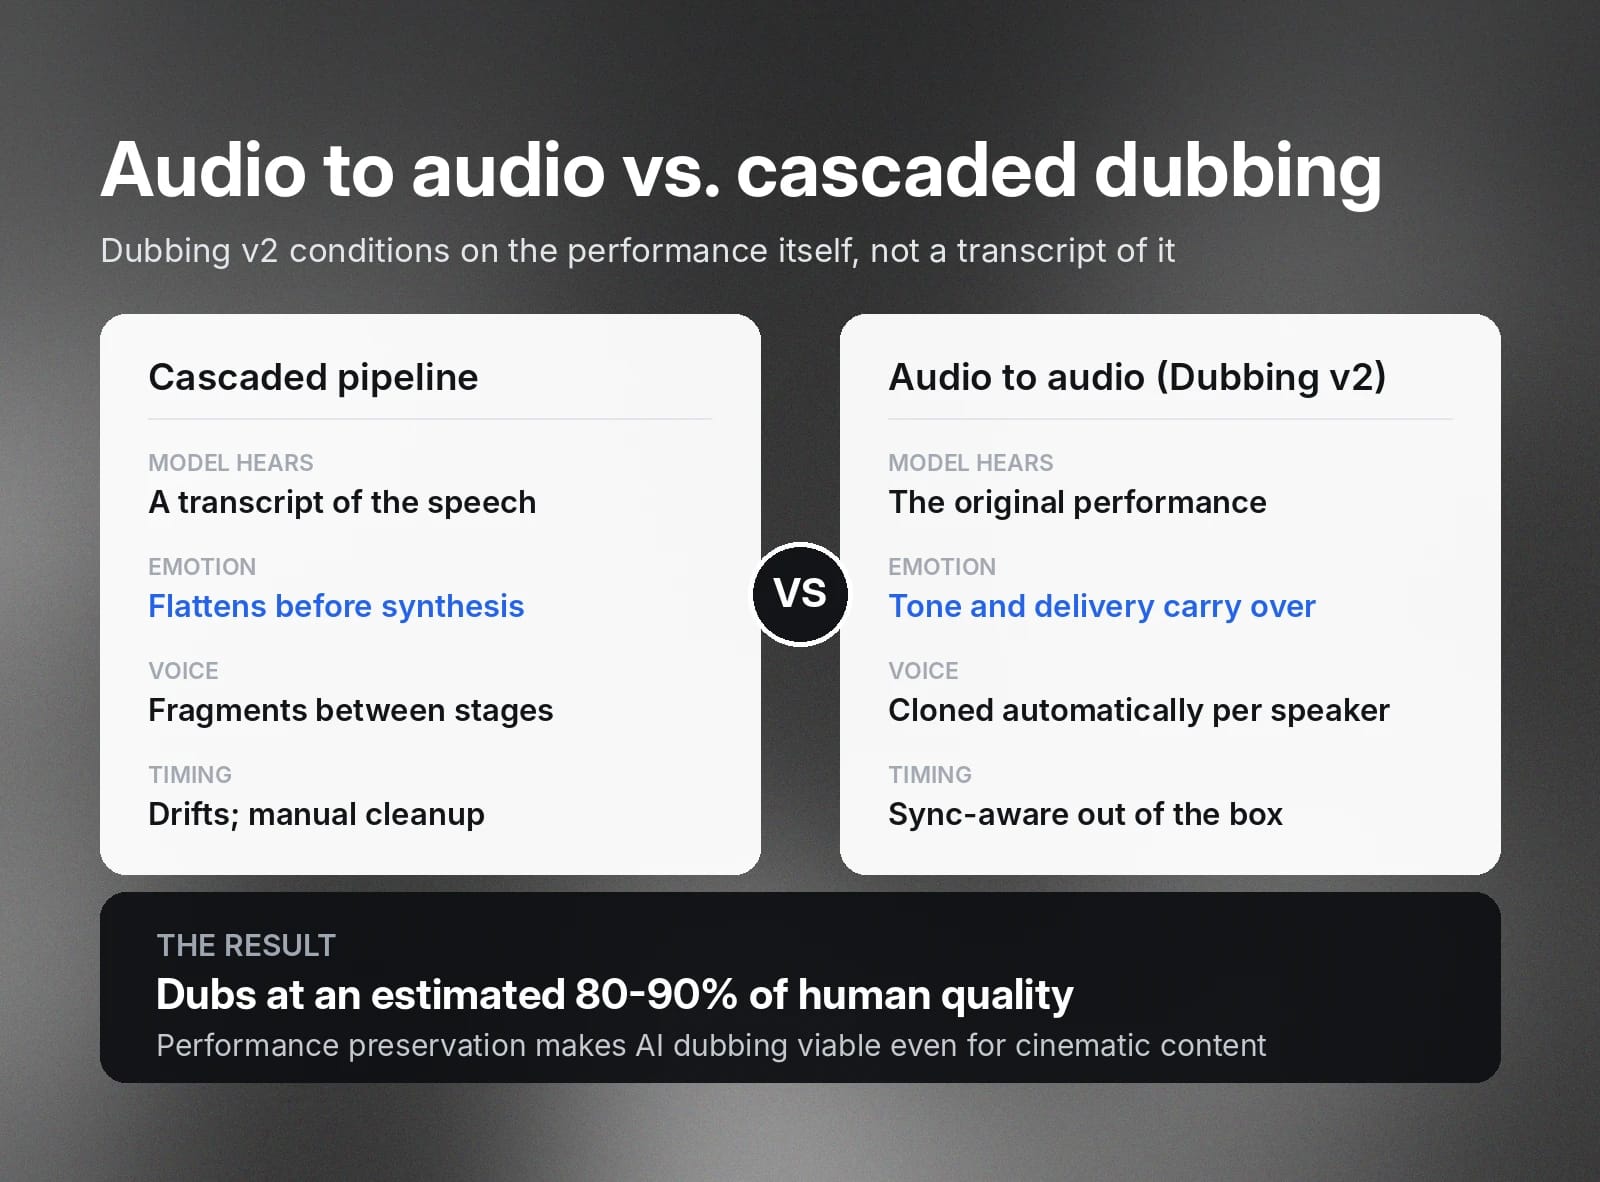
我们估计,Dubbing v2 生成的配音可达到人工质量的 80%–90%,这意味着 AI 配音如今也适用于影视内容。
Dubbing v2 还具备另外三项核心能力:
- 时序感知翻译:模型翻译时会考虑时序,因此配音音频的起止时间默认就能与原始内容对齐。无需处理视频或进行口型同步,音频会精准落在原台词所在的位置。
- 自动 语音克隆:每个译文都会以原说话者的克隆音色交付,无需手动克隆。即使有多位说话者,也能在所有支持的语言中保留说话者身份、音高和音色。
- 区域级准确度:Dubbing v2 可区分地区变体,例如拉丁美洲西班牙语和卡斯蒂利亚西班牙语,并通过 pt-BR 等语言代码为巴西葡萄牙语提供区域控制。
选择 AI 配音 API 时要关注什么
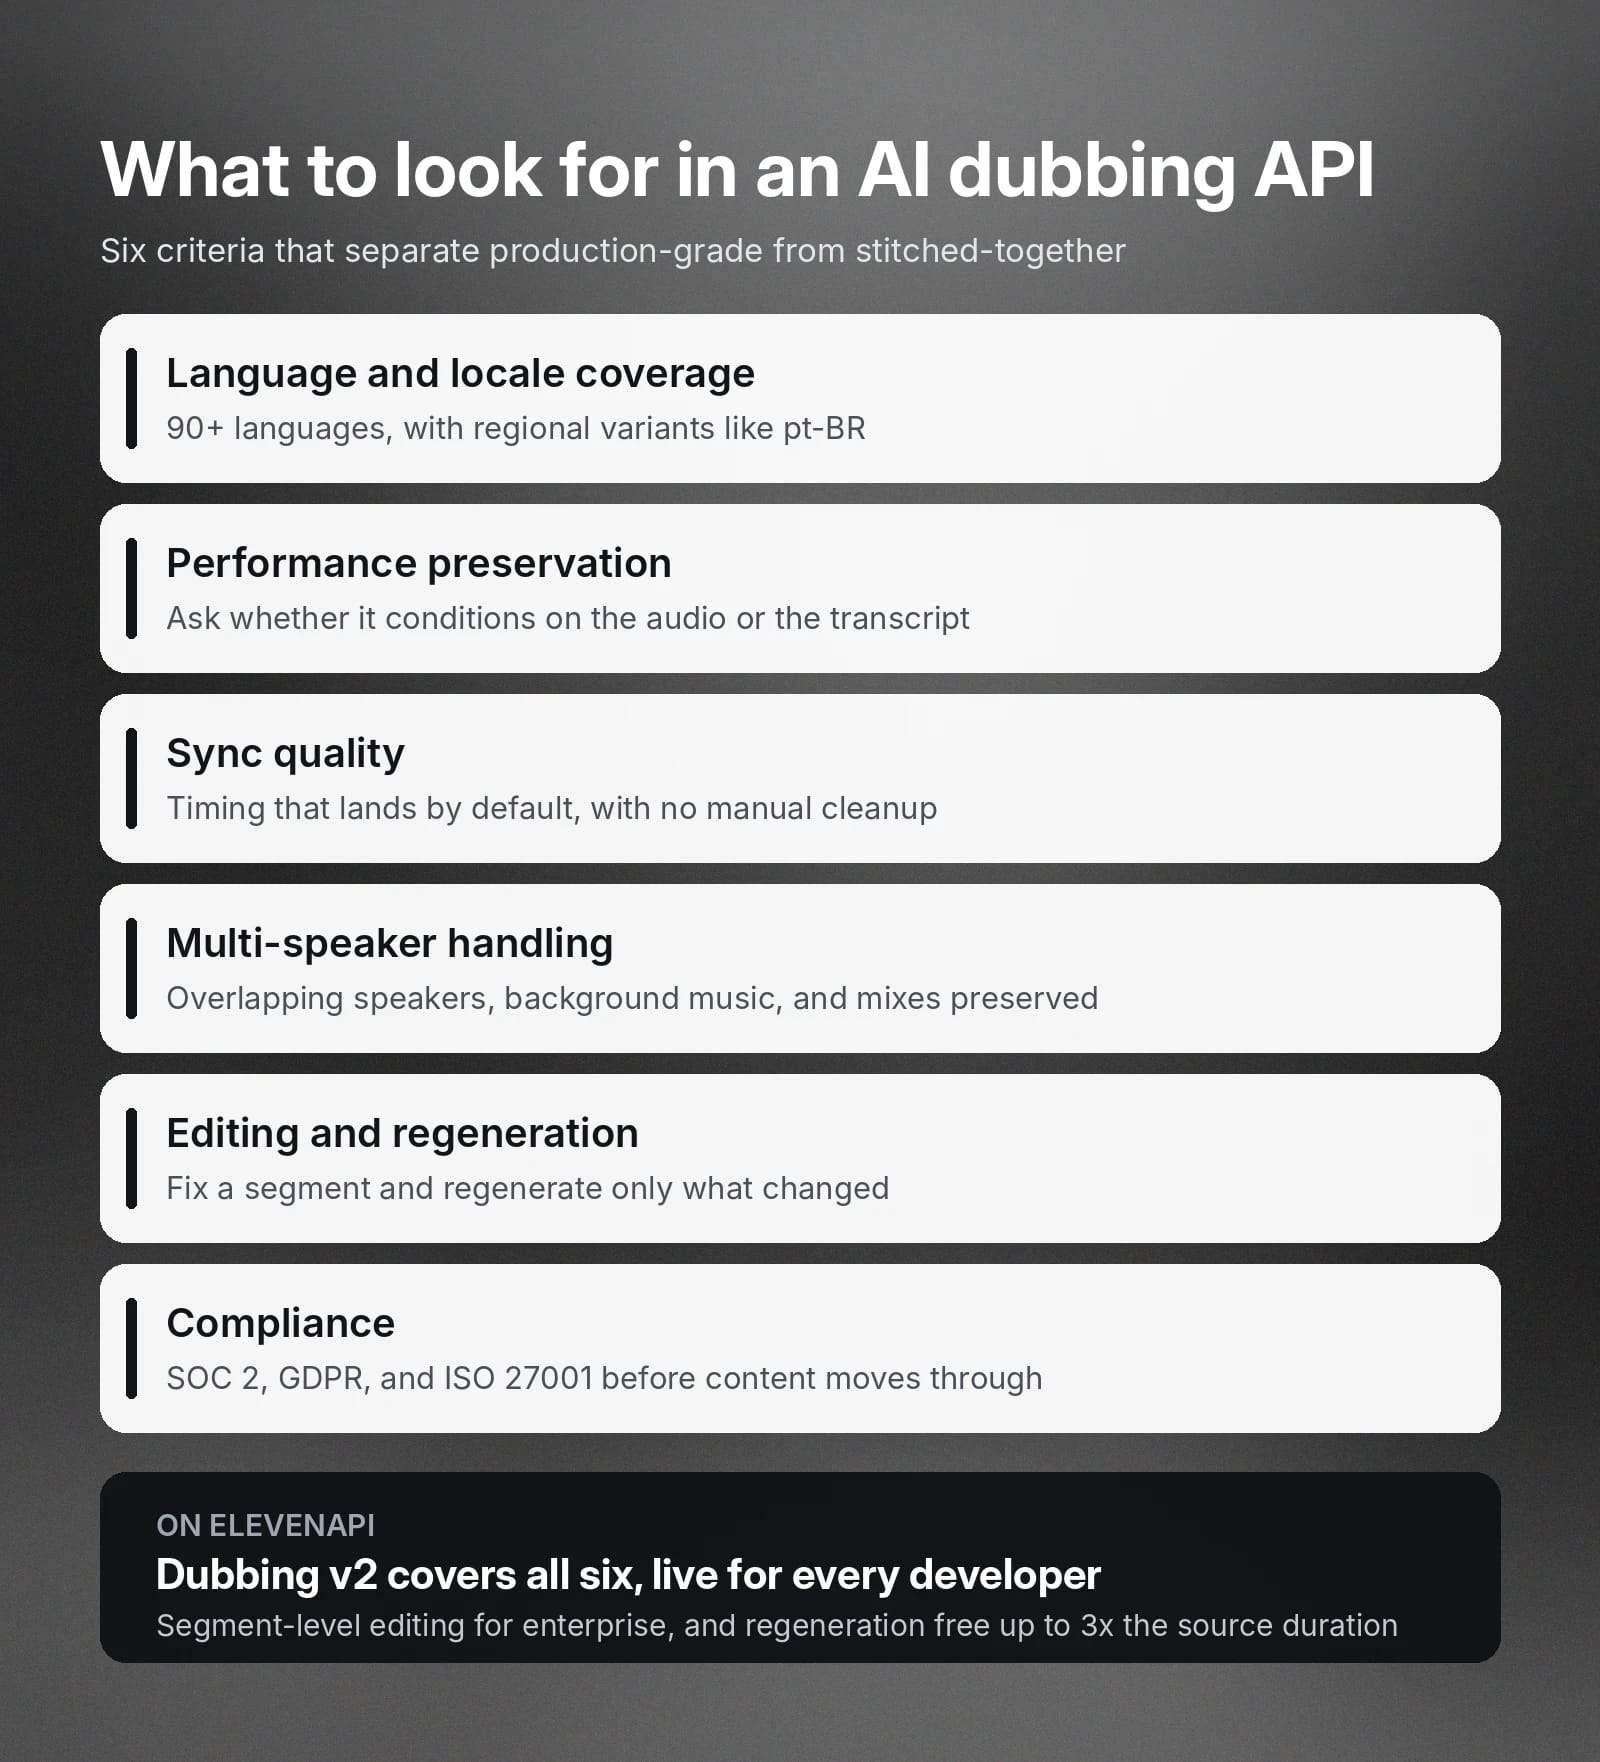
为开发流程评估 AI 配音 API 时,需要关注几个核心标准。
优质 AI 配音 API 通常具备以下主要功能:
- 广泛的语言和区域覆盖:应关注覆盖广度(90 多种语言),以及能否精细指定区域变体等内容。
- 表演保留:确认系统是基于源音频还是转写文本生成。音频转音频架构决定情感能否在配音中保留下来。
- 无缝同步质量:配音音频若偏离原始时序,会带来数小时的手动修整工作。同步应默认生效,避免后期处理开销。
- 多说话者和背景处理能力:AI 配音 API 应能轻松处理重叠说话者或 音效,还应保留片段中的背景 音乐 或混音。
- 编辑和重新生成:可让你修正转写、优化译文并仅重新生成受影响片段的配音 API,可避免为整个文件重新配音。
- 合规性:企业工作负载需要在内容通过系统前满足 SOC 2、GDPR 和 ISO 27001 合规要求。
本指南接下来将介绍 ElevenLabs Dubbing API,它具备上述所有功能。
如何使用 ElevenLabs Dubbing API 为音频和视频配音
Dubbing API 围绕项目组织。每个项目包含一个源文件及其转写文本。之后可按每种目标语言添加一个语言,每种语言都有各自的译文和输出。
以下基本的创建和获取 workflow 适用于 ElevenAPI 平台 的所有用户。
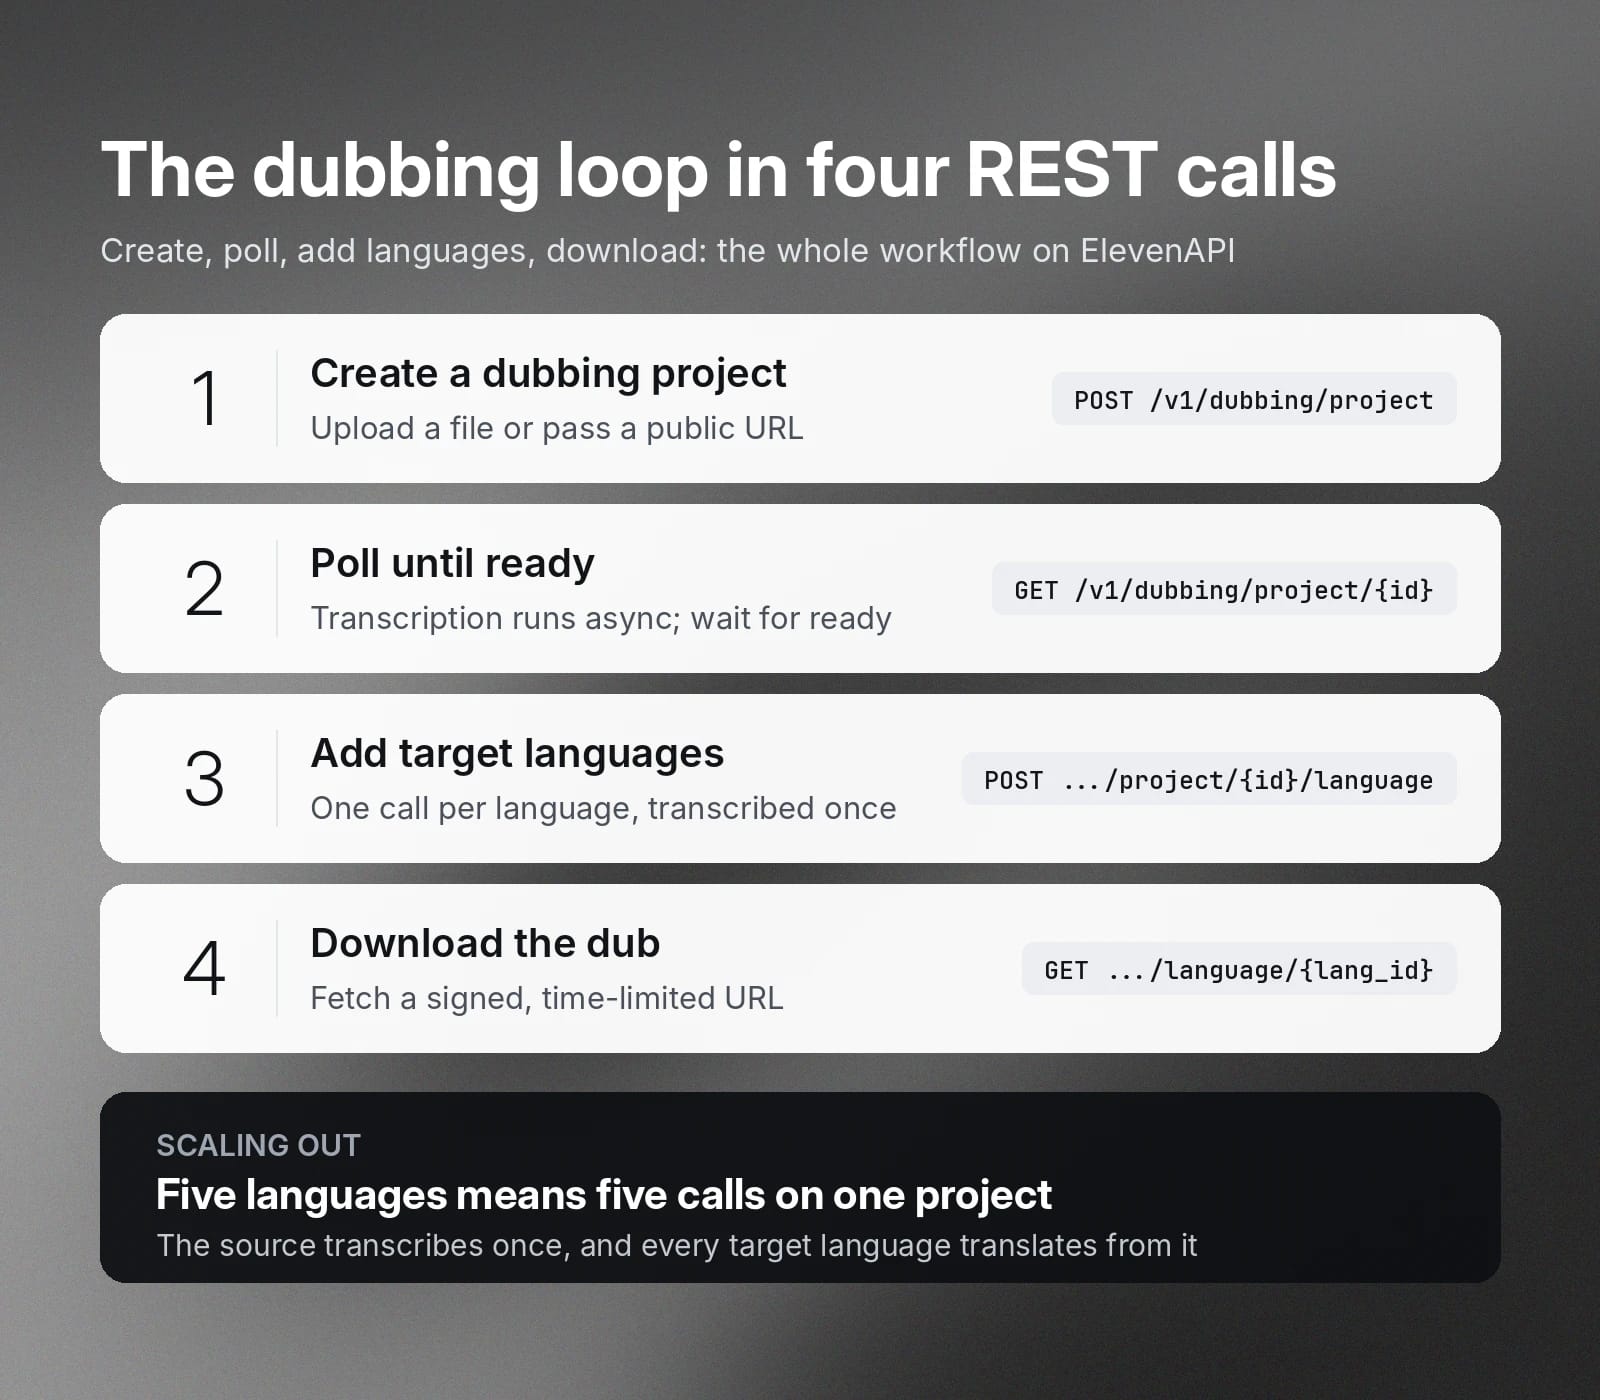
1)创建配音项目
通过上传文件或提供公开 URL 发送源媒体。身份验证使用 xi-api-key 请求头中的 API 密钥。你可以传入可选的参考标签,方便在系统中识别项目;还可以传入关键术语,让转写和翻译更倾向于采用产品或品牌名称。
通过 URL 创建
通过上传文件创建
响应会返回状态为 queued 的 project_id。省略 source_language 后,模型会在转写时自动检测语言。
2)轮询直到项目就绪
源内容会异步转写,因此请持续轮询项目,直到状态变为 ready。
就绪项目已准备好源转写文本,等待你添加目标语言。每种语言的进度记录在语言本身,因此项目从此会始终保持 ready 状态。
3)添加目标语言
每个目标添加一种语言。cloning_strength 设置(0 到 10,默认值为 7)用于控制原始音色相似度与目标语言自然表达之间的平衡。
每种语言都会依次经历 queued、processing 和 completed 状态。
若要配音为 5 种语言,请对同一项目发起 5 次调用。源内容只会转写一次,每种语言都基于它进行翻译。
4)下载配音输出
当语言状态为 completed 后即可获取。响应包含配音音频的签名下载 URL。
请注意,下载 URL 有时限;需要新链接时,请再次获取该语言。
完成这 4 个步骤后,你便拥有一套全自动配音循环:创建、轮询、添加语言、下载。
通过 API 编辑和重新生成配音
自动化输出可满足大多数用例,但高端本地化通常仍需要人工审核措辞,确保最终效果准确自然。Dubbing API 为企业客户提供译文两端的片段级控制。
源转写文本是所有语言翻译时使用的唯一事实来源,且可完全编辑。你可以修正听错的台词、更正说话者归属,或调整任意片段的时序:
每种目标语言都有自己的转写文本,将每个源片段与其译文配对。译文也可通过相同方式编辑。
你也可以提供自己的源转写文本和译文,让现有本地化 workflow 掌控措辞,而模型负责处理声音。
当配音完成后转写文本发生变化,该语言会被标记为 stale,只需一次调用即可根据当前文本重新生成。
在源媒体时长的 1 倍额度内,重新生成免费,因此迭代译文不会增加配音费用。超过 1 倍额度后,将按标准配音费率收费。
AI 配音 API 用例
只要需要批量本地化音频,视频配音 API 就很有用。人工配音耗时费力,AI 配音 API 可显著加快流程。
以下是 AI 配音 API 的几个用例:
- 媒体创作平台:将配音直接集成到创作者制作 workflow 中,让用户无需离开应用即可尝试配音。
- 培训和支持内容:拥有全球招聘渠道的企业可将内容本地化为不同语言,为所有用户提供入职培训视频支持。
- 流媒体和媒体:本地化流程可自动为长篇剧集或其他媒体配音,以便在多个地区发布。
- 营销素材:无需用数十种语言重新录制配音演员台词,即可推出多语言视频营销活动。
- 教育科技:课程平台可将讲师视频配音为所服务市场的各种语言,同时保留讲师的声音。
总而言之,配音 API 让大规模制作高质量本地化内容成为更易实现的选择。
Dubbing v2 现已在 ElevenAPI 上线
Dubbing API 现已面向自助服务和企业开发者开放。所有用户均可使用 Dubbing v2,企业工作区还可使用编辑端点。
探索 Dubbing API,了解完整功能;或 注册并创建 API 密钥,几分钟内即可完成首次配音。
配音 API 常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。


