语音克隆 API:工作原理及选型要点
- 发布时间
- 最近更新
从 AI 助手到客户支持,语音已成为数字产品的主要交互界面。尤其随着组织持续服务全球用户,这些语音助手必须覆盖多种语言和地区。但当 文本转语音(TTS)系统依赖通用或机械的音色时,品牌辨识度就会被削弱。
通过语音克隆 API,开发者可借助 API 调用,以特定人物的声音生成合成语音。输出不再由通用音色朗读文字,而是使用目标说话者的声音。你可以完全控制 TTS 系统的声音表现,以及它如何传达品牌形象。
语音克隆 API 为各领域带来新可能:从跨语言保留演员声音的媒体配音流程,到大规模维持一致品牌声音的客服平台。
本指南将介绍语音克隆 API 的工作方式、集成前需要评估的要点,以及如何管理这项技术涉及的同意与安全问题。
摘要
- 语音克隆 API 可通过上传音频样本,并在文本转语音请求中引用生成的音色 ID,以特定人物的声音生成语音。
- 即时语音克隆只需 1–2 分钟音频,几秒内即可生成可用音色;专业语音克隆则需使用 30 分钟至 3 小时的音频进行 3–6 小时微调,以获得更高且更稳定的质量。
- 负责任地使用语音克隆,需要提供音色所有者同意的证明、通过水印追溯生成音频来源,以及可按请求彻底删除音色模型的工作流程。
什么是语音克隆 API?它如何工作?
语音克隆 API 可让开发者应用通过调用外部语音克隆系统生成合成语音。它能让你即时生成某个人声音的音频片段。
开发者上传目标音色的音频样本后,API 会提取音色、节奏和发音等声音特征,构建音色 ID。
任何引用该音色 ID 的文本转语音请求,都会返回克隆音色的音频;模型训练、参数存储和语音合成均由提供商处理。
ElevenAPI 提供两种克隆方式。即时语音克隆(IVC)使用上传的音频样本实时引导生成,因此可用的克隆音色可在数秒内准备就绪。专业语音克隆(PVC)会基于音频微调模型,获得更深入、更稳定的效果。
快速测试使用 IVC。需要生产级语音克隆时使用 PVC。
选择语音克隆 API 时应关注的核心功能
语音克隆 API 的能力差异很大。两家提供商即使都提供语音克隆 API,也不代表其速度、质量和可控性都能满足用例需求。
评估语音克隆 API 时,请重点关注以下功能。
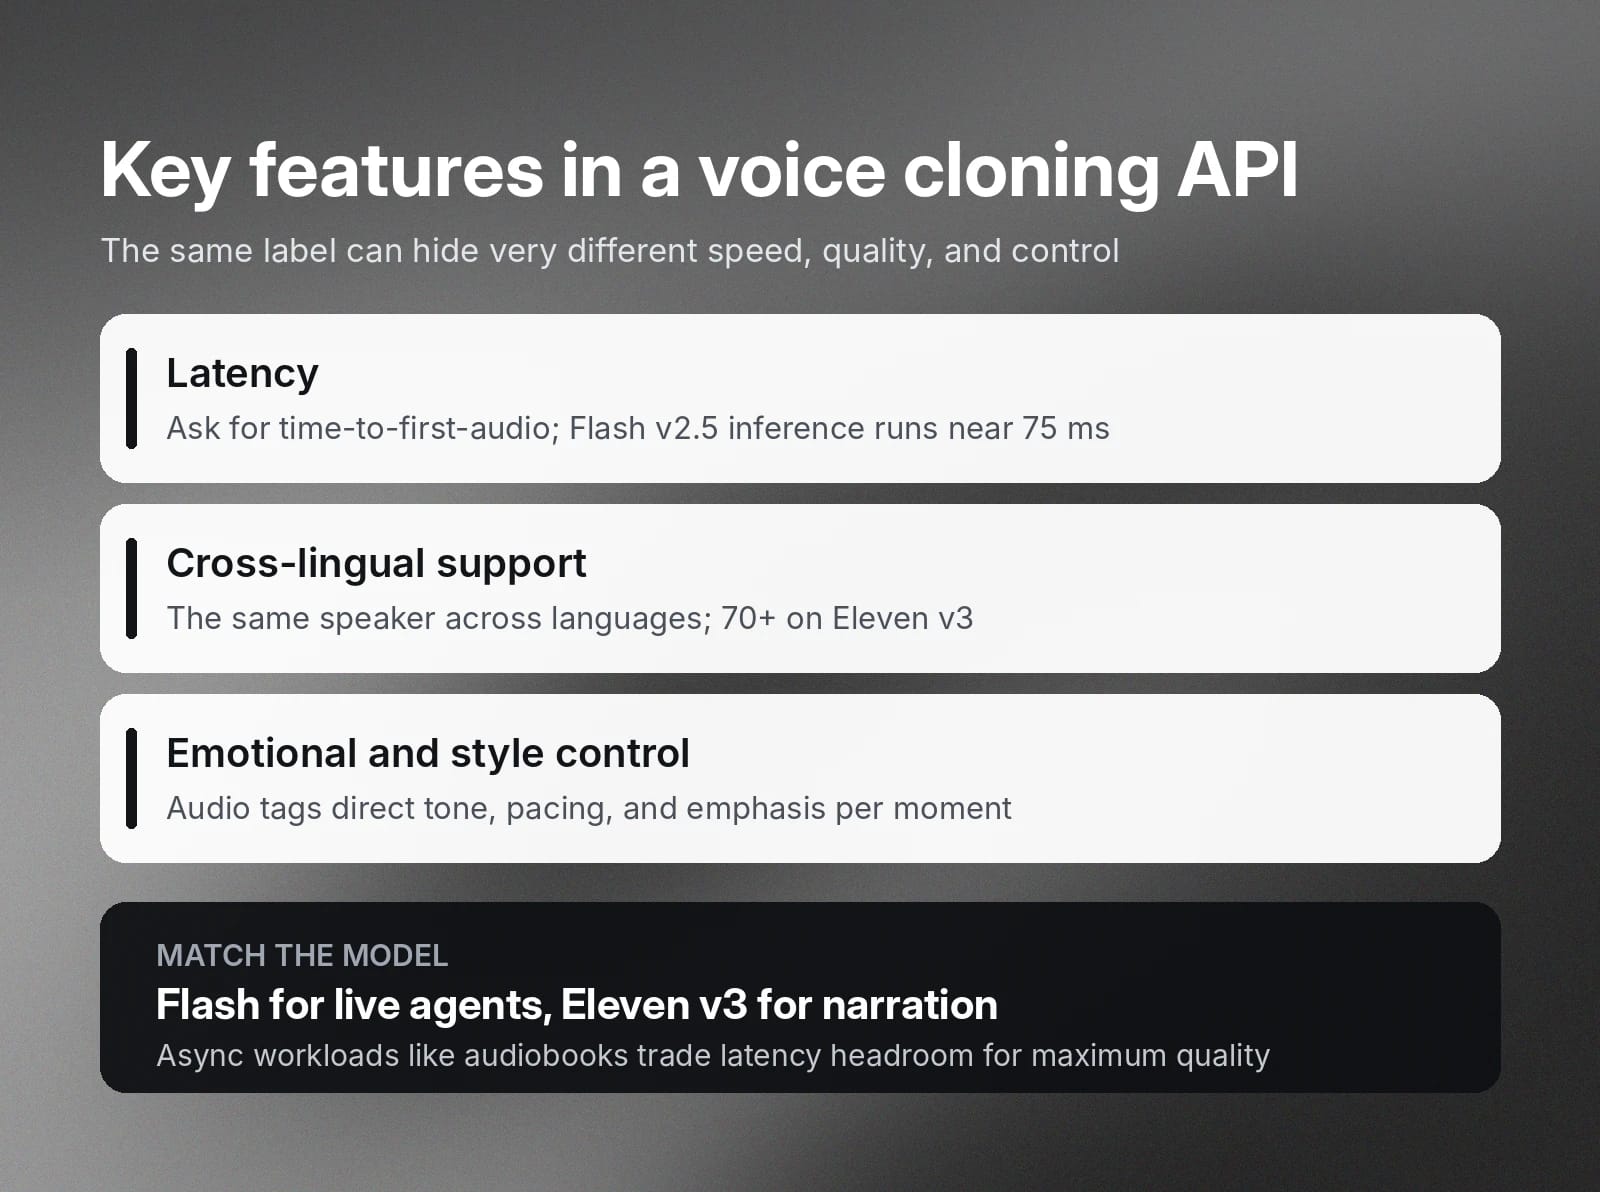
延迟
如果应用涉及实时交互,例如语音智能体、实时配音或互动角色,延迟是重要考量因素。相比 API 提供商的营销宣传,更应关注其公开的首段音频响应时间数据。
Eleven Flash v2.5 对于典型短输入的模型推理时间约为 75 ms。该数据不包括网络往返和应用开销,因此决定对话是否具有实时感的首段音频响应时间,在生产环境中会更高。Flash 仍专为分秒必争的实时场景打造。
对于有声书旁白或视频配音等异步工作负载,延迟的重要性较低。这类场景更适合注重质量的模型,例如Eleven v4。
语言与跨语言支持
跨语言克隆可让你用一种语言采集声音,再用另一种语言生成语音。评估语音克隆 API 时,应确认音色在不同语言中是否仍像同一位说话者,以及发音是否自然,而非带有浓重口音或机器翻译感。
ElevenAPI 在 Eleven v4 中支持 90 多种语言,在 Eleven v3 中支持 70 多种语言,并在 Multilingual v2 中支持 29 种语言;该模型专为在语言切换时保持一致的音质和口音而打造。
情感与风格控制
只能以一种语调说话的克隆音色会限制应用可能性,因为所有用例听起来都会平淡且单一。选择可控制表达方式的 API,包括情绪语调、语速和重音。
Eleven v3 支持音频标签,让应用能指导特定时刻的表达方式。这对于叙事内容、角色音色,以及同一音色需适应不同情境的任何应用尤为重要。
探索语音克隆 API 的实际应用场景
当语音本身成为产品体验的一部分时,语音克隆 API 最能发挥价值。有些场景追求大规模一致性;另一些则着重保留身份特征、提升无障碍体验,或让内容更易于本地化。
最有价值的用例往往不止于新奇,而是为支持团队、内容团队、教育工作者和依赖辅助语音技术的人群解决实际工作流程问题。
客户服务与呼叫中心
语音克隆可帮助企业在 IVR 菜单、外呼提醒和AI 语音智能体中保持一致的品牌声音。在不同渠道间切换的客户希望获得一致的体验,而语音可引导不同触点实现一致的交互。
Twilio 将 ElevenLabs 集成到其 ConversationRelay 平台,让开发者能直接在 Twilio 基础设施上构建对话式语音体验,并提供可满足生产环境通话量需求的自然语音。
声音银行
对于面临 ALS、喉癌或 MS 等退行性疾病的患者,语音克隆能在失去说话能力前保存极具个人意义的声音。
Della Larsen 于 2023 年确诊 ALS。她通过声音银行录制了自己朗读的 30 本儿童读物,留给未来的孙辈,让他们能听见她为自己读书。
高质量语音让原本可能彻底失去声音的人,在仍有机会时将声音保存下来。这会形成一份不可篡改的声音记录,供他们在未来长期使用。
如需了解更多声音银行信息,以及 ElevenLabs 如何致力于保存 100 万种声音,请查看我们的影响力页面。
教育与在线学习
语音克隆让教育产品能以熟悉且值得信赖的声音进行教学。尤其对初学者而言,更柔和或友善的声音可能让他们更有信心。
Chess.com 使用 ElevenLabs,将中村光、Levy Rozman 和 Magnus Carlsen 等国际象棋大师及知名创作者的声音引入其 Play Coach 功能,以玩家已在 YouTube 和 Twitch 上熟悉的声音,提供实时走棋反馈。
通过语音克隆 API 确保数据安全与负责任地使用 AI
语音克隆可能被用来冒充真人、制作诈骗电话,或根据本不应被克隆的语音样本生成音频。提供商应始终在平台中内置同意、可追溯性和留存控制机制。
以下是需要重点关注的 3 项保障措施。
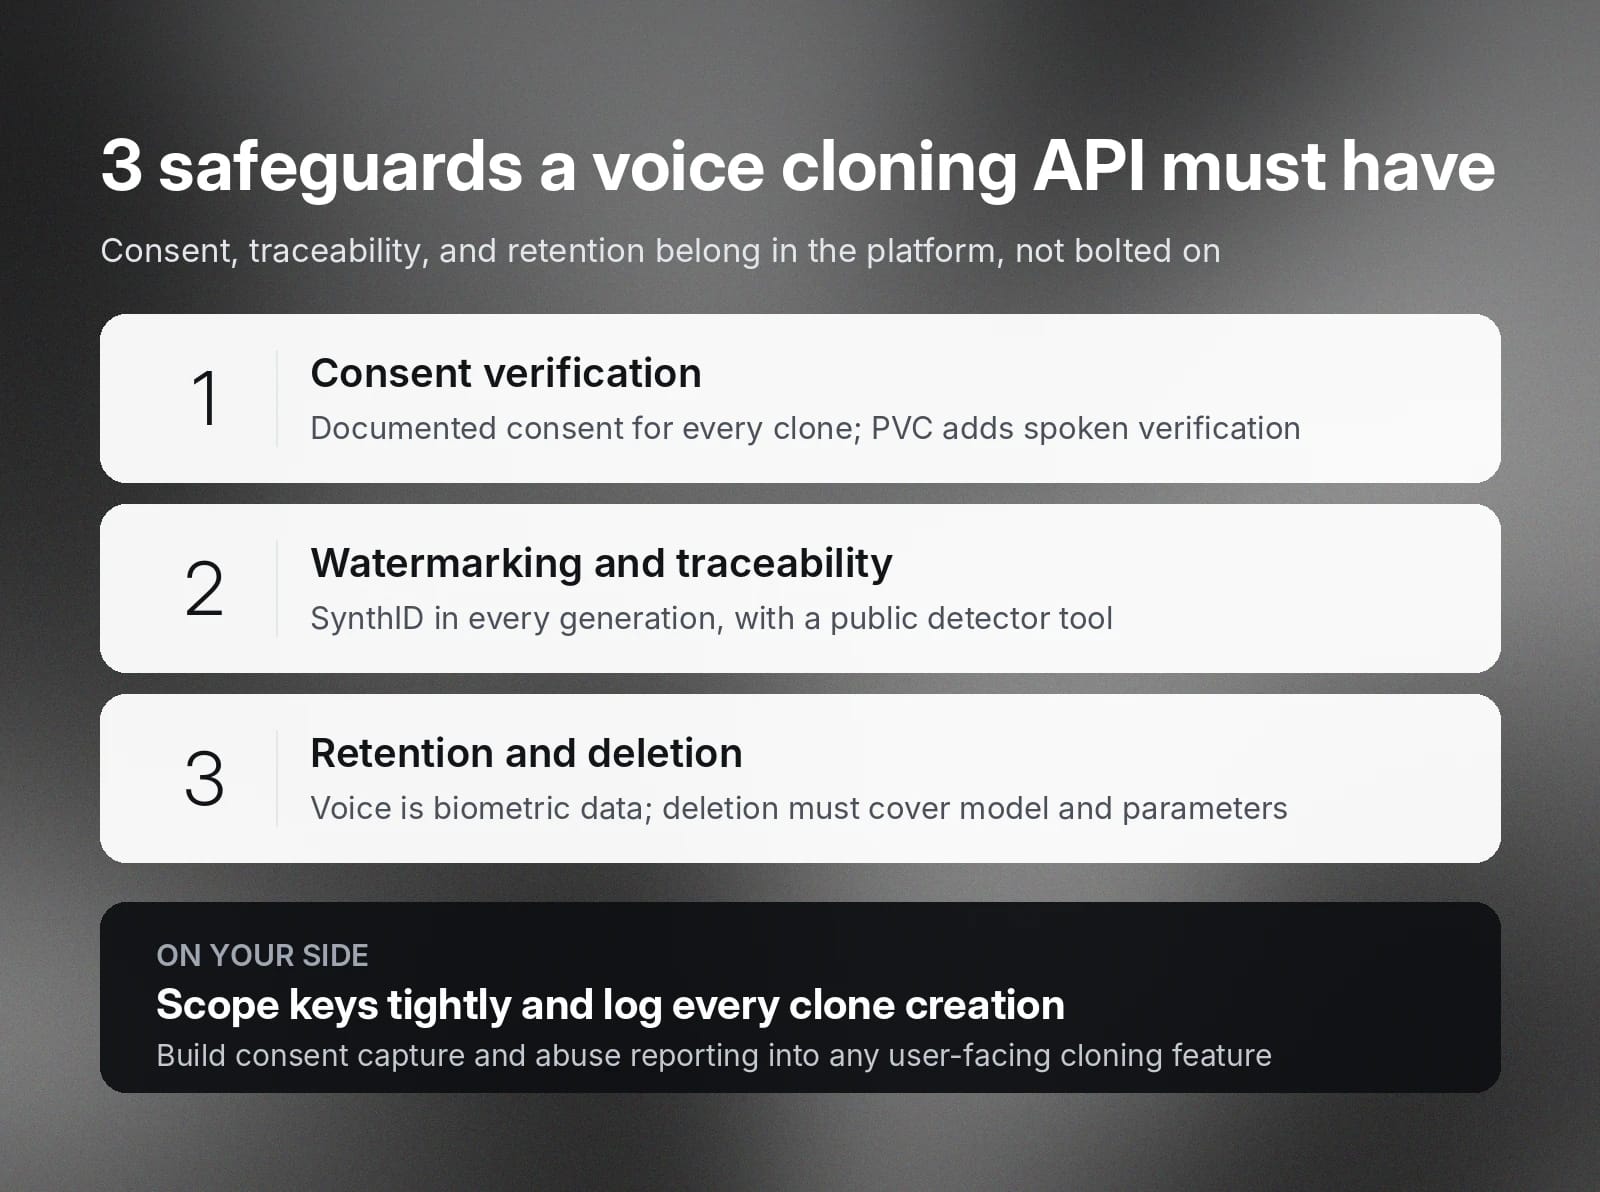
同意验证
每个克隆都应要求音色所有者提供书面同意。ElevenAPI 要求每次克隆均提交同意声明;专业语音克隆还会增加验证步骤,由说话者录制特定声明以确认身份。
对于允许终端用户克隆声音的应用,应在自身流程中加入同意采集机制。将宽松的同意要求视为危险信号。让任何人都能轻易被克隆的提供商,也可能更容易吸引滥用行为。
水印与可追溯性
生成音频应可归因。评估提供商时,应明确询问其如何支持生成后的归因。ElevenAPI 嵌入 SynthID,这是一项与 Google DeepMind 共同开发的数字水印技术,应用于每次生成;同时提供检测工具,用于验证音频是否由 ElevenLabs 生成。
滥用行为可被追溯,有争议的内容可被验证;如果克隆音色的来源受到质疑,企业也有依据可循。
留存与删除政策
在许多司法管辖区,语音数据属于生物识别数据。不同提供商在所有权、训练用途和留存方式上差异很大。集成前,请明确以下问题的答案:
- 克隆音色模型归谁所有?
- 提供商能否将语音数据用于训练?
- 提出删除请求后,多久能完成删除?
对于处理欧洲用户数据的应用,GDPR 删除权同样适用于根据录音创建的音色模型。提供商需要有删除工作流程,能够移除音色模型、训练数据及衍生参数。
ElevenAPI 提供零留存模式,面向企业版客户,可从源头避免留存请求数据,并提供数据驻留选项以选择数据存储位置。
责任也延伸至自身的集成方式。应严格限制访问密钥权限、记录克隆创建事件,并在所有面向用户的克隆功能中加入滥用举报机制。有关实施细节,请参阅API 身份验证与密钥管理最佳实践。
开始使用 ElevenAPI 语音克隆
要开始使用 ElevenAPI,请创建 API 密钥,通过语音克隆端点上传语音样本,并在文本转语音请求中发送返回的音色 ID。
官方 Python 和 Node.js SDK 支持完整 API 功能,而声音库提供 11,000 多种现成音色,适用于无需克隆的场景。
本指南介绍的合规功能已内置于平台,包括同意声明、验证、检测工具和删除工作流程。团队无需日后额外添加安全控制措施,即可从原型推进至生产环境。要估算用量,可使用API 价格计算器;要全面了解可用音色,请参阅音色综合指南。
完成设置后,只需几分钟即可克隆第一个音色。获取 API 密钥并开始克隆,或先查看文档了解更多。
常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。