即时语音克隆

了解如何使用我们一流的模型即时克隆语音。

语音克隆产品功能

创建即时语音克隆

克隆语音时,需考虑 AI 的训练内容:涵盖哪些语言,以及使用了什么类型的数据集。有关各个模型及其优势的更多信息,请参阅模型页面。

指南
如果不确定从法律角度看哪些内容是允许的,请查阅服务条款和我们的 AI 安全信息,了解更多详情。

1

前往即时语音克隆页面

在 ElevenLabs 控制台中,选择左侧的 音色 部分,然后点击 加号 图标。

在弹窗中选择 即时语音克隆。

2

上传或录制音频

按照屏幕上的说明上传或录制音频。

3

确认语音详情

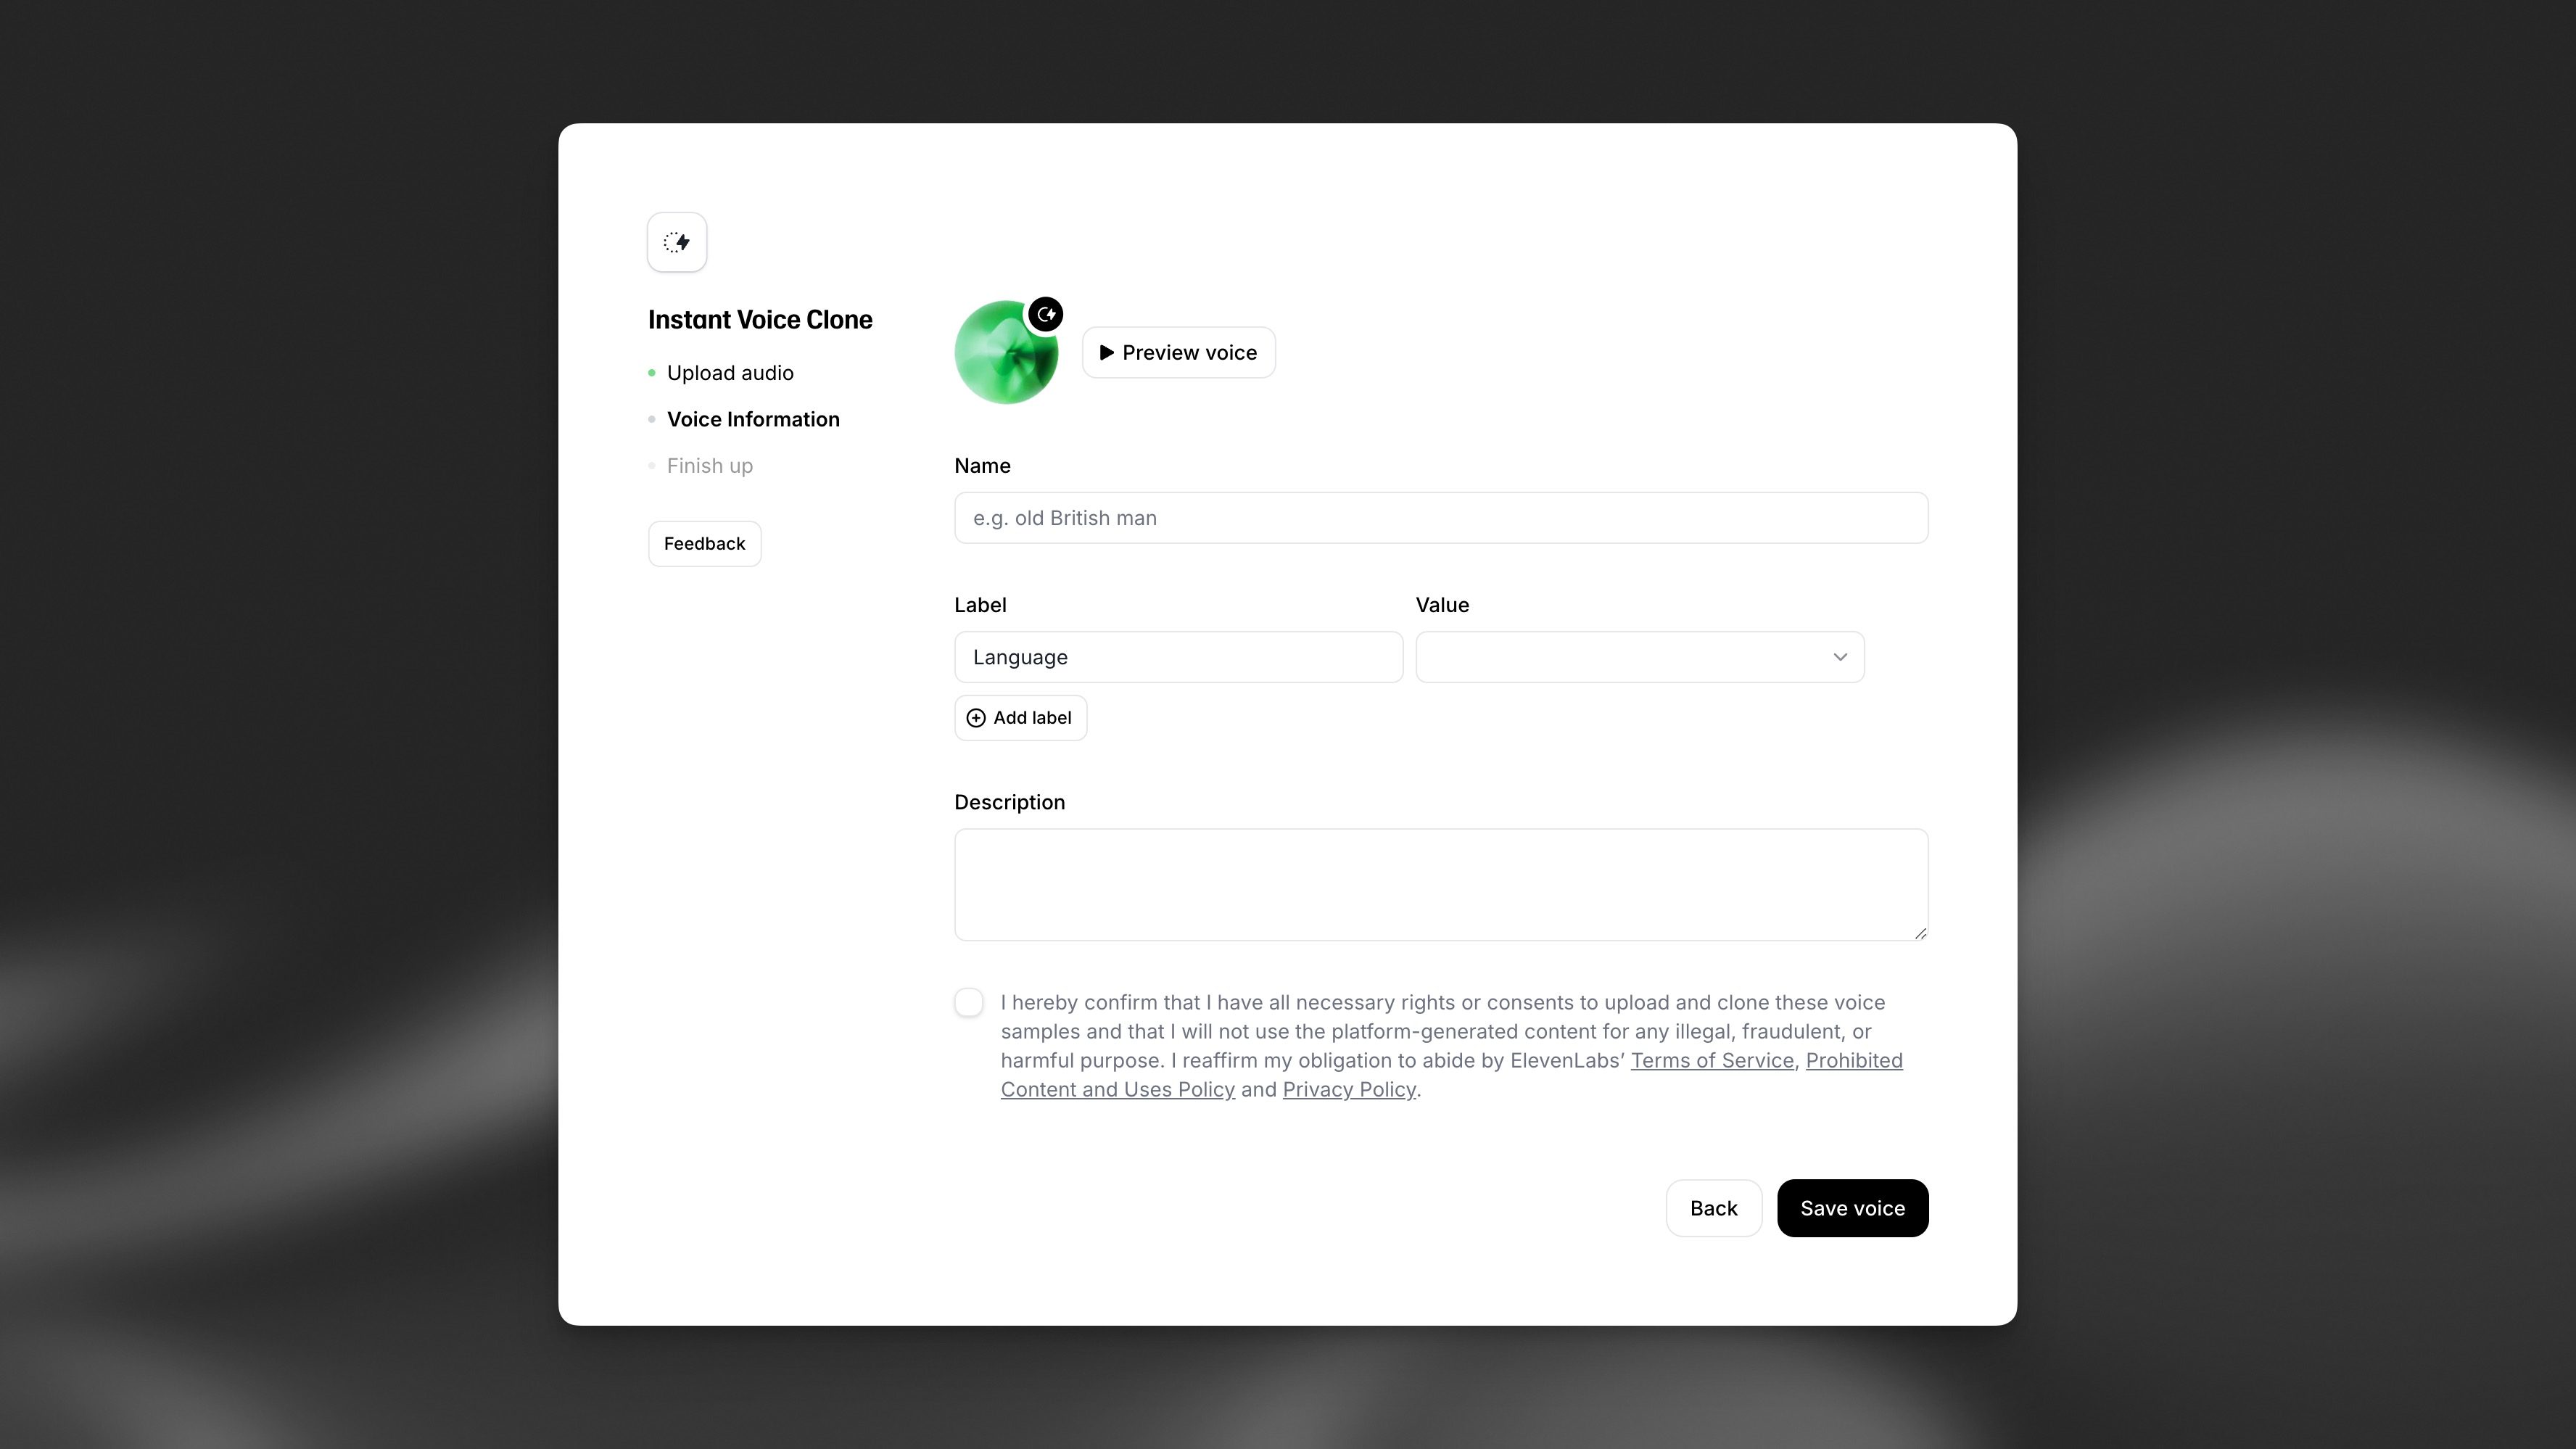
语音克隆 IVC 弹窗

为语音克隆命名并添加标签,确认你有权且已获得同意克隆该语音,然后点击 保存音色。

4

使用语音克隆

在控制台的 音色 部分,点击 我的音色,再点击 使用音色 即可开始使用。

最佳实践

录制至少 1 分钟音频

避免录制超过 3 分钟,因为改善效果很小,某些情况下甚至可能损害克隆效果。

音频的录制方式比样本总时长更重要。使用多少个样本并不重要,关键是合计总时长。

建议使用约 1-2 分钟清晰、无混响、无伪影且无任何背景噪音的音频。我们所说的“音频或录音质量”,不是指 MP3 或 WAV 等编解码器,而是指音频的采集方式。不过,就音频编解码器而言,建议使用 128 kbps 及以上的 MP3。更高的比特率不会显著提升克隆质量。

保持音频一致性

AI 会尝试模仿音频中听到的一切,包括说话速度、语调变化、口音、音色、呼吸模式和强度,以及噪音和嘴部咔嗒声。可能使其混淆的噪音和伪影也会被纳入考量。

确保整段语音保持一致的音调和演绎风格。同时,确保所有样本中的语音音质一致。即使只使用一个样本,也应确保整个样本保持一致。向 AI 提供动态范围很大的音频,即音高和音量波动明显的音频,结果会更难预测。

复现你的演绎方式

另一个需要注意的重要事项是,AI 会尝试复现你提供语音的演绎方式。如果你说话缓慢、单调且情感不多,AI 也会模仿这种风格。相反,如果你说话很快且情感丰富,AI 也会尝试复现这种风格。

所有样本中的语音保持一致至关重要,不仅是音调,演绎方式也要一致。如果差异过大,可能会使 AI 混淆,导致多次生成之间的输出变化更大。

保持合适的音量

保持合适的音量,避免音频过轻或过响。理想范围是 -23 dB 至 -18 dB RMS,真实峰值为 -3 dB。

常见问题
与只需不到 2 分钟音频即可快速克隆声音的 即时语音克隆 不同,专业语音克隆 可训练出更逼真的声音模型。它会使用大量语音数据训练专属模型,生成的声音几乎与原声无法区分。

专业语音克隆需要微调和训练,因此暂时无法立即使用克隆的声音。具体时间取决于前方排队人数及其他因素,难以准确预估,但微调通常需要 3–6 小时。

专业语音克隆准备就绪后,会收到邮件通知。

Cloning with instant voice cloning can be a bit complicated, and we do have some general guidelines. However, they are just that: guidelines. We don’t have any set rules when it comes to number of samples or length. We’ve seen users use samples of only 30 seconds and get excellent results, while we’ve also seen some users use 10 minutes of audio and have worse results. But we do have a few things that you should consider.

  • Audio quality is the most important aspect to consider when using instant voice cloning.
  • The number of samples is irrelevant; what’s important is the total run time. Having more than 2-3 minutes of audio will yield little improvement and can, in some cases, even be detrimental to the stability of the clone.

即时语音克隆和专业语音克隆支持多种文件类型。强烈建议使用 192kbps 或更高码率的 MP3。

推荐格式

  • MP3,192kbps 或更高

推荐时长

  • 即时语音克隆:1–2 分钟高质量音频
  • 专业语音克隆:30–180 分钟高质量音频

WAV 等无压缩格式通常无法提高克隆质量,还可能导致上传问题。请优先关注录音质量:使用无背景噪音、房间混响或多人说话的清晰录音,保持稳定的音量和音色,并避免长时间静音。

更多信息请参阅即时语音克隆(IVC)和专业语音克隆(PVC)。

在 ElevenLabs,我们致力于尊重知识产权,并采取措施防范技术可能被滥用:

  • 我们仅与遵守 服务条款 和 禁止使用政策 的客户合作。这些政策禁止将我们的技术恶意用于任何可被视为非法或有害的目的;
  • 我们支持声音所有者及其被许可方维护权利,并会审核和处理所有已知侵权行为;
  • 通过模型生成的所有音频都可立即追溯到负责生成的用户。

我们正在开发的技术尚属新兴领域,明确的监管规定尚未出台。作为 AI 研究实验室,我们的目标之一是提升人们对这项技术、其潜力及局限性的认识。

如需完整指南,强烈建议阅读有关 即时语音克隆 和 专业语音克隆 的文档。

关键在于:高质量且一致的输入 = 高质量且一致的输出。

时长

  • 即时语音克隆:1 - 2 分钟高质量音频
  • 专业语音克隆:30 - 180 分钟高质量音频

请使用能找到的最佳、最清晰的音频片段。音频中应只有 1 位说话者,没有背景噪声或干扰,且声音应清晰响亮。

与其为增加时长而使用许多质量不同的片段,不如优先选择麦克风质量明显更高、整体质量和语调保持一致的片段,而非专注于增加总时长。

确保片段中大部分对话符合你最偏好的说话风格和语调。不要包含过多说话者偏离目标语音模式的对话片段。

如有必要,可使用降噪工具减少背景噪声。

你可以在我们的文档此处找到更多信息。

可以。你可以使用 Flash v2.5 和 Multilingual v2 支持的任何语言克隆声音。完整支持语言列表请参阅此处。

你也可以克隆使用 AI 不支持语言说话的声音。克隆可能会捕捉到说话者的语调,但无法说出该语言,且结果可能无法预测。我们不建议这样做。

你无法将语音克隆下载或导出为独立文件。语音克隆会保留在 ElevenLabs 账户中。

你仍可在 ElevenLabs 网站之外使用 ElevenLabs 音色。第三方服务可通过 API 密钥 调用 ElevenLabs API,并使用账户中的音色生成语音。

如果日后想重新创建克隆,请保留创建时使用的原始音频样本。即使使用相同音频,每个克隆的声音也会略有不同。

ElevenLabs 提供两种克隆选项:

  • 即时语音克隆: 使用约 1–3 分钟音频即可快速生成结果。适用于大多数声音,但对少见口音或独特声音的效果可能有限。
  • 专业语音克隆: 保真度更高,需使用 30 分钟至约 3 小时的音频。微调通常需要 3–6 小时,如果排队的声音较多,可能需要更久。

如果即时语音克隆未能很好地捕捉声音或口音,请尝试专业语音克隆。

克隆创建后无法更改其口音或语调。若要改善效果,请更换所用音频样本。样本的细微调整也可能带来显著差异。

如果在专业语音克隆(PVC)完成微调并可供使用前尝试使用它,就会看到此错误。

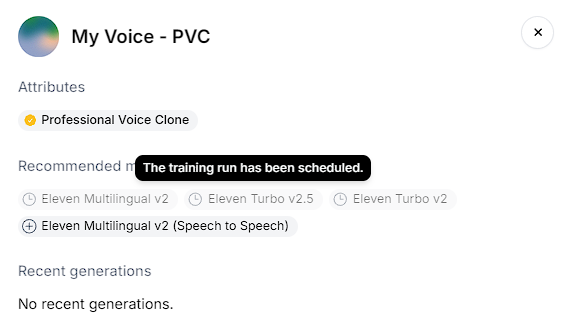
创建 PVC 后,它需要经过多个流程才能使用。完成音色验证后,系统会进行处理并排队等待微调。根据当前等待微调的其他音色数量,预计此过程通常需要 3–6 小时,但最长可能需要 24 小时。

可在我的音色中找到音色,然后点击 查看 查看更多详情,以检查 PVC 的进度。将鼠标悬停在各模型上,即可查看当前状态。  

如需了解各状态的详细含义,请参阅专业语音克隆的状态是什么意思?

PVC 完成微调并可供使用后,会看到弹窗通知,同时也会收到电子邮件通知。

No results