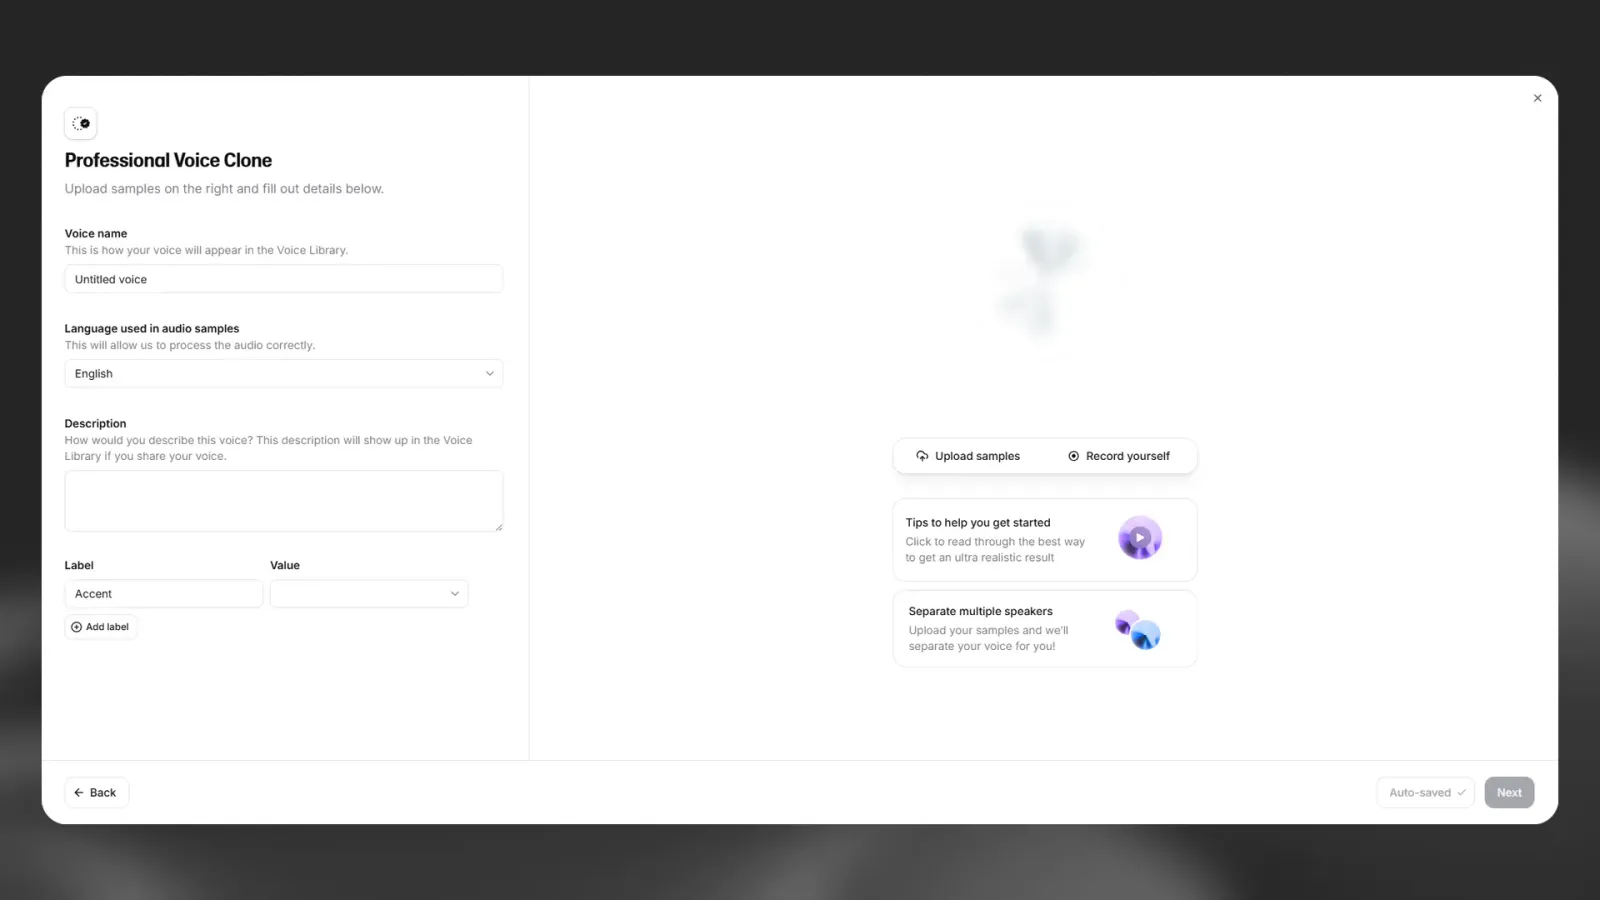
即时语音克隆与专业语音克隆有什么区别? 与只需不到 2 分钟音频即可快速克隆声音的 即时语音克隆 不同,专业语音克隆 可训练出更逼真的声音模型。它会使用大量语音数据训练专属模型,生成的声音几乎与原声无法区分。
专业语音克隆需要微调和训练,因此暂时无法立即使用克隆的声音。具体时间取决于前方排队人数及其他因素,难以准确预估,但微调通常需要 3–6 小时。
专业语音克隆准备就绪后,会收到邮件通知。
我可以创建他人声音的专业语音克隆吗? 不可以。你只能创建自己声音的专业语音克隆。即使对方同意,也不能克隆他人的声音。所有专业语音克隆都需要经过验证流程,以确认该声音属于你。
如果有人想与你分享他们的声音,可以在自己的账户中创建并验证专业语音克隆,然后使用分享链接私下分享给你。请在以下文章中了解更多:如何分享音色?
我最多可以拥有多少个专业语音克隆(PVC)? 专业语音克隆(PVC)名额因订阅套餐而异:
基础 PVC 名额
免费版和 Starter 套餐:无 PVC 名额
Creator、Pro 和旧版 Scale 套餐:1 个 PVC 名额
Scale 和旧版 Business 套餐:3 个 PVC 名额
Business 套餐:10 个 PVC 名额
Enterprise 套餐:自定义 PVC 名额数量
额外 PVC 名额 将专业语音克隆分享到声音库 后,如果该音色被标记为录音室品质,即可获得额外 PVC 名额。
录音室品质审核仅适用于已分享到声音库的音色
音色被声音库收录后,会自动进行录音室品质审核,但不会立即完成
如果共享的 PVC 被标记为录音室品质,会自动获得 1 个额外 PVC 名额
如果多个共享音色被标记为录音室品质,这种情况可能会多次发生
除非满足以下任一条件,否则无法创建更多 PVC:
通过声音库中共享音色的录音室品质审核获得额外名额
升级至 Scale 或更高套餐
重要说明
专业语音克隆只能用于克隆自己的声音
如果降级至 Creator 以下套餐,PVC 会保留在账户中,但需升级至 Creator 或更高套餐后才能使用
可拥有的自定义音色总数(包括 PVC)取决于订阅套餐
如何添加或升级用于训练专业语音克隆的模型? 所有专业语音克隆(PVC)都会自动在 Flash v2.5、Turbo v2.5 和 Multilingual v2 模型上训练。使用英语音频训练的 PVC 还会自动在 Flash v2 和 Turbo v2 模型上训练。
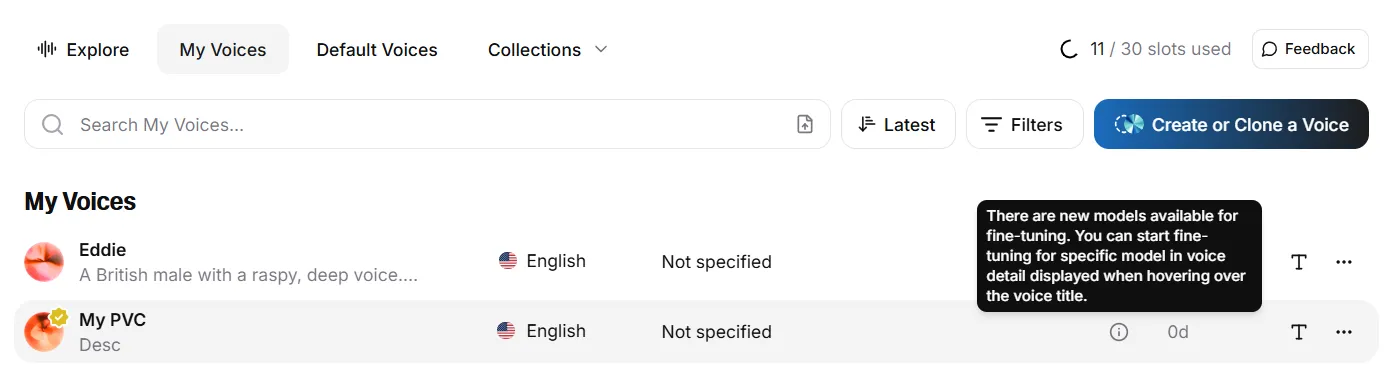
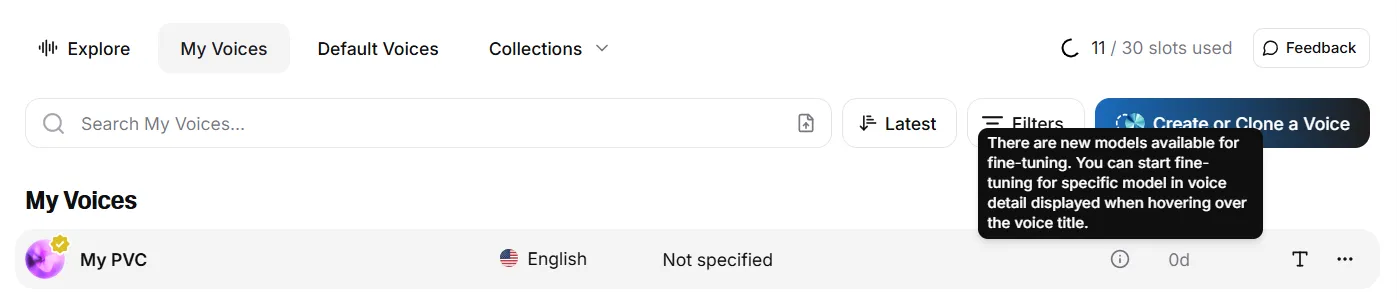
如果已有 PVC,现在可以选择在其他模型上进行微调。未来若发布支持微调的新模型,将收到通知。通知会以感叹号图标显示,出现在我的音色 音色列表中相应音色的右侧。将鼠标悬停在该图标上即可查看通知。
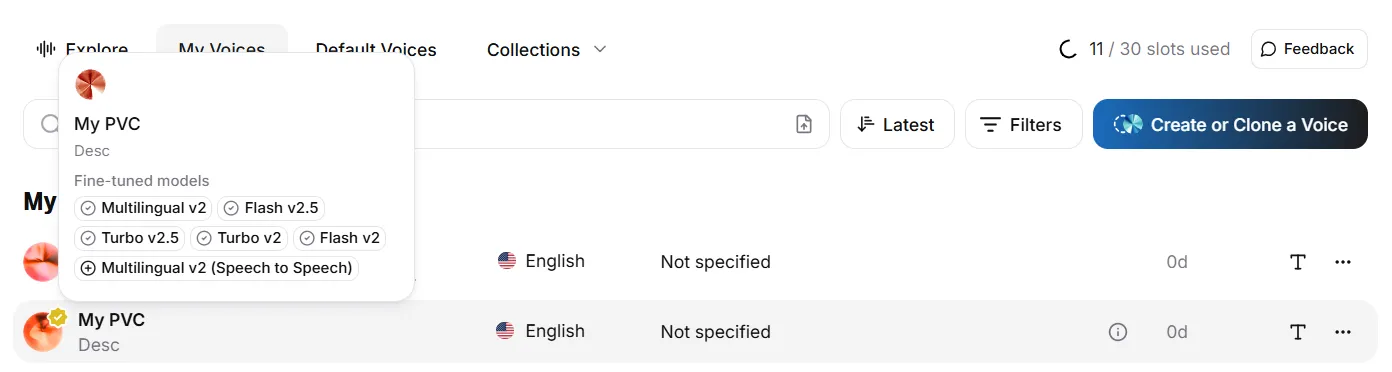
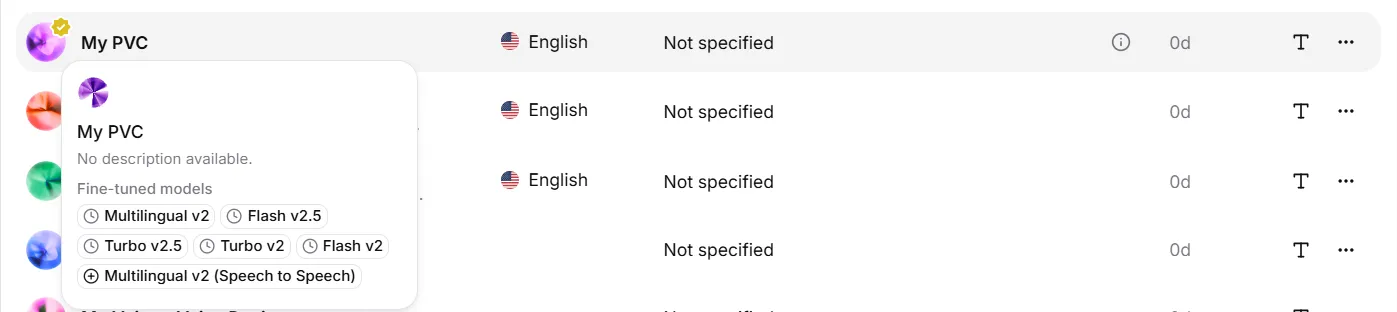
要开始微调,请将鼠标悬停在我的音色 列表中的音色名称上,即可看到所有可用模型。已在该模型上完成微调的音色会显示勾选图标,可进行微调的模型会显示加号图标。只需点击模型即可开始微调。
音色微调期间,可将鼠标悬停在模型名称上查看进度。请注意,由于音色缓存,可能需要刷新页面才能查看最新进度。微调完成后,将通过应用内通知和电子邮件告知你。
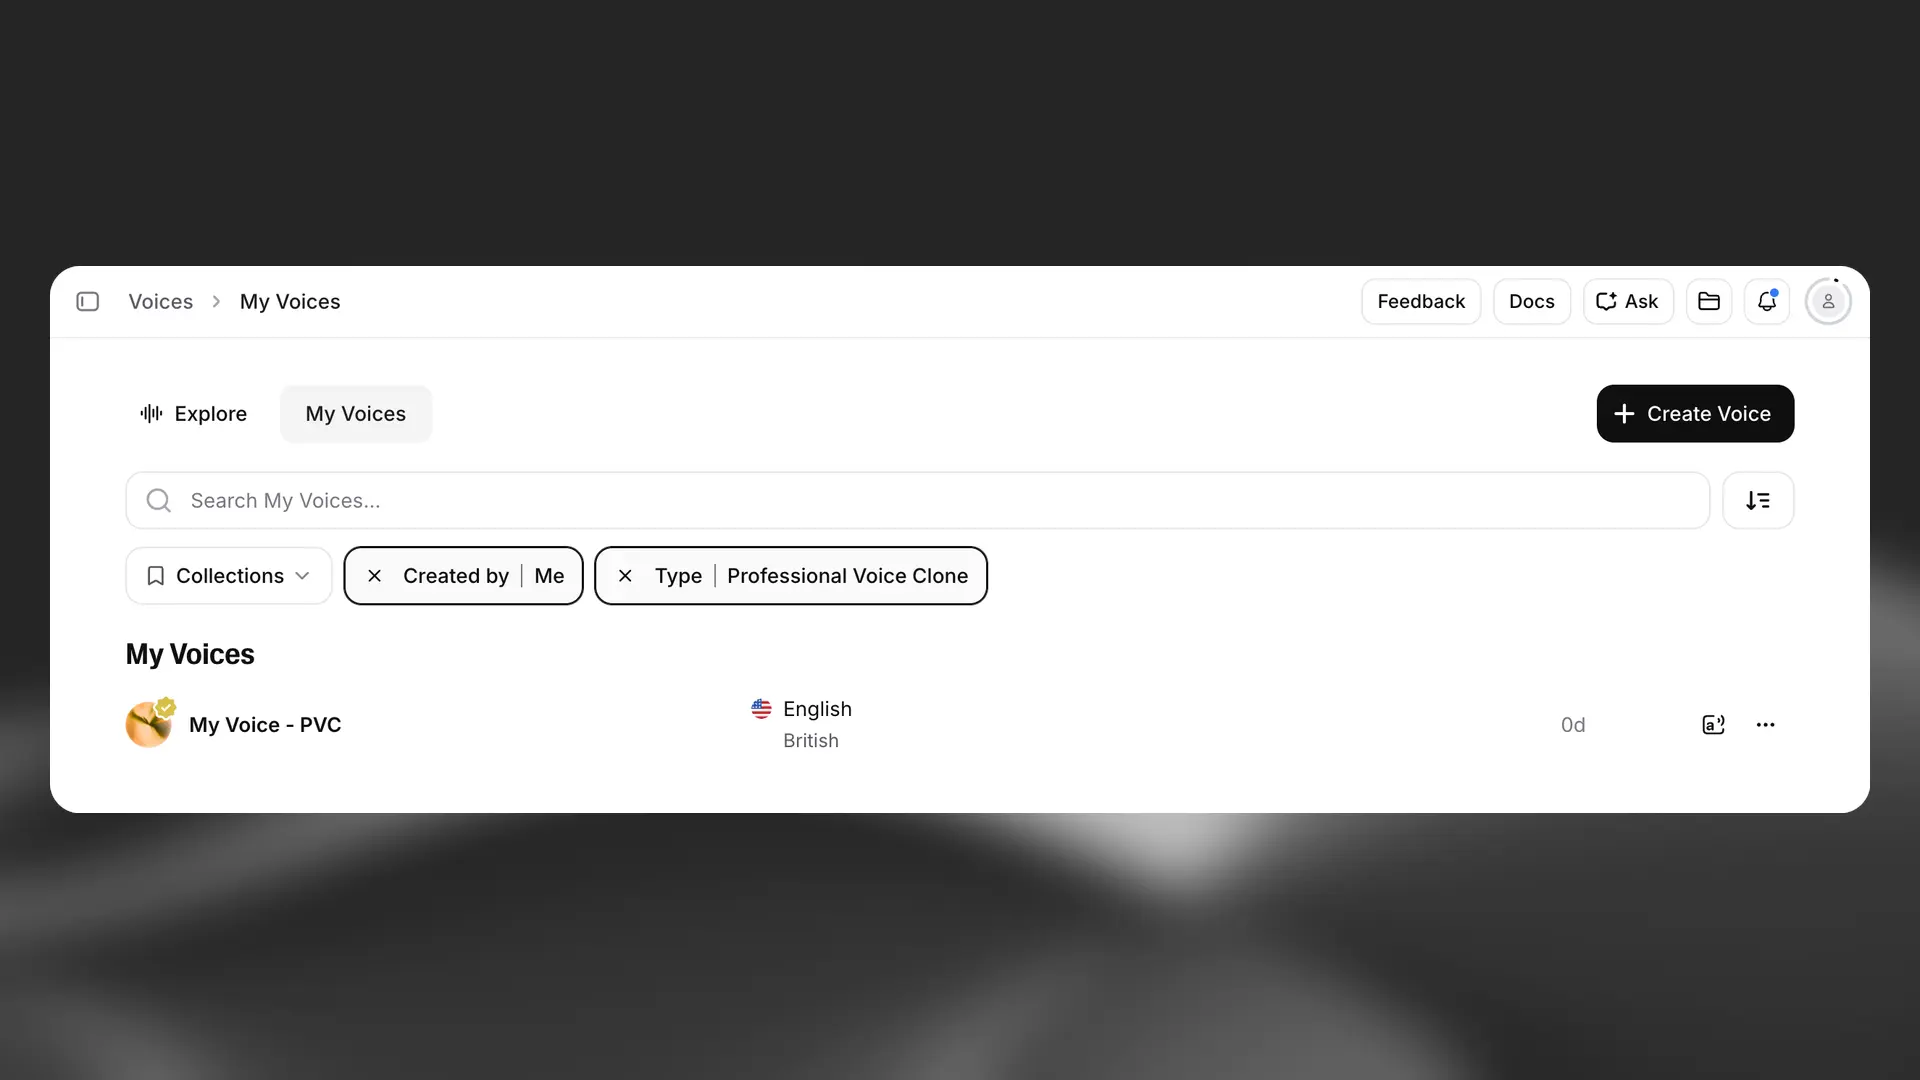
专业语音克隆的状态代表什么? 专业语音克隆在处理过程中会经历几个不同阶段。这些阶段会反映在我的音色 中专业语音克隆显示的状态里。
要查看当前状态,请在列表中找到音色,并查看右侧显示的图标。
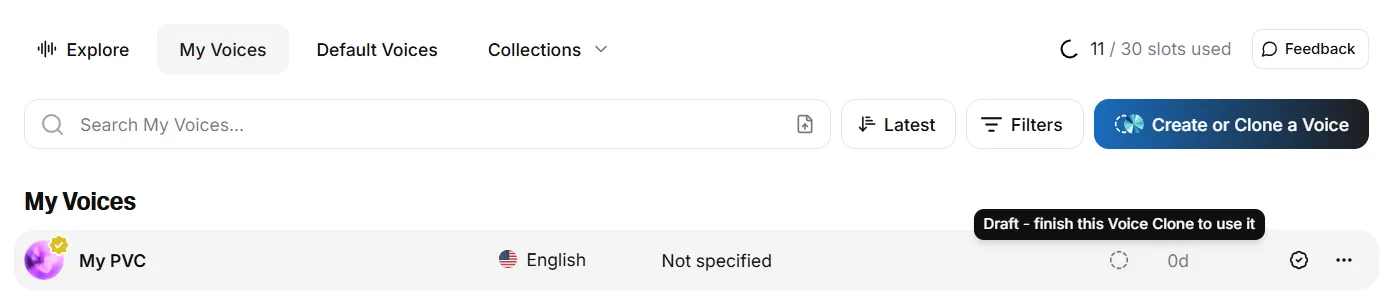
草稿: 此状态表示音色尚未完成。通常是因为尚未完成音色创建,或尚未验证音色。
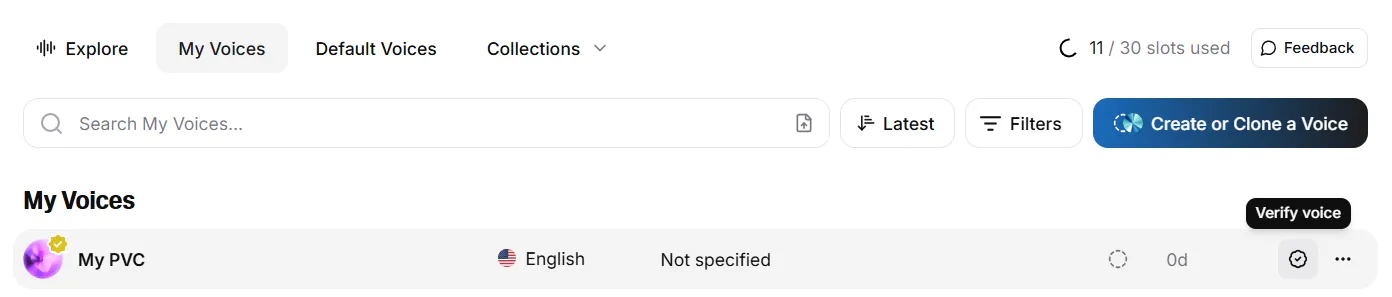
要完成验证流程,请点击勾选图标。
要返回音色创建流程,请点击 更多操作 (三个点),然后选择 编辑音色 。
完成音色验证后,还需在我们的模型上进行微调才能使用。可在我的音色 中将鼠标悬停在音色名称上跟踪此流程。这里会列出所有可用模型,并以图标显示各模型状态。
将鼠标悬停在模型名称上可查看更多信息,并会看到以下状态之一:
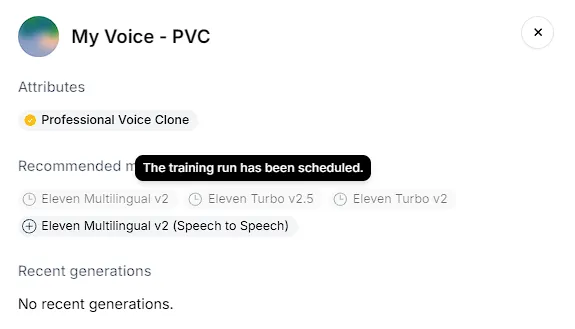
训练任务已排期 :表示音色正在等待可用训练名额。排队时长取决于队列中其他音色的数量。
正在创建数据集 和 正在进行微调 :有可用名额后,即会开始微调流程。此过程可能需要 6–24 小时。会以百分比显示音色在训练流程各步骤中的完成进度。
很抱歉,此训练任务遇到问题,已重新尝试。无需进一步操作
这表示出现了问题,但音色已自动排队重试微调流程。下次尝试时应能成功完成微调;但如果多次失败,请发送电子邮件至 support@elevenlabs.io 联系支持团队。
音色已可与此模型配合使用 :表示此模型的微调流程已完成,现在可以使用该模型生成此音色。
点击开始微调 :部分模型不会自动训练,需要点击模型名称才能开始微调。如果音色有其他可用于微调的模型,音色旁会显示感叹号图标。
要开始微调流程,只需将鼠标悬停在音色名称上,然后点击模型名称。
我的专业语音克隆(PVC)何时可以使用? 专业语音克隆会使用特定说话者的大量语音数据训练(微调)模型,以创建自定义模型。
上传样本并验证声音后,专业语音克隆将加入队列。预计训练时间约为 3–6 小时。具体时间取决于多个因素,因此难以准确预估。遗憾的是,有时可能需要更长时间。
可在 我的音色。 中查看声音当前状态。详情请参阅 专业语音克隆的状态是什么意思?
PVC 完成微调后,将通过应用内通知和电子邮件告知声音已可使用。
我的专业语音克隆失败或延迟了,该怎么办? 完成音色验证后,还需在我们的模型上进行微调才能使用。此期间,可在我的音色 中将鼠标悬停在音色名称上查看状态。这里会显示音色可用的所有模型。要查看各模型状态,请将鼠标悬停在模型名称上。
如果出现问题,可能会看到以下状态:
很抱歉,此训练任务遇到问题,已重新尝试。无需进一步操作。 这表示出现了问题,但音色已自动排队重试微调流程。下次尝试时应能成功完成微调;但如果多次失败,可能是 AI 无法解决的数据集问题。
可以尝试删除该音色,然后从头重新上传数据。这已帮助部分用户解决问题。
如果仍无法解决问题,可能需要检查训练音频,并考虑使用其他训练音频。
如果微调过程中持续失败,随时可发送电子邮件至 support@elevenlabs.io 联系支持团队。
如果专业语音克隆(PVC)验证失败,该怎么办? 如果在创建专业语音克隆时所有验证尝试均失败,可等待 24 小时后重新尝试。
也可以发送电子邮件至 support@elevenlabs.io 联系支持团队,以便他们为你检查问题。如果一切正常,他们会重置验证尝试次数,让你重新尝试。
以下建议可帮助你顺利验证专业语音克隆:
确保网页浏览器已获准使用麦克风,且未静音。
确保电脑麦克风录制的音频与用于克隆的已上传音频听起来相似,且没有背景噪音或其他外部音频干扰。
尝试以与训练音色所用音频相似的风格说话。
每句验证文本只朗读一次,然后按 停止 结束录音。多次朗读同一句可能导致验证失败。
专业语音克隆支持哪些语言? 专业语音克隆支持 Eleven v4 模型系列提供的所有语言,共 90 多种语言。
Eleven v4 模型系列支持 90 多种语言,包括:
南非荷兰语(af)、阿姆哈拉语(am)、阿拉伯语(ar)、亚美尼亚语(hy)、阿萨姆语(as)、阿斯图里亚斯语(ast)、阿塞拜疆语(az)、白俄罗斯语(be)、孟加拉语(bn)、波斯尼亚语(bs)、保加利亚语(bg)、缅甸语(my)、粤语(yue)、加泰罗尼亚语(ca)、宿务语(ceb)、克罗地亚语(hr)、捷克语(cs)、丹麦语(da)、荷兰语(nl)、英语(en)、爱沙尼亚语(et)、菲律宾语(fil)、芬兰语(fi)、法语(fr)、富拉语(普拉尔语)(ff)、加利西亚语(gl)、格鲁吉亚语(ka)、德语(de)、希腊语(el)、古吉拉特语(gu)、豪萨语(ha)、希伯来语(he)、印地语(hi)、匈牙利语(hu)、冰岛语(is)、印度尼西亚语(id)、意大利语(it)、日语(ja)、爪哇语(jv)、坎巴语(kam)、卡纳达语(kn)、哈萨克语(kk)、韩语(ko)、吉尔吉斯语(ky)、老挝语(lo)、拉脱维亚语(lv)、林加拉语(ln)、立陶宛语(lt)、卢干达语(lg)、卢森堡语(lb)、马其顿语(mk)、马来语(ms)、马拉雅拉姆语(ml)、马耳他语(mt)、普通话(zh)、毛利语(mi)、马拉地语(mr)、蒙古语(mn)、尼泊尔语(ne)、挪威语(no)、奥克语(oc)、奥里亚语(or)、普什图语(ps)、波斯语(fa)、波兰语(pl)、葡萄牙语(pt)、旁遮普语(pa)、罗马尼亚语(ro)、俄语(ru)、塞尔维亚语(sr)、绍纳语(sn)、信德语(sd)、斯洛伐克语(sk)、斯洛文尼亚语(sl)、索马里语(so)、索拉尼库尔德语(ckb)、西班牙语(es)、斯瓦希里语(sw)、瑞典语(sv)、塔吉克语(tg)、泰米尔语(ta)、泰卢固语(te)、泰语(th)、土耳其语(tr)、乌克兰语(uk)、乌尔都语(ur)、乌兹别克语(uz)、越南语(vi)、威尔士语(cy)、沃洛夫语(wo)、祖鲁语(zu)。
language_code 参数对大多数语言接受 ISO 639-1
双字母代码。没有 ISO 639-1 代码的语言使用 ISO
639-3 三字母代码:阿斯图里亚斯语(ast)、粤语
(yue)、宿务语(ceb)、菲律宾语(fil)、坎巴语(kam)和索拉尼库尔德语(ckb)。
语音克隆接受哪些文件? 即时语音克隆和专业语音克隆支持多种文件类型。强烈建议使用 192kbps 或更高码率的 MP3。
推荐格式
推荐时长
即时语音克隆:1–2 分钟的高质量音频
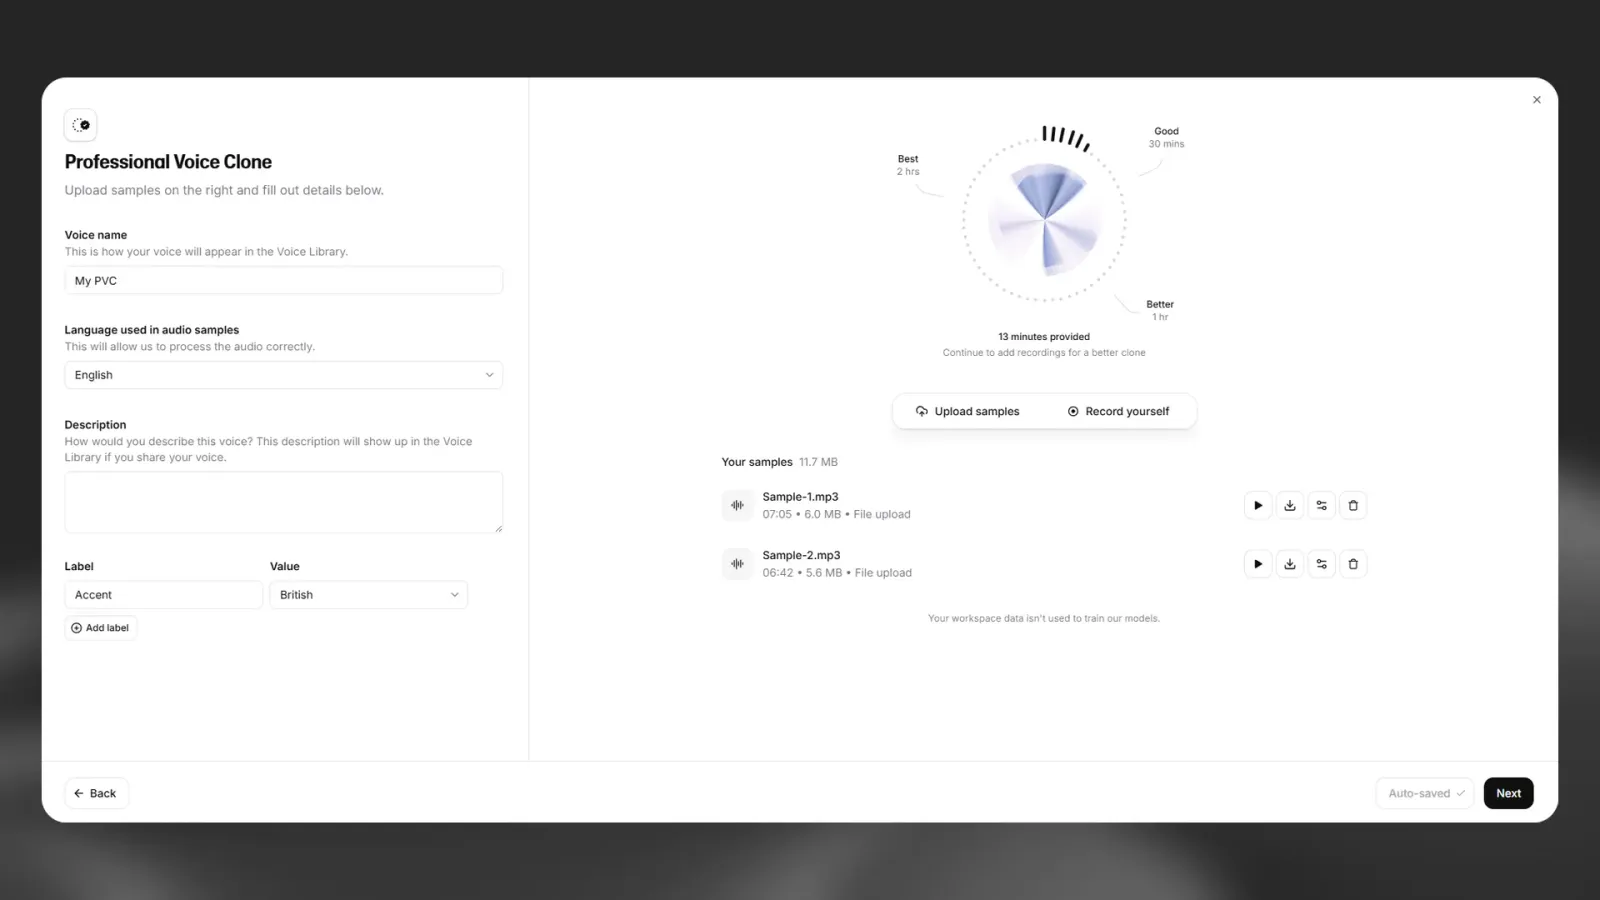
专业语音克隆:30–180 分钟的高质量音频
即时语音克隆的最短时长
在应用中上传样本时,每个文件至少需要 5 秒,所有样本合计至少需要 10 秒。要获得高质量克隆,建议达到上述推荐时长。
WAV 等未压缩格式通常不会提升克隆质量,还可能导致上传过程出现问题。请重点关注录音质量:使用无背景噪音、房间混响或多个说话者的清晰录音,保持音量和语调一致,并避免长时间静音。
更多信息,请参阅即时语音克隆(IVC) 和专业语音克隆(PVC) 。
可上传用于语音克隆的声音有哪些限制? 在 ElevenLabs,我们致力于尊重知识产权,并采取措施防范技术可能被滥用:
我们仅与遵守 服务条款 和 禁止使用政策 的客户合作。这些政策禁止将我们的技术恶意用于任何可被视为非法或有害的目的;
我们支持声音所有者及其被许可方维护权利,并会审核和处理所有已知侵权行为;
通过模型生成的所有音频都可立即追溯到负责生成的用户。
我们正在开发的技术尚属新兴领域,明确的监管规定尚未出台。作为 AI 研究实验室,我们的目标之一是提升人们对这项技术、其潜力及局限性的认识。
有什么技巧可以获得高质量的克隆语音? 如需完整指南,强烈建议阅读有关 即时语音克隆 和 专业语音克隆 的文档。
关键在于:高质量且一致的输入 = 高质量且一致的输出。
时长
即时语音克隆:1 - 2 分钟高质量音频
专业语音克隆:30 - 180 分钟高质量音频
请使用能找到的最佳、最清晰的音频片段。音频中应只有 1 位说话者,没有背景噪声或干扰,且声音应清晰响亮。
与其为增加时长而使用许多质量不同的片段,不如优先选择麦克风质量明显更高、整体质量和语调保持一致的片段,而非专注于增加总时长。
确保片段中大部分对话符合你最偏好的说话风格和语调。不要包含过多说话者偏离目标语音模式的对话片段。
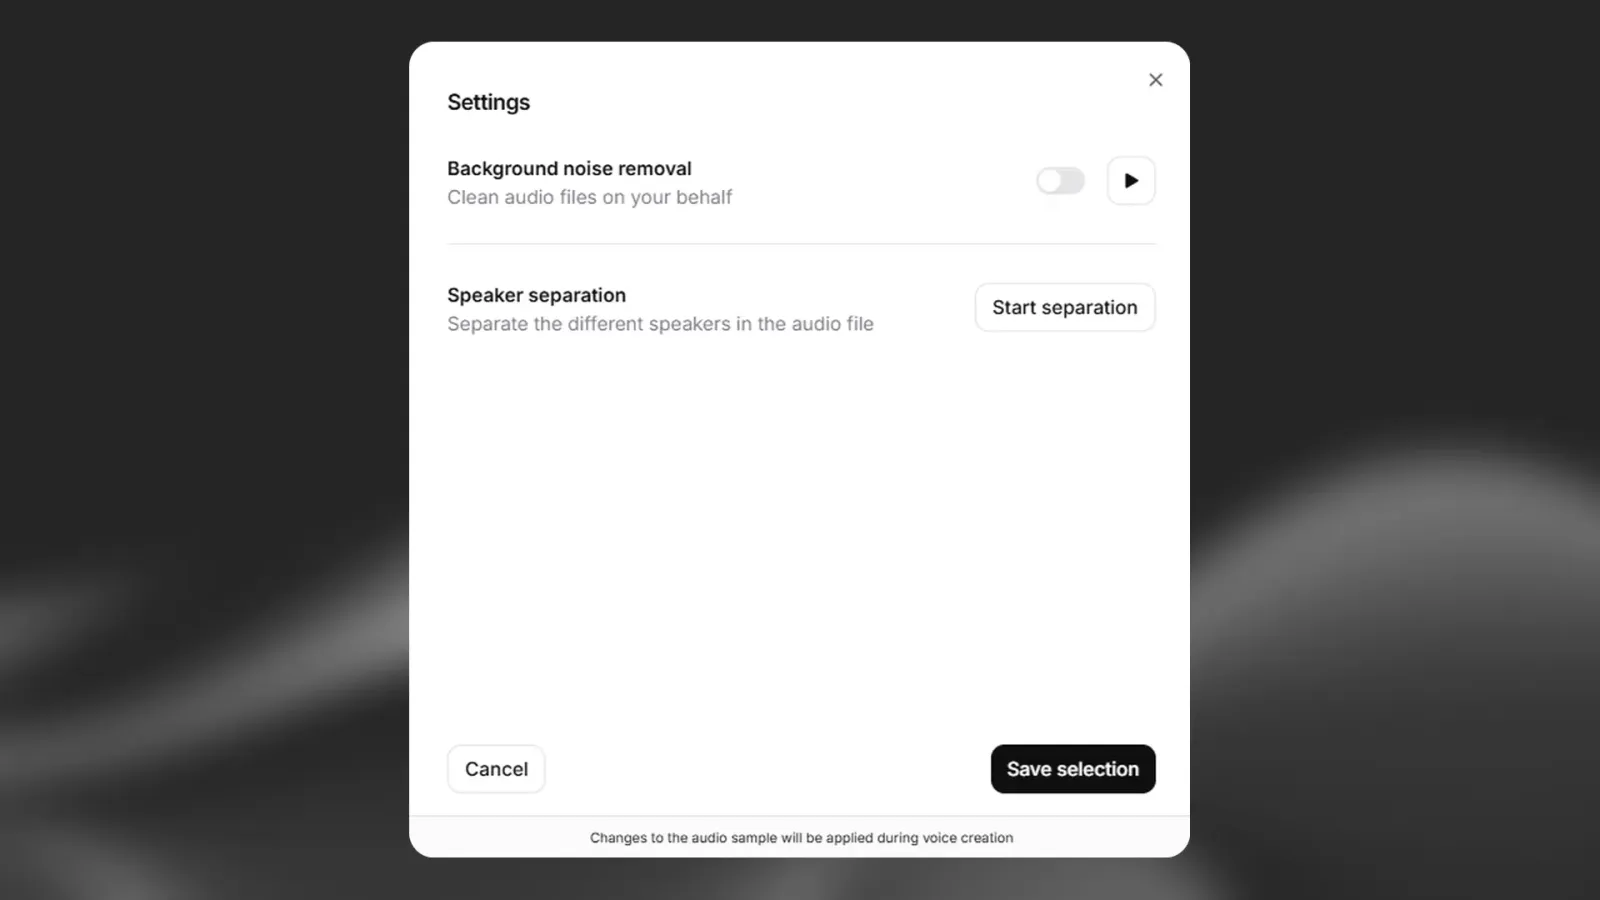
如有必要,可使用降噪工具减少背景噪声。
你可以在我们的文档此处 找到更多信息。
我可以用英语以外的语言克隆声音吗? 可以。你可以使用 Flash v2.5 和 Multilingual v2 支持的任何语言克隆声音。完整支持语言列表请参阅此处 。
你也可以克隆使用 AI 不支持语言说话的声音。克隆可能会捕捉到说话者的语调,但无法说出该语言,且结果可能无法预测。我们不建议这样做。
我可以导出语音克隆吗? 你无法将语音克隆下载或导出为独立文件。语音克隆会保留在 ElevenLabs 账户中。
你仍可在 ElevenLabs 网站之外使用 ElevenLabs 音色。第三方服务可通过 API 密钥 调用 ElevenLabs API,并使用账户中的音色生成语音。
如果日后想重新创建克隆,请保留创建时使用的原始音频样本。即使使用相同音频,每个克隆的声音也会略有不同。
为什么克隆后我的声音或口音听起来不正确? ElevenLabs 提供两种克隆选项:
即时语音克隆: 使用约 1–3 分钟音频即可快速生成结果。适用于大多数声音,但对少见口音或独特声音的效果可能有限。专业语音克隆: 保真度更高,需使用 30 分钟至约 3 小时的音频。微调通常需要 3–6 小时,如果排队的声音较多,可能需要更久。 如果即时语音克隆未能很好地捕捉声音或口音,请尝试专业语音克隆。
克隆创建后无法更改其口音或语调。若要改善效果,请更换所用音频样本。样本的细微调整也可能带来显著差异。
错误“未找到此语音的模型。请选择其他语音”是什么意思? 如果在专业语音克隆(PVC)完成微调并可供使用前尝试使用它,就会看到此错误。
创建 PVC 后,它需要经过多个流程才能使用。完成音色验证后,系统会进行处理并排队等待微调。根据当前等待微调的其他音色数量,预计此过程通常需要 3–6 小时,但最长可能需要 24 小时。
可在我的音色中找到音色,然后点击 查看 查看更多详情,以检查 PVC 的进度。将鼠标悬停在各模型上,即可查看当前状态。
如需了解各状态的详细含义,请参阅专业语音克隆的状态是什么意思?
PVC 完成微调并可供使用后,会看到弹窗通知,同时也会收到电子邮件通知。