
带时间戳和事件标记的音频转写如何工作?
- 发布时间
- 最近更新
原生逐词转录模型可将音频录音或实时流作为输入,输出由带标签和时间戳的 token 对象组成的结构化数组,涵盖语音和非语音声音。每个 token 分为 3 种类型:word、spacing 或 audio_event。音频事件可以是笑声、掌声或其他背景声音。
本文将介绍带时间戳的音频转录如何工作,以及它为何比依赖强制对齐的传统转录更灵活、更强大。
摘要
- 逐词转录可直接输出包含语音数据和非语言音频事件的结构化时间戳数组。
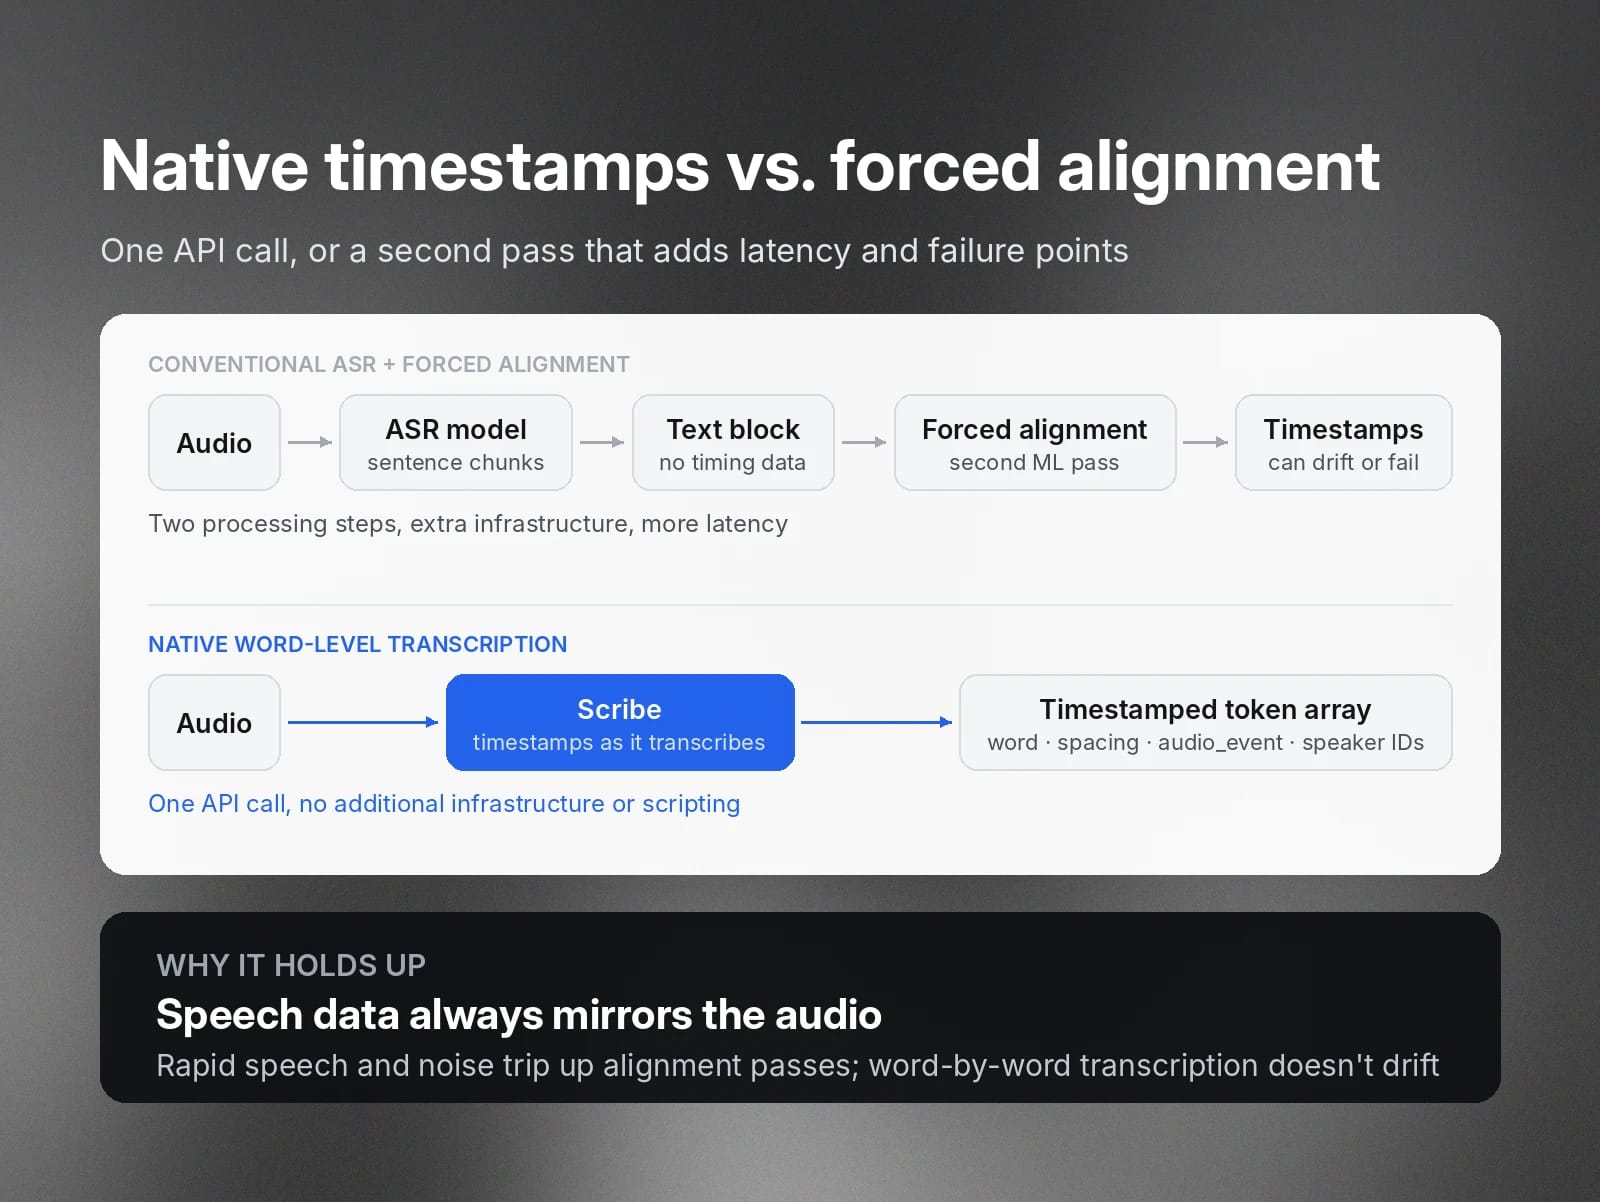
- 这不同于传统自动语音识别模型,后者输出完整文本块。若要将其与原始音频对应并添加时间戳,需要再执行一次强制对齐,这会花费更多时间并增加计算开销。
- 事件标签可捕捉笑声、掌声等非语言内容。这些数据可搜索,可根据受众反应帮助识别精彩片段或爆款时刻。
- 可将结构化输出数据提供给应用,用于高精度字幕、可搜索音频档案和自动化社交媒体剪辑等场景。
- Scribe 的逐词转录最多支持 5 个声道,每个声道均可独立转录。
什么是带时间戳和事件标签的音频转录?
带时间戳的转录是一种自动语音识别(ASR),会在转录时追踪单词和掌声等其他音频事件的精确起止时间。其输出是完全结构化、可导航的数据。
传统 ASR 转录会将音频解析为大段的人类可读文本。它能提供字幕和文本稿供人阅读,但作为数据用处不大。
如果想用时间戳将其结构化,需要将它再次交给辅助机器学习服务,把文本映射到音频。最终虽可生成类似输出,但这需要多个处理步骤,而不是由 API 原生提供,因此会增加一定延迟和额外计算开销。
为音频添加导航能力
带时间戳和事件标签的转录,关键优势在于人和机器都能读懂。它有一些重要的业务应用:
- 合规审计:可在转录文本中搜索关键词,并获取每次提及敏感数据的精确时间戳。
- 视频制作与编辑:视频制作软件可让字幕与画面中的语音精确同步到毫秒,还能恰当标记观众反应。
- 可搜索档案:公关、销售、培训等团队可将大量客户访谈、展会演讲、网络研讨会或全员大会转录成可搜索的大型档案。
- 营销分析与客户情绪:事件标签可以标记基础文本转录中可能丢失的受众反应。
原生逐词时间戳有哪些优势?
标准语音转文本模型处理语音时会按片段进行,通常是整句或整段。若想逐词添加时间戳,需要构建另一处理层,在第二次处理时执行所谓的强制对齐。这会增加基础设施和延迟,也会带来更多潜在故障点。例如,处理语速很快的语音或被嘈杂背景音掩盖的语音时,时间戳可能发生偏移,甚至完全失败。
带时间戳的转录(如 Scribe 所提供)会以更细粒度、逐词的方式转录,从而避免这一问题。一次 API 调用即可完成,无需额外基础设施或脚本。模型会在转录时计算时间戳,因此语音数据始终能准确对应音频。
带时间戳和事件标签的转录如何工作?
以Scribe为例。
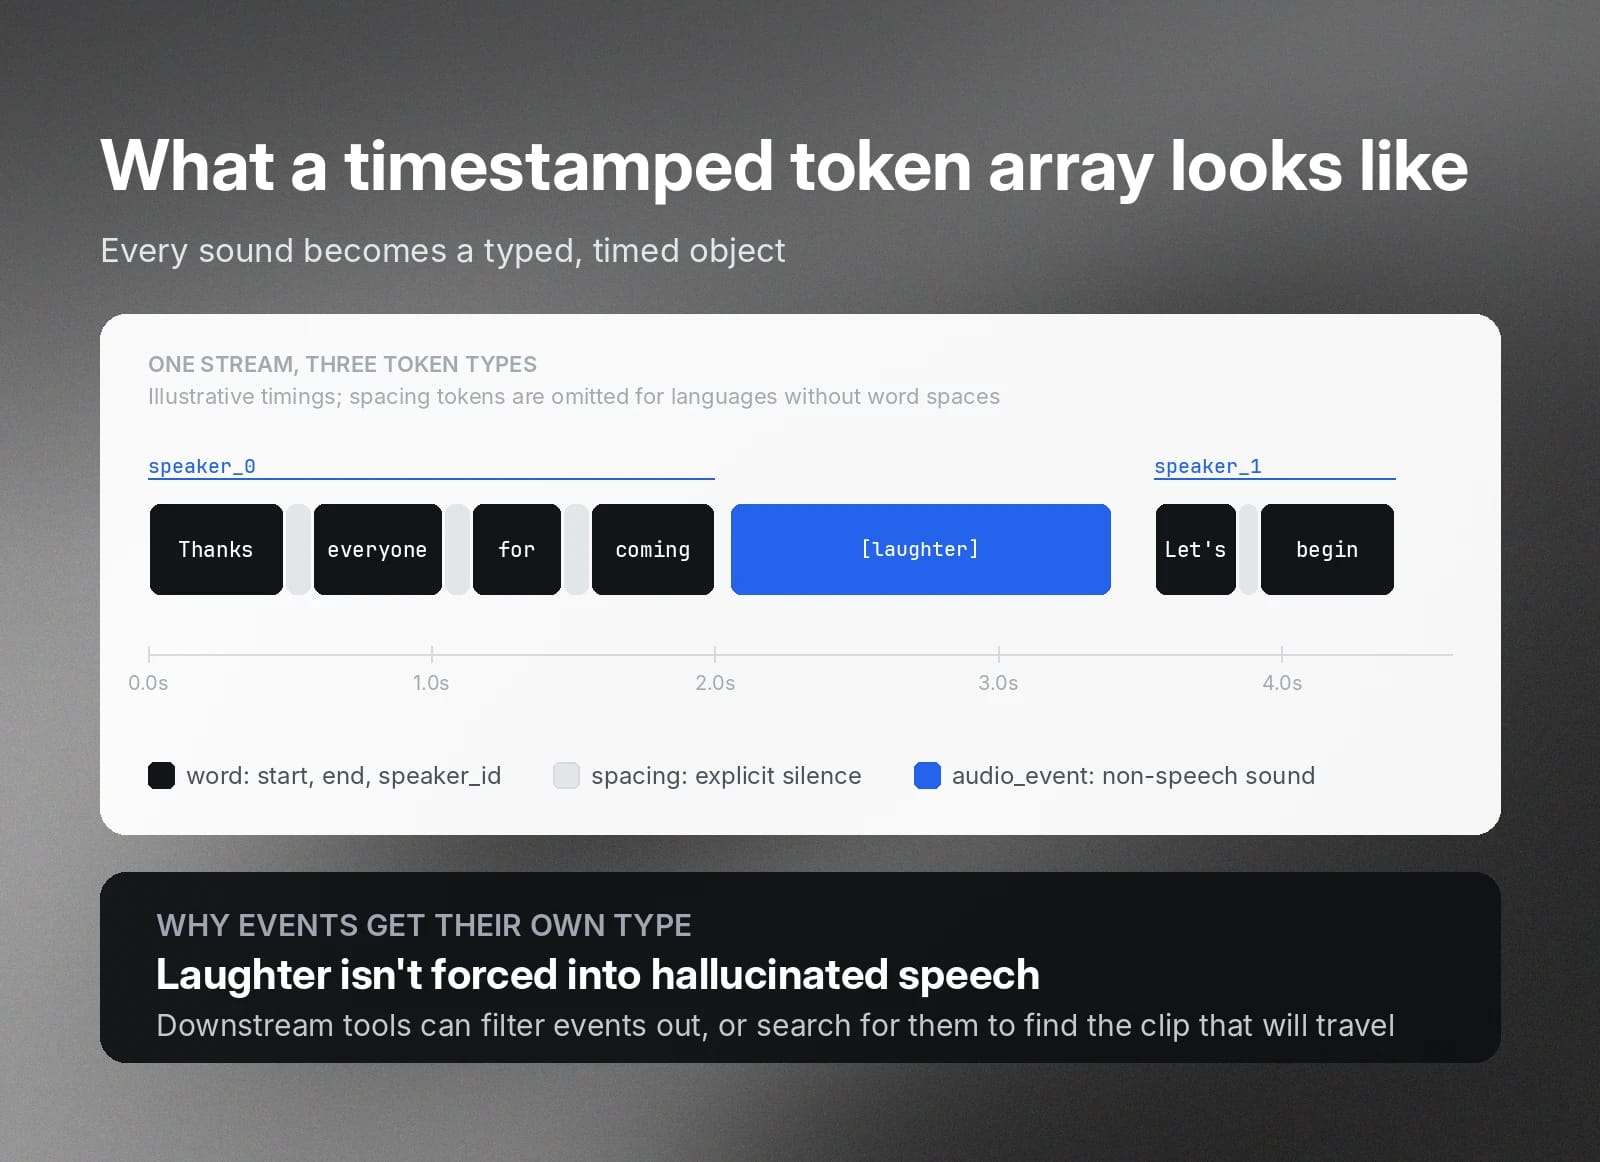
原生逐词转录模型会将音频流中的语音映射为结构化 token 对象数组,并将每个 token 标记为以下 3 种类型之一:word、spacing 或 audio_event。
- word:已识别的单个口语单词,包含起止时间和 speaker_id 标签。
- spacing:明确标记的静音或语音中的停顿,有助于字幕服务掌握正确节奏。日语、普通话、泰语、老挝语、缅甸语和粤语等不使用词间空格的识别语言不会使用此类型。
- audio_event:有意义的非语言音频,如笑声或掌声。模型会将这些内容构建为独立事件类型,不会强行将音频识别成虚构语音。
实时流参数
逐词转录模型还可包含特殊功能,以支持实时 WebSocket 音频转录。例如:
- include_timestamps=true:此参数会让连接在每个已完成音频块结束时发送的 committed_transcript_with_timestamps JSON 消息中包含逐词时间戳,因此流仍在运行时即可获取时间戳。只有同时启用 tag_audio_events 时,才会包含音频事件标签。
- include_language_detection=true:此参数会让连接标记检测到的不同口语语言及模型对检测结果的置信度评分,有助于实时生成多语言字幕。
语音转文本模型如何标记非语音事件?
启用 tag_audio_events 参数后,Scribe 会标记音频事件。它会像处理单词一样,为具体起止时间添加标签和时间戳。它可标记多种反应,最常见的是笑声和掌声,也包括可能具有上下文意义的其他环境音,例如脚步声或背景音乐。
最直接的作用是补充重要上下文,让文本稿和字幕更丰富。读者阅读简单、平铺的文本时,可能较难理解讽刺意味。[laughter] 标签可丰富文本稿,让其更具情感共鸣。
更好的分析效果
事件标签还能让下游分析更简洁,因为这些工具无需解析单个非结构化文本块。原生逐词转录会将音频事件拆分为结构化数据,工具可在适当时直接过滤这些事件,只处理语言内容。
spacing token 会让停顿可见,因此也可进行分析。这对情绪分析和 QA 等场景很有价值,例如衡量客服人员在通话中沉默了多久。
更轻松地搜索时间戳
也可以专门搜索这些事件。对产品测试访谈进行情绪分析时,可精准提取有意义的情绪反应。运营社交媒体账号时,也可快速搜索一小时演讲中的笑声,找出最可能走红的片段。
结构化时间戳文本稿有哪些实际应用?
从转录中原生获取结构化数据,可用于多个重要场景。
生成字幕和副标题
无需中间处理,即可将带时间戳的文本稿直接导出为 SRT、VTT 等制作字幕格式。视频编辑工具可利用单词时间点,在说出单词时高亮字幕中的对应文字。
转录模型会逐词处理,因此能轻松解析快速语音。传统模型可能难以处理连珠炮式的快速语音或重叠语音,而 Scribe 等逐词模型可输出清晰、结构化的文本稿。
音频和视频搜索
传统转录可匹配文本块中的关键词,但没有强制对齐,就无法跳转到某个短语说出的时刻。逐词转录的关键词搜索可建立完整索引,直接跳转到音频中说出该短语的那一秒。这实际上可将音频档案变为完全可搜索的参考资料库,尤其适合管理大型媒体库、播客网络和企业档案。
合规与风险审计
许多情况下需要录制包含敏感信息的音频,例如为 QA 录制客服通话。这类通话最可能包含敏感或受监管的个人信息。
要在保留音频数据用于分析的同时保持合规,需要能实时从文本稿中编辑敏感数据。原生逐词时间戳可让你利用ElevenLabs 的实体检测等功能,它会标记敏感实体(如信用卡号或姓名)并返回其偏移量和时间戳,以便在文本稿流式传入时将其隐藏。
例如,可在身份验证通话中识别并编辑说出的信用卡号、母亲婚前姓氏、出生日期和客户姓名。
自动化社交媒体剪辑
还可通过编程自动执行关键词搜索,从长内容中找到精彩片段。例如,可突出竞选演讲或企业研讨会中的重要时刻,将近期内容制作成适合 YouTube、LinkedIn 或 TikTok 的专业剪辑。
多声道和多说话人时间定位
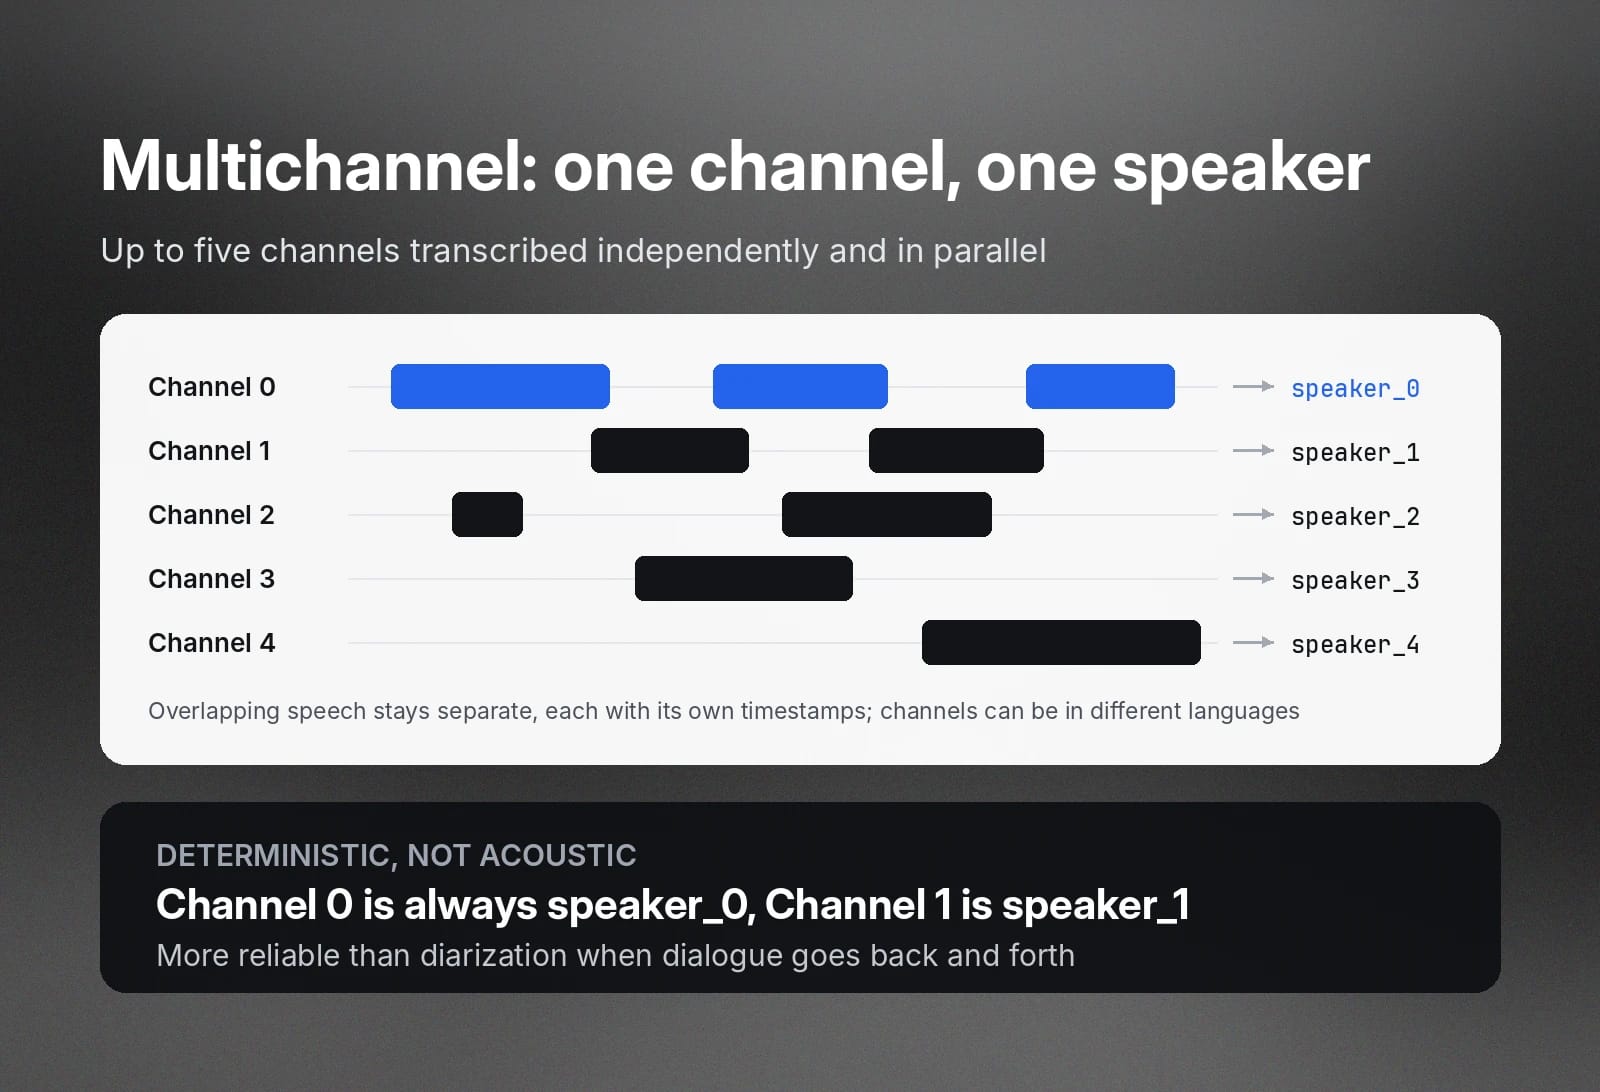
Scribe 可独立并行转录最多 5 个声道。每个声道都会分配说话人 ID 和时间戳。这比标准声学说话人分离更可靠,后者通常难以处理来回对话。对于多声道录音,Scribe 的说话人分配完全是确定性的。这意味着 Channel 0 对应 speaker_0,Channel 1 对应 speaker_1,以此类推。
它能识别尝试同时说话的说话人,并仍可为各自语音生成独立时间戳。说话人也可以使用不同语言。
以所需格式导出带时间戳的数据
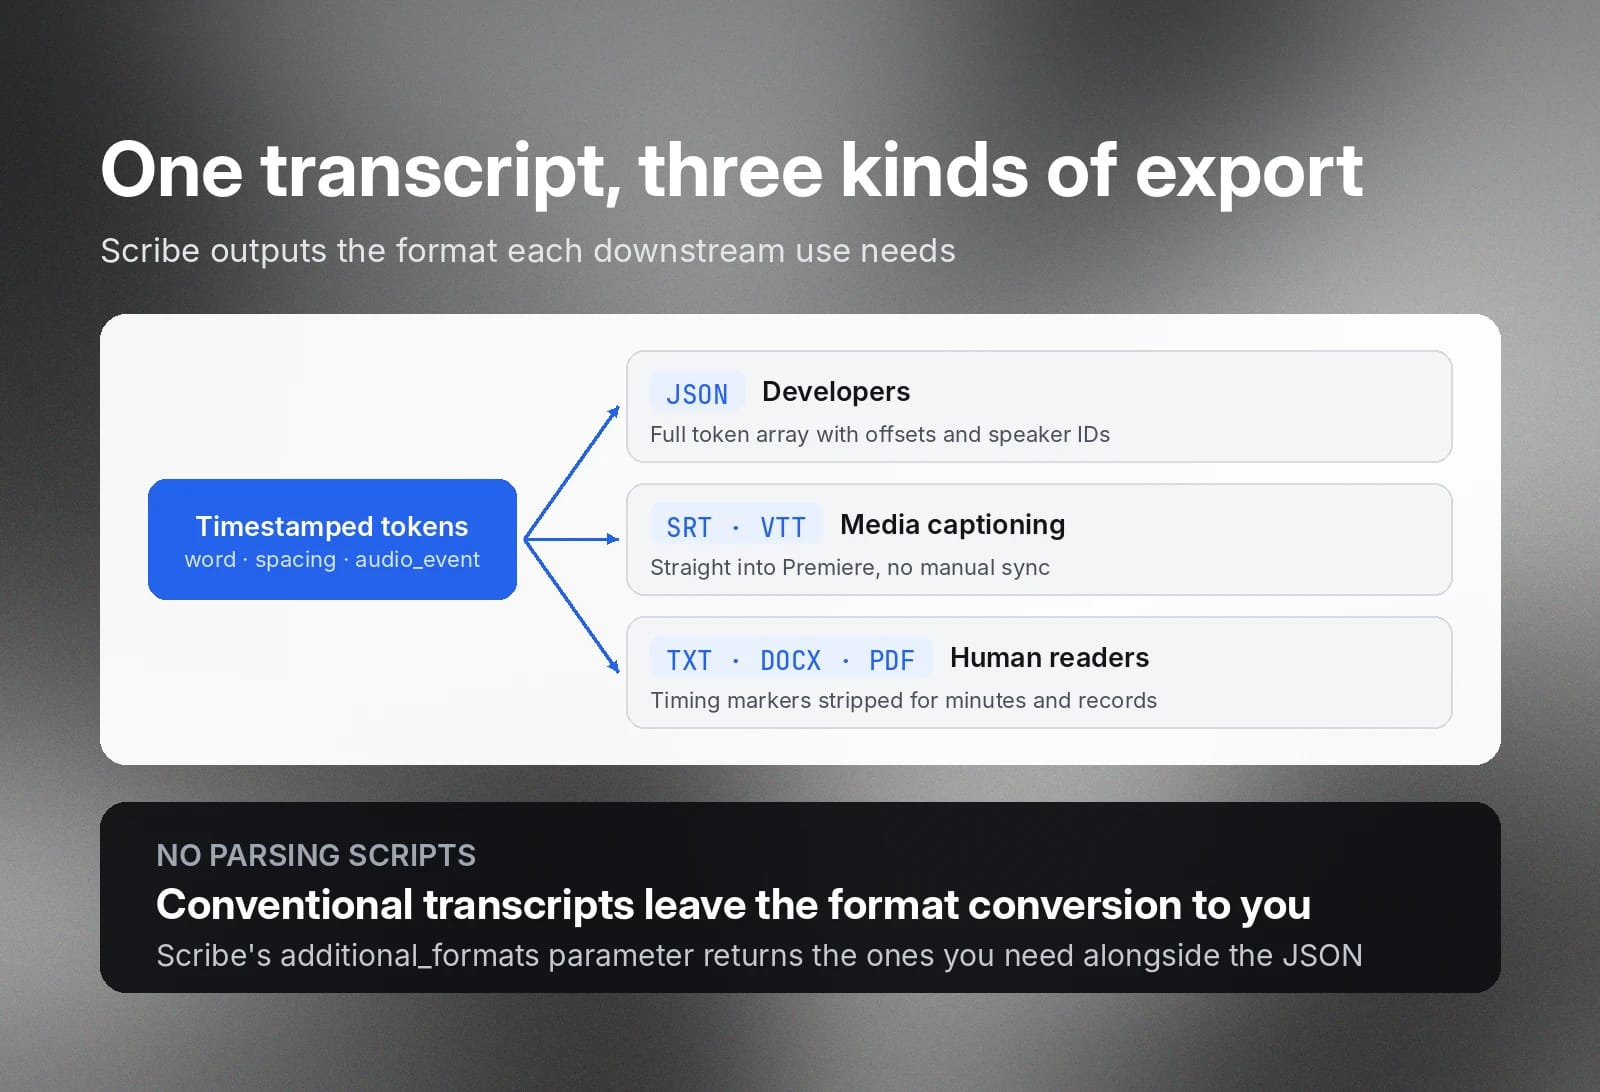
若要将传统文本稿分发为多种格式,很可能需要自行编写解析脚本。Scribe 可根据使用方式将文本稿导出为多种格式。完整架构定义请参阅 ElevenLabs 创建文本稿 API 参考文档。
面向开发者的结构化数据:JSON
Scribe 支持导出为 JSON,适用于希望获得可传递给下游应用的架构化数据的开发者。例如,开发者可利用这些 JSON 数据构建交互式媒体或组织的语义搜索数据库。完整的 word、spacing 和 audio_event token 数组会输出起止偏移量和说话人 ID。
媒体字幕:SRT 和 VTT
Scribe 可输出 SRT 和 VTT 文本稿,无需手动同步即可直接导入 Adobe Premiere 或其他制作应用。
人类可读格式:TXT、DOCX 和 PDF
它还可输出适合阅读的文本稿格式。在这些格式中,Scribe 会去除底层时间标记,让文本更易读,并适用于法律或审计文档。例如,需要在会议结束后立即高效分发董事会会议纪要、为 SEO 发布播客文本稿,或归档法律记录时,此功能非常实用。
开始使用 ElevenLabs 带时间戳和事件标签的转录
原生逐词转录可快速高效地提供工作流程所需的结构化数据。
立即在ElevenAPI中使用 Scribe 转录音频,或了解更多关于逐词转录的信息。
时间戳和事件标签转录常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。


