
什么是语音活动检测?它如何工作?
- 发布时间
语音活动检测可判断时长仅数毫秒的短音频帧中是否包含人声。它用于许多数字音频处理场景,包括转录、电话通信和语音智能体。
本文将介绍语音活动检测能做什么、不能做什么,以及它如何应用于关键企业场景。
摘要
- 语音活动检测(VAD)是现代音频工作流程的基础组件。它持续分析音频流,并针对每个毫秒级音频帧输出其中是否存在人声的“是”或“否”判断。
- VAD 告知下游音频工具何时运行、何时待命。LLM、转录服务及其他企业音频管道都会使用它。
- 语音活动检测算法会持续执行 5 个阶段的循环:采集音频、分帧、提取语音特征、评估包含语音的可能性,并将决策传递给下游服务。
- 早期 VAD 依靠纯数学信号处理来判断是否存在语音。现代 AI 系统使用神经网络实现同样功能,但对背景噪声和语义线索的上下文理解更好。
- VAD 系统只能判断音频帧是否包含语音,无法判断说话者是否已说完。端点检测系统会结合 VAD 和其他启发式分析工具,判断说话者是否表达完想法。
- 在企业场景中,VAD 可帮助 语音智能体 自然地与客户交谈,避免打断对方;优化 VoIP 带宽利用率;降低语音转文本(STT)AI 转录成本,以及支持其他用例。
- 应在真实环境下测试 VAD 系统。无瑕的录音棚录音无法有效判断其实际能力。
什么是语音活动检测(VAD)?
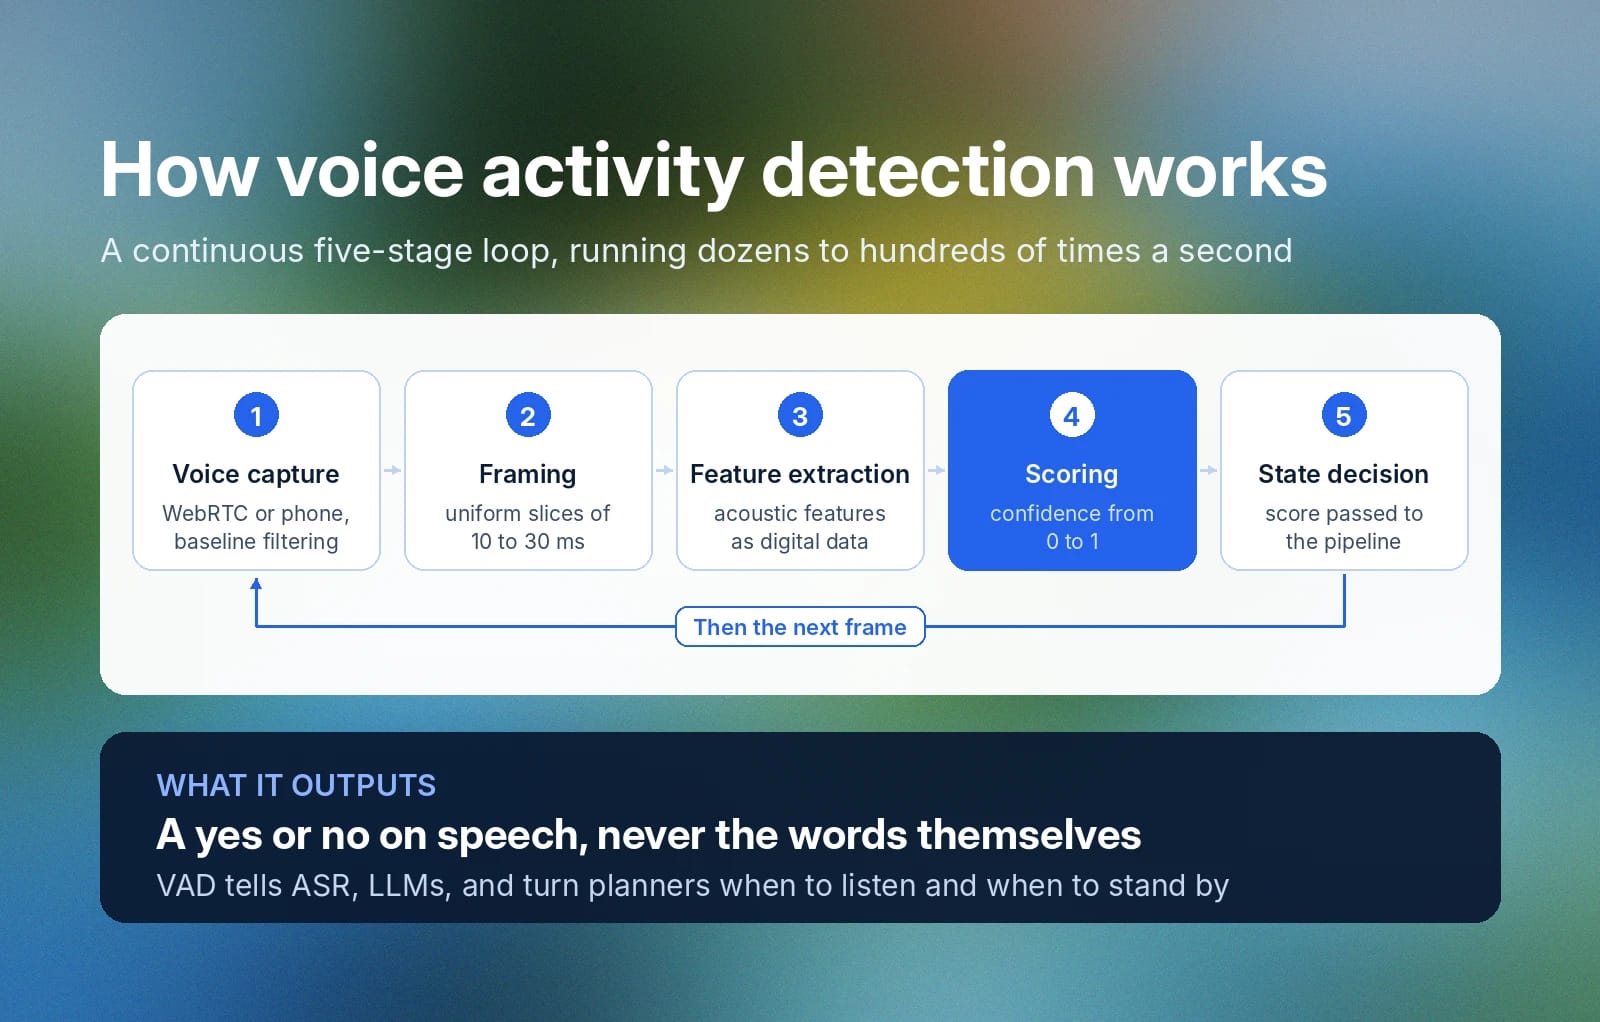
语音活动检测(VAD)是一种软件处理流程,用于判断称为帧的小段音频是否包含语音。VAD 算法每秒会在音频流上运行数十至数百次,并对是否检测到语音返回二元“是”或“否”的结果。
它用于更广泛的数字音频管道,例如 电信 或语音转录。它会告知 ASR/STT、LLM 和轮次规划器等其他下游系统,应主动监听音频流还是保持待命。
VAD 与 自动语音识别(ASR)并不相同。VAD 系统只会针对是否检测到语音输出概率性的“是”或“否”,不会输出实际词语。其主要作用是告知下游系统是否应处理某个音频帧。
语音活动检测算法如何工作?
VAD 算法处理音频流,并判断给定音频帧(通常为 10-30 毫秒)是否包含语音。
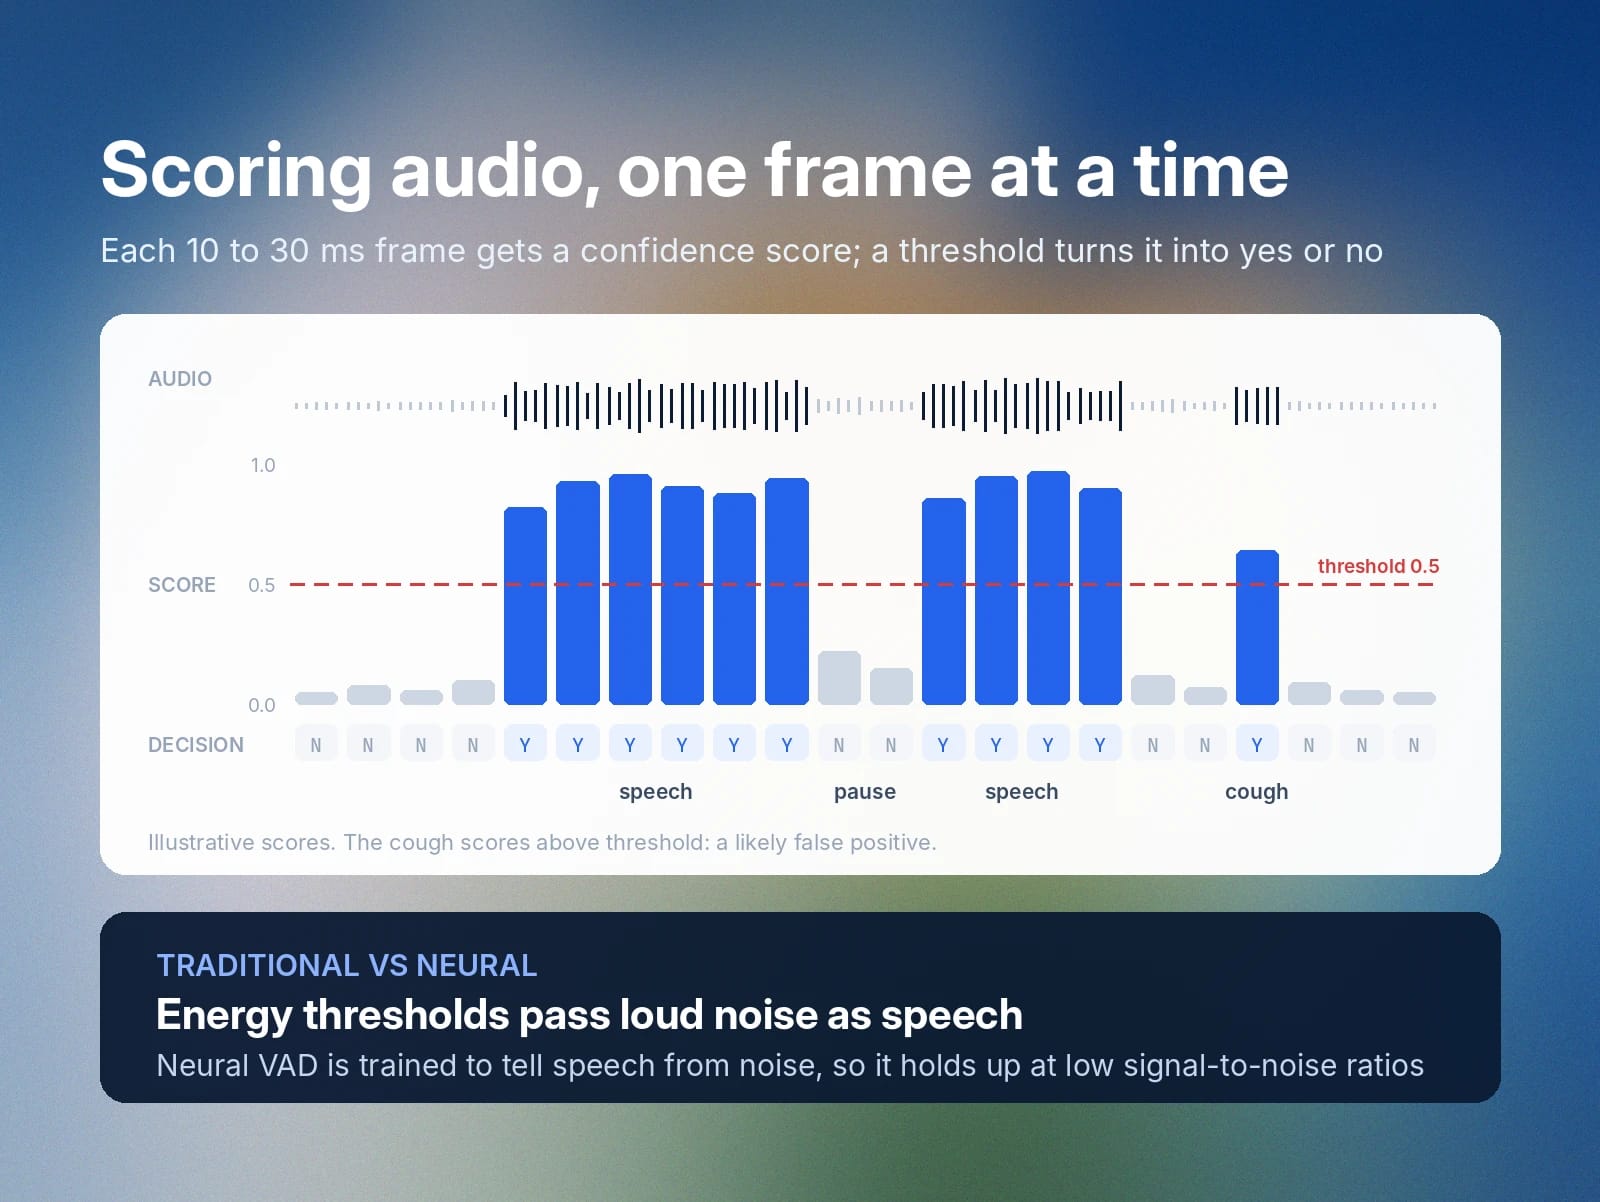
它会持续执行以下 5 个阶段的循环:
- 语音采集:运行 VAD 的系统通过 WebRTC 或电话通信接收音频流,并对数据应用基础降噪过滤。
- 分帧:算法将原始音频流切分为统一大小的帧。
- 特征提取:算法从音频流中提取可用数字数据进行数学表示的声学特征。
- 评分:系统将帧内提取的特征输入 VAD 算法,生成 0 到 1 的置信度评分,判断是否包含语音(0=“无语音”,1=“语音”)。
- 状态决策:VAD 系统将置信度评分传递给所在的音频管道,以便管道决定如何处理。
传统 VAD 与 AI VAD 对比
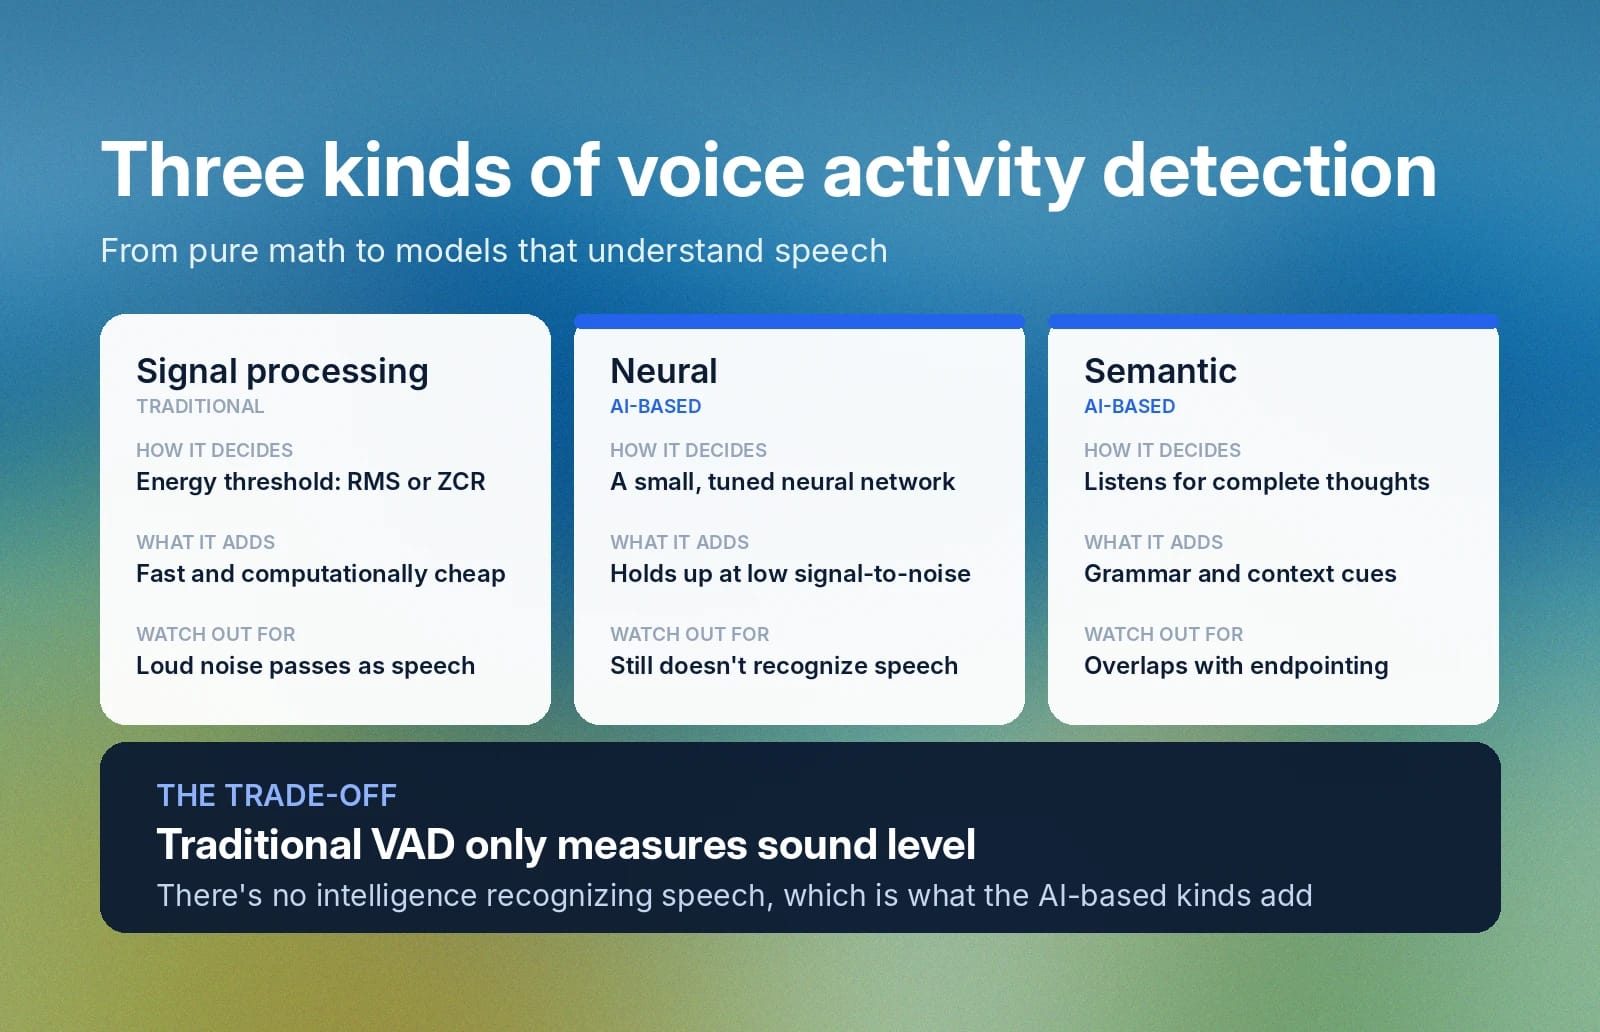
VAD 大致分为两类:信号处理和 AI。
AI VAD 又有两种不同方法,因此语音活动检测总共分为 3 类。
下面详细介绍。
传统(信号处理)VAD
传统 VAD 技术测量音频流的能量水平,超过特定阈值便确认存在语音。它完全基于数学计算,通常使用均方根(RMS)或过零率(ZCR)计算。帧的测量值高于阈值时,会作为语音传递;低于阈值时则不会。
传统 VAD 速度快、计算成本低,但它只能测量音频中的音量。响亮的背景噪声可能造成误报,且没有真正识别语音的智能能力。
AI VAD
新型 AI VAD 分为神经网络和语义两类。神经网络 VAD 不使用纯数学阈值,而是通过小型且高度优化的神经网络判断音频帧包含语音还是静音。训练使其能理解语音与噪声的差异,因此当音频流的信噪比(SNR)较低、背景噪声显著时,其表现优于传统 VAD。
神经网络 VAD 的缺点是仍无法识别语音内容本身。语义 AI VAD 则可以做到这一点。它与端点检测有所重叠,会监听音频输入以判断表达是否完整,并可根据语法和上下文理解后续是否可能还有语音。
VAD 与端点检测
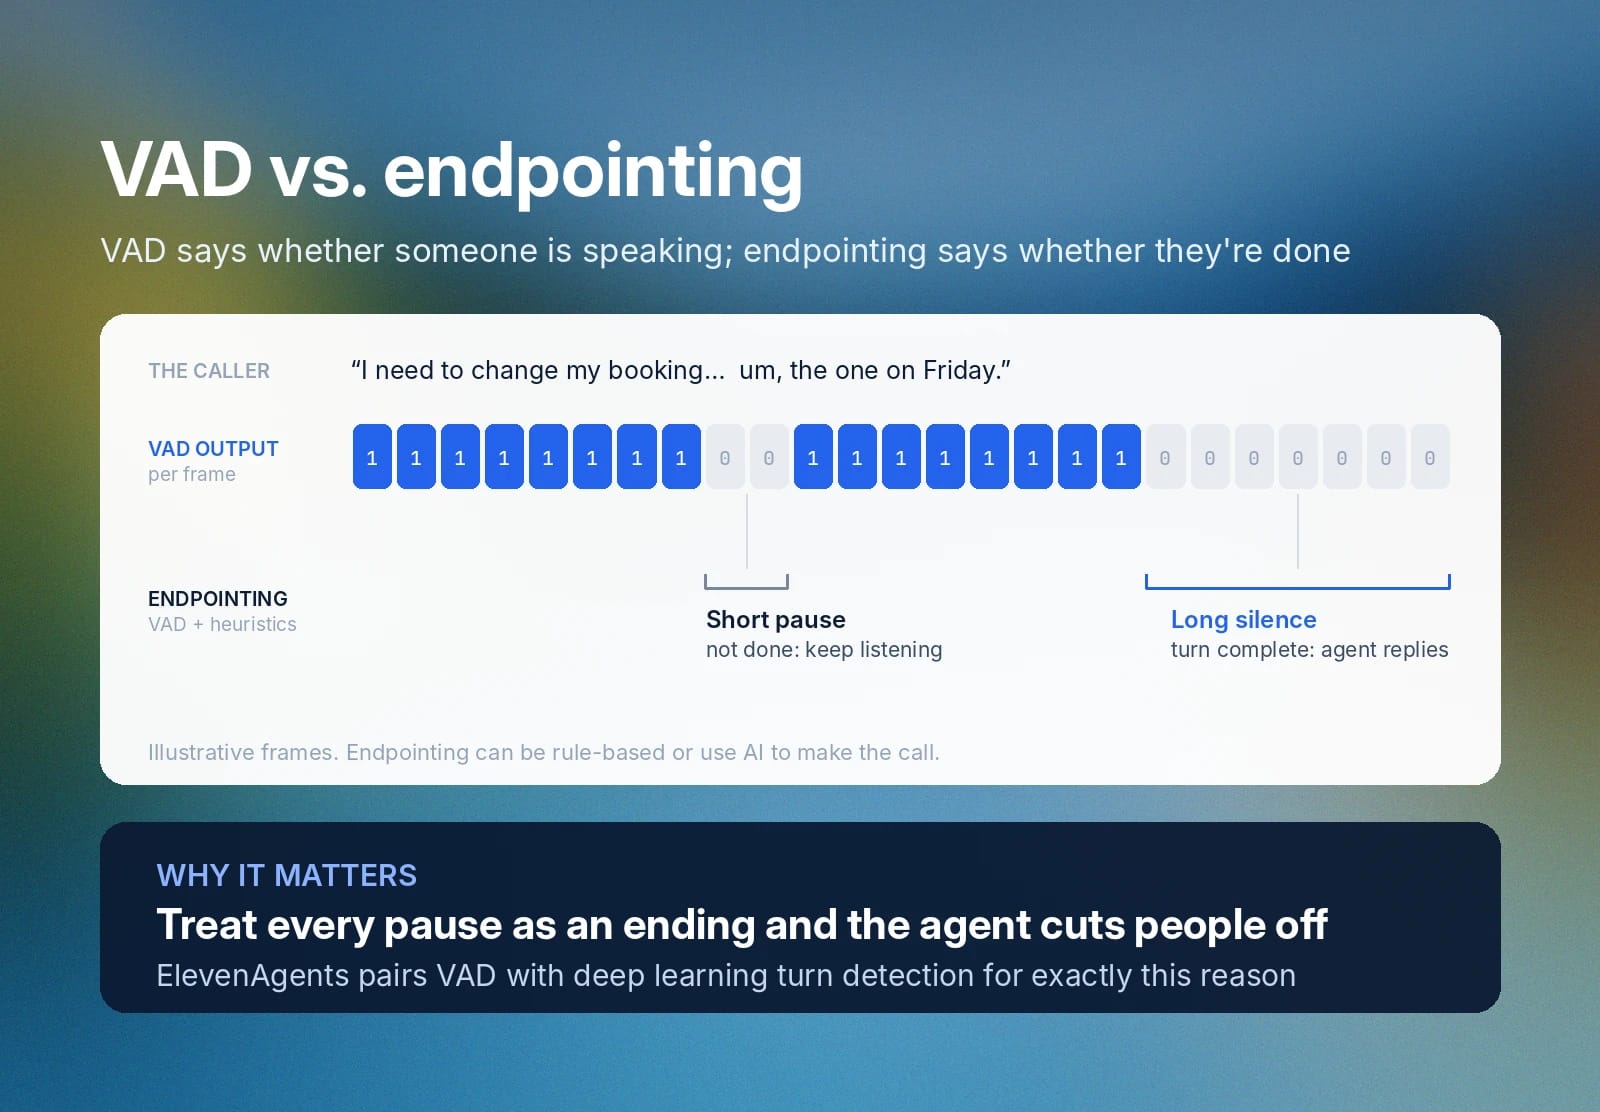
VAD 和端点检测是互补技术。语音活动检测系统只会判断其处理的每个音频帧中是否有人说话,作出二元的“是”或“否”决策,然后传递给其余音频处理管道。
端点检测系统会使用 VAD 输出并结合启发式分析,判断说话者是否表达完想法。它可以用基于规则的信号处理,也可以用 AI 作出这一判断。
实时 AI 中的语音活动检测应用
语音活动检测在许多应用场景中都很重要。
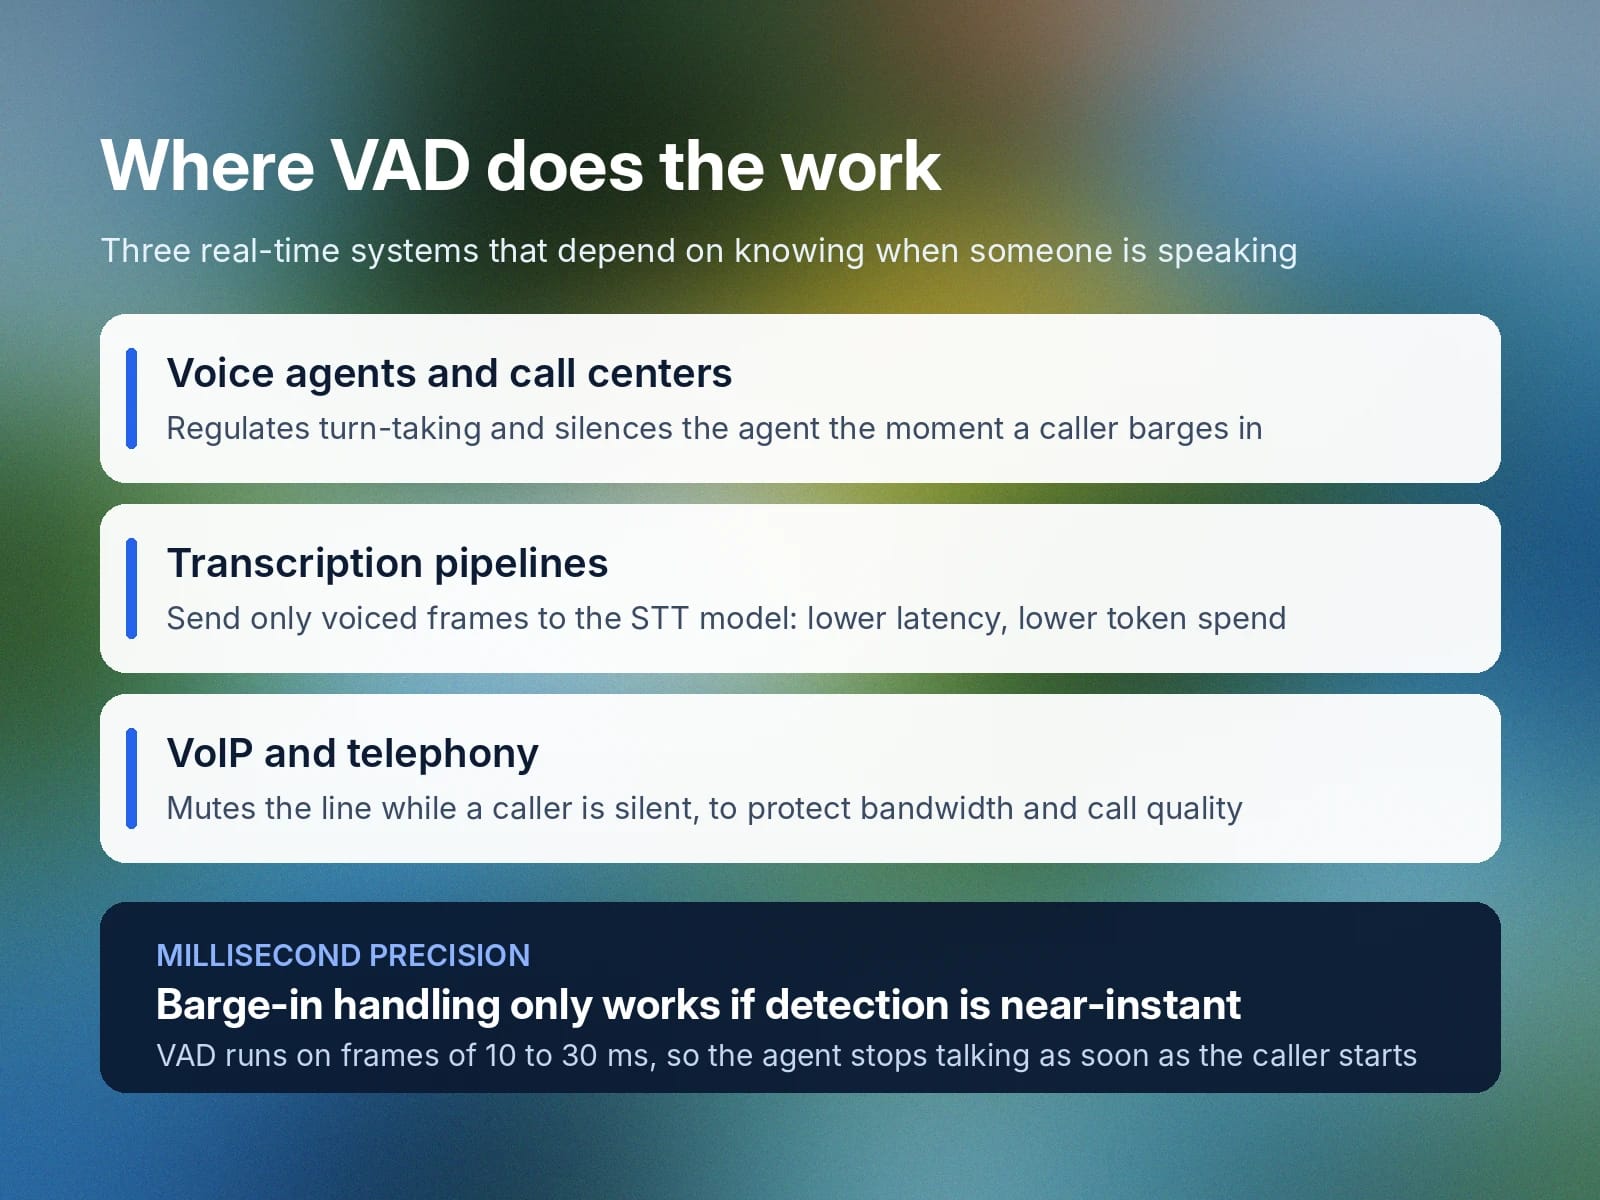
自主语音智能体和呼叫中心
负责筛选客户来电的 自主智能体 需要知道何时适合回应。既不希望智能体在客户说到一半时打断,也不希望客户提前回应时智能体继续压着对方说话。VAD 有助于调节 对话轮次切换,并维持自然的互动 流程。由于可精确到毫秒级,它还能有效处理客户“插话”,在客户打断智能体时让智能体静音。
转录管道
如果使用 语音转文本 转录 API 服务,例如 ElevenAPI,可以通过语音活动检测过滤发送的音频,让模型只处理含语音的帧。这能降低网络延迟,更重要的是减少转录模型的 token 用量,不会把 AI 支出浪费在背景噪声上。
VoIP 和电话通信优化
延迟也会影响企业 VoIP 网络的通话质量。为优化性能,这些数字音频系统会在来电者未说话时通过 VAD 暂时将线路静音。
语音活动检测为何具有挑战性?
传统语音活动检测依赖数学算法来判断是否存在语音。然而,人类语音模式并不规整。对话通常节奏不稳定、断断续续,还会在有背景噪声甚至有旁人交谈的真实环境中进行。VAD 的核心挑战是在嘈杂音频中识别有意义的静音。
这会带来几项具体挑战。
句中停顿
人们不会在整段对话中始终保持稳定节奏。他们会停顿、整理思路、边说边重新斟酌,或突然忘记要说什么。这些停顿都不代表说话者已讲完。人类听众通常很容易理解这一点,但软件甚至较新的 AI 模型可能难以判断。
VAD 系统若将这些停顿误认为话已说完,可能导致交易过程中句子被截断,或使 语音智能体 打断人类说话者。
人声噪声
轻声说话、逐渐减弱的尾音辅音(常见于句末)以及声带摩擦音等特征,都可能导致 VAD 系统漏掉有效语音。
不可预测的声学环境
风扇或流水等持续性背景白噪声,VAD 系统相对容易滤除。狗叫等间歇性噪声则可能被误标记为虚假语音。
高强度音频压缩会损失动态范围,使 VAD 更难区分静音帧和语音帧。
如何评估 VAD 性能
人类语音并不规整,尤其是在动态的真实环境中录制时。无瑕的音频录音并不适合测试 VAD 性能。单纯的语音转文本准确率也无法直接衡量 VAD 系统的效果,因为它位于 VAD 检测结果的下游。
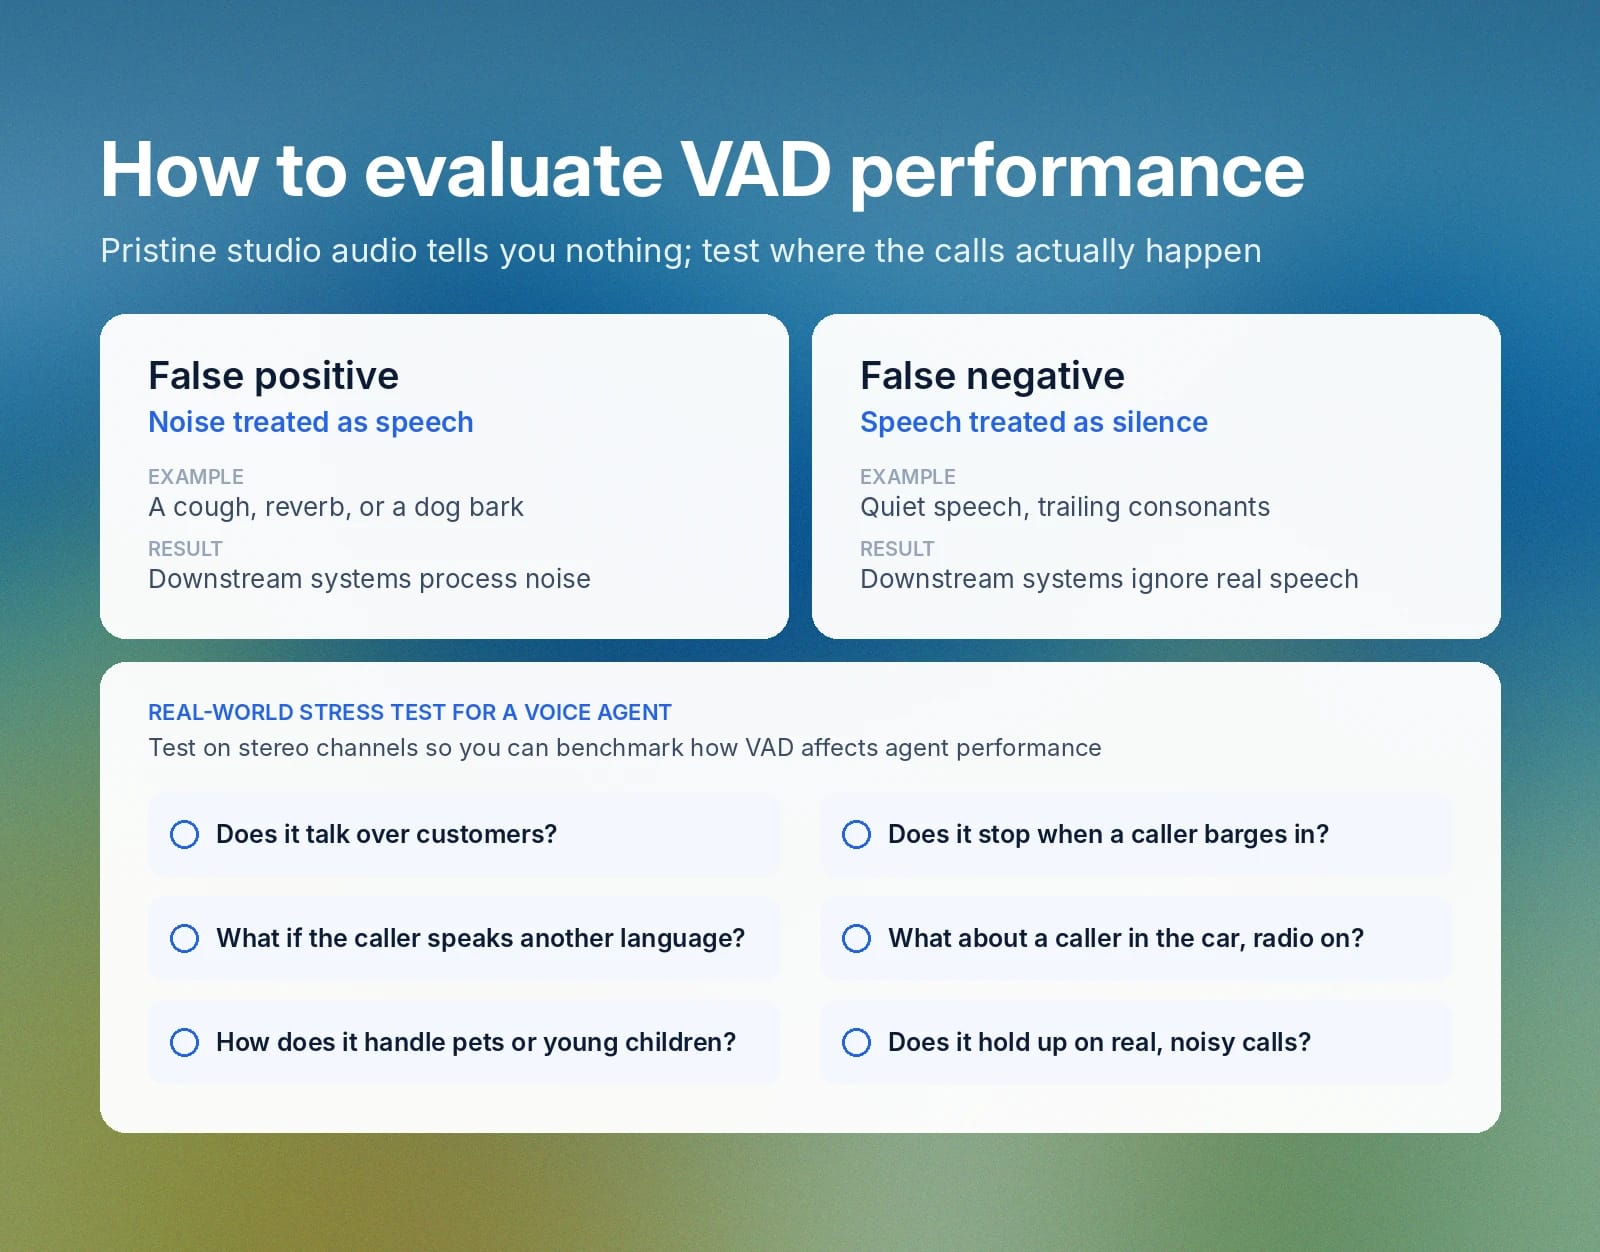
误报与漏报
VAD 误报是指将噪声视为语音。咳嗽声、混响、狗叫和其他突发背景噪声都可能触发误报,并被意外作为语音帧传递。
漏报是指将语音视为静音。VAD 会错误地让下游服务忽略这些音频帧。
真实环境压力测试
要评估 VAD 服务,需要了解它在实际录音环境和真实条件下的表现。
例如,如果要将 VAD 用于语音智能体,可尝试通过立体声声道进行测试,以衡量它对智能体性能的影响。可能需要考虑以下问题:
- 是否存在导致智能体压着客户说话的漏报?
- 用户插话时,它能否阻止智能体继续说话?
- 来电者说 外语 时会怎样?
- 它监听从真实环境来电的说话者时表现如何?
- 客户在车内来电但没有调低收音机音量时会怎样?
- 面对宠物或幼儿造成的背景噪声时,效果如何?
处理客户来电时,所有这些情况都很可能发生。VAD 需要经受压力并保持良好表现。
使用 ElevenAgents 开始构建客服智能体
ElevenAgents 使用混合式 VAD 和深度学习轮次检测系统,让智能体对话流畅自然。
立即使用 ElevenAgents 构建新的客服智能体。注册 即可开始。
常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。



