
交互模型:打造自然的人机对话
- 发布时间
- 最近更新
任何试图在 AI 语音智能体说到一半时打断它的人,都知道当系统并非为人类对话而设计时是什么感觉。节奏不对,声音与内容脱节,即使信息本身正确,互动还是显得别扭:不像在与知识丰富的人交谈,更像是在操作一款恰好会说话的软件。
这种不自然感源于系统架构。许多语音 AI 系统是为处理轮次而设计,而非真实的对话流。它们每次只处理一轮对话:监听、处理并回复。这在简单演示中可行,但当对话变得情绪化且难以预测时,就会失效。
交互模型是专为实时通过音频和文本沟通而设计的 AI 系统。它不仅理解说了什么,还能感知何时说出,以及当下需要怎样的情绪回应。本文将说明交互模型有何不同、它为何对部署语音 AI 的企业很重要,以及 ElevenLabs 如何朝这一方向构建。
摘要
- 大多数语音 AI 在真实对话中会失效,因为它无法处理打断、沉默或跨轮次延续的上下文。
- ElevenLabs 的交互技术栈可处理打断、停顿和重叠语音,不会丢失上下文或破坏对话节奏。
- ElevenLabs 正通过先进的级联架构、自研 语音转文本(STT)和 文本转语音(TTS),以及针对低延迟和自然往复对话优化的技术栈,迈向真正的交互模型。
为什么大多数人机语音沟通并不自然
大多数语音 AI 将对话视为一系列离散的输入和输出:系统等待一段语音,将其转换为文本,处理文本后再回复。这适用于命令与响应式互动,但真实对话并不是整齐的文本交换序列,而是充满停顿和插话的持续往复。
忽略轮次之间的连贯性及跨轮次延续的上下文,会导致以下 3 个具体问题:
- 它会打断你,或让你等待:系统无法区分思考时的停顿和一轮发言结束,因此会在你还没说完时插话,或在你说完后保持沉默。说到一半整理思路时,你会被打断;讲完重点后,又得面对一阵无声等待。
- 它一开口就无法应变:系统一开始回复,就不再聆听。如果你打断它以转换话题,它仍会继续回答你已经不再关心的问题,因为它无法察觉情况已经变化。
- 它会越聊越忘:每一轮都被孤立处理,5 轮之前的上下文无法延续。你最终不得不重复说明,或者系统的回应仿佛对话才刚刚开始。
结果是,对话功能上可能正确,体验上却依然不对劲。
交互模型能做到哪些传统语音 AI 做不到的事
传统语音 AI 一次只能处理一个轮次,而交互模型会同时运行整段对话,关注正在说什么以及接下来需要做什么。功能上的区别在于,交互模型会根据交流的实际状态作出响应。
交互模型具备:
- 实时响应:系统按对话速度响应,端到端循环时间可根据配置缩短至 1 秒以内。
- 自然处理打断、沉默和重叠语音:它能区分思考时的停顿和一轮发言结束,因此不会打断用户或留下冷场。当客户插话改变方向时,它也能处理重叠语音,不会丢失上下文或让对话中断。
- 贯穿整段交流的连续性:系统不会在每一轮重置上下文,而是持续保留对话历史,因此第 10 轮的回应会反映从第一轮起发生的所有内容。
- 自适应表达:可根据执行的任务类型,对声音进行编程调整,例如更平静、更直接或更具安抚感。
- 并行执行任务:系统可同时检索信息、调用工具并持续说话,而不是在查找信息时保持沉默。
检验交互模型的场景,是一通进展不顺的电话。以下录音中,一位客户致电处理航班取消问题。他们情绪紧张,需要尽快解决问题。
智能体能立即从客户用词中识别出紧迫感和挫败感。它会调整语气,在不丢失当前进度的情况下处理打断,并利用连接的工具为取消的航班提供实际解决方案。最终,客户无需人工客服即可解决问题。
与如今常见的轮次式智能体相比,这些系统会等待每一次停顿,以中性的基准语气回答,完全错过客户的挫败情绪。经过几轮无法回应来电者真实感受的交流后,电话很可能需要转交人工处理,客户会比一开始更加沮丧。
ElevenLabs 如何构建交互模型
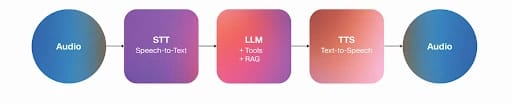
我们的对话管线采用 先进的级联架构,而非融合架构。因此,不是由单个模型处理所有任务,而是每个阶段都由专门组件负责。
这种方法的优势在于,我们可以独立优化管线的每个阶段,为任意组件替换更好的模型,而无需重建整个系统。由于这些组件均由我们自主开发,它们经过协同优化,能够相互传递丰富的上下文。这让管线仍能像一场连贯的对话一样运行,而非一串彼此独立的工具。
级联模型结构
融合模型结构
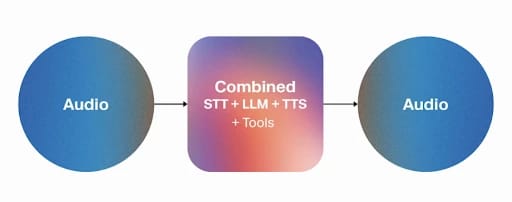
图片:级联模型与融合模型
当前构成该管线的技术包括:
- Scribe v2 Realtime:我们的 自研 STT 模型可在 90 多种语言中以约 150 ms 的延迟转录语音,并能应对背景噪音、口音、打断,以及笑声和停顿等非语言事件。它还可处理领域专用词汇,从医学术语到金融行话。
- 预测式轮次管理:该系统通过理解对话节奏,决定何时说话、停顿或等待,而不是依赖固定的静音阈值。我们对 语音活动检测模型的改进,使其能更好地过滤背景语音和简短回应,让轮次交接更自然。
- Eleven v3 Conversational:这是我们最具表现力的 TTS 模型之一,专为实时双向对话打造。它能在多个轮次间延续对话的情绪基调,因此智能体在第 10 轮的表达会反映此前发生的一切。
- Expressive Mode:基于 Eleven v3 Conversational 和轮次管理系统构建,Expressive Mode控制智能体当下的表达方式。客户感到沮丧时,它会缓和情绪;客户感到困惑时,它会给予安抚;需要清晰表达时,它会更直接。它还会读取表现标签,因此模型可根据 [laughs]、[whispers] 或 [sighs] 等提示塑造特定时刻的表达。
- Flash v2.5:我们的低延迟 TTS 模型支持 32 种语言,并可在 75 ms 内生成语音。当低延迟是首要目标时,它可将响应时间保持在人类自然对话节奏的范围内。
- Speech Engine:连接整个技术栈的中间层,通过 WebSocket 将服务器连接至我们的 ElevenAPI,每段对话对应一个连接。我们处理 STT 和 TTS,而服务器运行 LLM,因此技术团队可使用自己的模型,并将对话逻辑保留在自己的基础设施中。
这些模型持续改进,并定期发布新版本。每次发布都会通过更快的响应、更敏锐的情绪识别、更多语言和更流畅的表达,缩小与软件交谈和与人交谈之间的差距。
边思考边说话
交互模型并非每个部分都必须严格按顺序运行。ElevenAgents 可在对话继续时于后台持续工作,而不是在提问和回答之间默认保持沉默。
多个核心系统协同工作,实现同时说话与思考:
- 并行工具调用:智能体可以查询数据库、运行工具,或在仍在说话时查看订单状态,因此检索不会让对话出现停滞。
- 软超时:如果 LLM 生成回应的时间超出预期,智能体会说出“让我想想”或“嗯……”等简短填充语,而不是留下尴尬的沉默。软超时有助于保持自然的对话节奏,并减少被打断的可能性。
- 打断忽略词:系统不再使用固定的静音阈值,而是尝试理解所说内容的含义,以判断一轮发言是否真正结束。同样,“好的”或“嗯哼”等简短确认语可配置为直接通过,而不会触发完整打断,这意味着来电者每次插话时,智能体都不会丢失当前进度。
这些系统共同避免智能体给人正在缓冲或加载回应的感觉。它们构成精简的对话引擎,像人一样自然填补间隙,同时在后台处理信息和整理思路。
使用 ElevenLabs 时,对话实际如何运作
上述组件并非按整齐的直线依次运行,而是相互重叠。以下是 ElevenLabs 智能体如何在客服通话中处理来电者中途提出的“我的订单已经发货了吗,还是仍在处理中?”
- 来电者说话:音频通过 WebSocket 连接流式传输至 ElevenLabs,Scribe 开始实时转录,延迟约为语音后的 150 ms。
- 系统理解对话节奏:Scribe 仍在转录时,预测式轮次管理已在判断来电者是否说完,还是仍在思考中。句尾的“还是仍在处理中?”被识别为交接而非停顿,因此会触发下一步,而不是等待沉默。
- LLM 整合上下文并回应:转录的问题会连同对话历史、通过企业自有系统的 RAG、通话早些时候的工具输出以及系统提示词。它会综合分析这些信息,并生成基于来电者订单的回复。
- TTS 模型合成回应:文本会转化为自然的音频。如果 Expressive Mode 已启用,回应会带有符合当下情境的表达提示,使例行更新听起来轻松从容,而不是平淡生硬。低延迟优先时,Flash 可在 75 ms 内完成合成。
- 回复流式返回:合成尚未完成时,音频就已开始播放,因此来电者会在其余内容仍在生成时听到回答的开头。
- 循环重复:每一轮新对话都会延续此前的语气、上下文和历史。
在这个快速过程中,对话感觉很自然。来电者不再需要适应机器:无需放慢语速、过度咬字清晰,或等待提示音。他们只需像与人交谈一样自然说话。
在整个企业部署自然语音智能体
这里介绍的所有功能如今都已投入生产环境。从级联架构到亚秒级管线,全球各地的企业 已在使用 ElevenAgents大规模处理真实客户对话。
这也涵盖受监管、高风险的环境,因为我们的智能体架构支持护栏、审计日志和合规控制。ElevenLabs 已通过 SOC 2 Type II、ISO 27001、HIPAA 和 PCI DSS Level 1 认证,并提供 Zero Retention Mode 和区域数据驻留,满足需要将数据保留在特定边界内的团队需求。
准备好让智能体开始工作了吗?你可以创建智能体并在控制台中开始构建,或联系销售团队,了解适合你所在环境的部署方案。
交互模型常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。


