
什么是 RAG?检索增强生成如何工作
- 发布时间
- 最近更新
AI 模型根据训练中学到的内容生成答案,因此并不会自动了解训练完成后出现的公司政策、产品或其他信息。RAG(检索增强生成)通过在模型回答前检索相关外部信息并提供给模型,解决了这一问题。
RAG 让 AI 的回答以企业实际文档为依据。使用客户支持智能体的 RAG 可以在回答前调取现行退货政策或产品规格,从而降低幻觉风险。
本指南将介绍 RAG 在 AI 中的含义、检索与生成如何协同工作,以及 RAG 与单独使用 LLM 有何不同。还会讲解 RAG 的局限性、它在生成式 AI 应用中的适用场景,以及 RAG 如何支持AI 智能体中的知识检索。
摘要
- RAG 将检索系统与生成模型结合,让模型能够使用训练数据之外的信息。
- RAG 检索的知识存储在模型外部,因此无需重新训练即可更新。
- 当知识库过大、无法直接放入模型上下文时,ElevenAgents 会自动使用 RAG,让大型复杂知识库的回答既快速又准确。
AI 中的 RAG 是什么?
RAG 是围绕 LLM 构建的系统架构,可为其提供品牌指南、产品手册、知识库文章或内部数据库等外部信息。这让 AI 能够处理业务专属信息,使回答反映最新政策、私有知识及模型从未训练过的公司信息。
LLM 一次也只能处理有限的信息量,称为上下文窗口。大型组织知识库很容易超出这一限制,因此 RAG 将信息保留在 LLM 外部,只检索当前问题所需的段落。
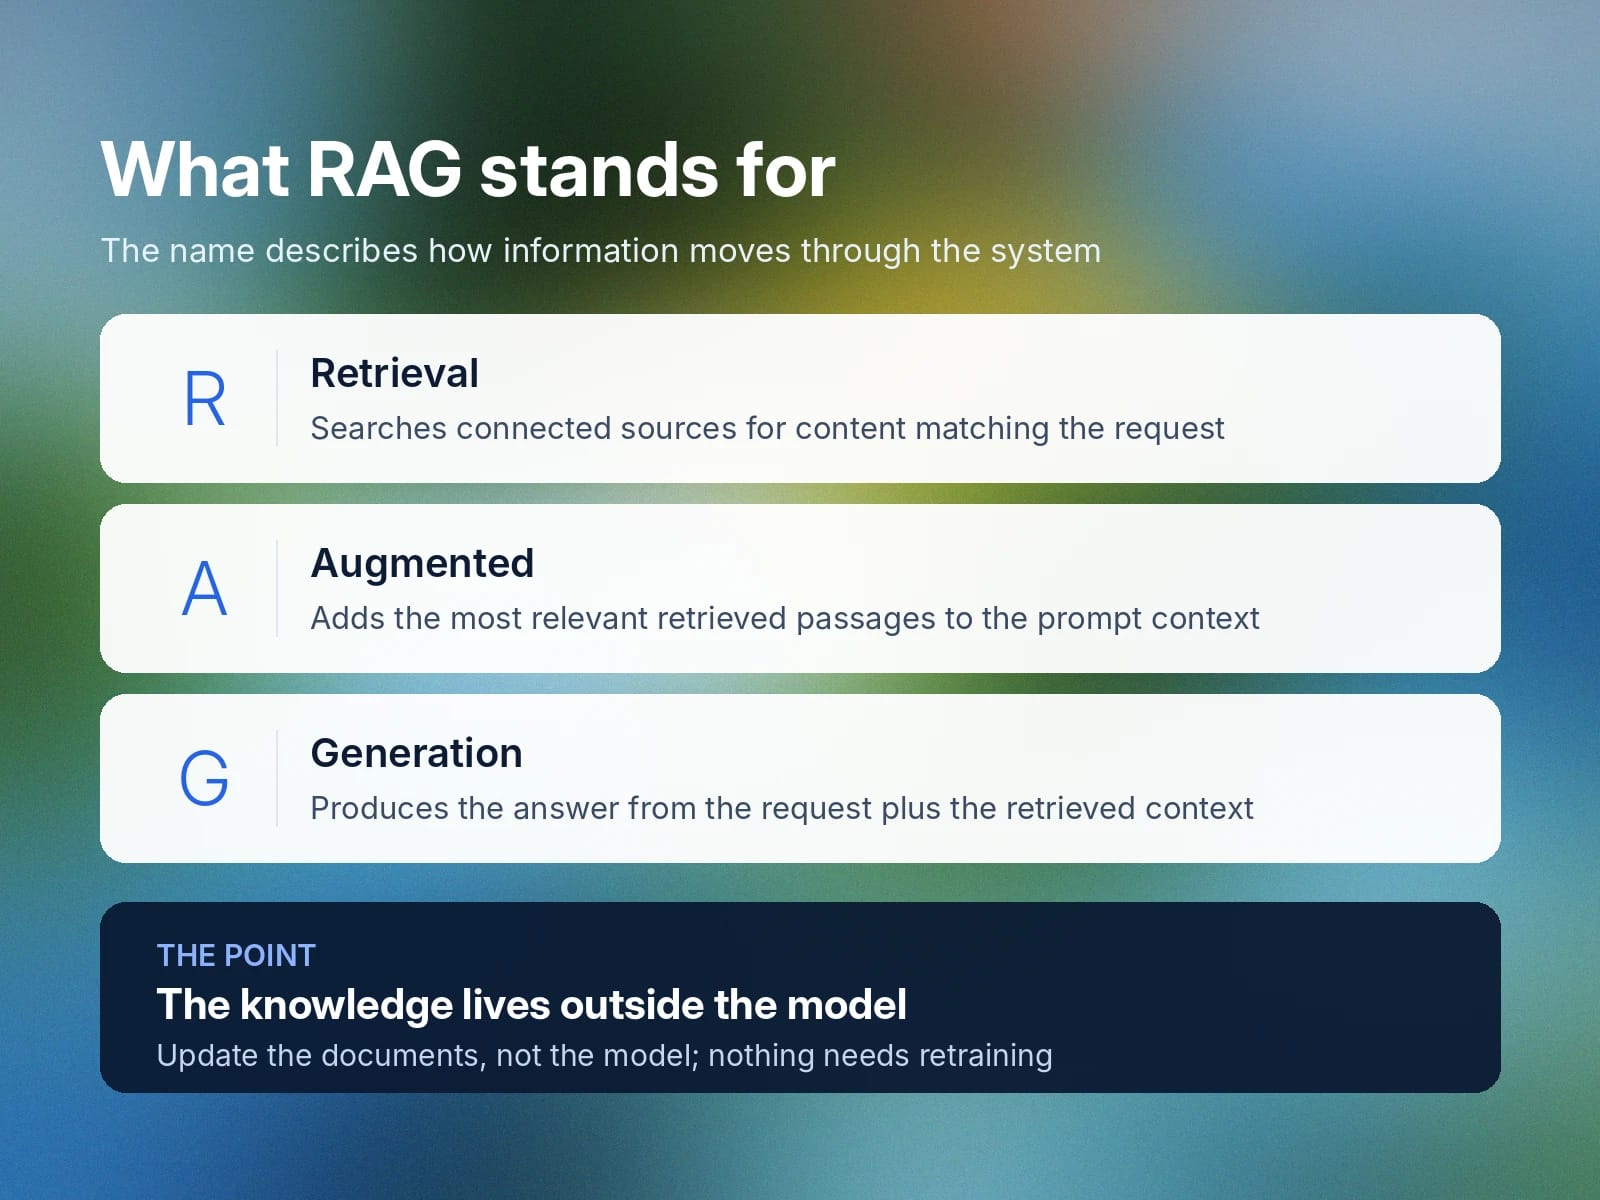
这一名称描述了信息在系统中的流转方式:
- 检索:在已连接的来源中搜索与用户请求匹配的内容,例如政策文档、服务台日志或库存文件。
- 增强:将检索到的最相关段落添加到提示词上下文中。
- 生成:利用用户请求和检索到的上下文生成答案。
RAG 还支持“依据源信息生成”,即通过向 LLM 提供生成答案所需的相关材料,将 AI 回答与特定来源信息关联起来。例如,客户询问保修政策时,RAG 系统会从公司文档中检索相关条款,并交给 LLM 据此作答。
检索增强生成如何工作?
RAG 系统先将外部知识准备为可搜索的形式,检索与用户问题最相关的信息,再在生成回复前将这些信息作为上下文提供给 LLM。
RAG 的实现复杂度各不相同。基础 RAG 使用直接的检索与生成流程,更高级的方法则可能加入查询改写、筛选、重排序或其他检索技术。
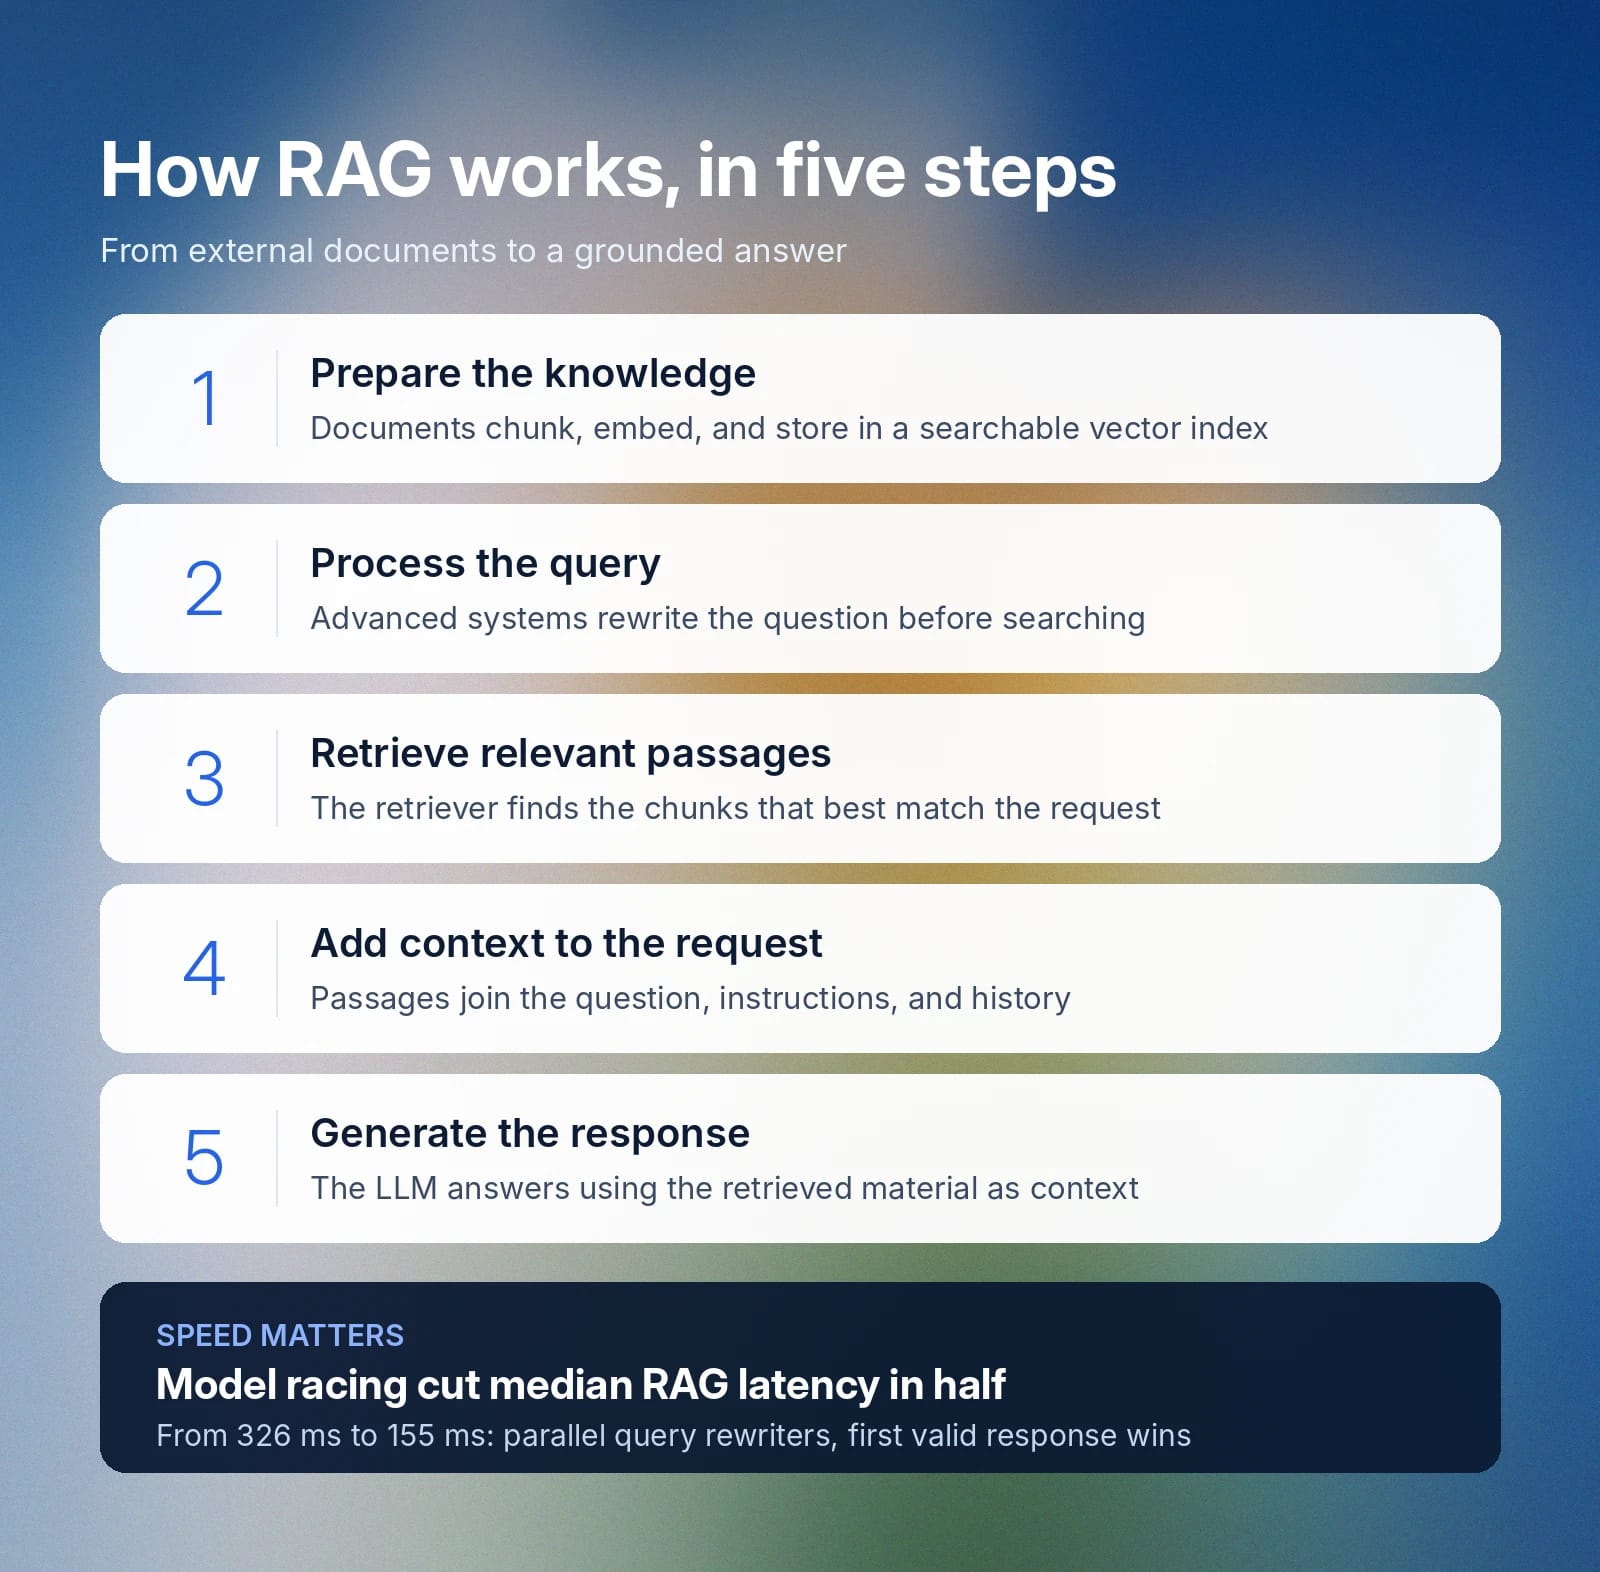
RAG 流程通常包含 5 个步骤:
- 准备知识:将文档拆分为较小段落(称为“分块”),转换为称作嵌入的数学表示,并存储在可搜索索引或向量数据库中。
- 处理查询:系统解读用户问题;在更高级的 RAG 系统中,会在搜索前改写或优化问题。
- 检索相关段落:检索器在已索引的知识库中搜索最符合请求的文本块。
- 将上下文添加到模型请求:将选定段落连同用户问题、相关指令和对话历史一起发送给 LLM。
- 生成回复:LLM 将检索到的材料作为上下文的一部分,用于生成答案。
许多 RAG 系统会选择性地将检索作为外部工具触发。ElevenAgents 支持团队直接在智能体设置中为知识库启用 RAG,并通过查询改写,在对话追问时将此前对话和模糊指代转化为精确、完整的搜索查询。
为确保及时响应,ElevenLabs 还开发了模型竞速架构,可将每个查询并行发送给多个改写模型,并采用首个有效回复。该方法将 RAG 延迟中位数降低了一半,从 326 ms 降至 155 ms。即使大型知识库触发检索,也能保持足够快的速度,维持自然的对话节奏。
LLM 与 RAG 模型有什么区别?
LLM 是理解和生成语言的模型。RAG 是围绕 LLM 构建的架构,在应用需要时检索外部信息。
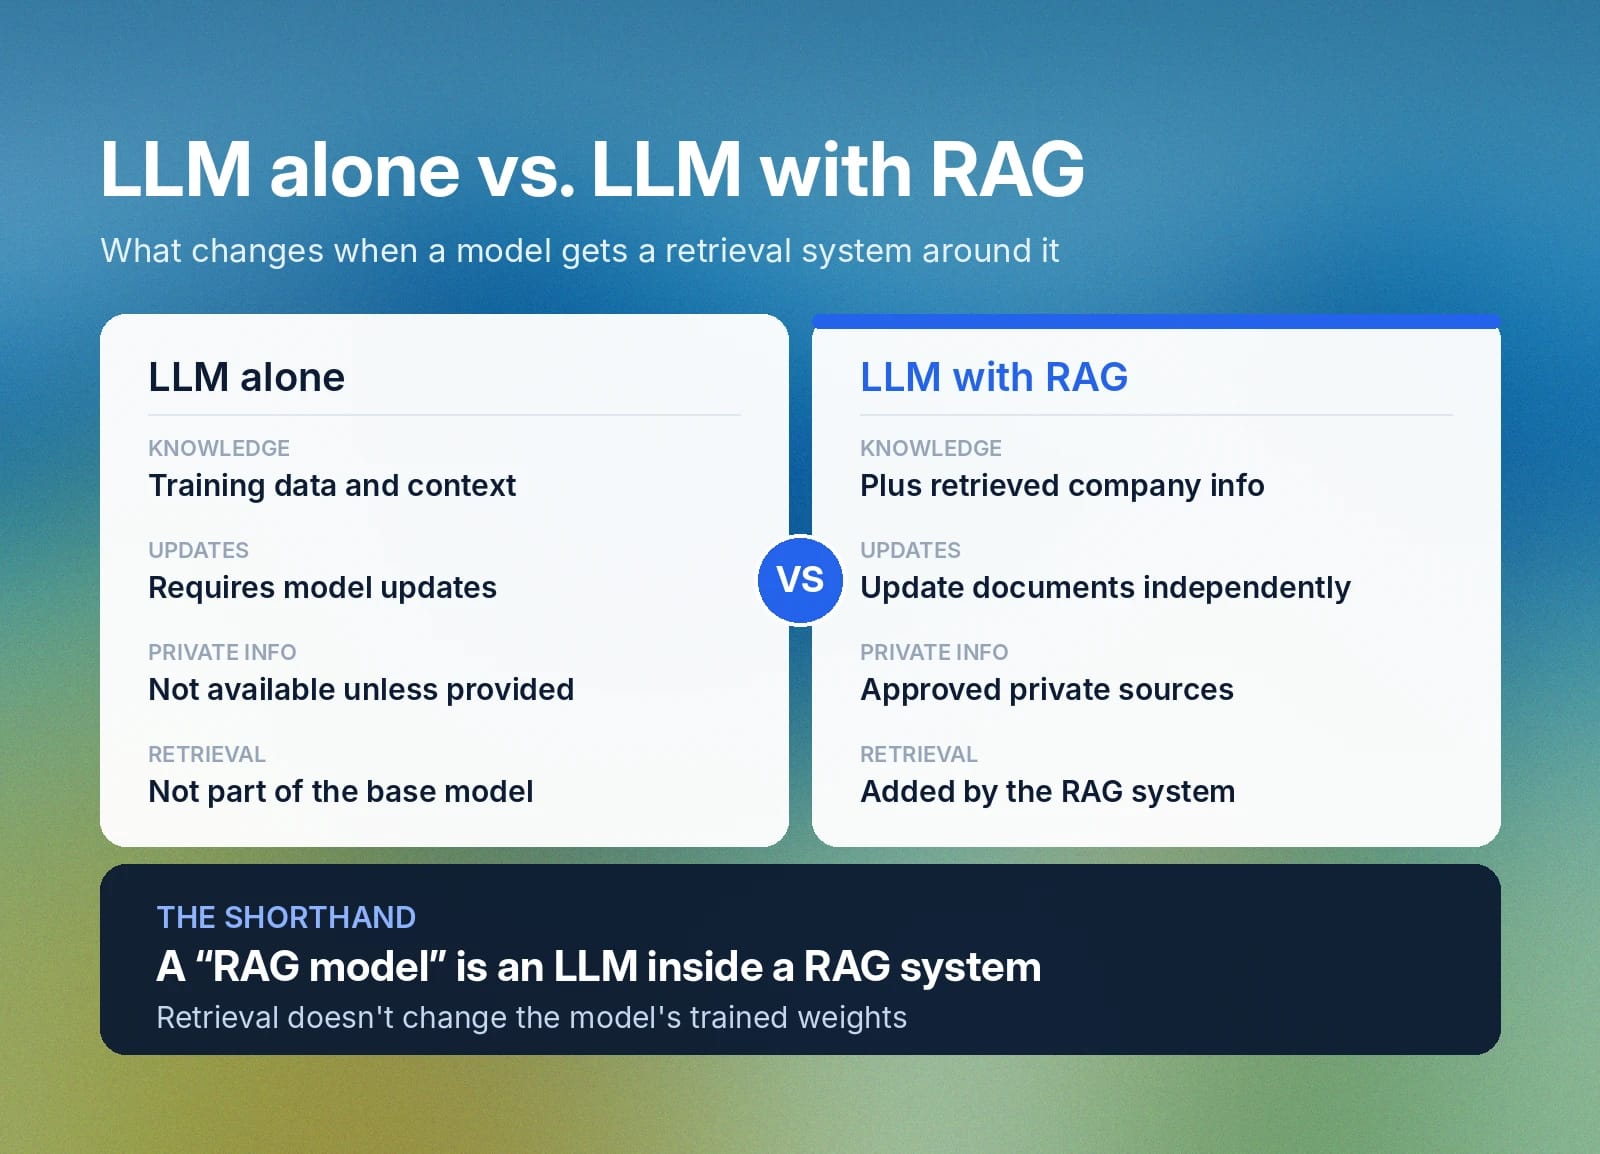
LLM 与 RAG 配合使用后,会有以下变化:
特性 | 单独使用 LLM | 结合 RAG 的 LLM |
知识 | 训练数据和当前上下文 | 训练数据、当前上下文,以及检索到的公司信息,如政策、产品文档或知识库内容 |
更新 | 新信息必须通过上下文或模型更新提供 | 外部知识可独立于模型更新 |
私有信息 | 除非提供,否则不可用 | 可从获准的私有来源检索 |
检索 | 并非基础模型的一部分 | 由外围 RAG 系统添加 |
“RAG 模型”有时用作 RAG 系统中 LLM 的简称。例如,公司可能会说自己将“RAG 模型”用于客户支持,但实际配置是由 LLM 在生成答案前检索相关帮助中心或政策内容。
RAG 模型在实际应用中的局限性
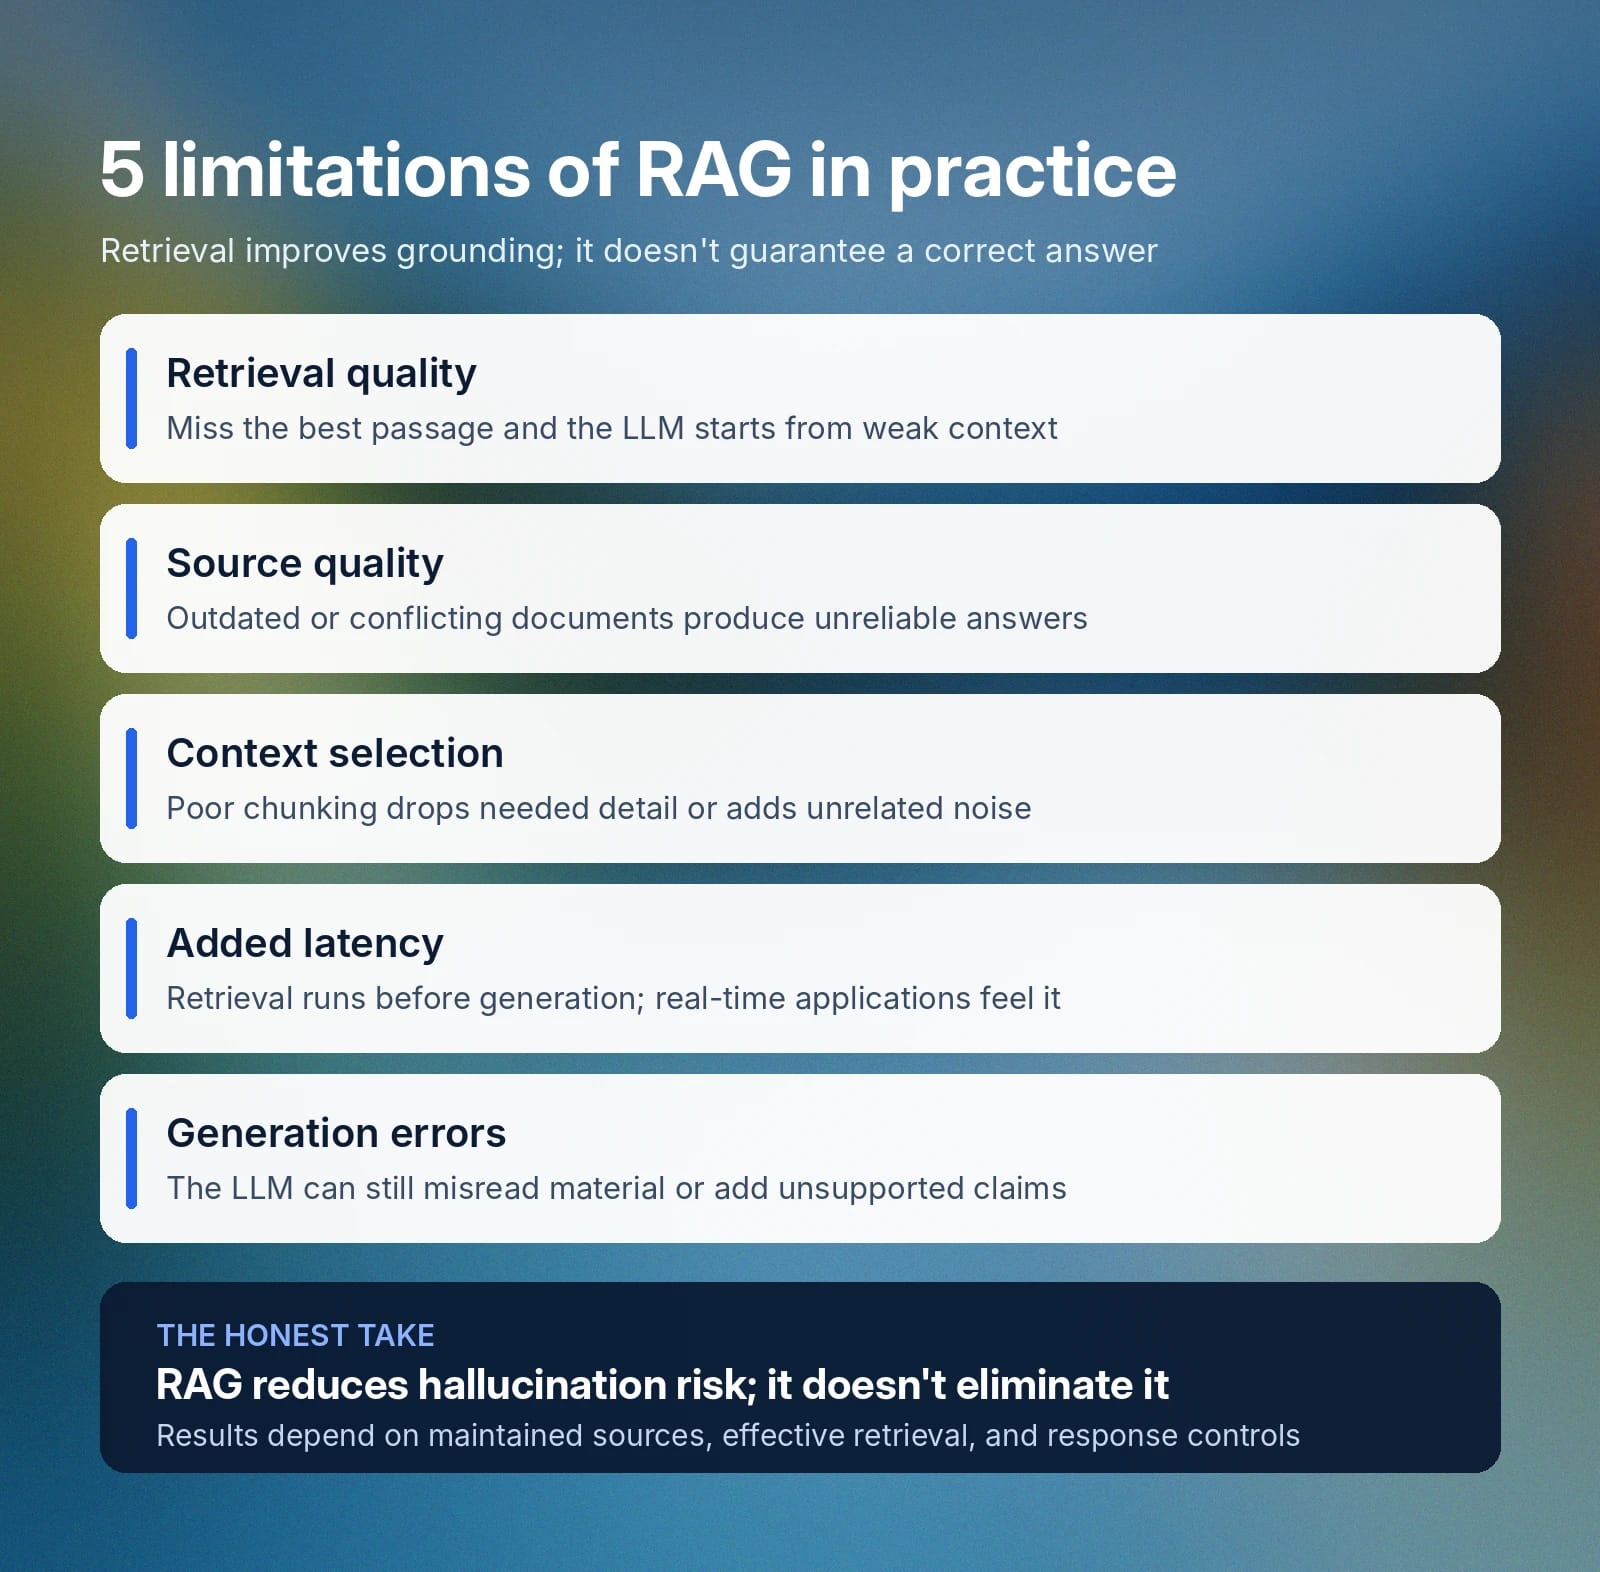
RAG 改善了对存储在 LLM 外部的相关业务知识的访问,但检索本身也有局限,且不能保证答案正确。主要局限体现在系统检索到什么、发送给模型什么,以及模型如何响应:
- 检索质量:如果系统遗漏最相关的段落,LLM 起始时获得的上下文就不完整或质量较低。措辞不佳的查询、较弱的语义匹配或含糊表述,都可能使检索偏离方向。
- 来源质量:过时、相互矛盾或不完整的文档可能导致答案不可靠。
- 上下文选择:不当的分块或检索选择可能遗漏必要细节,或引入无关信息。
- 额外延迟:检索和查询处理发生在生成之前,可能拖慢实时应用的响应速度。
- 生成错误:LLM 仍可能误解检索到的信息,或提出缺乏依据的说法。
RAG 能降低幻觉风险,但无法完全消除。准确结果仍取决于维护良好的来源、有效检索,以及对最终回复的控制措施。
生成式 AI 中的 RAG:实际用例与优势
当 AI 应用需要经常更新、属于组织内部,或无法在每次模型请求中全部纳入的信息时,RAG 最为实用。
以下是 RAG 最能发挥作用的场景:
跟进频繁更新的信息
RAG 可帮助团队让 AI 回复与最新产品详情、价格、政策和库存保持一致。团队可独立更新源信息,RAG 会在收到问题时检索相关版本。例如,潜在客户资格评估智能体可在评估来电客户时调取最新价格或套餐详情。
使用私有或专业知识
有些知识并非公开信息,而是私有或专业内容,例如内部政策、技术文档,或面向特定团队的支持内容。RAG 让智能体直接从这些来源检索,而非仅依赖公开信息或模型内置知识。
例如,内部 IT 或 HR 服务台智能体可以从 HR 专属知识库中检索信息来回答员工福利问题,而无需搜索不包含此类信息的公开文档。
搜索大型知识库
当公司的文档量远超 LLM 一次请求能处理的范围时,RAG 很有帮助。它只检索与当前问题相关的段落,而不是将整个集合发送给模型。在销售场景中,技术助手可在通话期间搜索产品手册,查找相关要求。
使用 ElevenAgents 开始构建高级 RAG 解决方案
ElevenAgents 可帮助团队构建 AI 语音和聊天智能体,通过无代码网页平台使用连接的知识源与 RAG,也可通过 API 将智能体直接嵌入自有产品。
对于启用 RAG 的智能体,团队可向知识库添加文档、URL 或文本,并只检索与每项查询相关的信息。
ElevenLabs 还针对实时对话优化了检索,在 ElevenAgents 架构中将 RAG 延迟中位数从 326 ms 降至 155 ms。无论通过控制台配置智能体,还是通过 API 在其基础上构建,使用 ElevenAgents 的团队都可开箱即用这些检索能力。
开始构建 ElevenAgents,或联系我们的团队,讨论适合应用的配置方案。


