我们如何让 RAG 提速 50%
- 发布时间
- 最近更新
RAG 通过让 LLM 响应基于大型知识库,提高智能体的准确性。RAG 不会将整个知识库发送给 LLM,而是嵌入查询、检索最相关的信息,并将其作为上下文传给模型。我们的系统会先进行查询改写,在检索前将对话历史整合为精确、独立的查询。
对于很小的知识库,直接将所有内容放入提示词可能更简单。但随着知识库扩大,RAG 对于在不让模型负担过重的同时保持响应准确,变得至关重要。
许多系统将 RAG 视为外部工具,但我们将它直接集成到请求流程中,让它处理每次查询。这能确保准确性一致,但也带来了延迟风险。
查询改写为何拖慢速度
大多数用户请求都会引用之前的对话内容,因此系统需要将对话历史整合为精确、独立的查询。
例如:
- 如果用户问: “能否根据流量高峰规律,自定义这些限制?”
- 系统会将其改写为: “企业版套餐的 API 速率限制能否针对特定流量规律进行自定义?”
改写会将“这些限制”这类模糊指代转为检索系统可用的独立查询,从而改善上下文并提高最终响应的准确性。但依赖单个外部托管的 LLM,意味着其速度和可用性会成为硬性依赖。仅这一步就占了 RAG 延迟的 80% 以上。
如何通过模型竞速解决问题
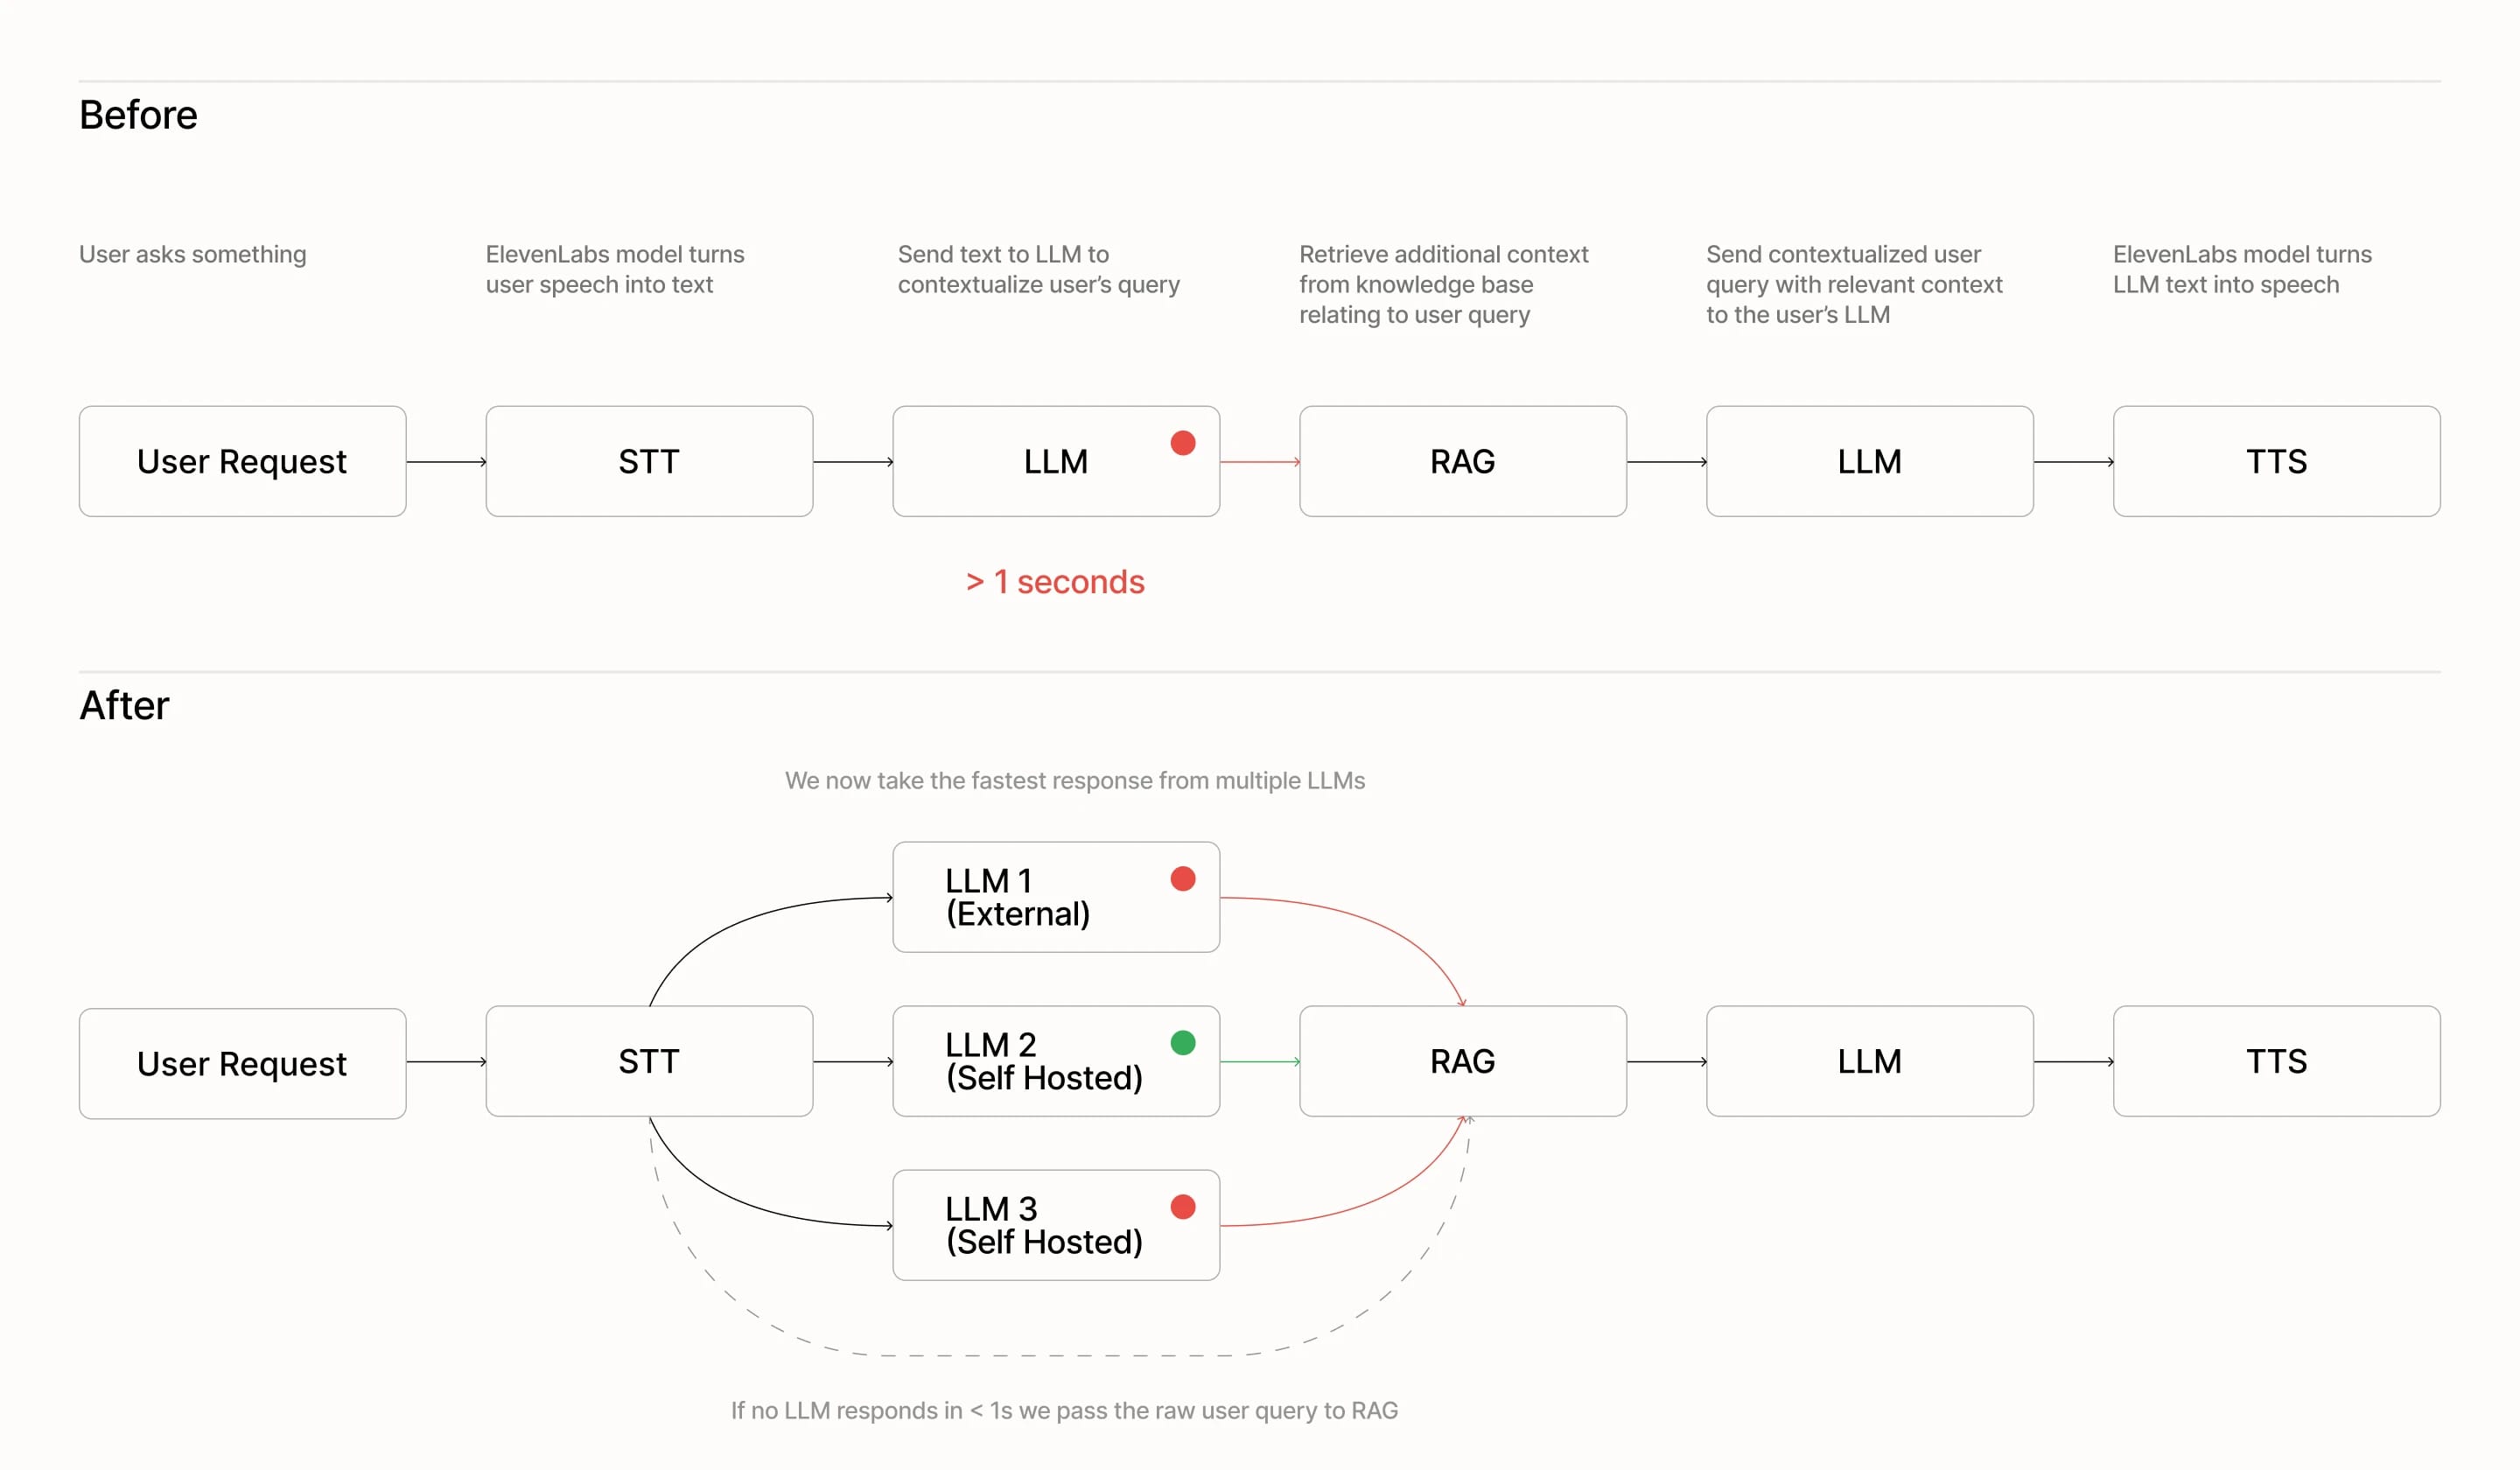
我们将查询改写重新设计为竞速模式:
- 多模型并行。每个查询会同时发送给多个模型,包括我们自托管的 Qwen 3-4B 和 3-30B-A3B 模型。最先返回有效响应的模型胜出。
- 保障对话流畅的回退机制。如果 1 秒内没有模型响应,就回退到用户的原始消息。虽然精确度可能较低,但可避免卡顿,确保对话持续进行。
对性能的影响
这一新架构将 RAG 延迟中位数减半,从 326ms 降至 155ms。与许多仅选择性地将 RAG 作为外部工具触发的系统不同,我们会对每次查询运行 RAG。延迟中位数降至 155ms 后,额外开销已微乎其微。
延迟前后对比:
- 中位数:326ms → 155ms
- p75:436ms → 250ms
- p95:629ms → 426ms
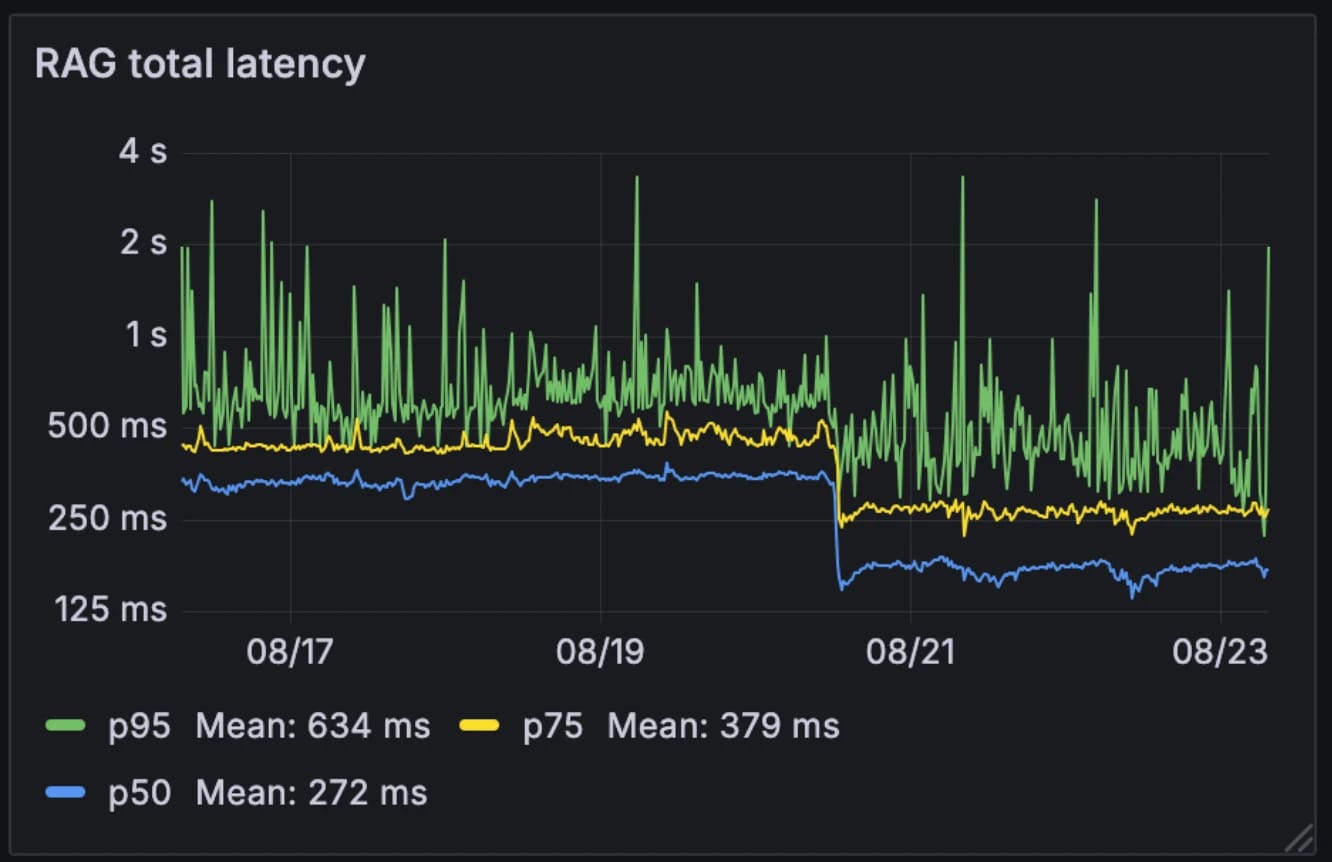
该架构也让系统更能应对模型性能波动。外部托管模型在需求高峰时可能变慢,而我们的内部模型相对稳定。通过让模型竞速,可平滑这种波动,将难以预测的单个模型表现转化为更稳定的系统行为。
例如,上个月一家 LLM 提供商发生故障时,对话仍可通过自托管模型无缝继续。我们已为其他服务运行这套基础设施,因此额外计算成本微乎其微。
为何重要
低于 200ms 的 RAG 查询改写消除了对话式智能体的一大瓶颈。即使处理大型企业知识库,系统仍能兼顾上下文感知与实时性。检索开销降至几乎可忽略的水平后,对话式智能体可以在不影响性能的前提下扩展。