通过更智能的工作流程解决文本转语音准确率问题
- 发布时间
- 最近更新
语音转文字(STT)准确率取决于三点:音频质量、人们的说话方式和所用词汇。噪声和重度压缩会损失录音细节,即使是强大的模型也难以处理重叠说话声或陌生术语。本指南将说明各类 STT 问题的成因及解决方法。
转录错误很少只停留在文本中。临床记录中听错的药物名称或通话日志中错误的账号,会进入所有使用这些文本的系统,包括搜索、分析和根据对话内容执行操作的 AI 智能体。准确率低还会增加审核时间,因为需要人工查找并修正错误。
好消息是,大多数 STT 准确率问题都能解决。其中许多方法只需微调现有配置或录音设置,无需更改模型设置。
这个主题也可能被称为语音识别准确率、ASR 准确率或转录准确率。语音转文字、语音识别和自动语音识别(ASR)都指将口语音频转化为书面文本的同一过程。无论使用哪个术语,本指南中的方法都适用。
摘要
- 语音转文字准确率取决于音频输入质量、说话者特征,以及词汇和上下文问题。
- 要解决准确率问题,请找出可在流程的哪个环节(输入、处理或输出)进行调整。
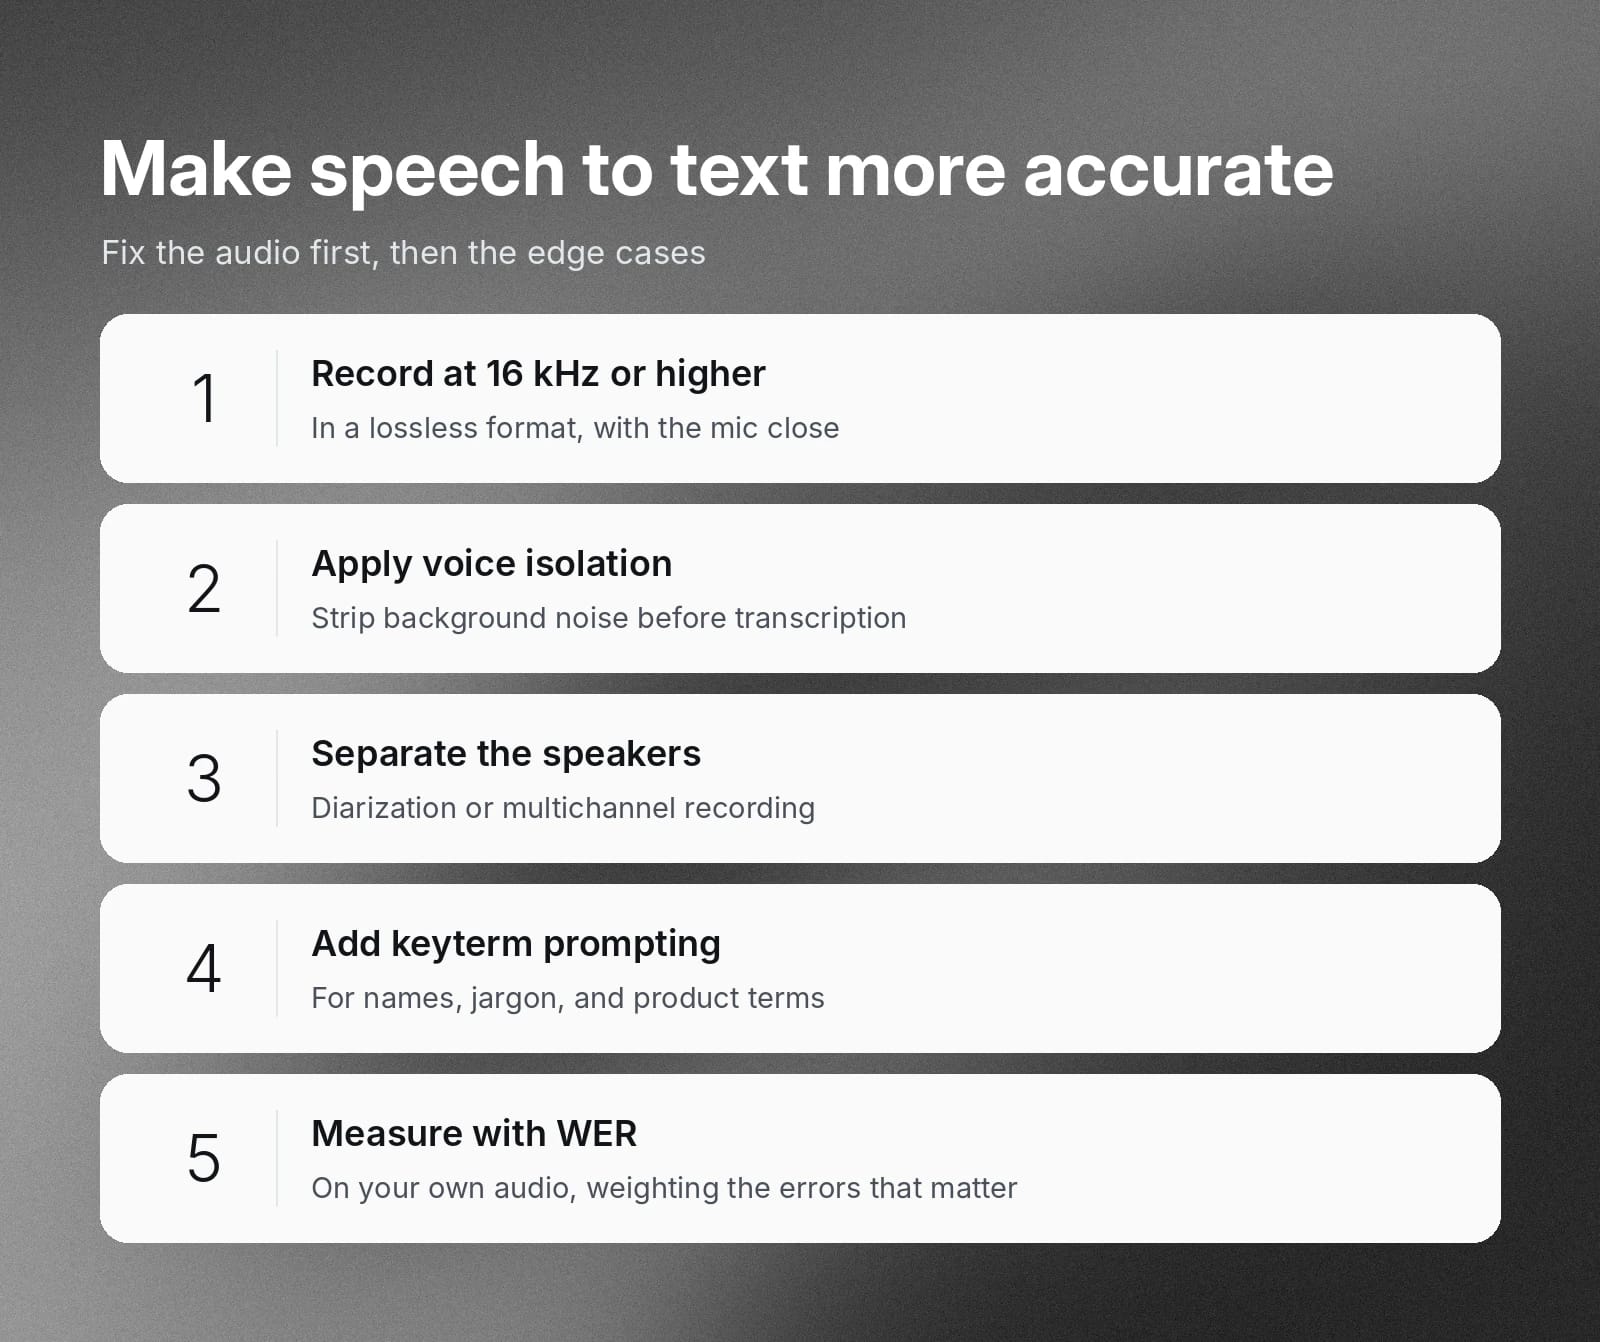
- 以 16 kHz 或更高采样率录音,使用无损格式,并将麦克风放在距离说话者 4 到 6 英寸处。
- 使用人声分离、说话人分离或多声道录音,以及关键术语提示,应对噪声、说话声重叠和专业词汇。
- 使用词错误率(WER)衡量准确率,并检查哪些错误对你的使用场景影响最大。
语音转文字准确率问题由什么引起?
设想有人请你转录一段音频:一位口音浓重的教授在拥挤餐厅里讲解复杂理论物理,背景还有音乐和嘈杂人声。数字计算机系统并不天生适应声音的多变性。要让STT 高效运行,需要大量训练和微调。尽管现代 AI 工具十分有效,许多问题仍会影响输出。了解这些问题后,就能在转录 workflow 中加以解决。
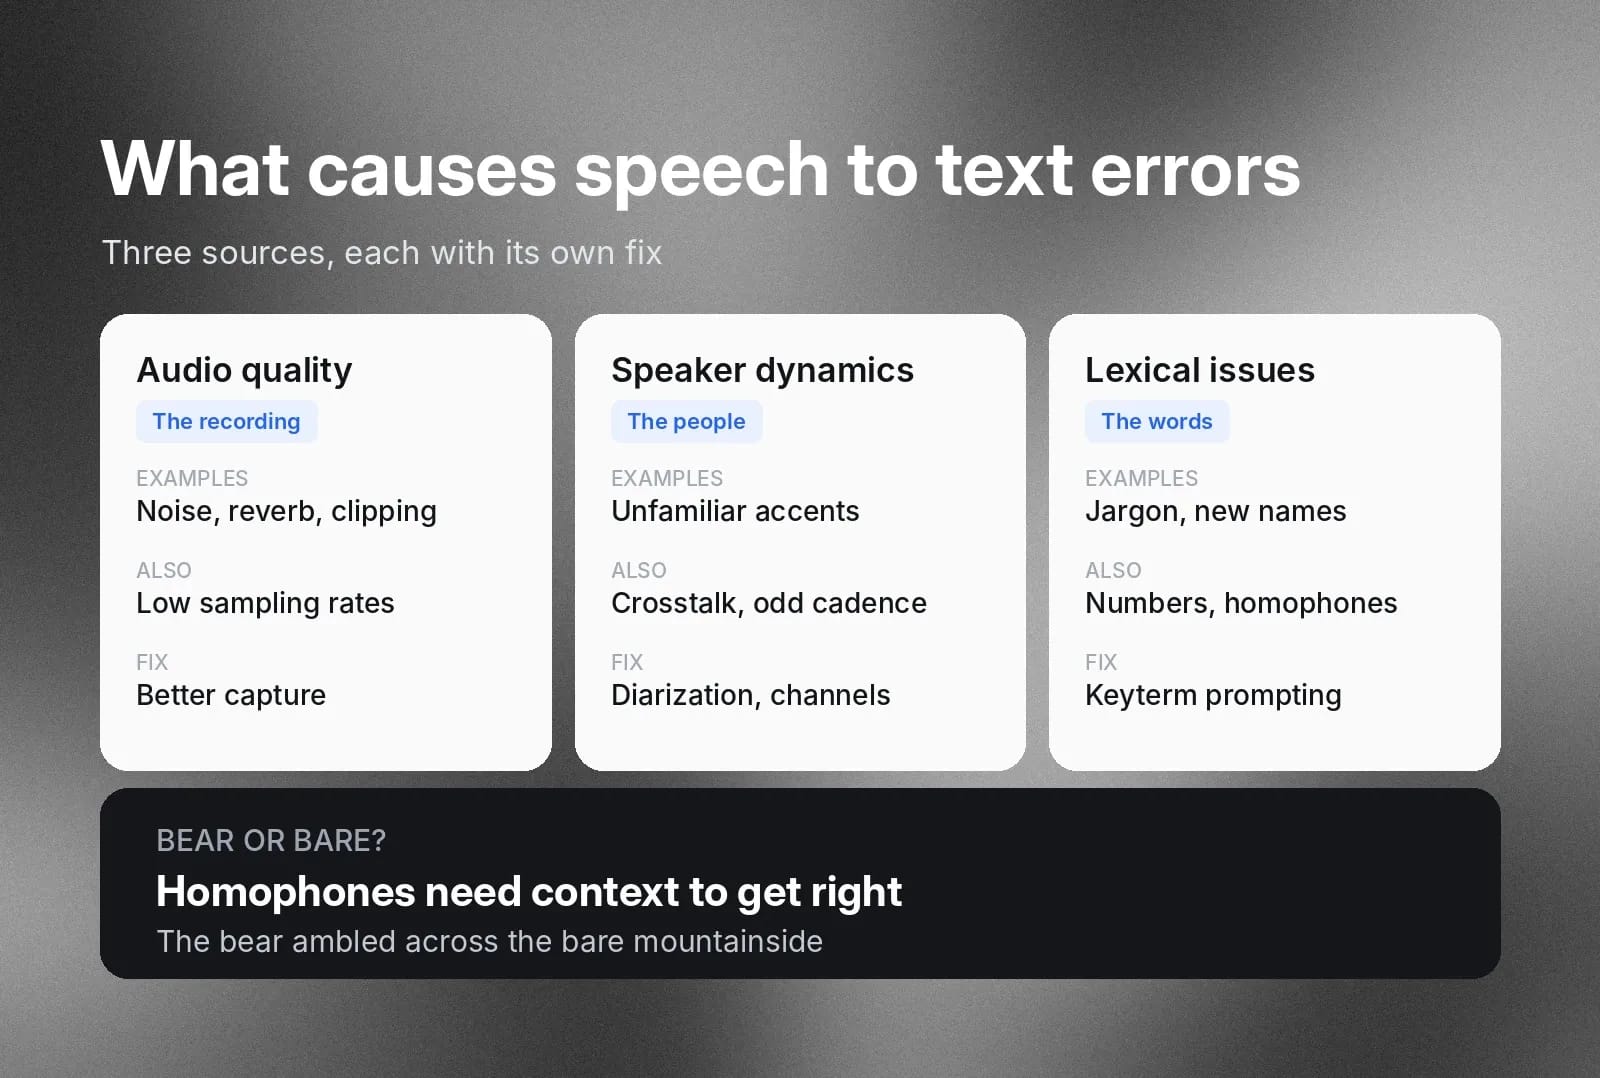
语音转文字不准确主要有三个原因:
- 音频输入质量问题
- 说话者特征
- 词汇和上下文问题
每种原因都需要不同的解决方法,以下将依次说明。
音频质量问题
首先,音频录制本身可能存在问题。麦克风故障可能导致语音失真或削波。场地声学造成的混响、录音信噪比(SNR)较低,或采样率过低,都可能丢失录音中的重要语音信息。
说话者特征
在安静场所说话、口音中性的单人录音相对容易转录。但我们需要转录的很少是这类录音。陌生口音、断断续续或非传统的说话节奏,都可能影响按标准语音训练的 STT 模型。串音或说话声重叠也会干扰模型准确解析内容。
词汇和上下文问题
最后,语音内容也可能给某些 STT 模型带来挑战。行业术语和新产品名称可能不在模型的训练数据中。模型会选择统计上最可能的输出,因此陌生的语音内容可能不是首选预测。数字或数学表达式,以及通常以数字书写的内容,也可能无法清晰转录。
同音异形词是读音相同但拼写不同的词。STT 模型需要足够的上下文理解才能区分它们。例如,“the bear ambled across the bare mountainside.”模型需要知道,动物拼作“bear”,而表示未覆盖表面的形容词拼作“bare”。
如何解决从音频到输出的语音转文字准确率问题
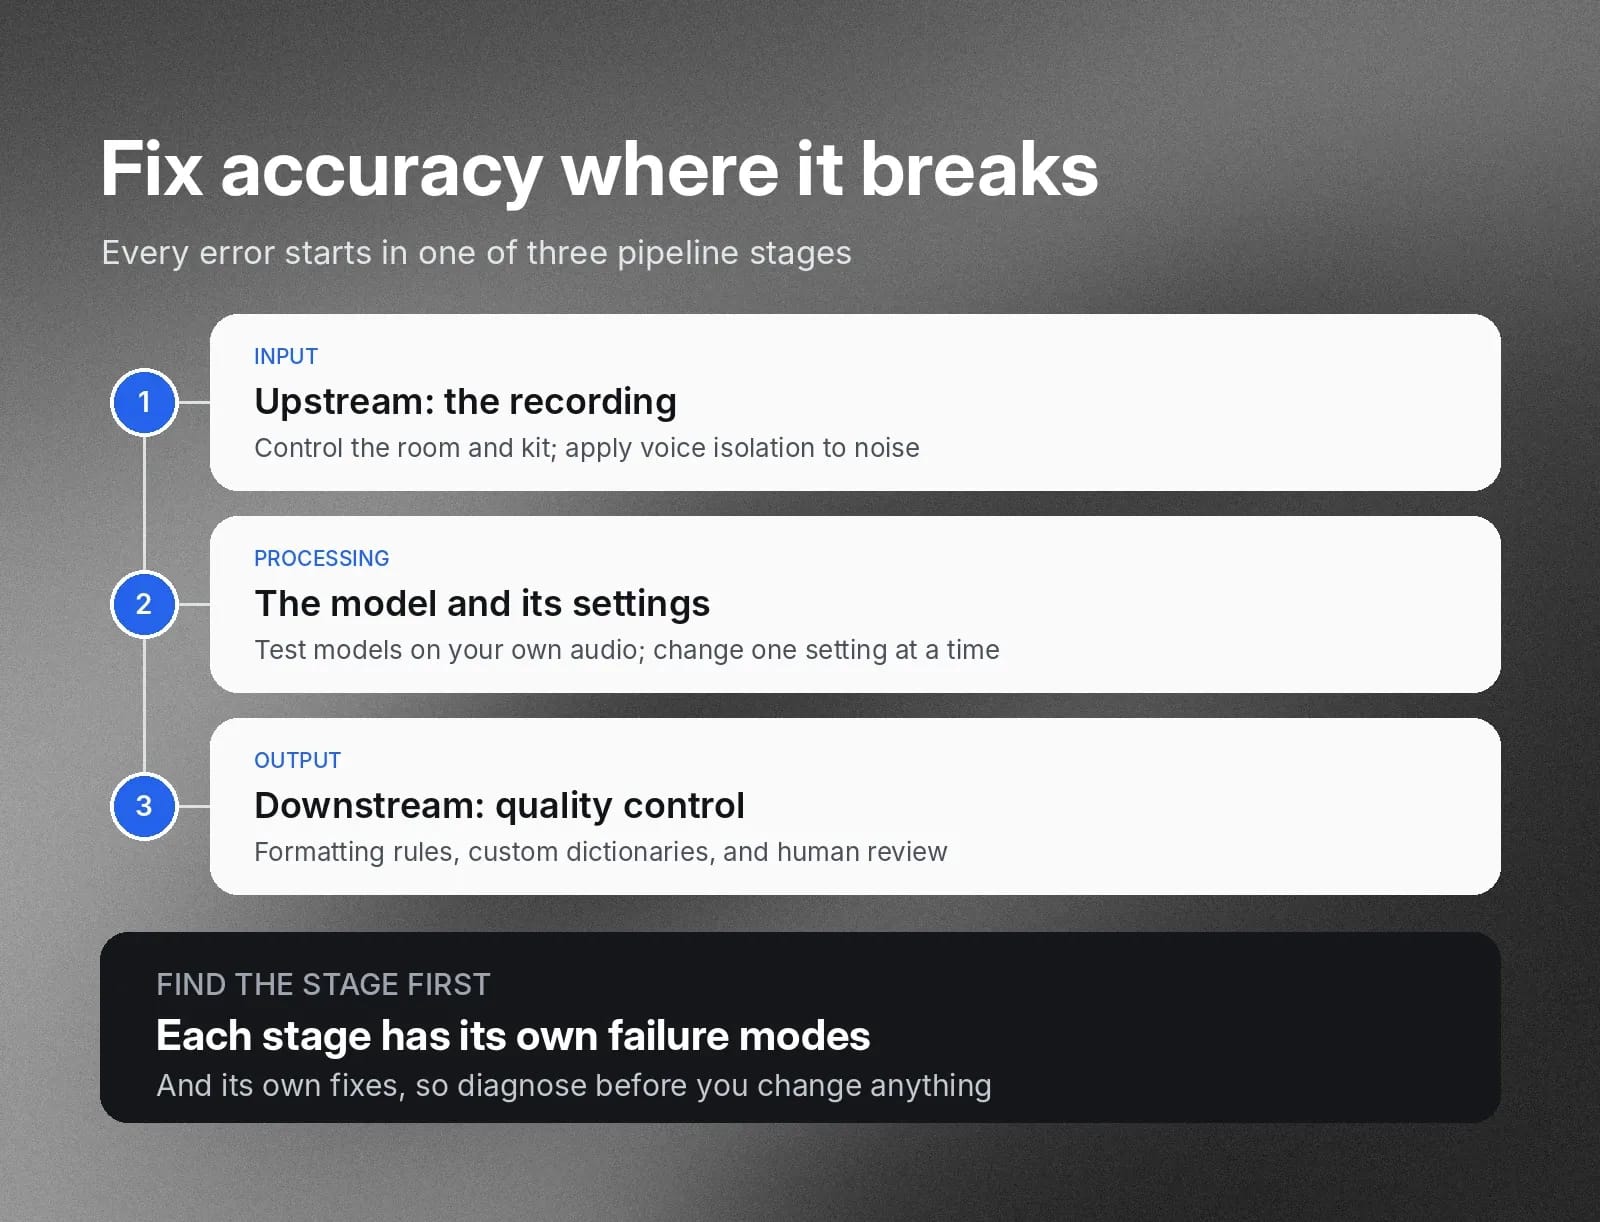
语音转文字处理包含一系列明确步骤。要解决准确率问题,需要找出流程中可调整的位置。总体而言,STT 流程分为:
- 输入
- 处理
- 输出
每个阶段都有各自的故障模式和解决方法。
上游输入准确率问题
录音环境可能存在问题,常见问题包括背景噪声或回声。录音设备如果出现故障,也可能导致问题。
解决这一阶段的问题,通常需要找出原因并加以处理。例如,如果知道 STT 工具难以处理嘈杂背景,那么应在更易控制的环境中进行对话。
对于无法避免的噪声,在音频进入模型前使用人声分离。
处理环节的准确率问题
将 API 配置到 STT 引擎的方式会影响处理结果。提示词结构和所选模型也会影响质量和错误数量。
解决这一阶段的问题,意味着要使用自己的音频测试设置。将相同样本录音分别送入各候选模型,比较其词错误率,然后每次调整一项设置以持续优化。
如果模型持续遗漏某类语音,例如嘈杂通话或某种地区口音,请在实际使用环境中测试不同模型的准确率。
下游输出准确率问题
这是质量控制层,专业流程会清理主引擎可能遗漏的转录错误和歧义。STT 流程常使用基于规则的模式匹配来统一格式,例如将“ten dollars”改为“$10.00”,这一过程称为逆文本规范化(ITN)。但如果说话者以非标准方式使用这些词,或发音错误,死板的查找替换工具就无法识别。
还要考虑是否由人工参与(HITL)检查输出质量。否则,不准确内容可能进入生产输出。与任何活动一样,只要由人执行,就可能发生人为错误。
在这一阶段,解决问题意味着捕捉主引擎遗留的错误。可将转录文本与参考样本对比,找出重复出现的错误,再为这些术语添加针对性规则或自定义词典。尤其对于高风险转录,务必加入人工审核环节。
如何通过更好的音频提高语音识别准确率
改善录音时的音频质量,可以减少许多下游准确率问题。使用更高采样率,尽量少压缩或不压缩,并尽可能保持录音环境清晰。
采样质量
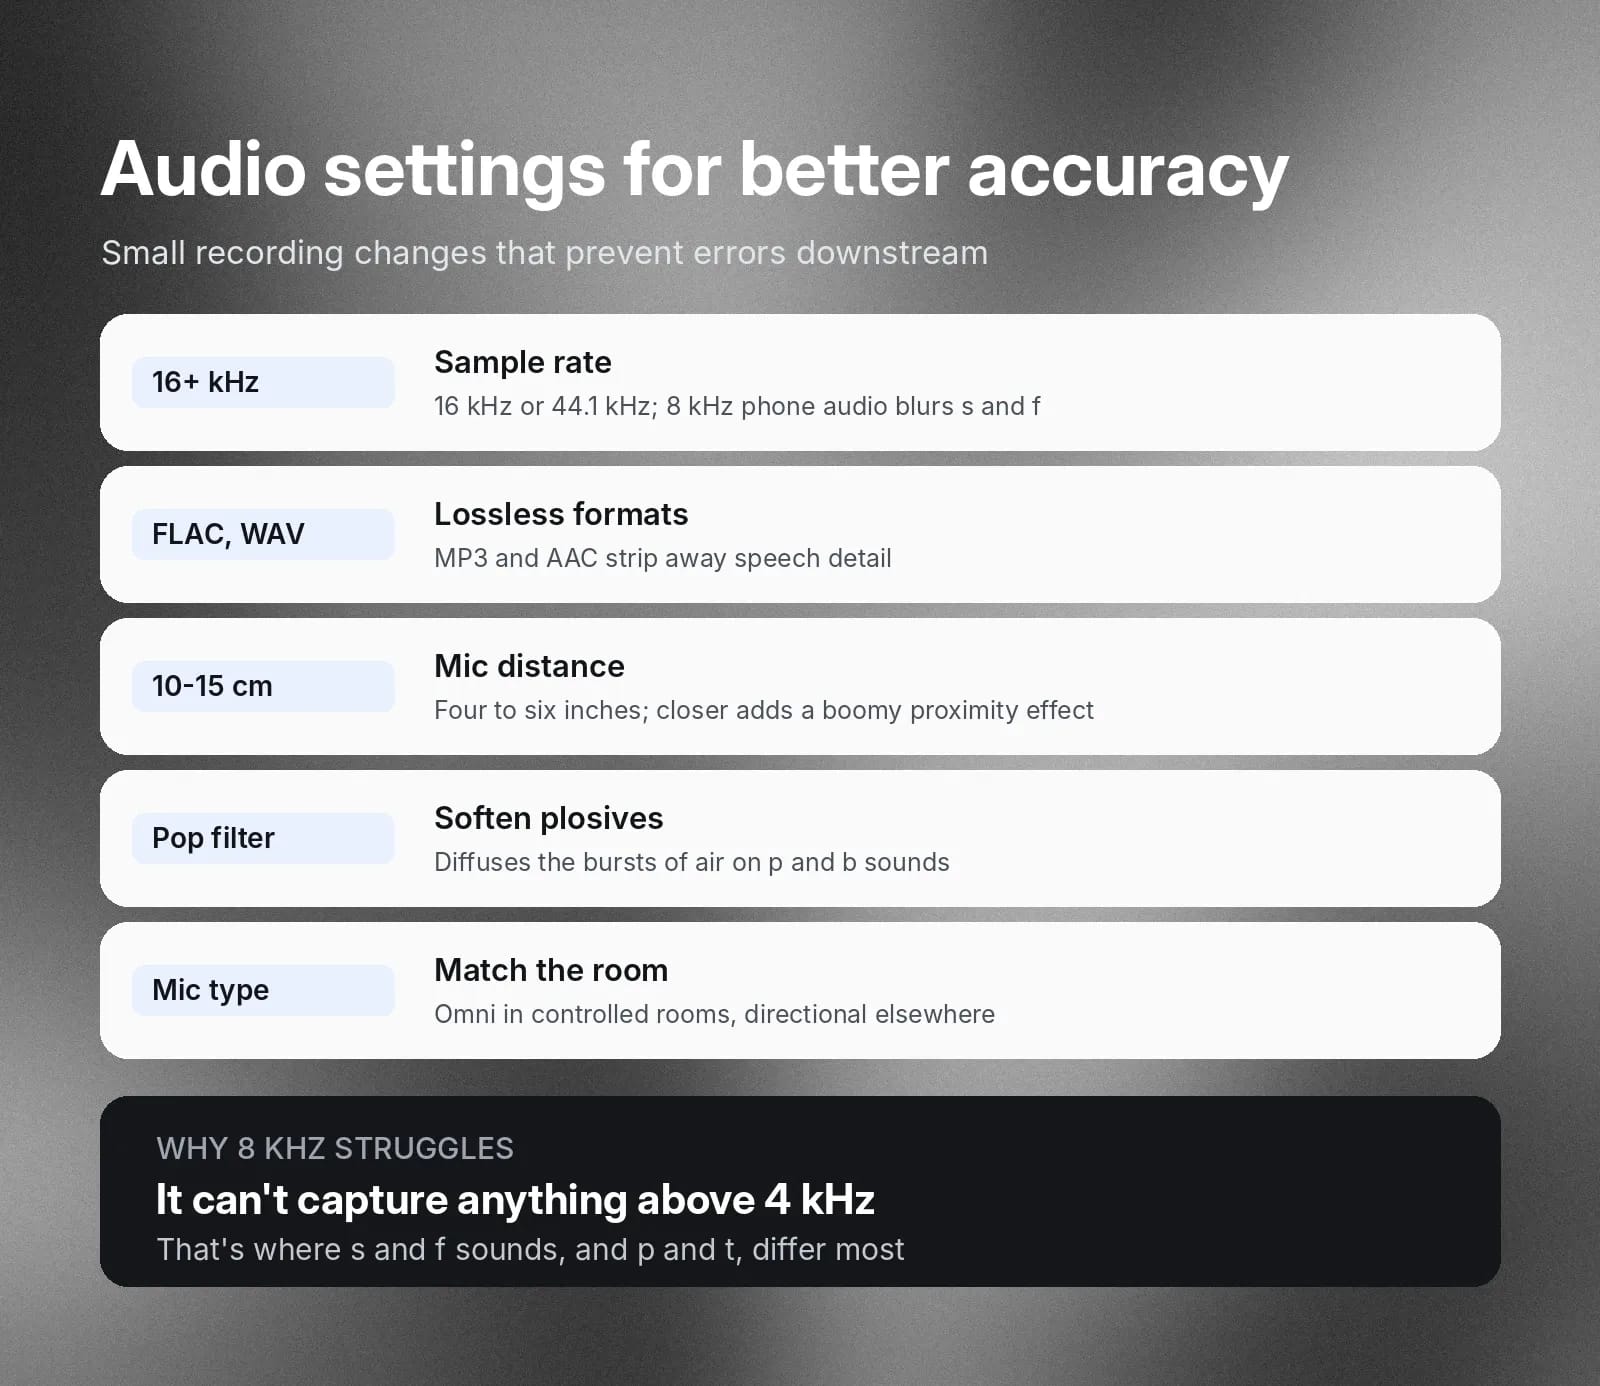
录音请使用 16 kHz 或 44.1 kHz 音频。8 kHz 及更低的传统电话级音频采样,可能难以让 STT 模型解析。对模型而言,这类音频听起来模糊混乱,而且模型无法像通话中的人一样要求说话者重复。
采样率只能重现最高为自身一半的频率,这称为系统的奈奎斯特频率。采样率仅为 8 kHz 时,4 kHz 以上的声音都会被截断,STT 模型也更难区分摩擦音(“s”与“f”)和爆破音(“p”与“t”)。
压缩
录制为 MP3 和 AAC 等有损格式,也会丢失语音细节,留给模型处理的信号更少。请使用 FLAC 或 PCM WAV 等无损或未压缩格式。
录音环境
使用麦克风时应遵循音频工程最佳实践。全向麦克风最适合受控环境;否则,定向麦克风更适合分离语音。将麦克风置于距离说话者嘴部 4 到 6 英寸(10-15 cm)的位置,并尽量避免说话者靠得更近,否则会产生近讲效应,增强低频并使录音浑浊。
还应尽可能为麦克风配备防喷罩。防喷罩可减弱发爆破辅音时产生的气流,例如“p”和“b”音。
降低背景噪声,提高语音识别效果
如前所述,应尽可能使用近距离拾音,理想距离是距说话者嘴部 4 到 6 英寸。避免会使录音浑浊的白噪声和背景噪声。若缺乏现场录音经验,可能不会注意到 HVAC 系统嗡鸣声、键盘敲击声和一般街道噪声等常见来源。这些都会影响 STT 模型解析语音的能力。
不过,背景噪声往往无法避免。这种情况下,应在将音频发送至 STT 模型前,将人声分离作为预处理步骤。人声分离利用软件算法或轻量级专用神经模型,从语音录音中滤除背景音频。
处理口音、说话声重叠和专业词汇
现代多语言模型使用多样化语音数据集训练,但在处理真实世界音频时,准确率仍会有所不同。请使用来自相关人群的样本音频,对不同模型进行基准测试。如果有可用的历史客服通话,可将那些包含实际场景中需转录的口音、节奏和说话模式的录音进行转录。
检查输出中的错误并识别相关模式。模型是否难以识别年轻群体使用的俚语?是否常在某种地区口音上出错?
处理说话声重叠
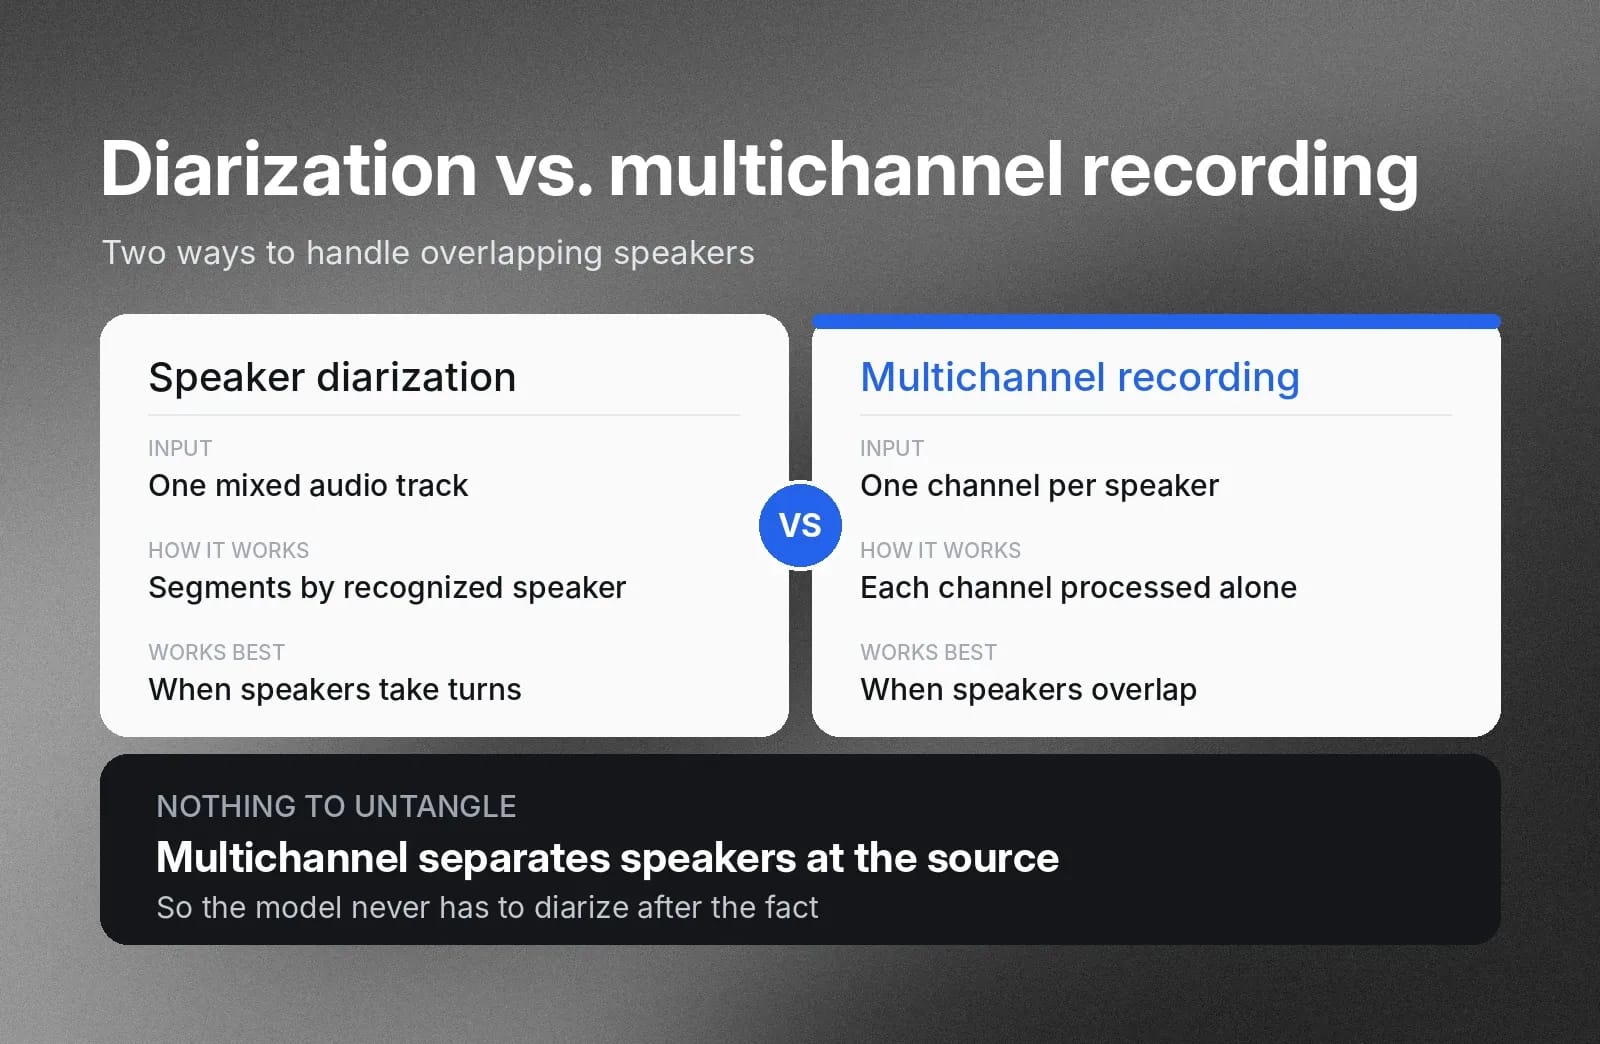
准确转录重叠语音的两项主要工具是说话人分离和多声道录音。说话人分离会获取原始音频输入,并按识别出的不同说话者进行分段。它适合说话者轮流发言清晰的情况。
原生多声道录音不会将所有人声混合为一条音轨,而是将每位说话者保留在独立声道中,STT 模型可分别识别和处理。每位说话者在录音中已被原生分离,因此语音模型无需事后进行说话人分离。
关键术语提示提供正向偏置
品牌名称、新产品名称、行业术语及其他独特词汇,若未包含在 STT 模型训练数据中,往往无法被准确转录。关键术语提示是向 STT 模型提供希望其优先采用的特定拼写。它通常不是一对一替换提示,而是根据上下文引导模型选择所需的自定义拼写。
准确转录数字、ID 和药物名称
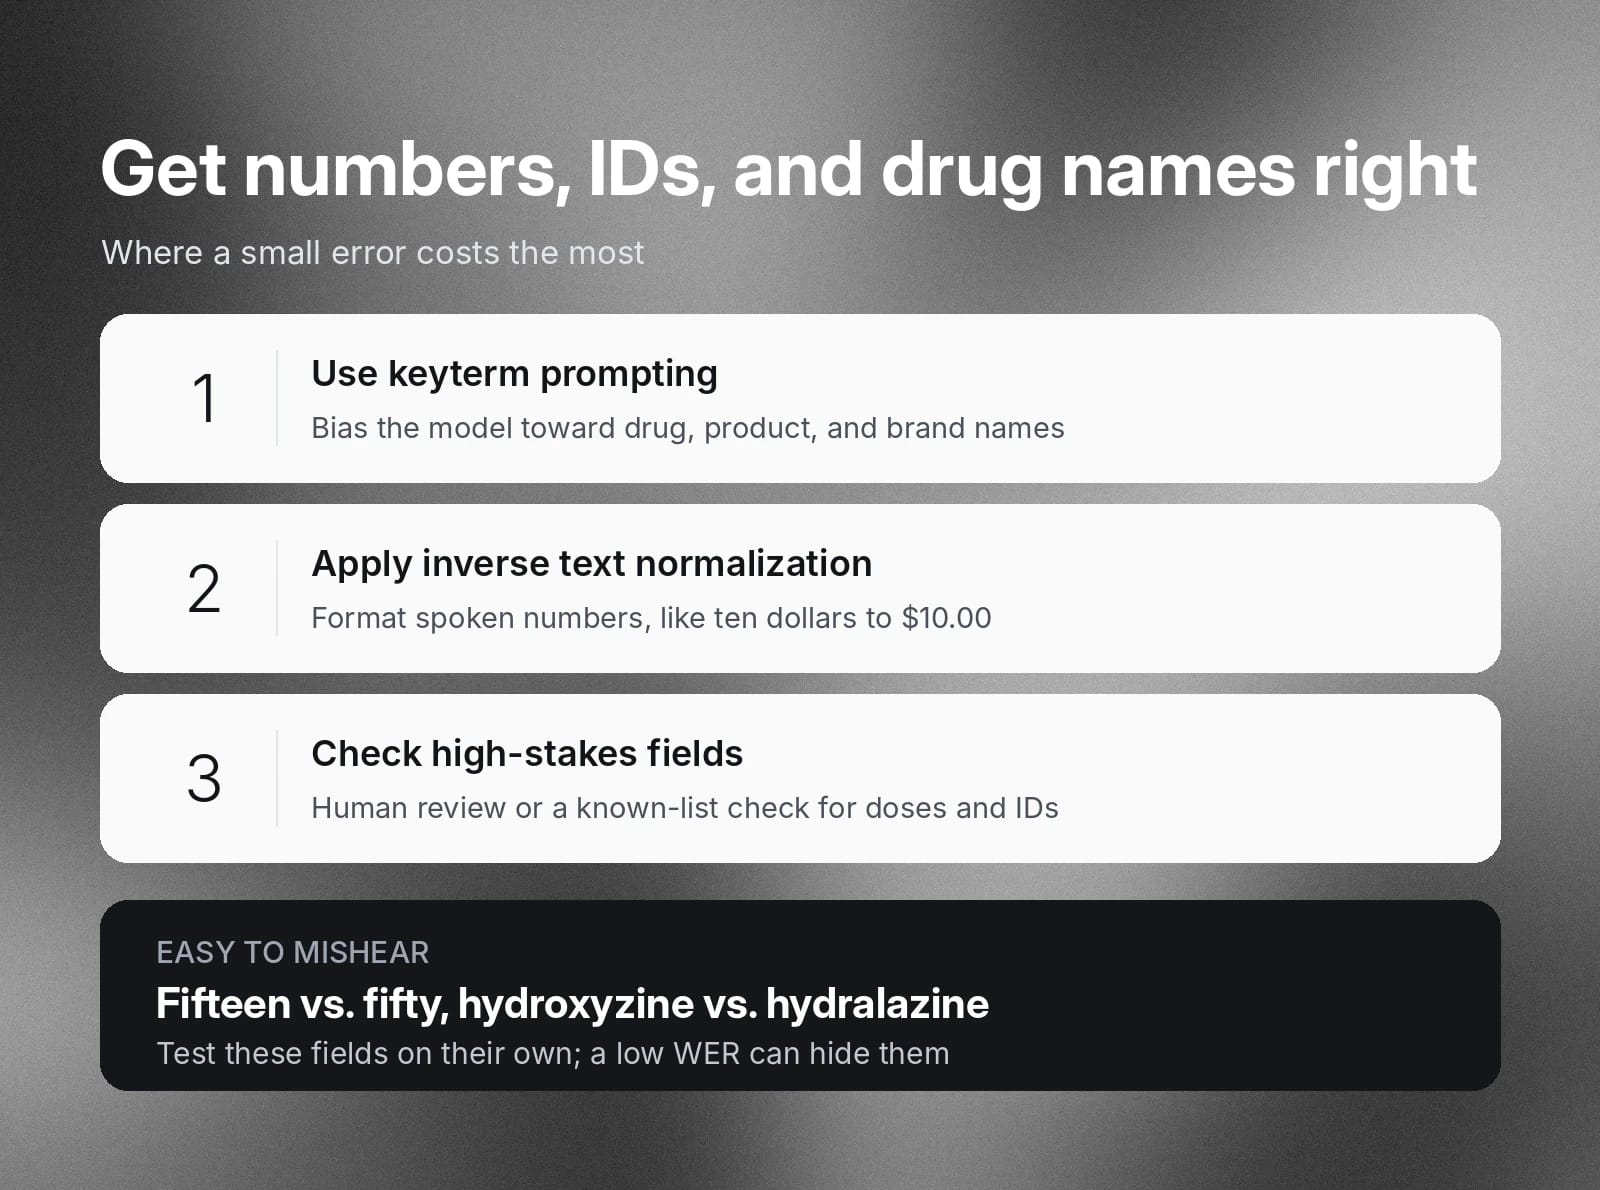
数字、账户 ID、邮编和药物名称中,微小错误的代价最大。模型可能将“fifteen”听成“fifty”,也可能混淆仅相差一个音节的两种药物名称,例如 hydroxyzine 和 hydralazine。
以下三步会有帮助:
- 使用关键术语提示:引导模型优先采用预期的药物名称、产品名称和其他术语拼写。
- 应用逆文本规范化(ITN):统一口述数字的格式,例如将“ten dollars”改为“$10.00”。
- 为高风险字段添加检查:对于药物剂量和账号等字段,使用人工审核,或根据已知列表自动检查。
应单独测试这些字段,因为较低的整体 WER 可能掩盖恰恰是最重要词汇上的错误。
使用词错误率衡量语音识别质量
词错误率(WER)是评估 STT 引擎准确率的实用指标。可以比较不同模型测试中的 WER,以了解它们的相对准确率。
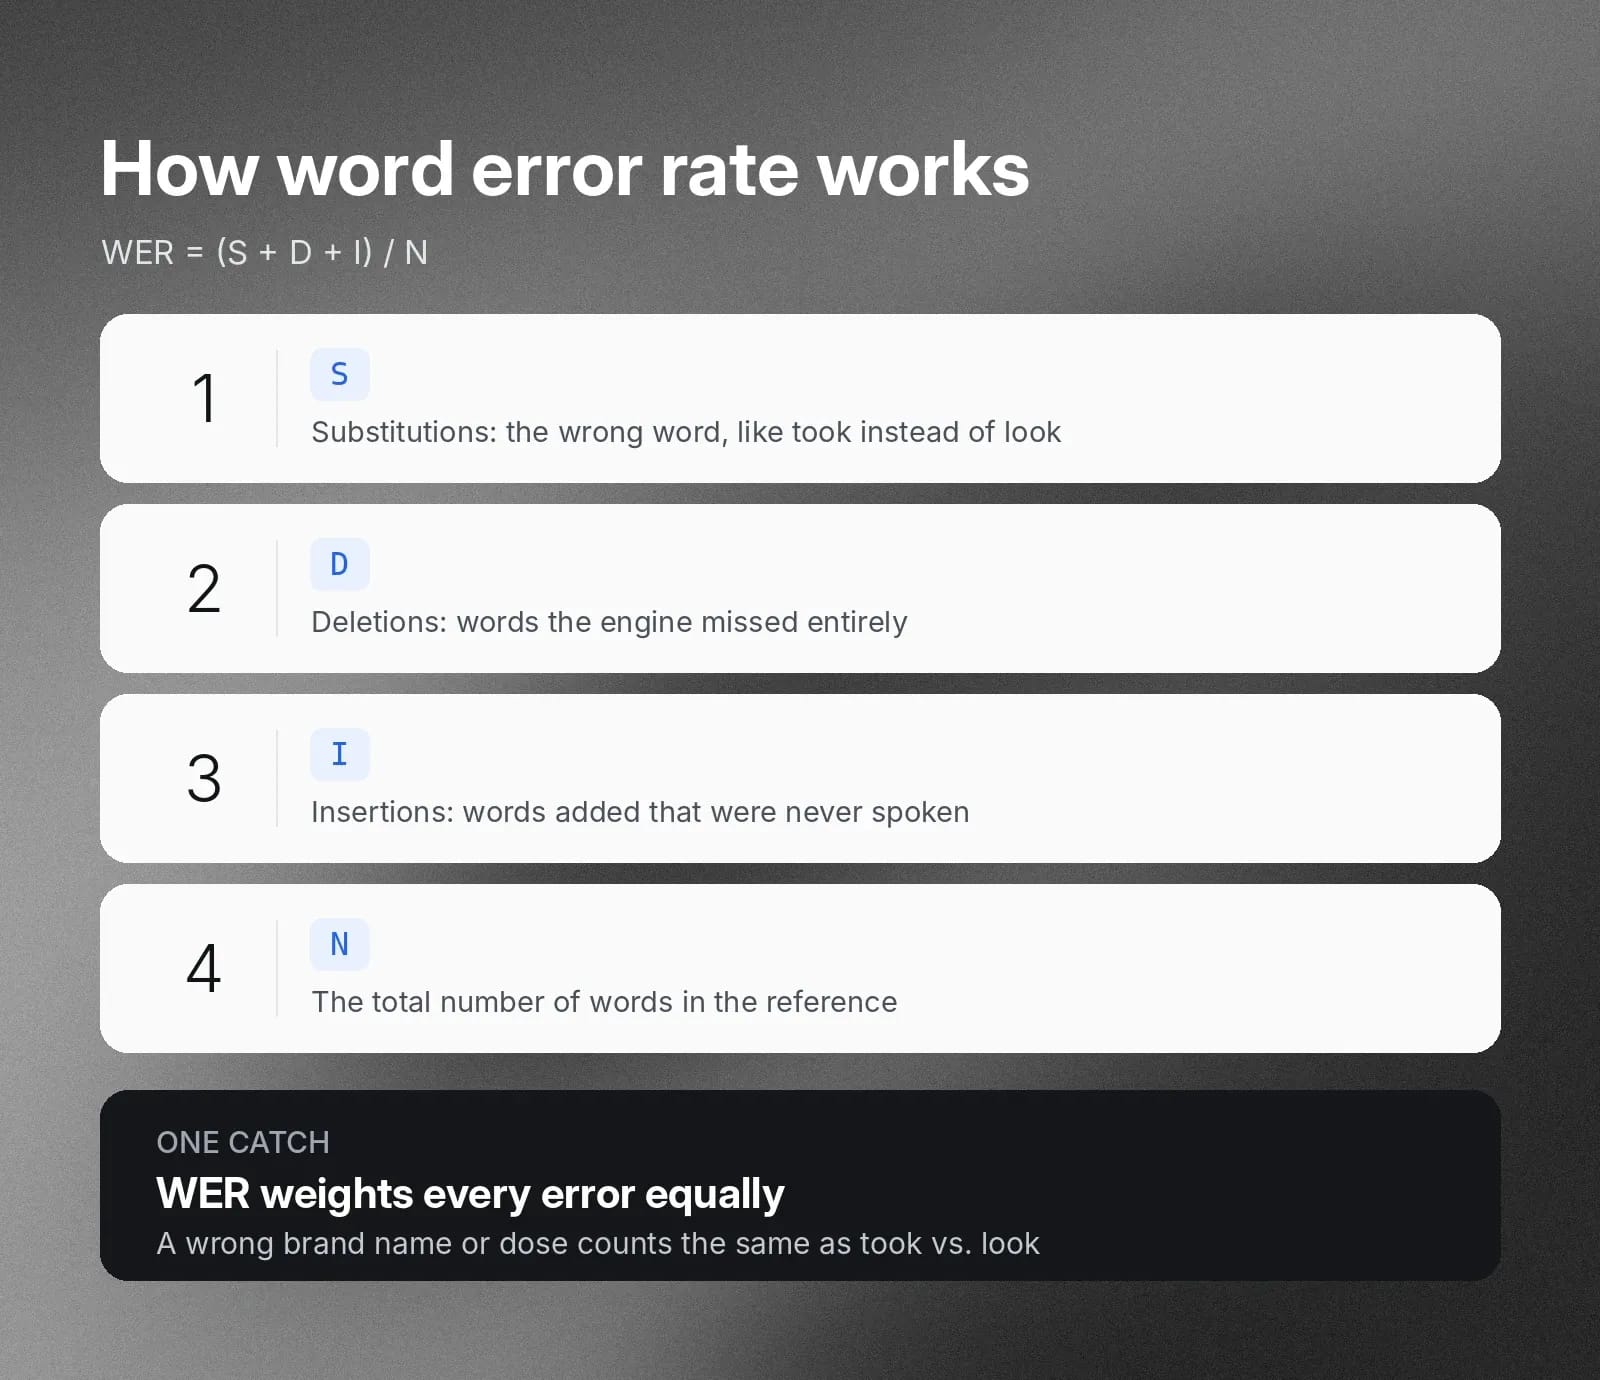
WER 的计算方式如下:
WER = (S + D + I) / N
- 替换(S):转录中,STT 引擎输出错误词语的次数,例如将“look”识别为“took”。
- 删除(D):完全遗漏的词语数量。
- 插入(I):添加了但原本未说出的词语数量。
- 参考文本总词数(N):样本语音输入中的总词数。
需要注意的是,WER 对所有错误赋予相同权重。例如,将“look”替换为“took”,与识别错品牌名称或药物剂量等重要数值,计数完全相同。请检查不同模型的 WER。
怎样的词错误率算好?
不存在唯一的理想 WER,因为合适的目标取决于音频和使用场景。干净的单人音频比说话声重叠的嘈杂通话有更低的错误率。请根据自己的录音比较模型,而不要只看宣传数字。
作为专业音频的参考,Scribe v2 Medical在公共医疗ASR基准测试中属于表现最佳的模型之一。请查看当前基准测试结果,获取最新数据。
基准测试结果会随新模型发布而变化。比较前请查看当前结果。
准确率与精确率:转录团队应衡量什么
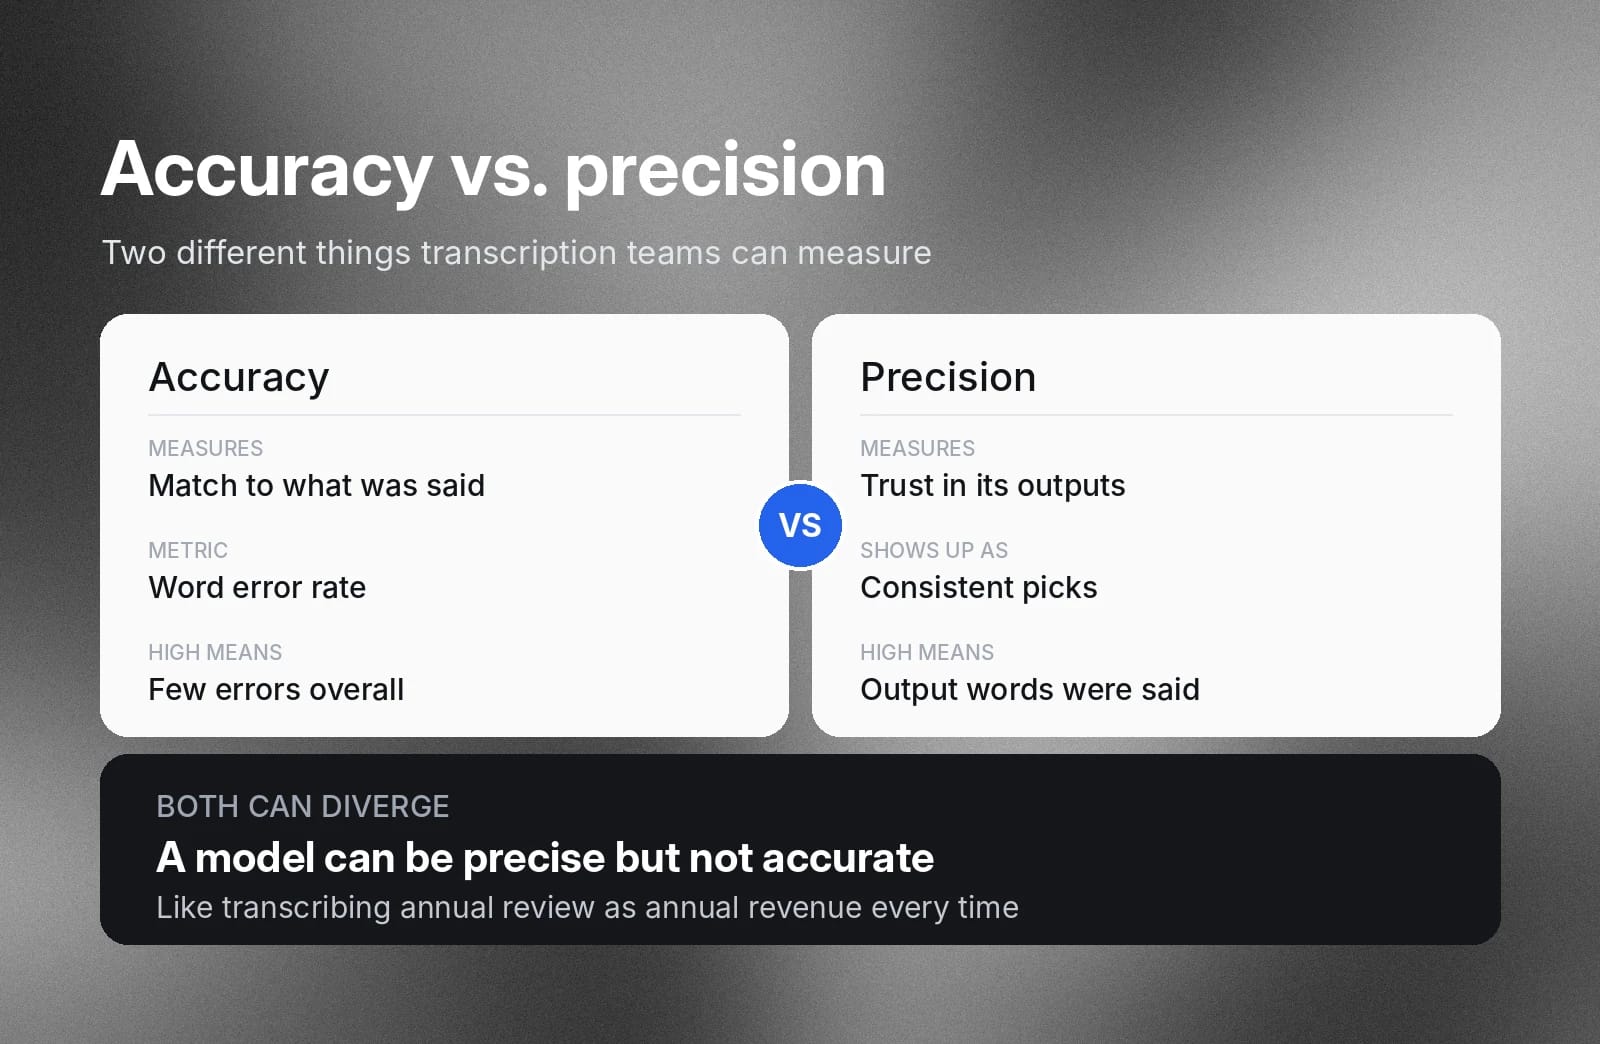
准确率指转录输出与口语“真实值”输入的匹配程度。词错误率衡量的是准确率。
精确率指 STT 模型正向预测的可靠性。高精确率模型在多次处理复杂语音时会选择同一个词。如果模型输出某个词,就可以相信该词存在于语音中。但高精确率模型的准确率仍可能较低,即它会遗漏许多词。
使用 ElevenAPI 开始更准确的转录
ElevenAPI可让你使用 Scribe v2——ElevenLabs 的语音转文字模型——以及解决本指南准确率问题的功能:用于名称和术语的关键术语提示、用于说话声重叠的多声道转录,以及说话人分离。
如果不想使用 API 进行转录,也可以使用ElevenCreateive STT。
立即使用ElevenAPI生成高质量语音转文字,或详细了解 ElevenAPI 的语音转文字功能。
语音转文字准确率常见问题

Jack Limebear 隶属于增长团队,负责博客和洞察页面的内容撰写与策略。加入 ElevenLabs 前,他曾在多家快速成长的 SaaS 初创公司和世界 500 强企业,拥有十余年内容策略管理经验。剑桥大学英语文学硕士。