Scribe v2 Medical 现已面向所有人开放
- 作者
- Min Kim
- 发布时间
- 最近更新
收听收听本文
临床音频是准确语音识别最难应对的场景之一。药物名称很长、罕见且容易混淆(hydroxyzine 和 hydralazine 仅相差一个容易听错的音节)。词汇密集,剂量、单位、解剖学和病理学术语可能接连快速出现。风险也更高,因为转录错误可能会写入患者病历。
因此,ElevenLabs 今日发布 Scribe v2 Medical,这是一款针对临床音频微调的文本转语音模型,现已在 ElevenAPI 上全面推出。在下方展示的各项评测中,它的词错误率(WER)始终位居参评模型最低之列;与基础版 Scribe v2 相比,临床音频的 WER 降低约 35%。
通用模型擅长处理日常语音,但在临床 workflow 最需要的场景中,性能可能下降。我们基于 Scribe v2 训练了医疗微调模型,重点优化药物名称和临床口述记录,并在所有人均可复现的公开基准上进行测试。
Scribe v2 Medical 专为临床场景优化
临床口述记录(MedDictate)
Corti 的 MedDictate 用于测试临床口述记录的转录,其中包含连续出现的英语、法语和德语药物名称、剂量及单位。在我们的评测中,Scribe v2 Medical 的整体 WER 在所测模型中最低,比基础版 Scribe v2 低约 35%。
模型 | 英语 | 法语 | 德语 | 整体 WER |
Scribe v2 Medical | 3.0% | 8.3% | 7.2% | 4.9% |
OpenAI GPT Transcribe | 3.9% | 7.8% | 9.6% | 5.9% |
Scribe v2(基础版) | 5.0% | 10.7% | 11.7% | 7.6% |
Muse Voice Transcribe 1.0 | 4.5% | 11.0% | 13.3% | 7.8% |
Deepgram Nova-3 Medical* | 5.5% | - | - | - |
*仅支持英语(24 个片段)— Deepgram Nova-3 Medical 不支持法语或德语。
医学术语(MedTerm)
MedTerm 同样是 Corti 发布的数据集,包含涵盖相同 3 种语言、由 600 个样本构成的临床术语基准;每个样本中的医学术语均已标注。这些标注使我们能够在完整转录文本的 WER 之外,从两个维度评估模型。术语召回率是转录文本中正确出现的已标注医学术语所占百分比(越高越好)。术语 WER 是仅针对这些术语计算的错误率,忽略其周围的普通语音(越低越好)。
Scribe v2 Medical 在这两个维度均领先所有测试模型,并在 3 种语言中领先其他所有提供商:
模型 | 术语召回率 ↑ | 术语 WER ↓ |
Scribe v2 Medical | 77.7% | 10.4% |
Scribe v2(基础版) | 77.1% | 10.7% |
OpenAI GPT Transcribe | 74.0% | 12.3% |
Muse Voice Transcribe 1.0 | 73.4% | 12.9% |
Deepgram Nova-3 Medical* | 72.5% | 13.6% |
Eka Medical ASR 基准
Eka Medical ASR 基准 包含 3,619 个英语临床音频样本,涵盖单独的药物和病症名称、临床句子以及临床医生与患者之间的对话;每个术语均有标注,数据集页面还发布了排行榜。
已发布的数据集包含 Gemini 2.5 Flash 和 GPT-4o 等较早模型,因此我们使用较新的模型进行了评测。SemWER(语义 WER)衡量模型是否识别出正确内容,不考虑格式差异(“mg”和“milligrams”视为相同答案);kwWER(关键词 WER)则仅对已标注的医学关键词采用相同评分方式。
模型 | semWER | kwWER |
Scribe v2 Medical | 6.50% | 6.02% |
Scribe v2(基础版) | 7.35% | 7.04% |
Deepgram Nova-3 Medical | 7.79% | 7.65% |
Muse Voice Transcribe 1.0 | 8.85% | 8.99% |
OpenAI GPT Transcribe | 13.90% | 13.20% |
Eka 为每个样本中的医学术语添加了标注,因此可以只针对医学术语,更细致地评估 Scribe v2 Medical 相比基础版的提升。Scribe v2 Medical 的错误比基础版少 15%(9.5% 对 11.1%),且术语出现在完整临床句子中时,提升最为明显(7.5% 对 9.9%)。
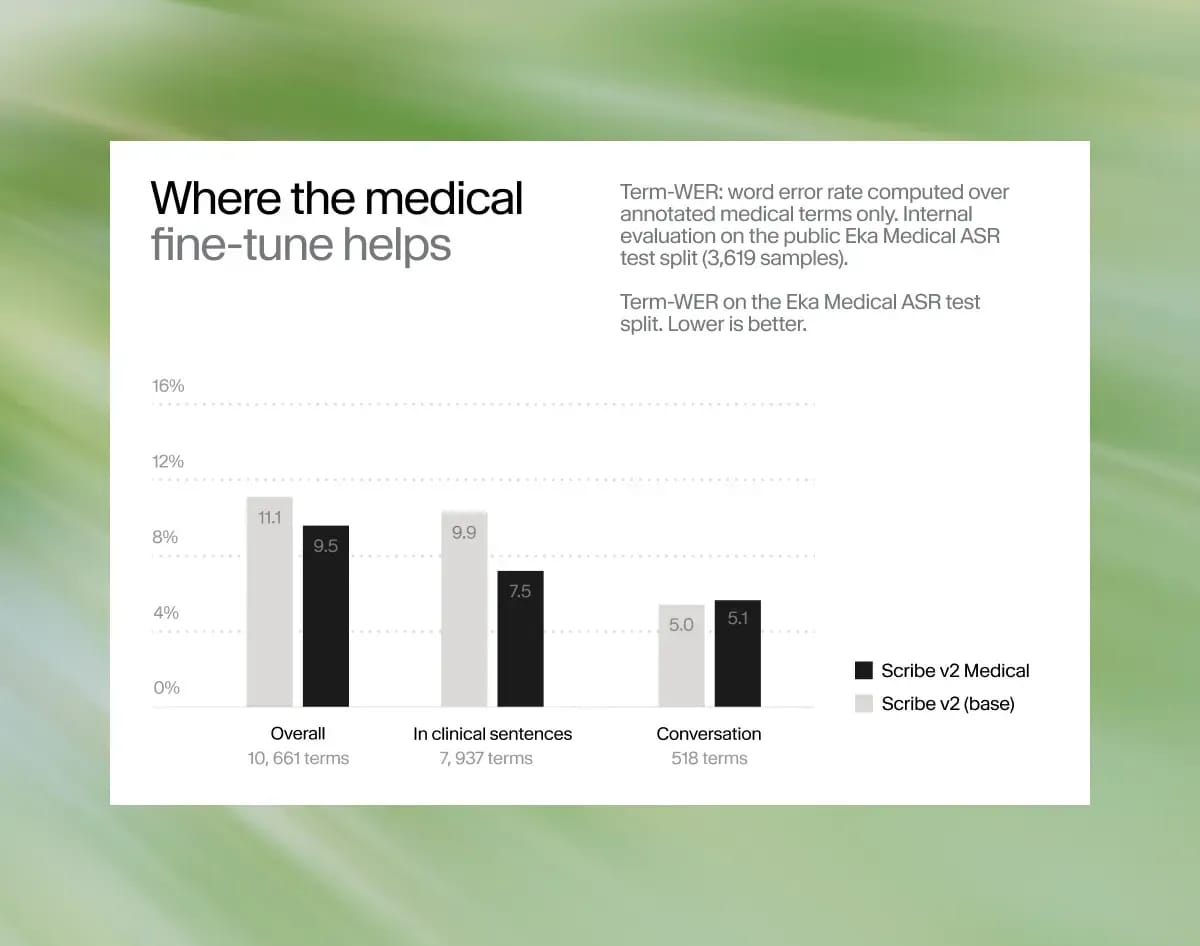
同一数据也表明,孤立的单词片段(没有上下文、仅说出一个药物名称)仍是排行榜上所有模型最难应对的情况,包括 Scribe v2 Medical。它在孤立术语上的 WER 为 14.3%,而这些术语出现在句子中时为 7.5%。在毫无上下文的情况下,一个听错的音节就可能导致令人印象深刻的错误:
- etodolac(一种 NSAID)→ “It'll do the luck”
- levomilnacipran(一种抗抑郁药)→ “Leave me alone now, Sephora.”
- methdilazine(一种抗组胺药)→ “Let's play our scene.”
减少这些错误的一种方法是使用 关键词提示,它可以让你突出药物名称或医学短语,引导模型更准确地转录这些内容。
生产环境中的客户
客户已在生产环境中使用 Scribe v2 Medical,并看到临床音频质量的提升。
“从 Deepgram 切换到 ElevenLabs Scribe v2 Medical 后,我们在临床术语上的准确率显著提升,这改变了团队的工作方式。”CareCo CEO 兼创始人 Mendel Erlenwein 表示,“当协调员信任转录文本时,他们就能减少更正记录的时间,把更多时间花在与患者通话上。患者的治疗方案很复杂,护理团队阅读的记录必须准确无误。”
通用语音表现出色
团队还验证了医疗微调不会降低其他领域的表现。在源自 Common Voice 的 6,000 个日常非医疗语音样本上,Scribe v2 Medical 四舍五入后的得分与基础版 Scribe v2 相同,两者的 WER 均为 5.3%。因此,v2 Medical 既能提供专业医疗模型的优势,也不会牺牲该基准上的准确率。
为受保护健康信息而构建
对于已签署商业伙伴协议且启用 零保留模式(ZRM)的企业客户,Scribe v2 Medical 符合 HIPAA 资格要求。
为 文本转语音 API 请求启用 ZRM 后,每次请求完成后都会立即删除音频输入和文本输出。ElevenLabs 不会保留其中任何内容;应用会收到完整的 API 响应,并可自行控制如何保留转录文本。
开始使用
Scribe v2 Medical 可通过 文本转语音 API 使用。只需传入新的模型 ID:scribe_v2_medical
该模型运行在批量 文本转语音 端点上。