ウェビナー振り返り:テキストチャットボットに人間らしい声を加える方法
- 公開日
- 最終更新日
聴くこの記事を聴く
チャットエージェントは、エンタープライズソフトウェアスタックの標準的な一部となっています。多くの企業がすでに導入しているか、構築を進めています。しかし、ユーザーがテキストではなく話したいときに何が起きるかを把握している企業は、まだ多くありません。
音声は、利便性を超えて重要な形でインタラクションを変えます。ユーザーは、テキストでは完全に失われる口調によって、苛立ちや緊急性、戸惑いを表現します。「注文品がまだ届かない」と入力する顧客と、不安そうな声で同じことを話す顧客は、異なるシグナルを発しています。文字起こししか読めないエージェントが得られる情報は、その半分にすぎません。
今、多くのチームが問うているのは、音声を追加するかどうかではありません。すでに機能しているものをすべて作り直さずに、どう追加するかです。
「ライブワークショップ:テキストチャットボットに人間らしく聞こえる音声を与える」では、Paul Asjes(デベロッパーエクスペリエンス)、Bhargavi Bhatt(カスタマーエクスペリエンス)、Fergal Burnett(プロダクトマーケティング、ElevenAPI)が、既存のエージェントに音声を追加する際の技術的な実情と、実際に機能するインテグレーションの姿を解説しました。
音声を使った構築が見た目以上に難しい理由
中心的な課題の一つが、発話ターンの切り替えです。人間は、イントネーション、リズム、文脈から、相手が話し終えたタイミングを判断できます。一方、音声活動検出(標準的なアプローチ)が検出できるのは、沈黙だけです。
その結果、あらゆる間を発話の合図として扱うシステムになりがちです。相手の話を遮り、考えの途中で切り、自然なためらいにも文が完結したかのように応答します。
技術的には機能していても、会話としては破綻しています。
もう半分の課題は文脈です。各ターンで会話履歴をLLMに渡すことは必要ですが、それだけでは不十分です。同じ言葉でも、伝え方によって意味は変わります。安心して「大丈夫です」と言う場合と、苛立って「大丈夫です」と言う場合では、文字起こしは同じでも、インタラクションは異なります。この次元を無視する音声システムは、個々のモデルがどれほど優れていても、常にどこか不自然に聞こえます。
エンジニアリングの負荷もあります。独自の音声オーケストレーションを担うチームは、発話ターンのロジック、割り込み処理、レイテンシープロファイリングを継続的に保守することになります。一度構築すれば終わりではありません。
既存のエージェントに音声を追加する方法
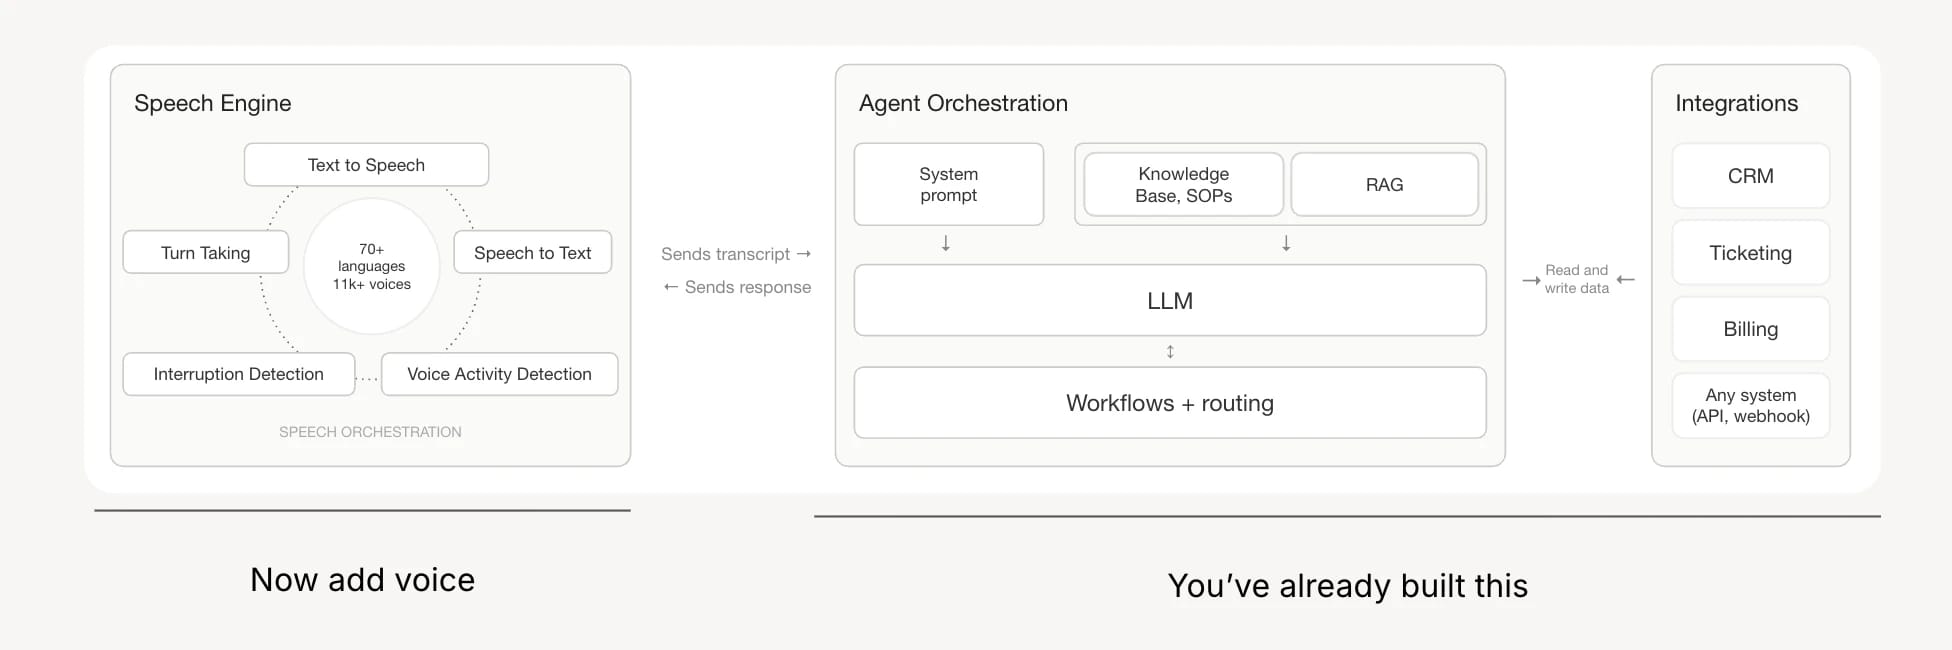
最もシンプルなのは、二重WebSocketアーキテクチャです。
- 1つの接続はクライアントとElevenLabs APIの間、もう1つはサーバーとElevenLabs APIの間で動作します
- ユーザーがマイクに話すと、オーディオがElevenLabs APIに送信され、文字起こしされた後にサーバーへ送られます
- サーバーはElevenLabs APIから取得した会話履歴全体をLLMに渡し、ストリーミングされた応答はオーディオ合成のために戻されます
- これはLLMの生成完了前に開始できるため、最初のバイトまでのレイテンシーを低く保てます
インテグレーションの要となるのは、onTranscript メソッドです。各ターンの終了時に呼び出され、会話履歴全体をLLMに渡します。
セッション開始時のcontextualUpdate により、ユーザーが音声へ切り替える前のテキスト会話で起きた内容を引き継げます。これにより、文脈を失うことなく、1つのエージェントが両方のモダリティで機能します。
構築時に押さえておきたいポイント:
- 音声では、チャット以上にLLMの選択が重要です。 高度な推論モデルでは、応答品質が高くても、オーディオでは不自然なためらいに感じられる間が生じます。リアルタイム音声では、知覚される品質の面で、ほぼ常に高速なモデルが優位です。
- オーディオにはWebSocketよりWebRTCを使いましょう。 WebRTCにはエコーキャンセリングとノイズキャンセリングが組み込まれており、モバイルや騒がしい環境では特に重要です。オーディオ転送にWebSocketを使う場合は、これらを自分で処理する必要があります。
- ユーザーに言語を選ばせないでください。 会話の流れが途切れてしまいます。発話の最初の数秒で言語を検出して固定する方がよいパターンです。ユーザーが何も操作しなくても、自然に言語を切り替えられます。
- 発話ターンモデルはLLMと分けてください。 ユーザーが話し終えたかどうかの判断をLLMに任せると、毎ターンでレイテンシーとコストが加わります。専用の発話ターンモデルなら、より高速かつ正確に処理できます。アーキテクチャ内の独立したコンポーネントとして扱う価値があります。
どこまでのインフラを自社で持つべきか
最適な答えは、すでに何があるかによって異なります。すでに機能するチャットエージェントがあるなら、LLM、オーケストレーション、ビジネスロジックをそのままに、上から音声レイヤーを追加するのが、通常は最も速く、リスクも最小の方法です。
何かを作り直す必要はありません。すでに機能しているものに、オーディオインターフェースを追加するだけです。
要件が電話対応、デプロイチャネルの管理、組み込みテスト、分析まで広がる場合は、スタックのより多くを音声エージェントプラットフォームに任せるのが理にかなっています。この2つのアプローチは相反するものではありません。チームは軽量な音声レイヤーから始め、ユースケースの成熟に合わせてプラットフォーム機能を追加できます。
デモ:既存のチャットボットに音声を追加する
このデモでは、日本旅行に向けて、テキストベースの旅行計画チャットボットと会話の途中にいるユーザーが、地域や食事のおすすめを尋ねる様子を紹介します。
紹介した内容:
- 基盤となるエージェントを変更することなく、チャットボットに音声レイヤーを追加しました。
- ユーザーは会話の途中で入力から発話に切り替えましたが、エージェントは両方のモダリティにわたって完全な文脈を保持しました。
- ユーザーはオランダ語で話し、エージェントは言語の切り替わりを自動的に検出しました
- エージェントが途中で遮られ、文の途中で英語に戻すよう求められると、それに応じ、指示されていないにもかかわらず、わずかにオランダ語アクセントを残して応答を終えました。
- 会話を通じて、割り込み検出により、エージェントが発話を終えるのを待つことなく、ユーザーは自然に話しかけられました。
重要な理由:
このデモで示したのは、専用に構築された音声エージェントではありません。すでに機能しているテキストエージェントの上に、音声レイヤーを追加したものです。文脈処理、言語検出、割り込み時の動作はすべて音声レイヤーによるもので、基盤のテキストエージェントは変更していません。
フルセッションを視聴
ウェビナー全編はこちらからご覧ください。
PaulはElevenLabsのDeveloper Growthチームに所属し、スペイン・バレンシアを拠点に、プラットフォームのアドボカシーやツール開発に取り組むDeveloper Experience Engineerです。ElevenLabs以前は、StripeでDeveloper Relationsを担当し、WorkOSでDXに携わり、長年にわたりフルスタックWebアプリやデベロッパーツールの開発を行ってきました。