Scribe v3 und v3 Live: unsere genauesten Speech-to-Text-Modelle
- Verfasst von
- Min Kim
- Veröffentlicht
AnhörenArtikel anhören
Audiobasierte Produkte beginnen mit einem Transkript: Besprechungsnotizen, Sprachagenten, Synchronisationen, klinische Dokumentation und Sendearchive mit Inhalten aus Jahrzehnten. Ein korrektes Transkript beim ersten Mal ist wichtig, denn jeder Fehler wirkt sich auf nachgelagerte Prozesse aus, wo seine Korrektur deutlich mehr kostet.
Doch Audio aus der realen Welt ist unübersichtlich. Mehrere Personen reden in einem Meeting gleichzeitig, ein Kunde macht auf einer belebten Straße mitten im Satz Pause oder bei einem Support-Anruf spricht keine der beiden Personen in ihrer Muttersprache.
Heute veröffentlicht ElevenLabs zwei neue Speech-to-Text-Modelle, die genau für diese Bedingungen entwickelt wurden:
- Scribe v3 für aufgezeichnetes Audio macht in 102 Sprachen 27 % weniger Wortfehler als Scribe v2 und liefert die genauesten Sprecherkennzeichnungen aller von uns getesteten Modelle,
- Scribe v3 Live ist die Variante mit niedriger Latenz für Echtzeit-Audio und macht 43 % weniger Fehler als Scribe v2 Realtime. Sie umfasst zudem erstmals Sprecherdiarisierung (die Zuordnung, wer was gesagt hat) und eine verbesserte Sprecherwechselerkennung.
Scribe v3 Live ist ab heute in ElevenAgents verfügbar. Beide Modelle sind auch in ElevenAPI verfügbar. Der Wechsel von Scribe v2 erfordert dort nur eine Änderung der Modell-ID in einer Zeile.
Das Feedback hinter Scribe v3
Scribe hat Hunderte Millionen Stunden an Transkriptionen für Apps für Besprechungsnotizen, Contact Center, Tools für klinische Dokumentation und Sprachagenten ermöglicht. Unabhängig vom Anwendungsfall fragten die Teams, die darauf aufbauen, immer wieder nach denselben fünf Dingen.
Teams für Meetings und Notizen wünschten sich bessere Diarisierung bei schnellen Wechseln und drei oder mehr Sprechern. Teams für Sprachagenten berichteten, dass ein Stille-Timer Anrufer unterbricht, wenn sie mitten im Satz pausieren oder langsamer werden, um eine Zahl vorzulesen. Teams mit Live-Produkten verzichteten zugunsten der Geschwindigkeit auf Genauigkeit, weil Echtzeit-Modelle deutlich schlechter abschnitten als Batch-Modelle. Kunden in Indien wollten, dass Hindi genauso gut funktioniert wie Englisch – auch wenn Anrufer mitten im Satz zwischen beiden Sprachen wechseln. Viele wollten außerdem mehr Kontrolle über die Ausgabe: von Zahlen als „123“ bis zu Listen mit Schlüsselbegriffen, die lang genug für einen Produktkatalog oder eine Liste von Medikamentennamen sind.
Sprecherkennzeichnungen, Sprecherwechselerkennung und mehr Kontrolle über die Ausgabe
Diarisierung, die auch in einem vollen Raum funktioniert
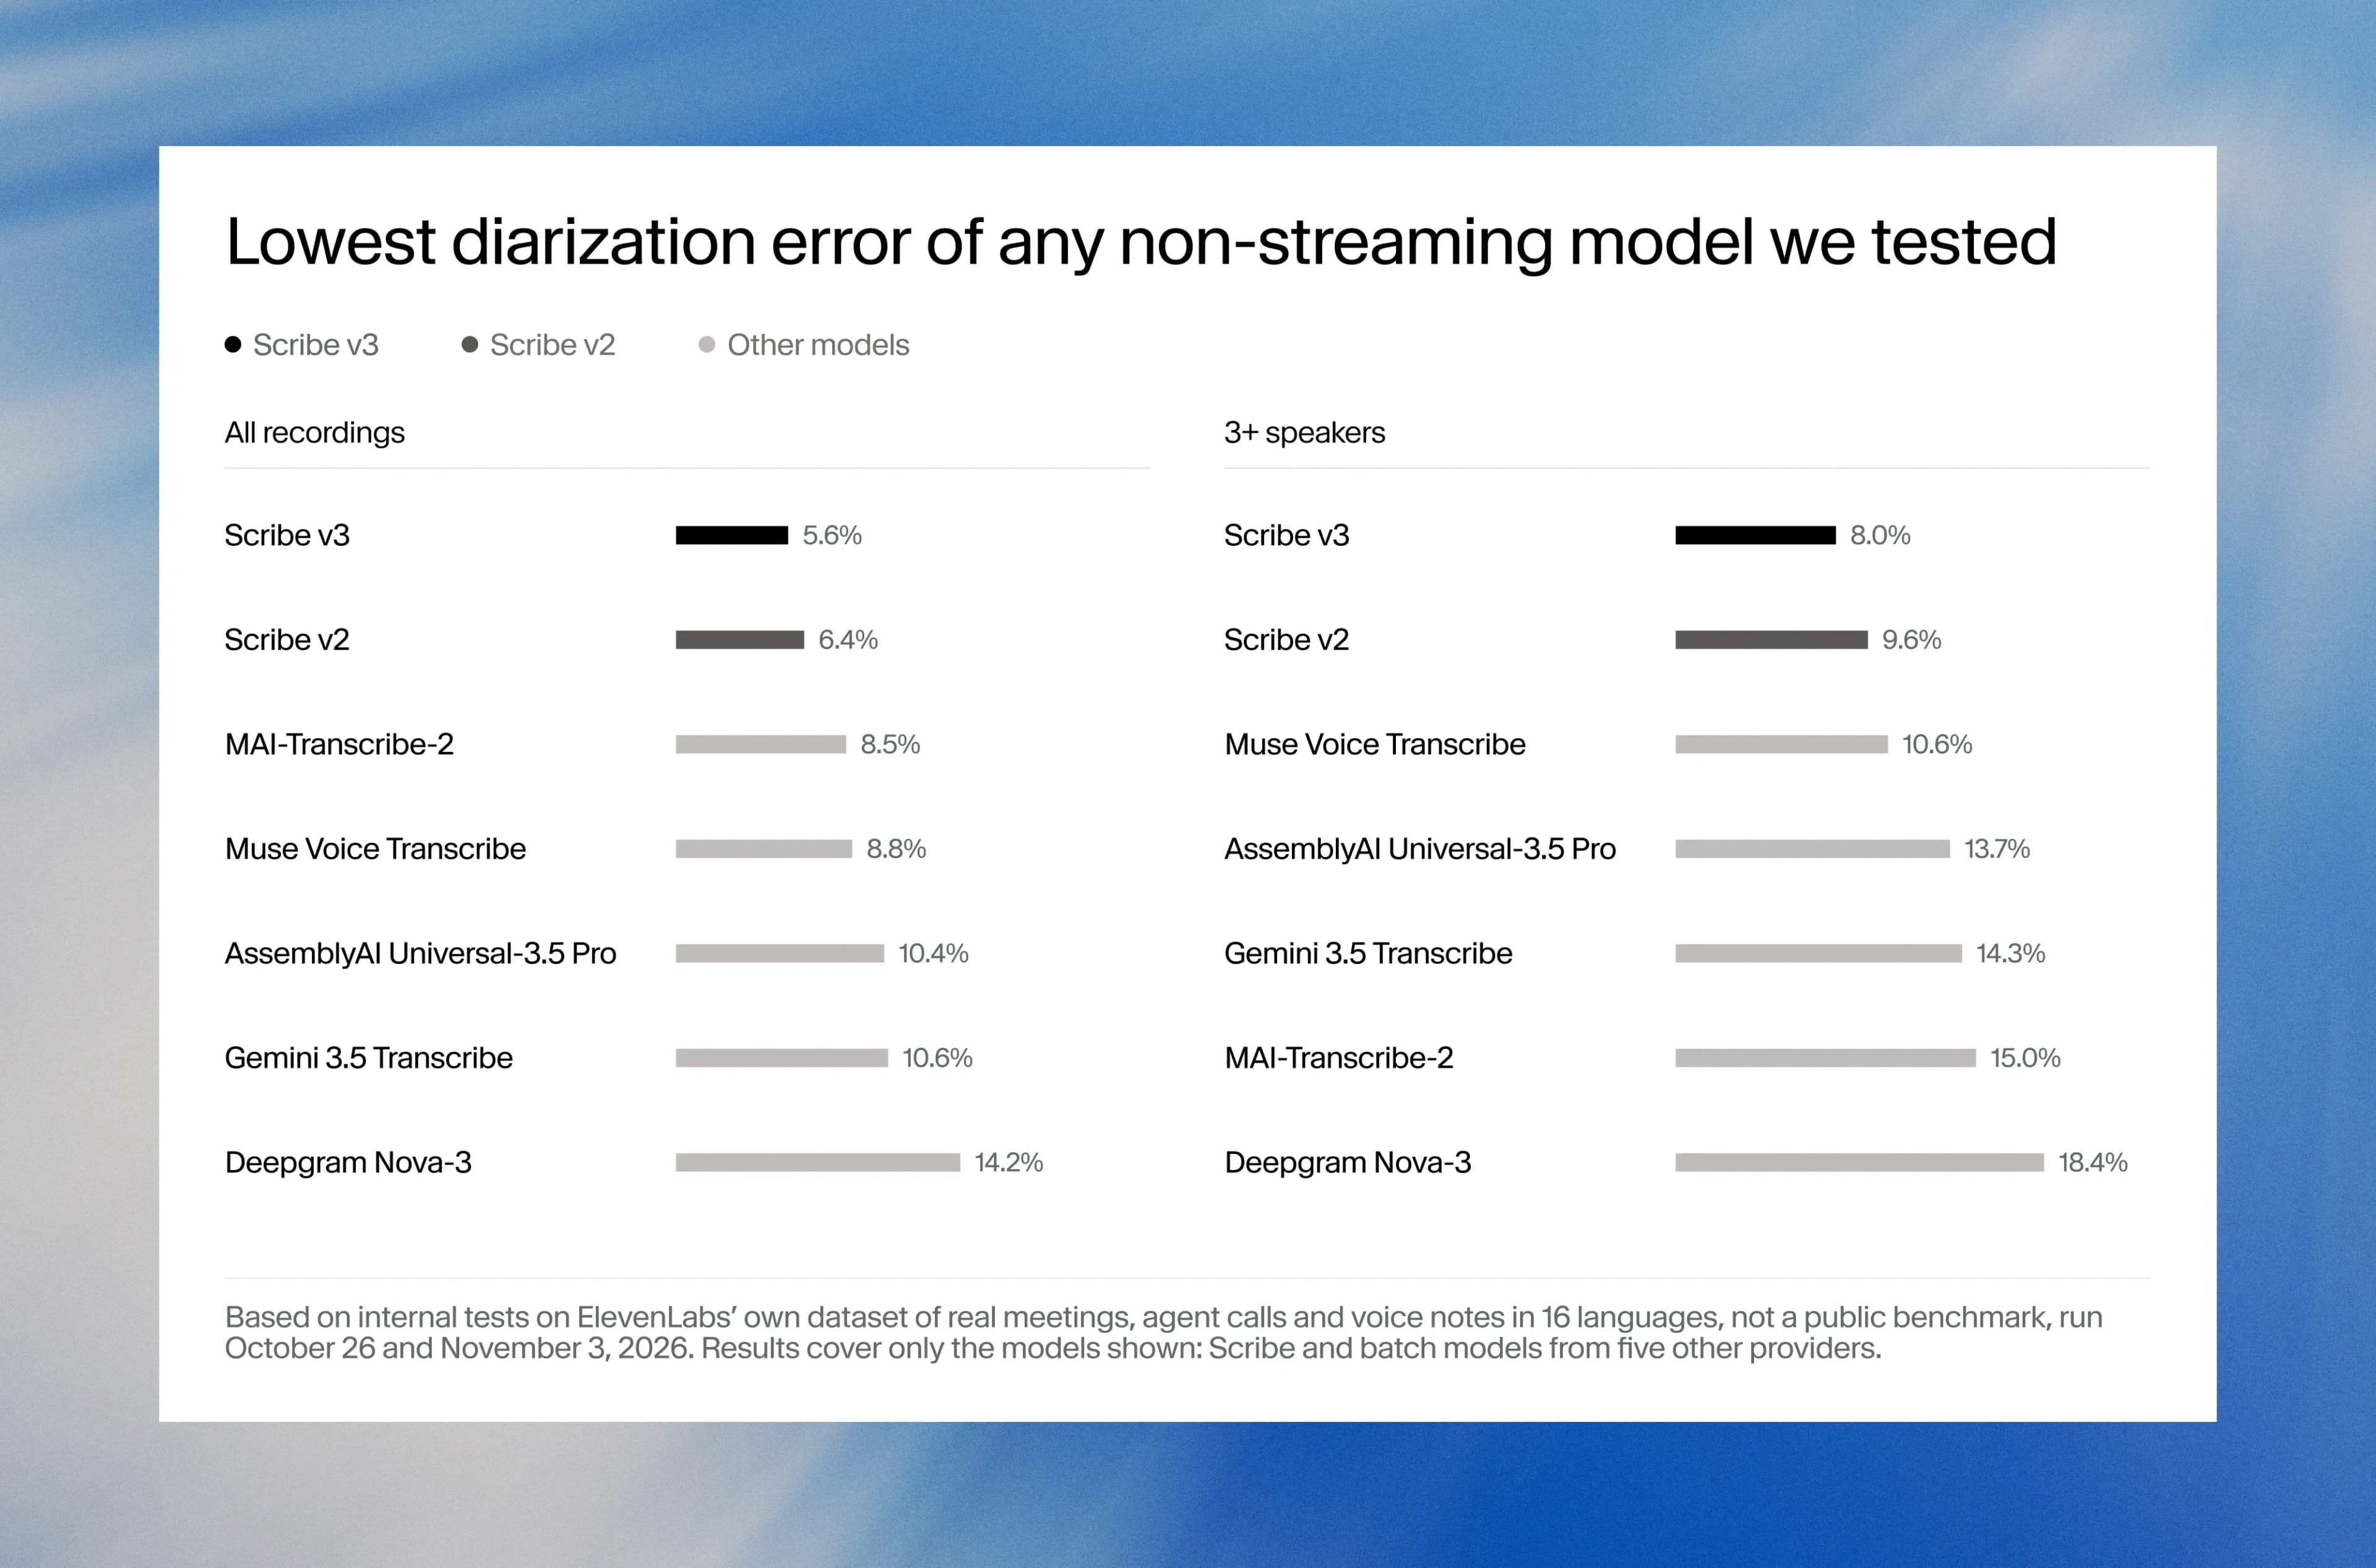
Bei einem Meeting-Transkript ist die richtige Sprecherzuordnung genauso wichtig wie die richtigen Wörter. Bei Aufzeichnungen mit drei oder mehr Sprechern macht Scribe v3 17 % weniger Diarisierungsfehler als Scribe v2. Genau bei diesen Aufzeichnungen scheitern die meisten bestehenden Modelle. Scribe v3 Live ermöglicht zudem erstmals Diarisierung für Echtzeit-Transkription – mit 39 % weniger Diarisierungsfehlern als das zweitbeste von uns getestete Echtzeitmodell.
Sprecherwechselerkennung, die dem Gespräch folgt
Damit Gespräche natürlich wirken, müssen Sprachagenten zuverlässig erkennen, wann jemand ausgeredet hat. Herkömmliche Systeme zur Sprecherwechselerkennung orientieren sich an Phasen der Stille. Doch Stille allein erzwingt einen Kompromiss: Ein kurzer Schwellenwert kann Personen unterbrechen, die mitten im Satz pausieren, während ein langer Schwellenwert einen Agenten langsam wirken lässt. Scribe v3 Live berücksichtigt neben dem Audio auch den Kontext des Gesprächs, damit ein Anrufer, der mitten in einer Zahl pausiert, nicht unterbrochen wird. Das ist dieselbe Sprecherwechselerkennung, die ElevenAgents bereits nutzt – jetzt auch in ElevenAPI verfügbar.
Mehr Kontrolle über Sprachen, Terminologie und Formatierung
Scribe v3 kann Hinweise darauf ableiten, welche Sprachen eine Aufnahme enthalten könnte, und Sie können wählen, ob Zahlen als Ziffern oder Wörter ausgegeben werden. Keyterm Prompting verarbeitet bis zu 1.000 Begriffe, die voraussichtlich vorkommen, etwa Markennamen, Akronyme und Fachjargon. Transkriptbearbeitungen wenden Formatierungsregeln in einfachem Englisch an, etwa „write every date as YYYY-MM-DD.“
Scribe v3 Live ergänzt einen mehrsprachigen Modus für Gespräche, in denen mitten im Satz die Sprache gewechselt wird. Außerdem gibt es eine Keyterm-Bibliothek für Vokabulare, die für eine Liste zu umfangreich sind. Während Keyterm Prompting Begriffe abdeckt, von denen Sie wissen, dass sie vorkommen, enthält die Keyterm-Bibliothek Tausende, die möglicherweise vorkommen. Das Modell nutzt sie nur, wenn es eine wahrscheinliche Übereinstimmung erkennt.
So schneidet Scribe v3 ab
ElevenLabs hat beide Modelle mit Scribe v2, Scribe v2 Realtime und anderen beliebten Speech-to-Text-Modellen verglichen und sie auf denselben Datensätzen bewertet. Die mehrsprachige Genauigkeit wurde anhand einer internen Version des FLEURS-Benchmarks gemessen, der kurze, klar gesprochene Sprache in 102 Sprachen testet. FLEURS kann keine Diarisierung messen, da jeder Clip nur einen Sprecher hat. Deshalb haben wir außerdem einen eigenen Datensatz mit realen Meetings, Agenten-Anrufen und Sprachnotizen in 16 Sprachen erstellt. Wir werden ihn in Kürze als Open Source veröffentlichen.
Sprecherdiarisierung
Scribe v3 hat den niedrigsten Diarisierungsfehler aller von uns getesteten Modelle: insgesamt 12 % weniger Fehler als Scribe v2 und 17 % weniger bei Aufzeichnungen mit drei oder mehr Sprechern.
Mehrsprachige Transkriptionsgenauigkeit
Wir berichten die Wortfehlerrate (WER) zusammen mit der semantischen WER, die einen Fehler nur zählt, wenn sich die Bedeutung des Transkripts ändert.
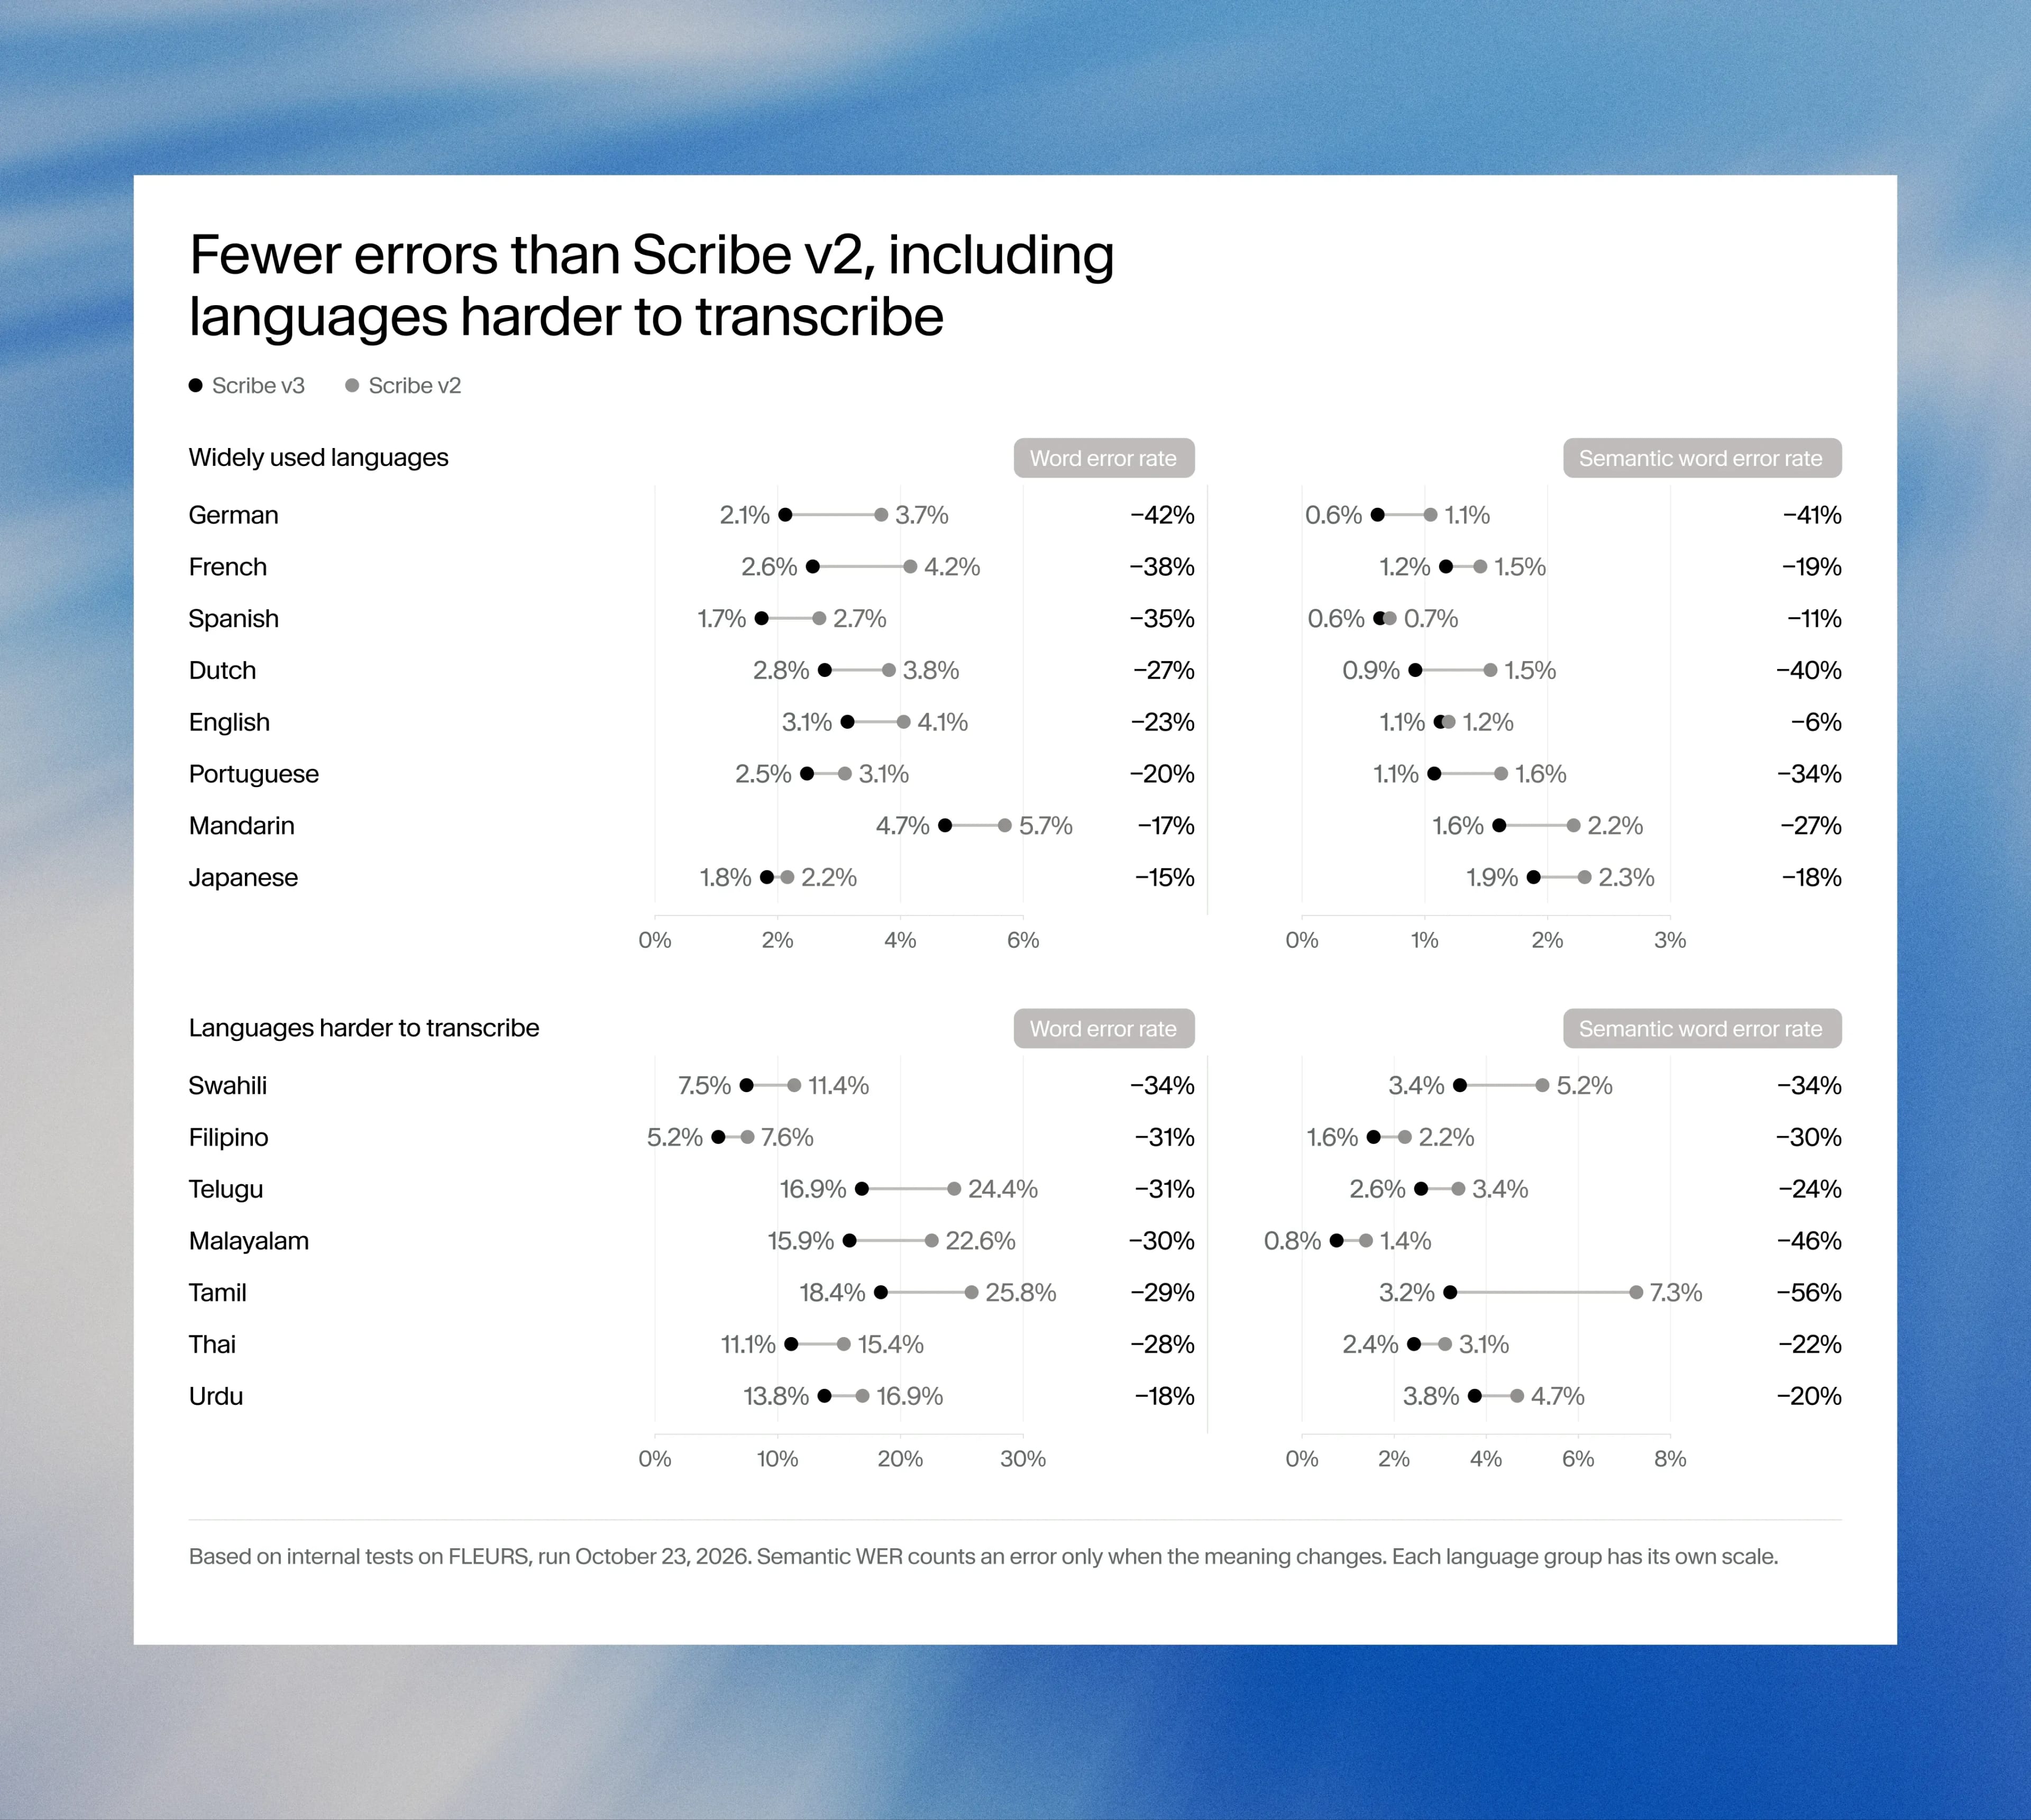
In 102 Sprachen auf FLEURS reduziert Scribe v3 die WER gegenüber Scribe v2 um 27 % und verbessert sich in jeder getesteten Sprache. In leichter zu transkribierenden Sprachen verbesserte sich Deutsch um 42 %, Spanisch um 35 % und Englisch um 23 %. In schwerer zu transkribierenden Sprachen sind die Verbesserungen größer: Swahili verbessert sich um 34 %, Tamil um 29 % und Thai um 28 %.
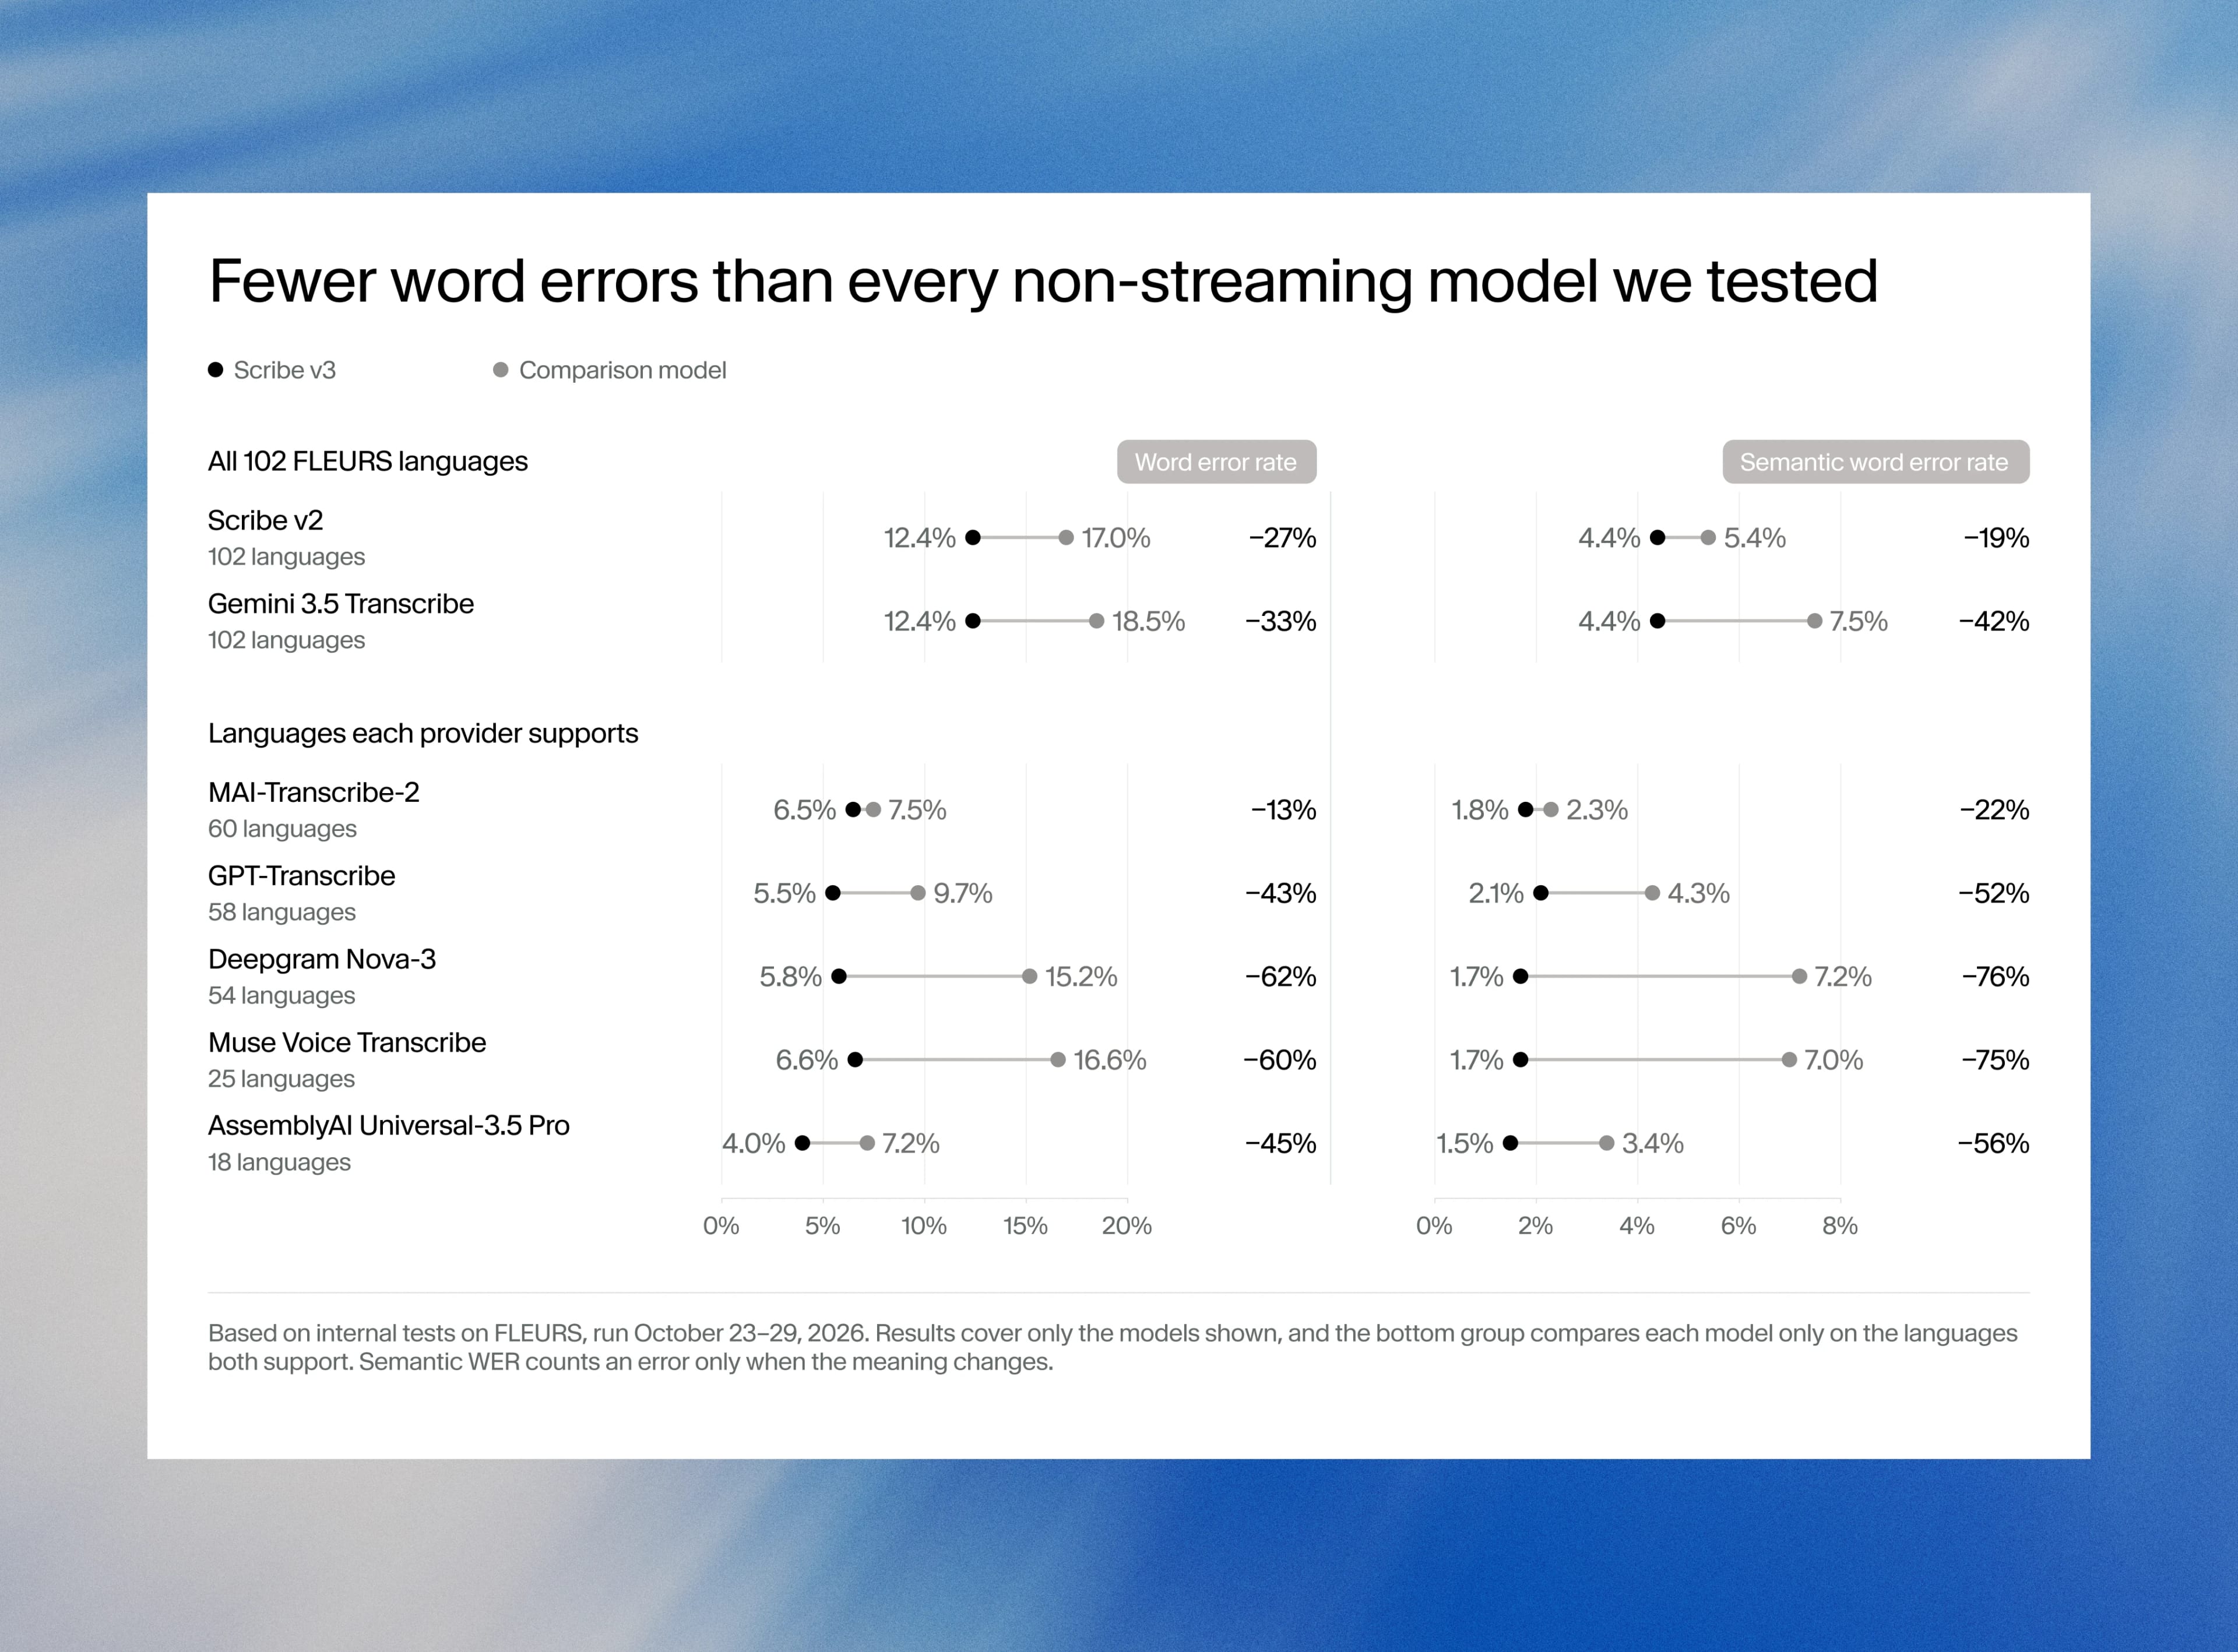
Scribe v3 macht außerdem weniger Wortfehler als jedes andere von uns getestete Batch-Modell ohne Streaming. Dabei verglichen wir jedes Modell in den Sprachen, die beide Modelle unterstützen.
Sprecherdiarisierung in Echtzeit
Im englischen Teil unseres praxisnahen Datensatzes mit 16 Sprachen liegt die Diarisierungsfehlerrate von Scribe v3 Live bei 3,1 %, verglichen mit 5,9 % bis 7,3 % bei den anderen von uns getesteten Echtzeitmodellen.
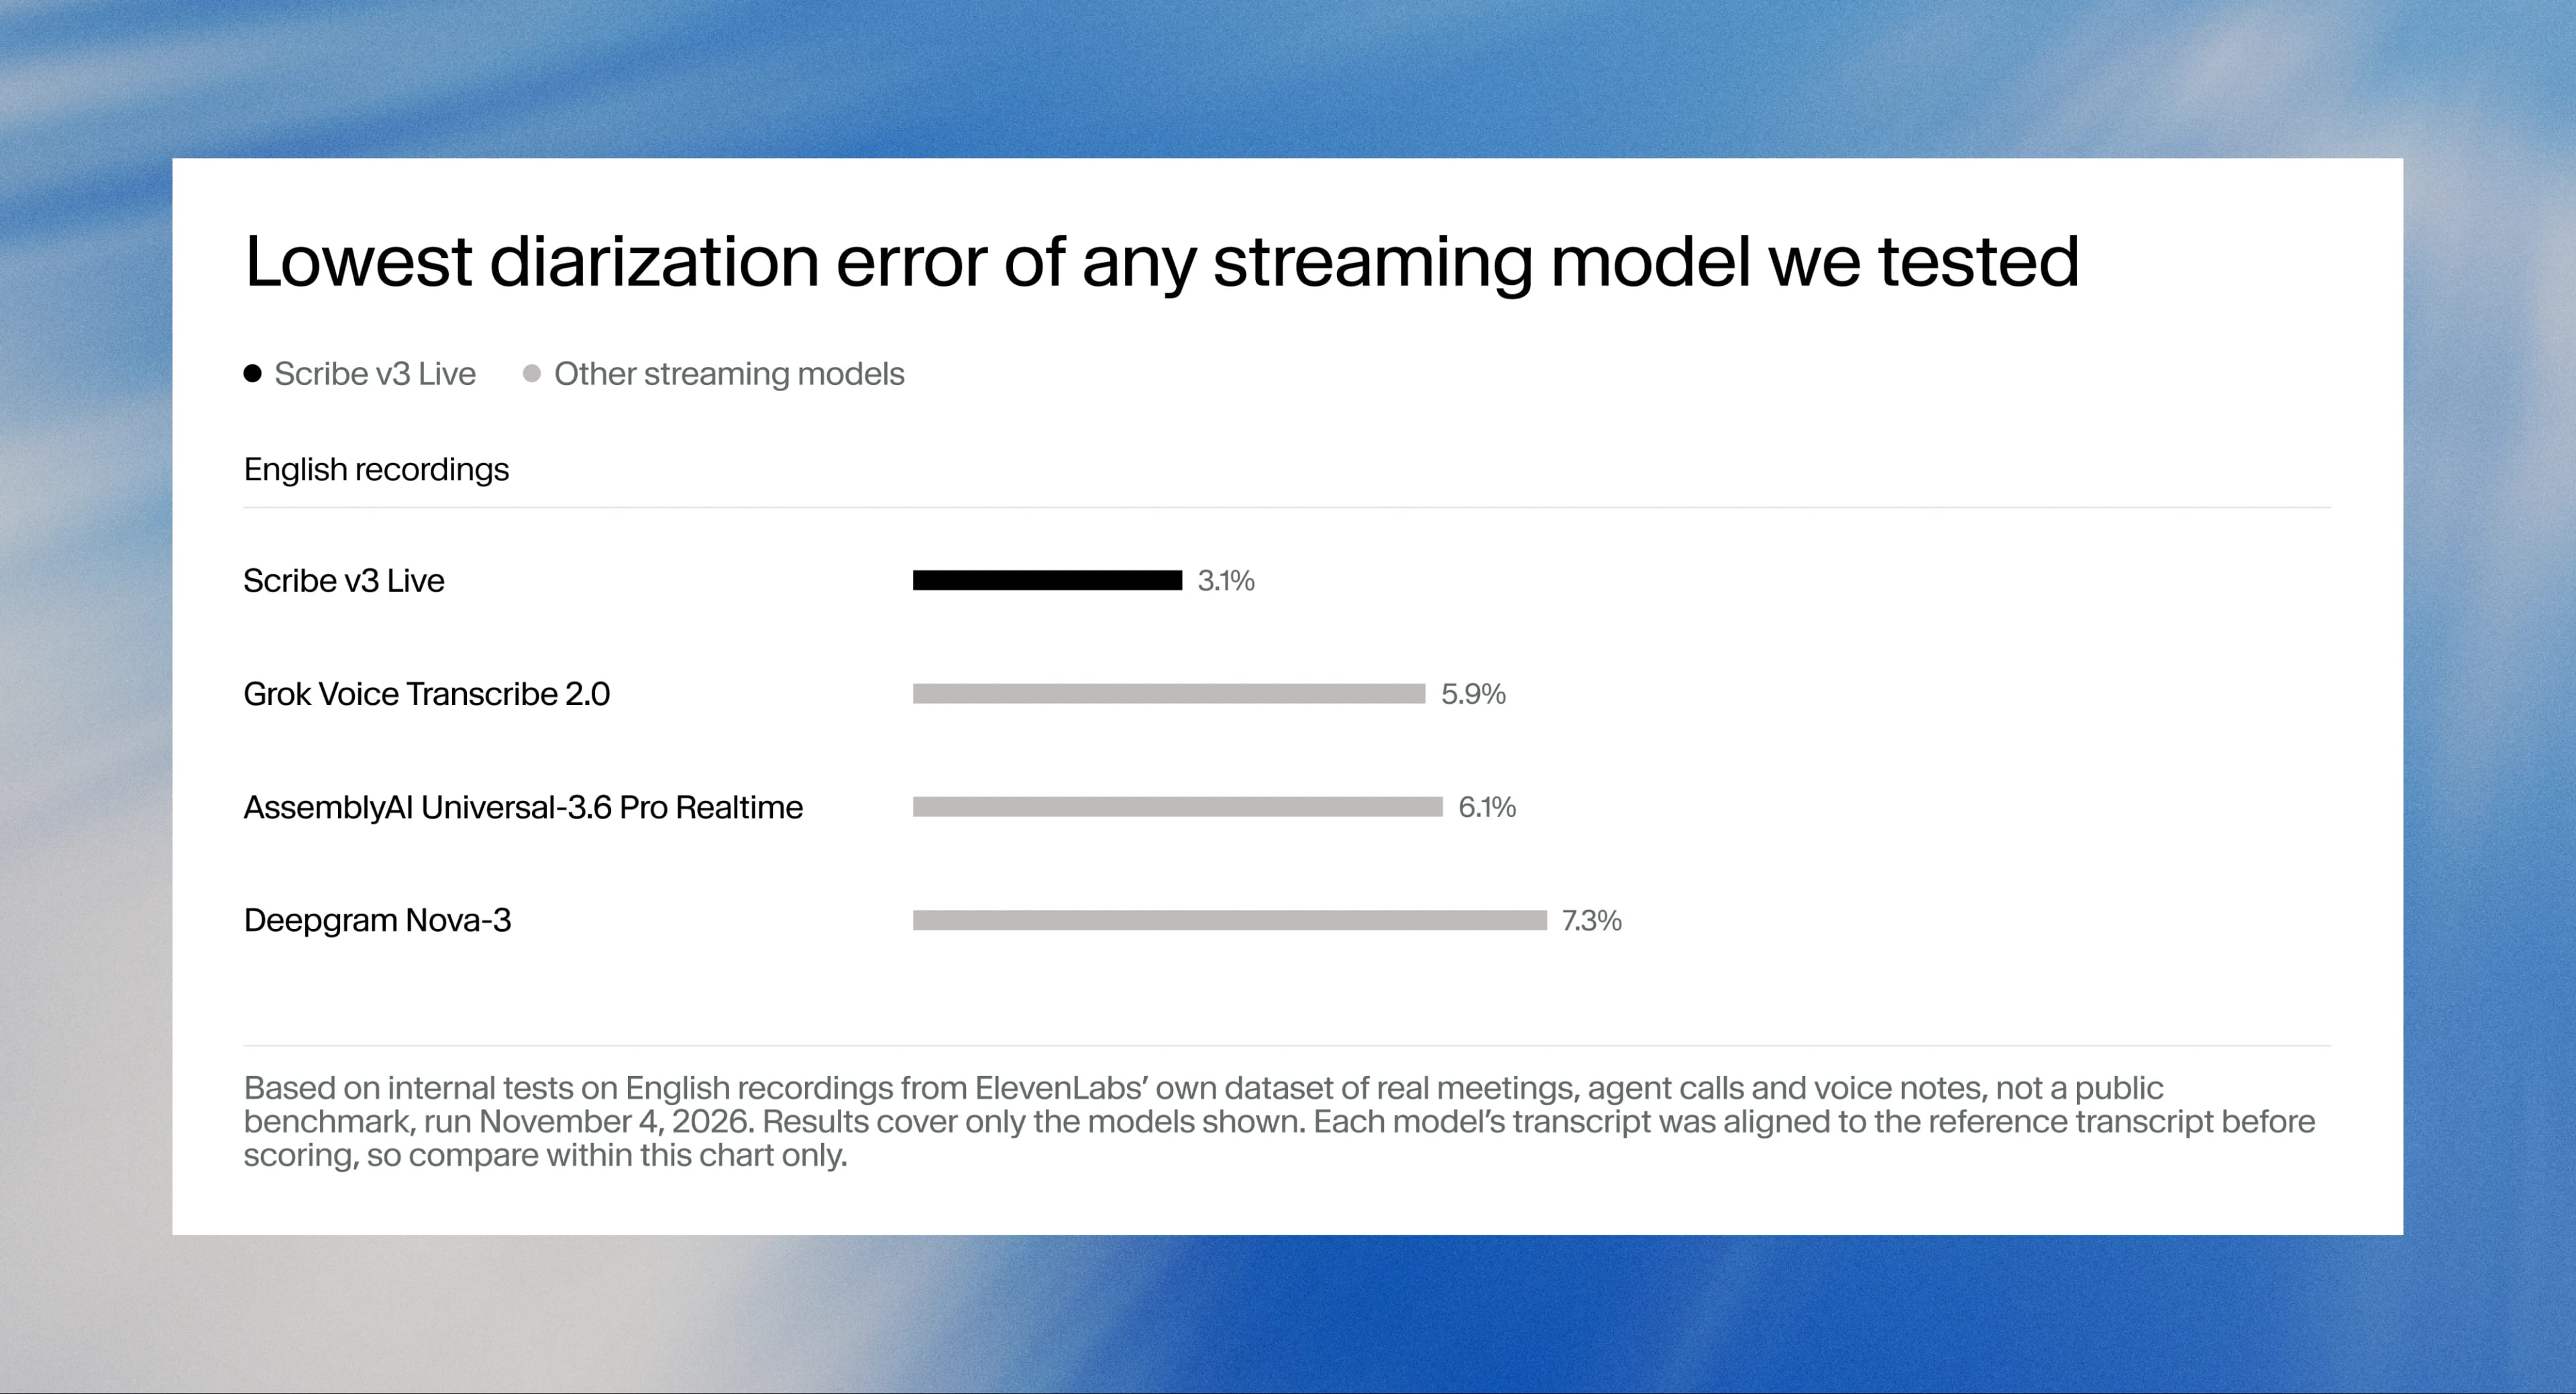
Standardwerte für Diarisierung zählen auch Transkriptionsfehler wie ausgelassene Wörter, und Echtzeitmodelle lassen mehr Wörter aus als Batch-Modelle. Um nur zu messen, ob jedes Wort dem richtigen Sprecher zugeordnet wurde, haben wir das Transkript jedes Modells vor der Bewertung mit der Referenz abgeglichen. Das senkt die Fehlerrate jedes Modells. Daher lassen sich diese Ergebnisse nicht mit den obigen Ergebnissen zur Batch-Diarisierung vergleichen.
Mehrsprachige Genauigkeit in Echtzeit
Bei Echtzeitmodellen betrachten wir zuerst die semantische WER. Ein Streaming-Modell schreibt Text, bevor es den ganzen Satz gehört hat, und jeder Anbieter formatiert Zahlen, Satzzeichen und Groß- und Kleinschreibung dabei anders. Die Standard-WER zählt diese Unterschiede als Fehler, selbst wenn die Bedeutung gleich bleibt. Deshalb ist die semantische WER der fairere Vergleich.
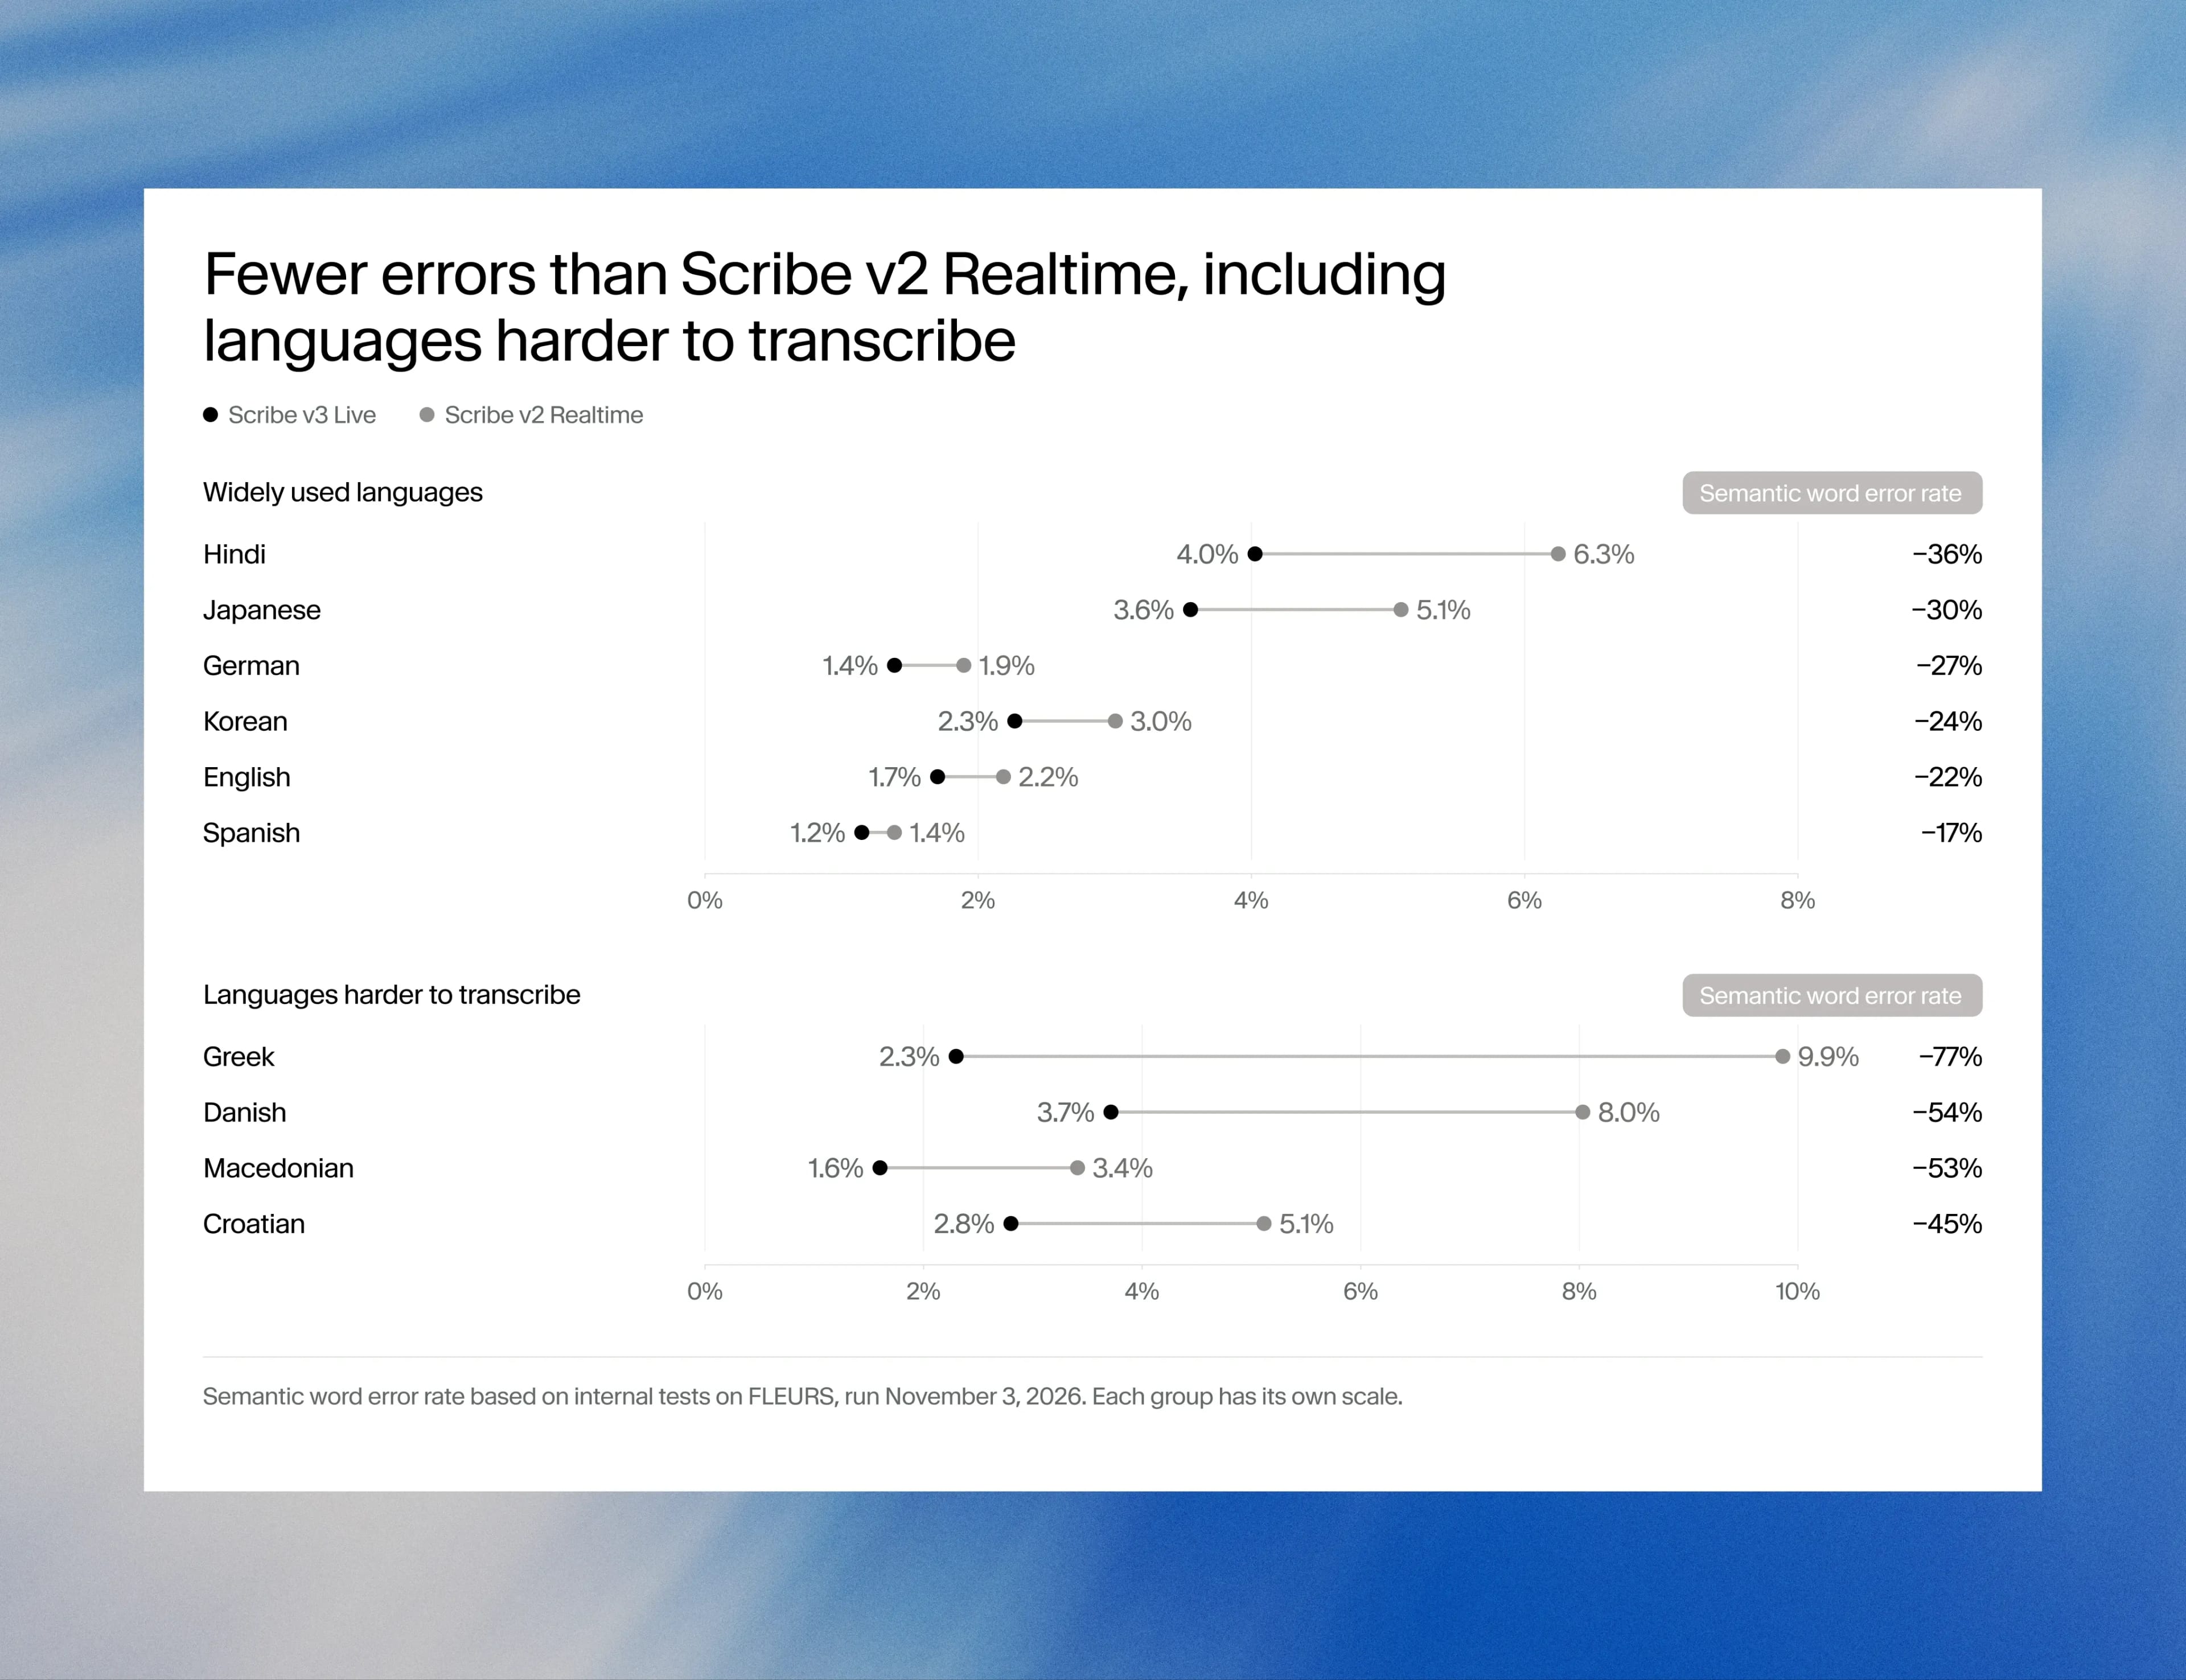
In 102 Sprachen reduziert Scribe v3 Live die semantische WER gegenüber Scribe v2 Realtime um 43 % und die WER um 31 %. Es verbessert sich in jeder Sprache und hat eine niedrigere Fehlerrate als jedes andere von uns getestete Echtzeitmodell.
Die Verbesserungen sind dort am größten, wo die Echtzeit-Transkription bisher zurücklag: Griechisch verbessert sich um 77 %, Dänisch um 54 % und Kroatisch um 45 %, während sich Hindi um 36 % verbessert.
Hinweis zur Methode: Wir haben jede Sprache vor der Mittelwertbildung einzeln bewertet, sodass alle 102 Sprachen gleich zählen. Viele veröffentlichte Ergebnisse fassen alle Clips in einem einzelnen Wert zusammen, was meist niedrigere Werte ergibt. Deshalb sind unterschiedlich gemessene Ergebnisse nicht direkt vergleichbar.
Was wenige Punkte Genauigkeit wert sind
Jede Modellveröffentlichung bringt Prozentzahlen mit sich, auch diese. Auf dem Papier ist jedoch schwer zu erkennen, was wenige Punkte in realen Szenarien bedeuten. Ein einstündiges Meeting mit 150 Wörtern pro Minute umfasst etwa 9.000 Wörter. Der Unterschied zwischen einer Wortfehlerrate von 4 % und 2 % sind also 180 falsche Wörter – drei pro Minute, in der jemand gesprochen hat. Diarisierungsfehler werden in Zeit statt in Wörtern gemessen. In demselben Meeting entspricht jeder Punkt daher 36 Sekunden Sprache unter dem falschen Namen.
Was diese Fehler kosten, hängt davon ab, wo sie auftreten. In einem Podcast-Transkript ist ein falsches Wort ein Tippfehler. In einer Ergebnis-Telefonkonferenz landet jedoch „fünfzehn“, verstanden als „fünfzig“, im Modell eines Analysten. Fehler häufen sich außerdem bei Namen, Zahlen, Akronymen und Fachjargon – genau den Wörtern, die eine Zusammenfassung oder ein Agent besonders zuverlässig erfassen muss.
Beim ersten Mal richtig in ElevenAgents
Sprachagenten spüren das besonders stark, denn eine einzige falsch verstandene Ziffer kann die Prüfung zum Beginn eines Anrufs scheitern lassen. Eneco versorgt in den Niederlanden mehr als 2 Millionen Haushalte und Unternehmen mit Energie, betreibt seinen Sprachagenten mit ElevenAgents und hat Scribe v3 Live vor der Veröffentlichung damit getestet. In echten Kundengesprächen erkannte der Agent niederländische Postleitzahlen beim ersten Versuch 40 % häufiger korrekt und Hausnummern 15 % häufiger.
„ElevenLabs ist ein echter Partner für Eneco. Gemeinsam mit den Forward Deployed Engineers arbeiten wir daran, unseren Sprachagenten weiter zu verbessern“, sagte Ruud Huigsloot, Senior Product Manager bei Eneco. „Es ist großartig, schon so früh deutliche Ergebnisse zu sehen, und wir freuen uns auf die weitere Zusammenarbeit.“
Für Unternehmen entwickelt
Scribe v3 und Scribe v3 Live laufen standardmäßig in den USA und werden für Unternehmenskunden mit Anforderungen an die Datenresidenz in isolierten Umgebungen in der EU, Indien und Singapur angeboten. Zero Retention Mode löscht Audio und Text, sobald eine Anfrage abgeschlossen ist. Beide Modelle sind durch unsere Programme für SOC 2, ISO 27001 und PCI DSS Level 1 abgedeckt, mit einem Business Associate Agreement HIPAA-konform nutzbar und für private Bereitstellungen verfügbar.
Heute starten
Scribe v3 Live ist in ElevenAgents verfügbar, und sowohl v3 als auch v3 Live sind die Standardmodelle in der ElevenLabs-App. Registrieren Sie sich, um es auszuprobieren.
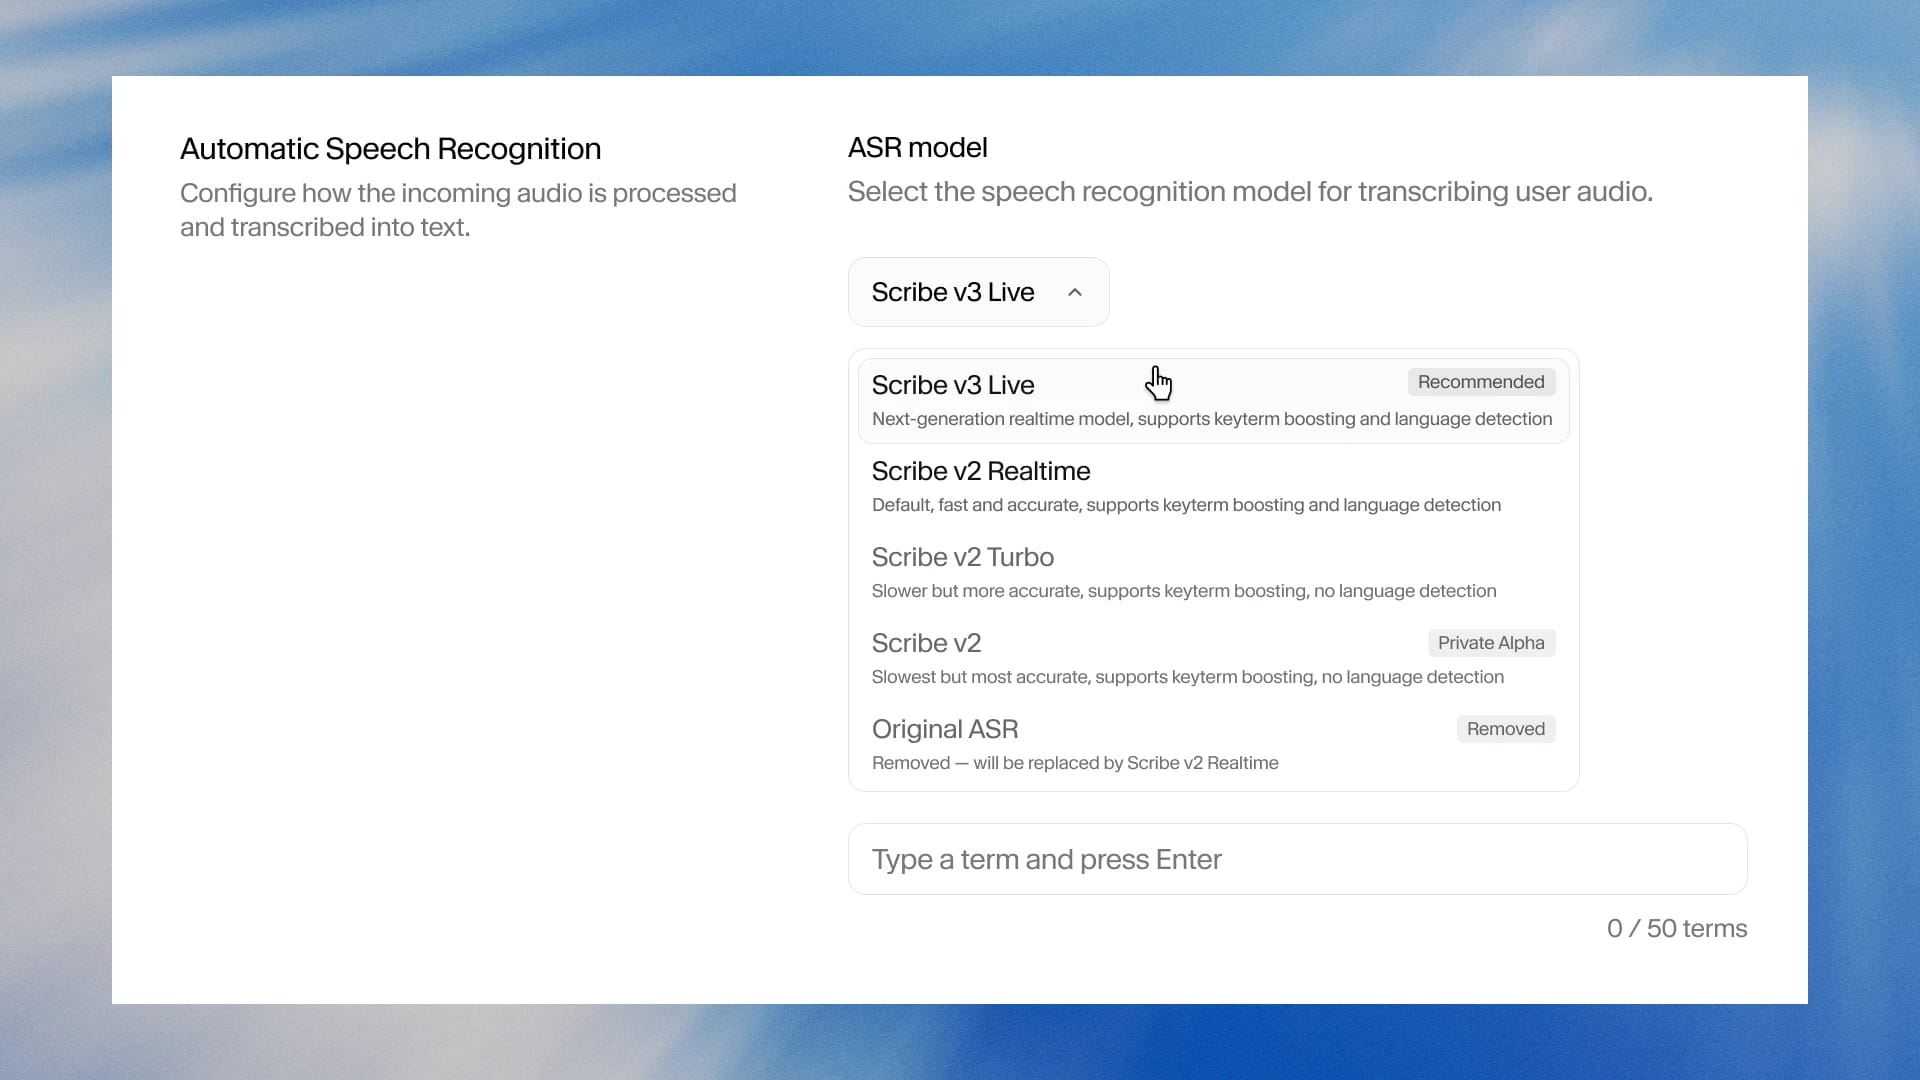
Beide Modelle sind ab heute auch in ElevenAPI verfügbar. Bestehende Integrationen werden durch Ändern der Modell-ID auf scribe_v3 oder scribe_v3_live aktualisiert.
Für Teams im Gesundheitswesen veröffentlichen wir außerdem eine für medizinische Gespräche optimierte Version von Scribe v3 Live in ElevenAgents.
Min arbeitet im Growth-Team bei ElevenLabs und verantwortet ElevenAPI sowie On-Prem/On-Device. Zuvor leitete er als zweiter GTM-Mitarbeiter das Produktmarketing bei Stainless. Davor war er als früher PMM bei WorkOS tätig und verantwortete dort Produkteinführungen, Enablement, Inhalte und Wachstum.