网络研讨会回顾:Cars24 如何用 Voice AI 自动化超 300 万分钟销售通话
- 发布时间
收听收听本文
Cars24 正在生产环境中大规模运行 语音智能体,覆盖 13 种语言。
本文回顾了 智能体幕后:Cars24 如何通过语音 AI 自动处理超过 300 万分钟的销售通话,Cars24 AI 与创新负责人 Jayesh Gupta 在活动中详细介绍了 Cars24 如何构建和部署语音 AI 系统——从最初的简单用例,到能够处理数百万分钟客户对话的 多智能体架构。
为何如此规模的语音 AI 至关重要
Cars24 是印度最大的二手车交易平台之一,业务覆盖印度、阿联酋和澳大利亚。每月售出 4,000 - 4,500 辆汽车,完成超过 100,000 次检测,并促成超过 22,000 次试驾。
这还未计入融资、交付后支持、罚款支付及汽车抵押贷款。仅销售漏斗中,每位客户的周期就长达 30 至 45 天。
75% 的买家是首次购车者。对他们而言,买车不是一笔普通交易,而是重大的财务和情感决策。这意味着 Cars24 产品的 70 - 80% 不是 App,而是对话:在漏斗每个阶段提供人工引导和协助的销售服务。
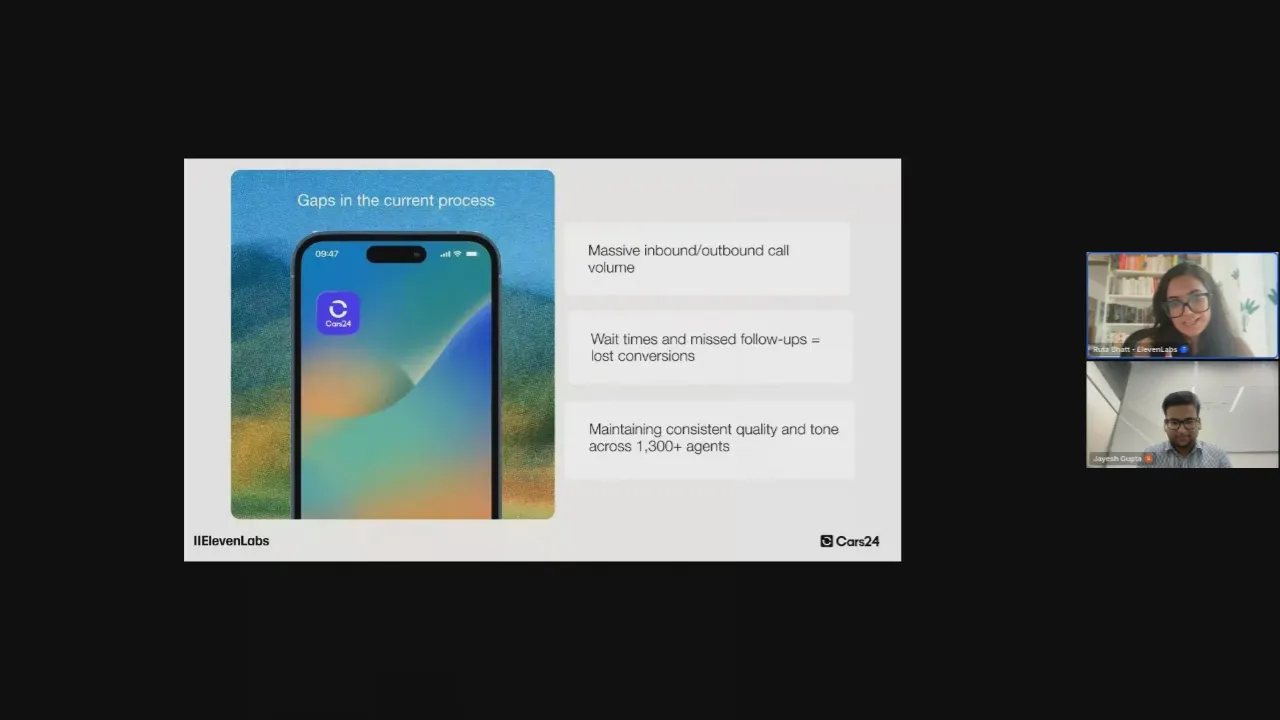
在采用 AI 智能体之前,系统正变得越来越慢。客户会打给错误的团队——例如联系销售团队处理支持需求,导致等待时间延长,客户体验低效。
等待时间越来越长,30 天销售漏斗中的跟进也会被遗漏。
从线索筛选到贷款文件,运营成本高昂且难以扩展。
如今:
- 25% 的通话量已实现自动化
- 近一半销售由语音 AI 协助完成
- 通话成本降低了 50%
演示 1:Cars24 谈判智能体
场景: Cars24 语音智能体致电一位考虑卖车的车主,用印地语谈判,说服其选择 Cars24 而非竞争平台。
演示内容:
- 智能体用印地语完成全程销售谈判
- 实时处理异议,并与其他平台竞争
- 对话自然,延迟低,没有机械式停顿
- 智能体在通话中促成卖家承诺选择 Cars24
重要性:这些智能体能主动销售、处理模糊情况、回应异议并推动转化决策——全程使用客户最习惯的语言。Cars24 发现,语言匹配能直接延长交谈时间并改善业务成果。
演示 2:通过多智能体编排进行交叉销售
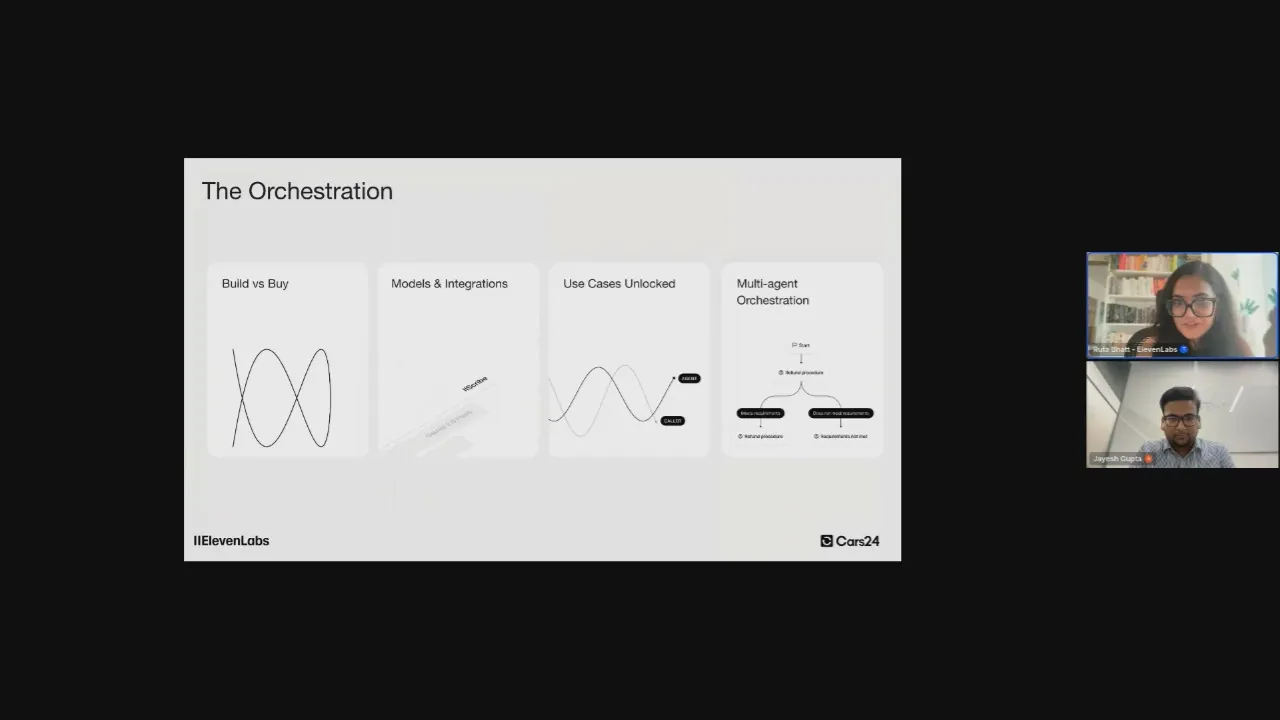
场景: 一位客户错过了检测预约。筛选智能体致电重新安排时间,发现升级购车意向后,实时将通话转接给销售智能体,后者在不丢失上下文的情况下接续对话。
演示内容:
- 智能体 1(Sneha)先处理错过的预约,并重新安排时间
- Sneha 探询意图:卖家是想升级车辆,还是因财务原因卖车?
- 客户表示有升级车辆的意向
- Sneha 提议转接至对应团队,并在通话中完成转接
- 智能体 2 获得完整上下文,继续围绕购买二手车展开对话
- 当客户要求 1 小时后回电时,智能体确认请求、总结预约状态,并顺利结束通话
重要性:这个演示展现了多智能体编排的实际运作方式。每个智能体负责一项任务,彼此传递上下文,不会重复询问或在交接时遗漏信息。Cars24 正在打造一个全天候统一号码,让客户完成卖车、买车、融资等整个流程,无需反复说明情况。
Cars24 如何构建:技术考量
Cars24 从最简单的用例开始:错过预约提醒。通话短、结果明确、出错成本低。这让他们能在扩展前先了解哪些方法有效。
当他们转向更长、更复杂的呼入通话——平均 7 分钟、有时长达 13 分钟的选车咨询——单智能体架构的局限开始显现。
mini 模型在通话超过 3 至 4 分钟后开始丢失上下文。
更大的模型则带来了延迟。
把所有内容塞进一个提示词会让系统变得脆弱:贷款流程的改动可能会影响购车流程。
他们的解决方案是多智能体编排,将对话拆分为多个阶段:
- 使用 mini 模型的小型筛选智能体捕捉初步意图
- 客户投入对话并愿意接受稍长等待后,由更大的模型接手进行需求探索
- 仅当涉及价格或融资时,才激活第 3 个专注贷款的智能体。
每个智能体各司其职,一个智能体的改动不会影响其他智能体。
技术栈(由 ElevenAgents 平台编排):
- 语音转文本:ElevenLabs Scribe v2 实时语音转写,因其在覆盖 13 种语言、嘈杂的二线和三线环境中的准确性而被选用
- 文本转语音:ElevenLabs Flash 2.5,近期已升级至 Eleven v4 Turbo,销售表现获得可衡量的提升
- LLM:大多数用例使用 GPT-4.1 mini;需要更深层推理的长时间需求探索通话使用 GPT-4o 或同等模型
- 电话系统:使用基于 WebSockets 的 24 kHz PCM 以保证音质;在印度采用 Twilio、Exotel 和 Plivo 等服务商
- 集成:通过自定义 API 调用接入 ElevenLabs Agents 平台,支持 MCP,并为澳大利亚市场原生集成 HubSpot
- 向量数据库:Qdrant,对超过 100 万个向量的大型数据集使用二进制量化,以降低延迟和成本
选择 ElevenLabs Agents,而非自行组装独立的 STT、LLM 和 TTS 组件,关键原因只有一个:延迟。
即使采用相同的底层模型,自行搭建管线也会持续让延迟超过 1 秒。
ElevenLabs 平台将模型与 编排层 整合在一起,使延迟降低了 30% 至 40%。这一改进直接带来 30% 至 40% 的转化提升。
Cars24 的最佳实践
1. 从失败成本最低的地方开始。Cars24 的首个用例是错过预约提醒——简短、简单、风险低。在这里验证模型为内部建立了信心,也让团队能在涉足销售漏斗中更高价值环节前积累经验。
2. 在真实客户身上运行,而非模拟环境。内部测试无法复现真实对话的复杂性。Cars24 在 10% 的真实流量上运行试点,接受短期下滑,并利用真实反馈不断迭代。
3. 将提示词长度设为硬性约束。 对于时长不足 2 分钟的通话,Cars24 将提示词限制在 4,000 至 5,000 个 token。更长的提示词会拖慢模型,且无法稳定改善结果。如果一个用例需要更多内容,就再构建一个智能体。
4. 将常见答案放在提示词中,而非知识库中。对于客户最常问的问题,直接将答案写入提示词。工具调用和 RAG 检索则留给剩余的 20%。这样可消除大多数知识查询带来的延迟峰值。
5. 预先录制第一条消息。ElevenLabs Agents 可在通话接通前预生成并缓存开场消息。再将第一条消息设为不可打断,可减少因网络延迟或过早打断导致的早期流失。
6. 在每通电话中嵌入评估。Cars24 对 100% 的通话使用 ElevenLabs Agents 评估,跟踪是否遵循 SOP、客户是否表现出沮丧情绪,以及是否发生故障。未通过的评估会触发人工审核,每天还会审计随机样本。团队因此能保持主动,而非被动应对。
7. 分阶段扩展。新智能体部署按 5%、10%、20%、50%、100% 逐步上线,每个阶段保持 2 天,确认评估指标稳定后再进一步扩大。
8. 不要联系未要求接收消息的客户。 Cars24 的每通外呼都面向已进入销售漏斗的人。未经请求的 AI 触达会增加投诉并损害信任。原则很简单:如果对方尚未参与,就不致电。
9. 当客户询问是否在与 AI 对话时,要如实回答。 Cars24 智能体被问及时会确认自己是虚拟助手。如果客户希望与人工沟通,通话会立即转接。
10. 将 AI 支出视为投资项目,而非成本。Cars24 现已将 AI 成本纳入年度运营计划,并制定与可衡量业务成果挂钩的具体任务。每次部署都应推动一项实际指标。
观看完整活动
观看完整活动请点击此处。
Ruta leads enterprise growth for ElevenLabs across Asia Pacific, helping top companies integrate AI Audio into their future. Previously, she led marketing at Jio Haptik, an AI SaaS company, and was a founding member at Libereka.