Qu'est-ce que la transcription multilingue et comment fonctionne-t-elle ?
- Rédigé par
- Jack Limebear
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Que vous organisiez une conférence internationale ou souhaitiez simplement conserver des comptes rendus précis de conversations avec le support client, dans toutes les langues, la transcription multilingue est plus nécessaire que jamais.
En convertissant les données audio en texte précis et consultable, les outils de transcription multilingue transforment les conversations en documents exploitables. La technologie qui permet la transcription dans différentes langues a évolué parallèlement aux recherches croissantes sur les modèles Speech to Text (STT). Les développeurs peuvent désormais intégrer de puissantes API STT à leurs workflows afin de créer des pipelines de transcription multilingue complexes.
Dans cet article, nous expliquerons ce qu'est la transcription multilingue, son fonctionnement via une application de bureau et une API, ainsi que son rôle essentiel pour les entreprises du monde entier.
En résumé
- La transcription multilingue transforme un fichier audio en texte écrit dans plusieurs langues.
- Les meilleurs outils de transcription multilingue offrent des fonctionnalités supplémentaires telles que la diarisation des locuteurs, l'ajout de termes clés et la détection d'entités.
- Vous pouvez utiliser des outils de transcription multilingue en ligne ou intégrer une API Speech to Text à vos workflows de développement.
- La transcription automatique offre rapidité et passage à l'échelle, tandis que la transcription humaine peut être utile dans des cas complexes impliquant plusieurs locuteurs qui se chevauchent.
- La précision de la transcription multilingue se mesure avec le taux d'erreur par mot (WER), qui varie selon la langue.
Qu'est-ce que la transcription multilingue et pourquoi est-elle importante ?
La transcription multilingue convertit l'audio parlé en texte écrit dans plusieurs langues. Les systèmes d'intelligence artificielle détectent automatiquement la ou les langues parlées et transcrivent l'audio. Le résultat d'un système STT multilingue peut être une transcription verbatim ou inclure une couche de traduction afin d'unifier les langues d'entrée dans une sortie commune.
Par exemple, lors d'une conférence internationale, des intervenants peuvent recevoir une question dans leur langue maternelle. L'outil Speech to Text multilingue peut soit transcrire directement les propos de chaque intervenant dans sa propre langue, soit produire un résultat unique dans une langue cible que le public peut lire. Ces outils STT permettent aux organisations de rendre leurs événements plus accessibles.
ElevenLabs intègre directement des fonctionnalités STT multilingues à notre modèle Speech to Text Scribe v2. Scribe v2 prend en charge la détection automatique de la langue, ce qui signifie qu'un même fichier peut contenir plusieurs langues. Vous pouvez indiquer les langues présentes dans un extrait audio ou laisser le paramètre sur « Détecter » afin que notre système identifie les langues présentes dans le fichier importé.
Avec ElevenAPI, le paramètre language_code utilise par défaut la prédiction automatique. Si vous connaissez déjà les langues présentes, les indiquer à l'avance améliore les performances.
Pourquoi la transcription multilingue est importante
Des études récentes suggèrent que le marché mondial des services de transcription atteindra 6 milliards de dollars d'ici 2035. Cette croissance s'explique notamment par le vaste éventail de cas d'usage qui tirent parti du STT multilingue.
La transcription multilingue est importante pour plusieurs raisons pratiques :
- Accessibilité : Les légendes et les sous-titres nécessitent des transcriptions multilingues précises avant de commencer la traduction ou le doublage. Le STT multilingue peut considérablement améliorer l'accessibilité pour les utilisateurs.
- Recherchabilité : L'audio transcrit devient du texte indexable : vos appels au support ou réunions peuvent ainsi devenir des ressources utiles pour d'autres personnes. La recherchabilité est particulièrement importante à mesure que les systèmes IA font émerger davantage de données issues de documents internes ; une transcription claire contribue à constituer une référence complète pour les données d'entrée.
- Conformité : De nombreux secteurs réglementés ont besoin de traces écrites auditables des interactions orales. Le STT multilingue vous permet de répondre à ce besoin dans toutes les langues de vos clients. Par exemple, la Financial Conduct Authority exige des établissements financiers qu'ils conservent les enregistrements et les transcriptions des conversations téléphoniques.
- Pipelines de contenu internationaux : Qu'il s'agisse de doublage ou de sous-titrage, les workflows commencent toujours par une transcription initiale très précise. Des outils de transcription multilingue de qualité permettent de franchir la première étape de ces workflows plus larges de distribution internationale de contenu.
La transcription multilingue est indispensable dans de nombreux secteurs : opérateurs télécoms qui transcrivent les appels au support, entreprises de services financiers qui respectent les exigences de conformité, équipes de santé qui documentent les interactions avec les patients, ou encore studios de cinéma qui localisent des contenus. Que vous travailliez dans le SaaS, le voyage ou les services publics, un système performant garantit des transcriptions de haute qualité et précises.
Fonctionnalités clés à rechercher dans les solutions de transcription multilingue
Les outils de transcription multilingue doivent pouvoir s'adapter à l'entrée audio qu'ils traitent, identifier dynamiquement les langues et les transcrire avec une grande précision.
Voici les principales fonctionnalités à rechercher dans une solution de transcription multilingue de qualité :
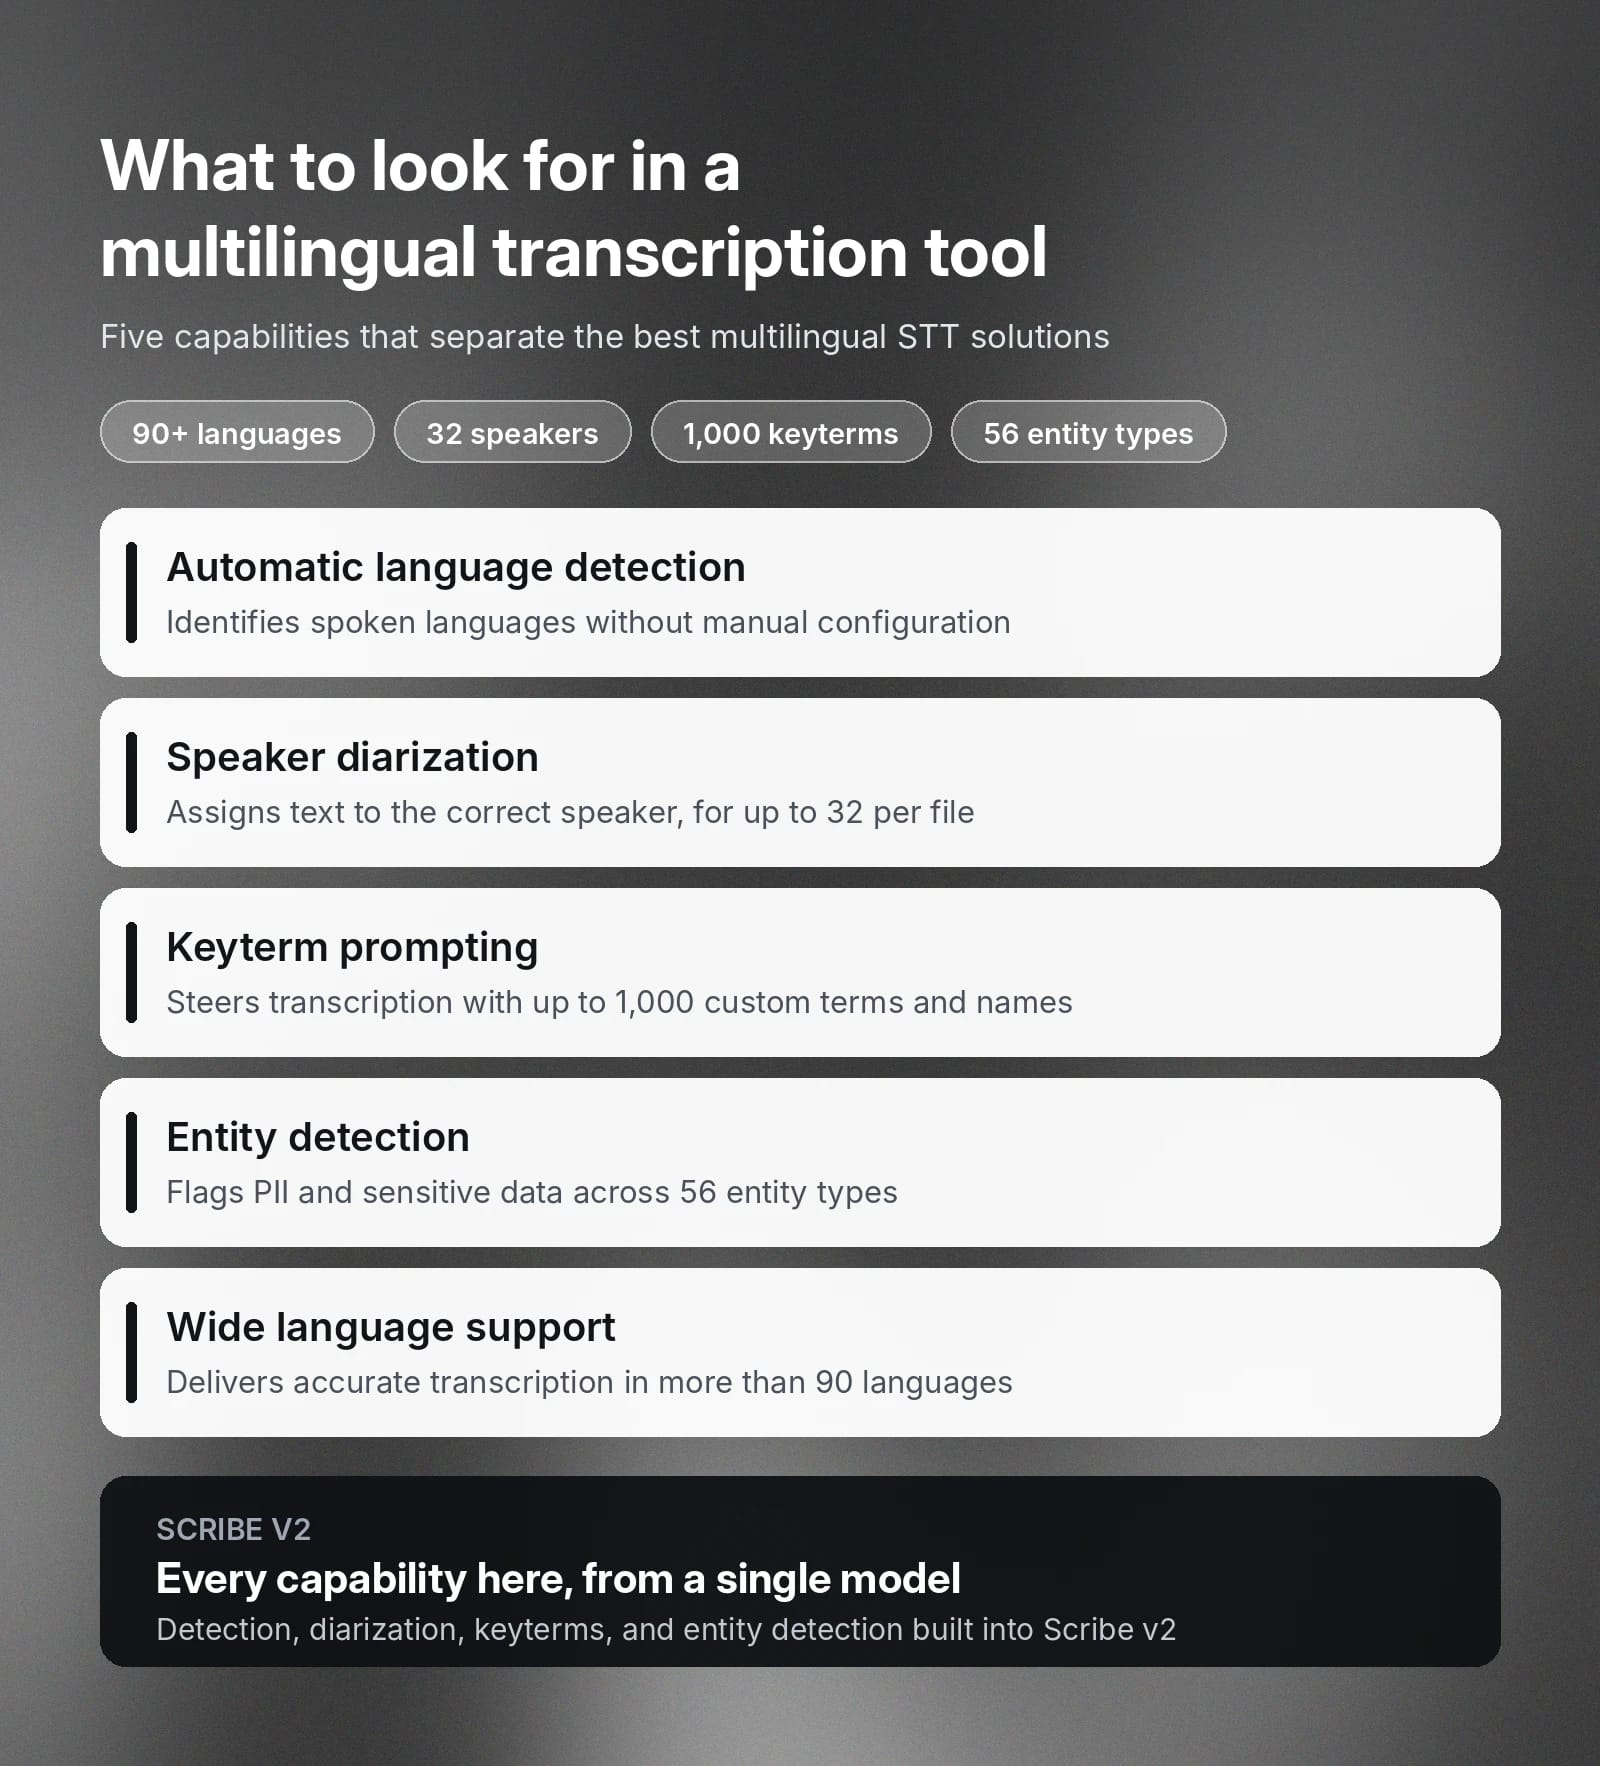
- Détection automatique de la langue : Le système doit identifier lui-même la langue parlée, plutôt que de bloquer la transcription jusqu'à ce que l'utilisateur fournisse une langue source. Lorsque la langue d'entrée est inconnue ou qu'un extrait contient plusieurs langues, la détection automatique de la langue vous permet de gérer plusieurs langues sans configuration manuelle.
- Diarisation des locuteurs : La diarisation attribue le texte transcrit au bon locuteur dans un fichier, ce qui est important pour toute transcription audio contenant plusieurs locuteurs. Par exemple, vous pouvez avoir plusieurs personnes sur un panel à identifier, ou simplement devoir distinguer clairement les moments où un client et un agent du support prennent la parole. Scribe v2 prend en charge la diarisation pour jusqu'à 32 locuteurs dans un même fichier.
- Ajout de termes clés : Les termes clés permettent aux utilisateurs de saisir manuellement un vocabulaire spécifique, tel que des noms de produits ou des noms propres, afin d'assurer une transcription correcte. Dans les systèmes de traitement par lots, Scribe v2 accepte jusqu'à 1 000 termes clés, tandis que Scribe v2 Realtime pour la transcription en direct en accepte jusqu'à 50.
- Détection d'entités : La détection d'entités identifie des mots spécifiques dans une transcription. Elle est essentielle aux efforts de conformité et de sécurité visant à protéger les données sensibles. Consultez la documentation ElevenLabs sur la détection d'entités pour obtenir le détail des 56 types d'entités pris en charge.
- Large prise en charge des langues : Sans surprise, les meilleures solutions STT multilingues peuvent transcrire un très grand nombre de langues. À titre de référence, Scribe v2 offre une transcription précise dans plus de 90 langues.
Ensemble, ces fonctionnalités couvrent un large éventail de cas d'usage et vous permettent de tirer parti d'un système STT fiable qui couvre plusieurs langues avec précision.
Comment transcrire efficacement de l'audio dans différentes langues
La méthode la plus efficace pour transcrire de l'audio dans différentes langues dépend de votre charge de travail. Pour des fichiers ponctuels traités par lots, la page ElevenLabs Speech to Text vous permet d'importer un fichier et de recevoir rapidement sa transcription.
Dans ElevenCreative, transcrire de l'audio est aussi simple que :
- Importer votre audio : Accédez à Speech to Text et cliquez sur « Transcrire des fichiers ».
- Sélectionner vos options : Sélectionnez la langue principale ou laissez « Détecter », activez les événements audio si vous souhaitez baliser les rires ou d'autres événements non verbaux, puis ajoutez des termes clés si nécessaire.
- Consulter vos résultats : Après avoir importé vos fichiers, vous pourrez cliquer sur le nom du fichier audio pour afficher sa transcription. Vous pourrez alors relire et affiner directement la transcription dans l'éditeur de transcription, puis l'exporter au format requis par chaque workflow en aval.
Pour la transcription programmatique ou à grand volume, utilisez l'API Speech to Text. Voici quelques éléments pour concevoir vos pipelines de production :
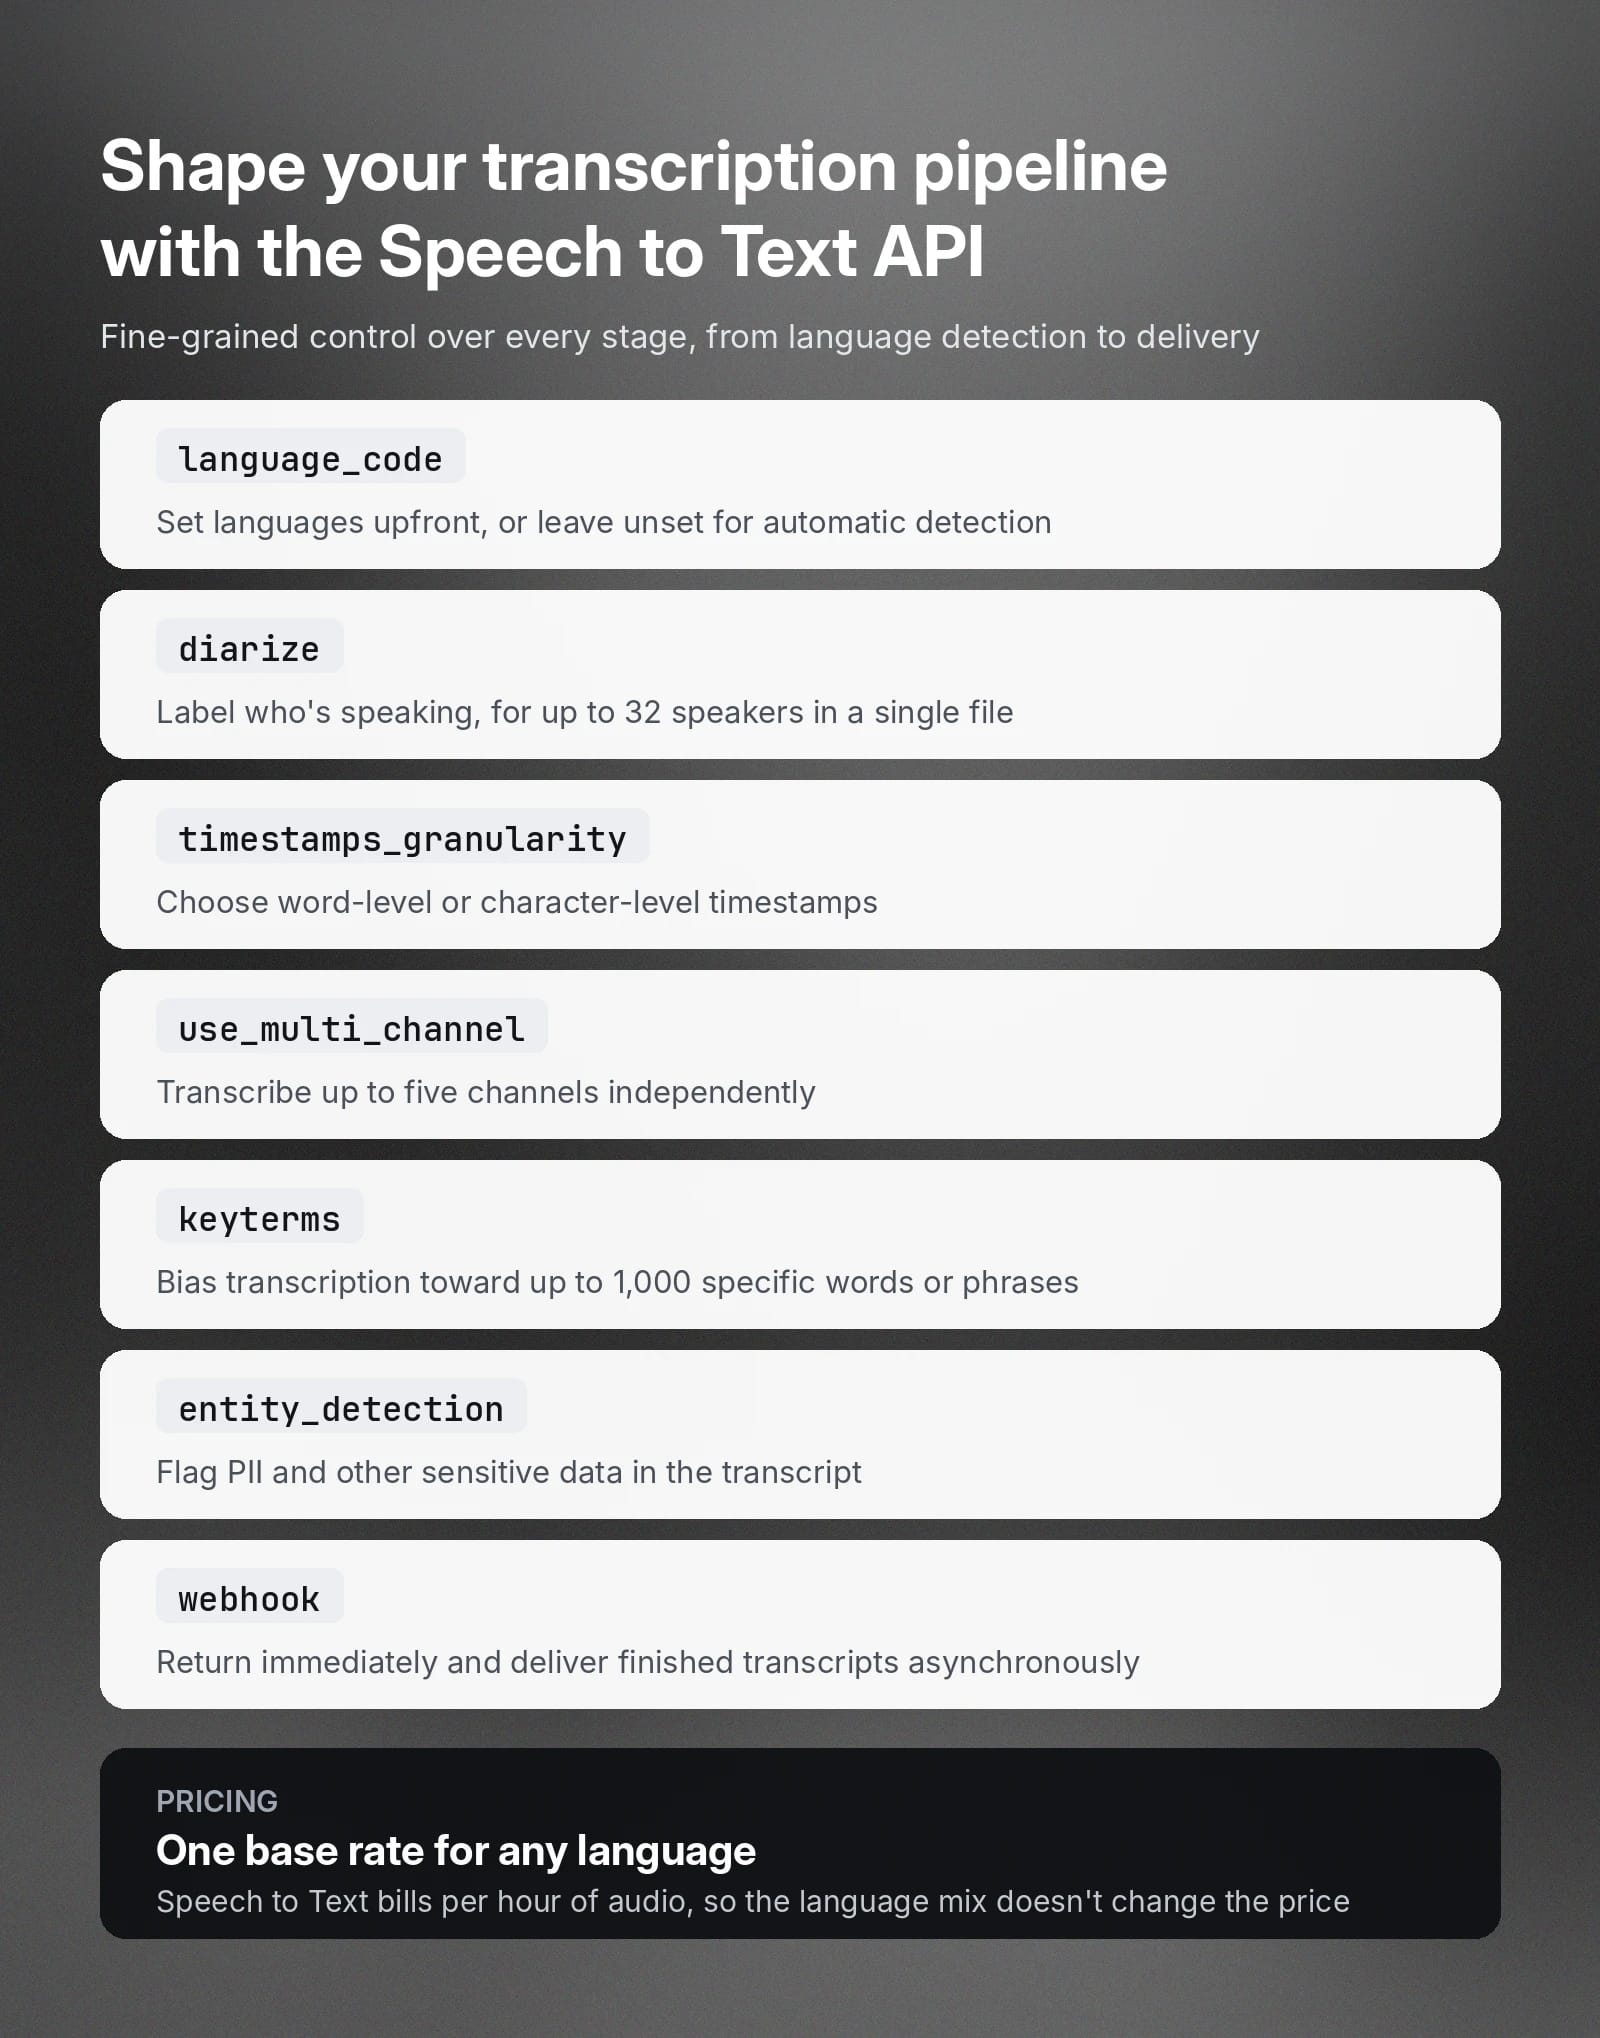
- Sélection du modèle : Le paramètre model_id permet de choisir entre scribe_v2 et scribe_v1. Le pipeline peut ainsi cibler un modèle précis plutôt que de s'appuyer sur une valeur par défaut susceptible de changer au fil du temps.
- Gestion des langues : Le paramètre language_code accepte un code ISO-639-1 ou ISO-639-3 et utilise la détection automatique s'il n'est pas renseigné. Fournir directement une langue peut améliorer les performances.
- Contrôles de diarisation des locuteurs : Définir diarize sur true indique quel locuteur parle. Le paramètre num_speakers limite le nombre de locuteurs de 1 à 32. Pour un contrôle plus précis, vous pouvez utiliser le paramètre diarization_threshold afin d'ajuster le compromis entre des locuteurs distincts.
- Précision des horodatages : Le paramètre timestamps_granularity contrôle le niveau de détail de sortie, avec des options d'horodatages au niveau du mot ou du caractère horodatages (ou aucun).
- Traitement asynchrone à grande échelle : Définir webhook sur true renvoie immédiatement la réponse et transmet la transcription terminée au webhook configuré une fois le traitement achevé. Le champ webhook_metadata associe des données de suivi personnalisées, telles que votre ID de tâche interne, à chaque réponse de webhook.
- Audio multicanal : Définir use_multi_channel sur true transcrit chaque canal indépendamment, jusqu'à cinq canaux, et associe à chaque mot un champ channel_index.
- Gestion de contenu spécialisé : Le paramètre keyterms oriente la transcription vers jusqu'à 1 000 mots ou expressions spécifiques, entity_detection signale les informations personnelles identifiables et d'autres données sensibles, et no_verbatim supprime les mots de remplissage et les faux départs du résultat.
Ensemble, ces paramètres vous donnent un contrôle précis sur chaque étape du pipeline. De la détection de la langue et l'identification des locuteurs au formatage et à la livraison des résultats, l'API Speech to Text s'adapte à vos besoins de production.
Langues prises en charge par les services de transcription
La couverture linguistique est un facteur majeur de différenciation des meilleurs outils de transcription multilingue. ElevenLabs Scribe v2 et Scribe v2 Realtime prennent tous deux en charge plus de 90 langues ; la documentation Speech to Text contient la liste complète des langues prises en charge.
Des langues telles que l'anglais, l'espagnol, l'italien, le polonais, le français et l'allemand disposent de volumes de données d'entraînement plus importants, ce qui se traduit souvent par une meilleure précision STT. Certaines langues, comme l'amharique, le ganda, le yoruba et le zoulou, présentent des taux de précision inférieurs à ceux des langues citées précédemment.
Les modèles ElevenLabs Scribe affichent un taux d'erreur par mot inférieur à 5 % pour 36 langues et un WER inférieur à 10 % pour 21 autres. Consultez le détail de la prise en charge des langues par ElevenLabs pour en savoir plus sur les langues prises en charge et leur WER.
Combien coûte la transcription multilingue ?
En règle générale, le prix de la transcription automatique dépend de la durée du fichier audio, plutôt que du nombre de mots ou de langues concernées. ElevenLabs facture Speech to Text selon la durée audio, par heure d'audio. Les tarifs varient selon le forfait et le modèle.
Voici les principaux facteurs qui influencent le prix de la transcription multilingue :
- Fonctionnalités de transcription supplémentaires : Certains fournisseurs facturent des frais supplémentaires pour l'activation de certaines fonctionnalités, telles que la détection d'entités.
- L'audio multicanal est facturé par canal : Lorsque vous activez use_multi_channel, chaque canal est facturé indépendamment. Un enregistrement à deux canaux coûte donc environ deux fois plus qu'un enregistrement à un seul canal.
- La langue ne modifie pas le tarif de base : La tarification fondée sur la durée permet au STT multilingue de prendre en charge n'importe quelle langue tout en conservant le même tarif horaire, ce qui simplifie la budgétisation des équipes travaillant dans plusieurs langues.
Pour en savoir plus sur le coût de Speech to Text d'ElevenLabs, consultez notre page des tarifs.
Commencez avec ElevenAPI pour une transcription multilingue précise
ElevenAPI intègre la transcription multilingue à n'importe quel workflow de production en quelques étapes. Que vous transcriviez du contenu destiné à des archives médias internationales, des interactions avec le support client, des réunions ou des entretiens de recherche, ou que vous recherchiez simplement une reconnaissance vocale précise dans des dizaines de langues, notre moteur STT multilingue peut vous aider.
Découvrez l'API ElevenAPI Speech to Text pour connaître toutes ses fonctionnalités, ou créez un compte ElevenLabs pour commencer dès aujourd'hui à transcrire de l'audio multilingue.
FAQ sur la transcription multilingue

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.