Présentation de Scribe v3 et v3 Live, nos modèles Speech to Text les plus précis
- Rédigé par
- Min Kim
- Publié
ÉcouterÉcouter cet article
Les produits fondés sur l'audio commencent par une transcription : notes de réunion, agents vocaux, doublage, documentation clinique et archives de diffusion couvrant des décennies de contenu. Obtenir cette transcription correctement dès la première fois est essentiel, car chaque erreur se répercute en aval, où elle coûte bien plus cher à corriger.
Mais l'audio réel est complexe. Plusieurs personnes parlent en même temps lors d'une réunion, un client se trouve dans une rue animée et s'interrompt au milieu d'une phrase, ou un appel au support réunit deux personnes qui ne parlent pas dans leur langue maternelle.
Aujourd'hui, ElevenLabs lance deux nouveaux modèles Speech to Text conçus précisément pour ces conditions :
- Scribe v3, pour l'audio enregistré, génère 27 % d'erreurs de mots en moins que Scribe v2 dans 102 langues et fournit les étiquettes de locuteurs les plus précises parmi tous les modèles que nous avons testés,
- Scribe v3 Live est la version à faible latence pour l’audio en temps réel et génère 43 % d’erreurs en moins que Scribe v2 Realtime. Il intègre également pour la première fois la diarisation des locuteurs (pour identifier qui a dit quoi) et une détection des tours de parole améliorée.
Scribe v3 Live est disponible dès aujourd'hui dans ElevenAgents. Les deux modèles sont également disponibles dans ElevenAPI, où passer de Scribe v2 ne nécessite qu'une modification d'une ligne de l'ID du modèle.
Les retours qui ont façonné Scribe v3
Scribe a assuré des centaines de millions d'heures de transcription pour des applications de prise de notes de réunion, des centres de contact, des outils de documentation clinique et des agents vocaux. Quel que soit le cas d'usage, les équipes qui s'appuient sur lui demandaient toujours les mêmes cinq choses.
Les équipes de réunion et de prise de notes voulaient une meilleure diarisation lors d'échanges rapides et avec trois locuteurs ou plus. Les équipes d'agents vocaux expliquaient qu'un minuteur de silence coupe les appelants lorsqu'ils s'interrompent au milieu d'une phrase ou ralentissent pour énoncer un chiffre. Les équipes développant des produits en direct sacrifiaient la précision à la vitesse, car le temps réel était sensiblement moins performant que le traitement par lots. En Inde, les clients voulaient que l'hindi atteigne le niveau de l'anglais, même lorsque les appelants passent de l'un à l'autre au milieu d'une phrase. Beaucoup souhaitaient aussi mieux contrôler la sortie, des nombres écrits sous forme de « 123 » aux listes de termes clés assez longues pour un catalogue de produits ou une liste de médicaments.
Étiquettes de locuteurs, détection des tours de parole et contrôle accru de la sortie
Une diarisation fiable dans une pièce animée
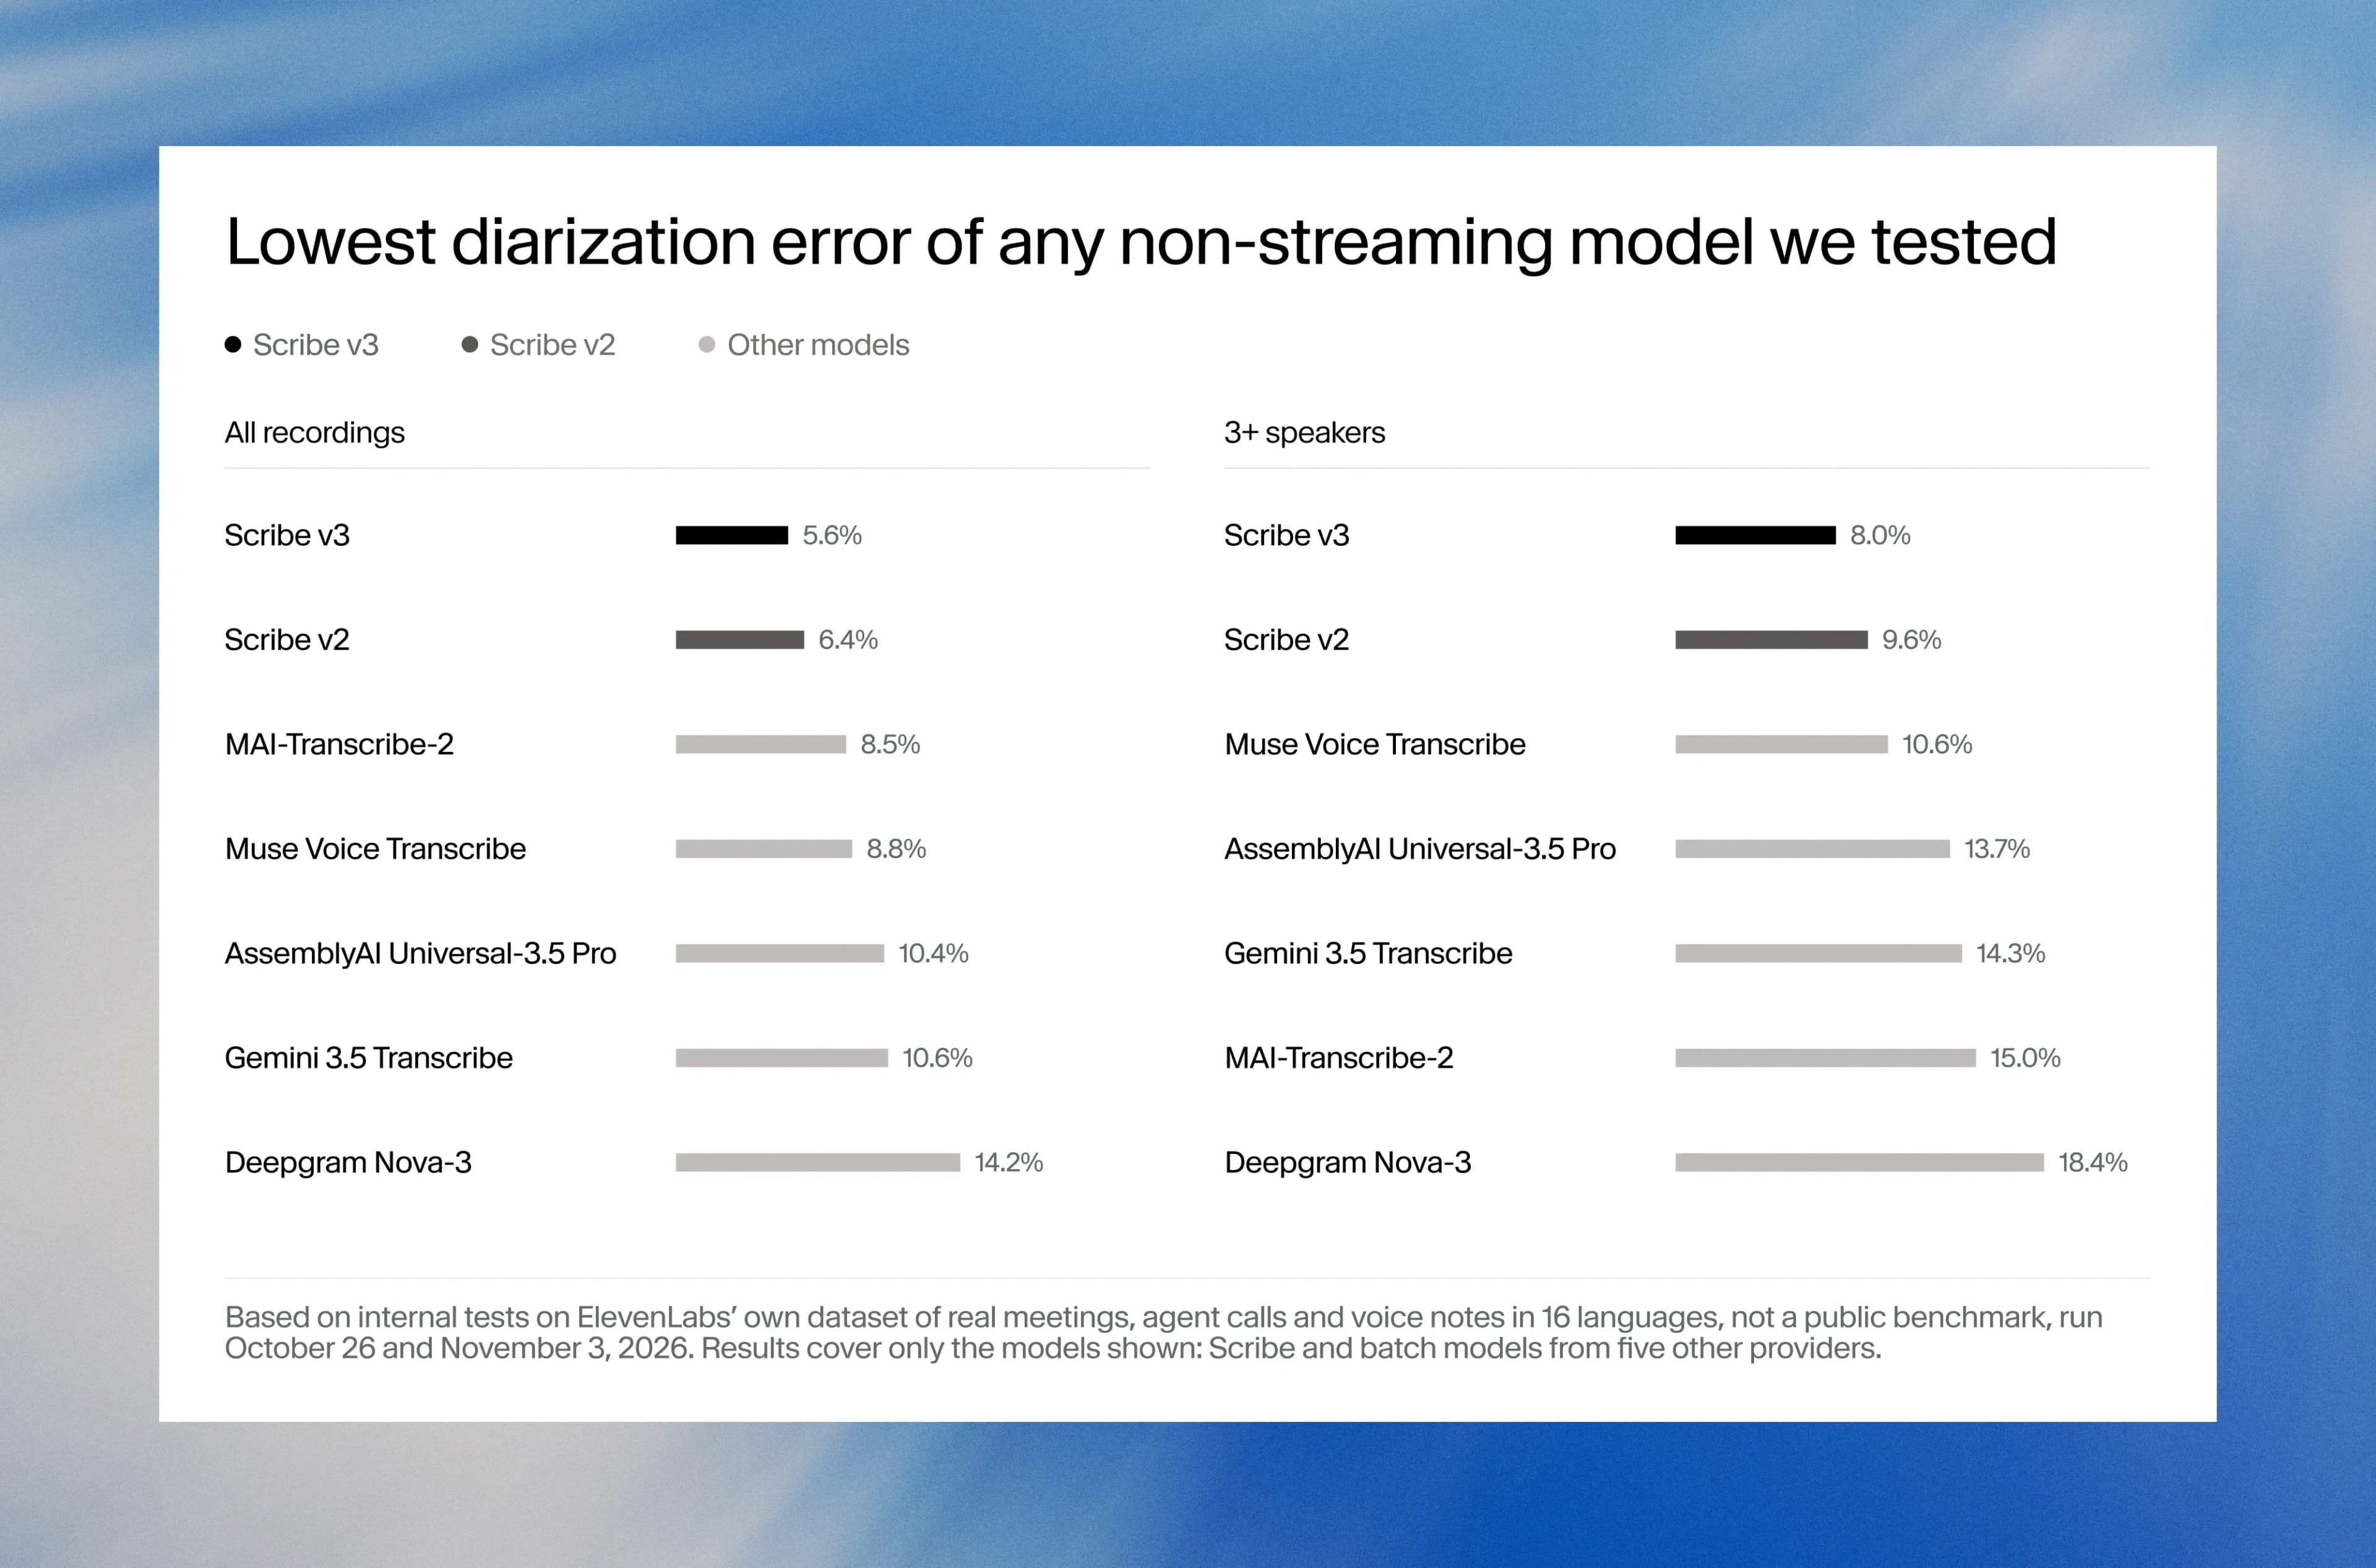
Dans la transcription d'une réunion, identifier le bon locuteur compte autant que transcrire les bons mots. Sur les enregistrements comptant trois locuteurs ou plus, ceux où la plupart des modèles existants échouent, Scribe v3 génère 17 % d'erreurs de diarisation en moins que Scribe v2. Scribe v3 Live apporte également, pour la première fois, la diarisation à la transcription en temps réel, avec 39 % d'erreurs de diarisation en moins que le deuxième meilleur modèle en temps réel que nous avons testé.
Une détection des tours de parole à l'écoute de la conversation
Pour que les conversations restent naturelles, les agents vocaux doivent prévoir avec précision lorsqu'un locuteur a fini de parler. Les systèmes traditionnels de gestion des tours de parole se fondent sur les périodes de silence. Mais le silence seul impose un compromis : un seuil court risque d'interrompre les personnes qui s'arrêtent au milieu d'une phrase, tandis qu'un seuil long donne l'impression qu'un agent est lent. Scribe v3 Live utilise le contexte de la conversation autant que l'audio, afin qu'un appelant qui s'interrompt au milieu d'un nombre ne soit pas coupé. C'est la même détection des tours de parole qu'utilise déjà ElevenAgents, désormais disponible dans ElevenAPI.
Un meilleur contrôle des langues, de la terminologie et du formatage
Scribe v3 peut déduire les langues susceptibles d'être présentes dans un enregistrement et vous permet de choisir si les nombres sont restitués sous forme de chiffres ou de mots. L'invite de termes clés prend en charge jusqu'à 1 000 termes dont vous savez qu'ils seront utilisés, comme des noms de marque, des acronymes et du jargon. Les modifications de transcription appliquent des règles de formatage rédigées en anglais courant, telles que « écrire chaque date au format AAAA-MM-JJ ».
Scribe v3 Live ajoute un mode multilingue pour les conversations où la langue change au milieu d'une phrase. Il ajoute également une bibliothèque de termes clés pour les vocabulaires trop volumineux pour une liste. Là où l'invite de termes clés couvre les termes dont vous savez qu'ils seront utilisés, la bibliothèque de termes clés en contient des milliers qui pourraient l'être, et le modèle ne la consulte que lorsqu'il détecte une correspondance probable.
Performances de Scribe v3
ElevenLabs a évalué les deux modèles face à Scribe v2, Scribe v2 Realtime et d'autres modèles Speech to Text populaires, en les notant sur les mêmes jeux de données. La précision multilingue a été mesurée sur une version interne du benchmark FLEURS, qui teste de courts extraits de parole lue, claire et propre dans 102 langues. FLEURS ne peut pas mesurer la diarisation, puisque chaque extrait ne comporte qu'un seul locuteur. Nous avons donc également constitué notre propre jeu de données à partir de réunions réelles, d'appels d'agents et de notes vocales dans 16 langues. Nous le publierons prochainement en open source.
Diarisation des locuteurs
Scribe v3 affiche le taux d'erreur de diarisation le plus faible parmi tous les modèles que nous avons testés, avec 12 % d'erreurs en moins que Scribe v2 au global et 17 % de moins sur les enregistrements comptant trois locuteurs ou plus.
Précision de la transcription multilingue
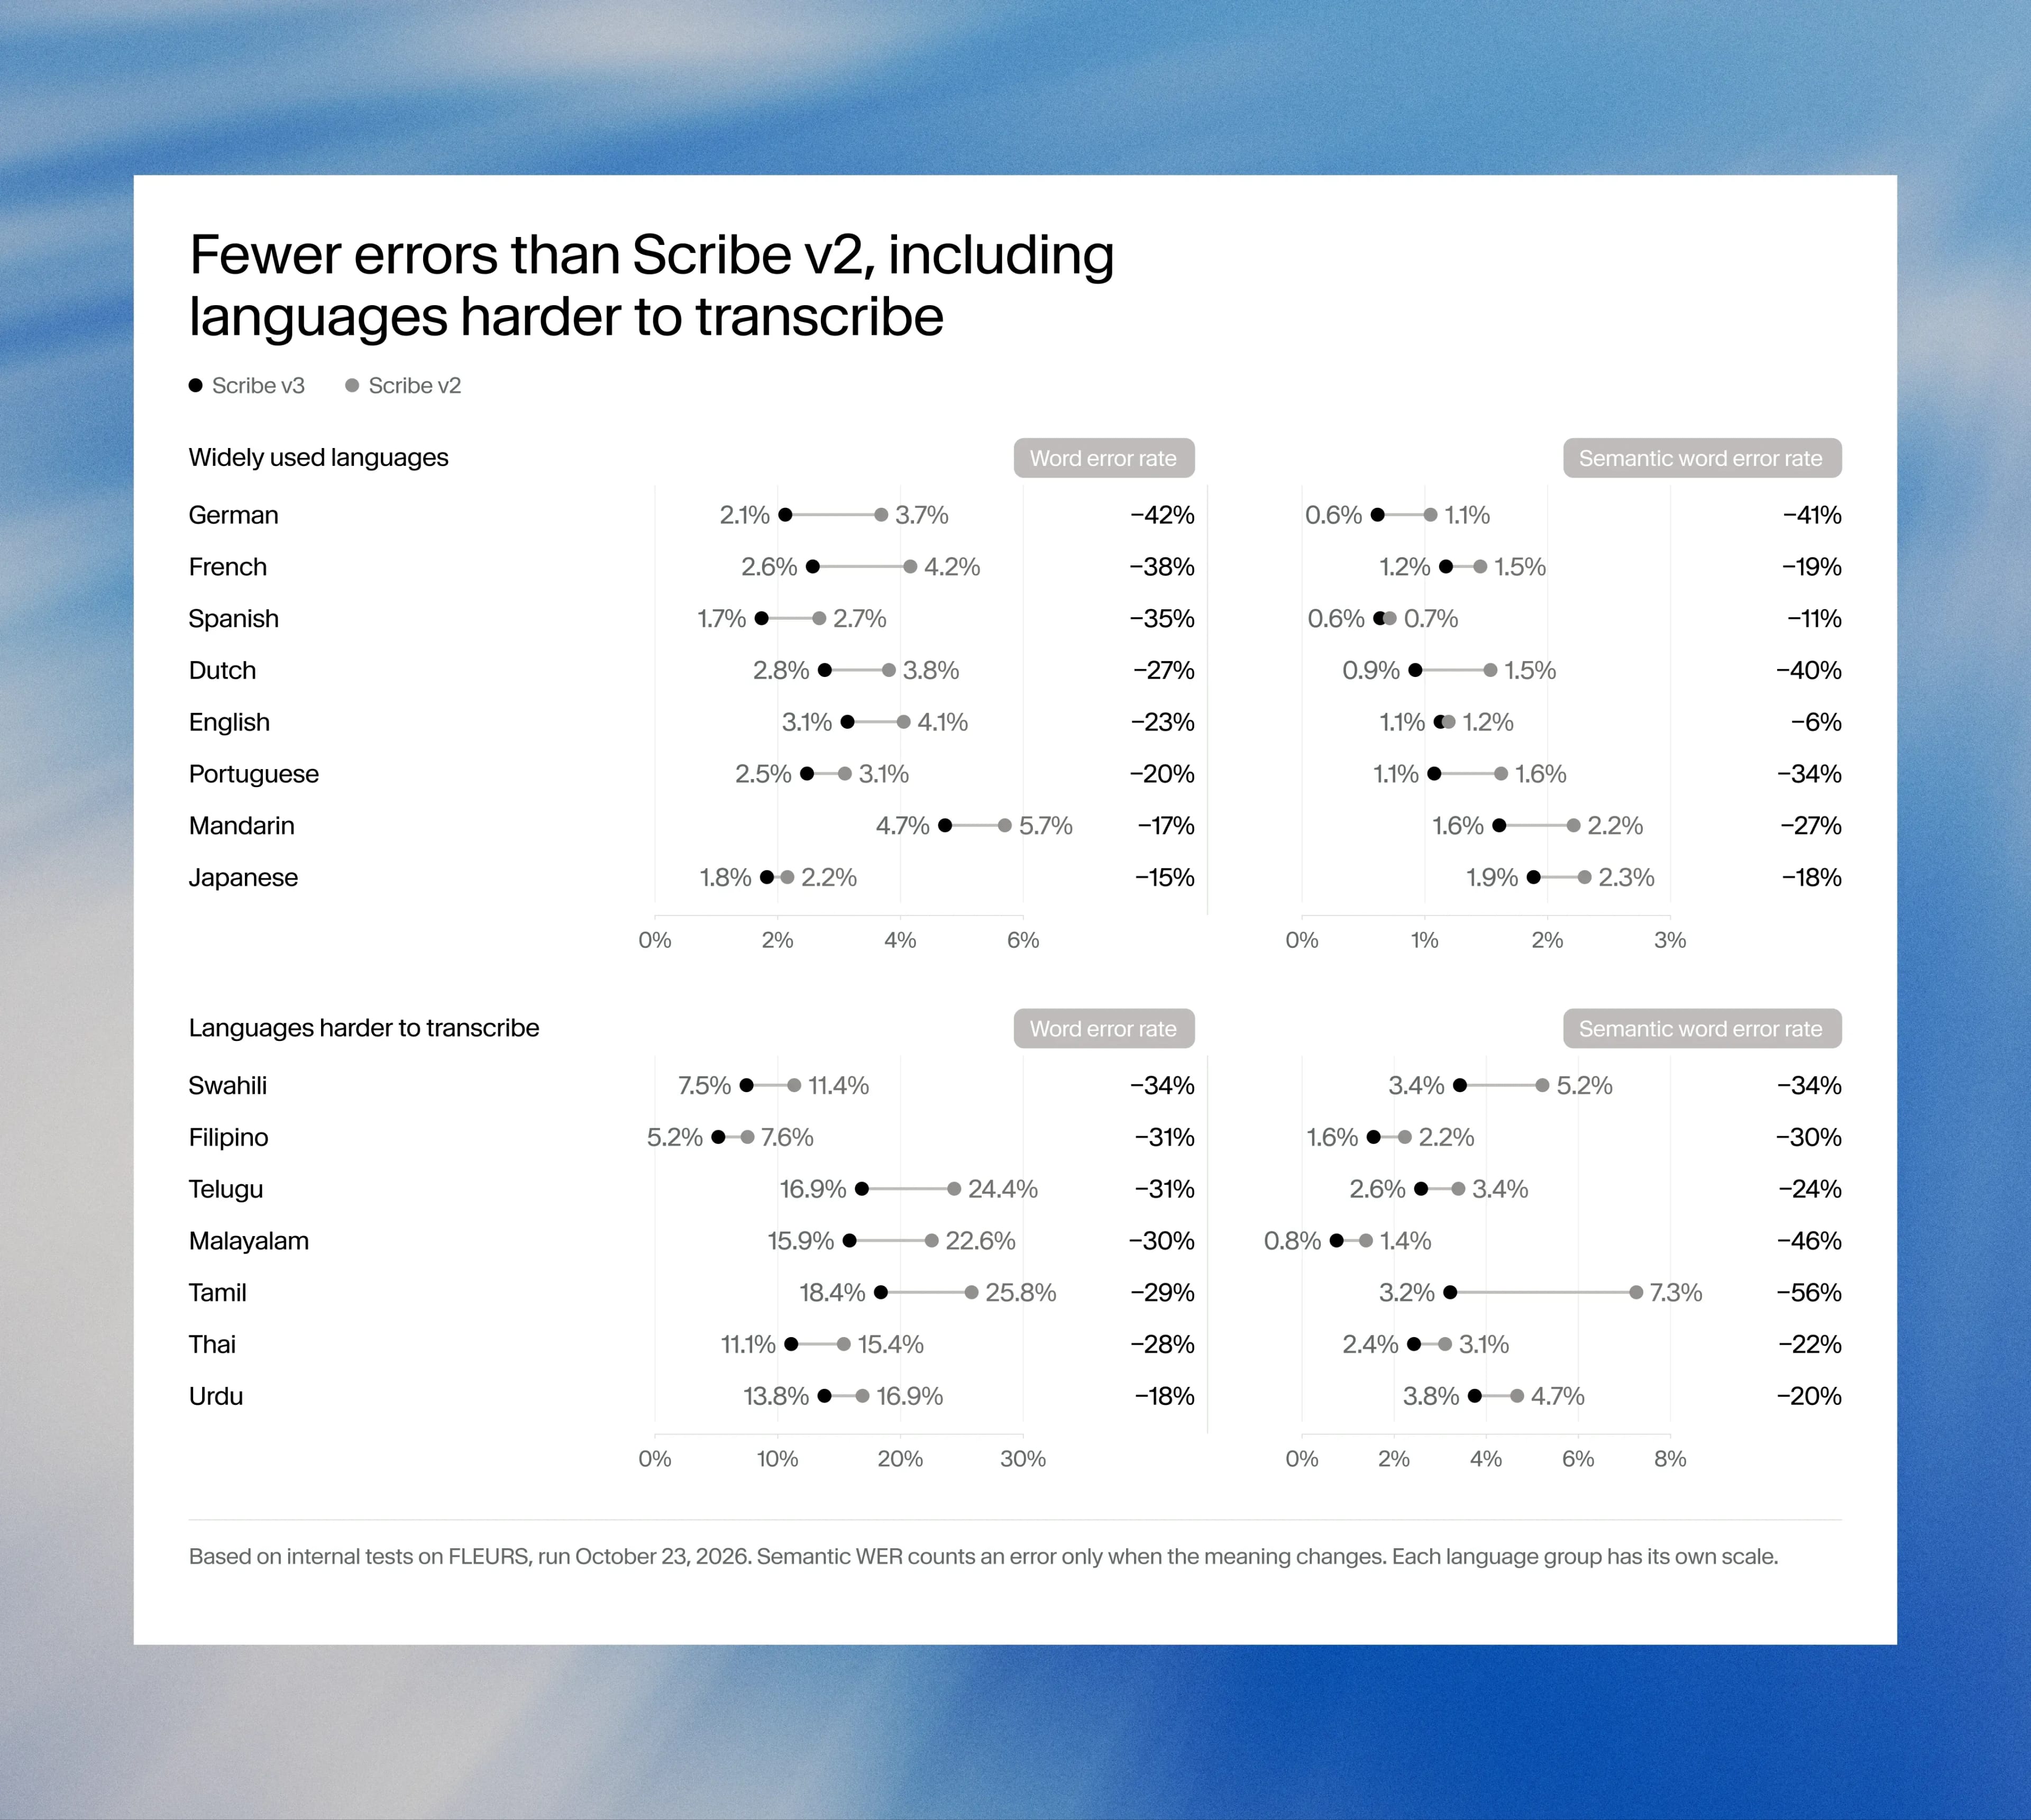
Nous indiquons le taux d'erreur sur les mots (WER) ainsi que le WER sémantique, qui ne compte une erreur que lorsque le sens de la transcription change.
Sur 102 langues dans FLEURS, Scribe v3 réduit le WER de 27 % par rapport à Scribe v2 et s'améliore dans toutes les langues testées. Dans les langues plus faciles à transcrire, l'allemand progresse de 42 %, l'espagnol de 35 % et l'anglais de 23 %. Les améliorations sont encore plus importantes pour les langues plus difficiles à transcrire : le swahili recule de 34 %, le tamoul de 29 % et le thaï de 28 %.
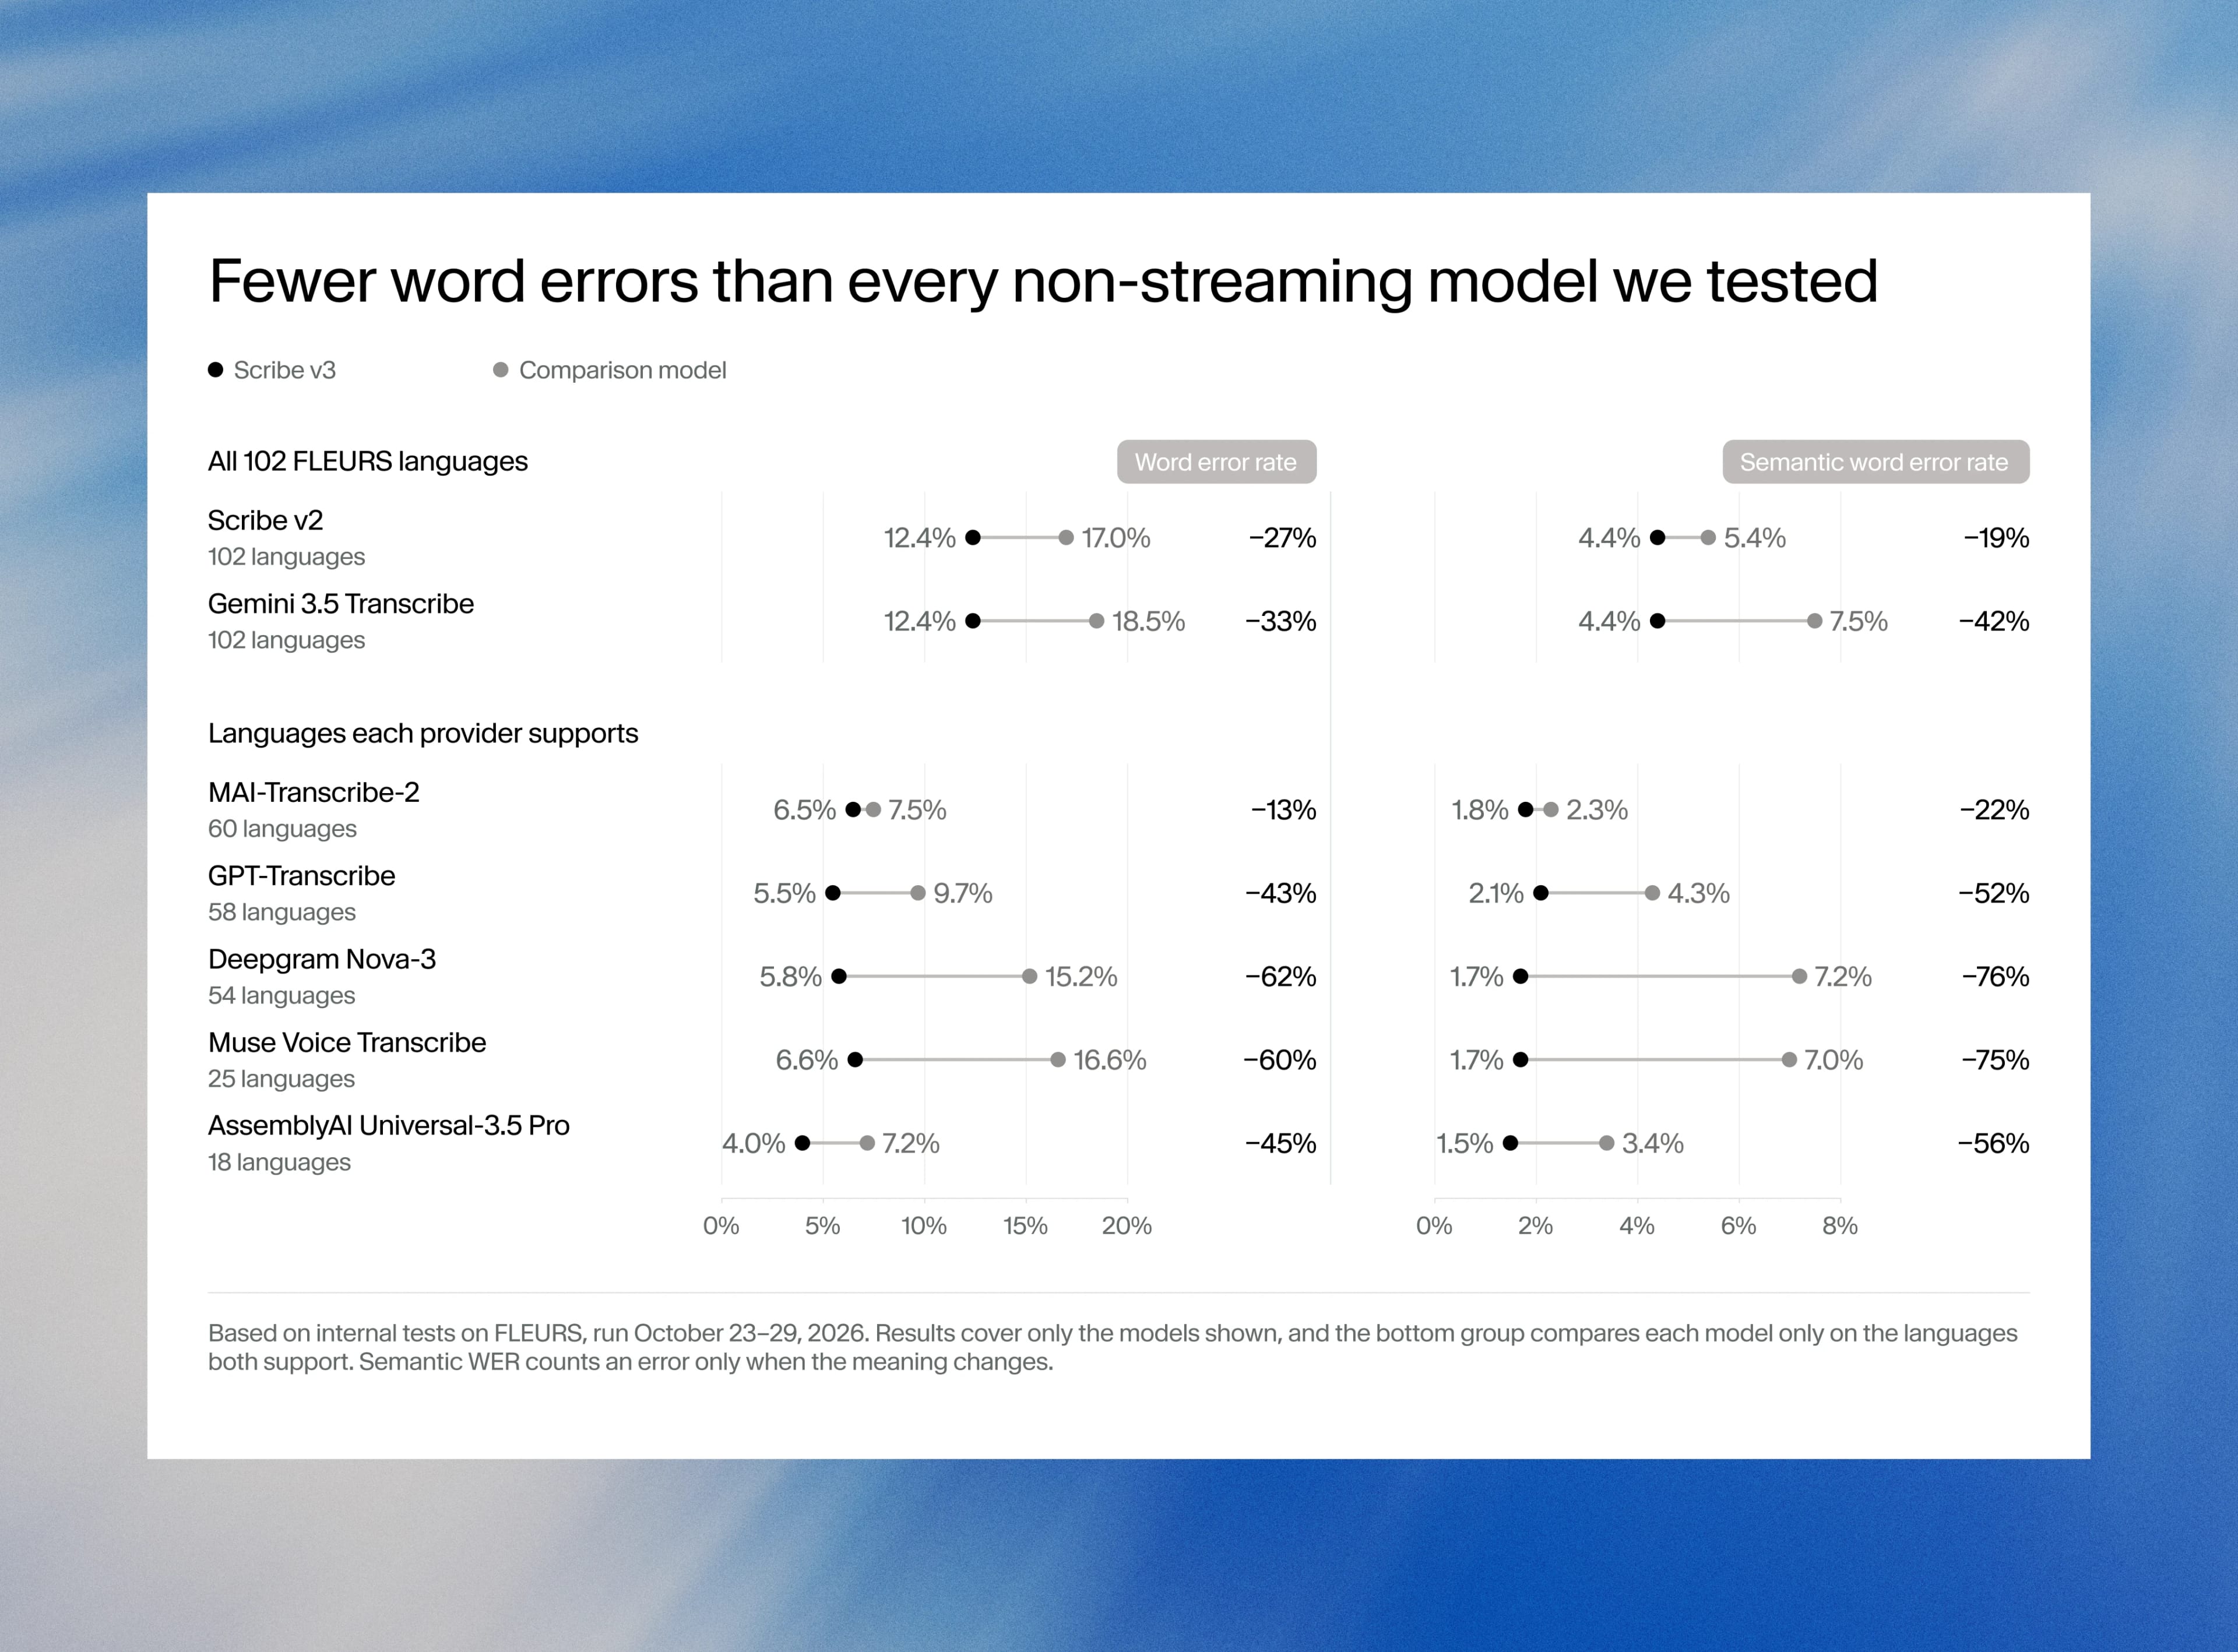
Scribe v3 génère également moins d'erreurs de mots que tous les autres modèles par lots, non streaming, que nous avons testés, en les comparant dans les langues prises en charge par les deux modèles.
Diarisation des locuteurs en temps réel
Sur la partie anglaise de notre jeu de données réelles couvrant 16 langues, Scribe v3 Live affiche un taux d'erreur de diarisation de 3,1 %, contre 5,9 % à 7,3 % pour les autres modèles en temps réel que nous avons testés.
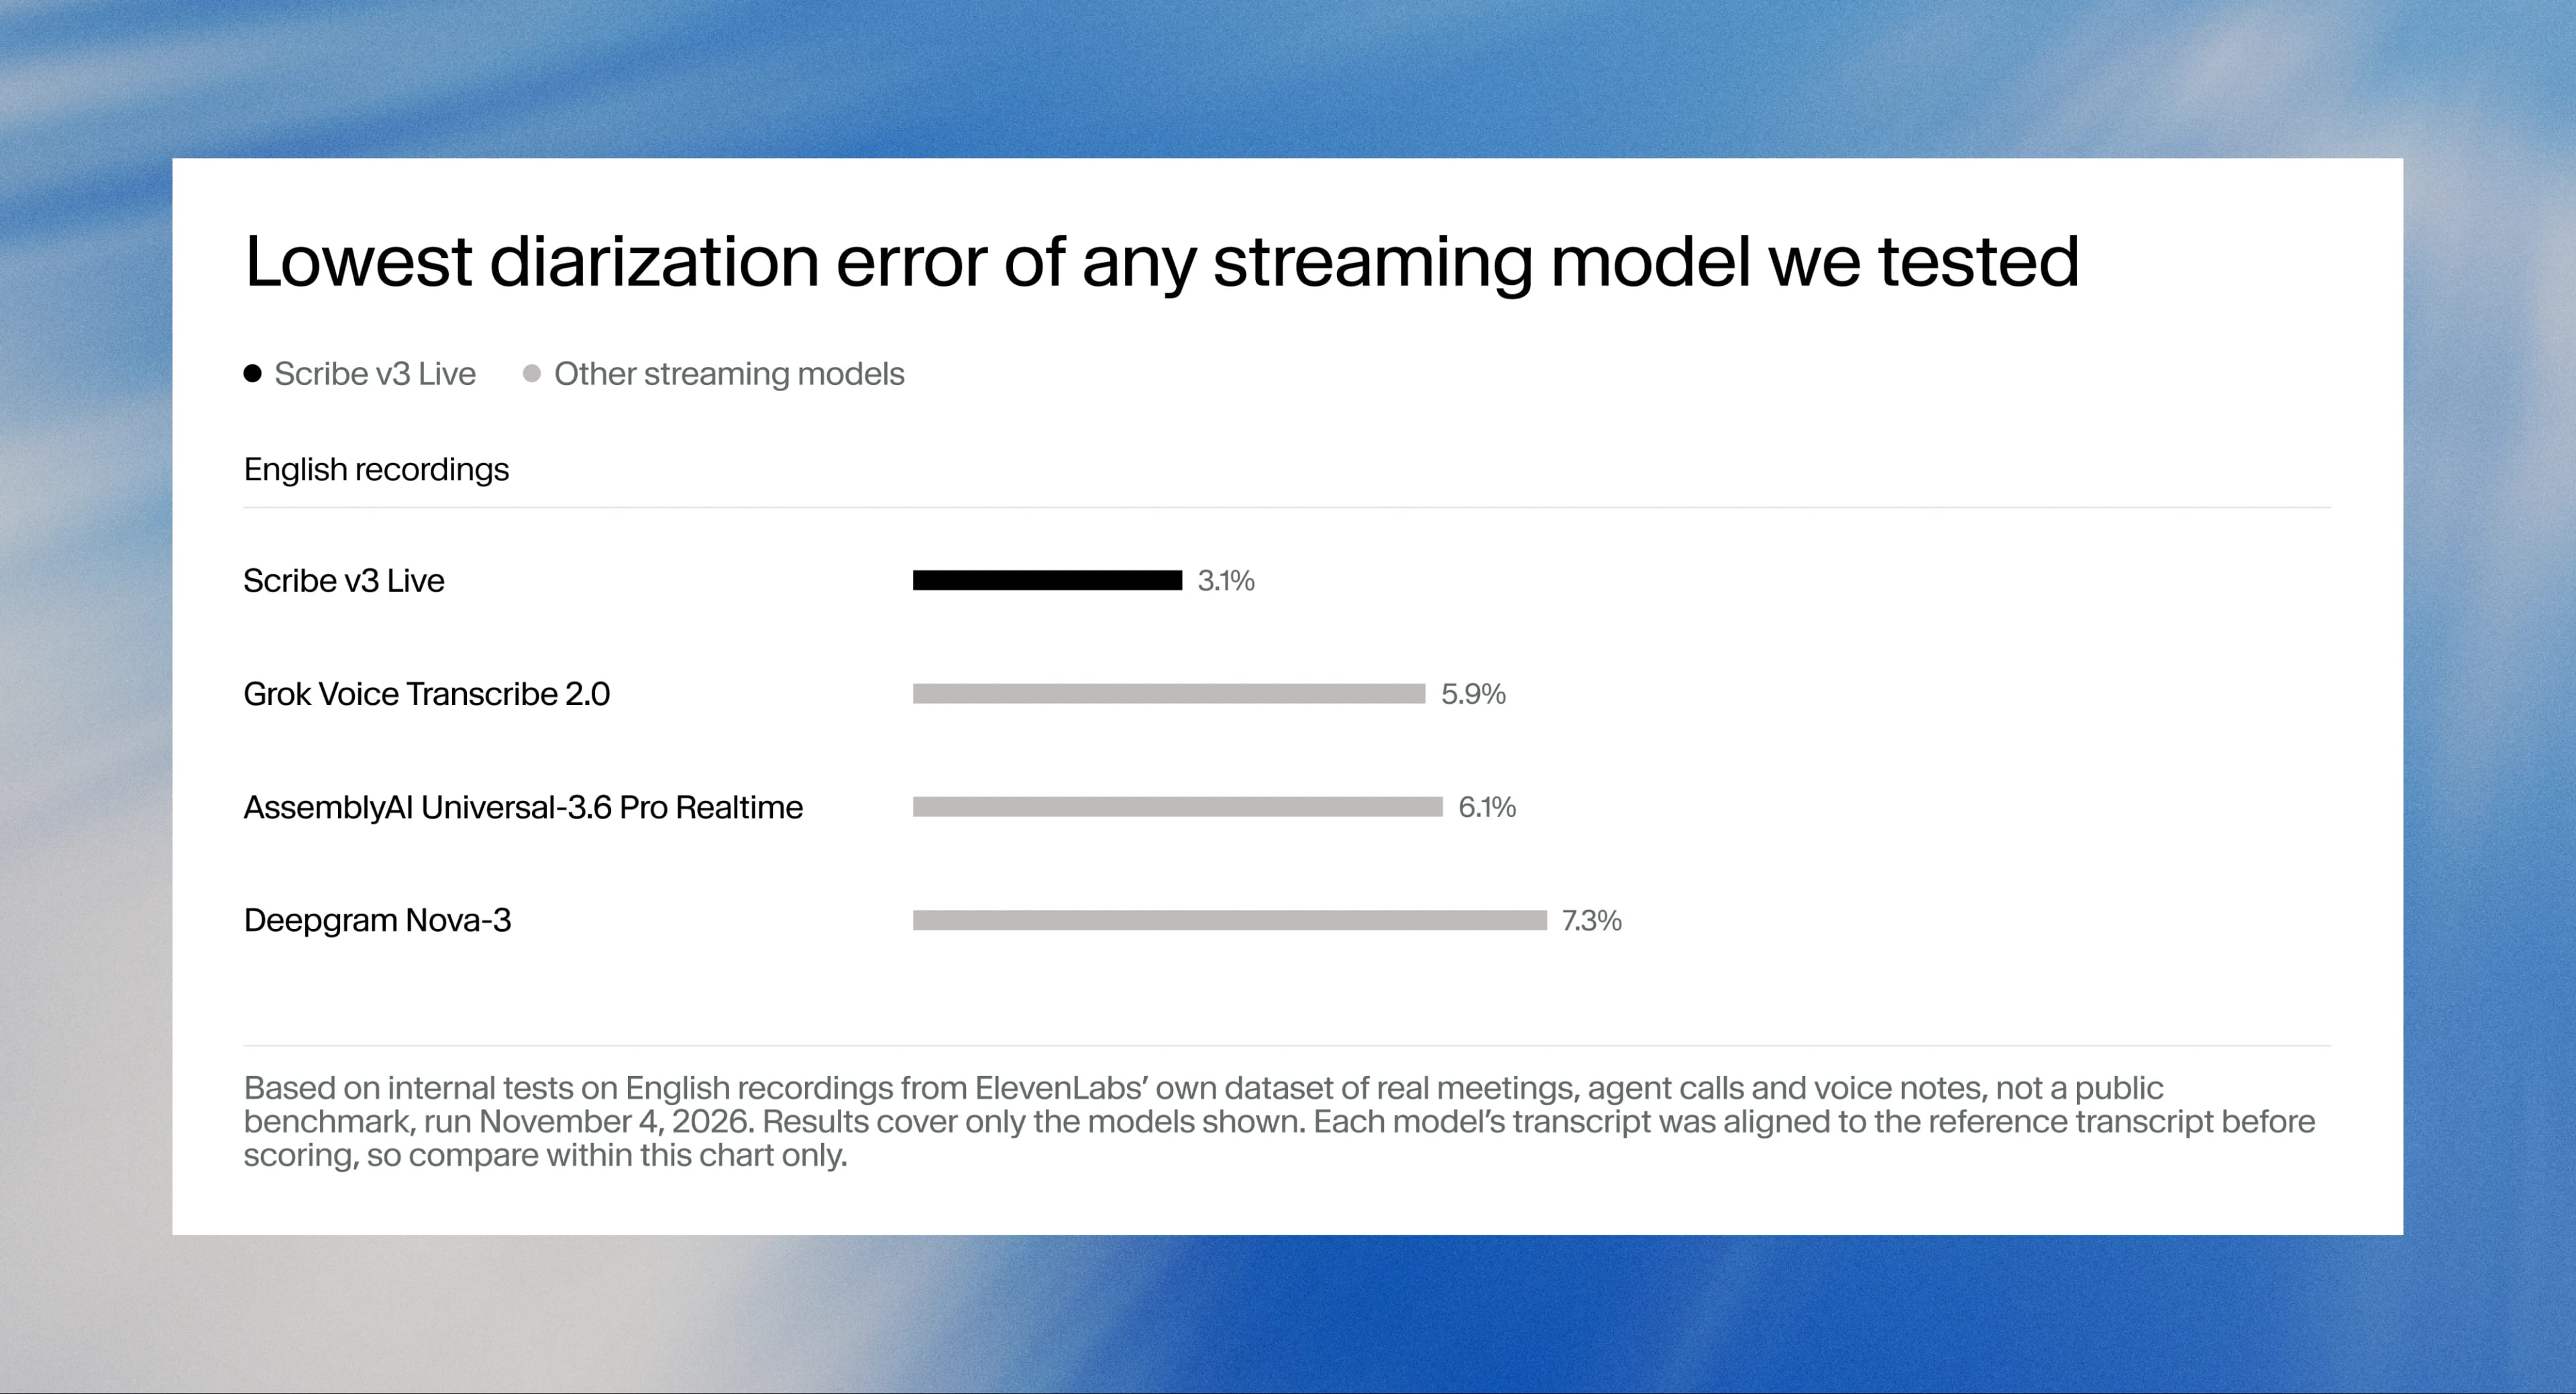
Les scores de diarisation standard comptent aussi les erreurs de transcription, comme les mots omis, et les modèles en temps réel omettent davantage de mots que les modèles par lots. Pour mesurer uniquement si chaque mot a été attribué au bon locuteur, nous avons aligné la transcription de chaque modèle sur la référence avant l'évaluation. Cela réduit le taux d'erreur de chaque modèle ; ces résultats ne peuvent donc pas être comparés à ceux de la diarisation par lots ci-dessus.
Précision multilingue en temps réel
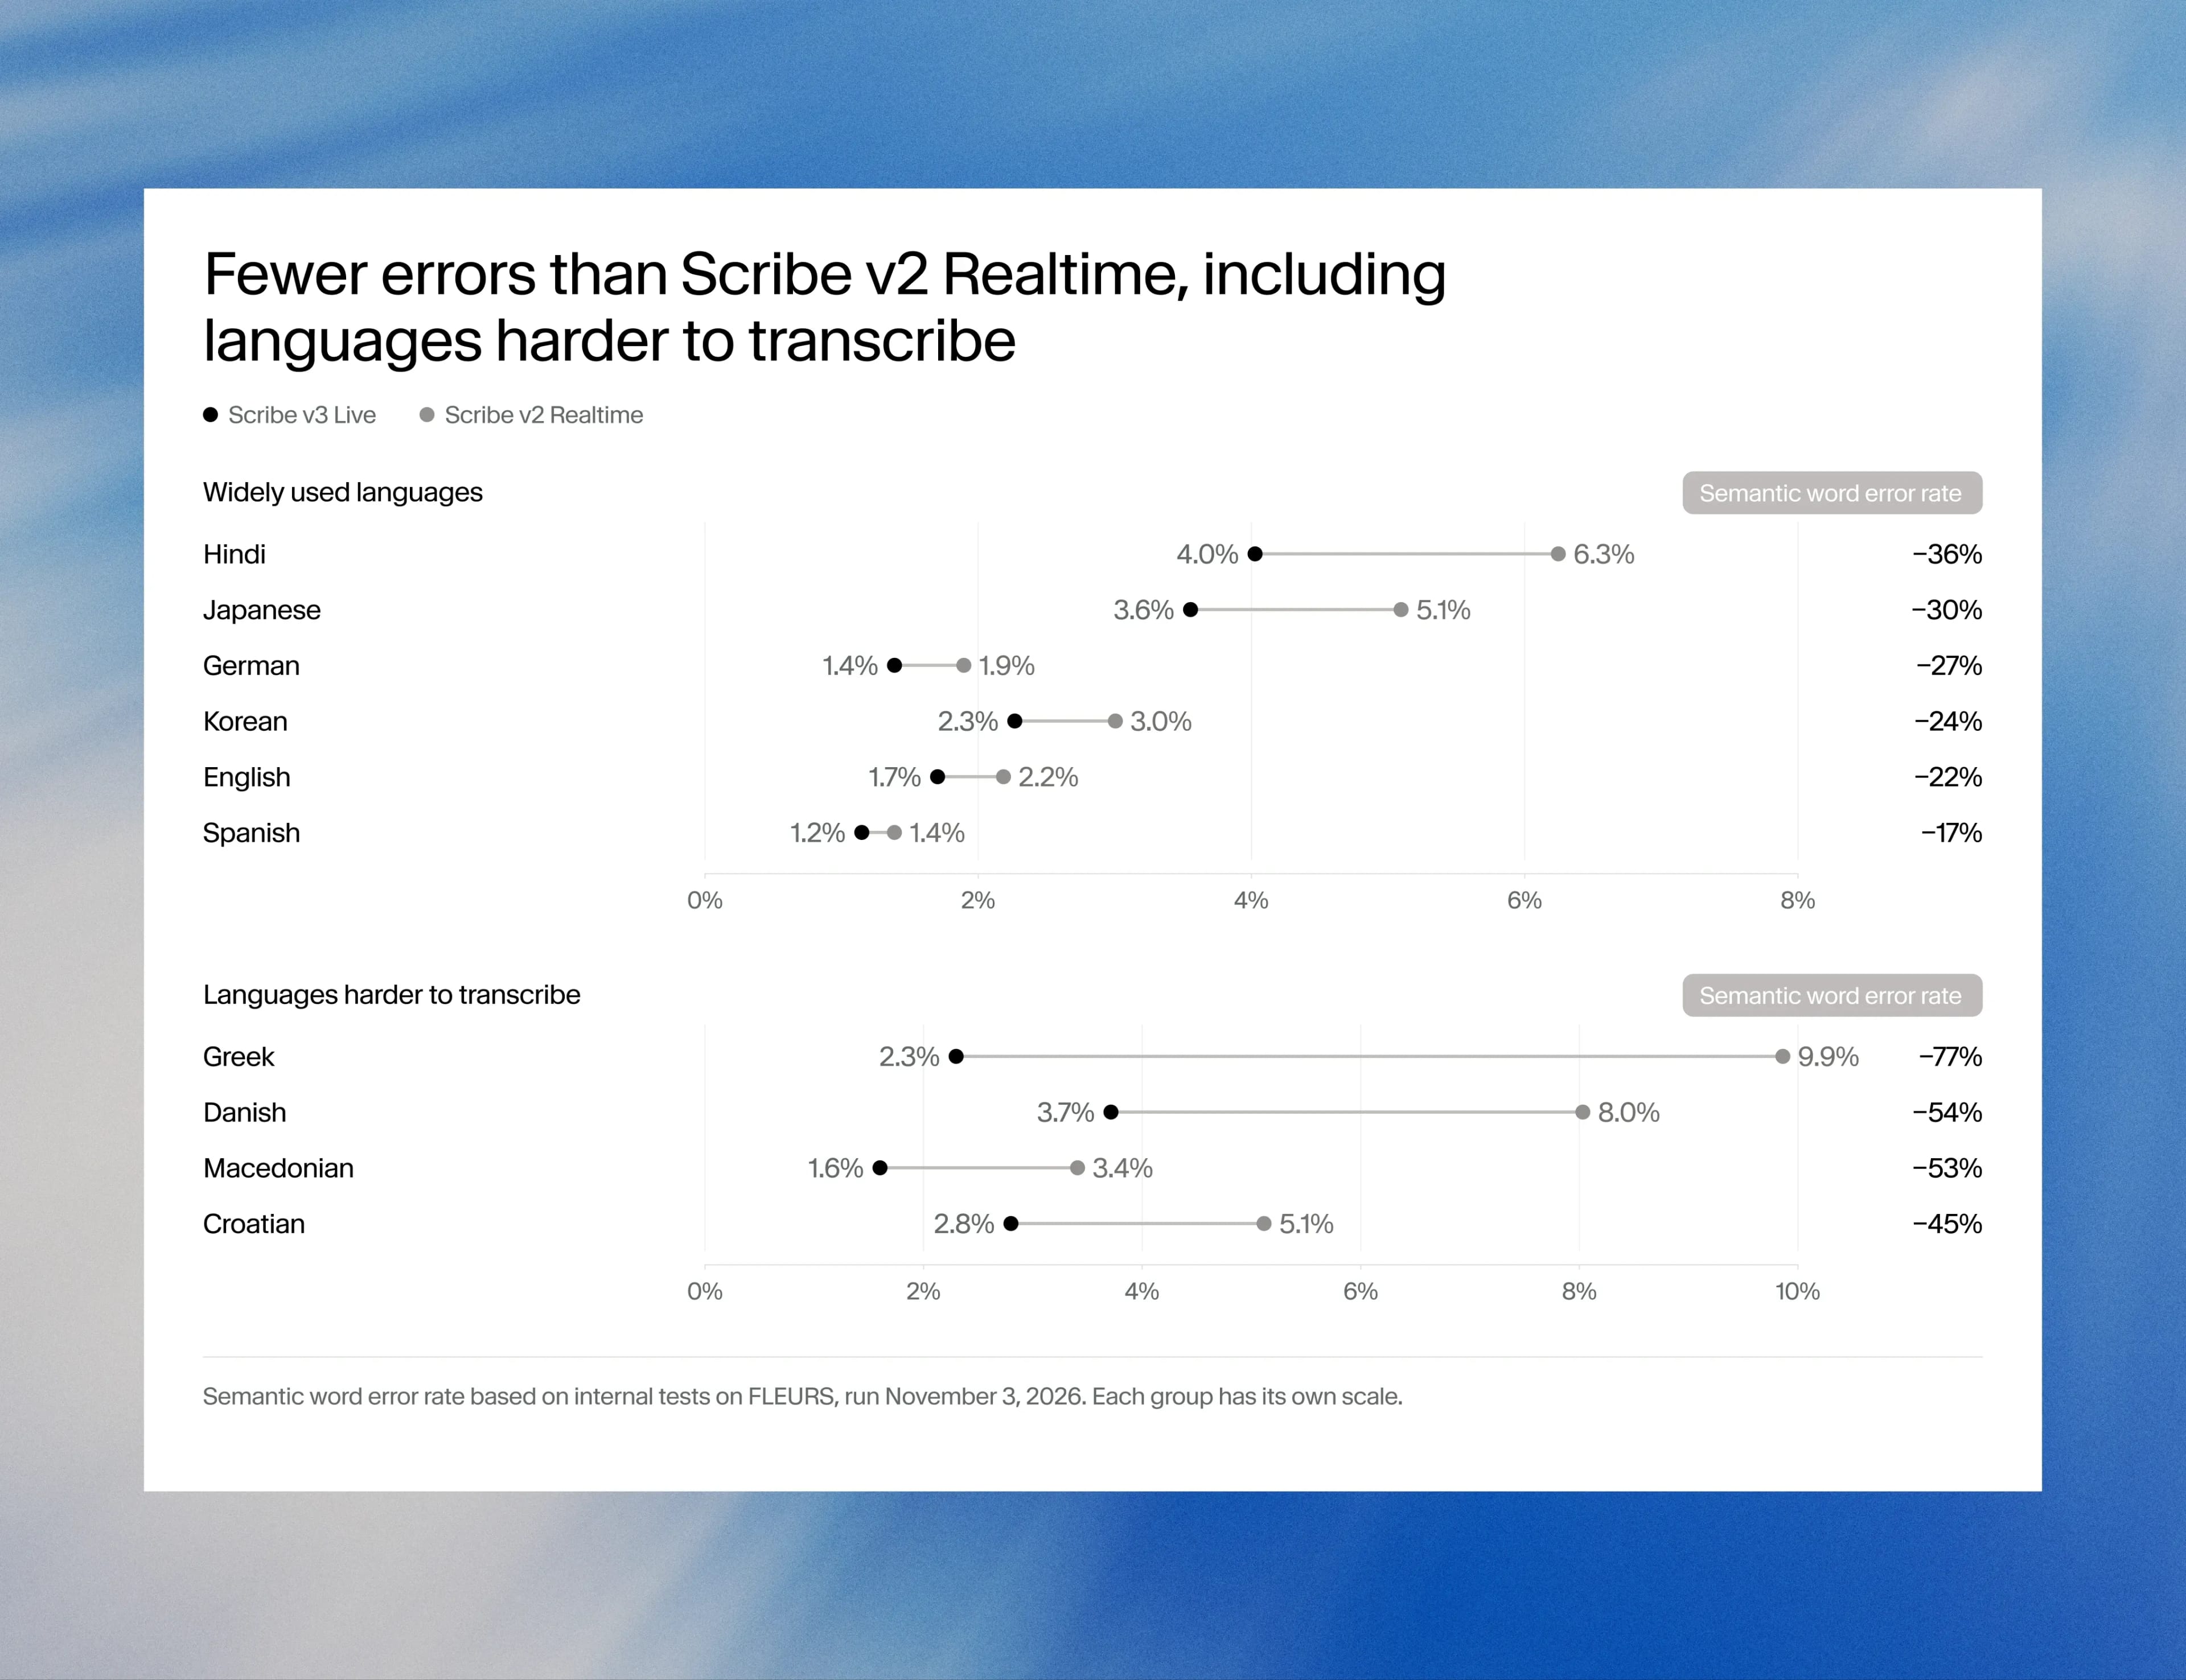
Pour les modèles en temps réel, nous privilégions le WER sémantique. Un modèle streaming écrit du texte avant d'avoir entendu la phrase entière, et chaque fournisseur formate différemment les nombres, la ponctuation et les majuscules au fil de la transcription. Le WER standard compte ces différences comme des erreurs, même lorsque le sens reste le même. Le WER sémantique constitue donc une comparaison plus équitable.
Dans 102 langues, Scribe v3 Live réduit le WER sémantique de 43 % et le WER de 31 % par rapport à Scribe v2 Realtime. Il s'améliore dans toutes les langues et affiche un taux d'erreur inférieur à celui de tous les autres modèles en temps réel que nous avons testés.
Les améliorations sont les plus marquées là où la transcription en temps réel accusait du retard : le grec progresse de 77 %, le danois de 54 % et le croate de 45 %, tandis que l'hindi progresse de 36 %.
Note méthodologique : nous avons évalué chaque langue séparément avant de calculer la moyenne, afin que les 102 langues aient le même poids. De nombreux résultats publiés regroupent tous les extraits dans un score unique, ce qui tend à donner des chiffres plus faibles ; les résultats mesurés selon différentes méthodes ne sont donc pas directement comparables.
Ce que représentent quelques points de précision
Chaque lancement de modèle s'accompagne de pourcentages, celui-ci aussi, mais sur le papier, il est difficile de saisir ce que quelques points représentent dans des situations réelles. Une réunion d'une heure à 150 mots par minute représente environ 9 000 mots ; l'écart entre un taux d'erreur de mots de 4 % et de 2 % équivaut donc à 180 mots erronés, soit trois pour chaque minute de parole. L'erreur de diarisation se mesure en temps plutôt qu'en mots : dans cette même réunion, chaque point représente 36 secondes de parole attribuées au mauvais nom.
Le coût de ces erreurs dépend de leur contexte. Dans la transcription d'un podcast, un mot erroné est une faute de frappe, mais lors d'une conférence téléphonique sur les résultats, « quinze » entendu comme « cinquante » se retrouve dans le modèle d'un analyste. Les erreurs se concentrent aussi sur les noms, les nombres, les acronymes et le jargon, précisément les mots qu'un résumé ou un agent doit absolument transcrire correctement.
Réussir dès la première fois avec ElevenAgents
Les agents vocaux sont les premiers concernés, car un seul chiffre mal entendu peut faire échouer la vérification qui déclenche l'appel. Eneco, qui fournit de l'énergie à plus de 2 millions de foyers et d'entreprises aux Pays-Bas, utilise son agent vocal sur ElevenAgents et a testé Scribe v3 Live avant son lancement. Lors de véritables appels clients, l'agent a reconnu correctement les codes postaux néerlandais dès la première tentative 40 % plus souvent, et les numéros de maison 15 % plus souvent.
« ElevenLabs est un véritable partenaire pour Eneco. Avec leurs ingénieurs déployés sur le terrain, nous travaillons à améliorer encore notre agent vocal », a déclaré Ruud Huigsloot, Senior Product Manager chez Eneco. « C'est formidable d'obtenir des résultats significatifs si tôt, et nous sommes impatients de poursuivre cette collaboration. »
Conçu pour les entreprises
Scribe v3 et Scribe v3 Live fonctionnent aux États-Unis par défaut et sont proposés dans des environnements isolés en Europe, en Inde et à Singapour pour les entreprises ayant des exigences de résidence des données. Le mode zéro rétention supprime l'audio et le texte dès qu'une requête est terminée. Les deux modèles sont couverts par nos programmes SOC 2, ISO 27001 et PCI DSS de niveau 1, sont éligibles à la conformité HIPAA avec un accord de partenariat commercial et sont disponibles en déploiement privé.
Essayez-les dès aujourd'hui
Scribe v3 Live est disponible dans ElevenAgents, et v3 comme v3 Live sont les modèles par défaut dans l’application ElevenLabs. S’inscrire pour l’essayer.
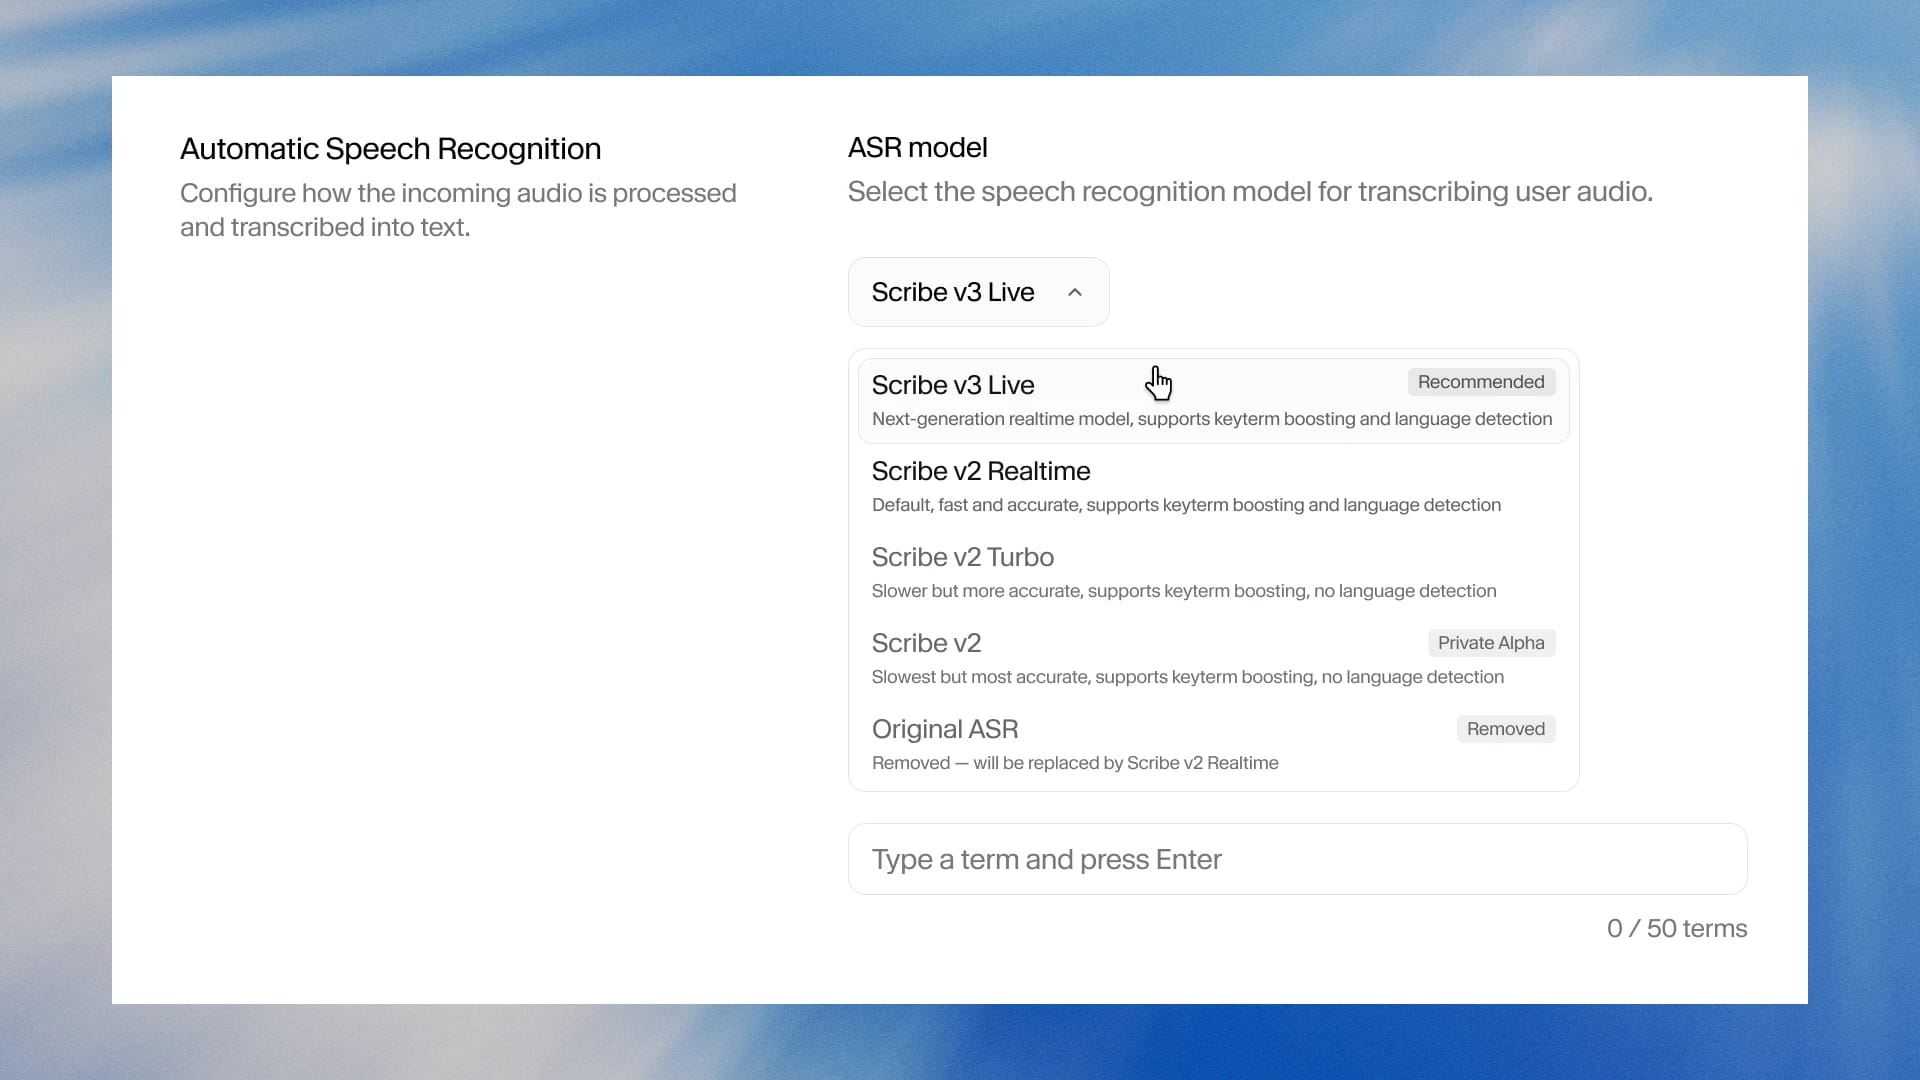
Les deux modèles sont également disponibles dans ElevenAPI dès aujourd'hui. Les intégrations existantes passent à la nouvelle version en remplaçant l'ID du modèle par scribe_v3 ou scribe_v3_live.
Pour les équipes de santé, nous lançons également dans ElevenAgents une version de Scribe v3 Live optimisée pour les conversations médicales.