Présentation d’Eleven Realtime : une façon plus simple de concevoir des agents vocaux naturels
- Rédigé par
- Min Kim
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Concevoir aujourd’hui un agent vocal au rendu naturel impose de nombreux choix. Vous devez sélectionner des composants tels que la reconnaissance vocale, la détection d’activité vocale, la gestion des tours de parole, le grand modèle de langage sous-jacent et la synthèse vocale. Concevoir cette pile constitue un projet à part entière, et faire fonctionner tous les composants efficacement ensemble exige davantage de tests et d’ajustements.
Eleven Realtime est une nouvelle catégorie de modèles de parole à parole qui élimine ces obstacles. Chaque modèle est un agent vocal complet, optimisé pour des cas d’usage spécifiques. Tous deux prennent en charge plus de 90 langues et peuvent utiliser n’importe laquelle des plus de 17 000 voix de la bibliothèque ElevenLabs :
Aujourd’hui, nous lançons :
- Eleven Realtime v1 Mini pour des conversations naturelles à moindre coût. C’est le meilleur choix pour les assistants IA, les enseignants et les personnages interactifs, et il convient à la plupart des cas d’usage.
- Eleven Realtime v1 Max pour les tâches complexes. Il convient parfaitement au support client, à la qualification de prospects et aux workflows à plusieurs étapes, lorsque l’agent doit suivre un processus et raisonner étape par étape.
Pourquoi nous avons conçu des modèles en temps réel
Vous ne devriez pas avoir à devenir expert en configuration pour concevoir un agent vocal au rendu naturel. Donner à un agent le comportement et la voix adéquats repose sur de nombreux arbitrages subtils : le délai à attendre après une pause avant de répondre, la façon de réagir lorsque l’utilisateur interrompt l’agent, ou encore l’interaction entre la voix, les prompts et le modèle. Dans ElevenAgents, vous pouvez ajuster tous ces paramètres.
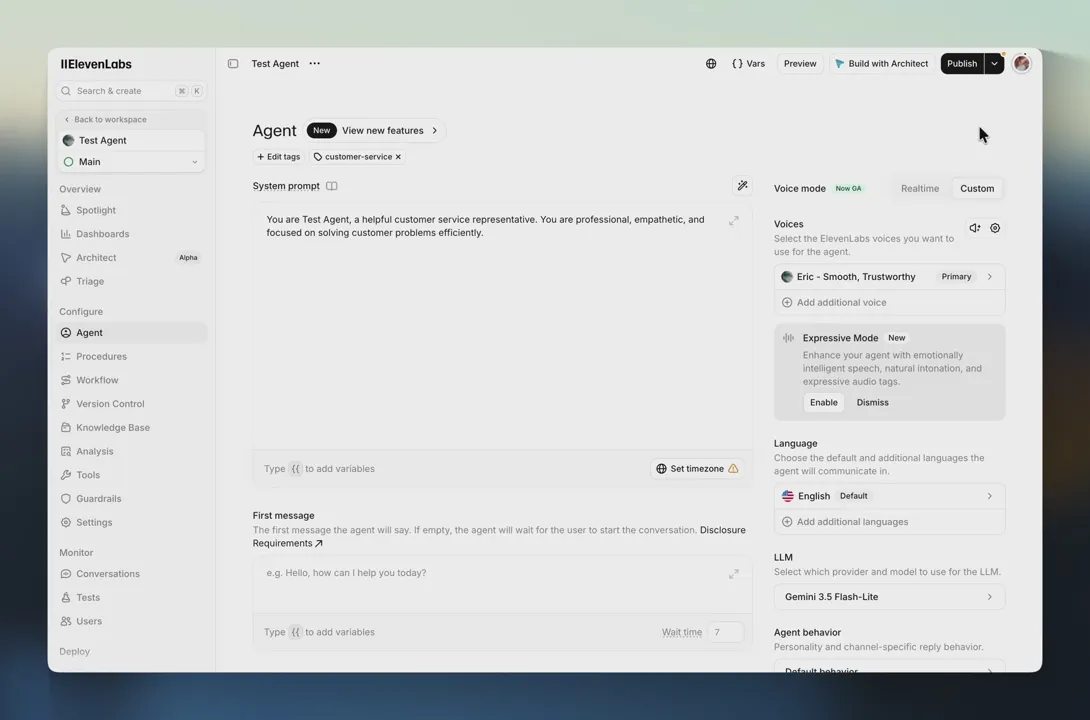
Il en va de même pour les développeurs qui utilisent déjà une API en temps réel. La nôtre est compatible avec l’API Realtime d’OpenAI : essayer Eleven Realtime consiste simplement à modifier l’endpoint et le nom du modèle dans le code que vous utilisez peut-être déjà.
Basé sur une architecture en cascade
Eleven Realtime repose sur une architecture en cascade composée des éléments décrits ci-dessus, optimisée de bout en bout. Nous les appelons modèles de parole à parole, car c’est ce que vous obtenez : de l’audio en entrée, de l’audio en sortie, un seul identifiant de modèle et un système comparable dans les mêmes classements que les modèles fusionnés et duplex.
Les modèles fusionnés ont d’abord établi la référence en matière de naturel pour les agents vocaux, tandis qu’une configuration en cascade impliquait une latence accrue à chaque transfert et des composants jamais optimisés les uns par rapport aux autres. Realtime élimine ce compromis, et l’optimisation qui relevait auparavant de votre projet est déjà effectuée.
L’architecture en cascade offre aussi des avantages pratiques en production, car chaque étape génère du texte. Vous pouvez voir ce que l’agent a entendu et ce qu’il a décidé de dire, afin de distinguer un mot mal compris d’une mauvaise décision. Ce même texte permet à ElevenAgents d’appliquer des garde-fous et le masquage des données personnelles identifiables à un agent Realtime.
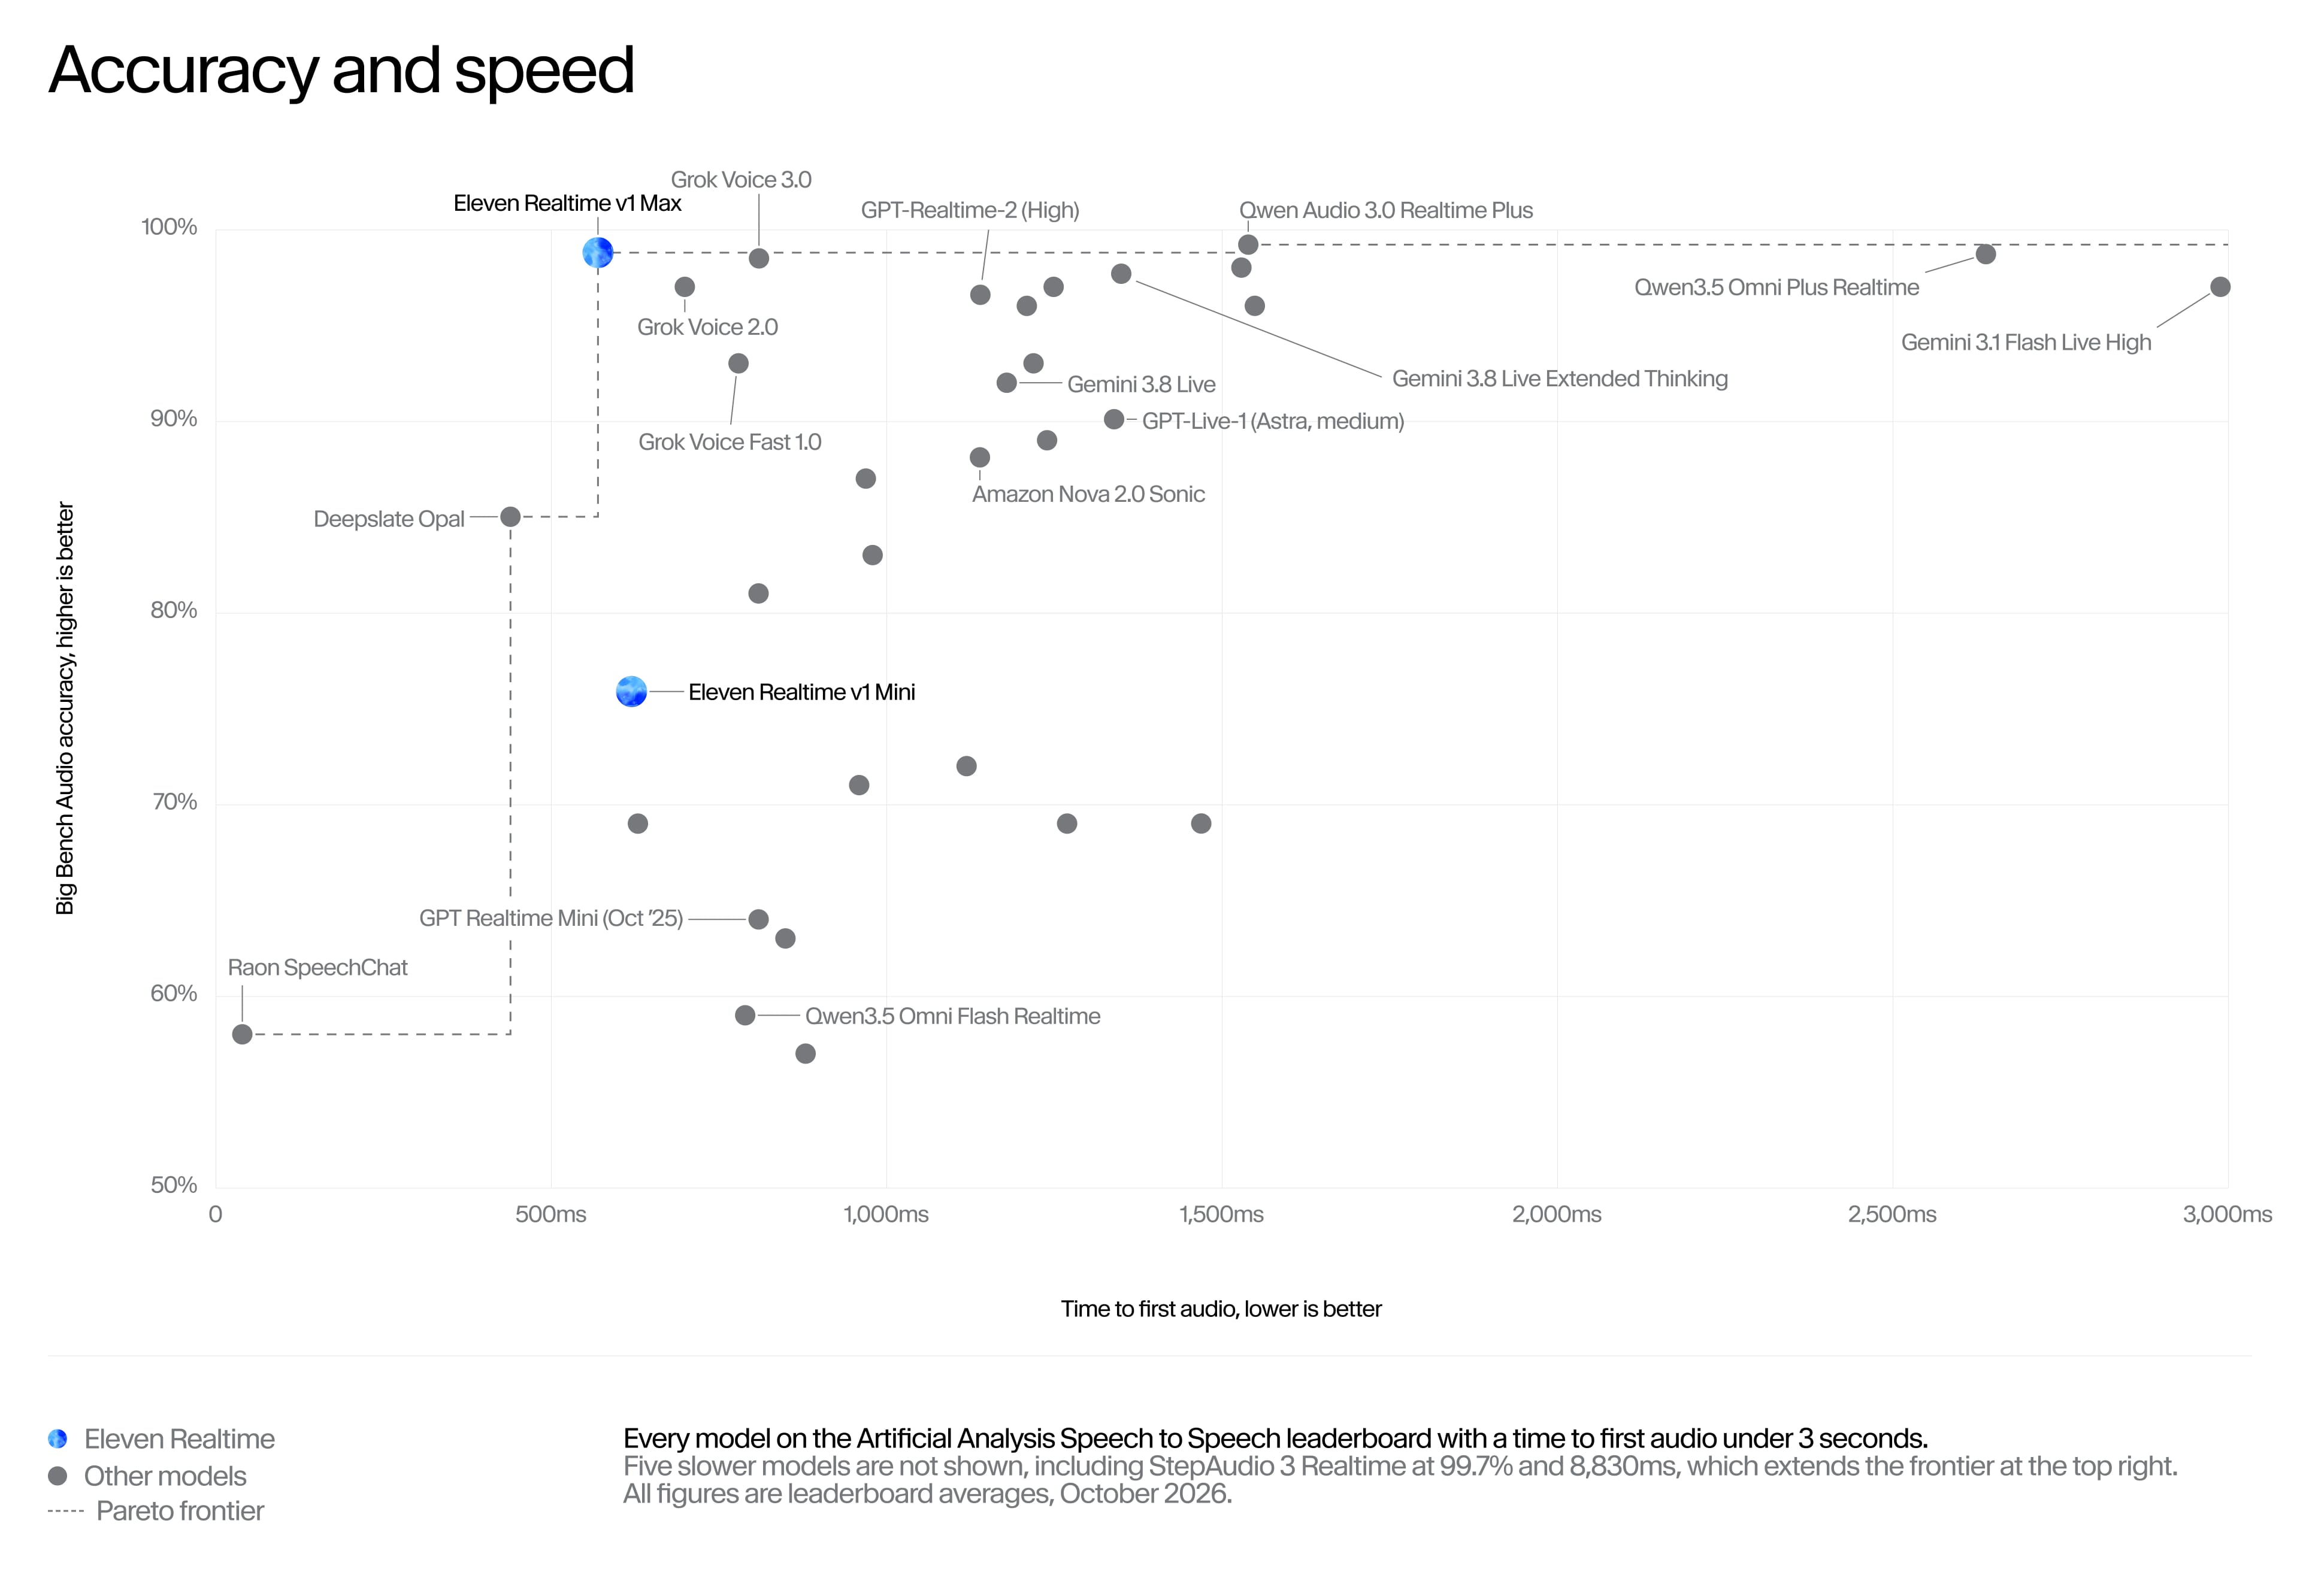
Les benchmarks ci-dessous permettent de vérifier que ce compromis a réellement disparu. En matière de dynamique conversationnelle, les deux modèles obtiennent des résultats comparables à ceux des modèles fusionnés. Pour la précision et la vitesse combinées, aucun modèle du classement Artificial Analysis n’est à la fois plus rapide et plus précis que v1 Max.
Performances
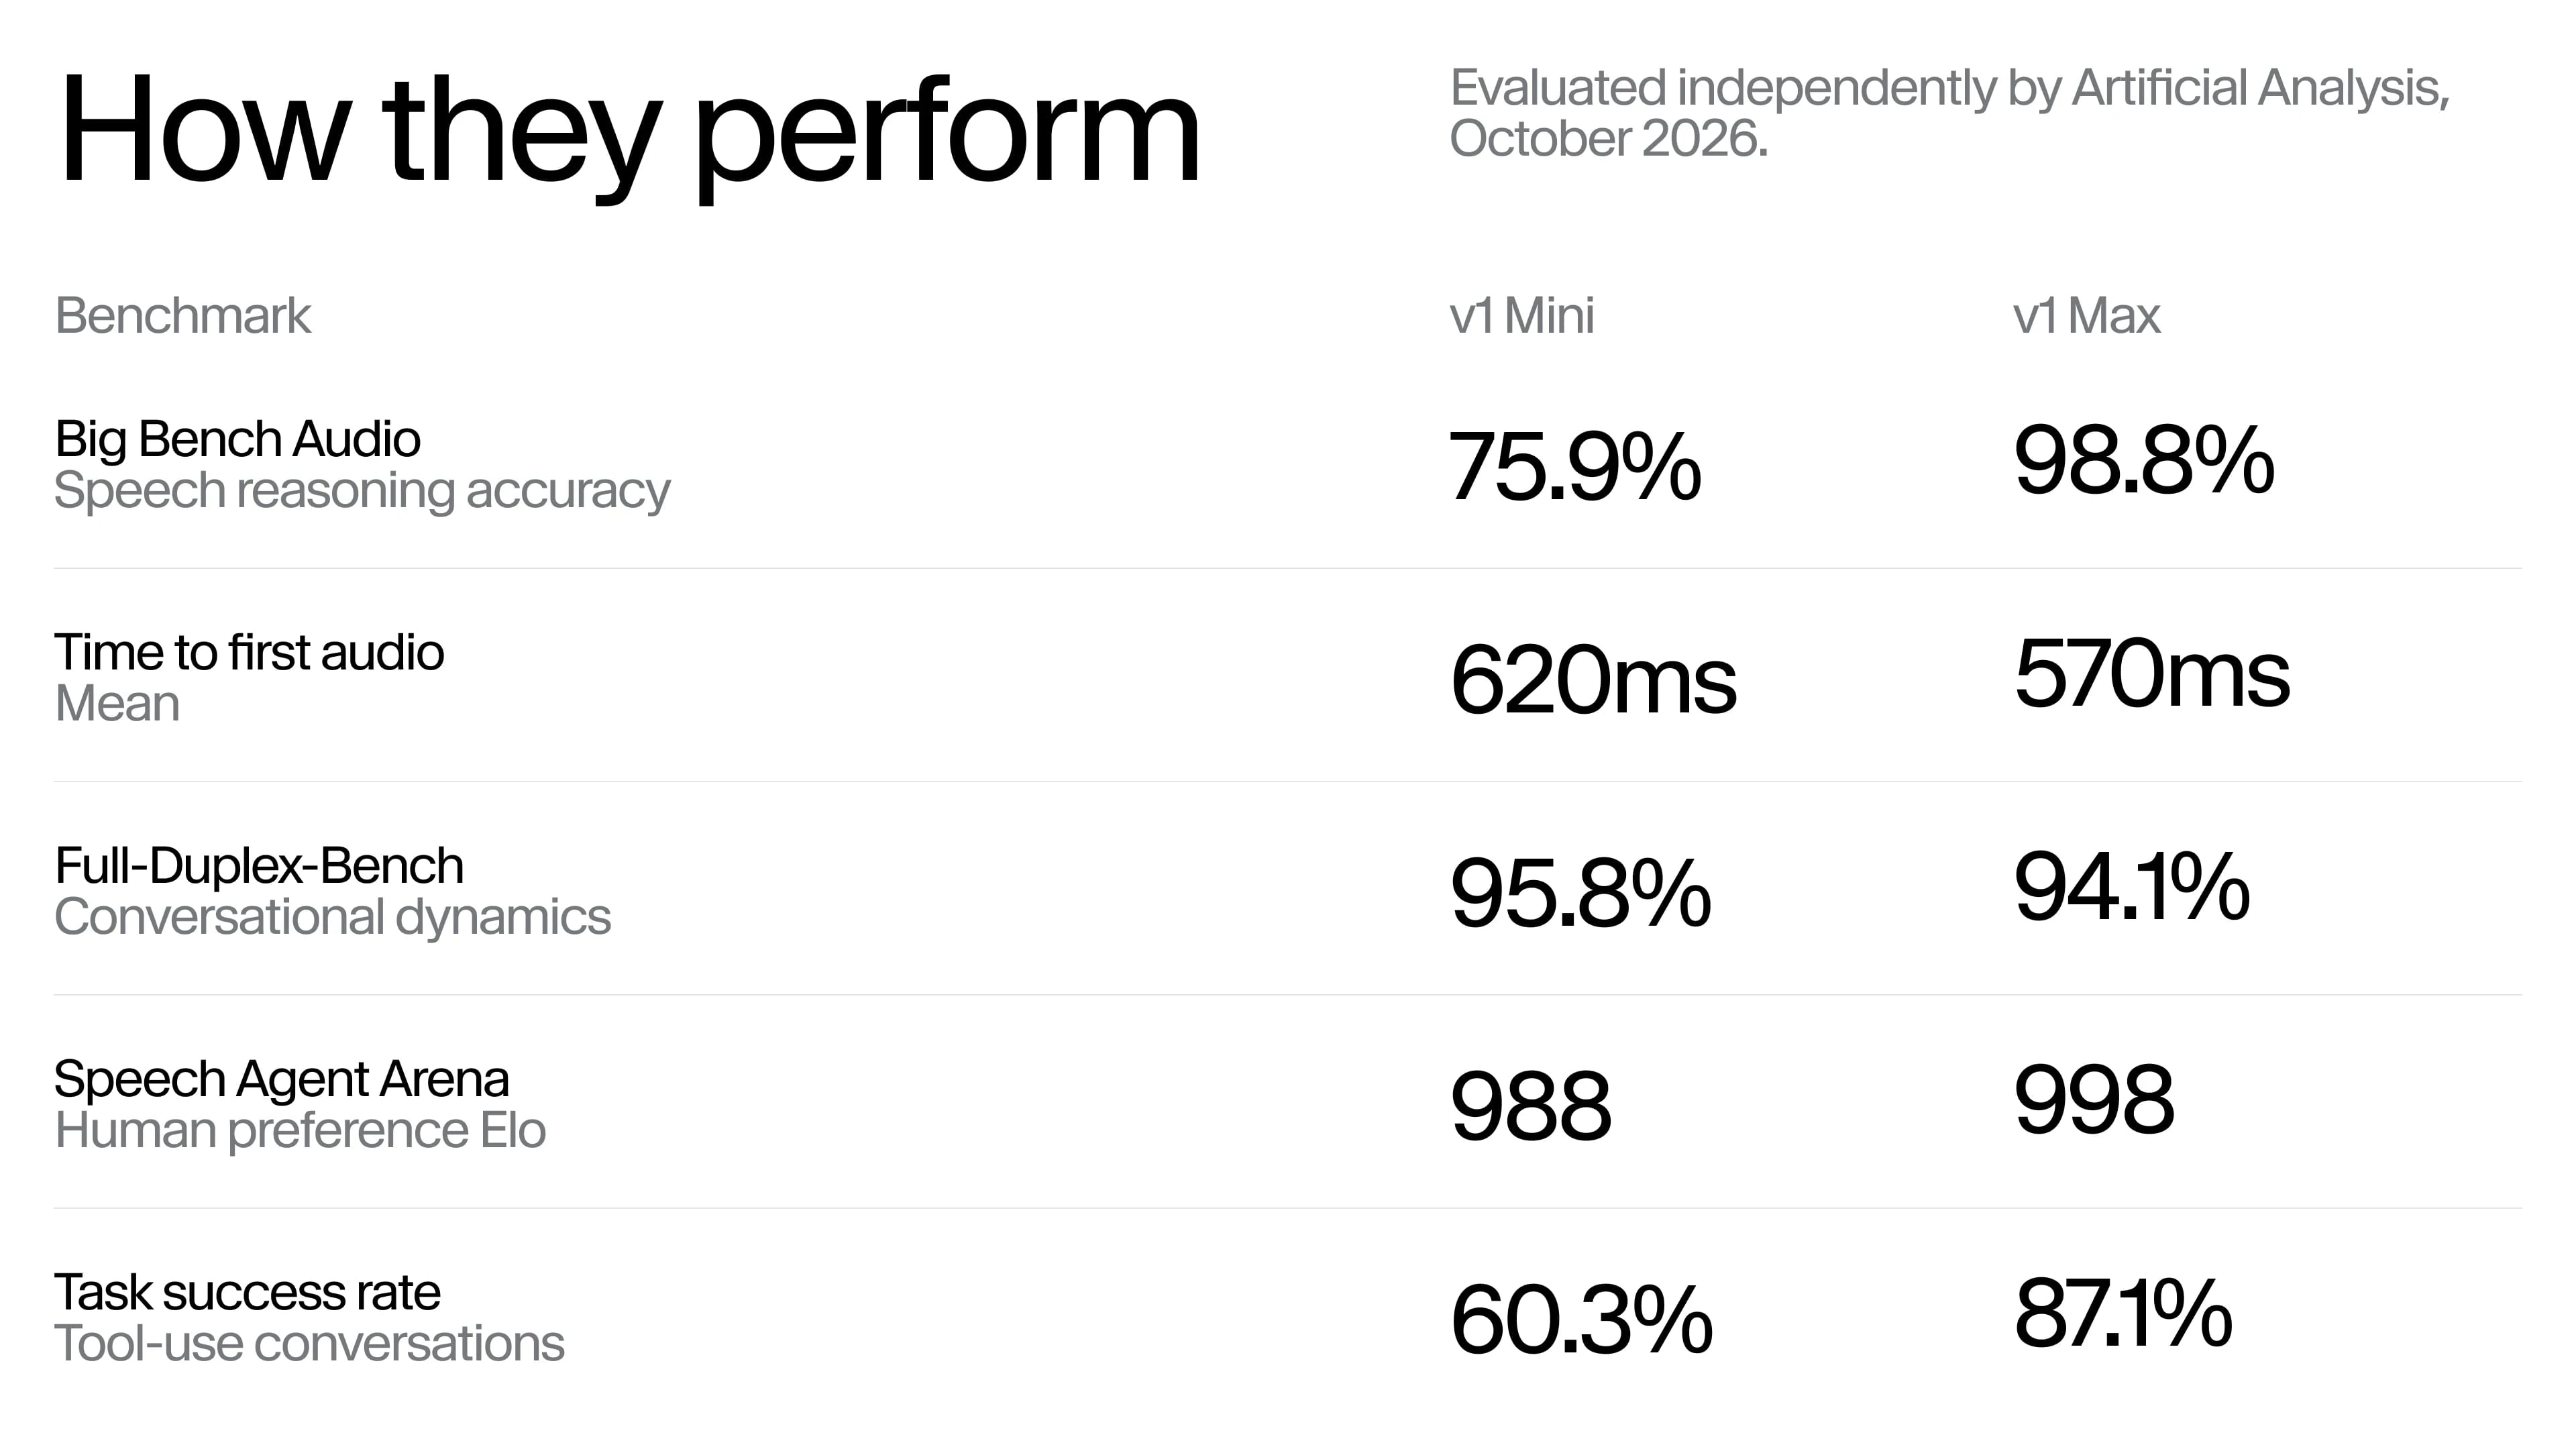
Artificial Analysis a évalué les deux modèles de manière indépendante selon trois benchmarks publics : Big Bench Audio pour le raisonnement vocal, Full-Duplex-Bench pour la dynamique conversationnelle et Speech Agent Arena pour les préférences humaines et la réussite des tâches.
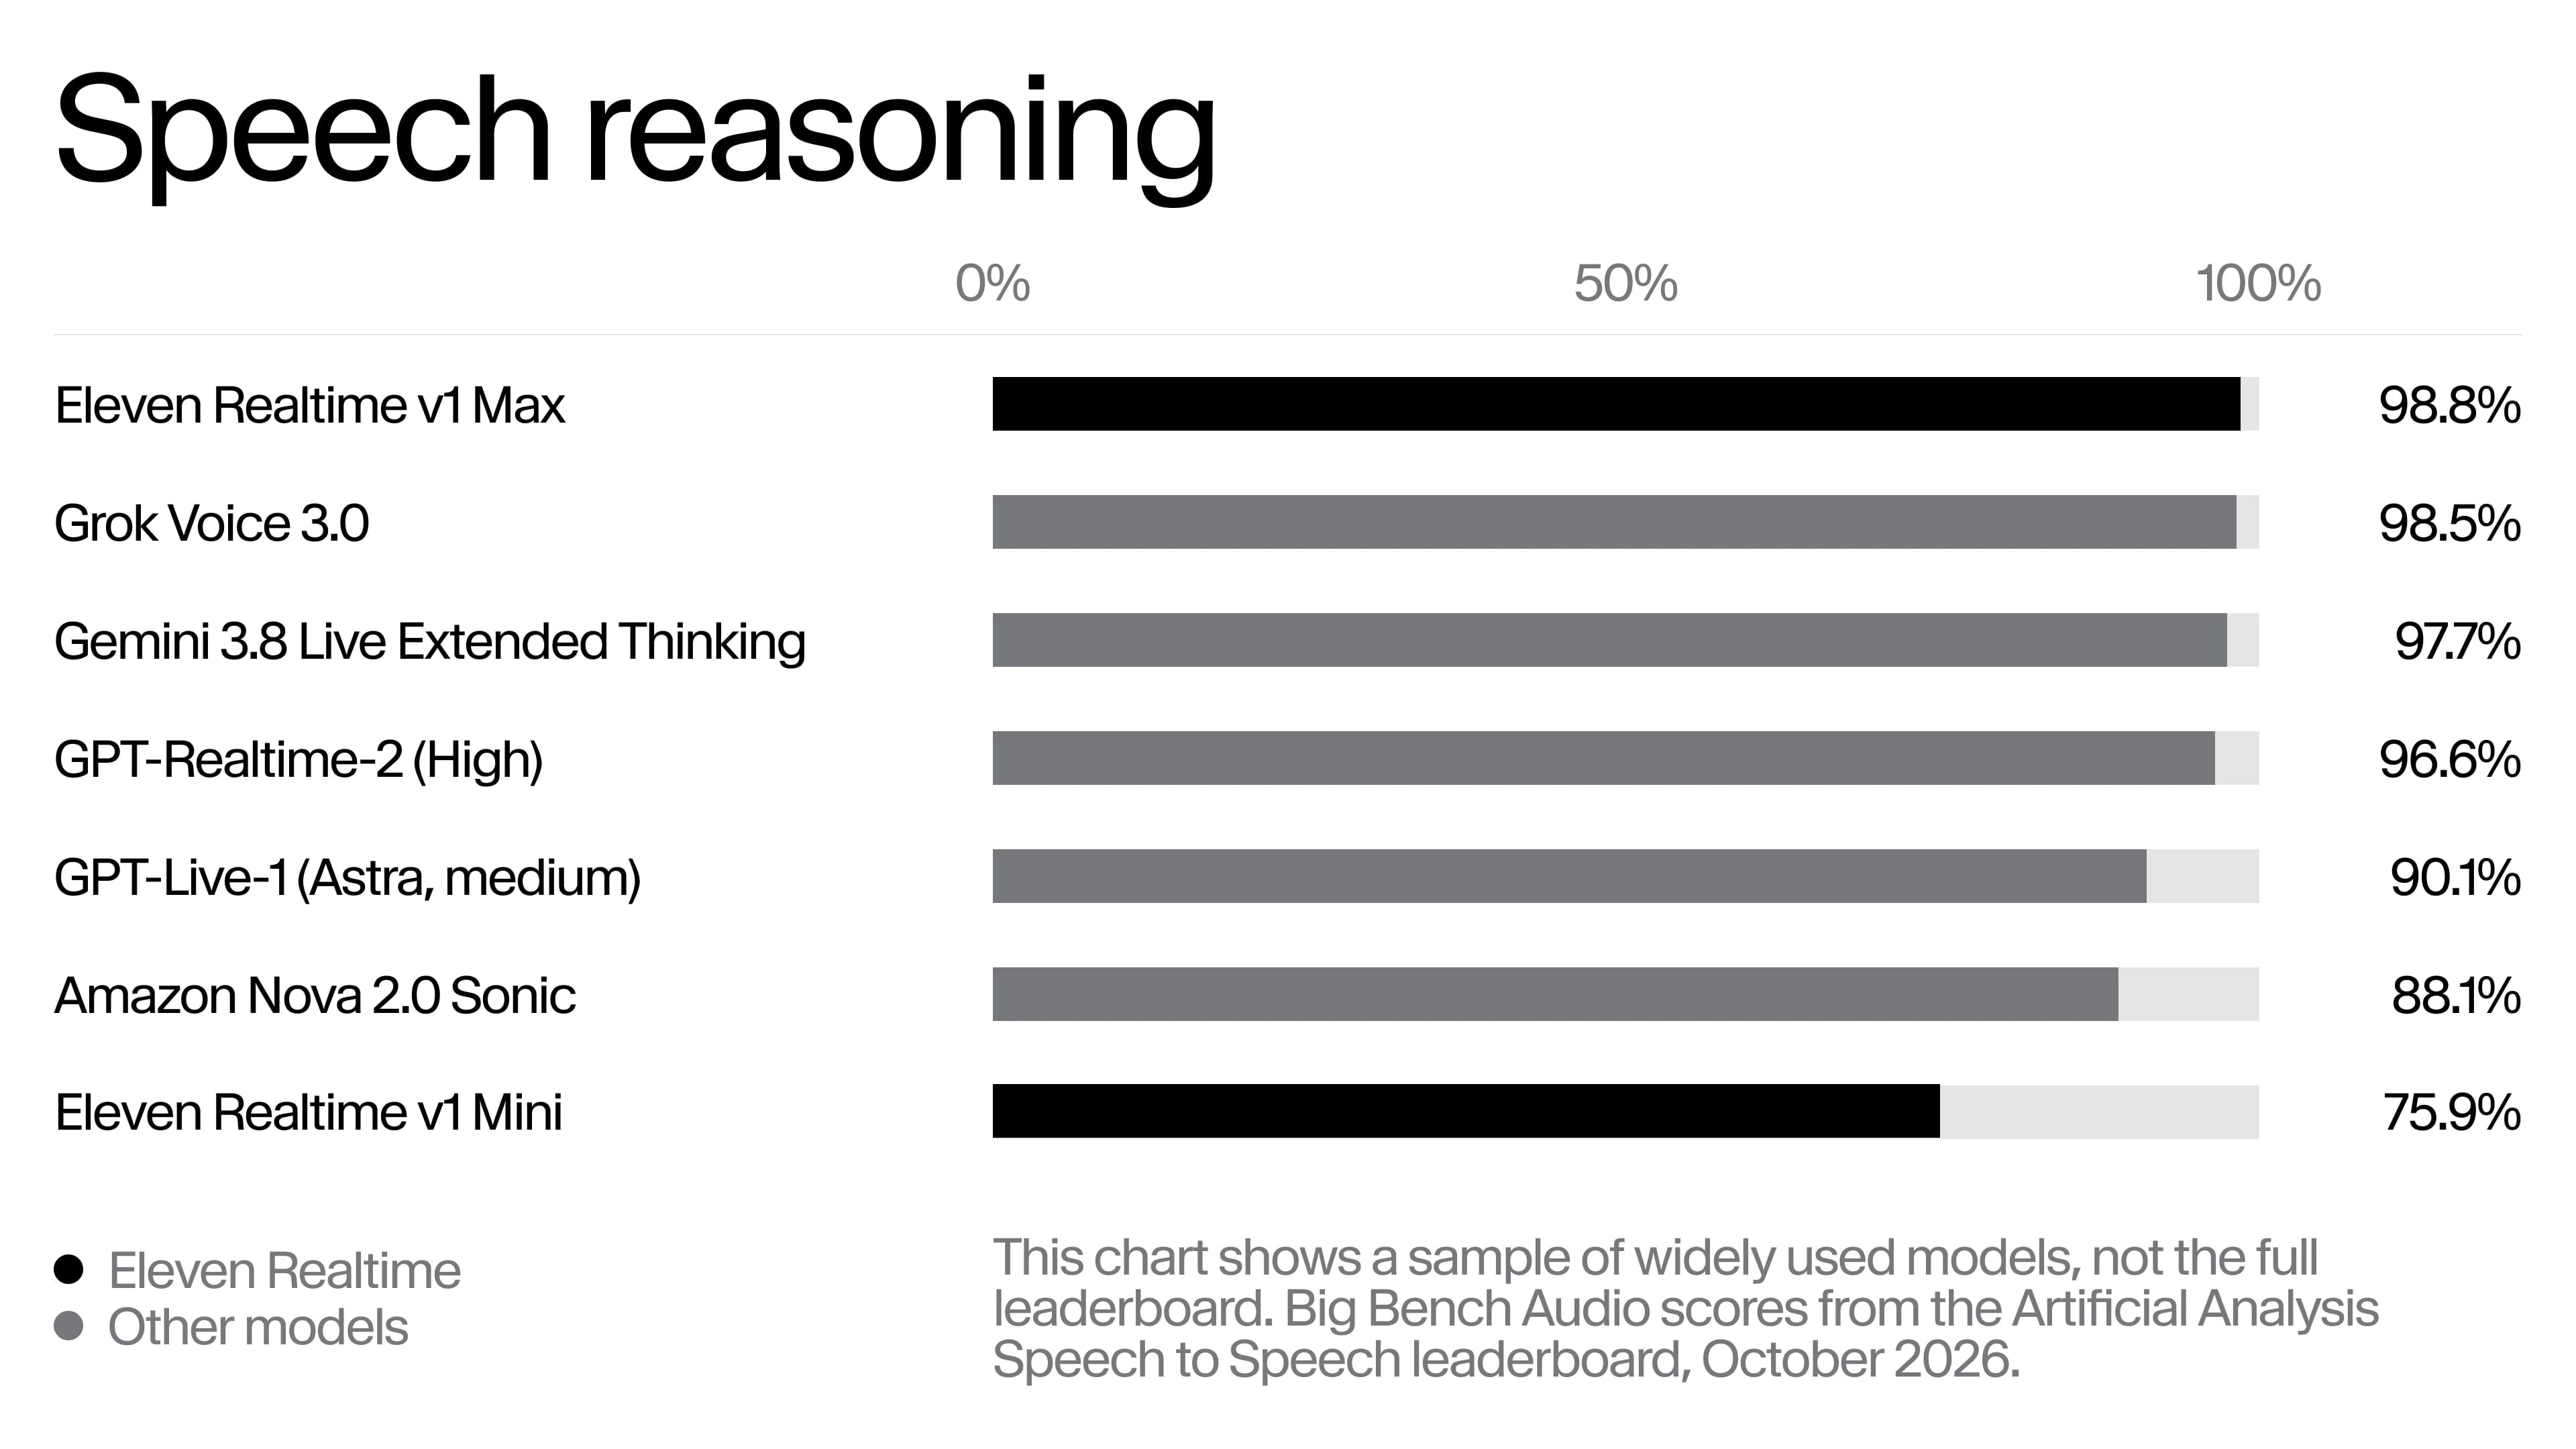
Raisonnement vocal
Big Bench Audio pose oralement 1 000 questions de raisonnement et évalue la réponse prononcée. Realtime v1 Max a répondu correctement à 98,8 % des questions, contre 75,9 % pour v1 Mini.
Vitesse
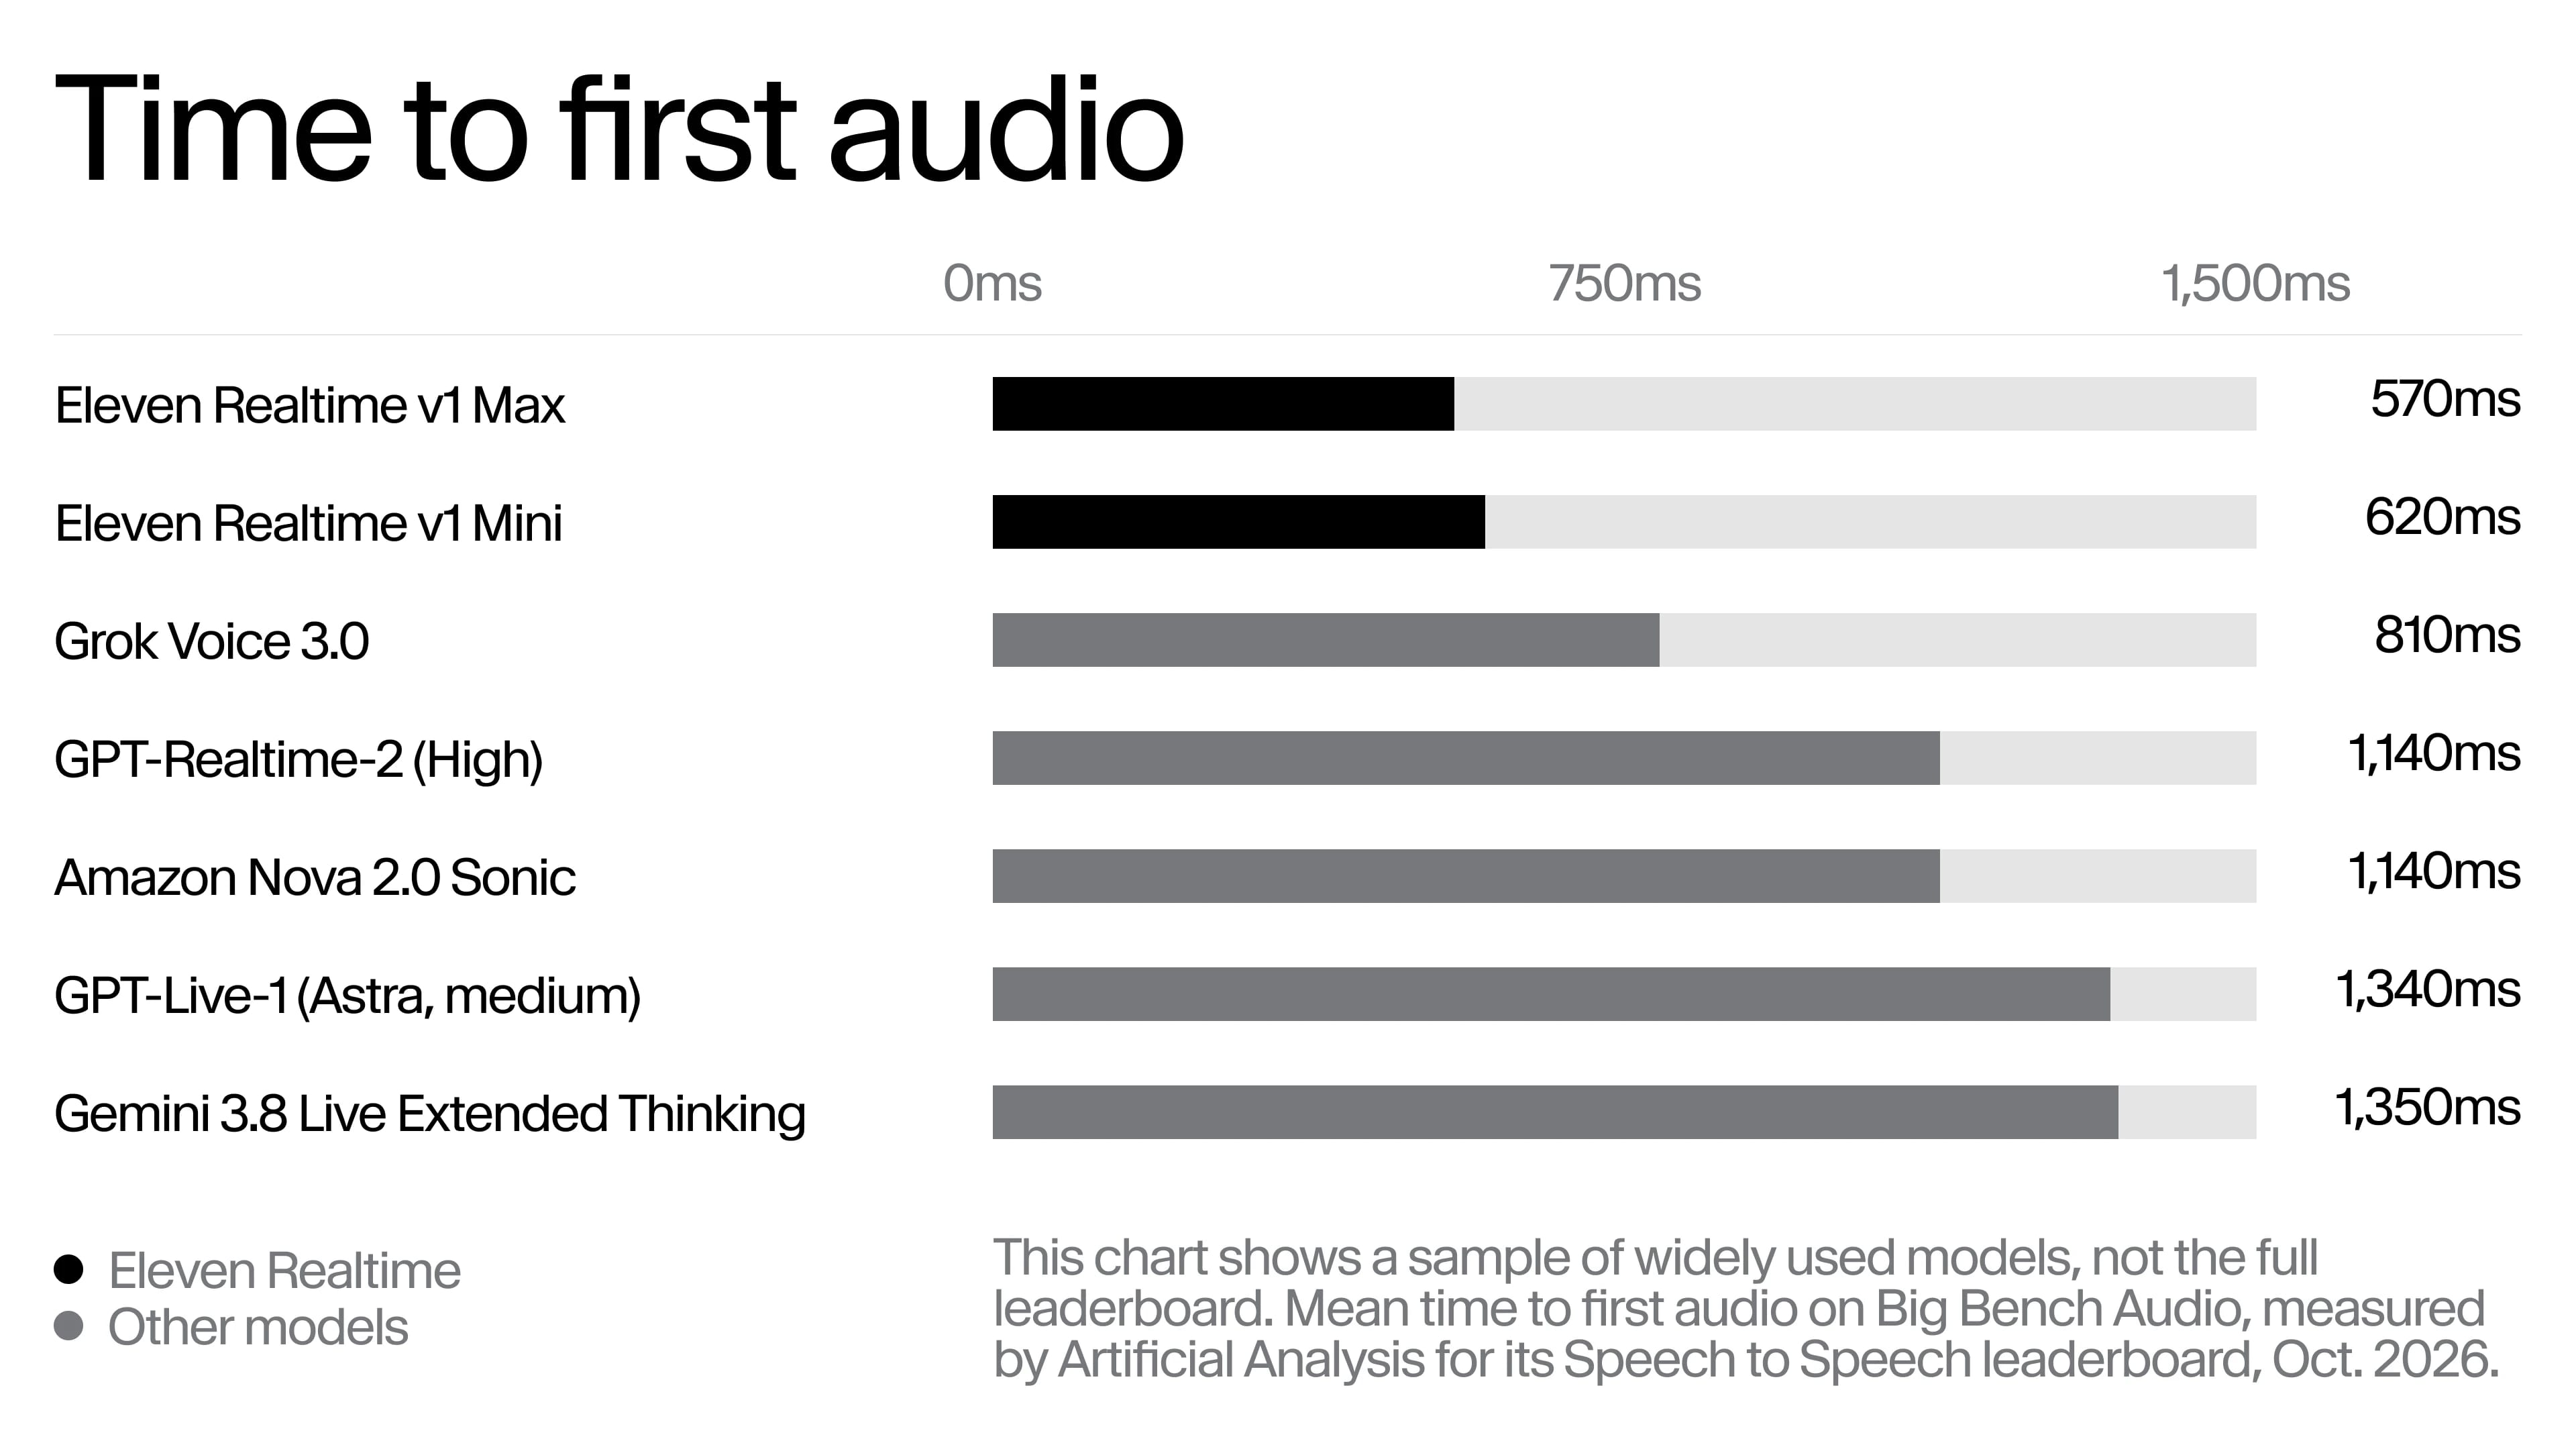
Big Bench Audio pose oralement 1 000 questions de raisonnement et évalue la réponse prononcée. V1 Max commence à parler en 0,57 seconde en moyenne, contre 0,62 seconde pour v1 Mini.
La frontière de Pareto entre précision et vitesse
La précision et la vitesse sont généralement considérées comme un compromis. Les modèles qui obtiennent les meilleurs résultats sur Big Bench Audio sont les plus longs à répondre, tandis que les plus rapides sacrifient une grande part de leur précision. V1 Max excelle sur ces deux indicateurs.
Dynamique conversationnelle et préférences humaines
Sur Full-Duplex-Bench, qui évalue les pauses, les tours de parole, les interruptions et les signaux d’écoute, v1 Mini obtient 95,8 % et v1 Max 94,1 %. Dans Speech Agent Arena, où des personnes comparent deux modèles lors de conversations en direct à l’aveugle, v1 Max a obtenu 998 points et v1 Mini 988. Pour les tâches nécessitant l’utilisation d’outils, v1 Max en a accompli 87,1 % et v1 Mini 60,3 %. C’est pourquoi nous recommandons Max pour les cas d’usage impliquant de nombreux appels d’outils.
Premiers pas
Dans ElevenAgents (recommandé)
Concevez un agent, ou ouvrez-en un existant, puis sélectionnez un modèle Realtime dans le menu déroulant. Vous bénéficiez alors de toutes les fonctionnalités d’ElevenAgents pour déployer des agents en production : des canaux par téléphone, sur le web, sur WhatsApp et de centre de contact en tant que service, des workflows, une base de connaissances, des garde-fous, des tests et la gestion des agents.
Consultez la documentation d’ElevenAgents pour plus de détails.
Via l’API Realtime
Si vous disposez déjà d’une intégration avec l’API Realtime d’OpenAI, le moyen le plus rapide d’essayer Eleven Realtime consiste à conserver votre code et à modifier sa destination. L’API Realtime se connecte via WebSocket et respecte les spécifications OpenAI Realtime : le SDK d’OpenAI fonctionne donc tel quel.
L’API Realtime se connecte uniquement via WebSocket. Une intégration WebRTC doit donc d’abord passer à WebSocket. Elle fonctionne également séparément d’ElevenAgents : si vous avez besoin de canaux, d’une base de connaissances ou d’autres fonctionnalités de la plateforme, utilisez ElevenAgents dès le départ.
Le guide de migration présente les étapes à suivre et les différences avec l’API d’OpenAI.