
Créez un agent vocal en 20 minutes avec ElevenLabs et Twilio
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Un agent vocal peut répondre aux appels entrants, transcrire les propos des appelants en temps réel avec Speech to Text (STT), générer une réponse avec un grand modèle de langage (LLM) et répondre oralement avec un module de Text to Speech (TTS). Avec ElevenLabs et Twilio, vous pouvez disposer d’un agent opérationnel sur un vrai numéro de téléphone en environ 20 minutes.
Pour les développeurs, la stack complète utilisée comprend ElevenLabs pour la synthèse vocale (Flash v2.5) et la transcription (Scribe v2 Realtime), Twilio pour la téléphonie, ainsi qu’OpenAI ou Anthropic pour le LLM. Tous ces éléments sont interchangeables : vous pouvez donc sélectionner les composants que vous connaissez le mieux et les utiliser à la place.
Cet article explique comment créer un agent vocal en 20 minutes avec Node.js et Typescript. Si vous préférez une alternative gérée qui prend en charge les tours de parole, les interruptions et la téléphonie sans que vous ayez à maintenir vous-même la cascade, découvrez ElevenAgents.
Fonctionnement de l’architecture d’un agent vocal
Avant d’écrire du code, il est utile de comprendre comment les trois services de votre stack technique s’articulent.
- Twilio : gère l’appel téléphonique et le transport audio.
- ElevenLabs : gère le STT via Scribe v2 Realtime et le TTS via Flash v2.5.
- LLM : gère l’appel d’outils et la rédaction de la réponse.
Chaque étape est un adaptateur léger. Vous pouvez donc remplacer un service par un autre sans modifier le reste. Par exemple, vous pouvez remplacer le LLM OpenAI par Anthropic sans réécrire les autres composants.
Un appel téléphonique atteint votre serveur via Twilio. Twilio répond à l’appel PSTN, ouvre un WebSocket vers votre serveur et transmet l’audio de l’appelant sous forme de flux de trames mu-law encodées en base64. Votre serveur exécute la cascade et renvoie l’audio synthétisé via ce même WebSocket, que Twilio lit à l’appelant.
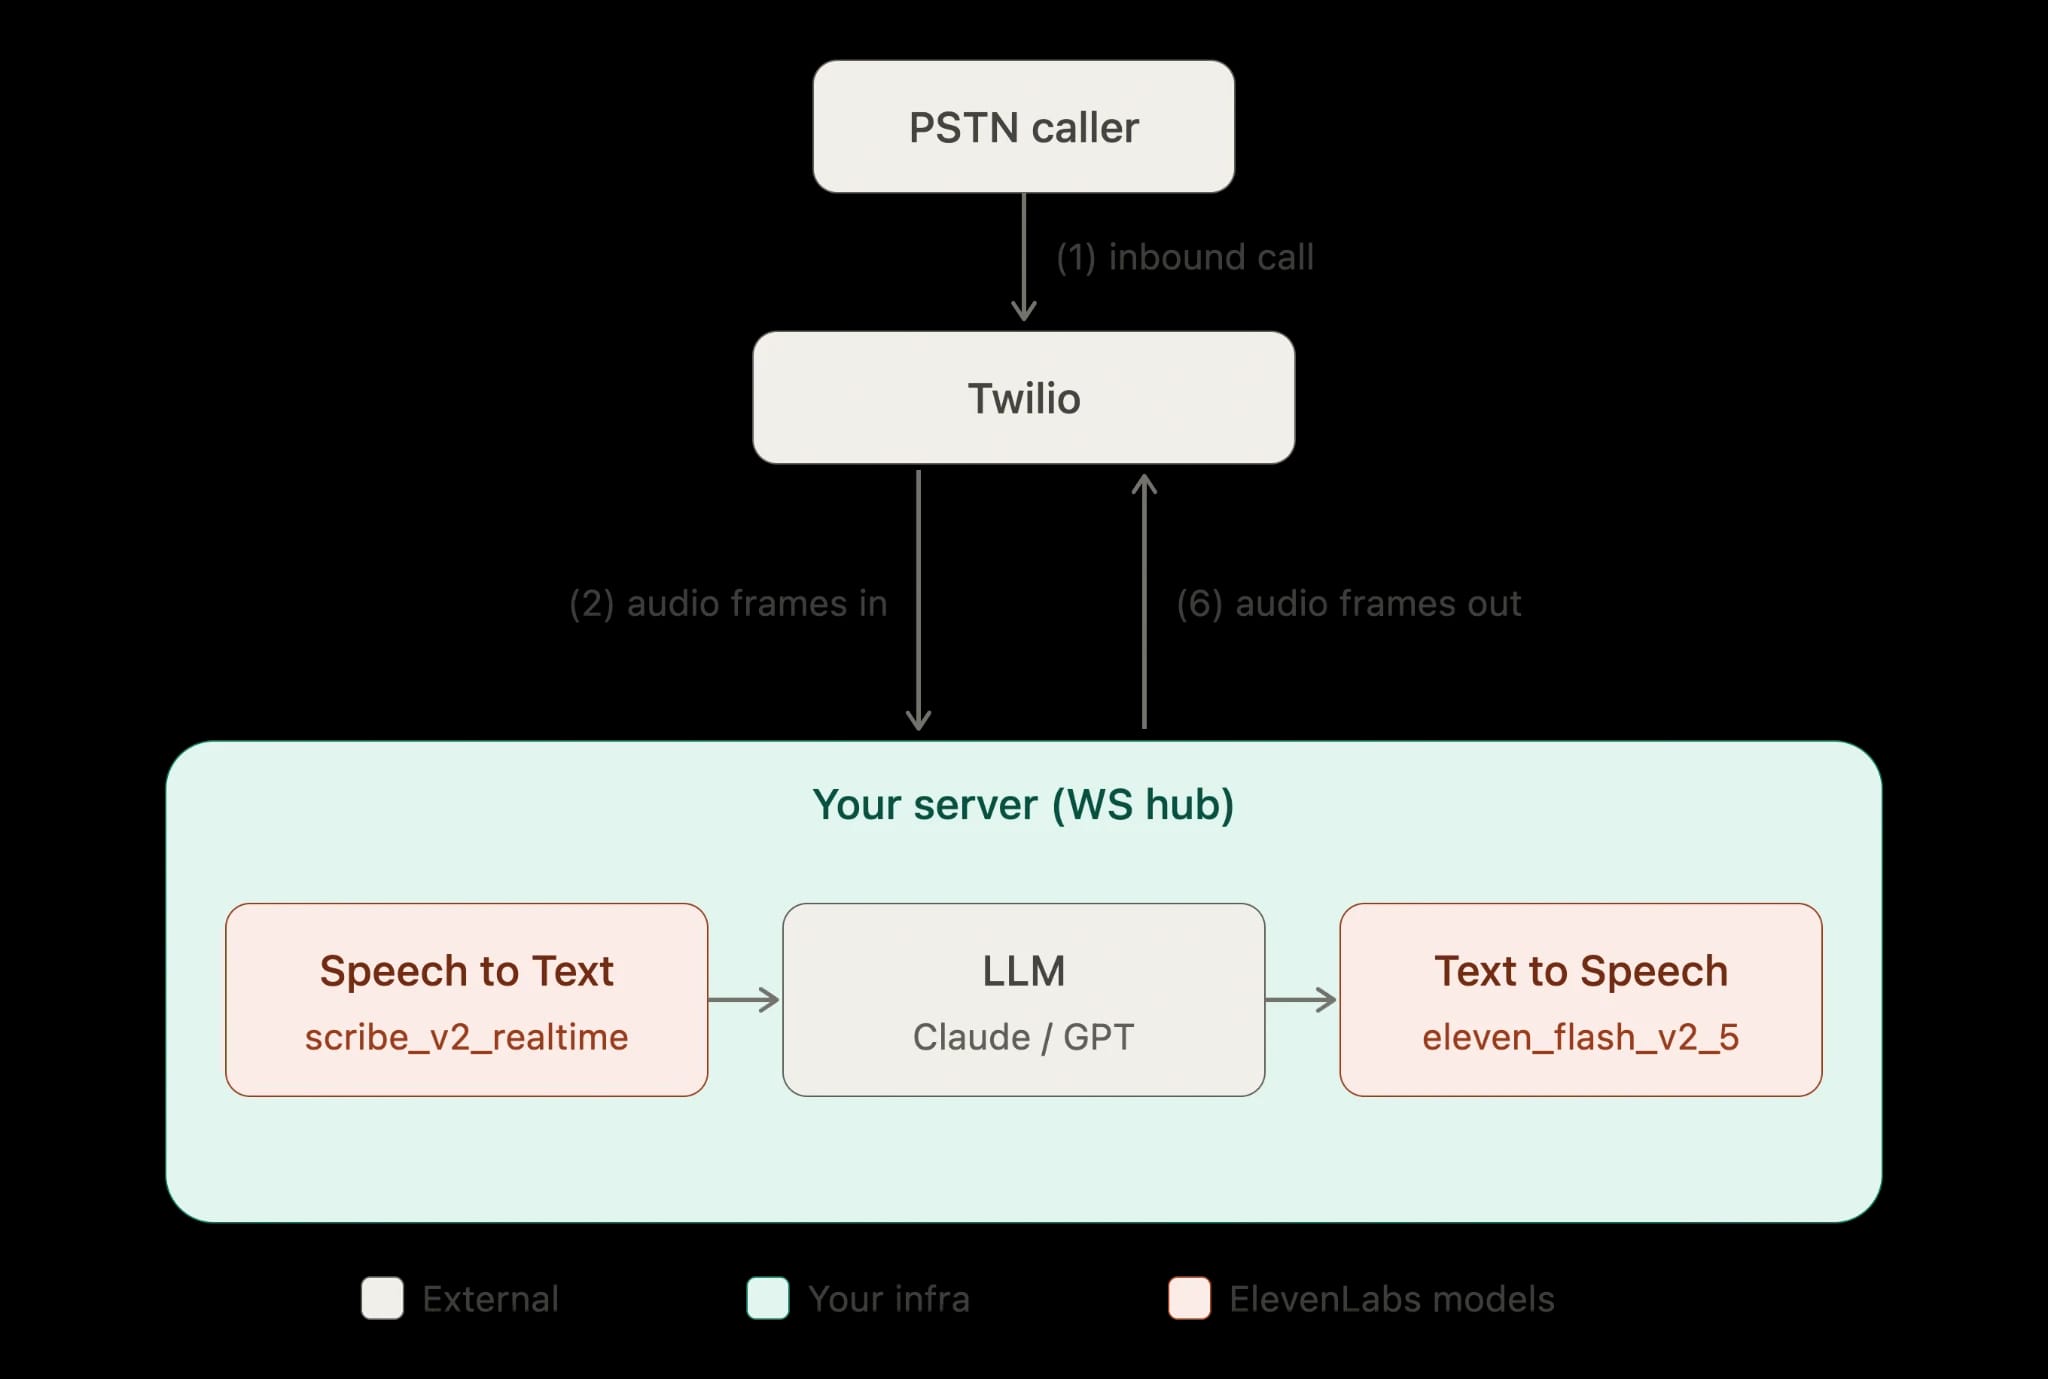
Voici le flux que vous utiliserez pour créer un agent vocal :
Un appelant compose votre numéro Twilio. Twilio récupère un document TwiML depuis votre webhook. Le TwiML demande à Twilio d’ouvrir un Media Stream vers votre point de terminaison WebSocket. Twilio transmet l’audio entrant sous forme d’événements JSON contenant des charges utiles mu-law (ulaw_8000) encodées en base64.
Votre serveur transmet les segments audio à Scribe v2 Realtime pour une transcription en streaming. Lorsqu’un tour de parole de l’appelant est finalisé, vous envoyez la transcription au LLM, puis synthétisez la réponse avec Flash v2.5 au format ulaw_8000. Vous renvoyez les trames mu-law synthétisées à Twilio via le WebSocket, encodées en base64, et Twilio les lit à l’appelant.
Scribe v2 Realtime émet des transcriptions partielles avec une latence d’environ 150 ms, et Flash v2.5 atteint environ 75 ms d’inférence du modèle, hors latence réseau et applicative. Le LLM contribue le plus, et de la manière la moins prévisible, au délai avant le premier audio. C’est là que se concentre la majeure partie du budget de latence. Pour réduire ce délai, nous diffusons la sortie du LLM token par token et commençons la synthèse avant que le modèle ait terminé sa phrase.
Pour comprendre les compromis entre les modèles qui motivent ces choix, consultez la présentation des modèles ainsi que l’explication pour comprendre la latence.
Ce dont vous avez besoin avant de créer un agent vocal
Ce guide suppose que vous avez réuni quatre éléments. Chacun est rapide à configurer, mais l’absence de l’un d’eux empêchera le serveur de s’exécuter.
Voici les prérequis à vérifier :
- Un numéro Twilio compatible avec Voice : notez le numéro, ainsi que l’Account SID et l’Auth Token dans la console Twilio.
- Clé API ElevenLabs : créez-la dans votre Dashboard ElevenLabs. La clé est transmise dans l’en-tête xi-api-key et est confidentielle, conservez-la donc uniquement côté serveur. Consultez l’authentification API.
- Clé API LLM : ce tutoriel considère Anthropic Claude et OpenAI comme des backends interchangeables, choisissez donc l’un des deux.
- Ngrok, ou tout autre tunnel, pour le développement local : Twilio doit pouvoir joindre votre serveur via une URL HTTPS et WSS publique, ce que ngrok permet sans déployer quoi que ce soit.
Définissez vos secrets comme variables d’environnement et ne les validez jamais dans votre dépôt.
Lancez ensuite un tunnel vers le port que votre serveur utilisera :
Comprendre le protocole Twilio Media Streams
Twilio ne vous fournit pas de socket audio brut. Il encapsule plutôt l’ensemble dans un protocole JSON structuré via WebSocket. Comprendre les quatre types d’événements et le format d’envoi permettra de comprendre parfaitement le gestionnaire WebSocket de l’étape 2 avant de l’écrire.
Une fois connecté à votre WebSocket, Twilio envoie une séquence de messages texte JSON pouvant appartenir à quatre types d’événements.
L’événement connected arrive en premier et confirme que le WebSocket est actif. L’événement start est envoyé une fois au démarrage du flux média. Il contient un streamSid que vous devez stocker, car il est nécessaire pour renvoyer de l’audio, ainsi que les métadonnées de l’appel dans start.customParameters et start.callSid.
L’événement media est récurrent : media.payload est un segment d’audio mu-law à 8 kHz encodé en base64, de 20 ms par trame, et media.track vaut inbound pour l’audio de l’appelant. Enfin, stop est envoyé à la fin du flux, généralement lorsque l’appel est raccroché.
Pour lire de l’audio en retour, envoyez un message de type media avec le même streamSid et une charge utile mu-law encodée en base64. Pour interrompre l’audio déjà mis en file d’attente, envoyez un message clear avec le streamSid, ce qui vide le tampon de sortie de Twilio.
Les encodages entrants et sortants sont identiques (ulaw_8000). Nous demandons ulaw_8000 à ElevenLabs Text to Speech et transmettons les octets directement à Twilio, sans rééchantillonnage intermédiaire.
Étape 1 : servir le webhook TwiML
Lorsqu’un appel arrive, Twilio envoie une requête HTTP à votre webhook, à laquelle vous répondez avec un TwiML qui connecte l’appel à votre Media Stream. Le verbe <Connect><Stream> ouvre un WebSocket bidirectionnel. Utilisez <Connect> plutôt que <Start> : il maintient l’appel pendant toute la durée du flux et vous permet de renvoyer de l’audio, ce qui est l’objectif de cette configuration.
Le TwiML renvoyé par le webhook est :
Dans Express, cela se résume à un seul gestionnaire POST qui renseigne l’hôte et renvoie le document :
Dans la console Twilio, configurez le webhook « A call comes in » du numéro sur https://your-subdomain.ngrok.app/incoming-call en utilisant HTTP POST.
Étape 2 : accepter le WebSocket Media Stream
Le gestionnaire WebSocket lit les événements Twilio, pilote la cascade et renvoie l’audio.
Nous conservons un petit état par appel : le streamSid, une connexion STT et un indicateur précisant si l’agent parle actuellement. Le gestionnaire décode chaque trame média entrante depuis base64 et transmet les octets mu-law bruts au STT :
Étape 3 : transcrire avec Scribe v2 Realtime
Scribe v2 Realtime accepte des segments audio en streaming et renvoie des transcriptions partielles et finales. Il prend directement en charge l’encodage mu-law, nous lui transmettons donc les trames de Twilio sans les modifier.
Il propose également la détection d’activité vocale pour une segmentation basée sur le silence et un contrôle de validation manuel afin de finaliser un segment. Pour un agent téléphonique, la segmentation pilotée par VAD est généralement le bon choix, car une pause naturelle est le signal le plus fiable indiquant qu’un tour de parole de l’appelant est terminé.
Voici les étapes : ouvrez un flux STT au début de l’appel. Transmettez chaque segment mu-law entrant. Réagissez aux transcriptions finalisées en appelant le LLM.
L’interface du client STT en temps réel évolue encore. La structure ci-dessous est donc placée derrière un petit adaptateur TypeScript (openRealtimeStt), que vous implémentez par rapport à l’API en production plutôt qu’à un ensemble figé de noms de champs. Considérez onFinal comme le hook qui transmet un tour de parole complet au stade suivant.
La latence de reconnaissance en temps réel est d’environ 150 ms pour les résultats partiels, ce qui réduit l’intervalle perçu entre la fin de parole de l’appelant et le début de réponse de l’agent. Pour l’équivalent en traitement par lots et l’ensemble des fonctionnalités, consultez la documentation Speech to Text et la page produit Speech to Text en temps réel.
Étape 4 : générer une réponse avec un LLM
C’est l’étape qui produit la réponse. Le LLM reçoit l’historique de la conversation et renvoie le texte de l’assistant. Diffusez la réponse en streaming pour commencer la synthèse dès la première phrase.
Ici, elle s’appuie sur OpenAI :
L’ID de modèle ci-dessus, gpt-4.1-mini, est un exemple de choix à faible latence. claude-haiku-4-5 est une option comparable chez Anthropic. Chaque fournisseur peut respecter le même contrat llmReply : remplacez le corps de la fonction et le reste de l’agent reste inchangé.
Le prompt système limite la longueur des réponses, ce qui est important au téléphone : les réponses longues semblent lentes et sont difficiles à interrompre naturellement.
Étape 5 : synthétiser avec Flash TTS en ulaw_8000
Le texte doit maintenant devenir un audio que Twilio peut lire. Demandez Flash v2.5 avec outputFormat: "ulaw_8000" afin que les octets correspondent à l’encodage attendu par Twilio, puis diffusez l’audio et renvoyez chaque segment via le WebSocket sous forme d’événement media.
Accumulez les tokens du LLM en fragments de la taille d’une phrase et synthétisez chaque fragment dès qu’il est complet, plutôt que d’attendre la réponse entière. Cela réduit le délai avant le premier audio, car l’appelant entend la première phrase pendant que le modèle produit encore la deuxième. Pour un contrôle plus fin de la synthèse incrémentale, le guide WebSocket TTS en temps réel explique comment envoyer du texte vers un unique socket de synthèse ouvert. L’approche de streaming HTTP ci-dessous est plus simple et convient aux courts tours conversationnels.
Préparer votre agent vocal IA pour la production
Après les cinq étapes ci-dessus, vous disposez d’un agent fonctionnel. Ce n’est pas la même chose qu’un déploiement en production.
Vous devez prendre en compte plusieurs éléments avant de placer l’agent sur une véritable ligne téléphonique.
Valider les signatures des webhooks Twilio
Toute personne connaissant l’URL de votre webhook peut lui envoyer une requête POST. La première étape consiste donc à confirmer que la requête provient bien de Twilio. Twilio signe chaque requête avec votre Auth Token dans l’en-tête X-Twilio-Signature, et vous devez rejeter toute requête qui échoue à la validation. La signature est calculée sur l’URL complète et les paramètres POST. Vous devez donc la calculer de la même manière que Twilio.
L’utilitaire Twilio s’en charge pour vous :
Gérer correctement les secrets
Conservez ELEVENLABS_API_KEY, la clé LLM et TWILIO_AUTH_TOKEN dans un gestionnaire de secrets, et non dans le code source ou dans des fichiers d’environnement en texte brut validés dans un dépôt. Limitez la clé ElevenLabs aux seuls points de terminaison nécessaires à ce service et attribuez-lui un quota de crédits, afin qu’une fuite ait un impact limité plutôt qu’illimité.
Les forfaits Enterprise permettent en outre de limiter une clé à des plages d’IP spécifiques par liste blanche d’IP. Ce serveur utilise directement la clé API, car elle ne quitte jamais votre backend. Si une logique audio était déplacée vers un navigateur ou un client mobile, vous passeriez à des jetons à usage unique afin que la clé ne soit jamais exposée côté client.
Comprendre la limite de requêtes simultanées
Chaque forfait possède une limite de requêtes simultanées, qui varie selon la famille de modèles. Cette limite correspond au nombre de requêtes générant activement de l’audio au même moment.
Pour un agent téléphonique, ce mode de calcul vous avantage. La génération audio est plus rapide que la lecture ; chaque appel ne consomme donc des requêtes simultanées TTS que pendant les courtes périodes de synthèse d’une réponse, et non durant tout l’appel. À titre indicatif, une limite d’environ cinq requêtes simultanées peut prendre en charge de l’ordre de 100 appels conversationnels simultanés, car la génération se termine bien avant la lecture.
Surveillez néanmoins la marge disponible plutôt que de faire des suppositions. Les réponses ElevenLabs exposent les en-têtes current-concurrent-requests et maximum-concurrent-requests. Enregistrez-les et créez des alertes à l’approche du maximum. Lorsque vous dépassez la limite, les requêtes sont mises en file d’attente selon leur priorité, ce qui ajoute généralement environ 50 ms, tandis qu’une surcharge persistante renvoie HTTP 429.
Gérez les réponses HTTP 429 avec un court délai de relance. Si elles persistent, augmentez les limites en effectuant un upgrade depuis la page des tarifs ou, pour les clients Enterprise, en passant par votre responsable de compte.
Gérer l’interruption et les chevauchements de parole
Un appelant qui commence à parler alors que l’agent s’exprime attend de lui qu’il s’arrête. C’est l’interruption en cours de parole, et sa bonne gestion contribue largement à rendre un agent naturel plutôt que scripté.
Détectez la parole de l’appelant pendant la lecture de l’agent à l’aide du signal VAD du STT. Lorsque vous la détectez, effectuez deux actions. D’abord, arrêtez de transmettre les segments TTS : le drapeau agentSpeaking dans speak s’en charge déjà en interrompant la boucle. Ensuite, envoyez à Twilio un message clear pour vider l’audio déjà mis en file d’attente de son côté.
Sans clear, Twilio continue de lire l’audio mis en mémoire tampon après l’arrêt de vos envois. L’agent semble alors parler par-dessus l’appelant.
Journaliser, surveiller et gérer les échecs avec élégance
Instrumentez chaque étape afin d’attribuer la latence lorsqu’un appel semble lent. Mesurez l’intervalle entre la transcription finale et le premier token du LLM, entre le premier token du LLM et le premier octet TTS, puis entre le premier octet TTS et la trame envoyée à Twilio. Vous constaterez que l’essentiel de votre latence variable se situe au niveau du LLM ; les étapes STT et TTS sont comparativement stables.
Prévoyez ensuite les défaillances partielles. Le LLM peut expirer, le flux STT peut être interrompu, et l’aller-retour réseau vers ElevenLabs varie d’environ 20 à 200 ms sur Internet public selon la zone géographique. Hébergez votre serveur à proximité de vos appelants, et pas uniquement d’ElevenLabs, car ElevenLabs achemine déjà le trafic vers le plus proche de ses clusters en Amérique du Nord, en Europe et en Asie du Sud-Est.
Lorsqu’une étape échoue, ne laissez pas l’appelant dans le silence : synthétisez une courte phrase de secours (« Désolé, pourriez-vous répéter ? ») et maintenez l’appel actif. Encadrez chaque étape d’un délai d’expiration et d’un try/catch afin qu’un tour de parole échoué ne ferme pas tout le WebSocket.
Quelques paramètres par défaut supplémentaires méritent d’être définis avant le lancement :
- Limitez la longueur des réponses dans le prompt système, comme indiqué, afin que les tours restent courts et interruptibles.
- Limitez l’historique de la conversation afin que les appels longs n’augmentent pas indéfiniment le contexte du LLM.
- Définissez une durée maximale d’appel pour éviter que des sessions bloquées ne consomment silencieusement des requêtes simultanées.
Pour continuer à optimiser les éléments que vous contrôlez, le document sur la latence explique l’origine du délai avant le premier audio, la présentation des modèles présente les compromis entre vitesse et qualité, et le guide WebSocket TTS en temps réel montre comment réduire davantage la latence de synthèse grâce à l’entrée de texte incrémentale.
Créez des agents vocaux prêts pour la production avec ElevenAPI
Après 20 minutes, vous disposez de chaque couche d’un agent vocal prêt pour la production. Twilio gère la téléphonie, Scribe v2 Realtime transcrit, un LLM génère les réponses et Flash v2.5 répond oralement via le même WebSocket.
Si vous préférez ne pas maintenir vous-même la cascade, ElevenAgents fournit la gestion des tours de parole, des interruptions et l’intégration téléphonique sous la forme d’un service géré, reposant sur les mêmes modèles que vous venez de connecter manuellement.
Pour continuer à optimiser une stack que vous contrôlez, consultez la page produit ElevenAPI pour découvrir les forfaits, les limites de requêtes simultanées et la Voice Library. Vous pouvez également vous inscrire et commencer dès aujourd’hui à effectuer votre premier appel.
FAQ : créer un agent vocal avec Twilio et ElevenLabs

Tadas Petra est ingénieur en relations développeurs et aide les développeurs à utiliser la suite de produits ElevenLabs. Il est aussi le fondateur de Hungrimind, une plateforme d’apprentissage pour développeurs. Auparavant, il était Lead Developer Advocate chez Agora et formateur chez Zero To Mastery.




