Créer Vibe Draw : associer ElevenLabs à FLUX Kontext pour créer des images à la voix
- Rédigé par
- Ryan Morrison
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Les interfaces vocales transforment notre façon de communiquer avec l’IA. Et si créer une image était aussi simple que de la décrire à voix haute ?
C’est cette idée qui m’a conduit à créer Vibe Draw comme projet de week-end. Cet outil créatif centré sur la voix associe l’IA vocale d’ElevenLabs à FLUX Kontext de Black Forest Labs pour transformer des instructions orales en images.
FLUX Kontext représente une nouvelle catégorie de modèles d’images. Contrairement aux systèmes texte-image traditionnels, Kontext gère à la fois la génération et la modification. Il peut créer de nouvelles images à partir d’instructions, modifier des images existantes et même fusionner plusieurs images de référence en un seul résultat.
Si des modèles comme GPT-4o et Gemini 2 Flash offrent des capacités multimodales, FLUX Kontext est conçu spécifiquement pour la manipulation visuelle de haute qualité. Lors de mes tests, j’ai pu modifier des lettres individuelles dans un texte stylisé ou repositionner un objet, simplement en décrivant le changement.
C’est alors que je me suis dit : « Pourquoi ne pas le faire à la voix ? » Et quelle meilleure base que la puissante technologie vocale d’ElevenLabs ?

Le défi technique
La création d’un système d’images piloté à la voix a nécessité de résoudre cinq problèmes clés :
- Compréhension du langage naturel : différencier les nouvelles créations des modifications
- Prise en compte du contexte : maintenir la continuité entre les interactions
- Gestion audio : éviter le chevauchement des réponses et gérer les files d’attente
- Génération visuelle : passer sans rupture de la génération à la modification
- Expérience utilisateur : rendre intuitives les interactions avancées avec l’IA
Vue d’ensemble de l’architecture
Vibe Draw fonctionne entièrement côté client et intègre les composants suivants :
- Web Speech API pour la reconnaissance vocale
- API TTS d’ElevenLabs pour les réponses vocales
- API FLUX Kontext pour la génération et la modification d’images
- Détection d’intention personnalisée pour comprendre les saisies des utilisateurs
Cette approche allège le prototype, mais les déploiements en production devraient faire transiter les requêtes par un serveur pour des raisons de sécurité.
Intégrer la voix avec ElevenLabs
Vibe Draw utilise l’API de synthèse vocale d’ElevenLabs, optimisée pour la réactivité conversationnelle :
Pour varier les réponses, elles sont sélectionnées aléatoirement à partir de modèles prédéfinis :
Gérer la lecture audio
Le chevauchement des réponses vocales brise l’illusion de conversation. Vibe Draw résout ce problème grâce à un système de file d’attente audio :
Chaque message est lu intégralement avant de déclencher le suivant.
Détection d’intention et gestion du contexte
Le système utilise la détection de mots-clés et du contexte pour déterminer si l’instruction de l’utilisateur concerne une nouvelle image ou une modification :
Cette approche garantit que les modifications ne sont appliquées que lorsqu’une image existe déjà et que le contexte le confirme clairement.
Génération d’images avec FLUX Kontext
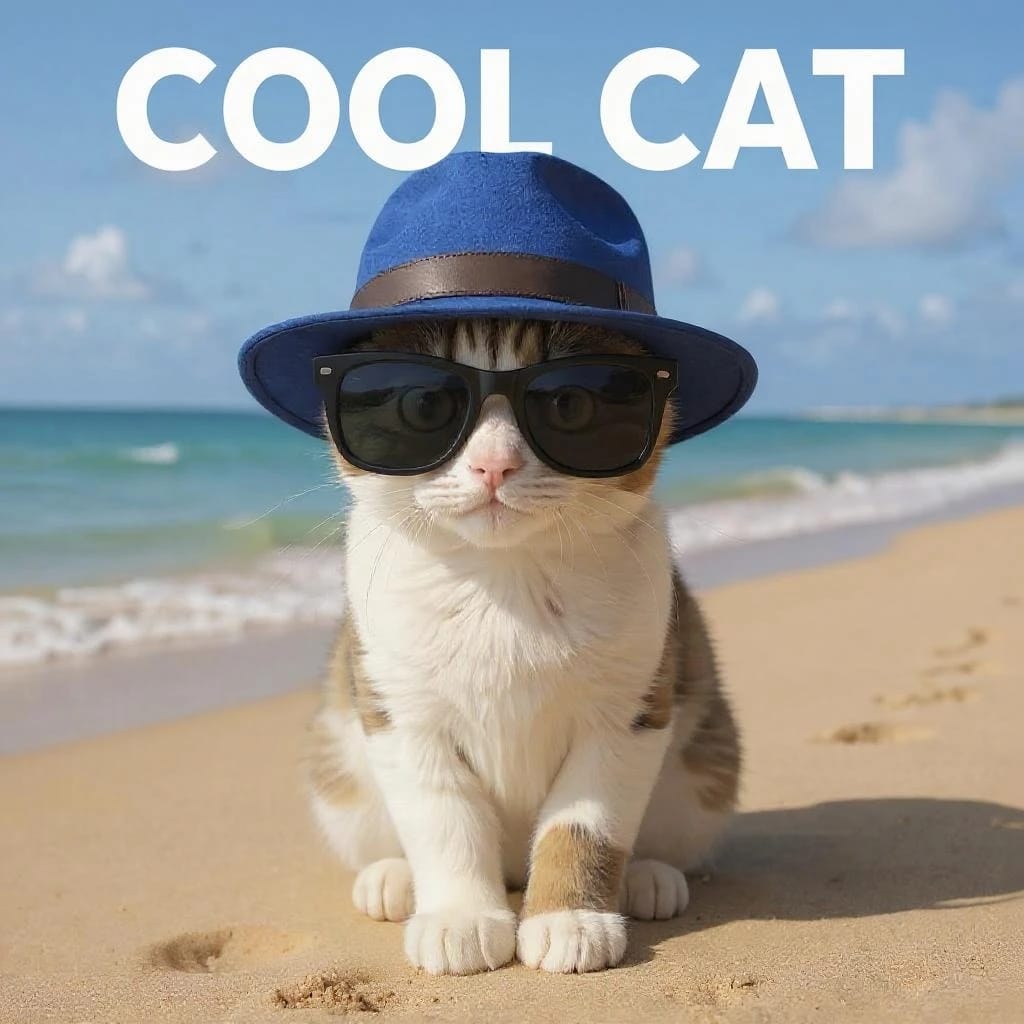
Kontext prend en charge deux modes : la génération et la modification.
Génération (texte vers image)
Modification (transformation contextuelle)
Gérer les transformations complexes
Certaines instructions impliquent des changements qui dépassent les limites de l’API de modification. Lorsqu’ils sont détectés, le système propose une solution de repli :
Optimiser l’expérience
Retours progressifs
Les retours de l’interface aident les utilisateurs à suivre l’état du système :
Synchronisation intelligente
Une conversation naturelle nécessite une synchronisation naturelle :
État de session
Pour préserver le contexte, les données de session sont enregistrées :
Considérations relatives aux performances
Pour garantir la réactivité :
- Chargement différé : initialiser les API uniquement lorsque nécessaire
- Limitation des requêtes : limiter les requêtes API par interaction
- Gestion des erreurs : se remettre proprement des délais d’attente ou des échecs
- Nettoyage des ressources : supprimer correctement les objets audio et les écouteurs d’événements
La suite
Les interfaces conversationnelles ouvrent la voie à de nouvelles possibilités :
- Entrée multimodale : « Donnez-lui davantage l’apparence de cette photo. »
- Sessions collaboratives : plusieurs utilisateurs contribuent à une même création
- Mémoire de style : le système apprend votre esthétique au fil du temps
- Streaming en temps réel : diffuser les mises à jour d’images à mesure que l’utilisateur parle et intégrer l’IA conversationnelle pour diffuser également la parole.
Points clés à retenir
La création de Vibe Draw a mis en lumière plusieurs principes fondamentaux pour les outils centrés sur la voix :
- Le contexte est essentiel : le suivi de l’état rend les interactions cohérentes
- Le rythme apporte de la personnalité : cadencer les réponses rend l’IA réactive
- Les solutions de repli préservent l’élan : lorsque la génération échoue, proposez des alternatives
- La variété maintient la fraîcheur : répéter la même phrase brise l’immersion
Conclusion
Vibe Draw illustre ce qui se produit lorsque l’IA vocale conversationnelle rencontre la créativité visuelle. La synthèse vocale naturelle d’ElevenLabs et les API d’images de FLUX Kontext s’associent pour offrir une nouvelle façon de créer : sans clics ni curseurs, uniquement par la parole.
Lorsque créer devient aussi simple que décrire, nous levons les barrières entre l’imagination et l’exécution.
Essayez par vous-même
Le code source complet est disponible sur GitHub. Pour exécuter votre propre version :
- Clonez le dépôt
- Ajoutez votre clé API ElevenLabs
- Ajoutez votre clé API FAL.ai
- Ouvrez vibe-draw-v2.html dans un navigateur moderne
- Cliquez sur le microphone et commencez à créer
Vous souhaitez concevoir votre propre expérience centrée sur la voix ? Découvrez l’IA conversationnelle d’ElevenLabs ou nous contacter.
Ryan a rejoint ElevenLabs après plus de deux décennies dans les médias et l'édition, y compris des rôles à la BBC et Future Plc. Il se concentre sur la stratégie de contenu et la narration, aidant ElevenLabs à façonner et partager son histoire.