
Design de IA conversacional: como criar experiências mais humanas para o usuário
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
Antes, o design de IA conversacional consistia em criar uma árvore de decisões. Os primeiros chatbots e menus de URA funcionavam com ramificações rígidas e pré-definidas: pressione 1 para faturamento, diga "sim" ou "não" e torça para que a pergunta do cliente correspondesse a um dos caminhos previstos. Esse modelo só funcionava enquanto a conversa permanecia dentro do que você já tinha criado.
Os agentes de IA eliminaram essa limitação. Agora, eles podem raciocinar sobre uma conversa em tempo real, consultar uma base de conhecimento, chamar ferramentas e lembrar o que já foi dito, sem ficarem limitados a um script fixo.
No entanto, essa mudança não eliminou a necessidade de design de IA conversacional. Pelo contrário, elevou o nível de exigência. Sem um script rígido para recorrer, a persona, o workflow e os pontos de decisão de um agente precisam ser definidos com qualidade suficiente para funcionar em uma conversa aberta e em tempo real, em vez de uma conversa predeterminada.
Este guia explica o que o design de IA conversacional realmente significa para chat e agentes de voz, por que ele importa para as métricas pelas quais sua equipe já é avaliada e o que você precisa otimizar para tornar a experiência mais natural. Faça isso bem, e você poderá implementar agentes de IA que se conectam aos clientes e oferecem um atendimento melhor e mais rápido.
Resumo
- O design de IA conversacional se refere à forma como a comunicação de um agente de IA é estruturada e otimizada para que a conversa pareça natural.
- A IA de voz é menos tolerante que o texto, pois problemas de voz, latência e timing que passam despercebidos em uma interface de chat podem fazer uma conversa por voz parecer robótica.
- O ElevenAgents foi projetado para possibilitar agentes de IA de voz e chat mais humanos, com recursos que permitem controlar a voz, a persona e o fluxo da conversa, além de otimizar a latência em todos os canais.
O que é design de IA conversacional?
O design de IA conversacional é a prática de UX de configurar como um agente de IA se comporta. Isso inclui desde sua persona até os guardrails, workflows e bases de conhecimento que ele utiliza, trabalhando em conjunto para tornar a conversa tão bem elaborada quanto qualquer outra parte da experiência com o produto.
Essa configuração não é igual em todos os lugares. Os agentes podem operar em vários canais, como chat, voz ou SMS, a partir de uma única configuração. Cada canal tem suas próprias restrições, mas é na voz que elas são mais rigorosas. Quando a voz é um dos canais do agente, ele precisa escolher e gerar uma voz, controlar o ritmo e a alternância de fala em tempo real e responder antes que uma pausa comece a parecer uma ligação interrompida. Nada disso é opcional como pode ser no chat, em que uma resposta um pouco lenta ou imperfeita raramente prejudica a interação.
Veja o que você precisa considerar ao implementar o design de IA conversacional para um agente de chat e o que a voz acrescenta a isso.
Os clientes não avaliam conscientemente cada um desses fatores. Eles apenas percebem quando algo parece estranho, e essa sensação é suficiente para prejudicar a confiança no agente como um todo, colocando em risco os objetivos para os quais você o implementou.
Por que o design de IA conversacional é importante para uma boa experiência do usuário
Todos os fatores abordados acima, da alternância de fala à latência e à persona, afetam como o cliente percebe sua marca em um momento decisivo, que pode transformá-lo em defensor ou detrator. Essa percepção aparece diretamente nas métricas pelas quais as equipes são avaliadas.
- Maior satisfação e taxas de resolução: Os clientes avaliam melhor uma interação quando o agente responde prontamente e não interrompe de forma inconveniente.
- Menor abandono: Os clientes abandonam uma conversa por mais motivos do que apenas longas esperas. Uma experiência que não atende às expectativas, seja uma pausa constrangedora em uma ligação ou uma resposta rígida e desalinhada com a marca no chat, pode provocar o mesmo impulso de encerrar a conversa.
- Resolução mais rápida: Configurações claras de fluxo de conversa e workflows bem mapeados significam menos becos sem saída, perguntas repetidas e momentos de "vou transferir você".
- Menos escalonamentos para agentes humanos: Quando um agente conduz o fluxo da conversa naturalmente e segue um workflow definido, ele resolve mais casos na primeira tentativa, em vez de confundir o cliente e levá-lo a pedir para falar com uma pessoa.
Por exemplo, considere a eDreams ODIGEO, uma das maiores plataformas de viagens online do mundo. Ela implementou agentes de IA com o ElevenAgents em cinco idiomas principais e registrou uma melhoria de dois dígitos na velocidade de resolução e uma redução de dois dígitos nas taxas de transferência de chamadas, impulsionadas em parte pela síntese de voz de baixa latência e por um reconhecimento de intenção mais preciso no início de cada chamada. Resultados como esses dependem de muitas variáveis além do design da conversa, mas mostram o que um bom design de IA conversacional pode possibilitar.
Como o design de IA conversacional funciona no ElevenAgents
No ElevenAgents, você pode otimizar fatores como persona, voz, alternância de fala, transferências e latência — os mesmos fatores que definem se um agente parece humano. Veja como configurar e otimizar cada um deles para que seu agente cumpra seu papel em uma conversa real.
Seleção de persona e voz
A persona define a primeira impressão do cliente, e uma incompatibilidade prejudica a confiança antes mesmo de a conversa começar. Uma persona rígida demais para uma marca de varejo amigável faz os clientes duvidarem do agente antes que ele diga algo útil. Comece a defini-la no prompt de sistema, onde você define o papel, a personalidade e os guardrails do agente antes de qualquer outra coisa.
Para agentes de voz, essa persona também precisa transparecer na voz. Uma voz informal demais para uma ligação financeira transmite o mesmo sinal que uma persona inadequada transmitiria em texto, então a seleção da voz passa a fazer parte do mesmo trabalho. Veja por onde começar:
- Seleção de voz: Combine a voz com sua marca, seu público e o tema. Sotaque, gênero e tom ajudam a criar confiança com cada pessoa que liga e definem o tom da conversa.
- Suporte multilíngue: Selecione uma voz para cada idioma que você oferece, em vez de usar uma única voz em todos os mercados. Uma só voz forçada em vários idiomas tende a soar estrangeira em pelo menos um deles, prejudicando a confiança que você busca construir.
O ElevenAgents oferece acesso a mais de 11.000 vozes na Voice Library, com busca por sotaque, personagem e caso de uso, para que você raramente comece do zero. Se nenhuma delas for adequada, há mais duas opções: clonar uma voz existente a partir de uma breve amostra de áudio ou criar uma do zero com um prompt de texto que descreva a idade, o sotaque, o tom e o ritmo desejados.
Configurações do fluxo da conversa
É na voz que a conversa segue o cronograma mais rigoroso. Diferentemente do chat, em que uma pausa é apenas um espaço em branco, uma quebra de ritmo em uma ligação é imediatamente interpretada como silêncio total ou conexão interrompida. Acertar esse ritmo é a maior alavanca para fazer um agente de voz parecer um participante natural da conversa, e isso começa pelo próprio modelo de alternância de fala.
O modelo de alternância de fala da ElevenLabs é um sistema baseado em pesquisa, criado para detectar quando uma pessoa realmente terminou de falar, em vez de apenas fazer uma pausa. Isso permite determinar quando um agente deve responder, em vez de estimar com base em um atraso fixo.
Além disso, veja algumas configurações que você pode ajustar para acertar o fluxo da conversa:
- Tempo limite do turno: Quanto tempo o agente espera em silêncio antes de responder, para não interromper enquanto o cliente ainda está pensando nem deixá-lo esperando depois que terminou.
- Tempo limite suave: Uma breve frase de preenchimento que o agente usa durante uma pausa de processamento, como "Um momento" ou "Deixe-me verificar", para que os clientes não pensem que a ligação caiu. Evite frases que prometam um prazo específico, como "um segundo", pois os tempos reais de resposta variam.
- Interrupções: Define se o agente para de falar quando o cliente começa a falar por cima dele. Ative essa opção para uma conversa natural. Desative-a quando a mensagem completa for importante, como em avisos legais, instruções de segurança e tudo o que precise ser ouvido por inteiro.
- Prontidão para responder: A rapidez com que o agente responde quando o cliente para de falar. "Ansioso" é adequado para atendimento ao cliente, onde respostas rápidas são mais importantes. "Paciente" funciona melhor ao coletar informações do cliente, como telefone ou endereço de e-mail, para que o agente não interrompa o cliente no meio de um dígito. "Normal" é um bom padrão para conversas gerais.
Pequenos ajustes aqui fazem muita diferença. Até uma pequena mudança no tempo limite pode separar um agente que parece atencioso de um que parece interromper as pessoas.
Workflow, design de transferências e scripts
Workflows são onde grande parte do design de IA conversacional é colocada em prática no ElevenAgents. Eles definem o que acontece e quando: os pontos de decisão, os caminhos de escalonamento, as transferências — tudo o que, de outra forma, ficaria para o agente improvisar.
Os workflows trabalham junto com outros dois sistemas para aprimorar seu agente. O prompt de sistema define o comportamento central do agente, como seu papel, tom e o que ele pode ou não dizer, em momentos importantes, como saudações ou transferências. Procedures são uma opção mais prescritiva para uma única tarefa bem definida, como verificar a identidade de um cliente ou orientar uma devolução. Em vez de se ramificarem com base no que o cliente diz, elas seguem uma sequência fixa do início ao fim, passo a passo, independentemente de como a conversa se desenvolve.
A maneira mais fácil de começar a criar seu agente é usar modelos de agentes prontos, que trazem um ponto de partida tanto para workflows quanto para prompts de sistema. Assim, você faz ajustes finos em vez de começar do zero. Veja algumas mudanças que você pode fazer para personalizá-los:
- Mapeamento de decisões: Mapeie exatamente o que o agente faz em cada ponto de decisão, para que toda a conversa seja definida da abertura à resolução. Nós de subagentes permitem ajustar o prompt de sistema, o modelo ou até a voz em pontos específicos do fluxo, para que uma etapa sensível de verificação seja executada com guardrails mais rigorosos do que uma conversa informal no início da chamada.
- Gatilhos de escalonamento: Defina gatilhos claros para transferir a conversa para uma pessoa, integrados ao workflow em vez de deixar a decisão para o agente no momento. Por exemplo, escale quando um problema não for resolvido após duas tentativas, quando o cliente pedir um supervisor ou quando a transação for sensível ou valiosa o suficiente para precisar de uma pessoa.
- Contexto da transferência: No prompt de sistema, defina o que o agente deve coletar antes de transferir, como um ID de pedido ou número da conta, e as condições que acionam uma transferência. Depois, mapeie esses dados salvos para a configuração da ferramenta de transferência, para que sejam enviados automaticamente, sem que o cliente precise repetir as informações a um representante humano.
- Frases roteirizadas: Defina a redação exata para momentos críticos no prompt de sistema. Saudações iniciais, mensagens de erro, avisos legais e transferências por escalonamento nunca devem ser deixados para o agente improvisar. Uma frase exata como "Estou com dificuldades para acessar essas informações agora" é mais confiável do que deixar o agente adivinhar como dizer isso quando algo dá errado.
O próprio workflow é criado como um gráfico visual no ElevenAgents, com cada ponto de decisão e gatilho de escalonamento mapeado como um nó que você vê e edita diretamente.
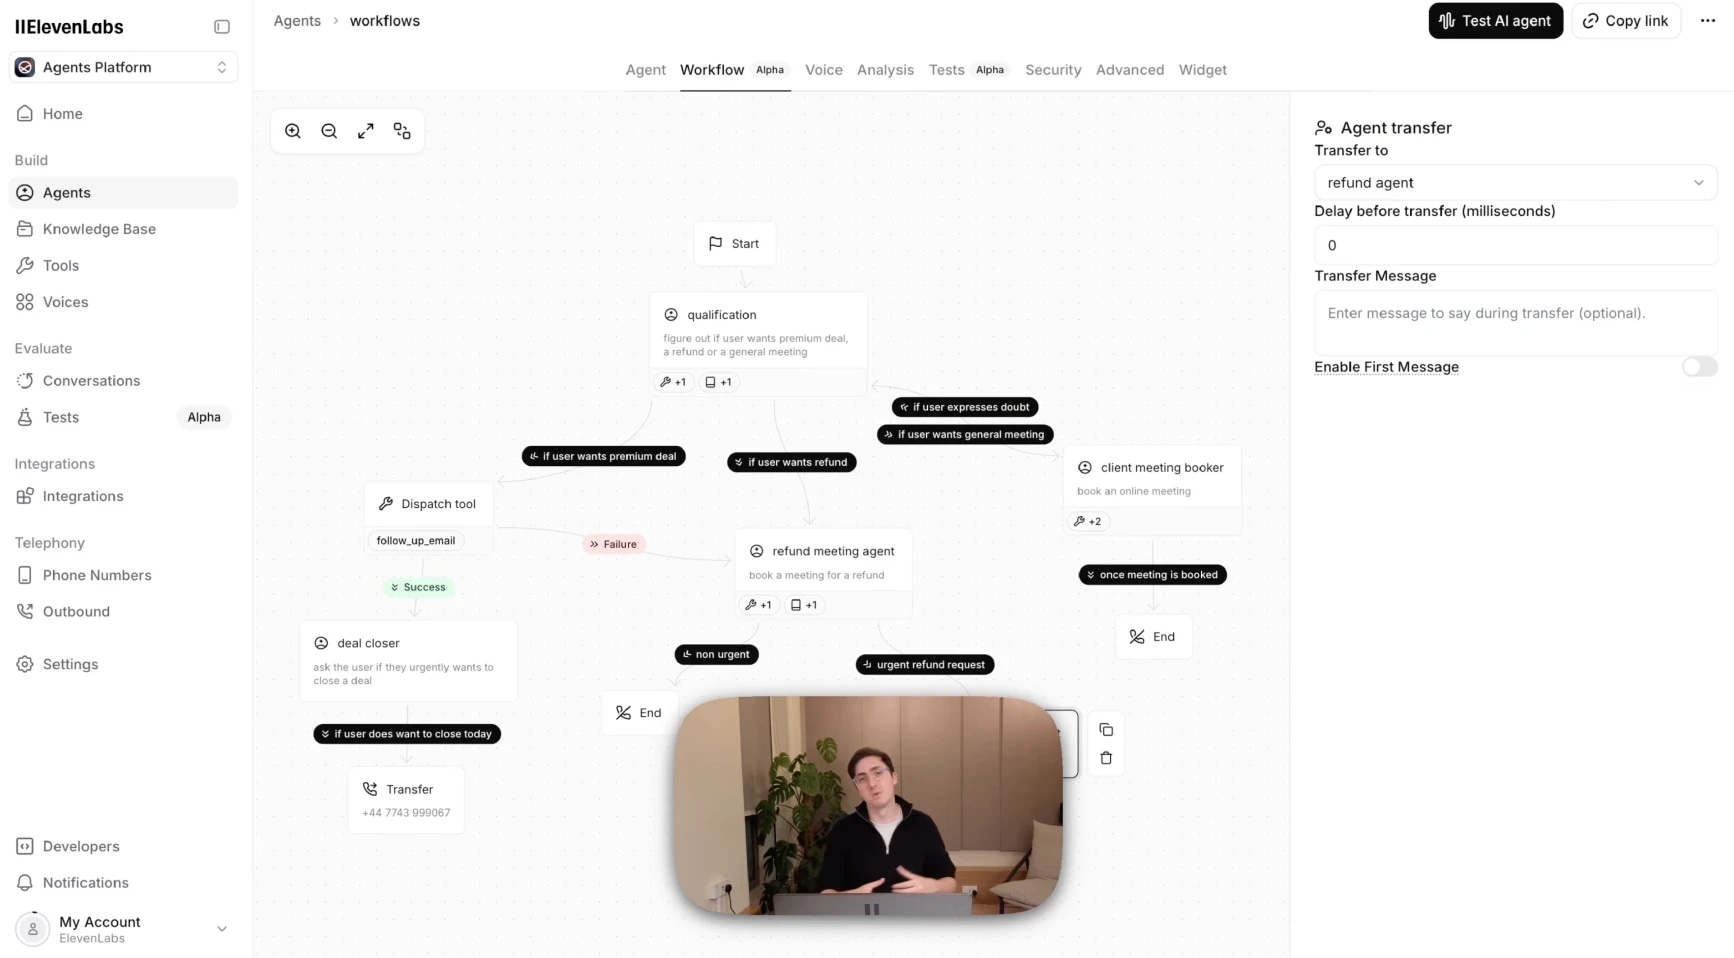
Quando entra em operação, a análise sobrepõe dados reais de conversas nesse mesmo gráfico, para que você veja exatamente onde os clientes estão travando ou abandonando a conversa e possa corrigir isso sem precisar adivinhar.
Latência e desempenho
A latência é um dos maiores fatores para determinar se uma interação parece humana ou não. Uma resposta lenta é uma das formas mais rápidas de lembrar o cliente de que ele está falando com uma máquina, mesmo que todo o restante da conversa esteja indo bem.
Cada parte do pipeline adiciona sua própria latência, seja o agente executado por chat ou por voz. Algumas delas se aplicam aos dois casos. Outras só se aplicam quando a voz faz parte da equação.
- LLM: Cada escolha de modelo envolve uma troca entre custo, qualidade de raciocínio e velocidade, e o equilíbrio ideal depende da conversa. Interações simples e frequentes, como perguntas frequentes ou confirmações de agendamento, podem usar um modelo mais rápido e leve sem prejudicar a experiência. Para tarefas mais complexas, como orientação financeira ou resolução de problemas em várias etapas, geralmente vale a pena usar um modelo com raciocínio mais robusto, mesmo que ele responda um pouco mais devagar.
- Base de conhecimento e RAG: Cada consulta à base de conhecimento adiciona uma ida e volta antes que o agente possa responder. Por isso, uma base de conhecimento enxuta e focada responde mais rápido do que uma que o agente precisa pesquisar amplamente.
- Integrações e chamadas de ferramentas: Cada chamada a uma ferramenta externa, como consultar um pedido no Salesforce ou verificar a disponibilidade em um calendário, adiciona sua própria ida e volta. Escreva descrições claras das ferramentas para que o agente não hesite sobre qual chamar e use apenas as ferramentas de que a conversa realmente precisa.
- Geografia e hospedagem de dados: Faça sua região do ElevenAgents corresponder ao local em que seus dados estão hospedados e, para implementações por telefone, também à região do seu provedor de telefonia, seja Twilio, SIP ou outro. Se a região do seu agente e a região do gateway de chamadas estiverem em lados opostos do mundo, essa distância adicionará latência antes mesmo de a conversa começar.
- Speech to Text (somente voz): O Scribe transcreve o que o cliente diz antes que o agente possa raciocinar sobre qualquer coisa. Use a versão em tempo real (Scribe v2 Realtime) para conversas ao vivo, em vez da versão em lote, desenvolvida para priorizar precisão em vez de velocidade.
- Alternância de fala (somente voz): Determina quando o agente decide responder, como explicado em detalhes acima. Vale lembrar que ela é um fator de latência por si só, pois um modelo que hesita em detectar o fim de um turno adiciona atraso antes mesmo de o restante do pipeline começar.
- Text to Speech e seleção de voz (somente voz): Vozes padrão e sintéticas, assim como Instant Voice Clones, respondem mais rápido do que Professional Voice Clones. Use Professional Voice Clones apenas quando a fidelidade adicional justificar a troca em relação à latência.
Para conhecer melhor a latência, veja as práticas recomendadas para otimização de latência e como a latência é medida e relatada em todo o pipeline.
Crie seu primeiro agente com o ElevenAgents
Os recursos abordados aqui são o que o design de IA conversacional significa na prática para um agente de IA. Tudo isso é nativo do ElevenAgents e pode ser configurado em um console sem código, para que você possa criar um agente que mantenha uma conversa real, em vez de apenas responder corretamente às perguntas.
Para equipes que querem ajuda prática para chegar lá, os Forward Deployed Engineers da ElevenLabs trabalham diretamente com sua equipe para definir o escopo, criar e lançar um agente pronto para produção e continuam ajudando a ajustar o desempenho depois que ele entra em operação.
Seja criando por conta própria ou contando com suporte, a forma mais rápida de perceber a diferença é experimentar. Comece hoje criando um agente ou falando com nossa equipe de vendas.
Perguntas frequentes sobre design de IA conversacional

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.



