Jak korzystać z API do transkrypcji spotkań: w czasie rzeczywistym i wsadowo z Scribe v2
- Autor
- Jack Limebear
- Opublikowano
PosłuchajPosłuchaj tego artykułu
Ręczne robienie notatek ze spotkań jest żmudne i podatne na błędy, zwłaszcza gdy spotkanie trwa dłużej niż godzinę. Zabiera to czas i odciąga uczestników od dyskusji. Nawet z nagraniem audio przypisanie konkretnych wypowiedzi do poszczególnych mówców bywa trudne.
API do transkrypcji spotkań pozwala zamienić spotkania na żywo lub nagrane w tekst ze znacznikami czasu i oznaczeniami mówców w twoim produkcie. Wysyłasz audio i otrzymujesz uporządkowaną transkrypcję — bez budowania własnego modelu mowy.
Ten artykuł wyjaśnia, jak działa API do transkrypcji spotkań, porównuje transkrypcję w czasie rzeczywistym i wsadową oraz pokazuje, jak tworzyć z Eleven Scribe v2 i Eleven Scribe v2 Realtime.
Podsumowanie
- API do transkrypcji spotkań zamienia audio ze spotkania na transkrypcje ze znacznikami czasu i oznaczeniami mówców.
- Transkrypcja w czasie rzeczywistym oferuje napisy na żywo podczas spotkania z niskim opóźnieniem, a transkrypcja wsadowa przetwarza nagrania audio po jego zakończeniu.
- Dokładność transkrypcji spotkań zależy od jakości audio, wzorców głosu mówców i użytego modelu głosowego.
- ElevenLabs oferuje modele Scribe v2 i Scribe v2 Realtime, które pozwalają zespołom inżynierskim tworzyć bardzo dokładne produkty do transkrypcji spotkań.
Co robi API do transkrypcji spotkań i kto go potrzebuje
API do transkrypcji spotkań przyjmuje audio ze spotkania i zwraca tekst. Obsługuje rozpoznawanie mowy, diarizację mówców i znaczniki czasu, dając ci kompletny zestaw narzędzi. W porównaniu z ręcznym robieniem notatek zamiana mowy na tekst podczas spotkań daje uczestnikom przeszukiwalny zapis, do którego mogą wracać.
Wraz z tym, jak coraz więcej zespołów wdraża agentów AI, pisemne zapisy spotkań stają się przeszukiwalnym kontekstem. Wewnętrzny agent przeszukuje transkrypcje, wyciąga szczegóły i udostępnia informacje, ograniczając silosy danych oraz ułatwiając dostęp do nich między zespołami.
Wiele komercyjnych narzędzi oferuje transkrypcję, ale nie zawsze w pełni spełniają wymagania organizacji.
Dla zespołów inżynierii produktu stworzenie aplikacji STT do spotkań lub dodanie tej funkcji do istniejącego narzędzia bywa lepszym rozwiązaniem. Własne oprogramowanie do transkrypcji spotkań daje ci kontrolę nad:
- Prywatnością: ElevenLabs oferuje tryb Zero Retention Mode dla użytkowników Enterprise, co pomaga spełniać wymogi prywatności w wybranych regionach.
- Własnym słownikiem: Możesz przekazać modelowi dodatkowy kontekst, aby rozumiał i transkrybował terminy charakterystyczne dla twojej firmy, produktu i branży.
- Dopasowanym workflow: Zamiast ograniczać się do workflow dostawcy, tworzysz narzędzie do transkrypcji spotkań połączone z wewnętrzną bazą danych, CRM i oprogramowaniem firmowym.
ElevenLabs oferuje wiodące modele głosowe i audio, które pomagają tworzyć aplikacje do transkrypcji spotkań. Dzięki naszemu API możesz dokładnie zamieniać wypowiedzi ze spotkania w notatki tekstowe. Nasze modele obsługują ponad 90 języków, w tym angielski, francuski, mandaryński i dziesiątki innych.

Zamiana mowy na tekst dla spotkań w czasie rzeczywistym czy wsadowo: jak wybrać
Transkrypcja w czasie rzeczywistym przechwytuje strumienie audio podczas mówienia i zamienia je w napisy na żywo. Używasz jej, aby zapewnić pomoc tekstową podczas spotkania lub uruchamiać działania w trakcie sesji za pomocą bota na żywo. Transkrypcja wsadowa przetwarza całe nagranie po spotkaniu, tworząc bardziej zwięzłą i uporządkowaną transkrypcję. Pomaga tworzyć notatki po spotkaniu, prowadzić dokumentację i zachowywać zapisy do audytu.
Wybierając między transkrypcją mowy na tekst w czasie rzeczywistym a wsadową, warto rozumieć skutki techniczne i kosztowe.
Oto szybkie porównanie obu metod.
Cechy | Transkrypcja w czasie rzeczywistym | Transkrypcja wsadowa |
Działanie techniczne | Przechwytuje strumienie audio na żywo podczas mówienia. Wymaga aktywnego połączenia z modelem głosowym. | Przetwarza całe nagranie audio po spotkaniu. Może działać asynchronicznie. |
Dokładność | Standardowa. Przetwarza audio na bieżąco bez pełnego kontekstu. | Wyższa. Ma wystarczająco dużo czasu na analizę pełnego kontekstu rozmowy. |
Zastosowania | Napisy na żywo podczas spotkania, bot do spotkań. | Notatki po spotkaniu, prowadzenie dokumentacji. |
Koszt | Wyższy, ponieważ wymaga stałego połączenia. | Niższy dzięki wydajności przetwarzania zbiorczego. |
Ostatecznie wybór zależy od priorytetów. Jeśli tworzysz asystenta spotkań na żywo, musisz transkrybować w czasie rzeczywistym. W przeciwnym razie wybierz transkrypcję wsadową, która jest tańsza i dokładniejsza.
Jak skonfigurować API do transkrypcji spotkań z Scribe v2
ElevenLabs Speech to Text pozwala transkrybować spotkania za pomocą Scribe v2 Realtime i Scribe v2. Oba modele głosowe są wytrenowane, aby dokładnie oznaczać mówców niezależnie od akcentu, dialektu i jakości audio. Scribe v2 Realtime pozwala od razu transkrybować mowę na żywo, a Scribe v2 zamienia nagrania audio w bardzo dokładne transkrypcje.
Dostęp do obu modeli uzyskasz przez nasze API. Poniżej omawiamy każdy model, jego kluczowe funkcje, architekturę API i sposoby integracji z twoim rozwiązaniem do transkrypcji.
Opcja 1: transkrypcja w czasie rzeczywistym (na żywo)
Transkrypcja w czasie rzeczywistym pozwala przetwarzać rozmowy podczas spotkania i zamieniać je w tekst, gdy mówcy mówią. Między mową słyszalną a transkrybowaną nie ma zauważalnych przerw lub są one minimalne.
Do transkrypcji w czasie rzeczywistym używasz modelu Scribe v2 Realtime, który zapewnia niskie opóźnienie 150 ms między wejściem audio a wyjściem tekstowym (niemal natychmiastowe częściowe transkrypcje). Po integracji modelu z aplikacją do transkrypcji uzyskasz napisy bez przerw.
Scribe v2 Realtime został zaprojektowany do obsługi rozmów na żywo i sprawdza się tam, gdzie potrzebne są napisy na żywo, notatki ze spotkania w czasie rzeczywistym lub przekazywanie tekstu na żywo do asystenta AI, aby uruchamiać dodatkowe działania. Model obsługuje też do 50 kluczowych terminów w promptach.
Jak transkrybować z Scribe v2 Realtime
Aby transkrybować na żywo, połącz swój produkt z Scribe v2 Realtime przez ElevenAPI.
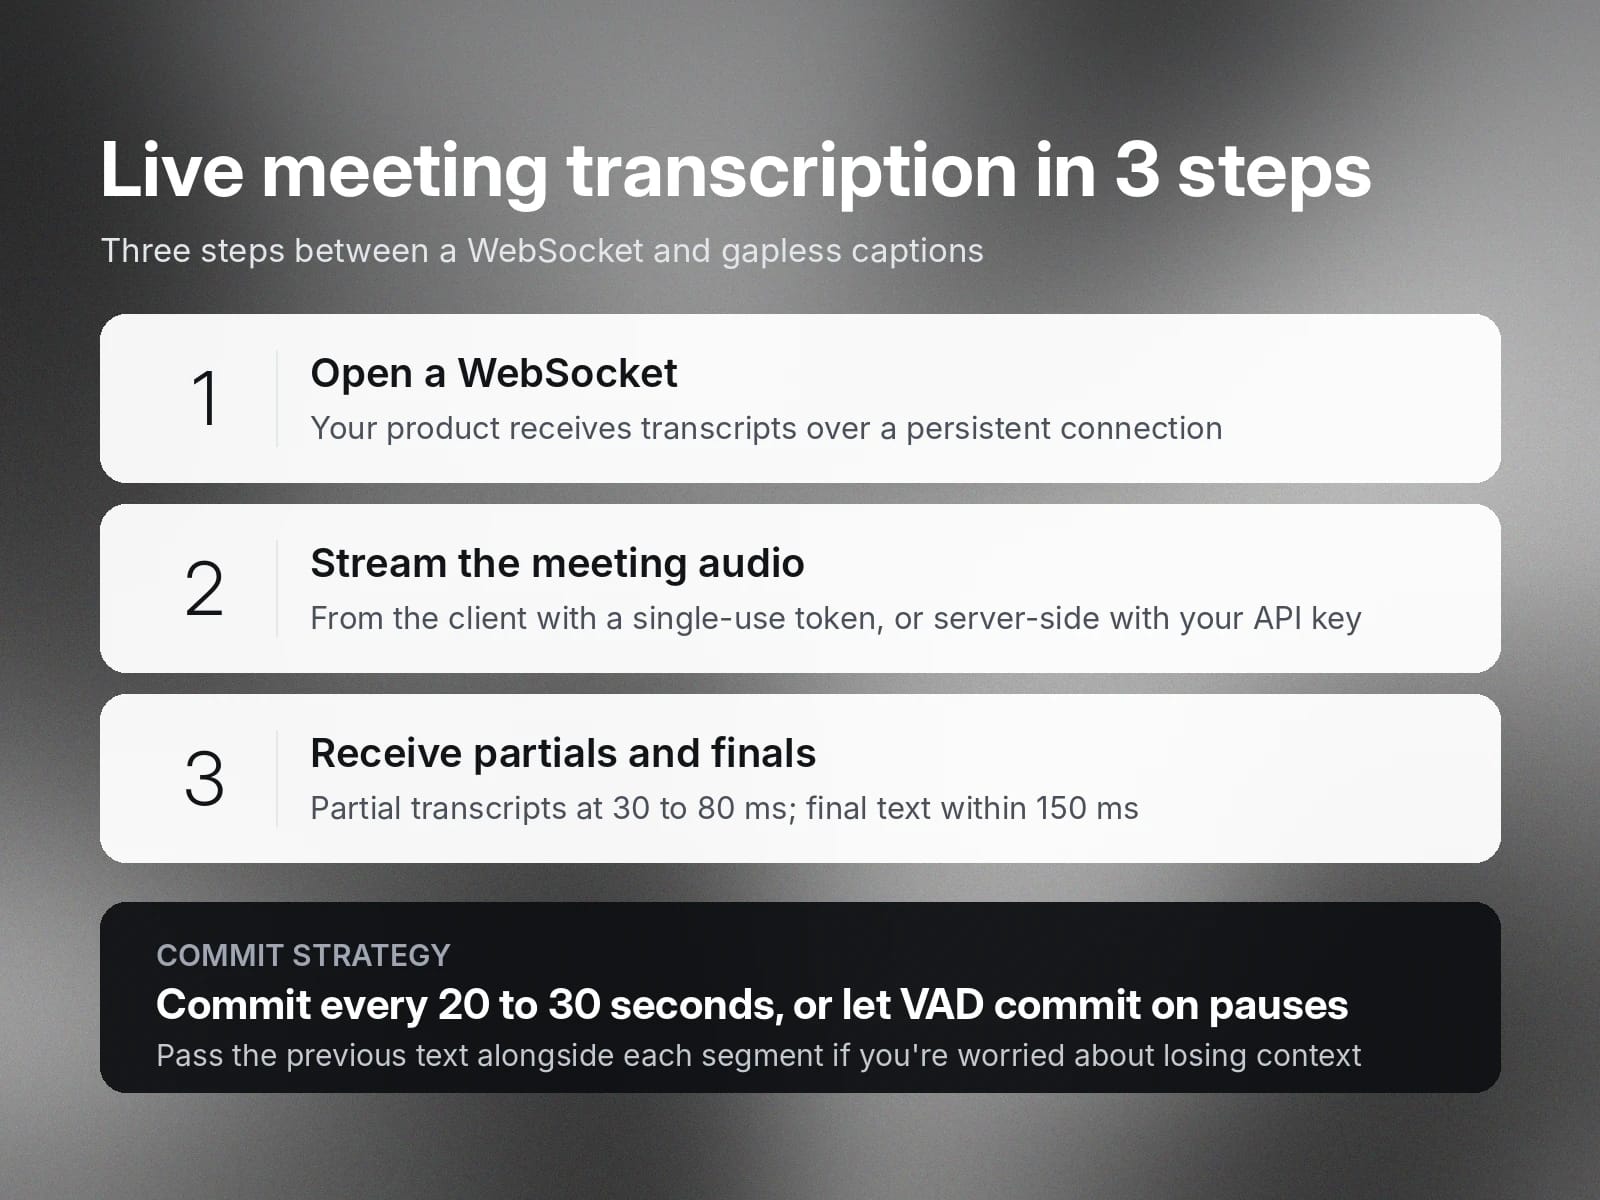
- Najpierw otwórz WebSocket, aby twój produkt mógł odbierać transkrypcje z modelu Scribe v2 Realtime.
- Następnie wyślij do modelu strumienie rozmów ze spotkania na żywo.
- Na koniec odbieraj częściowe i końcowe transkrypcje w ciągu 150 ms.
W kodzie tworzysz procedury obsługi zdarzeń API występujących podczas całego procesu transkrypcji. Na przykład kod obsługuje zdarzenia wysyłania danych audio i odbierania zatwierdzonej transkrypcji.
Metody streamingu na żywo dla Scribe v2 Realtime
Poniższy przykład tworzy na backendzie token jednorazowy. Twój klient może streamować audio ze spotkania do API transkrypcji spotkań bez ujawniania klucza API.
Zależnie od architektury aplikacji możesz streamować rozmowy na żywo z Scribe v2 Realtime z aplikacji klienckiej lub serwera backendowego.
- Streaming po stronie klienta: W tej metodzie przekazujesz dane audio do modelu bezpośrednio z mikrofonu lub przez ręczne dzielenie na fragmenty. Aby połączyć się z API, uwierzytelniasz się tokenem jednorazowym, co chroni klucz API przed ujawnieniem.
- Streaming po stronie serwera: Ta metoda pozwala streamować audio bezpośrednio z URL, przesyłanych plików lub strumienia audio. Zamiast tokenu jednorazowego używasz klucza API ElevenLabs.
Wybór strategii zatwierdzania dla Scribe v2 Realtime
Poniższy przykład konfiguruje wykrywanie aktywności głosowej. API zatwierdzi segment transkrypcji za każdym razem, gdy mówca zrobi przerwę.
Końcowa transkrypcja tworzy zapis dowodowy, który dokładnie oddaje to, co zostało powiedziane na spotkaniu. Końcowe transkrypcje można zatwierdzać na dwa sposoby: ręcznie lub przez Voice Activity Detection (VAD).
- Ręczne zatwierdzanie: Domyślnie musisz ręcznie zatwierdzić segment transkrypcji w kodzie. Dla optymalnego opóźnienia zalecamy zatwierdzanie co 20–30 sekund. Jeśli obawiasz się utraty kontekstu, możesz wysłać poprzedni tekst razem z segmentem audio do przetworzenia.
- Voice Activity Detection: Możesz też użyć VAD, które wykrywa ciszę w strumieniu audio, aby rozpocząć transkrypcję.
Opcja 2: transkrypcja wsadowa (po spotkaniu)
Transkrypcja wsadowa to skuteczny sposób na zamianę godzin nagrań spotkań w tekst. Zapewnia zwięzłe, trafne kontekstowo transkrypcje z diarizacją na dużą skalę.
Scribe v2 to model zamiany mowy na tekst ElevenLabs, który obsługuje dynamiczne oznaczanie audio. Pozwala dokładnie wyodrębniać dane z rozmów, a także zdarzenia pozamowne, takie jak śmiech i kroki.
W przeciwieństwie do transkrypcji w czasie rzeczywistym Scribe v2 stworzono do tworzenia notatek ze spotkań po nagraniu. Możesz na przykład nagrywać spotkania na platformach takich jak Zoom, Teams i Google Meet, a po sesji przesyłać pliki audio do Scribe v2 w celu transkrypcji wsadowej.

Jak transkrybować wsadowo z Scribe v2
Transkrypcja z Scribe v2 przebiega asynchronicznie przez REST API. Nie musisz utrzymywać aktywnego połączenia z modelem głosowym. Zamiast tego używasz webhooka, który powiadomi cię, gdy transkrypcja będzie gotowa.
Poniżej znajduje się workflow, który zamienia nagrania audio w transkrypcję.
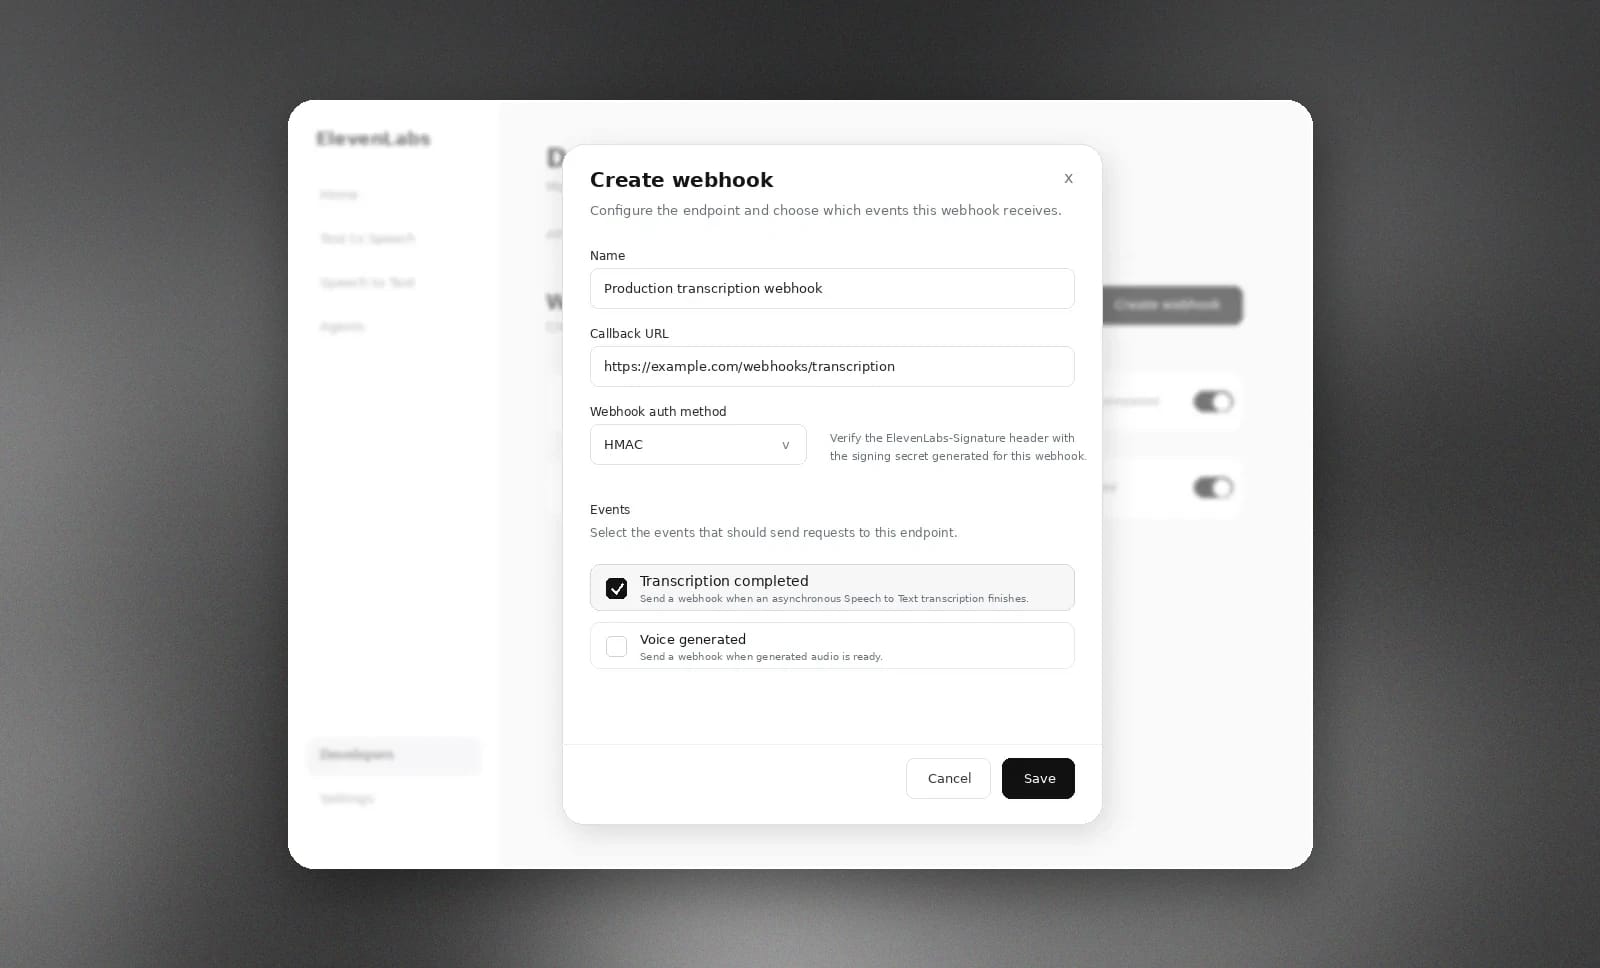
- Najpierw utwórz WebHook w panelu ElevenLabs, aby odbierać wyniki transkrypcji.
- Następnie utwórz w kodzie procedury obsługi zdarzeń, które przetworzą zwróconą transkrypcję.
- Potem prześlij pliki audio do endpointu REST Scribe v2.
Po zakończeniu transkrypcji zostanie wywołana skonfigurowana procedura obsługi zdarzenia.
Promptowanie słowami kluczowymi dla Scribe v2
Scribe v2 (wsadowy) obsługuje do 1000 terminów dla promptowania słowami kluczowymi. Wysyłając plik audio do transkrypcji, możesz uwzględnić te terminy w wywołaniu API. W przeciwieństwie do listy słownictwa Scribe v2 porównuje słowa kluczowe z kontekstem rozmowy, aby ustalić właściwą transkrypcję.
Dzięki temu model zwraca większą uwagę na określone terminy, gdy ktoś je wypowiada, i dokładnie je transkrybuje.
Poniższy przykład przekazuje w żądaniu terminy dotyczące firmy i produktu, więc API poprawnie transkrybuje je w kontekście.
Na przykład transkrybuje „ElevenLabs”, gdy wymawiasz to słowo w kontekście marki lub firmy.
Transkrypcja wielokanałowa dla Scribe v2
Transkrypcja wielokanałowa pozwala modelowi Scribe v2 transkrybować poszczególne kanały w pliku audio zawierającym wypowiedzi różnych mówców. Ta funkcja przydaje się przy tworzeniu narzędzia do transkrypcji konferencji, nagrań sądowych lub podcastów.
Każdy kanał zostanie oznaczony unikalnym identyfikatorem reprezentującym mówcę.
Typowe wyzwania w transkrypcji spotkań i jak radzi sobie z nimi API
Podczas transkrypcji spotkań zespoły inżynierskie często mierzą się z kilkoma wyzwaniami.

Nakładające się wypowiedzi
Gdy kilku mówców mówi jednocześnie, trudno zrozumieć, co jest mówione. Aby rozróżniać mówców, użyj diarizacji lub transkrypcji wielokanałowej, które oferuje Scribe v2. Otrzymasz wtedy osobne transkrypcje oznaczone odpowiednimi mówcami.
Błędna interpretacja
Kolejnym problemem narzędzi do transkrypcji jest dokładne wykrywanie i interpretowanie konkretnych produktów, marek lub terminów branżowych. Na przykład „DevOps”, termin znany deweloperom oprogramowania, może zostać błędnie zapisany jako „dev ops”. API ElevenLabs do transkrypcji spotkań pozwala nakierować model na właściwą interpretację dzięki promptowaniu kluczowymi terminami.
Wielojęzyczni mówcy
Niektóre spotkania odbywają się w różnych językach, a mówcy przełączają się między co najmniej dwoma językami, które znają. Standardowe modele głosowe mają trudności z interpretacją kontekstu i treści wypowiedzi, co obniża jakość transkrypcji. Scribe v2 umożliwia transkrypcję wielojęzyczną w ponad 90 językach, dokładnie rejestrując rozmowy w miarę ich trwania.
Napisy na żywo i transkrypcja po nagraniu
Niektóre zespoły muszą wyświetlać napisy na żywo i generować transkrypcję po spotkaniu. Niestety nie każde gotowe narzędzie do transkrypcji oferuje obie funkcje. API ElevenLabs pozwala korzystać z obu dzięki Scribe v2 i Scribe v2 Realtime.
Zacznij korzystać z API do transkrypcji spotkań
ElevenAPI daje dostęp do wiodących modeli Speech to Text do tworzenia narzędzi do transkrypcji spotkań. Konfiguracja środowiska jest prosta. Pobierasz klucz API i instalujesz SDK dla Pythona lub Node.js. Następnie integrujesz Scribe v2 lub Scribe v2 Realtime ze swoim produktem za pomocą udostępnionego API.
Uzyskaj dostęp do ElevenLabs i wyślij pierwsze żądanie API już teraz.
FAQ

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.