कन्वर्सेशनल AI को मापना: सफलता के लिए ज़रूरी मेट्रिक्स
- लेखक
- Jack Limebear
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
कन्वर्सेशनल AI टूल्स चौबीसों घंटे ग्राहक सहायता देने की लागत को काफी कम कर देते हैं। इसके लिए न तो रात की शिफ्ट में स्टाफ रखना पड़ता है, न ही भूमिकाओं को विदेश में आउटसोर्स करने से जुड़े डेटा प्राइवेसी जोखिम उठाने पड़ते हैं।
लेकिन लागत में बचत तभी मायने रखती है, जब एक AI एजेंट ग्राहक समस्याओं को हल कर सके। सही मुख्य प्रदर्शन संकेतकों के साथ कन्वर्सेशनल AI को मापने से पता चलता है कि यह काम कर रहा है या नहीं, खासकर बहुत अधिक ग्राहक प्रश्न संभालने वाले उद्यमों के लिए।
यह लेख बताता है कि कन्वर्सेशनल फ्लो और जवाबों की सटीकता का मूल्यांकन ग्राहक अनुभव और आपके ब्रांड, दोनों की सुरक्षा कैसे करता है। हम यह भी समझाते हैं कि ग्राहक अनुभव टीमें कॉलर के अभिवादन पर प्रभावी A/B परीक्षण कैसे चलाती हैं। आप एक भरोसेमंद, बहुभाषी कन्वर्सेशनल AI प्लेटफ़ॉर्म बनाए रखना भी सीखेंगे।
सारांश
- गुणवत्ता, अनुभव और संचालन संबंधी मेट्रिक्स के आधार पर कन्वर्सेशनल AI को व्यवस्थित रूप से मापने से ग्राहक अनुभव की सुरक्षा के लिए ज़रूरी डेटा मिलता है।
- ऑटोमेटेड मूल्यांकन टूल बड़े पैमाने पर कन्वर्सेशनल AI मेट्रिक्स को लगातार ट्रैक और बेहतर करते हैं, जबकि मानव कर्मचारी नियमित स्पॉट चेक करते हैं।
- A/B टेस्ट के लिए एक बार में सिर्फ़ एक खास वेरिएबल को अलग रखने से यह ठीक-ठीक पता लगाना आसान होता है कि क्या गलत हुआ, ताकि आप पहचानी गई समस्याओं पर सीधे असर करने वाले सुधार लागू कर सकें।
- निरंतर सुधार ज़रूरी है, क्योंकि AI कंपनियां अक्सर अंतर्निहित मॉडल अपडेट करती हैं, जिससे पहले भरोसेमंद रहे चैटबॉट्स प्रोडक्शन में अलग तरह से काम करने लगते हैं।
कन्वर्सेशनल AI को मापने का मतलब और इसका महत्व
कन्वर्सेशनल AI को मापने में यह व्यवस्थित रूप से आकलन करना शामिल है कि आपके परीक्षण किए गए या तैनात AI एजेंट ग्राहक अनुरोधों को कितनी अच्छी तरह संभालते और समस्याएं हल करते हैं। लक्ष्य यह तय करना है कि आपके तय किए गए प्रदर्शन मानकों के आधार पर आपके ऑटोमेटेड सिस्टम वास्तविक दुनिया में बहु-चरणीय बातचीत को कितने प्रभावी ढंग से संभालते हैं। ये मानक आमतौर पर दिखाते हैं कि मॉडल यूज़र के इरादे को कितनी अच्छी तरह समझते हैं, ब्रांड के अनुरूप रहते हैं, सटीक जवाब देते हैं और समस्या को सफलतापूर्वक हल करते हैं।
टीम के काम कम करने के लिए बने सिस्टम के लिए मॉडल मूल्यांकन अतिरिक्त काम लग सकता है। लेकिन लगातार मूल्यांकन के बिना यह जानना मुश्किल होगा कि मॉडल वास्तविक उपयोग मामलों में कितना अच्छा प्रदर्शन करता है। दूसरे शब्दों में, आप जानते हैं कि आपका AI सिस्टम ग्राहक सहायता संचालन लागत कम करता है, लेकिन क्या आप पुष्टि कर सकते हैं कि यह ग्राहकों को खुश कर रहा है या उन्हें दूसरे समाधान खोजने के लिए प्रेरित कर रहा है?
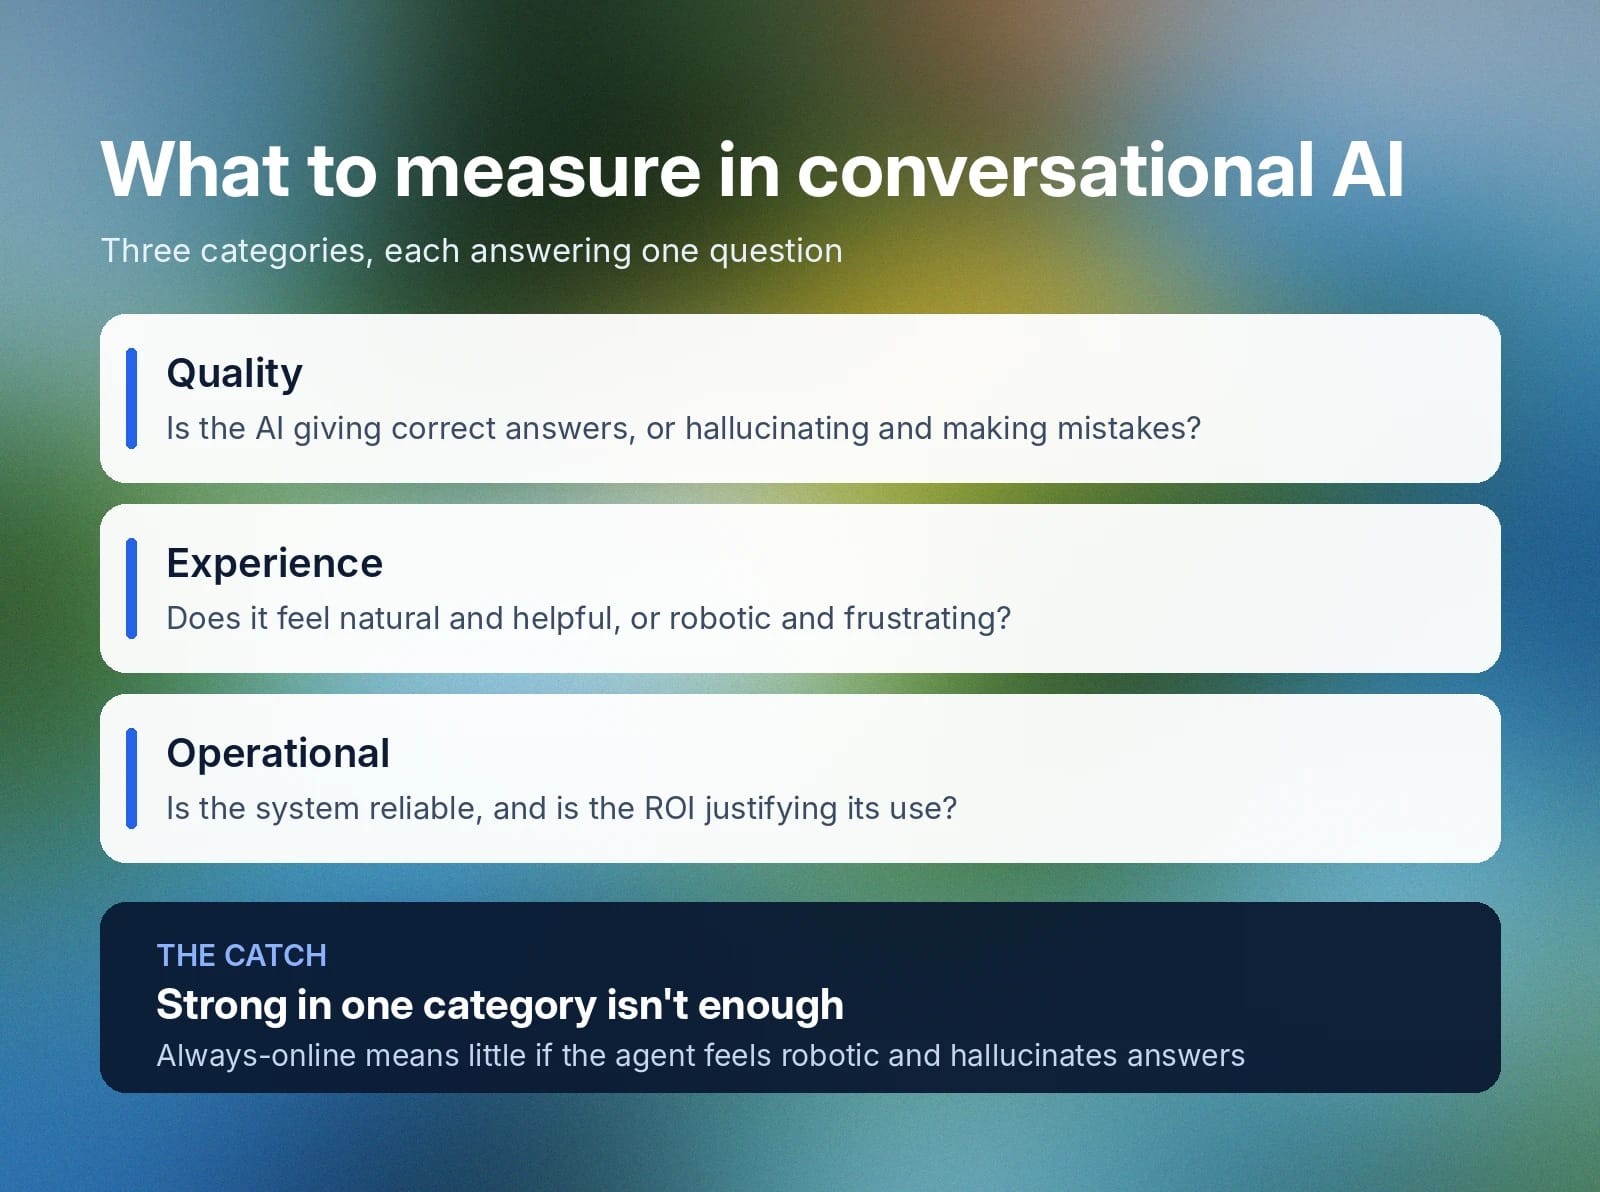
व्यापक मापन के लिए मॉडल को तीन मुख्य श्रेणियों में देखना ज़रूरी है:
- गुणवत्ता: यूज़र के शुरुआती अनुरोध के आधार पर आकलन करें कि AI के जवाब कितने सटीक, सुसंगत और प्रासंगिक हैं। यहां मुख्य सवाल है: क्या AI सही बातें समझकर यूज़र्स को सही जवाब दे रहा है, या वह हैलुसिनेशन कर रहा है और गलतियां कर रहा है?
- अनुभव: ग्राहक अनुभव का मूल्यांकन करें, जैसे AI ने कितनी जल्दी जवाब दिया और संतोषजनक उत्तर देने के लिए उसे कितने चरण लगे। यहां मुख्य सवाल है: क्या यूज़र के लिए अनुभव स्वाभाविक और मददगार लगता है, या रोबोटिक और निराशाजनक?
- संचालन: तय करें कि सिस्टम भरोसेमंद ढंग से काम करता है या नहीं और आपकी ग्राहक सहायता ज़रूरतों के लिए किफायती समाधान बना रहता है या नहीं। आम चिंताएं हैं: क्या सिस्टम का अपटाइम अधिक है और क्या यह अपने इस्तेमाल को उचित ठहराने के लिए ज़रूरी निवेश पर रिटर्न दे रहा है?
हर टीम के लिए सफलता अलग होती है और सहायता को ऑटोमेट करने से पहले आपकी शुरुआती समस्याएं इसमें बड़ी भूमिका निभाती हैं। उदाहरण के लिए, अगर आपकी टीम को शुरुआत में 24/7 ग्राहक सहायता बनाए रखने में मुश्किल होती थी, तो AI एजेंटों की चौबीसों घंटे उपलब्धता आसानी से ग्राहक सहायता प्रदर्शन को बेहतर बनाती है। हालांकि, कुल सफलता के लिए इनमें से हर श्रेणी महत्वपूर्ण है, इसलिए कोई सिस्टम जो हमेशा ऑनलाइन हो और बहुत कम क्रैश होता हो, ग्राहकों के लिए अधिक उपयोगी नहीं होगा अगर वह रोबोटिक लगे और जवाबों में हैलुसिनेशन करे।
ट्रैक करने के लिए मुख्य कन्वर्सेशनल AI मेट्रिक्स
एजेंट के ग्राहक-संबंधी प्रदर्शन और आपके मौजूदा इम्प्लीमेंटेशन से वास्तविक व्यावसायिक मूल्य बन रहा है या नहीं, यह जानने के लिए स्पष्ट और कार्रवाई योग्य आंकड़े ट्रैक करें। निरंतर आकलन नियमित सुधार का रास्ता भी खोलता है। जब आप ठीक-ठीक पहचान लेते हैं कि आपके वर्कफ़्लो में रुकावटें कहां हैं या कहां बदलाव करने की ज़रूरत है, तो मूल कारण को प्रभावी ढंग से दूर करने के लिए आपके पास डेटा होता है।
वॉइस कॉल और चैटबॉट प्रदर्शन का मूल्यांकन करते समय इन कन्वर्सेशनल AI मेट्रिक्स को शुरुआती आधार के रूप में इस्तेमाल करें:
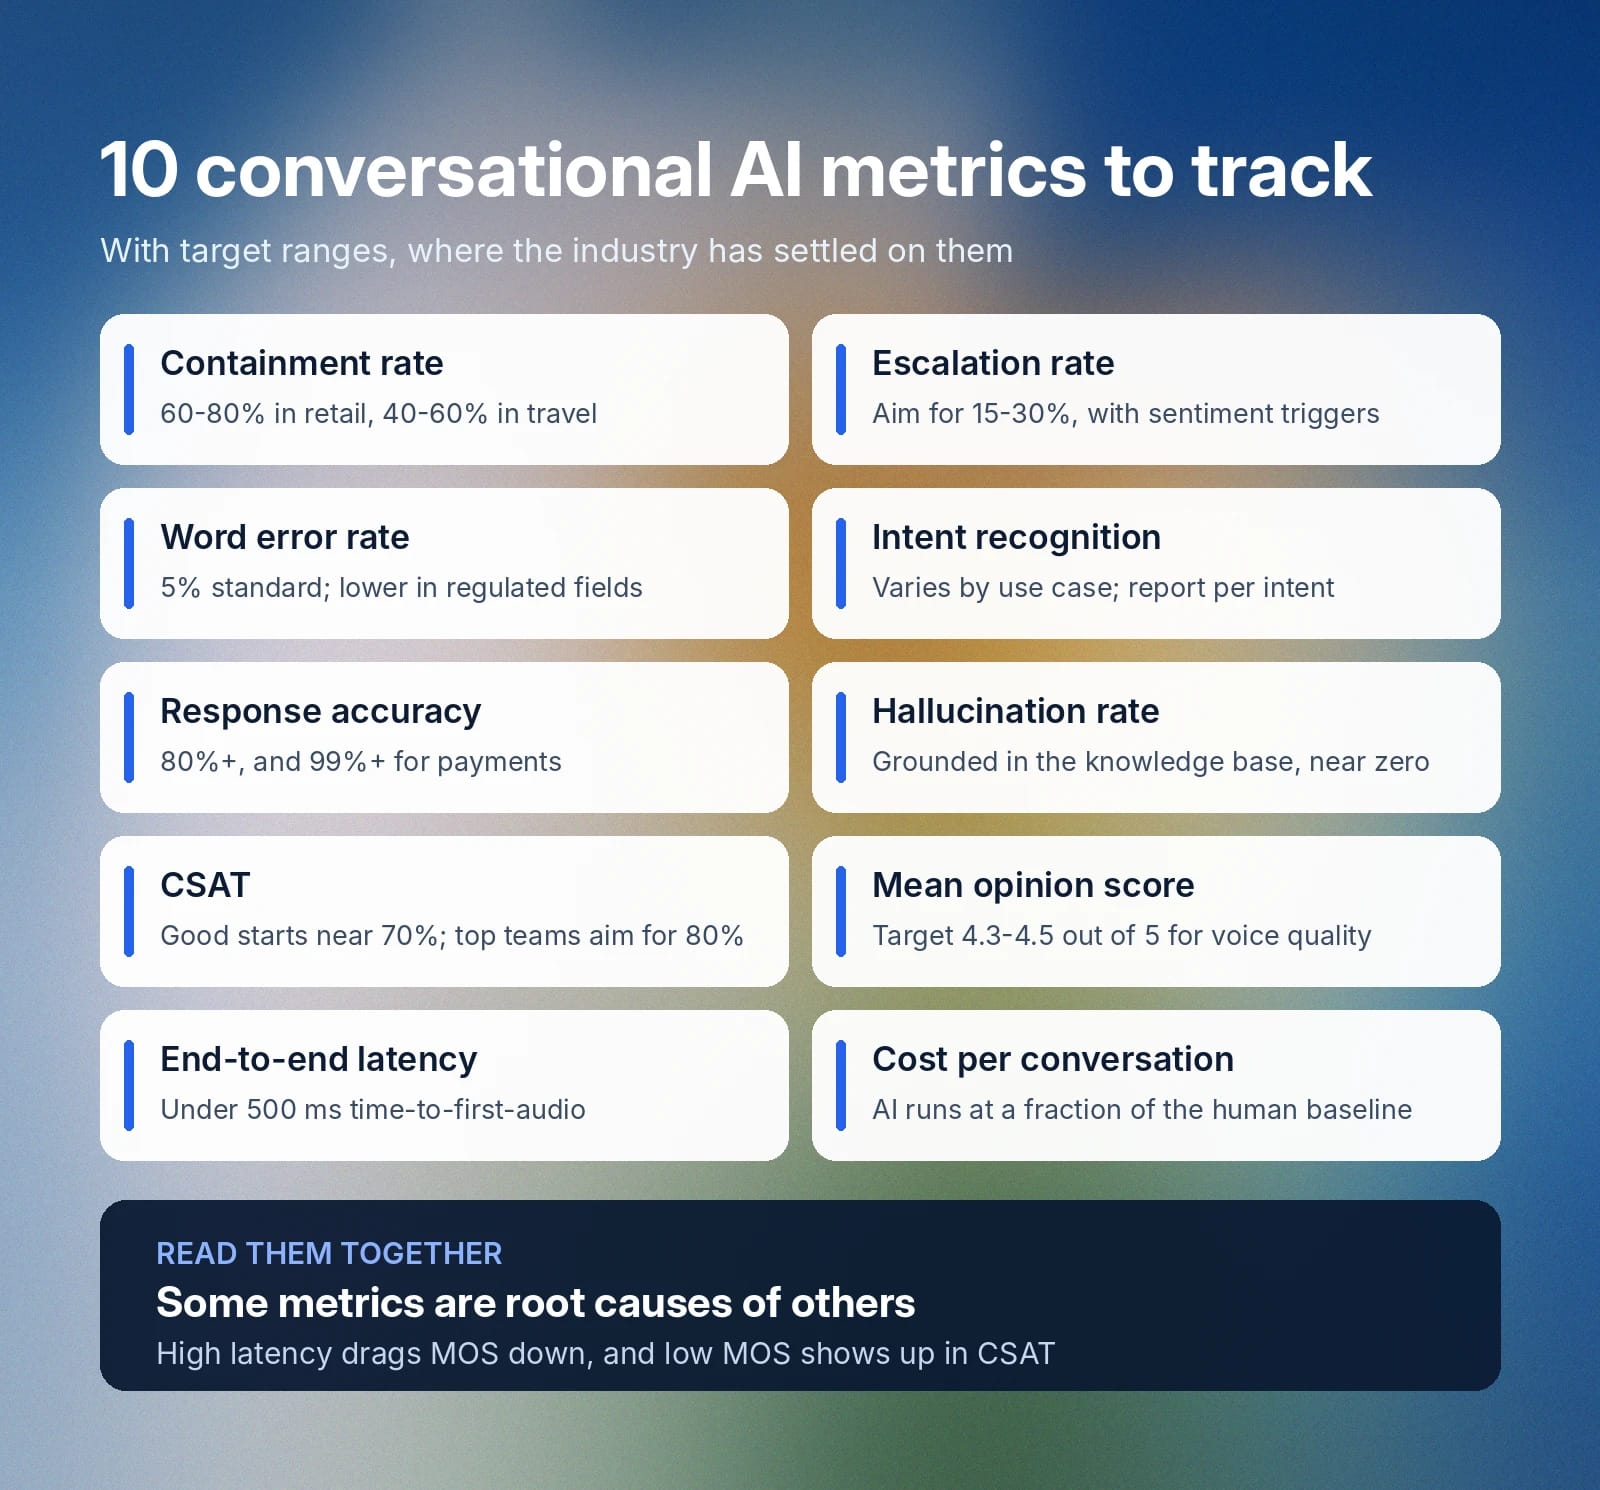
- कंटेनमेंट रेट: उन पूछताछों का प्रतिशत ट्रैक करें जो ऑटोमेटेड चैनल के भीतर पूरी तरह हल हो जाती हैं। लक्ष्य उद्योग, संदर्भ, उपयोग के मामलों और बॉट के प्रकार के अनुसार बदलते हैं। उदाहरण के लिए, 60–80% काफी मानक है रिटेल के लिए, जबकि ट्रैवल साइटों के लिए आंकड़े 40–60% के बीच होते हैं।
- एस्केलेशन रेट: मापें कि AI एजेंट कितनी बार कॉल को इंसान तक एस्केलेट किए बिना संभालते हैं। सक्रिय कंपनियां जैसे ही भावना नकारात्मक होती है, कॉल इंसानों को ट्रांसफर करने के लिए ऑटोमेटिक थ्रेशहोल्ड तय करती हैं। अच्छी एस्केलेशन रेट उद्योग और कार्य की जटिलता पर निर्भर करती है, लेकिन लक्ष्य 15–30% रखें।
- वर्ड एरर रेट (WER): ट्रैक करें कि कॉल या ट्रांसक्रिप्शन के दौरान AI शब्दों को कितनी सटीकता से “सुनता” है। उद्योग का अच्छा मानक 5% है, लेकिन आपको WER इससे कम चाहिए, खासकर रेगुलेटेड क्षेत्रों या स्वास्थ्य सेवा, वित्त और कानून जैसी संवेदनशील जानकारी संभालने वाले उपयोग मामलों में।
- इरादा पहचानने की सटीकता: केवल शब्दों से आगे, सफल AI एजेंट प्रदर्शन की शुरुआत यूज़र की समस्या और उनकी ज़रूरत को सटीकता से समझने से होती है। सटीकता के लक्ष्य उपयोग के मामले और हर इरादा श्रेणी के अनुसार बदलते हैं।
- जवाब की सटीकता: तय करें कि मॉडल कितनी भरोसेमंद तरीके से सत्य और सार्थक जवाब देता है। ग्राहकों को उनकी समस्याएं हल करने में मदद देने के लिए यह महत्वपूर्ण है। सामान्य ग्राहक सेवा प्रश्नों के लिए 80% या अधिक की ज़रूरत होती है, लेकिन भुगतान जैसे संवेदनशील उपयोग मामलों के लिए 99% या अधिक चाहिए।
- हैलुसिनेशन रेट: जवाब की सटीकता से करीबी संबंध होने पर भी, हैलुसिनेशन विशेष रूप से नॉलेज बेस के आधार पर जवाबों की तथ्यात्मक सटीकता तय करता है। कम हैलुसिनेशन रेट मददगार होने और यह सुनिश्चित करने के लिए महत्वपूर्ण है कि मॉडल ऐसे वादे न करें जिन्हें कंपनी पूरा नहीं कर सकती।
- ग्राहक संतुष्टि (CSAT): संतुष्टि जानने के लिए कॉल के बाद के सर्वे से ग्राहकों की भावना जुटाएं। कंपनियां यह डेटा पांच-पॉइंट स्केल पर इकट्ठा करती हैं, लेकिन नतीजे अक्सर प्रतिशत में बताती हैं। SurveyMonkey के अनुसार, अच्छे CSAT स्कोर आमतौर पर लगभग 70% से शुरू होते हैं, जबकि कुछ कंपनियां 80% या उससे अधिक का लक्ष्य रखती हैं।
- मीन ओपिनियन स्कोर (MOS): यह मानव-केंद्रित मेट्रिक भी पांच-पॉइंट स्केल का उपयोग करता है, लेकिन इसका लक्ष्य AI जवाब की स्वाभाविकता और सिंथेटिक वॉइस की स्पष्टता को मापना है। MOS का लक्ष्य लगभग 4.3-4.5 रखें।
- एंड-टू-एंड वॉइस लेटेंसी: यूज़र के अनुरोध पूरा करने और एजेंट के जवाब देना शुरू करने के बीच की कुल देरी गिनें। प्रोडक्शन-ग्रेड एजेंट 500 मिलीसेकंड से कम एंड-टू-एंड टाइम-टू-फर्स्ट-ऑडियो (TTFA) का लक्ष्य रखते हैं। ElevenLabs Flash v2.5 मॉडल फिलहाल आंतरिक मॉडल इन्फ़रेंस लेटेंसी लगभग 75 ms हासिल करता है। वास्तविक एंड-टू-एंड लेटेंसी आपकी लोकेशन और इस्तेमाल किए गए एंडपॉइंट प्रकार जैसे कारकों के अनुसार बदलती है।
- प्रति बातचीत लागत: हर ऑटोमेटेड ग्राहक इंटरैक्शन की कुल संचालन लागत को मानव सत्रों से तुलना करके मापें। ElevenLabs बातचीत की शुरुआत 10 सेंट प्रति मिनट से होती है, जबकि ग्राहक सेवा प्रतिनिधियों का औसत प्रति घंटा वेतन बताता है कि मानव बातचीत की लागत लगभग 32 सेंट प्रति मिनट होती है। इससे लगभग 70% की लागत बचत होती है, हालांकि कीमत प्लान और उपयोग के अनुसार बदल सकती है। मौजूदा कीमतों के लिए ElevenLabs प्राइसिंग पेज देखें।
अपने मॉडल प्रदर्शन को मापने के लिए मेट्रिक्स चुनते समय, उन क्षेत्रों पर विचार करें जो आपके उद्योग और बिज़नेस मॉडल के लिए सबसे महत्वपूर्ण हैं। उदाहरण के लिए, बैंकिंग और रोगी जानकारी जैसे क्षेत्रों में सटीकता और तथ्यात्मकता विशेष रूप से महत्वपूर्ण हैं, जबकि लेटेंसी, MOS और एस्केलेशन रेट ग्राहक अनुभव को प्राथमिकता देने वाली कंपनियों के लिए सबसे अधिक मायने रखते हैं।
ध्यान रखें कि कुछ मेट्रिक्स दूसरे मेट्रिक्स के मूल कारण बताते हैं। उदाहरण के लिए, अधिक लेटेंसी से MOS स्कोर कम होने और नतीजतन CSAT के रूप में कम ग्राहक संतुष्टि मिलने की संभावना है।
कन्वर्सेशनल AI की सटीकता कैसे मापें
लगभग 500 से 1,000 वास्तविक पुरानी बातचीत से ग्राउंड-ट्रुथ टेस्ट सेट बनाकर मॉडल की सटीकता मापें। वास्तविक लॉग में टाइपो, स्लैंग और यूज़र की गलतियों जैसी अव्यवस्थित, स्वाभाविक भाषा दर्ज होती है, जो सिंथेटिक डेटा में अक्सर नहीं होती। फिर इरादा पहचान, जवाब की सटीकता और हैलुसिनेशन रेट के आधार पर अपने सिस्टम का इन वास्तविक लॉग से मूल्यांकन करें।
इन इंटरैक्शन का ऑटोमेटेड मूल्यांकन LLM-as-a-judge स्कोरिंग विधि से चलाएं। हालांकि, यह सुनिश्चित करने के लिए कि वे एक-दूसरे के अनुरूप हैं, ऑटोमेटेड स्कोर को हमेशा मानव-लेबल वाली प्रणालियों के विरुद्ध सत्यापित करें। फिर मानव समीक्षक एक सरल तीन-पॉइंट रूब्रिक के जरिए चैटबॉट प्रदर्शन का साप्ताहिक स्पॉट चेक करते हैं:
- सही: जवाब तथ्यात्मक, संदर्भ के अनुरूप है और यूज़र के मुख्य इरादे को सीधे पूरा करता है।
- स्वीकार्य: जवाब तकनीकी रूप से सही और मददगार है, लेकिन इसमें कुछ छोटी शैलीगत समस्याएं, कुछ अटपटे वाक्यांश या ब्रांड के अनुरूप न होने वाला फ़ॉर्मैटिंग है।
- गलत: जवाब में तथ्यात्मक गलतियां, गंभीर हैलुसिनेशन या यूज़र के इरादे की पूरी तरह गलत समझ होने के कारण इसे तुरंत सुधारने की ज़रूरत है।
आदर्श रूप से, मॉडल का मूल्यांकन करने के लिए आप प्रति-इरादा विधि अपनाएं, क्योंकि AI एजेंट कुछ संदर्भों में अच्छा प्रदर्शन करते हैं और दूसरों में बुरी तरह विफल होते हैं। कुल आंकड़ों का उपयोग करने से उच्च प्रदर्शन वाले क्षेत्र महत्वपूर्ण कमजोरियों को छिपा सकते हैं।
हमने Next Reply (Scenario) टेस्टिंग को सीधे अपनी ElevenAgents टेस्टिंग में बनाकर इस वर्कफ़्लो को आसान किया है। Next Reply फ़ीचर पूरी बहु-चरणीय बातचीत के बजाय एजेंट के भेजे गए फ़ॉलो-अप संदेश का मूल्यांकन करता है। हालांकि, आप मूल्यांकन बिंदु तक की चैट हिस्ट्री देते हैं और जवाब को नीति, टोन और गुणवत्ता मानकों के आधार पर स्कोर करते हैं।
कन्वर्सेशनल AI जवाबों का A/B टेस्ट कैसे करें
A/B टेस्टिंग वास्तविक दुनिया का फ़ीडबैक जुटाती है, ताकि ग्राहकों की पसंद का अनुमान न लगाना पड़े। फिर आप इस अनुभवजन्य डेटा का उपयोग AI मॉडल के प्रदर्शन को बेहतर बनाने के लिए करते हैं। मेट्रिक्स ट्रैक करने के बाद, आपकी टीम के पास शायद बदलने वाली चीज़ों या चलाने वाले प्रयोगों की सूची होती है। लेकिन एक साथ कई चीज़ें बदलने से यह समझना मुश्किल हो जाता है कि क्या काम किया और क्या नहीं।
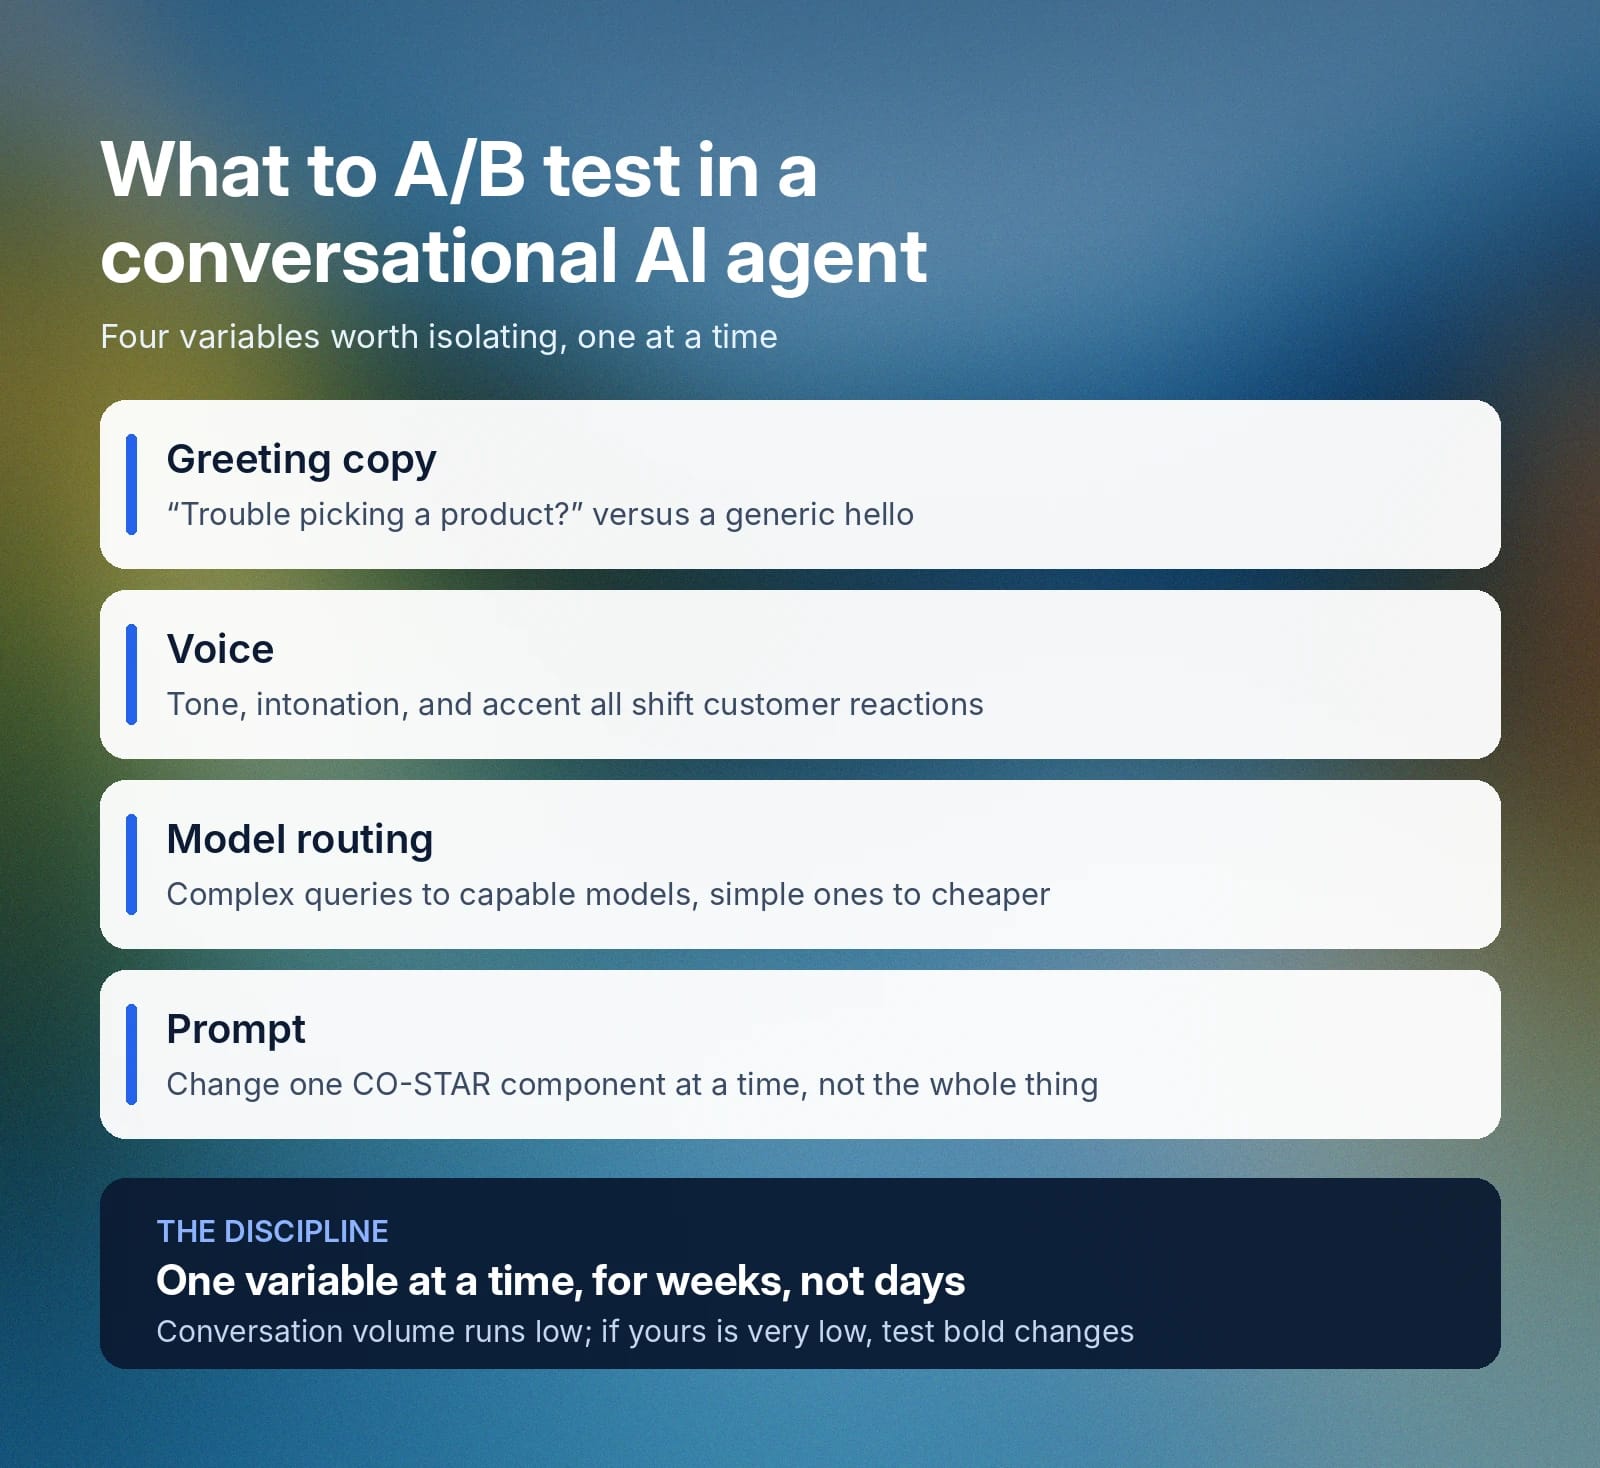
इसलिए, वैध टेस्ट चलाने के लिए बाकी अंतर्निहित नॉलेज बेस को स्थिर रखते हुए, एक समय में सिर्फ़ एक खास वेरिएबल को अलग रखना ज़रूरी है। बदलने योग्य तत्वों में शामिल हैं:
- अभिवादन कॉपी: शुरुआती अभिवादन संदेश को सिर्फ़ “नमस्ते, मैं आपकी क्या मदद कर सकता हूं?” कहने के बजाय कुछ खास बनाना, जैसे “नमस्ते। प्रोडक्ट चुनने में दिक्कत हो रही है?”
- वॉइस: पुल्लिंग या स्त्रीलिंग, टोन, उतार-चढ़ाव और यहां तक कि एक्सेंट के आधार पर, कुछ परिस्थितियों में ग्राहक कुछ वॉइस को दूसरों से अधिक पसंद कर सकते हैं।
- मॉडल रूटिंग:अधिक सक्षम मॉडल आमतौर पर महंगे होते हैं, इसलिए जटिल और सरल प्रश्नों को उसी के अनुसार रूट करना कुशल और किफायती विकल्प है।
- प्रॉम्प्ट: प्रॉम्प्ट के कई घटक होते हैं, इसलिए एक बार में सिर्फ़ एक पहलू बदलें, जैसे संदर्भ, उद्देश्य, शैली, टोन, ऑडियंस या जवाब टेम्प्लेट (CO-STAR)।
टीमों को टेस्टिंग टाइमलाइन भी समायोजित करनी चाहिए। कन्वर्सेशनल ट्रैफ़िक आम तौर पर वेब पेज व्यूज़ से बहुत कम होता है, इसलिए सांख्यिकीय महत्व पाने के लिए आपको टेस्ट दिनों के बजाय हफ्तों तक चलाना होगा। अगर आपका वॉल्यूम बहुत कम है, तो छोटे बदलावों के बजाय बड़े, स्पष्ट बदलाव टेस्ट करें।
एक व्यावहारिक वर्कफ़्लो के लिए एजेंट वर्ज़निंग, तुलना और रोलबैक टूल भी चाहिए। हमने इन्हें सीधे ElevenAgents में बनाया है।
डिप्लॉयमेंट से पहले कन्वर्सेशनल AI एजेंट का टेस्ट कैसे करें
ग्राहक सेवा उन लोगों के साथ सीधा संपर्क बिंदु है जो आपके मुनाफ़े को प्रभावित करते हैं, और AI कभी-कभी छोटे बदलावों पर अप्रत्याशित प्रतिक्रिया देता है। इसलिए, किसी नए या संशोधित कन्वर्सेशनल AI एजेंट को प्रोडक्शन में लॉन्च करने से पहले हमेशा टेस्ट करें। सिर्फ़ “वाइब टेस्टिंग” काफ़ी नहीं है।
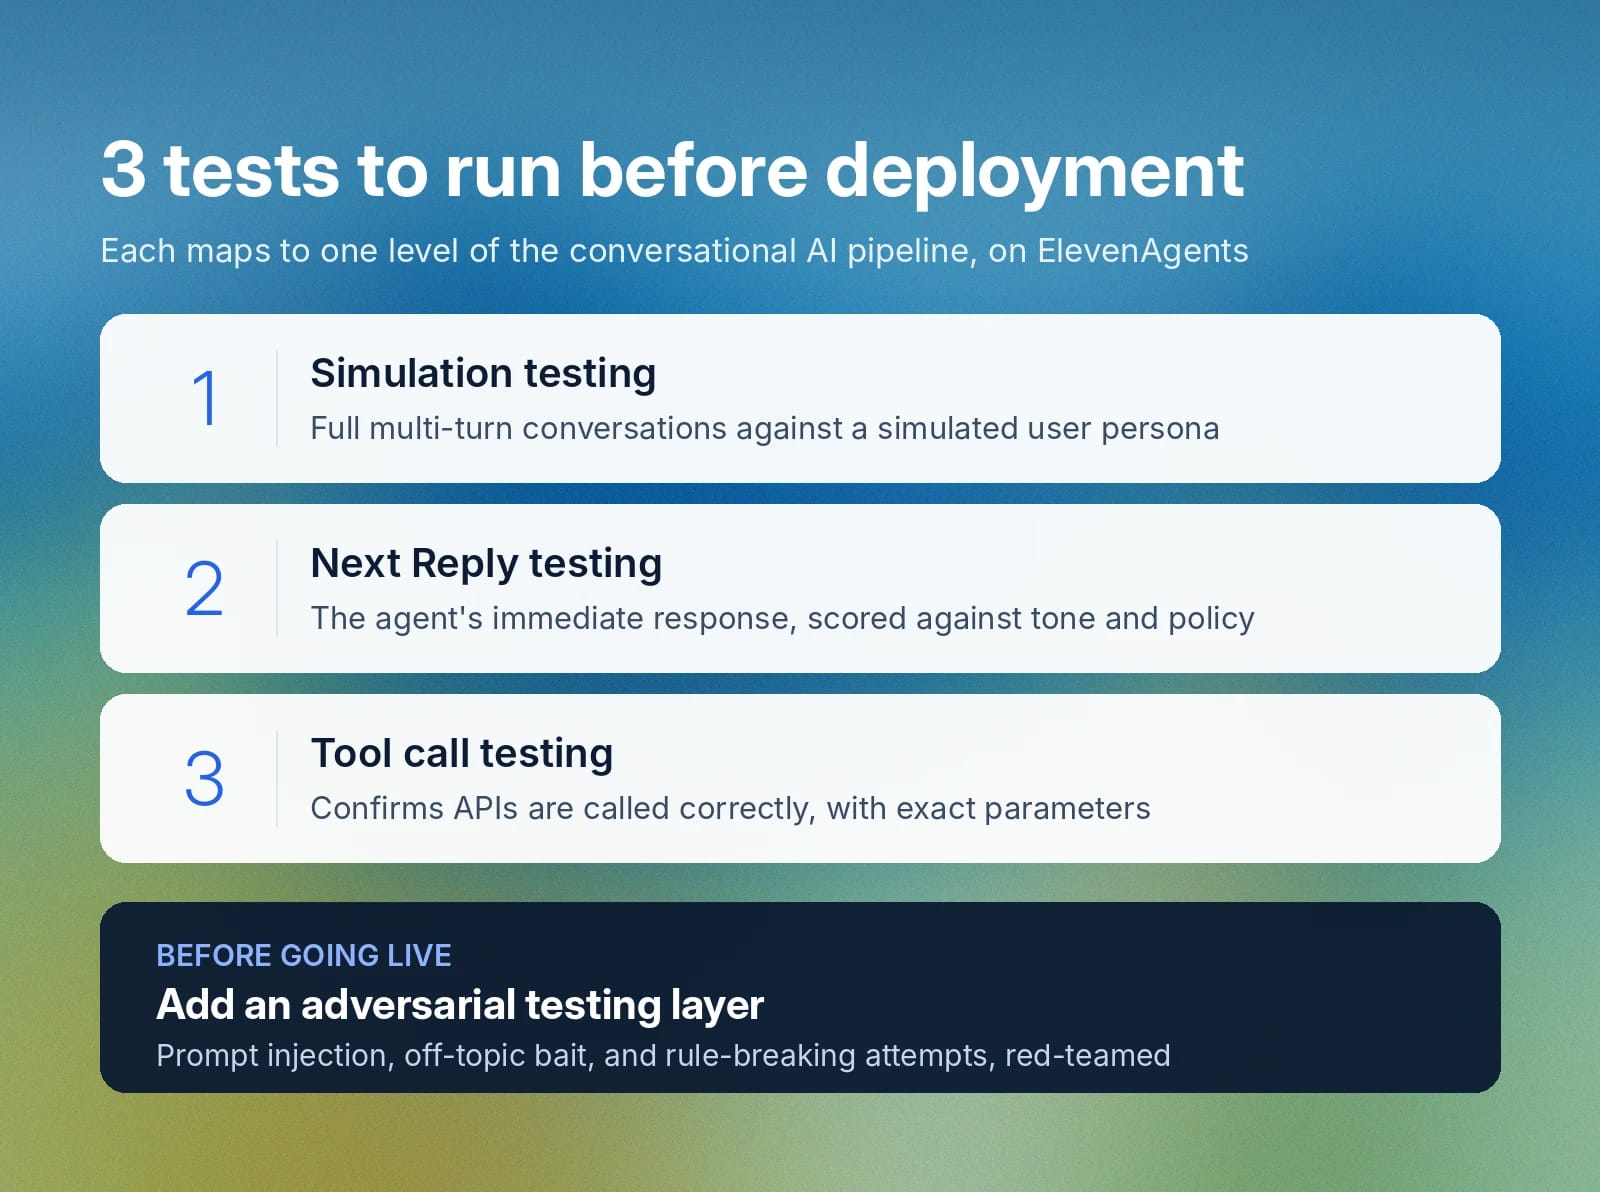
हमने अपना ElevenAgents टेस्टिंग फ़्रेमवर्क तीन मुख्य टेस्ट प्रकारों के आधार पर डिज़ाइन किया है, जो आपकी कन्वर्सेशनल AI पाइपलाइन के खास स्तरों को लक्षित करते हैं:
- सिमुलेशन टेस्टिंग: एक पूर्ण सिमुलेटेड यूज़र पर्सोना के साथ बहु-चरणीय बातचीत चलाती है, ताकि पुष्टि हो सके कि डायलॉग पसंदीदा प्रदर्शन स्तरों को पूरा करता है या नहीं।
- Next Reply टेस्टिंग: जवाबों की उपयुक्तता और सटीकता की पुष्टि के लिए एजेंट के केवल तत्काल जवाबों को खास टोन, नीति या अन्य सीमाओं के विरुद्ध टेस्ट करती है।
- टूल कॉल टेस्टिंग: यह सुनिश्चित करती है कि एजेंट कनेक्टेड API को सही ढंग से कॉल करें और उच्च-दांव वाले डेटाबेस लुकअप या ट्रांसफ़र के लिए आवश्यक सटीक पैरामीटर पास करें।
इतने सारे हमलावर दुर्भावनापूर्ण उद्देश्यों से मॉडल को जेलब्रेक करने की कोशिश कर रहे हैं, इसलिए लाइव होने से पहले आपको एडवर्सेरियल टेस्टिंग लेयर की भी ज़रूरत होगी। प्रॉम्प्ट इंजेक्शन, ऑफ़-टॉपिक बैट और नियम तोड़ने की कोशिशों को टेस्ट करने के लिए QA टीमों, प्रॉम्प्ट इंजीनियरों और रेड-टीम साइबरसिक्योरिटी पेशेवरों के साथ काम करें।
अंत में, यूज़र्स के एक छोटे समूह के लिए पायलट वर्ज़न लॉन्च करके और उनके वास्तविक व्यवहार की निगरानी करके चरणबद्ध रोलआउट करें। बड़े समूह या पूरे ग्राहक आधार के लिए रिलीज़ करने से पहले मॉडल के पास होने के लिए सख्त मानदंड तय करें। रिलीज़ की निगरानी के लिए एक जवाबदेह मालिक नियुक्त करना न भूलें और अगर किसी बदलाव से प्रदर्शन मेट्रिक्स गिरते हैं, तो रोलबैक का रास्ता बनाएं।
प्रोडक्शन में चैटबॉट प्रदर्शन का मूल्यांकन
अपना कन्वर्सेशनल AI मॉडल लॉन्च करने से पहले, हर उपयोग के मामले में सफलता कैसी दिखती है, यह तय करें। अत्यधिक रेगुलेटेड क्षेत्रों के एप्लिकेशन के लिए यह खास तौर पर महत्वपूर्ण है, जहां सटीकता और डेटा प्राइवेसी के मानक अधिक और आवश्यकताएं सख्त होती हैं।
ऑटोमेटेड जवाबों से बड़े पैमाने पर मॉडलों का A/B टेस्ट आसान होता है, लेकिन निष्पक्ष टेस्टिंग के लिए इसे ज़रूरत के अनुसार ट्रांसक्रिप्ट पढ़ने और मानव टेस्टर्स के फ़ीडबैक के साथ जोड़ना होगा। ह्यूमन-इन-द-लूप उन बातचीत की बारीकियों को पकड़ते हैं जो AI मॉडल से छूट जाती हैं, और डेटा की उन विशेषताओं को भी जो कुल आंकड़ों में खो जाती हैं। व्यापक मूल्यांकन रणनीति में सेंटिमेंट एनालिसिस और सीधे यूज़र फ़ीडबैक भी शामिल होता है।
निवेश पर उच्च रिटर्न देने वाले परिपक्व सिस्टम की एक और पहचान निरंतर सुधार है। जहां प्रतिस्पर्धी टेस्टिंग और मॉनिटरिंग को अलग-अलग काम मानते हैं, वहीं एक परिपक्व पाइपलाइन उन्हें एक में जोड़ती है। इस स्थिति में, प्रोडक्शन विफलताएं अगले ऑप्टिमाइज़्ड एजेंट को प्रशिक्षित करने के लिए सीधे आपके टेस्ट सेट में जाती हैं।
जब AI कंपनियां उन बेस मॉडलों को अपडेट करती हैं जिन पर आपका एजेंट चलता है, तब नियमित समायोजन भी ज़रूरी हो जाते हैं। यह बदलाव अक्सर पहले प्रभावी रहे प्रॉम्प्ट को अचानक अविश्वसनीय या अनुचित जवाबों का कारण बना देता है।
हमने यह फ़ीडबैक लूप सीधे अपने प्लेटफ़ॉर्म में बनाया है। हमारे कन्वर्सेशन एनालिसिस टूल्स का इस्तेमाल करके संरचित डेटा संग्रह को ऑटोमेट करें और सेंटिमेंट का आसानी से मूल्यांकन करें। बड़े संगठन भी हमारे एंटरप्राइज़ कन्वर्सेशनल AI इन्फ्रास्ट्रक्चर का इस्तेमाल दुनिया भर में अपने एजेंटों को भरोसे के साथ मॉनिटर और स्केल करने के लिए करते हैं।
ग्राहक सेवा मेट्रिक्स के लिए ElevenAgents के साथ शुरुआत करें
बड़े पैमाने पर कन्वर्सेशनल AI को सफलतापूर्वक लॉन्च करने के लिए केवल उच्च-गुणवत्ता वाली वॉइस और कम-लेटेंसी मॉडल पर्याप्त नहीं हैं। आपको बहु-एजेंट वर्कफ़्लो को डिज़ाइन, बनाने, टेस्ट, डिप्लॉय और समायोजित करने के लिए एकीकृत इकोसिस्टम चाहिए।
ElevenAgents आपको ज़रूरी स्केलेबल इन्फ्रास्ट्रक्चर देता है। आपकी टीम के पास सर्वोत्तम नतीजों के लिए मॉडलों की लगातार निगरानी और ऑप्टिमाइज़ेशन करने हेतु Next Reply वेरिफ़िकेशन, सेंटिमेंट ट्रैकिंग और ऑटोमेटिक डेटा कलेक्शन जैसे टूल्स होते हैं। और भी बेहतर बात यह है कि आप ग्राहकों तक पहुंचने से पहले ही रिग्रेशन पकड़ लेते हैं।
क्या आप कन्वर्सेशनल AI को मापने की प्रक्रिया को आसान बनाने के लिए तैयार हैं? हमारे एजेंट टेस्टिंग फ़ीचर्स देखें और जानें कि हमारी एंटरप्राइज़ टीमें आपकी ग्राहक सेवा मेट्रिक्स बढ़ाने वाले भरोसेमंद एजेंट कैसे डिप्लॉय करती हैं।
ElevenAgents के बारे में और जानें या साइन अप करें और आज ही शुरू करें।
कन्वर्सेशनल AI को मापने के बारे में अक्सर पूछे जाने वाले सवाल

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।