
कन्वर्सेशनल AI लेटेंसी क्या है और इसे कौन से कारक प्रभावित करते हैं?
- लेखक
- Jack Limebear
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
के लिए कन्वर्सेशनल AI में, लेटेंसी ही अच्छे ऐप्लिकेशन और बेहतरीन ऐप्लिकेशन के बीच फर्क पैदा करती है।
कन्वर्सेशनल AI मूल रूप से महत्वाकांक्षी है। इसका लक्ष्य इंसान से बातचीत करने जैसा अनुभव देना है और इसके लिए यह वैसी ही भावनात्मक अभिव्यक्ति, पिच और लय को दोहराने की कोशिश करता है। आप बोलना बंद करने के बाद और AI एजेंट के जवाब देना शुरू करने के बीच जो देरी ‘स्वाभाविक’ लगती है, उसे भी इसमें शामिल करें, तो लेटेंसी का एक ऐसा लक्ष्य मिलता है जो इंसानों के वास्तविक संवाद के तरीके पर आधारित है।
जो व्यवसाय बड़े पैमाने पर कन्वर्सेशनल AI एजेंट डिप्लॉय करना चाहते हैं, उन्हें उस स्वाभाविक अनुभव को हासिल करने के लिए लेटेंसी को यथासंभव कम करना होगा। इस लेख में बताया गया है कि कन्वर्सेशनल AI लेटेंसी क्या है, पूरे पाइपलाइन में देरी क्यों होती है और इसे कम करने का एक उच्च-स्तरीय अवलोकन क्या है।
सारांश
- कन्वर्सेशनल AI लेटेंसी, यूज़र के बोलना बंद करने से लेकर एजेंट का पहला शब्द सुनाई देने तक की कुल एंड-टू-एंड देरी है।
- 700 ms से अधिक लेटेंसी वाले एजेंट अस्वाभाविक लग सकते हैं, जबकि 1,200 ms से अधिक वाले एजेंटों में कॉल छोड़ने की दर अधिक होती है।
- कन्वर्सेशनल AI पाइपलाइन के हर चरण में लेटेंसी जुड़ती जाती है।
- ElevenAgents एक ही एकीकृत आर्किटेक्चर में पूरी पाइपलाइन संभालता है, जिससे आपके व्यवसाय के लिए कम-लेटेंसी वाला कन्वर्सेशनल AI सुलभ बनता है।
कन्वर्सेशनल AI लेटेंसी क्या है?
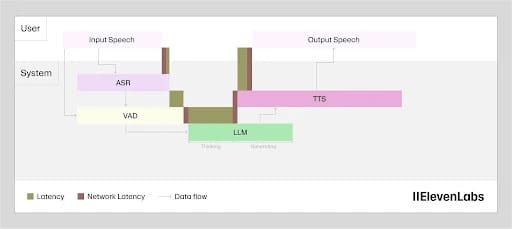
कन्वर्सेशनल AI लेटेंसी, आपके बोलने के बाद सिस्टम को जवाब देने में लगने वाला कुल समय है। आधुनिक AI मॉडल के लिए लेटेंसी को ms में मापा जाता है। पर्दे के पीछे, कुल लेटेंसी कई अलग-अलग प्रक्रियाओं से मिलकर बनती है, जिनमें से हर एक एंड-टू-एंड पाइपलाइन का एक हिस्सा पूरा करती है।
एक सामान्य कन्वर्सेशनल AI पाइपलाइन इस तरह होती है:
- एक यूज़र बोलता है
- स्पीच टू टेक्स्ट मॉडल ऑडियो को ट्रांसक्राइब करता है
- ट्रांसक्रिप्ट को LLM मॉडल को भेजा जाता है, जो जवाब तैयार करता है
- फिर LLM के टेक्स्ट को टेक्स्ट टू स्पीच मॉडल से ऑडियो में बदला जाता है
- फिर यूज़र को ऑडियो सुनाया जाता है
इनमें से हर चरण कन्वर्सेशनल AI सिस्टम में लेटेंसी जोड़ता है। इसलिए, लेटेंसी पर चर्चा करते समय कुछ अलग-अलग संक्षिप्त शब्दों को समझना ज़रूरी है।
मॉडल इन्फ़रेंस लेटेंसी
मॉडल इन्फ़रेंस लेटेंसी वह समय है जो मॉडल आउटपुट बनाने में लगाता है। इसे आंतरिक रूप से मापा जाता है और सभी बाहरी कारक इसमें शामिल नहीं होते। यह बताती है कि सामान्य इनपुट पर आपका इंजन कितनी तेज़ी से काम करता है। उदाहरण के लिए, Flash v2.5 की मॉडल इन्फ़रेंस लेटेंसी लगभग 75 ms है। यह जानकर आप अलग-अलग प्रतिस्पर्धियों के मॉडलों की गति की तुलना कर सकते हैं।
हालाँकि, याद रखें कि यह वह लेटेंसी नहीं है जिसका यूज़र वास्तव में अनुभव करता है। यह सिर्फ़ मॉडल द्वारा आउटपुट बनाने में लगाए गए कुल समय से संबंधित है।
LLM टाइम-टू-फर्स्ट-टोकन
लार्ज लैंग्वेज मॉडल (LLM) टाइम-टू-फर्स्ट टोकन (TTFT), किसी प्रॉम्प्ट को प्रोसेस करके आउटपुट का पहला उपयोगी टोकन बनाने में LLM द्वारा लिया गया कुल समय है।
TTS जनरेशन तब शुरू होता है जब आपके LLM से पहला टोकन आता है। इसलिए, यह मापता है कि LLM को आपके TTS मॉडल को चलने के लिए प्रॉम्प्ट करना शुरू करने में कितना समय लगता है। ज़्यादातर एंड-टू-एंड कन्वर्सेशनल AI सिस्टम में, LLM TTFT कुल लेटेंसी का एक अहम हिस्सा होता है।
TTS टाइम-टू-फर्स्ट ऑडियो (TTFA)
TTS टाइम-टू-फर्स्ट ऑडियो (TTFA), पहली TTS रिक्वेस्ट से लेकर मॉडल से पहला ऑडियो चंक वास्तव में निकलने तक का समय मापता है। यह मॉडल इन्फ़रेंस लेटेंसी बताने का तरीका है, लेकिन खास तौर पर TTS इंजन के लिए।
एंड-टू-एंड टाइम-टू-फर्स्ट ऑडियो (TTFA)
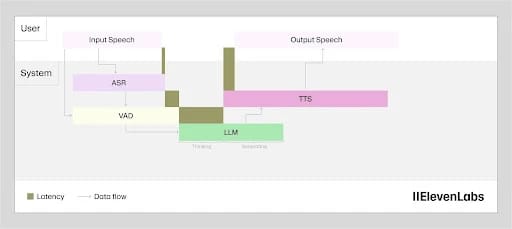
एंड-टू-एंड TTFA ही कुल कन्वर्सेशनल AI लेटेंसी है। यह पाइपलाइन के हर हिस्से का योग है, जिसमें स्पीच रिकग्निशन, LLM TTFT, TTS, TTFA और चरणों के बीच होने वाले सभी नेटवर्क ट्रांसमिशन शामिल हैं। कन्वर्सेशनल AI लेटेंसी को समग्र रूप से समझने के लिए, यही वह मेट्रिक है जिसे यूज़र महसूस करता है।
जब वे बोलते हैं, तो आपके एजेंट से कुछ सुनने से पहले उन्हें एंड-टू-एंड TTFA का इंतज़ार करना पड़ता है। यह एक समग्र माप है, यानी पाइपलाइन के किसी भी हिस्से को बेहतर बनाने से इसमें सुधार होगा।
कन्वर्सेशनल AI लेटेंसी क्यों मायने रखती है
जब कोई यूज़र आपके AI एजेंट से बात करता है, तो लेटेंसी इस अनुभव को लेकर उसकी राय तय करने वाला अहम कारक बन जाती है। कम लेटेंसी से यूज़र को जवाब के लिए कम इंतज़ार करना पड़ता है, जिससे बातचीत स्वाभाविक लगती है और आपका एजेंट सक्षम दिखता है।
जिन एजेंटों की लेटेंसी ज़्यादा होती है, वे कृत्रिम और कम सक्षम लगते हैं, भले ही उनके जवाबों की गुणवत्ता समान हो। व्यवसायों के लिए कुछ सौ ms का अंतर भी बहुत लंबा लग सकता है, जिससे आपका कस्टमर सपोर्ट एजेंट बोझिल और अप्रभावी लग सकता है।
यहाँ कुछ स्थितियाँ दी गई हैं, जो दिखाती हैं कि व्यवहार में कन्वर्सेशनल AI लेटेंसी क्यों मायने रखती है:
- 500 ms से कम: कन्वर्सेशनल एजेंट तेज़ और सहज लगता है। यूज़र को बोलना बंद करने और पहला जवाब मिलने के बीच की देरी शायद महसूस न हो, जिससे बातचीत आसानी से चलती रहती है।
- 500 ms से 1000 ms: यूज़र के बोलना बंद करने और जवाब मिलने के बीच की देरी महसूस होने लग सकती है। यह बस थोड़ी ज़्यादा लंबी होती है, इसलिए यूज़र खुद को दोहराकर या रुककर पहले से समायोजन करने की कोशिश कर सकते हैं कि एजेंट ने वास्तव में उन्हें समझा है या नहीं।
- 1000 ms से अधिक: देरी धीमी लगने लगती है और कुछ यूज़र्स को लग सकता है कि AI एजेंट बातचीत की गति नहीं पकड़ पा रहा है। ट्रांसक्रिप्ट में कभी-कभी रुकावटें या किसी मानव एजेंट से बात करने के अनुरोध दिख सकते हैं। कुछ मामलों में, यूज़र कॉल छोड़ सकते हैं।
इनमें से हर सीमा का वास्तविक व्यावसायिक नतीजों पर असर पड़ता है।
लेटेंसी स्पेक्ट्रम के निचले स्तर पर, आपके पास एक कस्टमर सर्विस एजेंट होगा जो आने वाले सवालों को स्वाभाविक रूप से संभाल सकता है और यूज़र्स को बिना अतिरिक्त मदद के उनके सवाल हल करने में मदद कर सकता है। इससे आपके मानव एजेंटों का दबाव कम होता है और ग्राहक संतुष्टि बनी रहती है। लेटेंसी स्पेक्ट्रम के ऊपरी स्तर पर, जो एजेंट बहुत देर तक हिचकिचाता हुआ लगे, वह ग्राहकों को निराश करेगा।
हमने वॉइस एजेंट लेटेंसी बजट बेंचमार्क को एक दूसरे लेख में परिभाषित किया है, ताकि P50 और P95 दोनों मानों पर अच्छी लेटेंसी कैसी दिखती है, यह बताया जा सके।
कन्वर्सेशनल AI लेटेंसी क्यों होती है?
कन्वर्सेशनल AI लेटेंसी कई अलग-अलग प्रक्रियाओं का सार बताने वाला शब्द है, जिसमें हर हिस्सा कुल लेटेंसी में योगदान देता है। इसलिए, कम लेटेंसी की बाधा केवल बेहतर मॉडल चुनकर हल होने वाली समस्या नहीं, बल्कि सिस्टम-स्तर की समस्या है। आखिरकार, पाइपलाइन में कई मॉडल मिलकर काम करते हैं।
डेवलपर्स के लिए, हमने वॉइस एजेंट लेटेंसी ऑप्टिमाइज़ेशन पर एक विस्तृत तकनीकी गाइड लिखी है, जिसका उपयोग करके आप एंड-टू-एंड टाइम-टू-फर्स्ट ऑडियो (TTFA) के हर चरण को बेहतर बना सकते हैं।
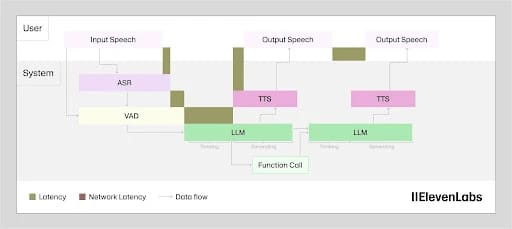
मुख्य पाइपलाइन के अलावा, टेलीफोनी और फ़ंक्शन कॉलिंग जैसे कारक भी लेटेंसी बढ़ाते हैं, भले ही वे मॉडल इन्फ्रास्ट्रक्चर के आंतरिक हिस्से न हों।
यहाँ उन सभी कारकों का अवलोकन है जो कन्वर्सेशनल AI लेटेंसी में योगदान देते हैं।
ऑटोमैटिक स्पीच रिकग्निशन
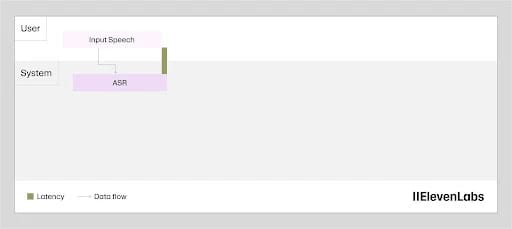
स्पीच रिकग्निशन की लेटेंसी ट्रांसक्रिप्ट बनाने में लगने वाला समय नहीं है। यूज़र के बोलते समय ट्रांसक्रिप्शन प्रक्रिया बैकग्राउंड में चलती है, इसलिए बोलना खत्म होने तक टेक्स्ट काफी हद तक तैयार होता है।
यहाँ लेटेंसी वास्तव में बोलना खत्म होने और ट्रांसक्रिप्ट के अंतिम रूप से तैयार होकर अगले चरण में भेजे जाने के बीच का अंतर है। Scribe v2 Realtime इस अंतर को लगभग 150 ms तक कम करता है और लगातार स्ट्रीम करता है, ताकि टर्न खत्म होते ही आउटपुट तैयार हो।
टर्न-टेकिंग और एंडपॉइंटिंग
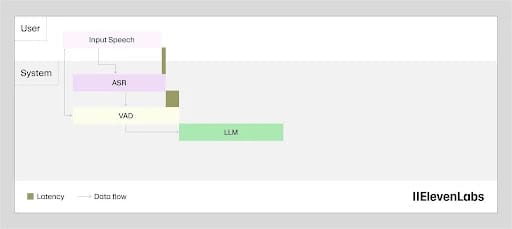
एक वॉइस एक्टिविटी डिटेक्टर (VAD), स्पीच रिकग्निशन और लैंग्वेज मॉडल के बीच होता है। इसका काम तय करना है कि यूज़र ने वास्तव में बोलना कब खत्म किया है।
गलतियों से बचने के लिए, VAD टर्न खत्म घोषित करने से पहले लगातार बनी रहने वाली चुप्पी की एक सीमा तक इंतज़ार करता है। यह इंतज़ार लैंग्वेज मॉडल के किसी शब्द को प्रोसेस करने से पहले लेटेंसी जोड़ता है। यह थोड़ी अतिरिक्त लेटेंसी समय तो बढ़ाती है, लेकिन यूज़र के बोलते समय ही सिस्टम का जवाब देना शुरू करने से भी बचाती है।
तकनीकी रूप से देखें तो, अगर कन्वर्सेशनल AI के बाकी सभी कॉम्पोनेंट्स की लेटेंसी शून्य होती, तो टर्न-टेकिंग से जुड़ी लेटेंसी अच्छी बात होती। इंसान भी बात का जवाब देने से पहले थोड़ा रुकते हैं। मशीन द्वारा वैसा ही विराम लेना इंटरैक्शन को वास्तविक बनाता है। लेकिन चूँकि कन्वर्सेशनल AI के अन्य कॉम्पोनेंट्स पहले से लेटेंसी जोड़ते हैं, इसलिए न्यूनतम लेटेंसी आदर्श है।
लैंग्वेज मॉडल प्रोसेसिंग
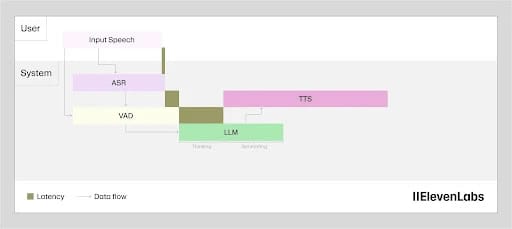
जब स्पीच टू टेक्स्ट (STT) इंजन से ट्रांसक्रिप्ट तैयार हो जाता है, तो लैंग्वेज मॉडल जवाब बनाता है। यहाँ लेटेंसी पूरे जवाब को बनाने में नहीं, बल्कि टोकन बनाना शुरू करने में लगने वाला समय है। ये टोकन आते ही सीधे TTS चरण में स्ट्रीम हो जाते हैं, इसलिए TTFT सबसे अहम होता है।
मॉडल के चुनाव के अलावा, प्रॉम्प्ट की लंबाई और नॉलेज बेस का आकार भी इस चरण को प्रभावित करते हैं। LLM को जितना अधिक संदर्भ देखना होगा, उतना अधिक समय लगेगा। बड़े पैमाने पर ऐसे सिस्टम डिज़ाइन करते समय, गति बनाए रखने के लिए उपयोगी नॉलेज बेस और संक्षिप्त प्रॉम्प्ट के बीच सही संतुलन बनाना ज़रूरी है।
स्पीच सिंथेसिस
TTS लेटेंसी, लैंग्वेज मॉडल से पहले टोकन मिलने और ऑडियो शुरू होने के बीच का समय है। टोकन मानव बोलने की गति से तेज़ आते हैं, इसलिए सिंथेसिस मॉडल कभी पूरे जवाब का इंतज़ार नहीं करता। TTS लेटेंसी सिर्फ़ पहले ऑडियो चंक तक पहुँचने का समय है।
पुराने मॉडलों को स्पीच जनरेट करना शुरू करने में 2-3 सेकंड लगते थे, इसलिए यह चरण कन्वर्सेशनल AI लेटेंसी में सबसे बड़ा योगदान देने वाला चरण हुआ करता था। ElevenLabs का Flash v2.5 इस समस्या को सीधे हल करता है: यह ~75 ms लेटेंसी के साथ स्पीच सिंथेसिस देता है और इस बाधा को सेकंड से घटाकर सेकंड के एक अंश तक ले आता है।
नेटवर्क लेटेंसी
डेटा को एक स्थान से दूसरे स्थान पर भेजने से हमेशा लेटेंसी जुड़ती है, और भौगोलिक दूरी राउंड-ट्रिप नेटवर्क लेटेंसी को और बढ़ाती है।
एंड-टू-एंड जवाब के लिए कई कॉम्पोनेंट्स साथ काम करते हैं, इसलिए नेटवर्क हॉप्स के कई सेटों पर काफी लेटेंसी जमा हो सकती है।
फ़ंक्शन कॉलिंग
फ़ंक्शन कॉल, LLM चरण में API राउंड-ट्रिप जोड़ते हैं। तेज़ आंतरिक लुकअप में कुछ दर्जन मिलीसेकंड लगते हैं, जबकि पेमेंट प्रोसेसर या इन्वेंटरी सिस्टम में सेकंड लग सकते हैं। लेटेंसी पूरी तरह कॉल की जा रही सेवा पर निर्भर करती है, इसलिए इस चरण को सीधे ऑप्टिमाइज़ करना सबसे मुश्किल है।
सबसे प्रभावी तरीका है कि टूल कॉल पूरा होने से पहले ही LLM को जवाब देने का प्रॉम्प्ट दिया जाए। "मैं आपके लिए यह जाँचता हूँ" जैसा वाक्य, चुप्पी छोड़ने के बजाय बाहरी कॉल पूरी होने तक यूज़र को जोड़े रखता है। टूल के समानांतर चलने के दौरान वॉइस रिस्पॉन्स शुरू हो जाता है।
कन्वर्सेशनल AI लेटेंसी कैसे कम करें
कन्वर्सेशनल AI लेटेंसी कम करने के लिए हर पाइपलाइन चरण को उसके प्रभाव के क्रम में देखना ज़रूरी है। अलग-अलग सुधारों से लेटेंसी पर असर पड़ता है, लेकिन सबसे बड़ा बदलाव देखने के लिए आपको पूरी पाइपलाइन पर समग्र रूप से काम करना होगा।
ये कुछ सिद्धांत हैं जो उच्च स्तर पर कन्वर्सेशनल AI लेटेंसी कम करने में आपकी मदद कर सकते हैं:
- TTS मॉडल चयन: Flash v2.5 जैसे गति के लिए ऑप्टिमाइज़ किए गए TTS मॉडल, गुणवत्ता के लिए ऑप्टिमाइज़ किए गए Eleven v3 जैसे मॉडलों से अलग आर्किटेक्चर इस्तेमाल करते हैं। रीयल-टाइम वॉइस एजेंट्स के लिए सही विकल्प वह उच्चतम-गुणवत्ता वाला मॉडल है जो आपके लेटेंसी लक्ष्य को पूरा करे—और लगभग हमेशा यह गति के लिए ऑप्टिमाइज़ किया गया मॉडल होता है।
- LLM मॉडल चयन: छोटे और तेज़ LLM आम तौर पर बड़े LLM की तुलना में कम टाइम-टू-फर्स्ट-टोकन देते हैं। ऐसा सबसे तेज़ LLM चुनना जो फिर भी काम के लिए आपके गुणवत्ता मानक को पूरा करे, TTS मॉडल चुनने जितना ही महत्वपूर्ण है।
- स्ट्रीमिंग: स्ट्रीमिंग TTS, सिंथेसिस के दौरान ऑडियो को चंक्स में लौटाता है, इसलिए यूज़र पहला शब्द तब सुन लेता है जब मॉडल बाकी ऑडियो बना रहा होता है। यह अवधारणा LLM आउटपुट पर भी लागू होती है: लैंग्वेज मॉडल के अगले वाक्य बनाते समय पहले वाक्य पर TTS सिंथेसिस शुरू करने से पाइपलाइन की लेटेंसी कम की जा सकती है।
- सिस्टम प्रॉम्प्ट डिज़ाइन: यूज़र सिस्टम प्रॉम्प्ट को सरल बना सकते हैं—निर्देशों को हर निर्णय चरण का हिस्सा रखने के बजाय प्रक्रियाओं या वर्कफ़्लो में डालकर। इससे हर टर्न पर मॉडल को समझने के लिए कम संदर्भ मिलता है।
- गार्डरेल्स: स्ट्रीमिंग मॉडल में गार्डरेल्स चलाने पर गार्डरेल जाँच पूरी होने से पहले आउटपुट चलना शुरू हो सकता है, बजाय इसके कि जाँच पूरी होने तक प्लेबैक रुका रहे।
- मॉडल कोलोकेशन: जहाँ संभव हो, एक ही स्थान पर होस्ट किए गए मॉडल इस्तेमाल करने से, जैसे ElevenLabs Agents स्टैक में, कॉम्पोनेंट्स पास रहते हैं और अलग-अलग होस्ट किए गए मॉडलों के बीच हॉप्स से लेटेंसी नहीं जुड़ती।
- भौगोलिक स्थिति: आपके सर्वर और यूज़र्स के बीच की कम दूरी लेटेंसी को काफी घटा सकती है, क्योंकि इससे एंड-टू-एंड TTFA में नेटवर्क का योगदान सीधे कम हो जाता है।
इन कारकों के अलावा, अधिक जानकारी के लिए आप यह लेटेंसी ऑप्टिमाइज़ करने की तकनीकी गाइड इस्तेमाल कर सकते हैं।
ElevenAgents के साथ कम-लेटेंसी वाला कन्वर्सेशनल AI शुरू करें
एजेंट बनाते और डिप्लॉय करते समय कन्वर्सेशनल AI लेटेंसी एक बहुत अहम बात है। ElevenAgents में लेटेंसी ऑप्टिमाइज़ेशन प्रक्रिया में ही शामिल है। रिकवर टाइम के लिए ओवरलैप तकनीकों से लेकर अलग-अलग कॉम्पोनेंट्स की कम मॉडल इन्फ़रेंस लेटेंसी तक, ElevenAgents आपके व्यवसाय के लिए कम-लेटेंसी वाले कन्वर्सेशनल AI स्टैक बनाता है।
आखिरकार, लक्ष्य वास्तविकता का अनुभव बनाना है। यूज़र को कंप्यूटर प्रोग्राम के फ़ायदे लेते हुए इंसान से बात करने की सहजता महसूस होनी चाहिए। उप-प्रक्रियाओं को तेज़ करके अब यह संभव है।
इसके बारे में और जानें ElevenAgents या सेल्स से संपर्क करें और आज ही शुरुआत करें।




