
वर्ड एरर रेट (WER): मुख्य बातें, फॉर्मूला और उपयोग
- लेखक
- Jack Limebear
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
सिद्धांत रूप में, वर्ड एरर रेट (WER) किसी ऑटोमैटिक स्पीच रिकग्निशन (ASR) टूल की सटीकता तय करने का एक मेट्रिक है। कम WER का मतलब है कि आपका अंतिम ट्रांसक्रिप्ट अधिक सटीक है, जबकि अधिक एरर रेट गलत तरीके से ट्रांसक्राइब की गई जानकारी दिखाता है।
व्यवहार में, WER उस मेडिकल ट्रांसक्रिप्शन सॉफ़्टवेयर के बीच का अंतर हो सकता है जो लिखता है कि मरीज़ को प्रिस्क्रिप्शन की ‘पंद्रह मिलीग्राम’ चाहिए, और उस सॉफ़्टवेयर के बीच जो ‘पचास मिलीग्राम’ लिख देता है। यह उस सपोर्ट टूल के बीच का फर्क है जो ग्राहक की ज़रूरतों को सही ढंग से ट्रांसक्राइब करता है और उस टूल के बीच जो आपके यूज़र को निराश छोड़ देता है।
इस लेख में हम समझेंगे कि WER क्या है, इसकी गणना कैसे करें और अपने ASR प्रोवाइडर को बेंचमार्क करने के लिए इसका इस्तेमाल कैसे करें।
सारांश
- वर्ड एरर रेट, रेफ़रेंस ट्रांसक्रिप्ट में शब्दों की संख्या से भाग देकर, प्रतिस्थापन, विलोपन और जोड़—इन तीन तरह की त्रुटियों को गिनता है।
- WER का फ़ॉर्मूला है: WER = (S + D + I) / N।
- कम WER स्कोर का मतलब है कि अंतिम आउटपुट अधिक सटीक है।
- 5% से कम WER एक अच्छा बेंचमार्क है, हालांकि कानूनी या मेडिकल ट्रांसक्रिप्शन के लिए इससे भी कम वर्ड एरर रेट की ज़रूरत हो सकती है।
- WER सभी त्रुटियों को समान मानता है, इसलिए संदर्भ के आधार पर पढ़ने के लिए यह एक परफ़ेक्ट मेट्रिक नहीं है। Semantic Word Error Rate (SWER) जैसे उभरते मेट्रिक यह मापकर इस कमी को दूर करने की कोशिश करते हैं कि किसी कथन का अर्थ बरकरार रहा या नहीं।
वर्ड एरर रेट क्या है?
वर्ड एरर रेट (WER), स्पीच टू टेक्स्ट मॉडल में स्पीच रिकग्निशन की सटीकता मापने का मानक मेट्रिक है। यह 0-1 के रूप में दर्शाता है कि ट्रांसक्राइब करते समय STT सिस्टम क्या गलत करता है (0.8 का अर्थ 80% एरर रेट होगा), जिसे उसके प्रतिस्थापन, विलोपन और जोड़ के आधार पर मापा जाता है।
प्रतिस्थापन तब होता है, जब किसी शब्द की जगह गलत शब्द आ जाता है। विलोपन तब होता है, जब कोई शब्द पूरी तरह छूट जाता है। वहीं, जोड़ तब होता है जब ट्रांसक्रिप्ट में ऐसा शब्द शामिल हो जो कभी बोला ही नहीं गया था। WER इन तीनों घटकों का इस्तेमाल करता है और फिर सही ट्रांसक्रिप्ट में शब्दों की संख्या से भाग देता है, जिससे एक ऐसा अंक मिलता है जिसकी तुलना आप दूसरे वेंडर्स से कर सकते हैं।
WER का फ़ॉर्मूला इस तरह है:
WER = (S + D + I) / N
जहाँ:
- S: प्रतिस्थापन (शब्द गलत है)
- D: विलोपन (शब्द मौजूद नहीं है)
- I: जोड़ (अतिरिक्त शब्द मौजूद है)
- N: रेफ़रेंस ट्रांसक्रिप्ट में कुल शब्द
आप WER को दशमलव या प्रतिशत, दोनों रूपों में दिखा सकते हैं। WER जितना कम होगा, आपका स्कोर उतना ही बेहतर होगा, क्योंकि मॉडल ने ट्रांसक्राइब करते समय कम गलतियाँ कीं।
व्यवहार में, 10% WER का मतलब है कि आपकी मीटिंग के ट्रांसक्रिप्ट में हर 10 में से लगभग 1 शब्द को दोबारा देखना होगा।
स्पीच रिकग्निशन सिस्टम में वर्ड एरर रेट क्यों अहम है?
वर्ड एरर रेट टीमों को अलग-अलग प्रोवाइडर्स की तुलना करने के लिए एक ऑब्जेक्टिव मेट्रिक देता है। यह मार्केटिंग दावों से परे जाकर स्पष्ट रूप से बताता है कि स्पीच रिकग्निशन मॉडल कितना सटीक है। साक्ष्य के आधार पर विकल्पों का आकलन करने वाली किसी भी एंटरप्राइज़ को साफ़ पता चल जाता है कि इस क्षेत्र में कौन-से मॉडल आगे हैं।
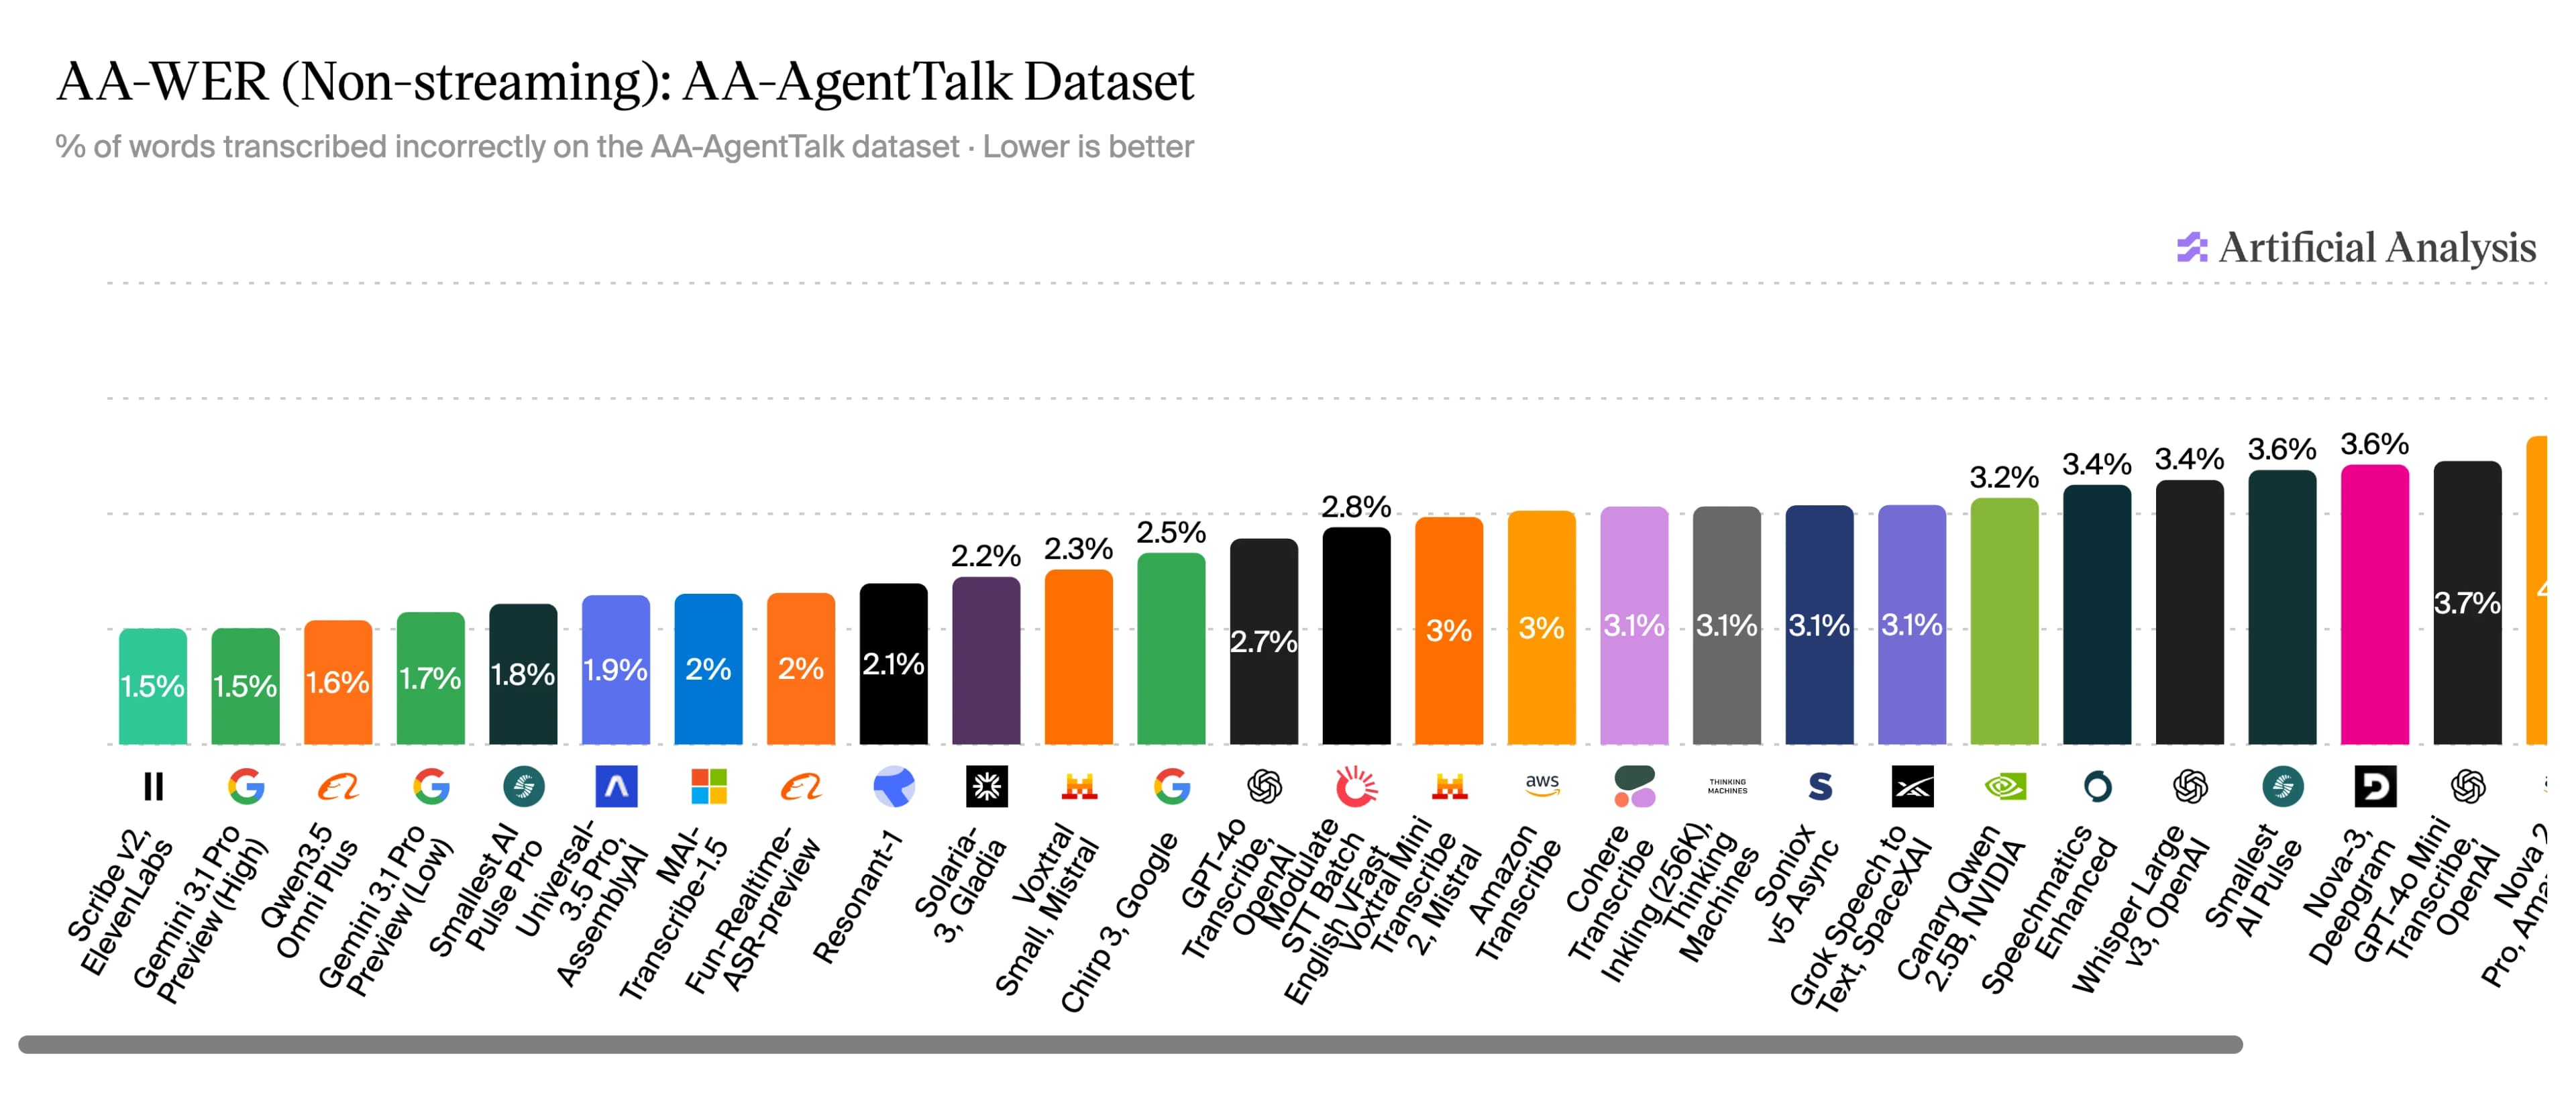
स्रोत: Artificial Analysis को 10 जुलाई, 2026 को देखा गया।
जुलाई 2026 तक, Artificial Analysis के स्वतंत्र शोध में ElevenLabs के Scribe v2 को नॉन-स्ट्रीमिंग ट्रांसक्रिप्शन मॉडल के लिए AA-AgentTalk डेटासेट पर इंडस्ट्री में सबसे कम WER वाला मॉडल माना गया है, जिसका WER 1.5% है।
वेंडर मूल्यांकन से आगे, WER का प्रोडक्ट स्तर पर वास्तविक प्रभाव पड़ता है। 12% WER वाला मेडिकल ट्रांसक्रिप्शन सॉफ़्टवेयर मरीज़ के रिकॉर्ड में गंभीर गलतियाँ ला सकता है। किसी कस्टमर सपोर्ट कॉल में गलत ट्रांसक्रिप्शन से आगे की प्रक्रियाओं में विफलताएँ हो सकती हैं, जैसे गलत सेंटिमेंट एनालिसिस या खराब कैटेगराइज़ेशन।
इन उपयोग-केस-विशिष्ट समस्याओं से आगे, ASR सिस्टम के विफल होने पर सबसे ज़्यादा असर अक्सर उन लोगों पर पड़ता है जिनके लिए बोले गए कंटेंट तक पहुँचने का एकमात्र तरीका ट्रांसक्रिप्ट ही होता है। World Wide Web Consortium अधिक संदर्भ के लिए, एक्सेसिबिलिटी पहलों से अपेक्षित न्यूनतम मानकों पर विस्तृत दस्तावेज़ उपलब्ध कराता है।
वर्ड एरर रेट की गणना कैसे करें: फ़ॉर्मूला और उदाहरण
कदम पता होने पर वर्ड एरर रेट की गणना करना आसान है। जैसा कि ऊपर बताया गया है, इस्तेमाल होने वाला फ़ॉर्मूला WER = (S + D + I) / N है। सभी शब्दों का विवरण ऊपर दिया गया है, लेकिन तुरंत संदर्भ के लिए ये हैं: प्रतिस्थापन, विलोपन, जोड़ और ट्रांसक्रिप्शन में कुल शब्दों के लिए N।
WER की गणना इस तरह करें:
- रेफ़रेंस ट्रांसक्रिप्ट बनाएं: किसी ऑडियो क्लिप का सटीक ट्रांसक्रिप्शन तैयार करने के लिए मानव ट्रांसक्रिप्शन और सत्यापन का उपयोग करें।
- अपने STT टूल का इस्तेमाल करें: ऑडियो क्लिप को ट्रांसक्राइब करने के लिए ASR प्लेटफ़ॉर्म का इस्तेमाल करें और एक AI ट्रांसक्रिप्ट बनाएं, जिसे आप टेस्ट के रूप में इस्तेमाल करेंगे।
- दोनों वर्ज़न को अलाइन करें: न्यूनतम एडिट्स की संख्या जानने के लिए डायनेमिक प्रोग्रामिंग (विशेष रूप से Levenshtein एल्गोरिदम) का इस्तेमाल करें। इस एल्गोरिदम को हम आगे के सेक्शन में विस्तार से समझाएँगे।
- फ़ॉर्मूला लागू करें: मानव-सत्यापित कॉपी की तुलना में AI-जनरेटेड वर्ज़न की कुल त्रुटियाँ गिनें और फिर सटीक WER निकालने के लिए WER = (S + D + I) / N का इस्तेमाल करें।
कागज़ पर यह काफ़ी तकनीकी लग सकता है, लेकिन व्यवहार में यह कहीं आसान है। आइए एक उदाहरण से समझते हैं कि हमारा क्या मतलब है।
रेफ़रेंस ट्रांसक्रिप्ट: Mrs. Dalloway said she would buy the flowers herself.
ASR आउटपुट: Miss Dalloway said she would buy flowers herself.
कुल त्रुटियों की गणना करें, तो 9 कुल शब्दों में 1 S और 1 D हैं।
फ़ॉर्मूला लगाने पर मिलता है: WER = 2 / 9 = 0.222 = 22.2%।
Python से वर्ड एरर रेट की गणना
मैन्युअल तरीका बढ़िया काम करता है, लेकिन आप Python से WER की गणना करके समय बचा सकते हैं। jiwer लाइब्रेरी यह सब पूरी तरह अपने-आप संभालती है।
jiwer के दस्तावेज़ का इस्तेमाल करके आप यह पैकेज इंस्टॉल कर सकते हैं, जिसे खास तौर पर ASR सिस्टम का मूल्यांकन करने और WER जैसे मुख्य मेट्रिक देने के लिए बनाया गया है। डाउनलोड होने के बाद, Python से WER की तेज़ी से गणना करने के लिए आप यह कोड इस्तेमाल कर सकते हैं:
ध्यान दें कि इस उदाहरण में ASR आउटपुट, मूल रेफ़रेंस से दो जगह अलग है। ‘jumps’ शब्द को गलती से ‘leaps’ के रूप में ट्रांसक्राइब किया गया है (एक प्रतिस्थापन), और ‘lazy’ से पहले ‘last’ जोड़ा गया है (एक जोड़)। रेफ़रेंस ट्रांसक्रिप्ट के नौ शब्दों में दो त्रुटियों के कारण वर्ड एरर रेट (WER) 0.222 या 22.2% होता है।
वर्ड एरर रेट और अन्य रिकग्निशन मेट्रिक की तुलना
हालाँकि ASR की सटीकता मापने के लिए WER मानक मेट्रिक है, फिर भी आप दूसरे टूल इस्तेमाल कर सकते हैं। उदाहरण के लिए:
- कैरेक्टर एरर रेट (CER): WER की तरह यह शब्द-स्तर के बजाय कैरेक्टर-स्तर पर ट्रांसक्रिप्शन की सटीकता मापता है। उन भाषाओं के लिए सबसे अच्छा है जिनमें शब्दों की स्पष्ट सीमाएँ नहीं होतीं (scriptio continua), या ऐसे कार्यों के लिए जिनमें वर्तनी अहम हो।
- मैच एरर रेट (MER): यह प्रतिस्थापन, जोड़ और विलोपन को WER से थोड़ा अलग ढंग से मानते हुए ट्रांसक्रिप्शन त्रुटियों का अनुपात मापता है। यह वाक्य में गलत त्रुटियों के अनुपात पर केंद्रित होता है।
- वर्ड इन्फ़ॉर्मेशन लॉस्ट (WIL): ट्रांसक्रिप्शन के दौरान मूल जानकारी का कितना हिस्सा खो गया, इसका अनुमान। यह WER की सीधी त्रुटि-गणना के बजाय बोधगम्यता का माप देता है।
- एम्बेडिंग एरर रेट (EmbER): ट्रांसक्रिप्ट्स के बीच अर्थ-आधारित विश्लेषण देता है। यह WER से आगे जाकर सही शब्द और गलत ट्रांसक्रिप्शन के बीच के अर्थगत अंतर की जानकारी देता है।
इनमें से हर मेट्रिक अलग परिस्थिति के लिए बेहतर है। नीचे दी गई टेबल देखें:
Levenshtein दूरी के उदाहरण: WER के पीछे का गणित
वर्ड एरर रेट वास्तव में मूल आउटपुट और हाइपोथेसिस आउटपुट के बीच की दूरी का माप है। इस अंतर को गणितीय रूप से समझने के लिए हम Levenshtein दूरी का इस्तेमाल करते हैं।
Levenshtein दूरी एक अनुक्रम को दूसरे में बदलने के लिए आवश्यक न्यूनतम सिंगल-यूनिट एडिट्स की संख्या गिनती है। WER के लिए इसका मतलब खास तौर पर प्रतिस्थापन, जोड़ और विलोपन के एडिट्स हैं। उदाहरण के लिए, अगर हमें Cat को Mat में बदलना हो, तो एक अक्षर ‘C’ को ‘M’ से बदलना होगा, जिससे Levenshtein दूरी 1 होगी।
हालाँकि CER की गणना में आप इसका ज़्यादा इस्तेमाल देखेंगे, WER Levenshtein दूरी को शब्द-स्तर तक बढ़ाता है। इसमें हर यूनिट कैरेक्टर के बजाय एक पूरा शब्द होता है, और वास्तविक दूरी यह मापती है कि हमारे ASR आउटपुट को सटीक मूल में बदलने के लिए कितने शब्द एडिट्स लगेंगे।
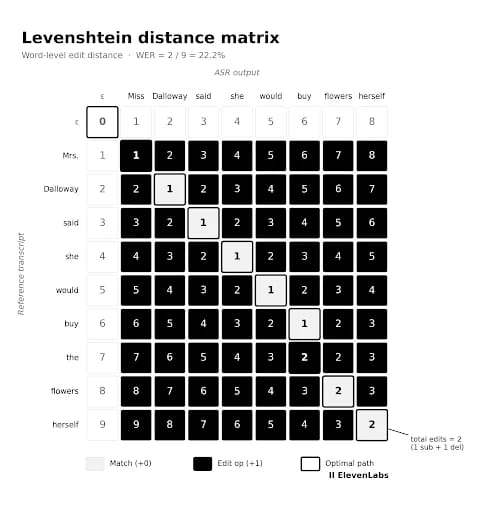
हम एक मैट्रिक्स बनाते हैं, जहाँ हर सेल मूल ट्रांसक्रिप्ट और ASR ट्रांसक्रिप्ट के बीच की कुल दूरी दिखाता है। इसके बाद Levenshtein दूरी मैट्रिक्स को ऊपर-बाएँ से नीचे-दाएँ तक भरती है और अंतिम सेल शब्द-स्तर के कुल एडिट्स की संख्या देता है। उस संख्या को N से भाग देना आपका WER है।
हालाँकि इस मैट्रिक्स की गणना आम तौर पर अलग-अलग कैरेक्टर्स के साथ की जाती है, सरलता के लिए यहाँ हमारे पिछले उदाहरण का बड़ा रूप दिया गया है।
वर्ड एरर रेट से जुड़ी आम कमियाँ और गलतफ़हमियाँ
खासकर जब STT APIs ज़्यादा सुलभ हो रही हैं और ASR सॉफ़्टवेयर व्यापक एजेंट स्टैक का आम हिस्सा बन रहा है, तो हमें अलग-अलग टूल्स के बीच काफ़ी तुलना देखने को मिलेगी।
अपनी वर्ड एरर रेट की गणना करने से पहले, कुछ आम समस्याओं और गलतफ़हमियों को समझना ज़रूरी है।
- सभी त्रुटियाँ समान हैं: WER हर त्रुटि को समान रूप से महत्वपूर्ण मानता है। कई संदर्भों में यह ठीक हो सकता है, लेकिन कुछ उपयोग के मामलों में यह स्वीकार्य नहीं है। उदाहरण के लिए, अस्पताल में 5% एरर रेट, जिसे अच्छा WER माना जाएगा, फिर भी समझ से बाहर हो सकता है, क्योंकि एक या दो त्रुटियाँ भी मरीज़ को जोखिम में डाल सकती हैं। इस सीमा के कारण Semantic Word Error Rate (SWER) जैसे नए मेट्रिक विकसित हुए हैं, जो हर शब्द के हूबहू मिलने के बजाय यह मापने की कोशिश करते हैं कि वाक्य का अर्थ बरकरार रहा या नहीं।
- WER 100% से अधिक हो सकता है: हालाँकि हमने पहले बताया था कि WER 0 और 1 के बीच होता है, फिर भी आपको 100% से अधिक WER मिल सकता है। ऐसा इसलिए है क्योंकि जोड़ की त्रुटि मूल ट्रांसक्रिप्ट के कुल शब्दों से अधिक शब्द बना सकती है। इसका आम उदाहरण ‘I’m’ को ‘I am’ के रूप में ट्रांसक्राइब करना है, जहाँ एक शब्द दो बन जाते हैं।
- कम WER तकनीकी रूप से हमेशा बेहतर नहीं होता:कागज़ पर 5% WER, 10% WER से बेहतर है। लेकिन अगर उस 5% में शामिल त्रुटियों ने वाक्य का संदर्भ काफ़ी बदल दिया हो, जबकि 10% वाली त्रुटियों ने नहीं, तो पूरी तस्वीर सामने नहीं आती। संदर्भ यहाँ अब भी बहुत अहम है, और इसी अर्थगत प्रभाव को समझने के लिए SWER जैसे मेट्रिक विकसित किए जा रहे हैं।
2024 में Apple ने एक दिलचस्प अध्ययन प्रकाशित किया था, जिसमें ऊपर बताए गए आख़िरी बिंदु की जाँच की गई। जब लोगों ने यह देखकर 9.4% के WER की गणना का आकलन किया कि ASR पढ़ने योग्य था या नहीं, तो उन्होंने उसी अंश को सिर्फ़ 2.2% WER दिया। जिस उदाहरण का परीक्षण हुआ, उसमें लोगों ने कई मामलों में ‘त्रुटियों’ को महत्वहीन माना, जिससे Human WER मशीनों की तुलना में 4x से भी अधिक उदार निकला।
WER के लिए इंडस्ट्री बेंचमार्क
आदर्श WER उस इंडस्ट्री या उपयोग-केस पर बहुत निर्भर करता है, जिसमें आप ASR तकनीक का इस्तेमाल कर रहे हैं। हालाँकि WER के लिए <5% एक इंडस्ट्री बेंचमार्क है, मेडिकल या कानूनी ट्रांसक्रिप्शन जैसे विशिष्ट क्षेत्रों में इससे बहुत कम रेट की ज़रूरत होती है।
Artificial Analysis के जुलाई 2026 के अध्ययन में ElevenLabs के Scribe v2 ने 1.5% WER स्कोर किया। हालाँकि, यह याद रखना ज़रूरी है कि ये आँकड़े आमतौर पर प्राथमिक भाषा के रूप में अंग्रेज़ी पर आधारित होते हैं। अन्य भाषाओं में STT तकनीक उतनी प्रभावी नहीं हो सकती।
ElevenLabs Docs में सामान्य WER श्रेणियों का विवरण दिया गया है, जो Scribe v1 और Scribe v2 द्वारा समर्थित सभी भाषाओं में लागू होती हैं।
रिकग्निशन सटीकता बढ़ाने के लिए ElevenAPI से शुरुआत करें
जब आप ऐसा ऐप्लिकेशन या प्रोडक्ट बना रहे हों जहाँ ट्रांसक्रिप्शन की गुणवत्ता मायने रखती है, तो अच्छे ASR API और औसत ASR API के बीच का अंतर पहले आपके WER में और फिर आपके यूज़र्स के अनुभव में दिखता है।
ElevenLabs Scribe, स्पीच टू टेक्स्ट लेयर है, जो ElevenAPI के ज़रिए उपलब्ध है। 90+ भाषाओं और इंडस्ट्री-लीडिंग WER के साथ, इसमें स्पीकर डायरीकरण, शब्द-स्तर के टाइमस्टैम्प, कीटर्म प्रॉम्प्टिंग और एंटिटी डिटेक्शन जैसे फीचर भी हैं।
ElevenAPI के बारे में और जानने के लिए ElevenLabs Docs देखें या साइन अप करके आज ही शुरुआत करें।
वर्ड एरर रेट FAQ

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।


