ऑटोमैटिक स्पीच रिकग्निशन (ASR) क्या है?
- लेखक
- Jack Limebear
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
1952 में, दुनिया का सबसे उन्नत स्पीच रिकग्निशन सिस्टम ठीक 9 शब्द समझ सकता था।
करीब 75 साल आगे बढ़ें, तो ऑटोमैटिक स्पीच रिकग्निशन (ASR) दर्जनों भाषाओं को रियल टाइम में ट्रांसक्राइब करता है—आपके फ़ोन के वॉइस असिस्टेंट से लेकर लाइव वीडियो पर दिखने वाले कैप्शन तक।
यह गाइड उस तकनीक को समझती है जिसने 1952 के सिस्टम और आज के सिस्टम के बीच की दूरी पाटी। इसमें जानें कि ASR क्या है, यह आवाज़ को टेक्स्ट में कैसे बदलता है और आज भी कैसे विकसित हो रहा है।
सारांश:
- ASR का मतलब ऑटोमैटिक स्पीच रिकग्निशन है—यह तकनीक बोली गई ऑडियो को लिखित टेक्स्ट में बदलती है।
- ASR का शुरुआती रूप 1952 में आया था और 2010 के दशक के अंत में डीप लर्निंग सिस्टम मानव मानकों के बराबर पहुँच गए।
- आधुनिक ASR लाखों घंटों के ऑडियो पर प्रशिक्षित एंड-टू-एंड न्यूरल नेटवर्क का उपयोग करता है।
- वर्ड एरर रेट (WER) सटीकता का मानक मेट्रिक है, लेकिन प्रोडक्शन ASR में लेटेंसी, डायरीकरण की गुणवत्ता और संदर्भ की समझ भी अहम हैं।
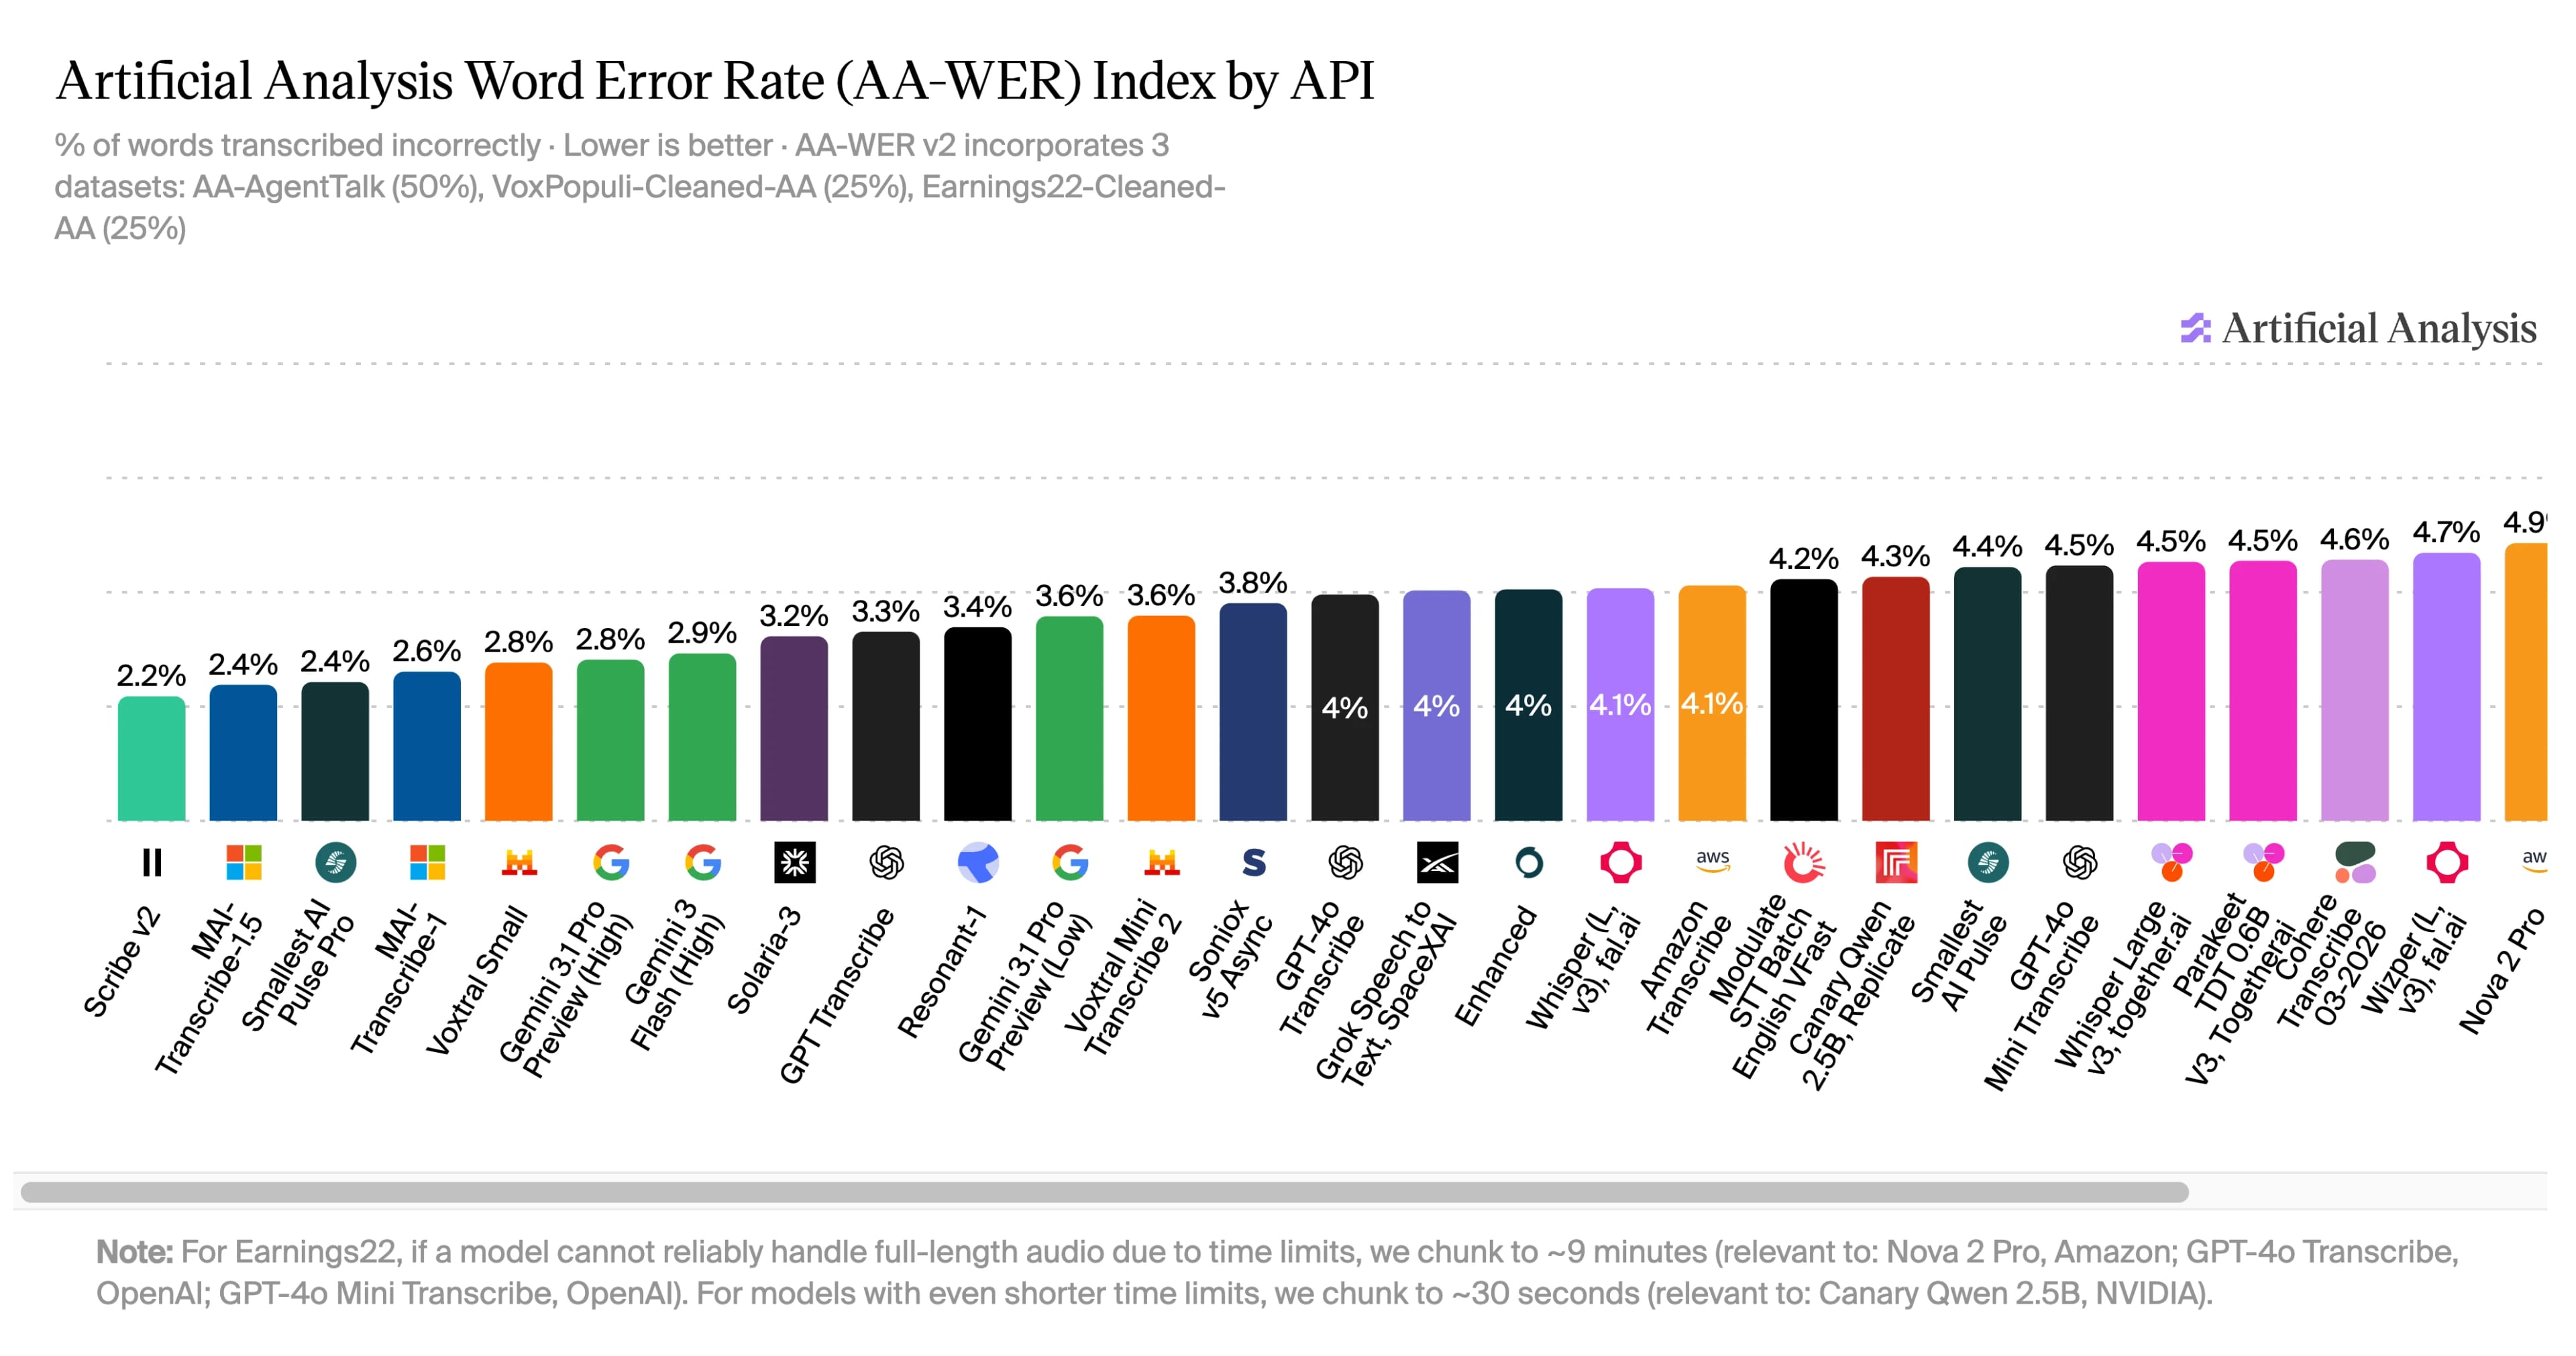
- ElevenAPI डेवलपर्स को प्रोडक्शन-ग्रेड ASR देता है, जिसे स्वतंत्र रूप से Artificial Analysis ने 2.2% वर्ड एरर रेट के साथ बेंचमार्क किया है, जो इसके इंडेक्स में सबसे कम है (जुलाई 2026)।
ऑटोमैटिक स्पीच रिकग्निशन (ASR) क्या है?
ऑटोमैटिक स्पीच रिकग्निशन, जिसे अक्सर सिर्फ़ ASR कहा जाता है, ऐसे सॉफ़्टवेयर को बताता है जो मानव आवाज़ सुनकर उसे सटीक, मशीन-पठनीय टेक्स्ट में बदलता है। इसे आमतौर पर स्पीच टू टेक्स्ट और स्पीच रिकग्निशन, या कभी-कभी कंप्यूटर स्पीच रिकग्निशन भी कहा जाता है।
ASR इतना आम हो गया है कि आप शायद हर दिन बिना जाने ही इसका इस्तेमाल करते हों। जब भी आप कोई संदेश बोलकर लिखवाते हैं, वॉइस असिस्टेंट से सवाल पूछते हैं, लाइव वीडियो के सबटाइटल पढ़ते हैं या इंटरैक्टिव वॉइस रिस्पॉन्स फ़ोन सिस्टम में नेविगेट करते हैं, तो आप ASR का उपयोग कर रहे होते हैं।
हालाँकि स्पीच टू टेक्स्ट और ASR को अक्सर समान अर्थ में इस्तेमाल किया जाता है (और वे काफ़ी जुड़े हैं), वे बिल्कुल एक ही चीज़ नहीं हैं। ASR वह तकनीक है जो पहचानती है कि क्या कहा गया, जबकि STT उस तकनीक का एक टूल के रूप में उपयोग है। वॉइस रिकग्निशन सॉफ़्टवेयर ASR के ऊपर काम करता है और पहचानता है कि कोई शब्द किसने कहा, जो स्पीकर डायरीकरण क्षमताओं की बुनियाद बनता है।
ये छोटे अंतर हैं, लेकिन यदि आप अपने ऐप्स या वेबसाइट में ASR/STT/वॉइस रिकग्निशन सिस्टम जोड़ना चाहते हैं, तो इन्हें समझना ज़रूरी है।
ऑटोमैटिक स्पीच रिकग्निशन तकनीक का संक्षिप्त इतिहास
ऑटोमैटिक स्पीच रिकग्निशन तकनीक जितनी पुरानी है, उतनी अधिकांश लोग मानते नहीं हैं; इसके शुरुआती संस्करण 1950 के दशक तक जाते हैं। शुरुआत के बाद के 70 से अधिक वर्षों में ASR कई अहम चरणों से गुज़रा है, जिन्होंने इसके विकास की नींव रखी।
ASR तकनीक के प्रमुख दौर ये रहे हैं:
- 1952 और पहला ASR: 1952 में, AUDREY नाम का ऑटोमैटिक डिजिट रिकग्नाइज़र, Bell Laboratories ने एक से नौ तक के अंक समझने के लिए बनाया था। यह टूल केवल लगभग 90% सटीक था और सिर्फ़ अपने आविष्कारक द्वारा इस्तेमाल किए जाने पर काम करता था, इसलिए इसकी सीमाएँ बहुत थीं। आज की आधुनिक क्षमताओं से यह बहुत दूर था, फिर भी केवल 1-9 को पहचान पाना बड़ी उपलब्धि थी।
- 1960 से 70 का दशक और बढ़ती ASR शब्दावली: अगले दशकों में IBM, University College London और जापान की NEC सहित दुनिया भर की प्रयोगशालाओं ने अलग-अलग संदर्भों में AUDREY जैसे मॉडल बनाए। Stanford में भारत के स्नातक छात्र राज रेड्डी ने अपने PhD प्रोजेक्ट के लिए एक स्वर पहचानने वाला सिस्टम बनाया, जिससे हर शब्द के बीच रुके बिना निरंतर स्पीच रिकग्निशन की नींव पड़ी। DARPA (Defense Advanced Research Projects Agency) ने इस दौरान ऐसे शोध को फंड किया, जिससे Beam Search आया—वाक्य निर्माण और डिकोडिंग की एक विधि, जो 1976 तक 1,000 से अधिक शब्दों की पहचान में अहम रही।
- 1980 से शुरुआती 2010 का दशक और सांख्यिकीय प्रगति: 1987 में, राज रेड्डी के एक छात्र ने, जो तब प्रोफ़ेसर थे, Hidden Markov Models को Beam Search के साथ जोड़ा। इससे ऐसे ASR संभव हुए जिन्हें किसी एक खास वक्ता पर प्रशिक्षित करने की ज़रूरत नहीं थी। इस सफलता ने स्पीच रिकग्निशन सिस्टम का प्रशिक्षण समय बहुत कम कर दिया। Dragon Systems ने 1997 में NaturallySpeaking Preferred नाम से पहला व्यावसायिक ASR जारी किया। यह प्रति मिनट 100 शब्द पहचान सकता था और खूब बिका।
- आधुनिक दौर और डीप लर्निंग: 2010 के दशक में शोधकर्ताओं ने दिखाया कि ऑडियो और ट्रांसक्रिप्ट पर एंड-टू-एंड प्रशिक्षित एक न्यूरल नेटवर्क, पूरी तरह सांख्यिकीय पाइपलाइन से बेहतर प्रदर्शन करता है। डीप न्यूरल नेटवर्क के आने से ASR 5% से 10% एरर रेट के साथ इंसानी स्तर के करीब पहुँच गए। इसी समय Alexa और Siri जैसे वॉइस-आधारित असिस्टेंट बाज़ार में आए।
तब से ASR और अधिक सटीक व व्यापक हुआ है। जुलाई 2026 तक, Artificial Analysis के स्वतंत्र शोध ने ElevenLabs के Scribe v2 को उद्योग में सबसे कम, केवल 2.2% वर्ड एरर रेट (WER) वाला पाया।
ASR कैसे काम करता है? स्पीच टू टेक्स्ट तकनीक की बुनियादी बातें
ASR पहले ऑडियो सैंपल लेता है, उसे संख्यात्मक रूप में बदलता है और फिर एक प्रशिक्षित मॉडल से उन संख्याओं के अनुरूप शब्दों का सबसे संभावित क्रम अनुमानित करता है। आधुनिक ASR यह पूरी एंड-टू-एंड प्रक्रिया एक सेकंड से कम समय में रियल टाइम में करता है।
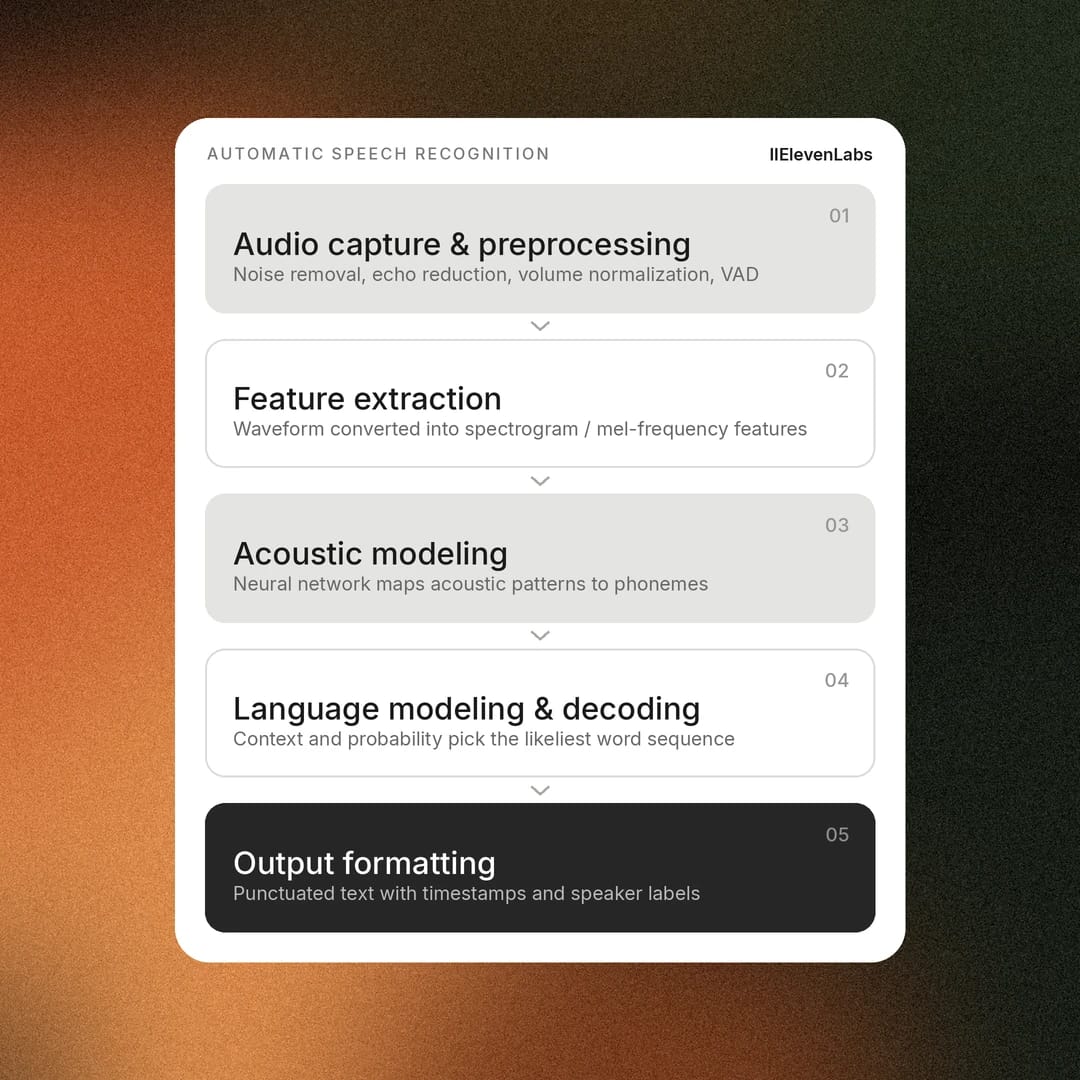
ASR पाइपलाइन के पाँच मुख्य चरण हैं:
- ऑडियो कैप्चर और प्रीप्रोसेसिंग: सिस्टम ऑडियो सिग्नल रिकॉर्ड करता है, बैकग्राउंड शोर हटाता है, इको कम करता है और एकरूपता बढ़ाने के लिए वॉल्यूम स्तर सामान्य करता है। मॉडल के आधार पर, ट्रांसक्रिप्शन शुरू होने से पहले यह आवाज़ को चुप्पी या बैकग्राउंड ध्वनियों से अलग करने के लिए वॉइस एक्टिविटी डिटेक्शन (VAD) इस्तेमाल कर सकता है।
- फ़ीचर एक्सट्रैक्शन: ऑडियो को संख्यात्मक रूप में बदला जाता है, आमतौर पर स्पेक्ट्रोग्राम या मेल-फ़्रीक्वेंसी फ़ीचर्स के रूप में, जो मानव आवाज़ की फ़्रीक्वेंसी और पैटर्न को सटीक रूप से दर्शाते हैं। यह चरण कच्चे वेवफ़ॉर्म को ऐसे डेटा में बदलता है जिसे मशीन लर्निंग मॉडल प्रभावी ढंग से प्रोसेस कर सके।
- अकॉस्टिक मॉडलिंग: न्यूरल नेटवर्क पिछले चरण के फ़ीचर्स का विश्लेषण करके फ़ोनीम या अन्य स्पीच यूनिट्स का अनुमान लगाता है और अकॉस्टिक पैटर्न व बोली जाने वाली भाषा के संबंध को सीखता है। आधुनिक एंड-टू-एंड मॉडल अक्सर यह काम भाषा समझने के साथ मिलाकर करते हैं, अलग चरण के रूप में नहीं।
- लैंग्वेज मॉडलिंग और डिकोडिंग: फिर सिस्टम व्याकरण, संदर्भ और गणितीय संभावना जैसे नियमों के आधार पर सबसे संभावित शब्द-क्रम को महत्व देता है। यहाँ संदर्भ और संभावना बहुत ज़रूरी हैं, क्योंकि दो वाक्यों का IPA (International Phonetic Alphabet) ट्रांसक्रिप्शन मिलता-जुलता हो सकता है, जबकि उनका संदर्भ बिल्कुल अलग हो। उदाहरण के लिए, “Recognize Speech” और “Wreck a nice peach” एक जैसे सुनाई दे सकते हैं, लेकिन उनके अर्थ पूरी तरह अलग हैं। अगर सटीकता से निर्णय न हो पाए, तो संदर्भ सिस्टम को सही विकल्प चुनने में मदद करता है।
- आउटपुट फ़ॉर्मेटिंग: आवाज़ में क्या है यह तय होने के बाद, अंतिम टेक्स्ट को विराम चिह्नों और कैपिटलाइज़ेशन के साथ ट्रांसक्राइब किया जाता है। शब्द-स्तर के टाइमस्टैम्प और स्पीकर लेबल जैसे अतिरिक्त मेटाडेटा अधिक विस्तृत ट्रांसक्रिप्ट बनाते हैं।
इन मुख्य चरणों में मॉडल आने वाले ऑडियो डेटा को लिखित ट्रांसक्रिप्ट में बदलता है।
पारंपरिक हाइब्रिड सिस्टम बनाम एंड-टू-एंड डीप लर्निंग ASR
ऊपर की पाइपलाइन बताती है कि ASR कैसे काम करता है, लेकिन पाइपलाइन के बीच वाले हिस्से के लिए वास्तव में दो तकनीकी तरीके हैं।
पुराने सिस्टम कई कंपोनेंट्स को जोड़ते हैं: शब्दों के उच्चारण को एन्कोड करने वाला लेक्सिकॉन मॉडल, ऑडियो को फ़ोनीम से मैप करने वाला अकॉस्टिक मॉडल और संभावित शब्द-क्रम का अनुमान लगाने वाला लैंग्वेज मॉडल। इन सभी को बनाने के लिए मानव विशेषज्ञता चाहिए—उच्चारण शब्दकोश हाथ से बनाने वाले भाषाविदों से लेकर ऑडियो में हर शब्द की सटीक स्थिति तय करने वाले एनोटेटर्स तक।
एंड-टू-एंड डीप लर्निंग इन सभी कंपोनेंट्स को एक ही न्यूरल नेटवर्क में समेट देती है। यह नेटवर्क लाखों घंटों के ऑडियो और ट्रांसक्रिप्ट के युग्मों से उच्चारण, ध्वनिकी और भाषा की संभाव्यता को अप्रत्यक्ष रूप से समझते हुए ऑडियो को सीधे टेक्स्ट में मैप करता है।
आइए, ASR तकनीक के पारंपरिक और आधुनिक तरीकों के अंतर को समझें।
ASR की सटीकता कैसे मापी जाती है: वर्ड एरर रेट (WER) बेंचमार्क
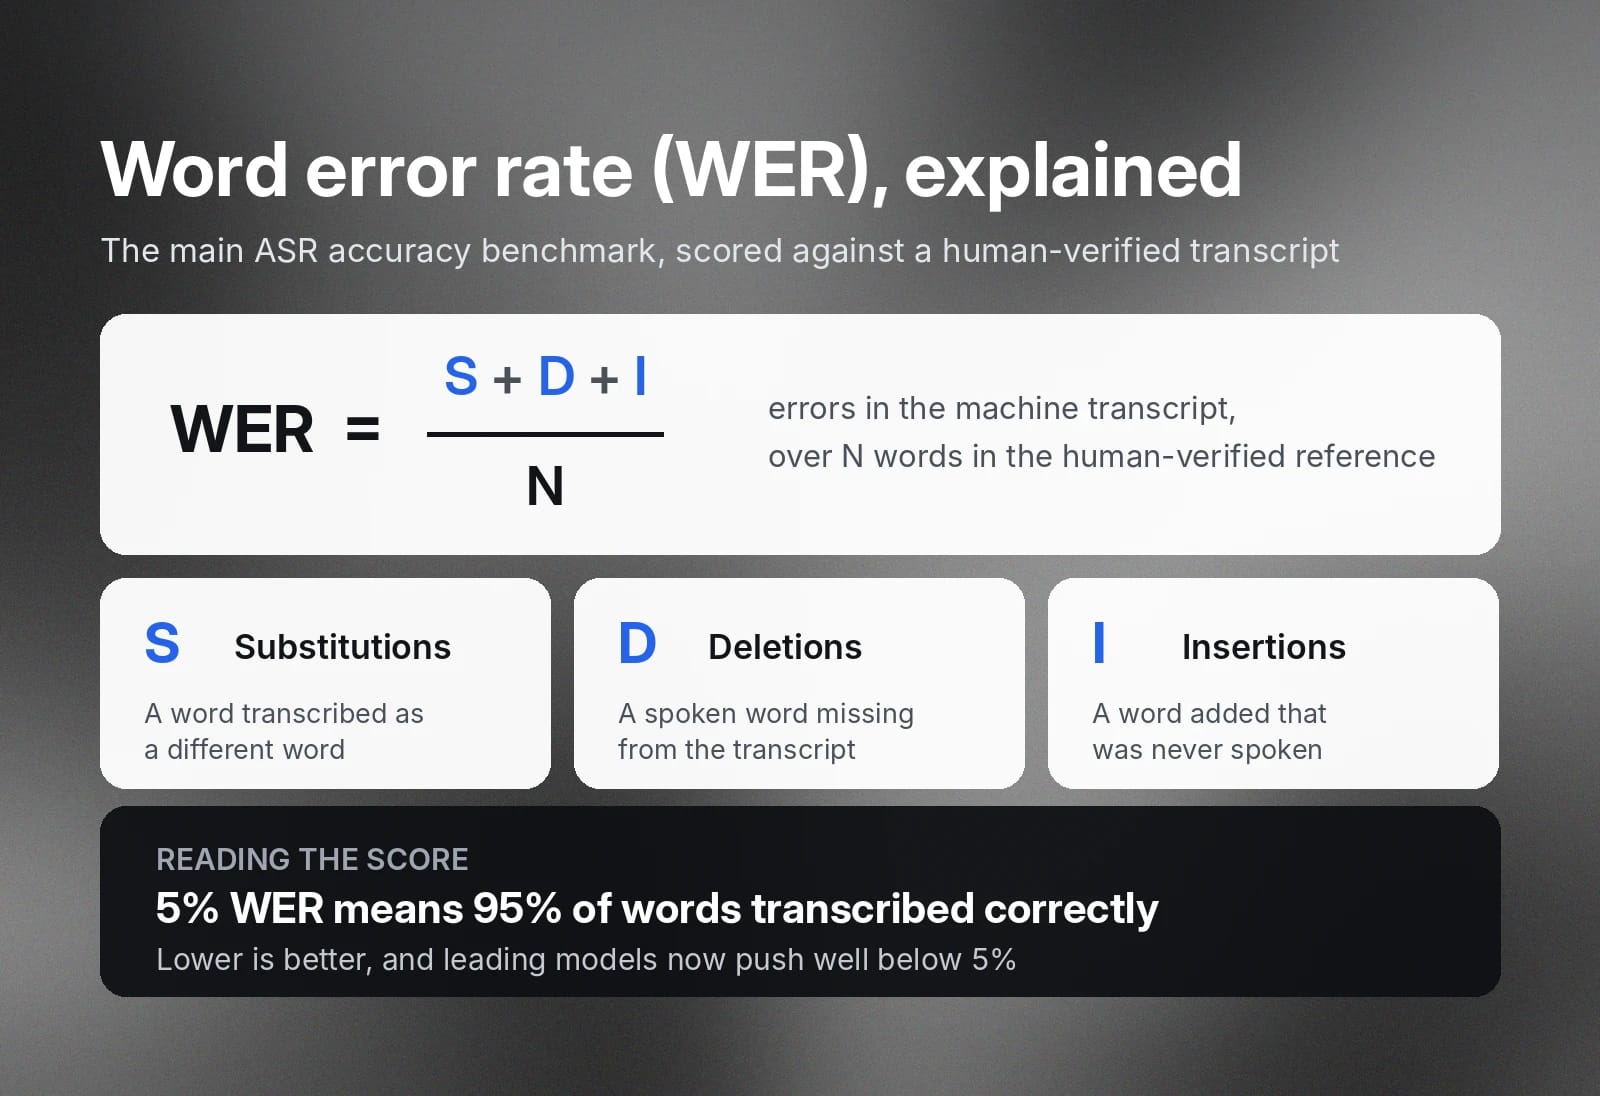
सभी स्पीच टू टेक्स्ट और ASR वर्कफ़्लो में वर्ड एरर रेट (WER) सटीकता का मुख्य मेट्रिक है। यह ASR से बने मशीन ट्रांसक्रिप्ट की तुलना मानव-सत्यापित संस्करण से करता है। इसमें तीन मुख्य तरह की त्रुटियाँ गिनी जाती हैं: प्रतिस्थापन, हटाना और जोड़ना।
WER का फ़ॉर्मूला कुल त्रुटियों को संदर्भ ट्रांसक्रिप्ट में शब्दों की संख्या से विभाजित करता है। 5% WER का अर्थ है कि सिस्टम ने 95% टेक्स्ट सटीक रूप से ट्रांसक्राइब किया। अब अधिकांश अग्रणी मॉडल पूर्णता की ओर बढ़ते हुए 5% से काफ़ी नीचे पहुँच रहे हैं।
हालाँकि WER उपयोगी बेंचमार्क है, ASR टूल की प्रभावशीलता तय करते समय इन बातों पर भी ध्यान देना चाहिए:
- फ़ॉर्मेटिंग की सटीकता: क्या सिस्टम गैर-मानक स्ट्रिंग्स को सही फ़ॉर्मेट कर सकता है? उदाहरण के लिए, क्या $1,225 जैसी राशि ऐसे ही दिखाई जाती है या “एक हज़ार दो सौ पच्चीस डॉलर” के रूप में लिखी जाती है?
- लेटेंसी: सटीकता अहम है, लेकिन अगर एक साधारण ट्रांसक्रिप्ट बनाने में कुछ मिनट लगें, तो टूल बेकार हो जाता है। यह बहुत सटीक हो, तब भी उपयोगिता बढ़ाने के लिए इसे कम लेटेंसी के साथ संतुलन बनाना होगा।
- मज़बूती: यहाँ तक कि तेज़ लहजों या शोर भरे बैकग्राउंड जैसे उपयोग मामलों में भी मॉडल की सटीकता में उल्लेखनीय कमी नहीं आनी चाहिए।
- डायरीकरण की गुणवत्ता: मल्टी-स्पीकर उपयोग मामलों में हर शब्द को सही वक्ता से जोड़ना ज़रूरी है। अलग-अलग वक्ताओं की पहचान और उन्हें सही टैग देना ASR में योगदान करता है, खासकर कानूनी अदालतों जैसे कई वक्ताओं वाले क्षेत्रों में।
और जानकारी के लिए, वर्ड एरर रेट पर हमारी विस्तृत गाइड पढ़ें।
आधुनिक व्यवसायों के लिए ASR के मुख्य फ़ायदे
वैश्विक स्पीच और वॉइस रिकग्निशन बाज़ार के 2030 तक $23.11 बिलियन से अधिक होने की उम्मीद है। बाज़ार की 19.1% CAGR बताती है कि यह तकनीक व्यावसायिक डिवाइसों में कितनी व्यापक हो चुकी है। हर आधुनिक मोबाइल फ़ोन में डिक्टेशन कीबोर्ड और वॉइस असिस्टेंट होता है, अधिकांश नई कारें वॉइस कमांड का जवाब देती हैं और स्मार्ट स्पीकर या असिस्टेंट अब दुनिया भर के घरों में हैं।
आवाज़ के ज़रिए तकनीक से बातचीत अब ग्राहकों के लिए एक सामान्य तरीका है। व्यवसायों के लिए ASR ग्राहक कॉल ट्रांसक्रिप्शन से लेकर वॉइस एजेंट सहायता तक सब कुछ देता है, प्रक्रियाओं में शामिल होकर उत्पादकता बढ़ाता है।
आधुनिक व्यवसायों के लिए ASR के कुछ प्रमुख फ़ायदे ये हैं:
- तेज़ इनपुट और दस्तावेज़ीकरण: 10 साल से भी पहले, Stanford ने एक शोधपत्र प्रकाशित किया था, जिसमें बताया गया कि स्पीच रिकग्निशन तकनीक कीबोर्ड से टाइप करने के मुकाबले लगभग तीन गुना तेज़ थी और इसकी त्रुटि दर भी कम थी। अधिकांश लोगों के लिए ASR ट्रांसक्रिप्शन वर्कफ़्लो और आवाज़ से नोट लेने का दस्तावेज़ीकरण तेज़ बनाएगा।
- कम परिचालन लागत: कई ऐसे उपयोग मामलों में जो पहले घंटों की मैन्युअल नोट-टेकिंग पर निर्भर थे, ASR तकनीक उच्च-गुणवत्ता ट्रांसक्रिप्शन की लागत बहुत कम कर देती है। अदालत के मामले, कॉन्टैक्ट सेंटर, हेल्थकेयर क्लिनिक और व्यावसायिक मीटिंग—सभी में अब सटीक ASR सिस्टम विस्तृत नोट्स और बातचीत के पूर्ण डायरीकृत ट्रांसक्रिप्ट बना सकते हैं।
- बेहतर पहुँच: विश्व स्वास्थ्य संगठन का अनुमान है कि 2.5 बिलियन लोग 2050 तक किसी न किसी प्रकार की सुनने की समस्या के साथ रहेंगे। उन्नत ASR टूल के रियल-टाइम कैप्शन डिजिटल मीटिंग्स और मीडिया को यूज़र्स के लिए सुलभ बना सकते हैं।
- खोजने योग्य वॉइस डेटा: जब आप ASR से आवाज़ को अपने-आप ट्रांसक्राइब करते हैं, तो ग्राहक और व्यवसाय के बीच हर बातचीत पूरी तरह रिकॉर्ड हो जाती है। हर सेल्स कॉल, सपोर्ट टिकट, संभावित ग्राहक की कॉल या मीटिंग खोजने और ऑडिट करने योग्य टेक्स्ट बन जाती है। खासकर AI के दौर में, मशीन-पठनीय फ़ॉर्मेट के लिए संदर्भ उपलब्ध कराना विस्तृत नॉलेज बेस बनाने में मदद कर सकता है। कार्यक्षमता हो या अनुपालन, इससे जानकारी दिखाई देती रहती है।
- हमेशा उपलब्ध ग्राहक अनुभव: ASR वॉइस एजेंट्स की बुनियादी तकनीकों में से एक है और ऐसे ऑटोमेटेड सपोर्ट उपयोग मामलों को सक्षम करता है जो ग्राहक कॉल हल करते हैं 24/7/365।
तकनीक में ऑटोमैटिक स्पीच रिकग्निशन इतना प्रमुख इसलिए है क्योंकि इसे शामिल करने के कई फ़ायदे हैं और यह व्यापक उपयोग मामलों को सपोर्ट करता है। चाहे आप मेडिकल क्षेत्र में हों या सेंटिमेंट एनालिसिस के लिए ग्राहक कॉल ट्रांसक्राइब करना चाहते हों, ASR एक बुनियादी तकनीक है जिसे आप अपनाएँगे और उपयोग करेंगे।
विभिन्न उद्योगों में ASR के लोकप्रिय उपयोग
ऑटोमैटिक स्पीच रिकग्निशन अनगिनत वर्कफ़्लो और प्रोडक्ट्स की केंद्रीय तकनीक है। यह इतना आम हो गया है कि यूज़र्स अक्सर यह भी नहीं सोचते कि यह उनकी इस्तेमाल की जाने वाली तकनीक में कैसे शामिल है।
दुनिया भर में ASR के कुछ लोकप्रिय उपयोग मामलों पर एक नज़र डालते हैं।
ग्राहक सेवा और कॉन्टैक्ट सेंटर
कॉन्टैक्ट सेंटर ASR के शुरुआती उपयोगकर्ताओं में थे। वे गुणवत्ता आश्वासन और अनुपालन के लिए कॉल ट्रांसक्राइब करते थे। आज ASR रियल टाइम में काम कर सकता है, बातचीत के दौरान एजेंट्स को सुझाव दे सकता है और हज़ारों ग्राहक इंटरैक्शन को टीमों के विश्लेषण योग्य डेटा में बदल सकता है।
मीडिया और मनोरंजन
ब्रॉडकास्टर और स्ट्रीमिंग प्लेटफ़ॉर्म ASR का उपयोग करके मानवीय बातचीत के सबटाइटल और कैप्शन उस स्तर पर बना सकते हैं, जिसकी बराबरी मानव ट्रांसक्राइबर नहीं कर सकते। यह रियल-टाइम ट्रांसक्रिप्शन को संभव बनाता है और वीडियो व ऑडियो लाइब्रेरी को पूरी तरह खोजने योग्य भी बनाता है।
हेल्थकेयर
क्लिनिकल स्टाफ अपने दिन का आश्चर्यजनक रूप से बड़ा हिस्सा दस्तावेज़ीकरण और चार्टिंग में लगाता है। ASR यह समय वापस दिलाता है और डॉक्टरों को मेडिकल STT प्लेटफ़ॉर्म देता है, जिसमें वे रियल टाइम में अपने नोट्स डिक्टेट कर सकते हैं।
वर्चुअल मीटिंग्स
मीटिंग प्लेटफ़ॉर्म अक्सर बातचीत के साथ-साथ ट्रांसक्रिप्शन के लिए डिजिटल नोट-टेकिंग देते हैं, ताकि किसी को भाग लेने और नोट्स लेने के बीच चुनना न पड़े। Google Meet जैसी सेवाएँ हर मीटिंग के बाद हाइलाइट किए गए एक्शन आइटम्स के साथ ट्रांसक्रिप्ट भी भेजती हैं, जिससे जानकारी का खोजने योग्य इंडेक्स बनता है।
कानूनी और अनुपालन
कानूनी मामलों में किसने क्या कहा, इसे सटीक रूप से रिकॉर्ड करना अदालत की मुख्य आवश्यकता है। कानूनी फ़र्म भविष्य के संदर्भ के लिए सटीक टाइमस्टैम्प के साथ अपनी मीटिंग्स, सुनवाई, क्लाइंट कॉल और कोर्ट सेशन ट्रांसक्राइब करने हेतु ASR प्लेटफ़ॉर्म इस्तेमाल करेंगी।
शिक्षा
विश्वविद्यालय के प्रोफ़ेसर छात्रों को उनकी अटेंड की गई कक्षाओं का रिकॉर्ड बनाने में मदद के लिए अपने लेक्चर का रिकॉर्डेड ट्रांसक्रिप्ट दे सकते हैं। जानकारी समझने और याद रखने के लिए छात्रों के पास शुरुआत करने हेतु एक व्यापक संसाधन होगा।
वॉइस एजेंट पाइपलाइन में ASR की भूमिका
ASR कई तरह के टेक डिप्लॉयमेंट का मानक हिस्सा है। वॉइस एजेंट तकनीक में, यह लगातार चलने वाले तीन व्यापक चरणों में पहला है।
- सुनें (ASR): एजेंट आने वाली ऑडियो स्ट्रीम कैप्चर करता है और आवाज़ को रियल टाइम में टेक्स्ट में बदलता है। आधुनिक ASR ऑडियो आने के साथ ही उसे लगातार प्रोसेस करता है, बैकग्राउंड शोर हटाता है, रुकावटें संभालता है, आंशिक ट्रांसक्रिप्ट बनाता है और पहचानता है कि हर व्यक्ति कब बोल रहा है।
- सोचें (लैंग्वेज मॉडल): एक बड़ा लैंग्वेज मॉडल ट्रांसक्रिप्ट की व्याख्या करता है, यूज़र के इरादे को समझता है, जुड़े हुए टूल और नॉलेज बेस से जानकारी लेता है, बातचीत का संदर्भ बनाए रखता है और सबसे उपयुक्त जवाब या कार्रवाई तय करता है।
- बोलें (टेक्स्ट टू स्पीच): एक टेक्स्ट टू स्पीच मॉडल जनरेट किए गए LLM जवाब को प्राकृतिक, भावपूर्ण ऑडियो में बदलता है। आधुनिक TTS सिस्टम कॉलर को ऑडियो स्ट्रीम करते समय गति, स्वराघात, भाव और ज़ोर को समायोजित कर सकते हैं; उन्हें पूरे जवाब का इंतज़ार नहीं करना पड़ता।
कन्वर्सेशनल लेटेंसी इन सभी चरणों में जुड़ती जाती है। लेटेंसी कम करने के लिए स्ट्रीमिंग ASR किसी कथन के पूरा होने का इंतज़ार करने के बजाय शब्द बोलते ही उन्हें आउटपुट करना शुरू कर देता है। ElevenAgents रियल-टाइम वॉइस एजेंट्स के लिए इसे मानक रूप में उपयोग करता है, जिससे एक कुशल एजेंट अनुभव बनता है।
ASR की चुनौतियाँ और तकनीक का विकास
1952 में अपनी शुरुआत के बाद से ASR तकनीक बहुत आगे आई है, लेकिन सटीकता कम करने वाली कई चुनौतियाँ अब भी मौजूद हैं।
आज भी ASR टूल को इन समस्याओं का सामना करना पड़ता है:
- लहजे और बोलियाँ: उपलब्ध प्रशिक्षण डेटा आमतौर पर कुछ भाषाओं और लहजों तक सीमित होता है, जिससे कम प्रचलित लहजों या कम लोगों द्वारा बोली जाने वाली भाषाओं को ASR टूल के लिए संभालना मुश्किल होता है। इसका समाधान समृद्ध और विविध प्रशिक्षण डेटासेट हैं।
- बैकग्राउंड शोर और एक साथ बोलने वाले वक्ता:अलग-अलग वॉल्यूम या तेज़ बैकग्राउंड शोर वाले माहौल में रिकॉर्डिंग के अलग-अलग शब्दों को पहचानना कठिन होता है। एक साथ बोलने वाले वक्ताओं का असर भी ऐसा ही हो सकता है और ASR ट्रांसक्रिप्शन की सटीकता कम हो सकती है।
- क्षेत्र-विशिष्ट शब्दावली: विशेष शब्दजाल या संक्षिप्तियों वाले क्षेत्रों में सटीकता बढ़ाने के लिए क्षेत्र-स्तर के शब्दकोश और संदर्भों की ज़रूरत होगी। चिकित्सा और कानून ऐसे दो क्षेत्र हैं जहाँ ASR टूल को अतिरिक्त सहायता या विशेष प्रशिक्षण की आवश्यकता होगी।
- गोपनीयता और सुरक्षा: कई न्यायक्षेत्रों में वॉइस डेटा को व्यक्तिगत डेटा माना जाता है। एंटरप्राइज़ को वॉइस डेटा की हैंडलिंग सुरक्षित रखने और व्यापक नियमों का अनुपालन सुनिश्चित करने के लिए स्पष्ट रिटेंशन नीतियाँ और सुरक्षा उपाय चाहिए।
ASR तकनीक के साथ काम करते समय लेटेंसी और सटीकता के बीच संतुलन एक व्यापक विचार है। कुछ उपयोग मामलों में दोनों के बीच संतुलन ज़रूरी है, जबकि चिकित्सा जैसे क्षेत्र संभवतः सटीकता को सबसे ऊपर रखेंगे।
प्रोडक्शन-ग्रेड ASR इंटीग्रेशन के लिए ElevenAPI से शुरुआत करें
ElevenAPI Scribe v2, ElevenLabs के स्पीच टू टेक्स्ट मॉडल, के ज़रिए आपके प्रोडक्ट में प्रोडक्शन-ग्रेड ऑटोमैटिक स्पीच रिकग्निशन लाता है। Scribe v2 शब्द-स्तर के टाइमस्टैम्प, स्पीकर डायरीकरण, ऑडियो इवेंट टैगिंग और रियल-टाइम ऐप्लिकेशन के लिए ज़रूरी सटीकता व विश्वसनीयता देता है।
और जानकारी के लिए ElevenLabs स्पीच टू टेक्स्ट पेज देखें या मुफ़्त अकाउंट बनाएं और मिनटों में API चालू करें।
ASR के बारे में अक्सर पूछे जाने वाले सवाल

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।