रियल-टाइम बनाम बैच ट्रांसक्रिप्शन: मुख्य अंतर
- लेखक
- Jack Limebear
- प्रकाशित
सुनेंइस आर्टिकल को सुनें
AI-संचालित ट्रांसक्रिप्शन मॉडल चुनते समय आपके पास दो विकल्प होते हैं: रियल-टाइम या बैच ट्रांसक्रिप्शन। दोनों स्पीच को टेक्स्ट में बदलते हैं, लेकिन उनका तरीका अलग होता है।
रियल-टाइम ट्रांसक्रिप्शन ऑडियो को चलते समय प्रोसेस करता है, जबकि बैच ट्रांसक्रिप्शन रिकॉर्डिंग पूरी होने के बाद पूरी ऑडियो रिकॉर्डिंग को प्रोसेस करता है। रियल-टाइम ट्रांसक्रिप्शन तुरंत नतीजे देता है, लेकिन बैच ट्रांसक्रिप्शन अक्सर ज़्यादा सटीक होता है।
इस गाइड में हम रियल-टाइम और बैच ट्रांसक्रिप्शन की तुलना करेंगे, ताकि आप अपने अगले प्रोजेक्ट के लिए सही मॉडल चुन सकें। हम बताएंगे कि हर मॉडल कैसे काम करता है, उसके फ़ायदे-नुकसान क्या हैं और उसके आम इस्तेमाल क्या हैं।
सारांश
- रियल-टाइम ट्रांसक्रिप्शन ऑडियो को चलते समय प्रोसेस करता है।
- बैच ट्रांसक्रिप्शन पूरी ऑडियो फ़ाइल को एक साथ प्रोसेस करता है।
- रियल-टाइम ट्रांसक्रिप्शन तेज़ होता है, लेकिन बैच ट्रांसक्रिप्शन ज़्यादा सटीक होता है क्योंकि मॉडल को पूरी ऑडियो फ़ाइल का द्विदिश संदर्भ मिलता है।
- रियल-टाइम ट्रांसक्रिप्शन लाइव वॉइस एजेंट्स, लाइव वीडियो कैप्शन या मीटिंग नोट्स जैसे ऐप्लिकेशन के लिए सबसे अच्छा है, जहां सटीकता से ज़्यादा गति अहम होती है।
- रिकॉर्डिंग के बाद बड़ी मात्रा में ऑडियो ट्रांसक्राइब करने के लिए बैच ट्रांसक्रिप्शन ज़्यादा सटीक और किफ़ायती होता है।
STT में रियल-टाइम ट्रांसक्रिप्शन क्या है?
रियल-टाइम ट्रांसक्रिप्शन में स्पीच-टू-टेक्स्ट (STT) मॉडल ऑडियो को चलते समय लिखित टेक्स्ट में बदलता है। इसे कभी-कभी स्ट्रीमिंग ट्रांसक्रिप्शन भी कहा जाता है।
रियल-टाइम ट्रांसक्रिप्शन में STT मॉडल ऑडियो को छोटे-छोटे हिस्सों में प्रोसेस करता है। शब्द बोले जाने के कुछ मिलीसेकंड बाद ही लिखित टेक्स्ट उपलब्ध हो जाता है। बातचीत आगे बढ़ने पर STT मॉडल को ज़्यादा डेटा और संदर्भ मिलता है, जिसका इस्तेमाल वह ट्रांसक्रिप्ट को बेहतर बनाने के लिए करता है।
ट्रांसक्रिप्शन का यह रूप उन स्थितियों में सबसे अच्छा काम करता है जहां सटीकता से ज़्यादा गति अहम हो। उदाहरण के लिए, ये मॉडल रियल-टाइम कैप्शन के साथ ऑडियो और वीडियो स्ट्रीम को ज़्यादा सुलभ बनाते हैं। रियल-टाइम नोट-टेकिंग प्लेटफ़ॉर्म भी इसका एक आम इस्तेमाल हैं।
STT में बैच ट्रांसक्रिप्शन क्या है?
बैच ट्रांसक्रिप्शन रिकॉर्डिंग खत्म होने के बाद, पूरी ऑडियो रिकॉर्डिंग को एक साथ स्पीच से टेक्स्ट में बदलता है। रिकॉर्डिंग की लंबाई और जटिलता के आधार पर इसमें कुछ सेकंड से लेकर 10 मिनट से ज़्यादा समय लग सकता है।
बैच ट्रांसक्रिप्शन मॉडल काम करते समय पूरी रिकॉर्डिंग के संदर्भ का उपयोग करते हैं। पूरा संदर्भ मॉडल को जटिल भाषा, बैकग्राउंड नॉइज़ या रुकावटों वाले हिस्सों को सही ढंग से समझने में मदद करता है। बैच ट्रांसक्रिप्शन मॉडल विराम-चिह्न और फ़ॉर्मैटिंग भी जोड़ते हैं, जिनमें कुछ रियल-टाइम मॉडल को दिक्कत हो सकती है।
बैच ट्रांसक्रिप्शन उन स्थितियों में सबसे अच्छा काम करता है जहां सटीकता सबसे अहम हो। कई संगठन अपने आर्काइव के लिए लंबे इंटरव्यू, मीटिंग या पॉडकास्ट ट्रांसक्राइब करने हेतु बैच मॉडल का इस्तेमाल करते हैं।
बैच और स्ट्रीमिंग आर्किटेक्चर ट्रांसक्रिप्शन को कैसे आकार देते हैं
ट्रांसक्रिप्शन के लिए बैच और स्ट्रीम प्रोसेसिंग की तुलना करने पर, दोनों मॉडल बुनियादी रूप से अलग प्रक्रियाओं का उपयोग करते हैं, जो अंतिम आउटपुट को प्रभावित करती हैं।
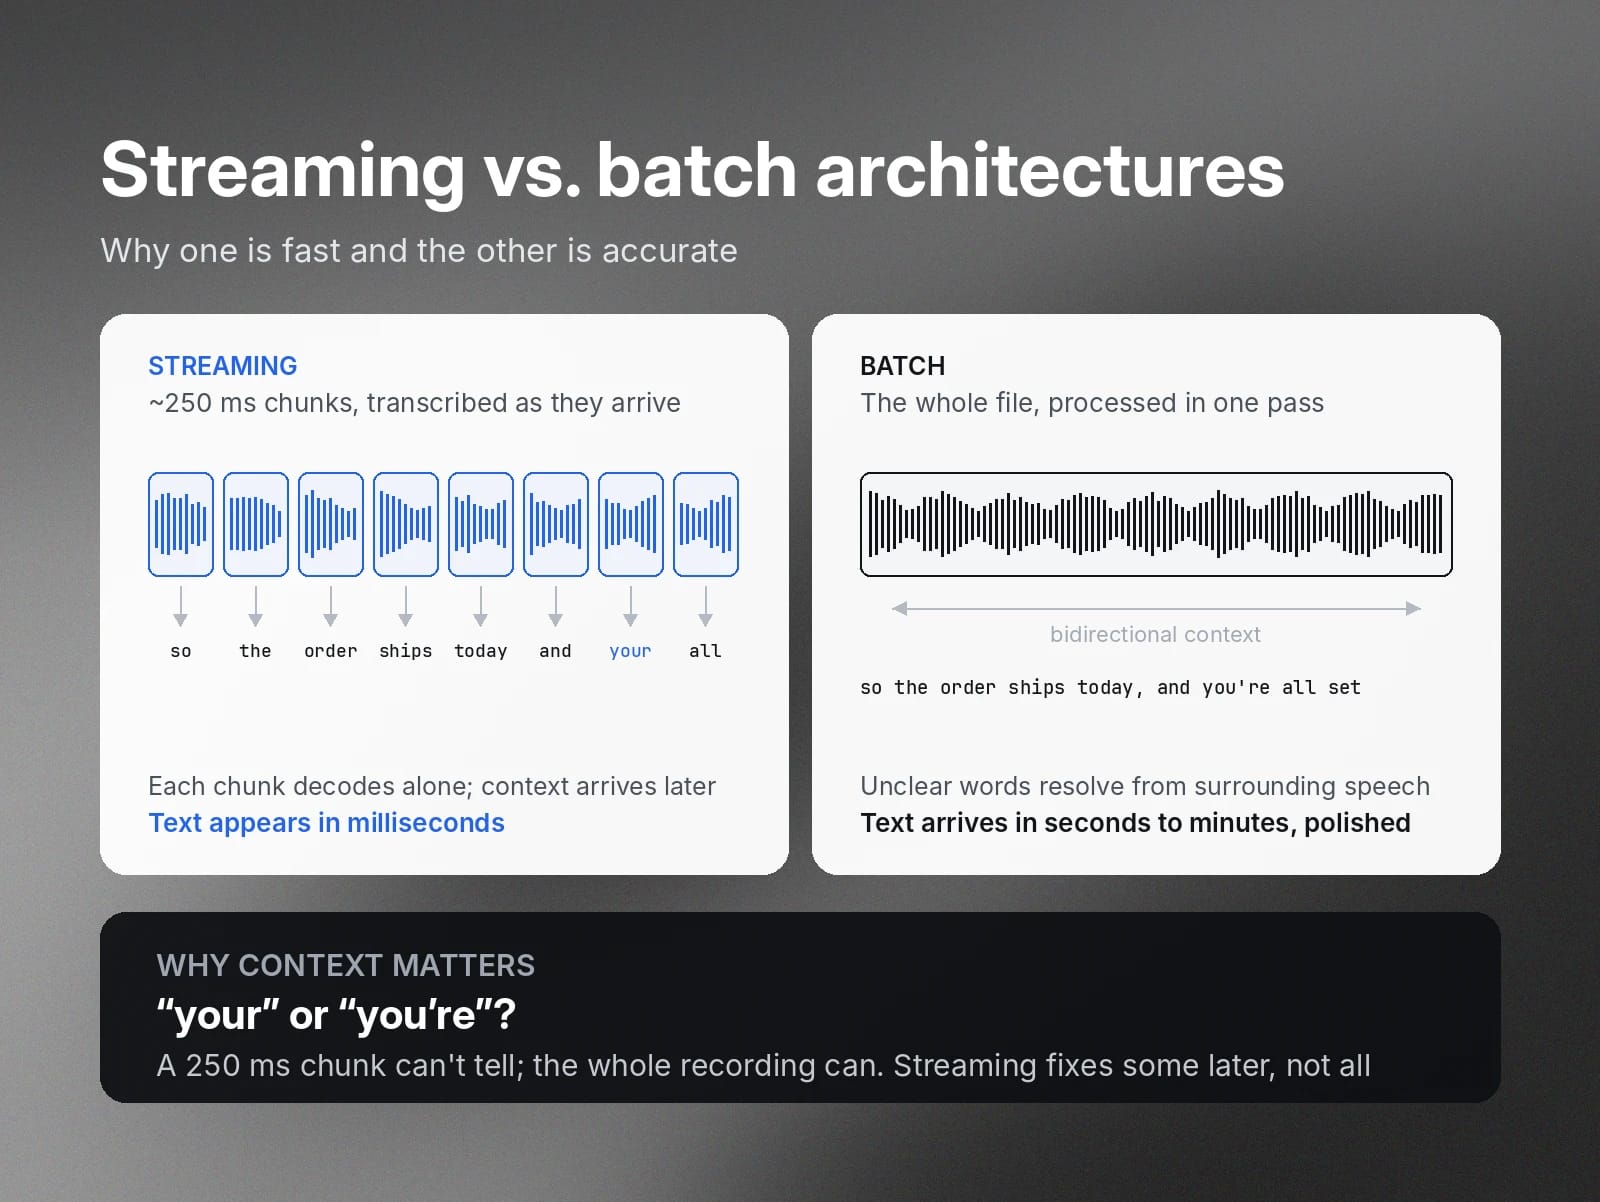
स्ट्रीमिंग ट्रांसक्रिप्शन मॉडल ऑडियो को हिस्सों में बांटते हैं और हर हिस्से को चलते समय ट्रांसक्राइब करते हैं। ये हिस्से बहुत छोटे होते हैं, आमतौर पर लगभग 250 मिलीसेकंड या उससे कम। इस फ़ॉर्मैट में ऑडियो प्रोसेस करने से ट्रांसक्रिप्शन मॉडल तेज़ी से काम कर पाता है और ऑडियो होने के कुछ सेकंड बाद टेक्स्ट दिखने लगता है।
चूंकि ये ऑडियो हिस्से बहुत छोटे होते हैं, इसलिए स्पीच टू टेक्स्ट मॉडल को बातचीत का पूरा संदर्भ नहीं मिलता, जिससे गलतियां हो सकती हैं। उदाहरण के लिए, ट्रांसक्रिप्शन मॉडल 'you're' की जगह 'your' लिख सकता है।
बातचीत जारी रहने और संदर्भ स्पष्ट होने पर रियल-टाइम ट्रांसक्रिप्शन मॉडल इनमें से कुछ गलतियां सुधार देता है। हालांकि, आमतौर पर हर गलती सुधारने के लिए पर्याप्त समय या संदर्भ नहीं होता, इसलिए अंतिम ट्रांसक्रिप्ट हमेशा 100% सटीक नहीं होता।
दूसरी ओर, बैच ट्रांसक्रिप्शन मॉडल पूरी ऑडियो फ़ाइल को एक बार में प्रोसेस करते हैं। यानी ट्रांसक्रिप्शन मॉडल के पास बातचीत का द्विदिश संदर्भ होता है, जिससे वह अस्पष्ट शब्दों या वाक्यांशों को समझता है। ऑडियो फ़ाइल में कुछ अस्पष्ट होने पर मॉडल उससे पहले और बाद के शब्दों का विश्लेषण करता है, ताकि यह तय कर सके कि क्या कहा गया था और उसे सटीक रूप से ट्रांसक्राइब कर सके।
इस अतिरिक्त संदर्भ के कारण बैच ट्रांसक्रिप्शन मॉडल रियल-टाइम ट्रांसक्रिप्शन मॉडल से धीमे होते हैं। हालांकि, अंतिम परिणाम कहीं ज़्यादा सटीक और बेहतर ढंग से तैयार होता है।
रियल-टाइम बनाम बैच ट्रांसक्रिप्शन मॉडल की मुख्य विशेषताएं: लेटेंसी, सटीकता और लागत
रियल-टाइम और बैच, दोनों मॉडल ट्रांसक्रिप्शन के लिए प्रभावी हैं: यह पूरी तरह आपके प्रोजेक्ट के प्रकार पर निर्भर करता है। कुछ प्रोजेक्ट को तुरंत नतीजे चाहिए, जबकि कुछ को उच्च सटीकता दर चाहिए।
रियल-टाइम और बैच ट्रांसक्रिप्शन में से चुनते समय इन बातों पर विचार करें:
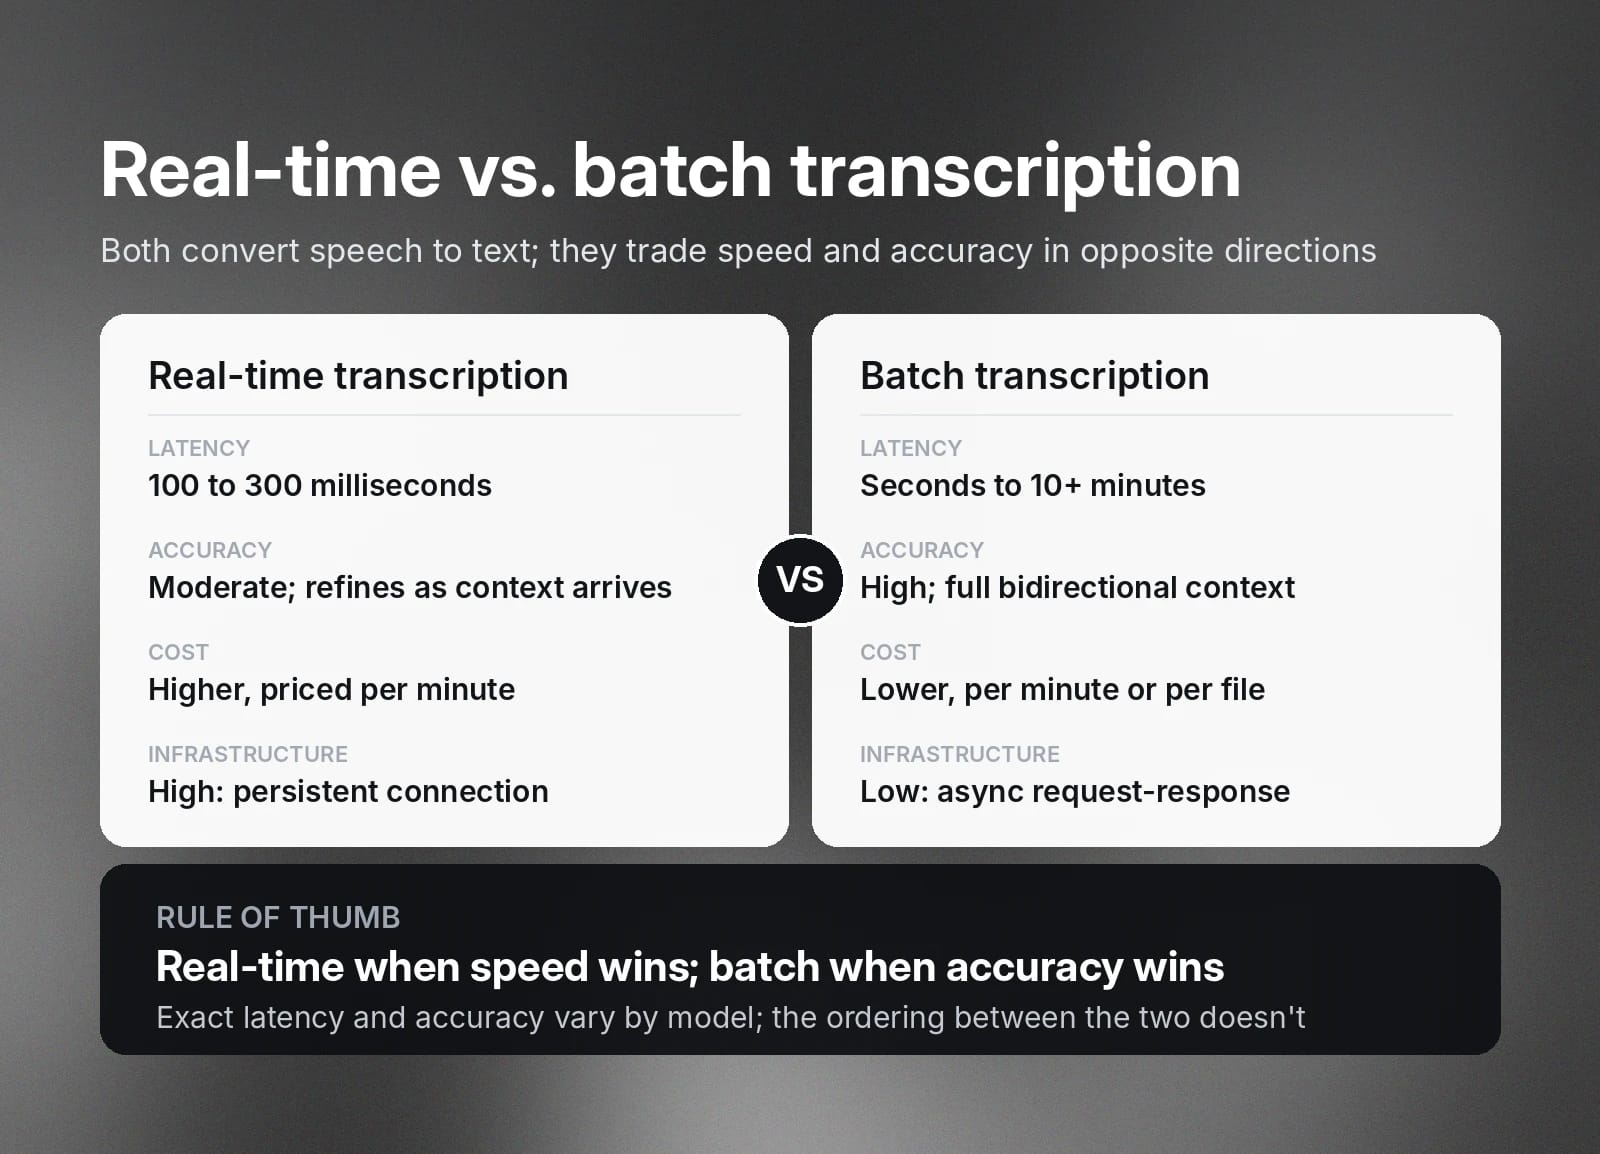
रियल-टाइम ट्रांसक्रिप्शन | बैच ट्रांसक्रिप्शन | |
लेटेंसी | 100 से 300 मिलीसेकंड | फ़ाइल की लंबाई के आधार पर, कुछ सेकंड से 10+ मिनट तक |
सटीकता | मध्यम | उच्च |
लागत | अधिक, प्रति मिनट कीमत | मध्यम, प्रति मिनट या प्रति फ़ाइल कीमत |
इन्फ़्रास्ट्रक्चर की जटिलता | अधिक, लगातार कनेक्शन और लोड बैलेंसिंग की ज़रूरत | कम, असिंक्रोनस रिक्वेस्ट-रिस्पॉन्स संरचना का उपयोग |
सटीक लेटेंसी और सटीकता दरें आपके इस्तेमाल किए जा रहे खास ट्रांसक्रिप्शन मॉडल पर निर्भर करती हैं। हालांकि, रियल-टाइम ट्रांसक्रिप्शन लगातार तेज़ होता है, जबकि बैच ट्रांसक्रिप्शन ज़्यादा सटीक होता है।
रियल-टाइम ट्रांसक्रिप्शन की लागत बैच ट्रांसक्रिप्शन से ज़्यादा होती है क्योंकि इसमें अधिक जटिल इन्फ़्रास्ट्रक्चर और अधिक ऑपरेशनल ओवरहेड लगता है। अपनी गति बनाए रखने के लिए रियल-टाइम मॉडल को लगातार कनेक्शन चाहिए, और इन्हें सेट अप व मेंटेन करने में बैच मॉडल की तुलना में अधिक समय लगता है।
लाइव बातचीत के दौरान सुलभता के लिए रियल-टाइम मॉडल में निवेश करना उचित है। हालांकि, जिन प्रोजेक्ट में गति प्राथमिकता नहीं है, वहां बैच ट्रांसक्रिप्शन इस्तेमाल करने से पैसे और सेटअप समय दोनों बचते हैं।
रियल-टाइम बनाम बैच ट्रांसक्रिप्शन API तुलना: अपने प्रोजेक्ट के लिए सबसे सही विकल्प चुनें
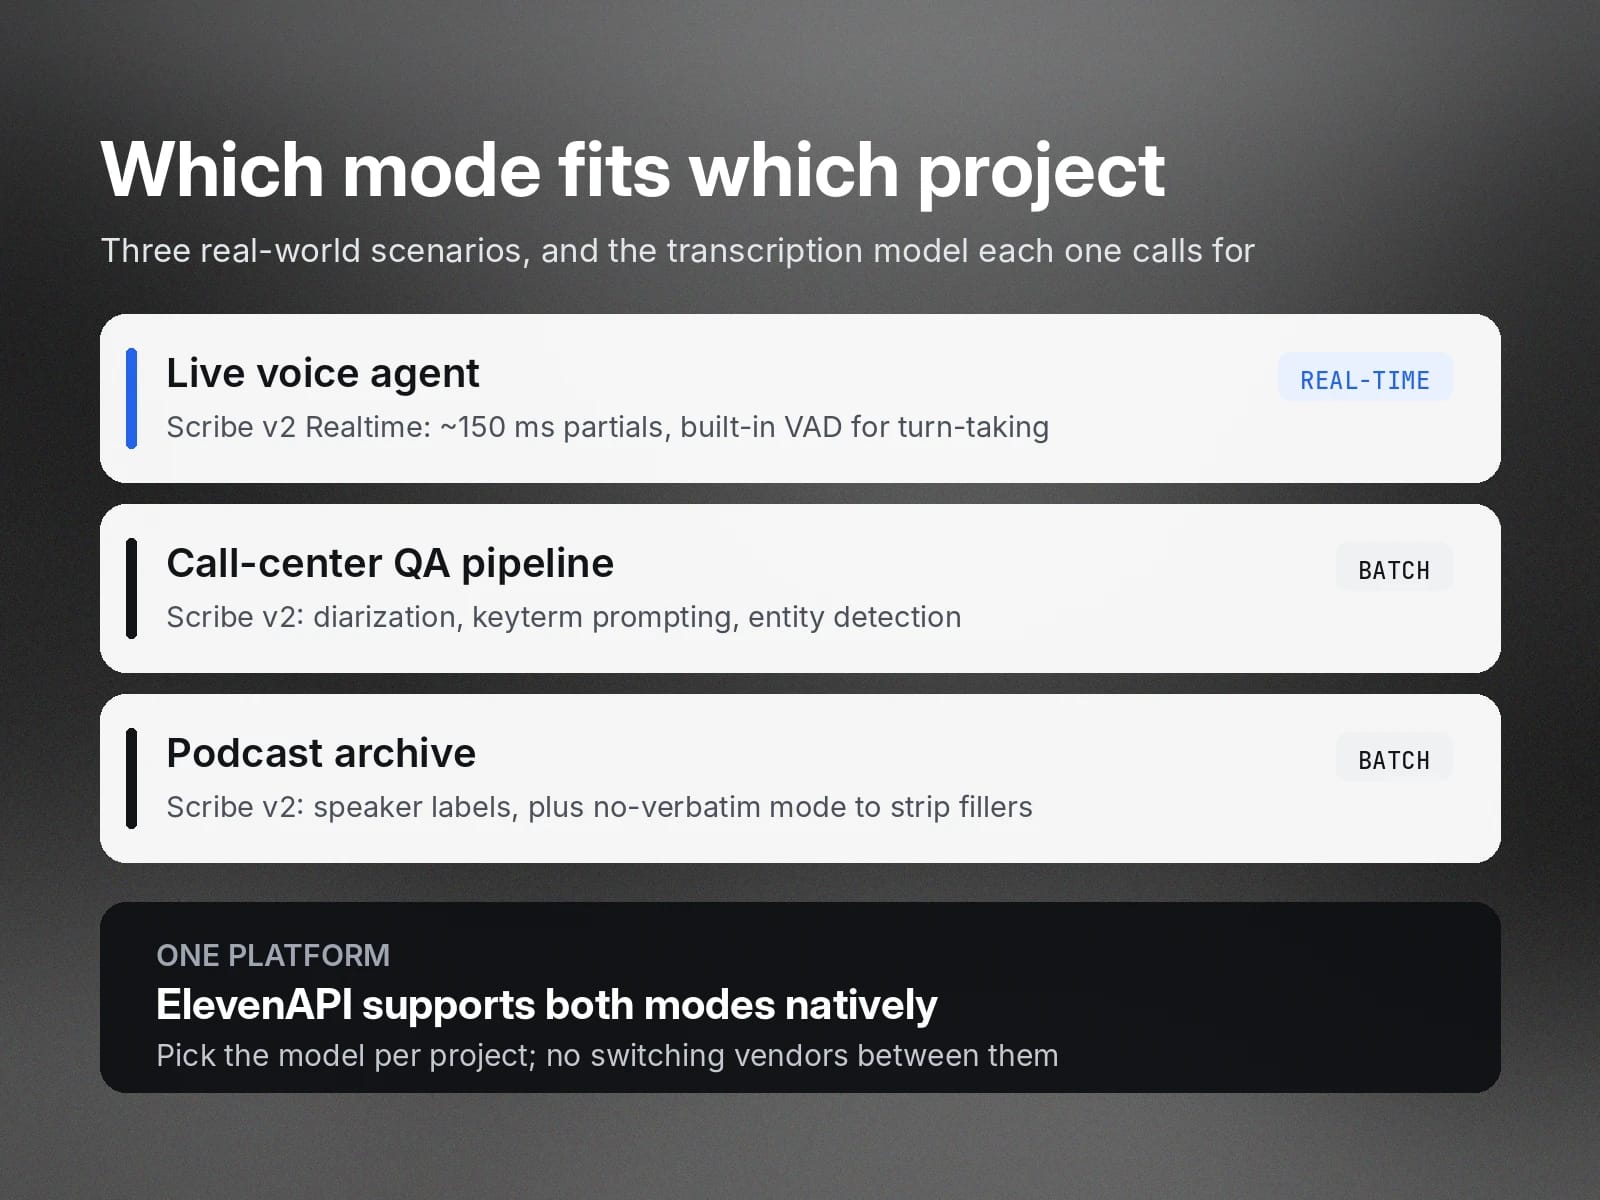
नया ट्रांसक्रिप्शन प्रोजेक्ट शुरू करने से पहले, आपको बैच और रियल-टाइम मॉडल के फ़ायदे-नुकसान परखने होंगे, ताकि पता चल सके कि आपके लक्ष्यों के लिए कौन-सा सबसे सही है। तीन वास्तविक स्थितियों में यह निर्णय प्रक्रिया कुछ ऐसी दिखती है।
लाइव वॉइस एजेंट: रियल-टाइम ट्रांसक्रिप्शन
लाइव कन्वर्सेशनल AI मॉडल को सुलभता के लिए लगभग तुरंत ट्रांसक्रिप्शन चाहिए, खासकर जटिल ऑपरेशनल या कस्टमर सर्विस चुनौतियों को संभालते समय।
रियल-टाइम मॉडल, जैसे Scribe v2 Realtime, सहज और स्वाभाविक बातचीत के लिए ज़रूरी कम लेटेंसी देता है। Scribe v2 Realtime लगभग 150 मिलीसेकंड में आंशिक ट्रांसक्रिप्शन देता है।
लाइव वॉइस एजेंट्स के लिए ट्रांसक्रिप्शन मॉडल को सटीक टर्न-टेकिंग भी चाहिए। यानी उन्हें यह पहचानने में सक्षम होना चाहिए कि यूज़र ने बोलना कब शुरू या खत्म किया और तुरंत जवाब देना चाहिए। प्रभावी टर्न-टेकिंग और रुकावट प्रबंधन ट्रांसक्रिप्ट को बातचीत से पीछे रहने से बचाता है।
रियल-टाइम ट्रांसक्रिप्शन मॉडल तेज़ नतीजों के लिए सटीक टर्न-टेकिंग को प्राथमिकता देते हैं। उदाहरण के लिए, Scribe v2 Realtime में इन-बिल्ट वॉइस एक्टिविटी डिटेक्शन है, इसलिए स्पीकर्स के बीच खामोशी पहचानने पर यह ट्रांसक्रिप्ट को अपने-आप विभाजित कर देता है।
कॉल सेंटर QA पाइपलाइन: बैच ट्रांसक्रिप्शन
क्वालिटी एश्योरेंस करते समय सटीकता अहम होती है, इसलिए इस स्थिति में Scribe v2 जैसा बैच ट्रांसक्रिप्शन मॉडल सबसे उपयुक्त है।
कॉल सेंटर ट्रांसक्रिप्शन में अक्सर विशिष्ट नाम और उद्योग से जुड़ी जानकारी होती है। अगर इन्हें सही ट्रांसक्राइब न किया जाए, तो विश्लेषकों के लिए यह तय करना मुश्किल होता है कि कॉल वास्तव में सफल रही या नहीं। चूंकि बैच मॉडल पूरी रिकॉर्डिंग को एक साथ प्रोसेस करते हैं, इसलिए उनके पास सटीक ट्रांसक्रिप्शन और फ़ॉर्मैटिंग के लिए ज़रूरी संदर्भ होता है।
Scribe v2 में ट्रांसक्रिप्शन की सटीकता बढ़ाने के लिए कई सुविधाएं हैं। स्पीकर डायराइज़ेशन यह सुनिश्चित करता है कि क्रॉस-टॉक होने पर भी एजेंट्स और ग्राहकों को हमेशा सही लेबल मिले। कीटर्म प्रॉम्प्टिंग मॉडल को पहले से ब्रांड नाम और उद्योग के शब्द देता है, ताकि वे सटीक रूप से ट्रांसक्राइब हों।
कॉल सेंटर ट्रांसक्रिप्ट में सोशल सिक्योरिटी नंबर और क्रेडिट कार्ड नंबर जैसी संवेदनशील जानकारी भी हो सकती है, जिसे हटाना ज़रूरी है। Scribe v2 में ऐसी संवेदनशील जानकारियां ढूंढने और उन पर टाइम-स्टैंप लगाने के लिए एंटिटी डिटेक्शन है, ताकि आप उन्हें हटा सकें।
पॉडकास्ट आर्काइव: बैच ट्रांसक्रिप्शन
पॉडकास्ट आर्काइव बनाते समय आपकी टीम और ऑडियंस को कभी भी देखने के लिए बेहतर ढंग से तैयार ट्रांसक्रिप्शन चाहिए। यहां सटीकता और साफ़ फ़ॉर्मैटिंग ज़रूरी हैं, इसलिए बैच ट्रांसक्रिप्शन सही विकल्प है।
बैच ट्रांसक्रिप्शन के साथ आपको अपनी सभी पॉडकास्ट फ़ाइलों के लिए स्पीकर लेबलिंग और डायराइज़ेशन सहित सटीक ट्रांसक्रिप्शन मिलता है। Scribe v2 में नो-वर्बेटिम मोड भी है, जो फ़िलर शब्द, हकलाहट और दोहराव को अपने-आप हटा देता है। इससे आपको मैन्युअल एडिटिंग में कम समय लगेगा और आप अपना पॉडकास्ट आर्काइव तेज़ी से बना सकेंगे।
ElevenAPI मूल रूप से रियल-टाइम और बैच, दोनों मोड सपोर्ट करता है। अगर आप एक साथ कई ट्रांसक्रिप्शन प्रोजेक्ट चला रहे हैं, तो आप उन सभी को एक ही प्लेटफ़ॉर्म पर मैनेज करने के लिए ElevenAPI इस्तेमाल कर सकते हैं। हर प्रोजेक्ट के लिए बस सही मॉडल चुनें, बिना अलग-अलग सर्विस प्रोवाइडर्स के बीच बार-बार स्विच करने की परेशानी के।
हाइब्रिड ट्रांसक्रिप्शन मॉडल: रियल-टाइम और बैच के बीच सेतु
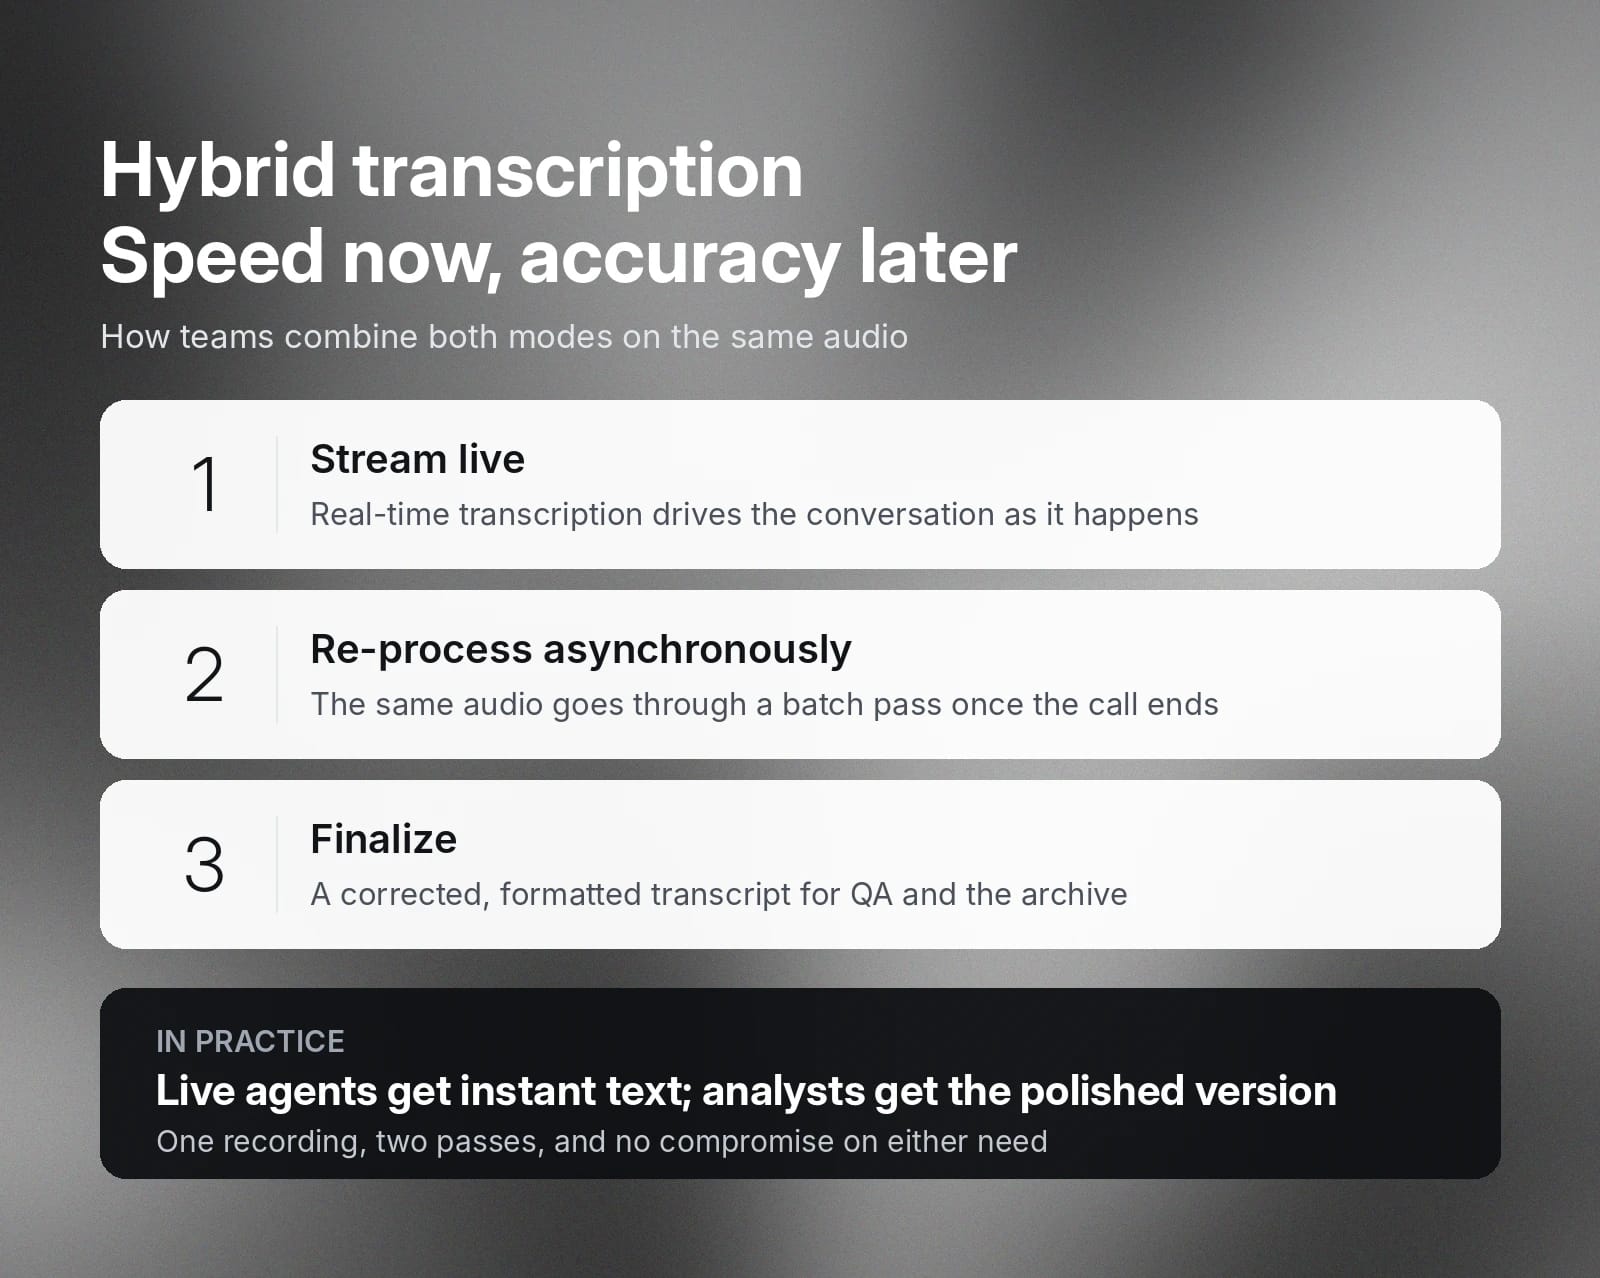
हाइब्रिड ट्रांसक्रिप्शन आर्किटेक्चर गति और सटीकता के संतुलन के लिए रियल-टाइम और बैच मॉडल को मिलाते हैं।
उदाहरण के लिए, कस्टमर सर्विस टीम लाइव बातचीत के दौरान तुरंत आउटपुट देने के लिए हाइब्रिड मॉडल इस्तेमाल कर सकती है, फिर क्वालिटी एश्योरेंस और आर्काइविंग के लिए ट्रांसक्रिप्ट को बेहतर बना सकती है। लाइव एजेंट्स रियल-टाइम ट्रांसक्रिप्शन इस्तेमाल करते हैं, फिर शुरुआती ट्रांसक्रिप्ट को असिंक्रोनस रीप्रोसेसिंग के लिए बैच मॉडल में भेजते हैं।
यह प्रक्रिया इस तरह काम करती है:
लचीले ट्रांसक्रिप्शन समाधानों के लिए ElevenAPI से शुरुआत करें
ElevenAPI 90 से ज़्यादा भाषाओं में तेज़ और सटीक ट्रांसक्रिप्शन के लिए रियल-टाइम और बैच, दोनों मॉडल देता है। ElevenAPI के उद्योग-अग्रणी ट्रांसक्रिप्शन मॉडल कम-गुणवत्ता वाले ऑडियो, बैकग्राउंड नॉइज़ या तेज़ एक्सेंट के साथ भी सटीक नतीजे देते हैं।
ElevenAPI 90+ भाषाओं के लिए तेज़ और सटीक ट्रांसक्रिप्शन देने वाले रियल-टाइम और बैच, दोनों मॉडल देता है। Scribe v2 उद्योग-अग्रणी ट्रांसक्रिप्शन सटीकता देता है और Scribe v2 Realtime लाइव उपयोग के मामलों में असाधारण सटीकता देता है। दोनों कम-गुणवत्ता वाले ऑडियो, बैकग्राउंड नॉइज़ या तेज़ एक्सेंट के साथ भी भरोसेमंद नतीजे देते हैं।
आपकी ज़रूरतों के अनुरूप ट्रांसक्रिप्शन आर्किटेक्चर बनाने में मदद के लिए दोनों मॉडल एक ही सुविधाजनक प्लेटफ़ॉर्म पर उपलब्ध हैं। इसे काम करते हुए देखने के लिए ElevenLabs स्पीच टू टेक्स्ट API देखें या API key बनाएं और शुरुआत करें।



