
इंटरैक्शन मॉडल्स: नेचुरल ह्यूमन-AI डायलॉग बनाना
- लेखक
- Jack Limebear
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
जिस किसी ने किसी AI वॉइस एजेंट को वाक्य के बीच में रोकने की कोशिश की है, वह जानता है कि जब कोई सिस्टम मानवीय बातचीत के लिए बना न हो, तो कैसा लगता है। लय गलत होती है, आवाज़ कंटेंट से अलग लगती है और जानकारी सही होने पर भी बातचीत अटपटी लगती है: जैसे किसी जानकार व्यक्ति से बात नहीं, बल्कि ऐसे सॉफ़्टवेयर को चलाना जो बस शब्दों का इस्तेमाल करता है।
इस अप्राकृतिक अनुभव की वजह संरचनात्मक है। कई वॉइस AI सिस्टम असली बातचीत के प्रवाह के बजाय बारी-बारी से होने वाले संवाद को संभालने के लिए बनाए गए थे। वे एक बार में एक आदान-प्रदान को सुनते, प्रोसेस करते और जवाब देते हैं। यह साधारण डेमो के लिए काम करता है, लेकिन बातचीत के भावनात्मक और अप्रत्याशित होने पर यह तरीका काम नहीं करता।
इंटरैक्शन मॉडल ऐसे AI सिस्टम हैं जो रियल टाइम में ऑडियो और टेक्स्ट के ज़रिए संवाद के लिए बनाए गए हैं। वे सिर्फ़ यह नहीं समझते कि क्या कहा गया, बल्कि यह भी कि कब कहा गया और उस पल किस तरह की भावनात्मक प्रतिक्रिया चाहिए। यह लेख बताता है कि इंटरैक्शन मॉडल को अलग क्या बनाता है, वॉइस AI इस्तेमाल करने वाले व्यवसायों के लिए यह क्यों अहम है और ElevenLabs इसे कैसे बना रहा है।
सारांश
- ज़्यादातर वॉइस AI असली बातचीत में विफल हो जाते हैं, क्योंकि वे रुकावट, चुप्पी या अलग-अलग टर्न में बने रहने वाले संदर्भ को संभाल नहीं पाते।
- ElevenLabs का इंटरैक्शन स्टैक संदर्भ खोए बिना या बातचीत का प्रवाह तोड़े बिना रुकावटों, ठहरावों और ओवरलैप होती बातचीत को संभालने के लिए बनाया गया है।
- ElevenLabs एक उन्नत कैस्केडेड आर्किटेक्चर, इन-हाउस स्पीच टू टेक्स्ट (STT) और टेक्स्ट टू स्पीच (TTS) तथा कम लेटेंसी और सहज आगे-पीछे चलने वाली बातचीत के लिए ट्यून किए गए स्टैक के साथ वास्तविक इंटरैक्शन मॉडल बना रहा है।
ज़्यादातर मानव-AI वॉइस कम्यूनिकेशन सहज क्यों नहीं लगते
ज़्यादातर वॉइस AI बातचीत को अलग-अलग इनपुट और आउटपुट की श्रृंखला की तरह देखते हैं: सिस्टम बोलने के एक हिस्से का इंतज़ार करता है, उसे टेक्स्ट में बदलता है, उस टेक्स्ट को प्रोसेस करता है और जवाब देता है। यह कमांड-और-रिस्पॉन्स इंटरैक्शन में काम करता है, लेकिन असली बातचीत टेक्स्ट एक्सचेंज की साफ़-सुथरी श्रृंखला नहीं होती। यह ठहरावों और बीच-बीच की टिप्पणियों से भरा लगातार संवाद है।
टर्न के बीच का प्रवाह और उनमें बना रहने वाला संदर्भ हटाने पर तीन खास समस्याएं पैदा होती हैं:
- यह आपको बीच में टोक देता है या इंतज़ार कराता है: सिस्टम सोचने के लिए लिए गए ठहराव और पूरे हो चुके टर्न में फर्क नहीं कर पाता, इसलिए या तो आपके बोलते समय ही जवाब देने लगता है या आपके रुकने के बाद चुप रहता है। वाक्य के बीच अपने विचार समेटें तो वह आपको काट देता है; अपनी बात खत्म करें तो कुछ पल की खामोशी झेलनी पड़ती है।
- बोलना शुरू करने के बाद यह प्रतिक्रिया नहीं दे पाता: सिस्टम जवाब देना शुरू करते ही सुनना बंद कर देता है। आप दिशा बदलने के लिए इसे रोकें, तो भी यह उसी सवाल का जवाब देता रहता है जिससे आप आगे बढ़ चुके हैं, क्योंकि यह समझ नहीं पाता कि कुछ बदल गया है।
- यह आगे बढ़ते हुए भूल जाता है: हर टर्न अलग से प्रोसेस होता है, इसलिए पांच एक्सचेंज पहले का संदर्भ आगे नहीं आता। आपको खुद को दोहराना पड़ता है या सिस्टम ऐसे जवाब देता है जैसे बातचीत अभी शुरू हुई हो।
नतीजा ऐसी बातचीत है जो काम के लिहाज़ से सही हो सकती है, फिर भी गलत लगती है।
इंटरैक्शन मॉडल क्या कर सकते हैं जो पारंपरिक वॉइस AI नहीं कर सकता
जहाँ पारंपरिक वॉइस AI एक बार में एक टर्न संभालता है, वहीं इंटरैक्शन मॉडल पूरी बातचीत को एक साथ चलाता है और इस पर ध्यान देता है कि क्या कहा जा रहा है और आगे क्या होना चाहिए। कार्यात्मक अंतर यह है कि इंटरैक्शन मॉडल सिर्फ़ सबसे हालिया इनपुट पर नहीं, बल्कि बातचीत की वास्तविक स्थिति के अनुसार जवाब देता है।
इंटरैक्शन मॉडल में ये खूबियां होती हैं:
- रियल-टाइम प्रतिक्रिया: सिस्टम को बातचीत की गति से जवाब देने के लिए बनाया गया है और कॉन्फ़िगरेशन के आधार पर इसका एंड-टू-एंड चक्र एक सेकंड से कम में चल सकता है।
- रुकावट, चुप्पी और ओवरलैप का सहज प्रबंधन: यह सोचने के लिए लिए गए ठहराव और पूरे हुए टर्न में फर्क करता है, इसलिए लोगों को बीच में नहीं काटता और न ही बेकार की खामोशी छोड़ता है। और जब ग्राहक दिशा बदलने के लिए इसके ऊपर बोलता है, तो यह संदर्भ खोए बिना या बातचीत बिगाड़े बिना ओवरलैप संभालता है।
- पूरे एक्सचेंज में निरंतरता: हर टर्न पर संदर्भ रीसेट करने के बजाय, सिस्टम बातचीत का इतिहास आगे लेकर चलता है। इसलिए टर्न 10 में इसका जवाब टर्न एक से अब तक हुई हर बात को दर्शाता है।
- अनुकूल डिलीवरी: आवाज़ को उसके काम के प्रकार के अनुसार बदलने के लिए प्रोग्राम किया जा सकता है—जैसे अधिक शांत, अधिक सीधी या अधिक भरोसा दिलाने वाली।
- समानांतर टास्क एक्ज़ीक्यूशन: सिस्टम जानकारी लाता है, टूल कॉल चलाता है और साथ ही बोलता भी रहता है, बजाय इसके कि कुछ खोजते समय चुप हो जाए।
इंटरैक्शन मॉडल की असली परीक्षा वह कॉल है जो खराब जा रही हो। नीचे की रिकॉर्डिंग में एक ग्राहक फ्लाइट रद्द होने के बारे में कॉल करता है। वह तनाव में है और अपनी समस्या का जल्द समाधान चाहता है।
एजेंट ग्राहक के इस्तेमाल किए गए शब्दों से ही उसकी तुरंत समाधान की जरूरत और निराशा को पहचान लेता है। वह अपना लहजा बदलता है, अपनी जगह खोए बिना रुकावट संभालता है और कनेक्टेड टूल्स से रद्द हुई फ्लाइट के वास्तविक समाधान देता है। आखिर में ग्राहक को मानव एजेंट की जरूरत के बिना समाधान मिल जाता है।
इसकी तुलना आज इस्तेमाल हो रहे सामान्य टर्न-आधारित एजेंटों से करें। ये सिस्टम हर ठहराव का इंतज़ार करेंगे, तटस्थ आधार से जवाब देंगे और ग्राहक की निराशा को पूरी तरह नज़रअंदाज़ कर देंगे। कुछ ऐसे एक्सचेंज के बाद जो कॉलर की असली भावना को नहीं समझते, कॉल शायद मानव एजेंट को देनी पड़ेगी, और ग्राहक शुरुआत से भी ज़्यादा निराश होगा।
ElevenLabs इंटरैक्शन मॉडल कैसे बना रहा है
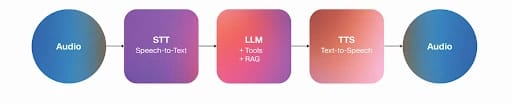
हमारी बातचीत पाइपलाइन उन्नत कैस्केडेड आर्किटेक्चर का उपयोग करती है, फ्यूज़्ड आर्किटेक्चर का नहीं। यानी सब कुछ एक मॉडल संभालने के बजाय हर चरण का अपना खास कंपोनेंट होता है।
इस तरीके का फ़ायदा यह है कि हम पूरे सिस्टम को दोबारा बनाए बिना पाइपलाइन के हर चरण को अलग-अलग ऑप्टिमाइज़ कर सकते हैं और किसी भी कंपोनेंट के लिए बेहतर मॉडल लगा सकते हैं। और क्योंकि हम इन कंपोनेंट्स को खुद बनाते हैं, इसलिए इन्हें एक-दूसरे तक समृद्ध संदर्भ पहुँचाने के लिए साथ में ऑप्टिमाइज़ किया जाता है। इसका मतलब है कि पाइपलाइन अलग-अलग टूल्स की श्रृंखला के बजाय एक सुसंगत बातचीत की तरह काम करती रहती है।
कैस्केडेड मॉडल संरचना
फ्यूज़्ड मॉडल संरचना
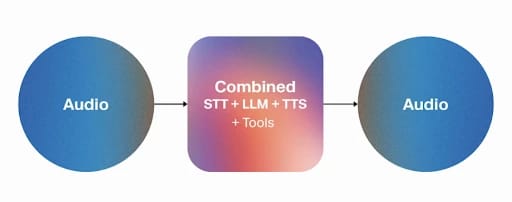
इमेज: कैस्केडेड बनाम फ्यूज़्ड मॉडल
फिलहाल पाइपलाइन में ये तकनीकें शामिल हैं:
- Scribe v2 रियलटाइम: हमारा इन-हाउस STT मॉडल 90+ भाषाओं में लगभग 150 ms में स्पीच को ट्रांसक्राइब करता है और बैकग्राउंड शोर, लहजों, रुकावटों और हंसी व ठहराव जैसे गैर-मौखिक संकेतों को भी संभालता है। यह मेडिकल शब्दों से लेकर वित्तीय शब्दावली तक, डोमेन-विशिष्ट शब्दों के लिए भी बनाया गया है।
- स्पेक्युलेटिव टर्न-टेकिंग: यह सिस्टम किसी तय चुप्पी सीमा पर निर्भर रहने के बजाय बातचीत का प्रवाह समझकर तय करता है कि कब बोलना, रुकना या इंतज़ार करना है। हमारे वॉइस एक्टिविटी डिटेक्शन मॉडल में सुधार इसे बैकग्राउंड में हो रही बातचीत और छोटे जवाबों को बेहतर ढंग से फ़िल्टर करने में मदद करते हैं, जिससे टर्न-टेकिंग अधिक स्वाभाविक लगती है।
- Eleven v3 कन्वर्सेशनल: हमारे सबसे अभिव्यक्तिपूर्ण TTS मॉडलों, जिसे लाइव, दोतरफ़ा बातचीत के लिए बनाया गया है। यह बातचीत के भावनात्मक माहौल को हर टर्न में आगे ले जाता है, इसलिए 10वें टर्न में एजेंट की डिलीवरी उससे पहले हुई हर बात को दर्शाती है।
- एक्सप्रेसिव मोड: Eleven v3 Conversational और टर्न-टेकिंग सिस्टम पर बना एक्सप्रेसिव मोड उस पल एजेंट की आवाज़ को नियंत्रित करता है। ग्राहक निराश हों तो यह स्थिति को शांत करता है, उलझन में हों तो भरोसा दिलाता है और स्पष्टता की जरूरत होने पर सीधा रहता है। यह एक्सप्रेसिव टैग भी पढ़ता है, ताकि मॉडल डिलीवरी के खास पलों को आकार देने के लिए [laughs], [whispers] या [sighs] जैसे संकेतों पर काम कर सके।
- Flash v2.5: हमारा कम-लेटेंसी TTS मॉडल 32 भाषाओं को सपोर्ट करता है और 75 ms से कम में स्पीच जनरेट करता है। जब लेटेंसी प्राथमिकता हो, तो यह रिस्पॉन्स टाइम को प्राकृतिक मानवीय लय के दायरे में रखता है।
- स्पीच इंजन: स्टैक को जोड़ने वाली लेयर, जो आपके सर्वर को हमारे ElevenAPI से WebSocket के ज़रिए जोड़ती है, हर बातचीत के लिए एक कनेक्शन। हम STT और TTS संभालते हैं, जबकि आपका सर्वर LLM चलाता है, ताकि तकनीकी टीमें अपना मॉडल ला सकें और बातचीत का लॉजिक अपने इन्फ्रास्ट्रक्चर पर रख सकें।
इन मॉडलों में लगातार सुधार हो रहा है और नए वर्ज़न नियमित रूप से रिलीज़ होते हैं। हर नई रिलीज़ तेज़ जवाबों, बेहतर भावनात्मक पहचान, अधिक भाषाओं और सहज डिलीवरी के साथ सॉफ़्टवेयर से बात करने और किसी व्यक्ति से बात करने के अंतर को कम करती है।
सोचते हुए बात करना
इंटरैक्शन मॉडल के हर हिस्से को सख्त क्रम में चलने की जरूरत नहीं होती। सवाल और जवाब के बीच डिफ़ॉल्ट रूप से चुप रहने के बजाय, ElevenAgents बातचीत जारी रहते हुए बैकग्राउंड में काम करता रह सकता है।
एक साथ बोलने और सोचने को संभव बनाने के लिए कुछ मुख्य सिस्टम साथ मिलकर काम करते हैं:
- समानांतर टूल कॉल: एजेंट डेटाबेस से क्वेरी कर सकता है, टूल चला सकता है या बोलते-बोलते ऑर्डर स्टेटस देख सकता है, इसलिए जानकारी लाना बातचीत में बेकार के ठहराव जैसा नहीं लगता।
- सॉफ्ट टाइमआउट: अगर LLM को जवाब जनरेट करने में अपेक्षा से ज्यादा समय लगता है, तो एजेंट अटपटी चुप्पी छोड़ने के बजाय “मुझे सोचने दें” या “हम्म” जैसा छोटा फिलर वाक्य बोलता है। सॉफ्ट टाइमआउट बातचीत का स्वाभाविक प्रवाह बनाए रखने और रुकावटों की संभावना कम करने में मदद करता है।
- रुकावट को अनदेखा करने वाले शब्द: तय चुप्पी सीमा इस्तेमाल करने के बजाय, सिस्टम कही जा रही बात का अर्थ पढ़कर समझने की कोशिश करता है कि टर्न वास्तव में कब खत्म हुआ है। इसी तरह, “ठीक है” या “हम्म-हम्म” जैसी छोटी सहमतियों को पूरी रुकावट ट्रिगर किए बिना आगे बढ़ने के लिए कॉन्फ़िगर किया जा सकता है, यानी कॉलर के हर बार बीच में बोलने पर एजेंट अपनी जगह नहीं खोता।
मिलकर ये सिस्टम एजेंट को ऐसा महसूस होने से बचाते हैं जैसे वह जवाब बफ़र या लोड कर रहा हो। ये एक सुव्यवस्थित बातचीत इंजन बनाते हैं, जो बैकग्राउंड में जानकारी प्रोसेस करते और विचार तैयार करते हुए किसी व्यक्ति की तरह स्वाभाविक ढंग से खाली जगह भरता है।
ElevenLabs के साथ बातचीत वास्तव में कैसे काम करती है
ऊपर के कंपोनेंट्स एक के बाद एक सीधी लाइन में नहीं चलते। वे ओवरलैप होते हैं। यहां बताया गया है कि ElevenLabs का एजेंट सपोर्ट कॉल के बीच में “क्या मेरा ऑर्डर भेज दिया गया है, या अभी भी प्रोसेस हो रहा है?” पूछने वाले कॉलर को कैसे संभालेगा।
- कॉलर बोलता है: WebSocket कनेक्शन पर ऑडियो ElevenLabs तक स्ट्रीम होता है और Scribe आवाज़ से करीब 150 ms पीछे रहते हुए रियल टाइम में ट्रांसक्राइब करना शुरू करता है।
- सिस्टम प्रवाह को पढ़ता है: Scribe के ट्रांसक्राइब करते समय ही स्पेक्युलेटिव टर्न-टेकिंग यह आकलन कर रहा होता है कि कॉलर की बात पूरी हुई है या वह अभी सोच रहा है। आखिर का “या अभी भी प्रोसेस हो रहा है?” ठहराव के बजाय आगे बात सौंपने जैसा लगता है, इसलिए यह चुपचाप इंतज़ार करने के बजाय अगला कदम ट्रिगर करता है।
- LLM संदर्भ तैयार करता है और जवाब देता है: ट्रांसक्राइब किया गया सवाल बातचीत के इतिहास, RAG, कॉल में पहले मिले टूल आउटपुट और सिस्टम प्रॉम्प्ट के साथ। यह इन सभी पर विचार करता है और कॉलर के ऑर्डर पर आधारित जवाब तैयार करता है।
- TTS मॉडल जवाब को सिंथेसाइज़ करता है: टेक्स्ट स्वाभाविक लगने वाले ऑडियो में बदल जाता है। अगर एक्सप्रेसिव मोड सक्रिय है, तो जवाब में उस पल के अनुरूप डिलीवरी संकेत होते हैं, इसलिए सामान्य अपडेट सपाट लगने के बजाय सहज और बिना जल्दबाजी का लगता है। जब लेटेंसी प्राथमिकता हो, तो Flash 75 ms से कम में सिंथेसिस करता है।
- जवाब वापस स्ट्रीम होता है: सिंथेसिस पूरा होने से पहले ही ऑडियो चलना शुरू हो जाता है, इसलिए बाकी जवाब जनरेट होते समय कॉलर जवाब की शुरुआत सुन लेता है।
- चक्र दोहराता है: हर नया टर्न बातचीत के लहजे, संदर्भ और इतिहास को आगे लेकर चलता है।
इस तेज़ प्रक्रिया के दौरान बातचीत स्वाभाविक लगती है। कॉलर मशीन के हिसाब से खुद को ढालना बंद कर देता है: वह धीरे नहीं बोलता, हर शब्द को ज़रूरत से ज़्यादा साफ़ नहीं बोलता और बीप का इंतज़ार नहीं करता। वह बस वैसे ही बात करता है जैसे किसी व्यक्ति से करता।
अपने पूरे व्यवसाय में स्वाभाविक आवाज़ वाले वॉइस एजेंट डिप्लॉय करें
यहाँ बताई गई हर चीज़ आज प्रोडक्शन में है। कैस्केडेड आर्किटेक्चर से लेकर सब-सेकंड पाइपलाइन तक, दुनिया भर के व्यवसाय पहले से ElevenAgents का इस्तेमाल बड़े पैमाने पर असली ग्राहक बातचीत संभालने के लिए कर रहे हैं।
इसमें रेगुलेटेड और उच्च-दांव वाले वातावरण भी शामिल हैं, क्योंकि हमारा एजेंट आर्किटेक्चर गार्डरेल्स, ऑडिट लॉग्स और कंप्लायंस कंट्रोल्स को सपोर्ट करता है। ElevenLabs के पास SOC 2 Type II, ISO 27001, HIPAA और PCI DSS Level 1 प्रमाणन हैं। साथ ही, उन टीमों के लिए Zero Retention Mode और क्षेत्रीय डेटा रेजिडेंसी उपलब्ध है जिन्हें डेटा किसी तय सीमा के भीतर रखना होता है।
क्या आप एजेंट को काम पर लगाने के लिए तैयार हैं? आप एजेंट बना सकते हैं और कंसोल में बनाना शुरू कर सकते हैं, या हमारी सेल्स टीम से बात कर सकते हैं ताकि आपके एनवायरनमेंट के लिए तय डिप्लॉयमेंट पर चर्चा हो सके।
इंटरैक्शन मॉडल FAQ

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।


