
कन्वर्सेशनल AI एजेंट्स का परीक्षण
- लेखक
- Anna Neely
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
जब कन्वर्सेशनल वॉइस एजेंट लाइव होते हैं, तो आप उन्हें बड़े पैमाने पर कैसे मॉनिटर करते हैं? वे तय तरीके से व्यवहार नहीं कर रहे हों, तो आप इसका पता कैसे लगाते हैं? और बदलाव करने के बाद, आप उनका टेस्ट कैसे करते हैं?
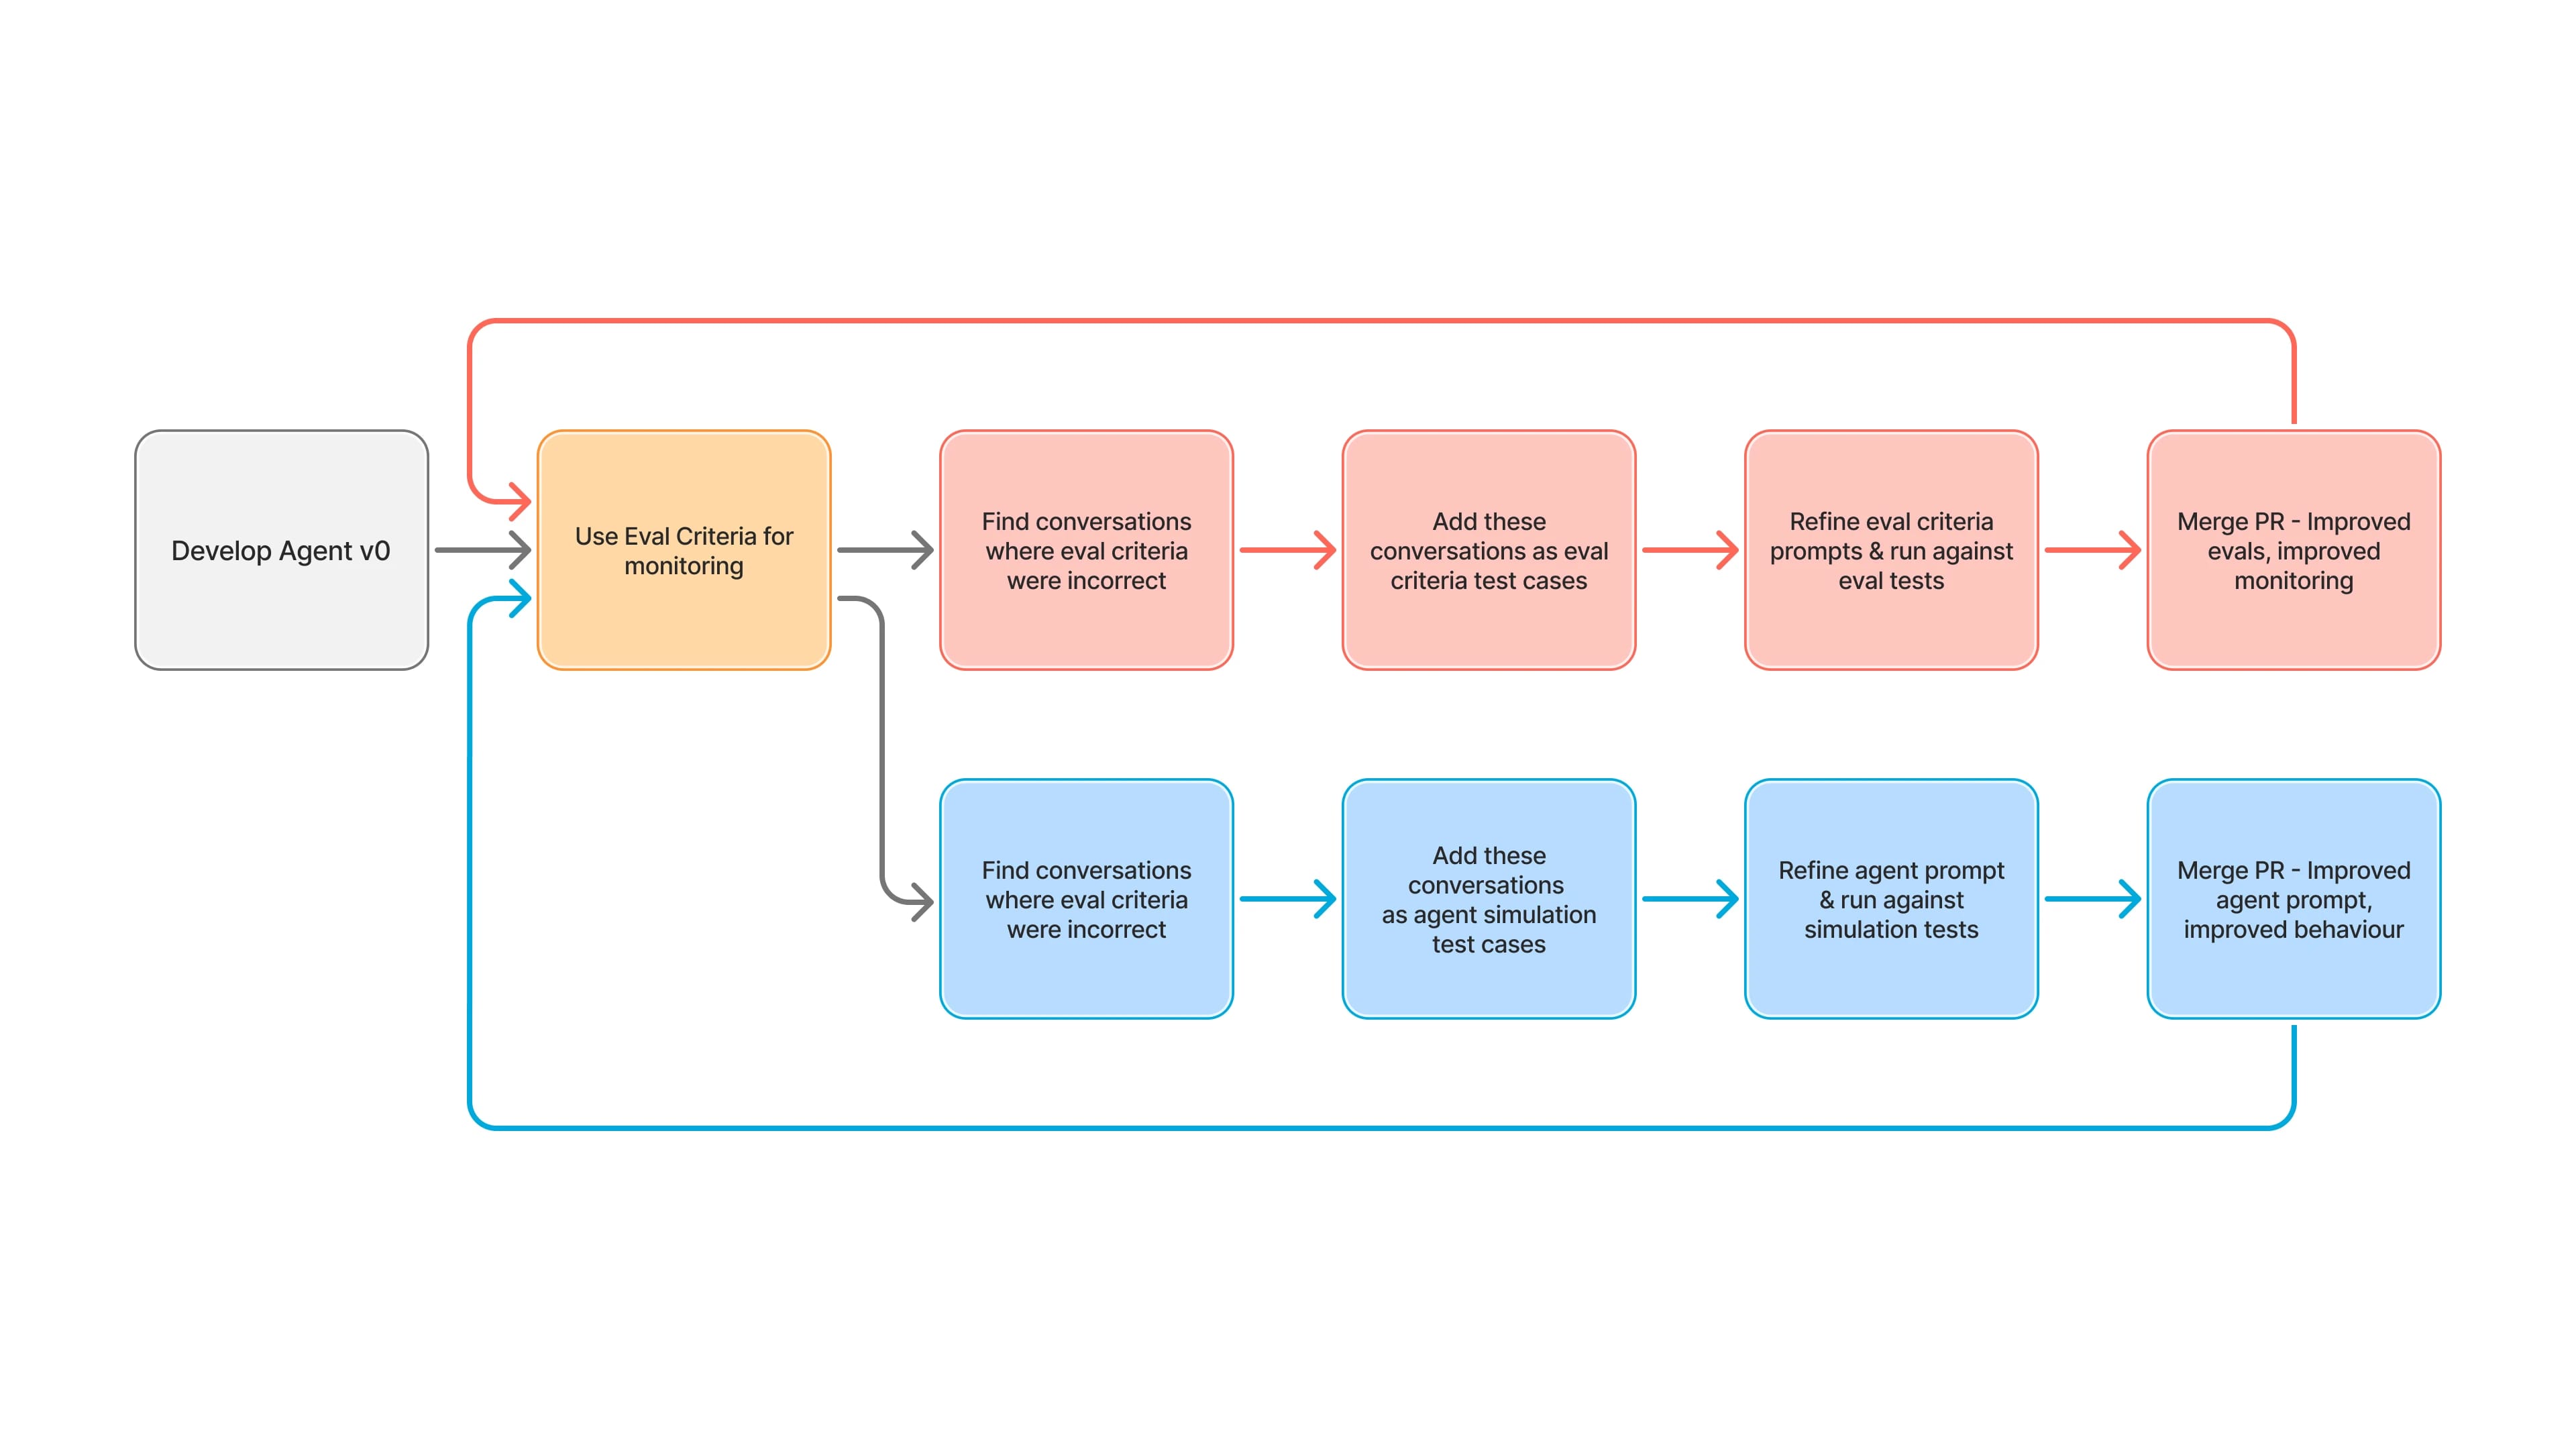
इन्हीं सवालों ने El, पर हमारे काम को आकार दिया, जो कन्वर्सेशनल AI से चलने वाला हमारा डॉक्यूमेंटेशन असिस्टेंट है। El के विकसित होने के साथ, हमने एजेंटों को मॉनिटर करने, मूल्यांकन करने और टेस्ट करने के लिए एक सिस्टम बनाया, जो मूल्यांकन मानदंडों और बातचीत के सिम्युलेशन पर आधारित है।
नींव तैयार करना: भरोसेमंद मूल्यांकन मानदंड
किसी भी एजेंट को बेहतर बनाने की शुरुआत यह समझने से होती है कि वह वास्तविक परिस्थितियों में कैसे व्यवहार करता है। इसके लिए हमें अपने मूल्यांकन मानदंडों को बेहतर बनाना था और यह सुनिश्चित करना था कि वे एजेंट के प्रदर्शन को मॉनिटर करने के लिए पर्याप्त सटीक और भरोसेमंद हों। हम उस बातचीत को असफल मानते हैं जिसमें एजेंट गलत जानकारी देता है या यूज़र को उनका लक्ष्य हासिल करने में मदद नहीं करता।
हमने ये मूल्यांकन मानदंड बनाए:
- इंटरैक्शन: क्या यह एक मान्य बातचीत है, क्या यूज़र ने प्रासंगिक सवाल पूछे, क्या बातचीत समझ में आई?
- सकारात्मक इंटरैक्शन: क्या यूज़र संतुष्ट होकर गया, या वह भ्रमित या निराश था?
- मूल कारण को समझना: क्या एजेंट ने यूज़र की मूल समस्या को सही पहचाना?
- यूज़र की पूछताछ का समाधान: क्या एजेंट ने यूज़र की समस्या हल की या सहायता का कोई वैकल्पिक तरीका दिया?
- हैलुसिनेशन: क्या एजेंट ने ऐसी जानकारी गढ़ी जो नॉलेज बेस में नहीं है?
अगर इंटरैक्शन असफल होता है, तो बातचीत ही मान्य नहीं है। अगर कोई दूसरा मानदंड असफल होता है, तो हम आगे जांच करते हैं। यही जांच तय करती है कि एजेंट को कैसे बेहतर बनाना है। कभी-कभी टूल के इस्तेमाल या टाइमिंग को बेहतर करना होता है। दूसरी बार, असमर्थित कार्रवाइयों को रोकने के लिए गार्डरेल्स जोड़ने होते हैं।
भरोसे के साथ सुधार: कन्वर्सेशन सिम्युलेशन API
जब हम पहचान लेते हैं कि क्या बेहतर करना है, तो अगला कदम टेस्टिंग होता है। यहीं हमारा कन्वर्सेशन सिम्युलेशन API आता है। यह वास्तविक यूज़र स्थितियों का सिम्युलेशन करता है—शुरू से अंत तक और चुनिंदा हिस्सों में भी—और प्रोडक्शन में लागू किए जाने वाले उन्हीं मानदंडों से नतीजों का अपने-आप मूल्यांकन करता है। यह टूल मॉकिंग और कस्टम मूल्यांकन को सपोर्ट करता है, इसलिए खास व्यवहारों का टेस्ट करने के लिए काफी लचीला है।
हम दो तरीके अपनाते हैं:
- पूर्ण सिम्युलेशन: पूरी बातचीत का टेस्ट करें शुरू से अंत तक।
- आंशिक सिम्युलेशन: निर्णय बिंदुओं या सब-फ्लो को सत्यापित करने के लिए बातचीत के बीच से शुरू करें। तेज़ी से सुधार करने और लक्षित डीबगिंग के लिए यह यूनिट टेस्टिंग का हमारा पसंदीदा तरीका है।
स्पष्ट और केंद्रित स्थितियां हमें यह नियंत्रित करने देती हैं कि LLM का किस चीज़ पर टेस्ट हो रहा है, जिससे एज केस, टूल के इस्तेमाल और फॉलबैक लॉजिक की कवरेज सुनिश्चित होती है।
बड़े पैमाने पर ऑटोमेशन: CI/CD में टेस्ट शामिल करना
आखिरी हिस्सा है ऑटोमेशन। हमने मूल्यांकन और सिम्युलेशन को अपनी CI/CD पाइपलाइन में शामिल करके ElevenLabs के ओपन APIs को अपने GitHub DevOps फ्लो से जोड़ा। हर अपडेट को डिप्लॉयमेंट से पहले अपने-आप टेस्ट किया जाता है। इससे रिग्रेशन रुकते हैं और वास्तविक परिस्थितियों के प्रदर्शन पर हमें तेज़ फीडबैक मिलता है।
नतीजे: और मजबूत, और स्मार्ट El
इस प्रक्रिया ने El को बनाने और बनाए रखने का हमारा तरीका बदल दिया। हमने एक फीडबैक लूप बनाया है, जो वास्तविक उपयोग को व्यवस्थित मूल्यांकन, लक्षित टेस्टिंग और ऑटोमेटेड वैलिडेशन से जोड़ता है। इससे हम सुधारों को अधिक तेज़ी और भरोसे के साथ जारी कर पाते हैं।
और अब हम इस फ्रेमवर्क को अपने बनाए किसी भी एजेंट पर लागू कर सकते हैं।
एना नीली प्रोडक्ट स्ट्रैटेजी पर ध्यान देती हैं और एंटरप्राइज ग्राहकों के साथ समाधान डिज़ाइन और इम्प्लीमेंटेशन में साझेदारी करती हैं



