Flash से मिलें
- प्रकाशित
सुनेंइस आर्टिकल को सुनें
Flash से मिलें। हमारा सबसे नया मॉडल, जो 75ms + एप्लिकेशन और नेटवर्क लेटेंसी में स्पीच जनरेट करता है।
कम लेटेंसी वाले कन्वर्सेशनल वॉइस एजेंट्स के लिए Flash हमारा सुझाया गया मॉडल है। आप आज ही हमारे कन्वर्सेशनल AI प्लेटफ़ॉर्म में Flash इस्तेमाल कर सकते हैं।
या मॉडल ID “eleven_flash_v2” और “eleven_flash_v2_5” का इस्तेमाल करके सीधे API के ज़रिए बनाएं: https://elevenlabs.io/docs/api-reference/text-to-speech/convert
Flash v2 सिर्फ़ अंग्रेज़ी में उपलब्ध है और Flash v2.5 32 भाषाओं को सपोर्ट करता है। दोनों की लागत हर 2 कैरेक्टर के लिए 1 क्रेडिट है
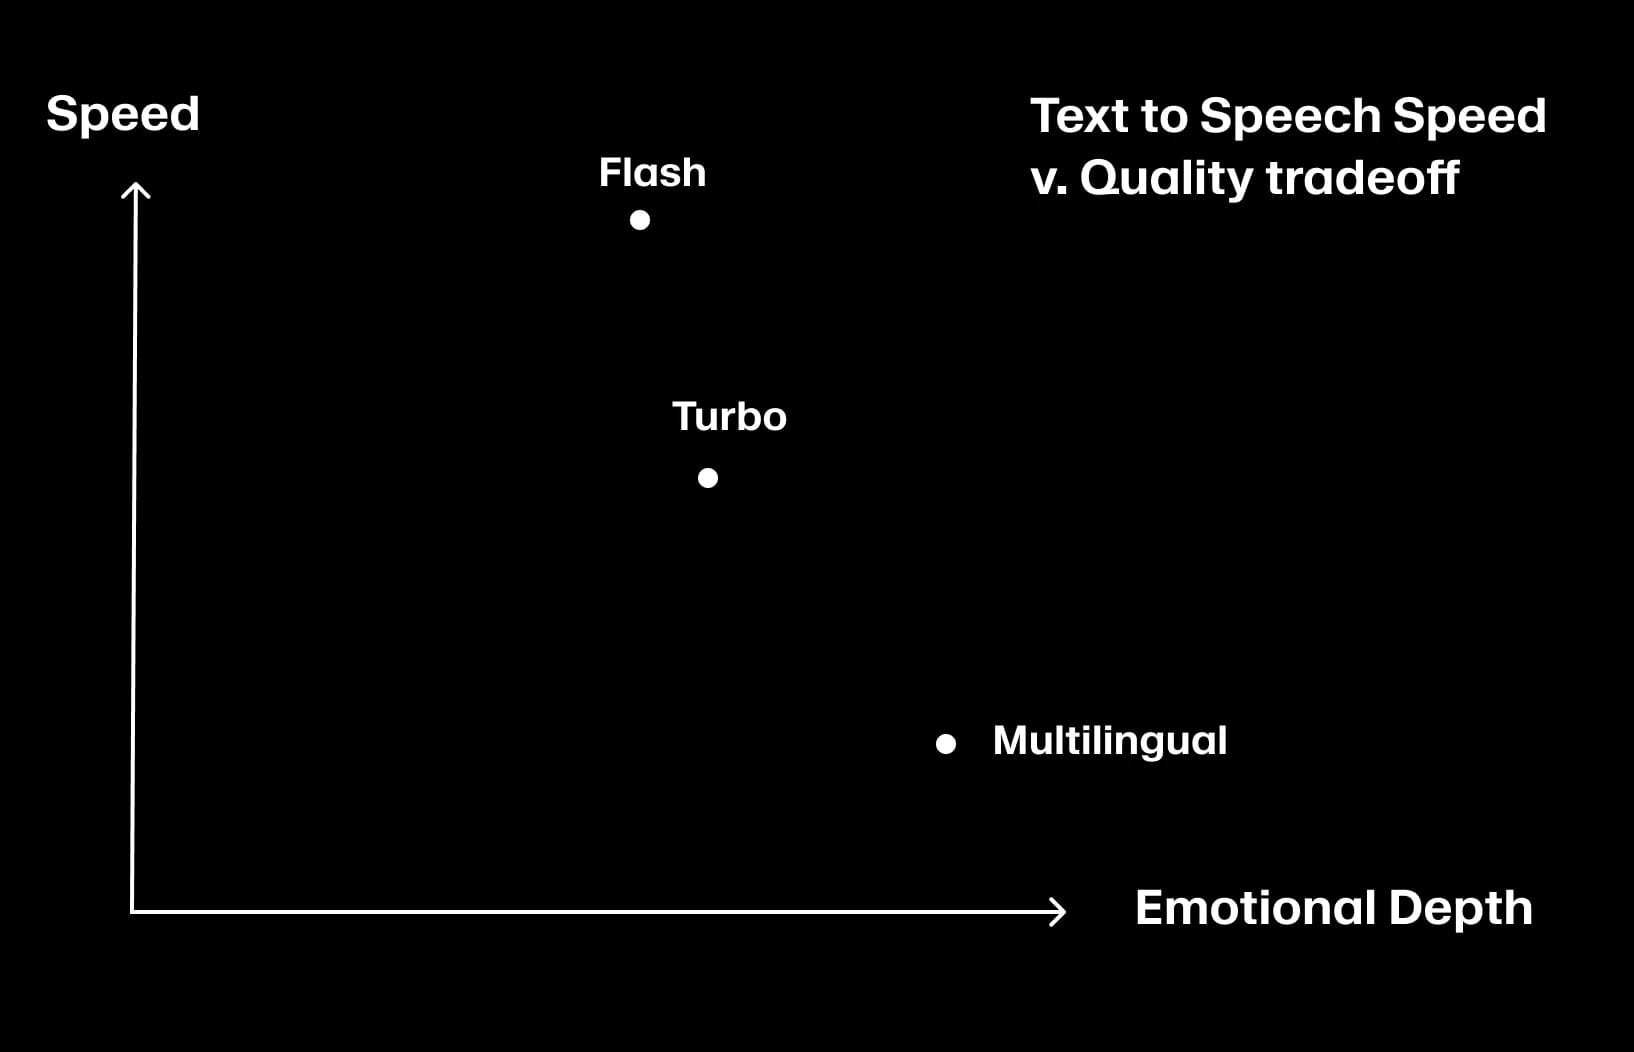
Turbo मॉडल्स की तुलना में इसकी क्वालिटी और भावनात्मक गहराई थोड़ी कम है, लेकिन लेटेंसी काफी कम है। हमारे मानव लेबलर्स द्वारा किए गए ब्लाइंड टेस्ट में, Eleven Flash ने लगातार मिलते-जुलते अल्ट्रा-लो-लेटेंसी मॉडल्स से बेहतर स्कोर किया, जिससे यह अपनी तरह की क्वालिटी वाला सबसे तेज़ मॉडल बन गया।
अपने इस्तेमाल के लिए सबसे सही मॉडल खोजने हेतु हमारी मॉडल्स गाइड देखें: https://elevenlabs.io/docs/developer-guides/models
हम उन सभी कम-लेटेंसी, मानव-जैसी कन्वर्सेशनल इंटरैक्शंस को देखने के लिए उत्सुक हैं जिन्हें Flash संभव बनाएगा।