पेश है Eleven v4, हमारा अब तक का सबसे भावपूर्ण मॉडल
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
टेक्स्ट की कोई पंक्ति, उसे कैसे बोला जाता है इसके आधार पर, काफी बदल सकती है। “मुझे चाहिए कि आप शांत रहें” अलग-अलग तरह से सुनाई देना चाहिए, इस पर निर्भर करते हुए कि इसे कौन कह रहा है—चाहे कोई डॉक्टर डरे हुए मरीज़ से इसे धीरे से कह रहा हो, या किसी गेम का किरदार लड़ाई में कूदने से पहले अपनी टीम पर चिल्ला रहा हो।
आज हम लॉन्च कर रहे हैं Eleven v4, हमारा अब तक का सबसे भावनात्मक टेक्स्ट टू स्पीच मॉडल, और इसका लो-लेटेंसी वेरिएंट, Eleven v4 Turbo।
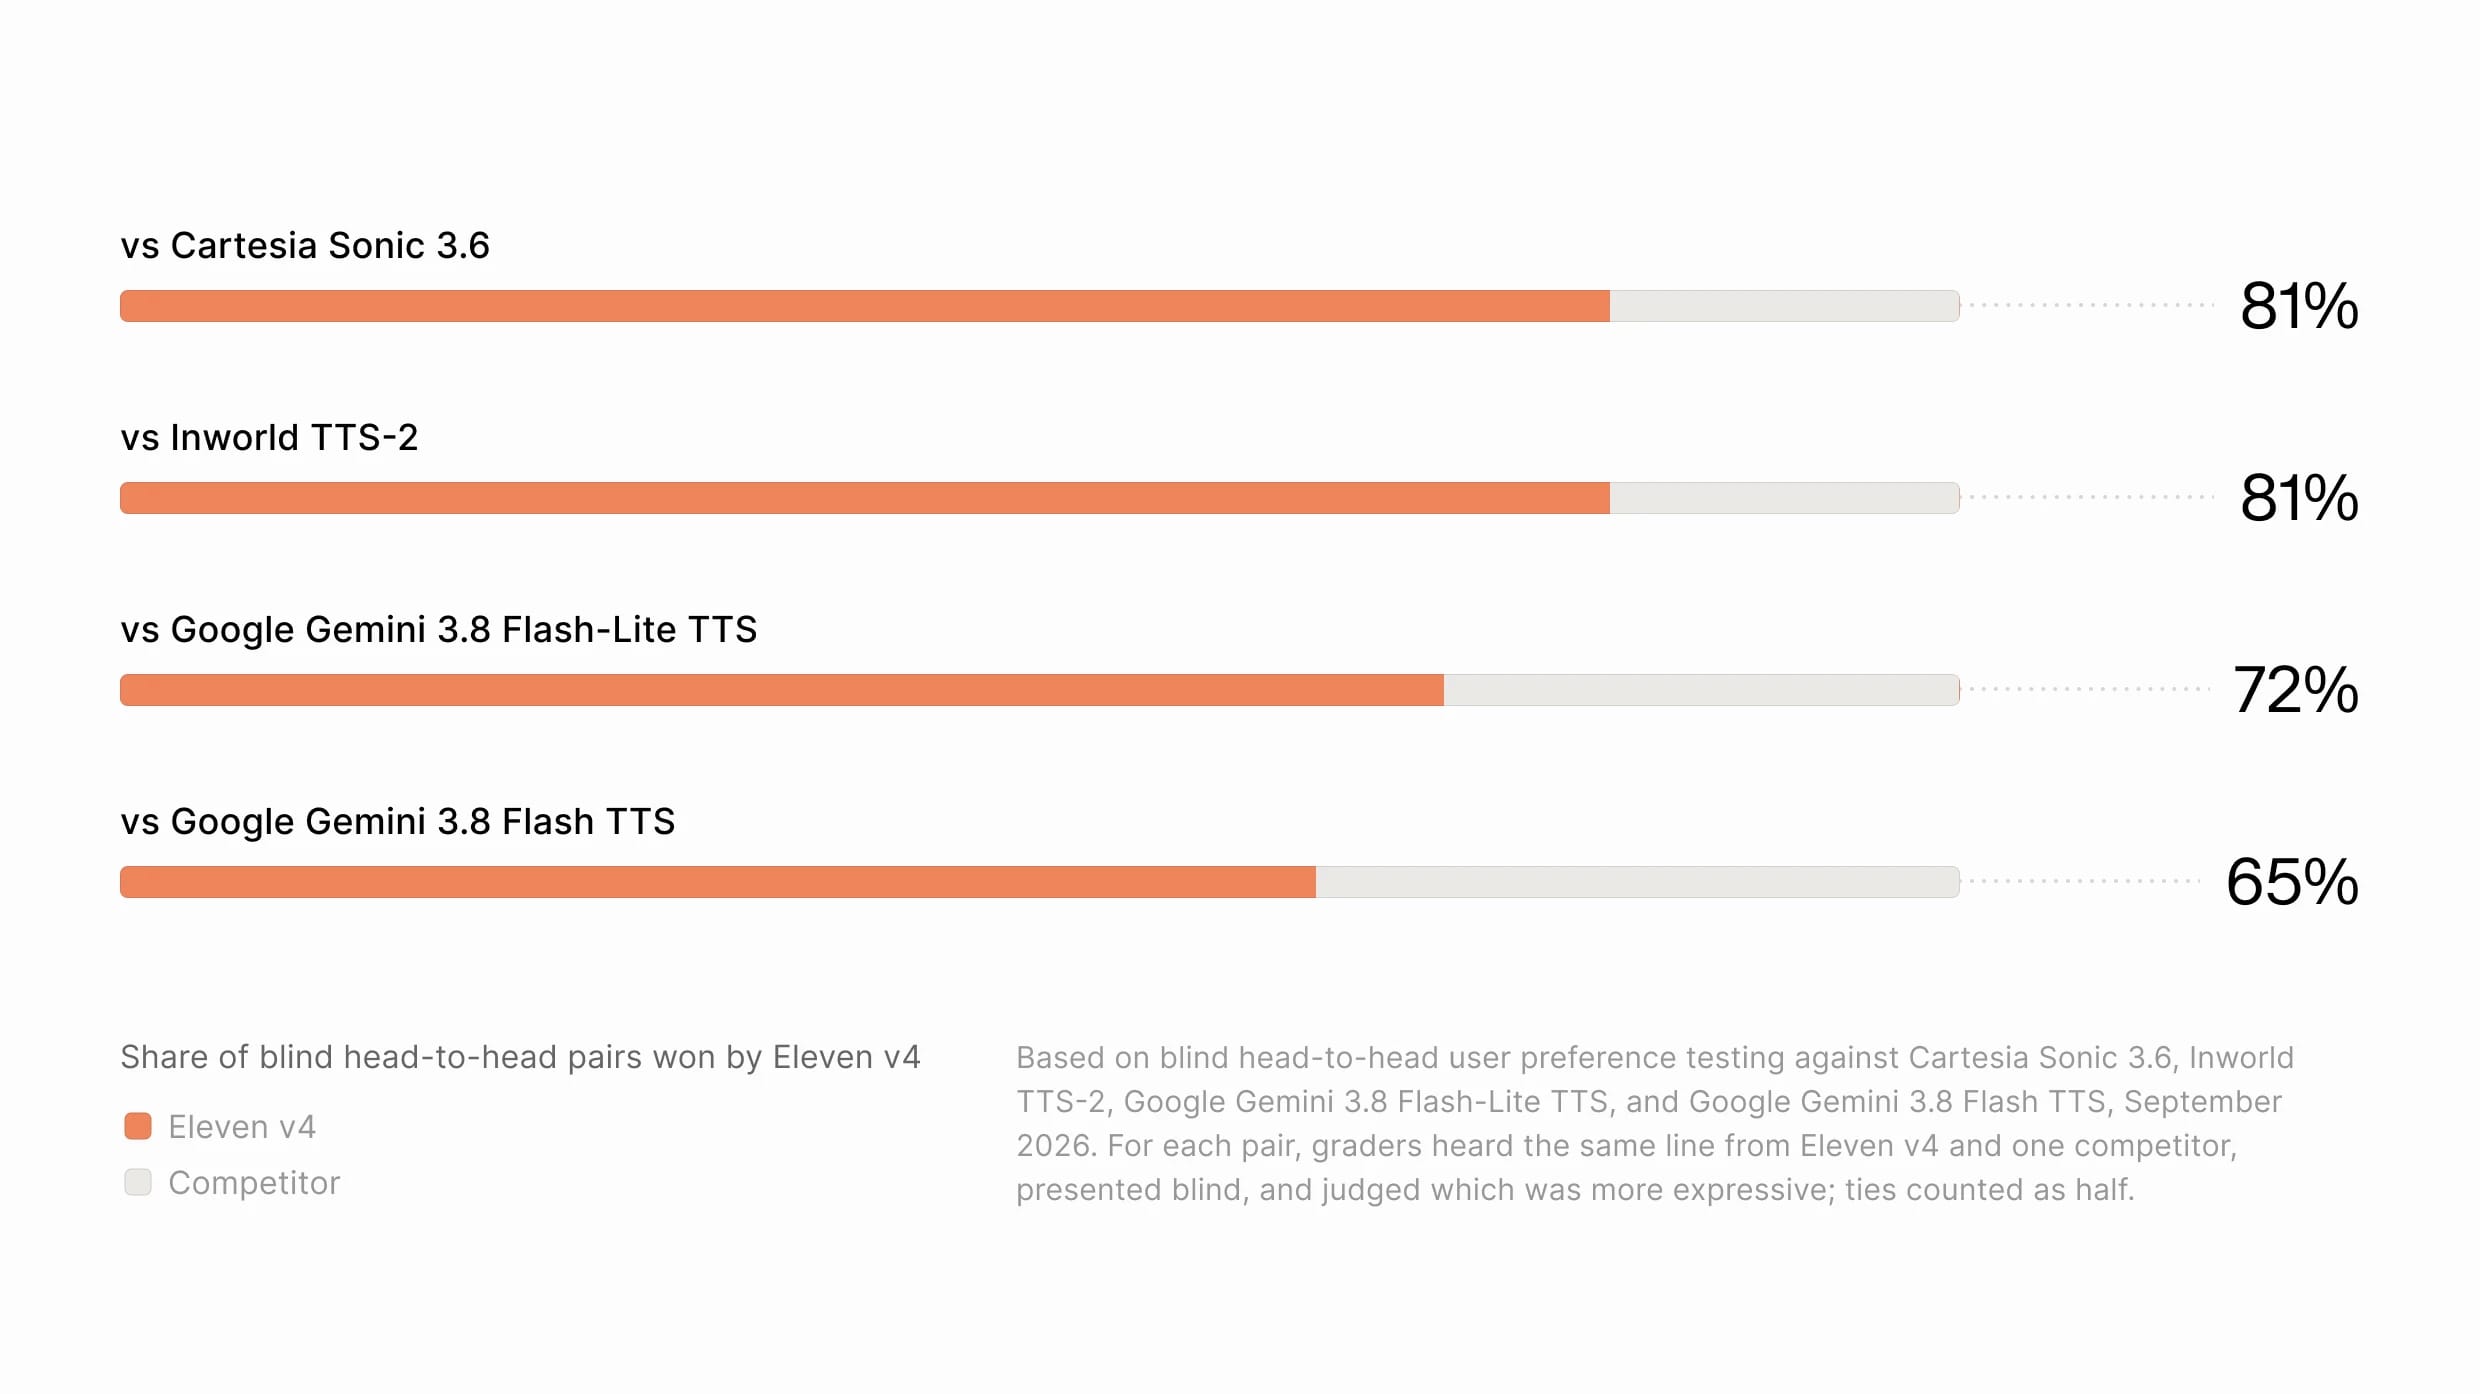
Artificial Analysis द्वारा #1 रैंक किया गया1, और ब्लाइंड हेड-टू-हेड टेस्ट में प्रतिस्पर्धी मॉडलों की तुलना में ~75% श्रोताओं की पसंद2, Eleven v4 को टोन, गति, भावना, किरदार और संदर्भ समझने के लिए डिज़ाइन किया गया है। यह स्पीकर की पहचान बनाए रखते हुए नाटकीय, कोमल, ज़रूरी, हास्यपूर्ण या बातचीत जैसा लगने वाला भाषण जनरेट करता है। ज़्यादा प्राकृतिक मल्टी-स्पीकर डायनामिक्स से बातचीत अलग-अलग पंक्तियों को जोड़ने के बजाय तुरंत प्रतिक्रिया देने वाली लगती है। स्पीकर बातचीत के संदर्भ के अनुसार प्रतिक्रिया देते हैं, जिससे संवाद और किरदारों की बातचीत अधिक स्वाभाविक बनती है।
परफॉर्मेंस के लिए बनाया गया नया आर्किटेक्चर
पूरी तरह नए आर्किटेक्चर पर बना, Eleven v4 हमारा सबसे भावनात्मक टेक्स्ट टू स्पीच मॉडल है, जिसे Artificial Analysis ने #1 रैंक किया है1। Eleven v4 Turbo इसी टेक्नोलॉजी को एजेंट जैसे लो-लेटेंसी उपयोग के मामलों में लाता है। ~100ms की मीडियन इन्फ़रेंस लेटेंसी के साथ, यह दो लोगों के बीच बातचीत के औसत विराम से भी तेज़ प्रतिक्रिया दे सकता है।
दोनों मॉडल ऐसा भाषण जनरेट कर सकते हैं जो मैकेनिकल के बजाय भावनात्मक लगे। ऑडियो फिडेलिटी भी हर स्तर पर बेहतर है, जिससे आउटपुट ज़्यादा साफ़ और प्राकृतिक सुनाई देता है।
टेक्स्ट टू स्पीच मॉडलों की पिछली पीढ़ियां टेक्स्ट को ज़ोर से पढ़ सकती हैं, लेकिन Eleven v4 भाषण में भावनात्मक गहराई लाता है जो कहीं अधिक स्वाभाविक लगती है। मॉडल इच्छित टोन, भाषण की गति, लेखन के किरदार और टेक्स्ट के संदर्भ को समझकर भावनात्मक रूप से असरदार भाषण दे सकता है।
यूज़र्स को आउटपुट पर बारीक नियंत्रण भी मिलता है और वे प्राकृतिक भाषा में बता सकते हैं कि कोई पंक्ति कैसे बोली जानी चाहिए। वे यह भी बता सकते हैं कि कुछ खास वाक्यांश कैसे कहे जाएं, उनमें कौन-सी भावना हो, और यहां तक कि साउंड इफेक्ट्स, के लिए भी inline tags इस्तेमाल कर सकते हैं, जैसे [laughs], [said angrily in French accent], [light rain], या [phone buzzing]। Eleven v4 इन ऑडियो टैग्स और डायरेक्शन प्रॉम्प्ट्स को पिछले मॉडलों से ज़्यादा सटीकता से फ़ॉलो करता है, इसलिए आपको वही डिलीवरी मिलती है जिसका आप वर्णन करते हैं। इससे नैरेशन को निर्देश देना, किरदारों या उनके संवादों को विस्तार देना और ऐसे अन्य काम आसान हो जाते हैं जहां डिलीवरी अहम हो।
ElevenLabs डेवलपर डॉक्यूमेंटेशन में पूरा टैग सिंटैक्स और API के ज़रिए इन टैग्स को लागू करने का तरीका बताया गया है। International Phonetic Alphabet (IPA) फोनीम्स के लिए सपोर्ट भी काफी बेहतर हुआ है, इसलिए कस्टम उच्चारण अधिक भरोसेमंद ढंग से काम करते हैं।
Eleven v4 कई स्पीकर्स के बीच एकरूपता और डायनामिक बातचीत में भी सुधार लाता है। स्पीकर्स की पहचान कैप्चर करने के नए तरीके का उपयोग करके, Eleven v4 हर वॉइस की खासियतें बनाए रखता है। यह एजेंट बातचीत, ऑडियोबुक्स, या विज्ञापनों में भाषण को एकरूप रख सकता है। चूंकि मॉडल पूरे दृश्य का संदर्भ समझता है, इसलिए यह ऐसा प्राकृतिक संवाद जनरेट करता है जिसमें स्पीकर्स अभी कही गई बात पर प्रतिक्रिया देते हैं, अलग-अलग पंक्तियों को जोड़ने के बजाय।
लो-लेटेंसी उपयोग के मामलों के लिए Turbo मॉडल
हाई-क्वालिटी वॉइस मॉडल आमतौर पर भाषण जनरेट करने में धीमे रहे हैं, यानी यूज़र्स को तेज़ या भावनात्मक वॉइस एजेंट्स में से चुनना पड़ता था। कई लोगों ने कुशल लेकिन एकसुरी एजेंट चुने हैं, जो अपनी समस्या सुलझाने की कोशिश कर रहे परेशान ग्राहक को रोबोटिक लग सकते हैं।
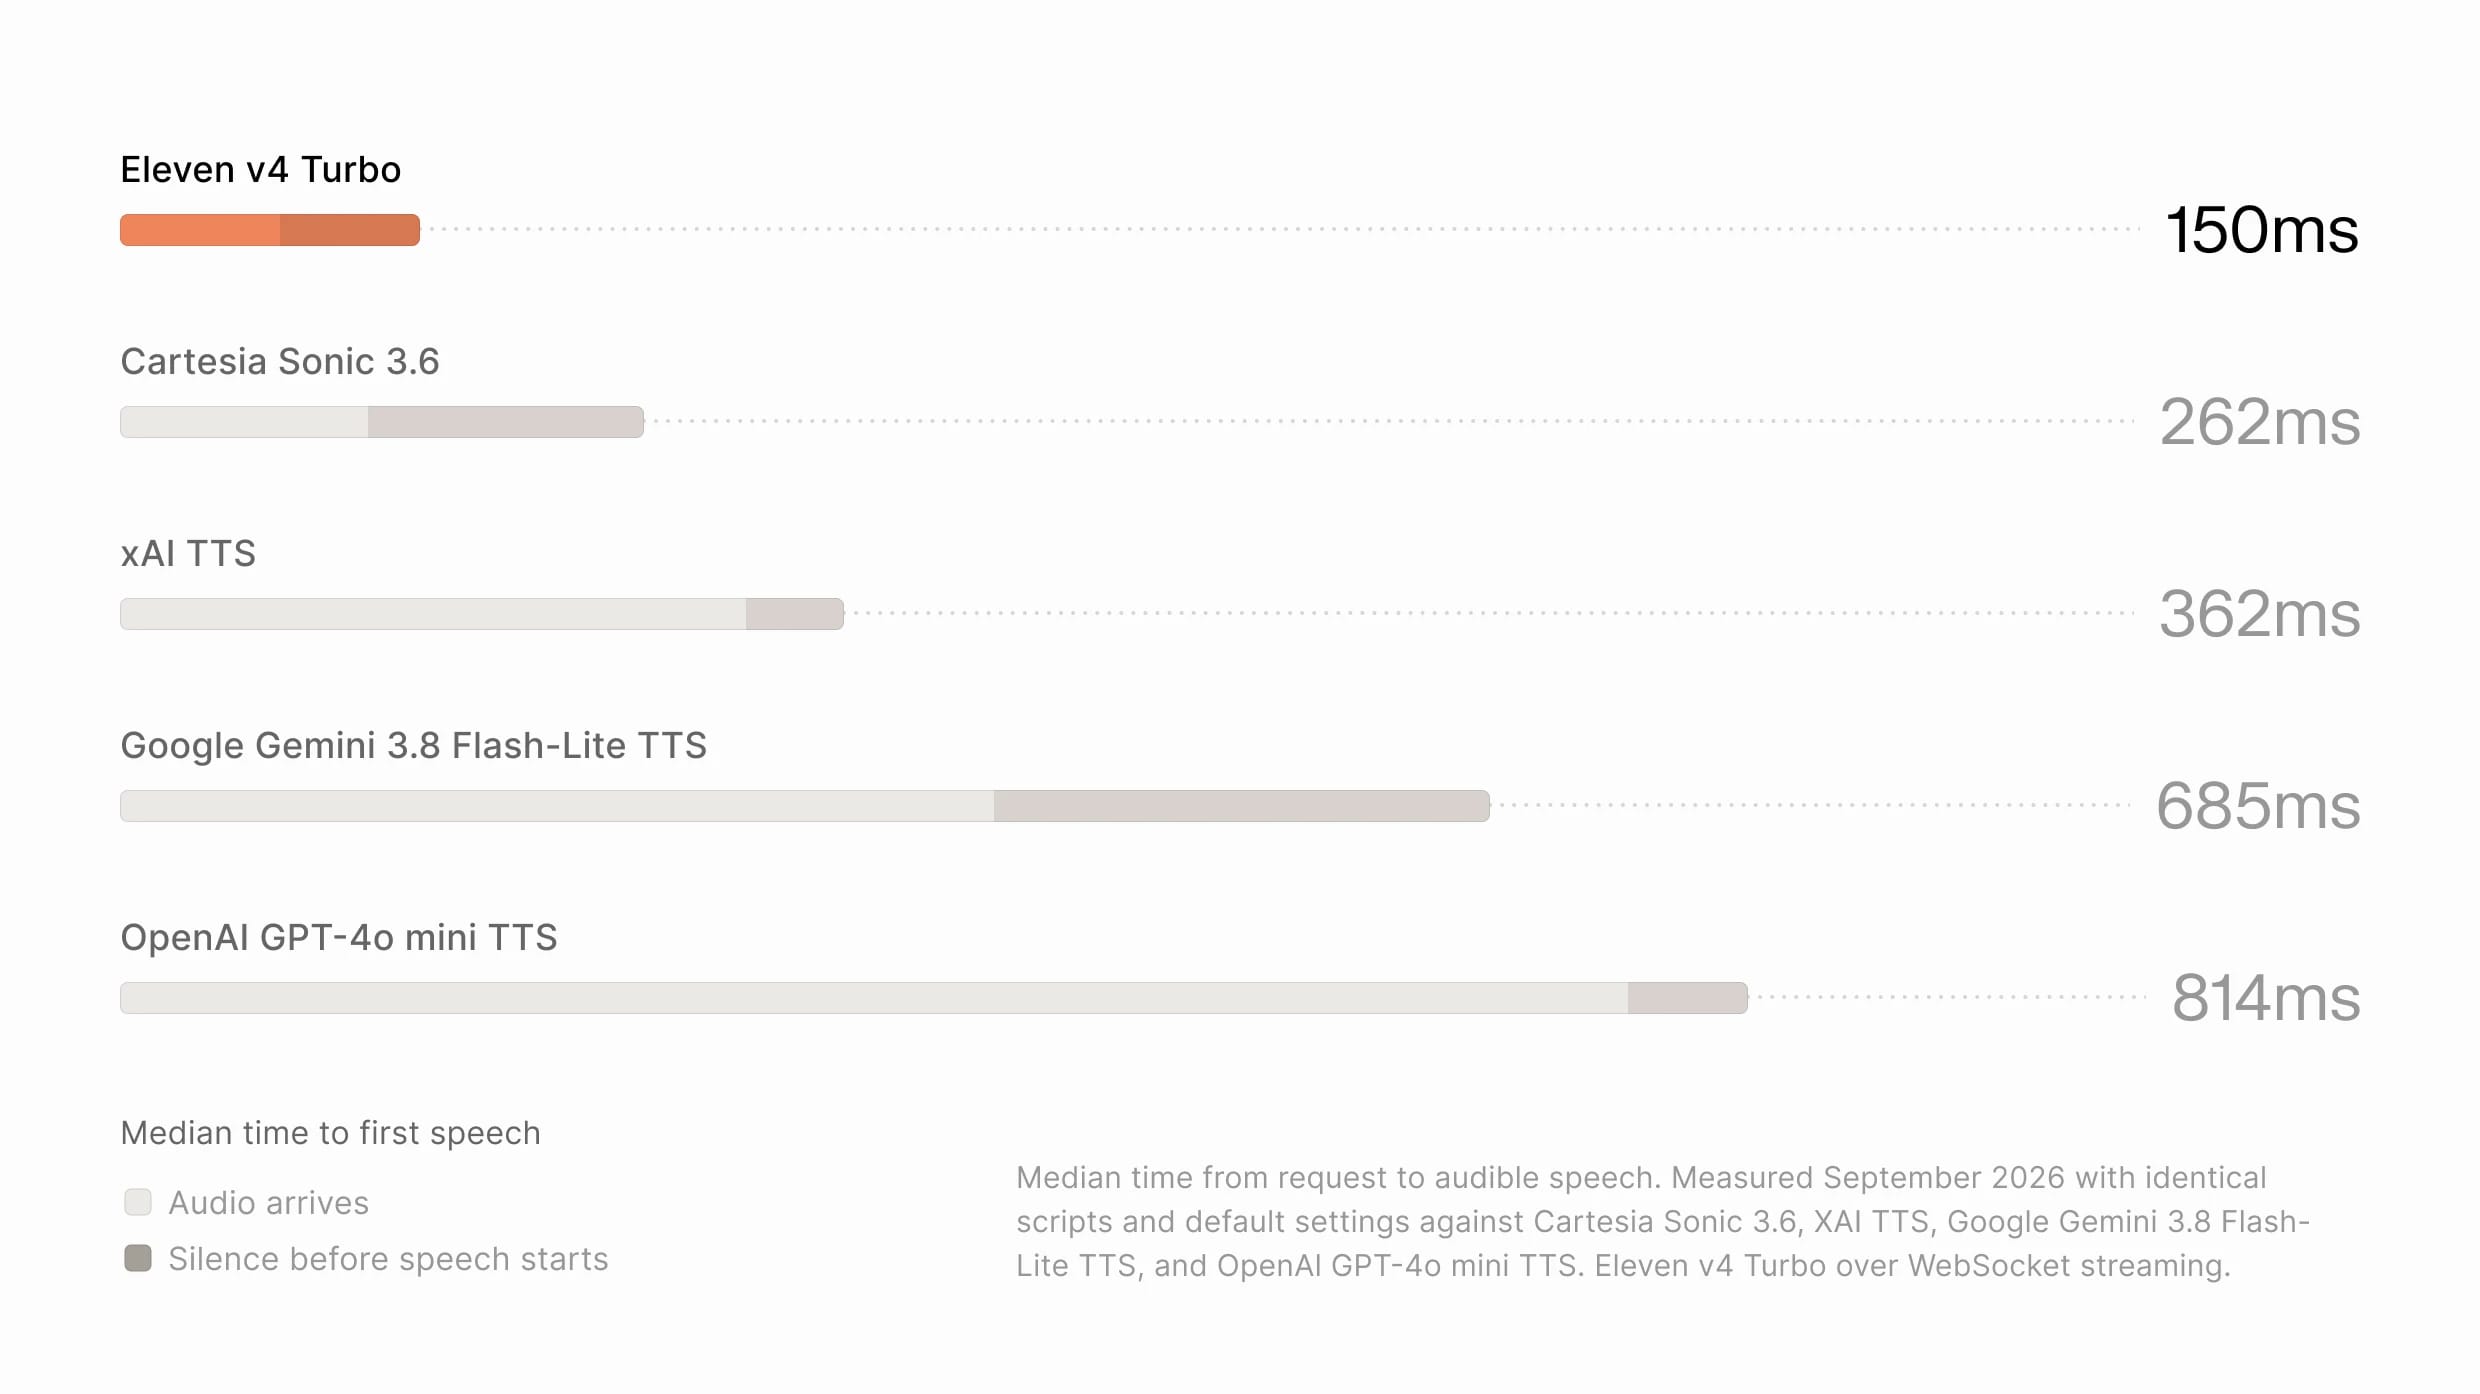
Eleven v4 Turbo, ~150ms के पहले भाषण तक के मीडियन समय के साथ, गति और भावना को जोड़ता है3, जिससे अनगिनत उद्योगों में शक्तिशाली एजेंट तैनात करना संभव होता है—हेल्थकेयर में चिकित्सा शब्दों का सटीक उच्चारण करने वाले गर्मजोशी भरे, भरोसा दिलाने वाले एजेंटों से लेकर गेमिंग में खिलाड़ियों का मनोरंजन करने वाले तेज़ बोलने वाले, स्लैंग इस्तेमाल करने वाले एजेंटों तक।
Eleven v4 Turbo मॉडल को ElevenLabs के कन्वर्सेशनल एजेंट्स प्लेटफ़ॉर्म ElevenAgents के साथ काम करने के लिए बनाया गया है। अन्य एजेंट बिल्डर्स अलग-अलग वेंडर्स के मॉडल और सॉफ़्टवेयर को जोड़ते हैं, इसलिए यूज़र्स के पास अपने खास उपयोग के मामलों के लिए मॉडल आउटपुट को बेहतर बनाने का कोई तरीका नहीं बचता। ElevenLabs की रिसर्च और इंजीनियरिंग टीमों ने Eleven v4 Turbo और ElevenAgents को एक सिस्टम के रूप में साथ ऑप्टिमाइज़ किया है, जिससे अधिक भावनात्मक, भरोसेमंद और लो-लेटेंसी एजेंट मिलते हैं।
एक वॉइस, अनगिनत भाषाएं
हमारे संवाद का तरीका संदर्भ, स्थान, यहां तक कि दिन के समय के अनुसार भी बदलता है। अलग-अलग भाषाओं में इसे दर्शाने वाला भावनात्मक भाषण बनाना, ऑडियो AI की सबसे कठिन चुनौतियों में से एक है।
Eleven v4 इन सभी क्षेत्रों में एक बड़ा कदम आगे है और सुधार सिर्फ मॉडल द्वारा वाक्यांशों के उच्चारण तक सीमित नहीं हैं। Eleven v4 भाषाओं के बीच लय, भावना और डिलीवरी को बेहतर ढंग से कैप्चर करता है, जिससे क्रिएटर्स ऐसा भाषण बना पाते हैं जो भाषा और संदर्भ के लिए स्वाभाविक लगे। उदाहरण के लिए, जापान में किसी बुज़ुर्ग अजनबी से आप जिस तरह बात करेंगे, वह इटली में उनसे बात करने के तरीके से काफी अलग होगा।
Eleven v4 और Eleven v4 Turbo, दोनों 90 से ज़्यादा भाषाओं को सपोर्ट करते हैं। अब एक भाषा में रिकॉर्ड की गई वॉइस किसी भी दूसरी भाषा को भी धाराप्रवाह बोलती है, मूल वॉइस की पहचान बनाए रखते हुए उस भाषा के मूल वक्ता का उच्चारण अपनाती है। उच्चारण के प्रति यह निष्ठा पहले से काफ़ी बेहतर है, इसलिए जनरेशन के दौरान वॉइस अब अपने स्रोत उच्चारण की ओर वापस नहीं भटकती।
कैटलन
स्पैनिश
डबिंग और लोकलाइज़ेशन के लिए, इसका मतलब है कि जिस ब्रांड वॉइस को आपने चुना है—चाहे वह आपके साथ काम कर रहा कोई मशहूर ऐक्टर हो या आपकी कंपनी के स्टाइल के लिए सबसे उपयुक्त टोन—वह Eleven v4 द्वारा समर्थित हर भाषा में बेहतरीन सुनाई देगी।
ज़्यादा प्रामाणिक, एकरूप वॉइस क्लोनिंग
Eleven v4 और Eleven v4 Turbo में वॉइस क्लोनिंग अधिक प्रामाणिक, शक्तिशाली और एकरूप है, और मूल स्रोत वॉइस से स्पीकर की समानता काफी बेहतर है। Instant Voice Clones अब केवल 10 सेकंड के ऑडियो से हाई फिडेलिटी के साथ वॉइस कैप्चर कर सकते हैं।
असली वॉइस
Eleven v4
Eleven v4 जनरेशन, संवाद, नैरेशन और दोबारा जनरेट की गई पंक्तियों में भी स्पीकर की पहचान को अधिक भरोसेमंद तरीके से बनाए रखता है। इसका मतलब है कि लंबे प्रोजेक्ट्स में किरदार, नैरेटर और क्लोन की गई वॉइस पूरी प्रोडक्शन में एकरूप बने रहते हैं। Eleven v4 सबसे उच्च-फिडेलिटी क्लोनिंग उपयोग के मामलों के लिए Professional Voice Clones (PVC) का सपोर्ट भी जोड़ता है।
Request stitching—लंबे कंटेंट के लिए जनरेशंस को एक साथ जोड़ना—भी Eleven v4 में काफी अधिक भरोसेमंद है, जिससे ElevenLabs Studio और ElevenLabs रीडर ऐप में काम करने का अनुभव बेहतर होता है।
खुद अंतर सुनें
Eleven v4 और Eleven v4 Turbo, भावनात्मक स्पीच जनरेशन में हमारी नवीनतम रिसर्च का नतीजा हैं। इन्हें ऐसे कंटेंट के लिए बनाया गया है जहां डिलीवरी उतनी ही अहम है जितने शब्द—चाहे वह ऑडियोबुक्स, किरदारों की परफ़ॉर्मेंस, वॉइसओवर, डबिंग या कन्वर्सेशनल एजेंट्स का लोकलाइज़ेशन हो।
दोनों मॉडल अब ElevenAgents, ElevenCreative, और ElevenAPI के ज़रिए उपलब्ध हैं। मुफ़्त अकाउंट बनाएं और आज ही Eleven v4 या Eleven v4 Turbo के साथ जनरेट करना शुरू करें।
- Artificial Analysis, Provider Voice Arena Leaderboard, सितंबर 2026
- सितंबर 2026 में Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS और Google Gemini 3.8 Flash TTS के विरुद्ध किए गए ब्लाइंड हेड-टू-हेड यूज़र प्रेफरेंस टेस्ट पर आधारित। हर जोड़ी के लिए, मूल्यांकनकर्ताओं ने Eleven v4 और एक प्रतिस्पर्धी की एक ही पंक्ति बिना पहचान बताए सुनी और तय किया कि कौन ज़्यादा भावनात्मक और कौन ज़्यादा प्राकृतिक सुनाई देता है; टाई को आधा गिना गया।
- रिक्वेस्ट से सुनाई देने वाला भाषण शुरू होने तक का मीडियन समय। सितंबर 2026 में Cartesia Sonic 3.6, xAI TTS, Google Gemini 3.8 Flash-Lite TTS और OpenAI GPT-4o mini TTS के विरुद्ध एक जैसी स्क्रिप्ट्स और डिफ़ॉल्ट सेटिंग्स के साथ मापा गया; सभी सिस्टम्स के लिए नेटवर्क लेटेंसी मापकर हटा दी गई। WebSocket स्ट्रीमिंग पर Eleven v4 Turbo।