आपके ट्रांसक्रिप्ट को कैसे पता चलता है कि हर शब्द कब बोला गया
- लेखक
- Mike Murphy
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
अगर आपने कभी टीवी पर ऐसी फ़िल्म देखी हो जिसमें प्रसारण में कोई समस्या हो और कलाकारों के संवाद कैप्शंस के साथ पूरी तरह सिंक से बाहर हों, तो आप जानते हैं कि यह कितना ध्यान भटका सकता है और आपको कहानी से बाहर कर सकता है। वॉइस मॉडल इस्तेमाल करने वाले वीडियो और सॉफ़्टवेयर में भी यही समस्या होती है: एक सेकंड देर से दिखने वाला सबटाइटल या गलत शब्द को हाइलाइट करने वाला ट्रांसक्रिप्ट उतना ही खराब लग सकता है।
ElevenLabs में अलाइनमेंट पर काम करने वाले शोधकर्ता डैनिला कोज़लोव ने कहा, “इंसान कम-से-कम शब्द स्तर पर मीडिया को अलाइन करने में काफ़ी अच्छे होते हैं। हमें अक्सर सहज रूप से पता चल जाता है कि कोई शब्द कहाँ से शुरू हो रहा है, लेकिन कैरेक्टर स्तर पर और मिलीसेकंड से भी कम सटीकता के साथ यह बहुत मुश्किल हो जाता है।”
आज ElevenLabs Cue के बारे में और जानकारी साझा कर रहा है। यह एक फोर्स्ड अलाइनमेंट मॉडल है, जो ऑडियो फ़ाइल के हर कैरेक्टर को सटीक टाइमलाइन पर रखता है। Cue, ElevenLabs के Scribe मॉडल परिवार को चलाता है और वास्तविक रिकॉर्डिंग्स पर, बेंचमार्क की सभी 29 भाषाओं में, यह ElevenLabs द्वारा टेस्ट किए गए हर अलाइनर से ज़्यादा सटीक है। यह किसी भी लंबाई की रिकॉर्डिंग को एक ही पास में संभालता है और एक घंटे के ऑडियो को एक सेकंड से कम समय में अलाइन करता है।
फोर्स्ड अलाइनमेंट क्या है?
कल्पना कीजिए कि कोई आपको एक वीडियो और उसका ट्रांसक्रिप्ट देता है और हर शब्द को उसके बोले जाने के पल से मिलाने को कहता है। यही फोर्स्ड अलाइनमेंट है। जब आप ElevenLabs के ट्रांसक्रिप्ट में किसी शब्द पर क्लिक करते हैं और प्लेयर ठीक उस जगह पर पहुँच जाता है, तो यह काम एक अलाइनर कर रहा होता है।
हालाँकि, फोर्स्ड अलाइनमेंट, AI अलाइनमेंट की ज़्यादा व्यापक अवधारणा से अलग है। AI अलाइनमेंट का मतलब AI सिस्टम को इस तरह डिज़ाइन करना है कि उनका व्यवहार लोगों के मूल्यों और व्यावसायिक प्राथमिकताओं से मेल खाए। फोर्स्ड अलाइनमेंट में हम सिर्फ़ टेक्स्ट और आवाज़ को मिलाने की बात कर रहे हैं।
Cue, स्पीच-टू-टेक्स्ट पाइपलाइन का आख़िरी चरण है। ElevenLabs का Scribe, स्पीच टू टेक्स्ट मॉडल, ऑडियो को ट्रांसक्राइब करता है और अलाइनर टाइमिंग तय करता है। हर Scribe अनुरोध इससे होकर गुज़रता है। यही मॉडल सबटाइटल्स, डबिंग और संगीत के लिए लिरिक्स टाइमिंग को भी चलाता है, और Forced Alignment API के ज़रिए अलग से भी उपलब्ध है।
चूँकि इतने सारे प्रोडक्ट इस पर निर्भर करते हैं, इसलिए अलाइनर को हर समर्थित भाषा में सटीक, बेहद तेज़ और एक साथ कई अनुरोध संभालने में सक्षम होना चाहिए।
पारंपरिक अलाइनर कहाँ कम पड़ते हैं
नए मॉडल से पहले, टीम ने उस अलाइनर मॉडल को बनाया था जो अब तक हर ElevenLabs प्रोडक्ट में इस्तेमाल हुआ था। वह शक्तिशाली था, लेकिन उन्हें पता था कि वे उसका नया वर्शन और बेहतर बना सकते हैं। कोज़लोव के आने पर, उन्होंने और टीम ने ElevenLabs के ग्राहकों और आंतरिक यूज़र्स से बात की कि पिछले अलाइनर के साथ काम करते समय उन्हें किन बातों से परेशानी हुई। उनकी शिकायतें उन ओपन-सोर्स टूल्स की सीमाओं से मेल खाती थीं जिन्हें टीम ने टेस्ट किया था।
लंबाई पहली बड़ी समस्या है। आज कई अलाइनर करीब 30 सेकंड लंबे क्लिप्स के लिए अच्छी तरह काम करते हैं, लेकिन लंबी फ़ाइलों को टुकड़ों में बाँटना पड़ता है। हर नया टुकड़ा थोड़ी टाइमिंग त्रुटि जोड़ सकता है, और टुकड़ों को जोड़ने पर और त्रुटियाँ आ सकती हैं। पूरी रिकॉर्डिंग्स में Cue की औसत टाइमिंग त्रुटि सिर्फ़ 179 मिलीसेकंड है, जबकि ओपन-सोर्स टूल्स में यह 283 ms से लेकर 6,000 ms से भी ज़्यादा थी।
वास्तविक दुनिया का रिकॉर्ड किया गया ऑडियो और भी बड़ी चुनौती है। बैकग्राउंड शोर, एक-दूसरे पर चढ़ती आवाज़ें और परिवेशी संगीत, टेक्स्ट को ऑडियो से मिलाते समय कई टूल्स को अपनी जगह खोने पर मजबूर करते हैं। लेकिन बहुत से लोग इन्हीं तरह की फ़ाइलों को ट्रांसक्राइब करवाना चाहते हैं, क्योंकि हम सभी ऐसी जगहों पर रहते हैं जो पूरी तरह शांत नहीं होतीं। बैकग्राउंड समस्याओं वाली अंग्रेज़ी रिकॉर्डिंग्स में Cue की औसत त्रुटि 57 ms थी, जबकि अन्य टूल्स में यह 65 ms से 920 ms तक थी।
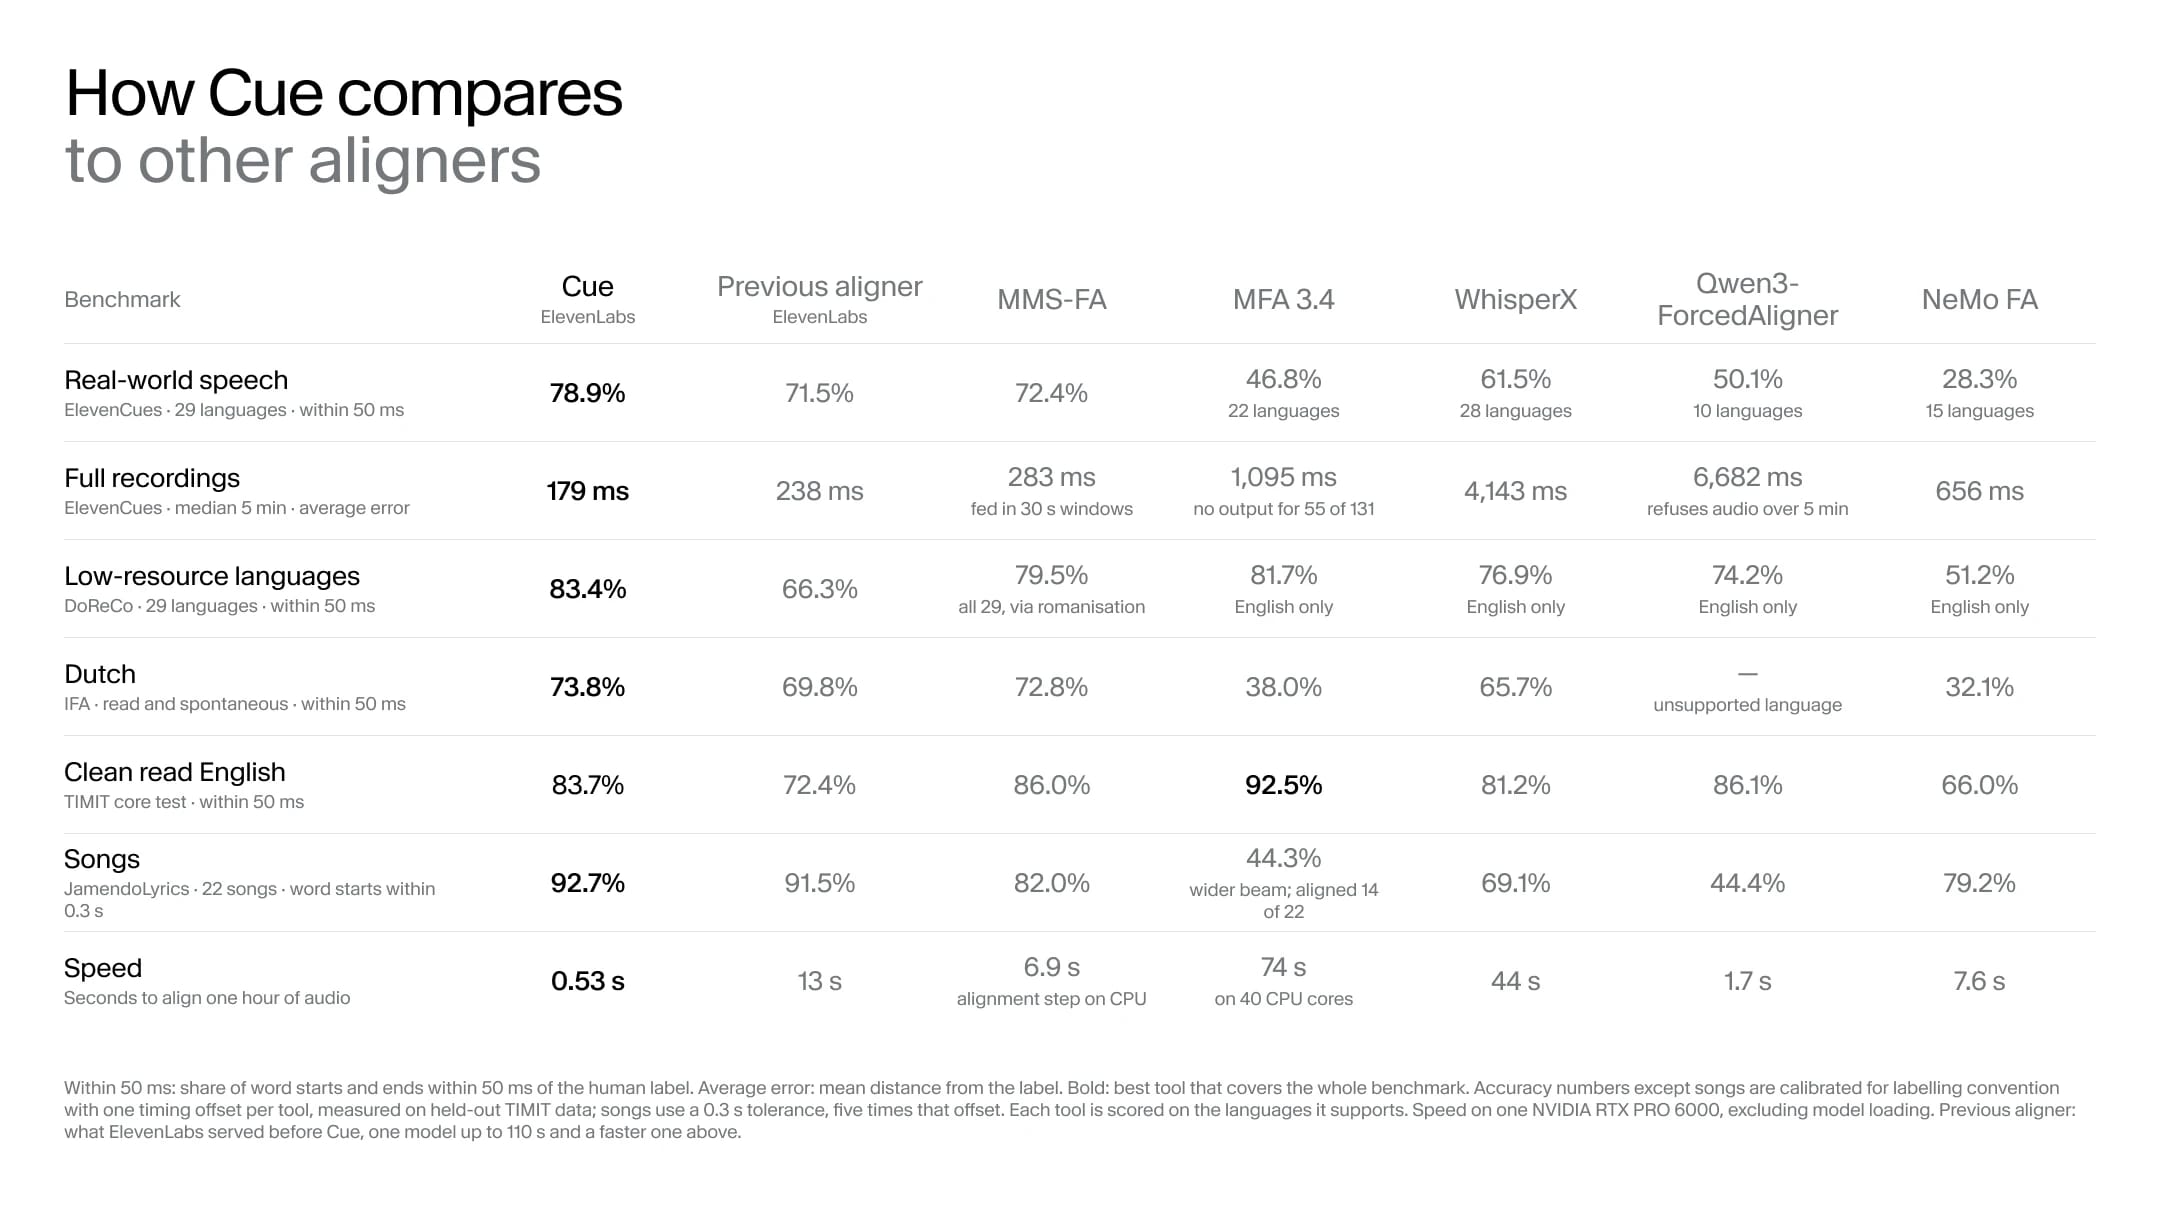
भाषा समर्थन भी एक और बाधा है। ज़्यादातर ओपन-सोर्स अलाइनर को हर समर्थित भाषा के लिए अलग मॉडल चाहिए होता है, इसलिए जिन भाषाओं के लिए ट्रेनिंग डेटा कम है, उनमें अक्सर प्रदर्शन उतना अच्छा नहीं होता या वे समर्थित ही नहीं होतीं। MMS-FA ही एकमात्र दूसरा टूल है जो सभी 29 बेंचमार्क भाषाओं को संभालता है, और तुलना में Cue आम तौर पर शब्दों की सीमाएँ पहचानने में तेज़ था।
इन मॉडलों के लिए गति भी एक समस्या है, क्योंकि बड़ी मात्रा में ऑडियो को अलाइन करना जल्दी महँगा हो सकता है। Cue हमारे प्रोडक्शन GPU पर लगभग आधे सेकंड में एक घंटे के ऑडियो को अलाइन कर सकता है। अगला सबसे तेज़ टूल, Qwen3-ForcedAligner, लगभग 2 सेकंड लेता है और सबसे धीमे टेस्ट किए गए टूल ने एक मिनट से भी ज़्यादा समय लिया।
Cue कैसे अलग है
Cue एक ही मॉडल है जो 90 से ज़्यादा बेंचमार्क भाषाओं को कवर करता है, जबकि इसके ज़्यादातर प्रतिस्पर्धी ऐसा नहीं करते। यह किसी भी लंबाई की रिकॉर्डिंग को एक ही पास में ले सकता है, जिससे लंबे फ़ाइलों में टाइमिंग त्रुटियाँ बढ़ाने वाले टुकड़ों में बाँटने से बचा जा सकता है।
ज़ूम करने के लिए पिंच करें या Control-स्क्रॉल करें। पैन करने के लिए क्षैतिज रूप से स्वाइप करें या Shift-स्क्रॉल करें। किसी शब्द पर फ़ोकस होने पर, ज़ूम करने के लिए प्लस और माइनस या पैन करने के लिए Shift के साथ बाएं या दाएं ऐरो का इस्तेमाल करें।
किसी शब्द के अक्षर देखने के लिए उसे चुनें
कोज़लोव ने कहा कि जहाँ ज़्यादातर मॉडल बेहतर प्रदर्शन के साथ बड़े होते गए हैं, वहीं Cue पिछले ElevenLabs अलाइनर से छोटा है। यह अब भी GPU पर चलता है, लेकिन लगभग आधे सेकंड में एक घंटे के ऑडियो को अलाइन कर देता है।
टीम ने Cue को उन तरह के ऑडियो के आधार पर बनाया जिन्हें लोग वास्तव में अपलोड करते हैं। पिछले अलाइनर को आधार बनाकर, उन्होंने वास्तविक अनुरोधों से एक बेंचमार्क तैयार किया और हर टूल को एक ही तरह से स्कोर किया—जिस शब्द को कोई टूल रख नहीं पाया, उसे त्रुटि गिना। Cue कैरेक्टर स्तर पर काम करता है, जो ज़्यादातर बेंचमार्क में इस्तेमाल होने वाले शब्द-स्तरीय लेबल्स से अधिक बारीक है, इसलिए ये स्कोर संभवतः इसकी सटीकता को कम करके दिखाते हैं।
अलाइनर मॉडलों के बारे में कोज़लोव ने कहा, “एक बिंदु पर आप इंसानी क्षमताओं के स्तर तक पहुँच जाते हैं। हमारा मौजूदा अलाइनर उस स्तर से आगे है, इसलिए यह जाँचना बहुत मुश्किल हो जाता है कि आप पूरी तरह सही हैं या बस कितने सटीक हैं, क्योंकि इसके लिए कोई स्वर्ण-मानक बेंचमार्क नहीं है। हमें कैरेक्टर-स्तरीय सिस्टम का बेंचमार्क करने के लिए शब्द-स्तरीय बेंचमार्क इस्तेमाल करने पड़े, जो ज़रूरी नहीं कि Cue की पूरी क्षमता दिखाते हों।”
Cue की गुणवत्ता यह भी दिखाती है कि ElevenLabs यूज़र फ़ीडबैक पर कितनी तेज़ी से काम कर सकता है। Cue लॉन्च होने के तुरंत बाद, एक ग्राहक ने टीम को बताया कि जॉर्जियन और कम संसाधनों वाली कुछ अन्य भाषाओं का प्रदर्शन अपेक्षा से खराब था। ElevenLabs अपने प्रोडक्ट्स का उपयोग करने वाली टीमों और ग्राहकों के क़रीब रिसर्च को रखता है। इसलिए हम समस्या को जल्दी पकड़ सके, मॉडल में संभावित सुधारों पर रिसर्च कर सके, मॉडल का नया वर्शन ट्रेन कर सके और उसे रिलीज़ कर सके — ग्राहक द्वारा समस्या बताए जाने के 24 घंटे से भी कम समय में।
गानों को अलाइन करना
संगीत मुश्किल है, क्योंकि गाने में शब्द खिंचते और धुंधले होते हैं, और कुछ ही मॉडल इसे अच्छी तरह कर पाते हैं। टीम को उम्मीद नहीं थी कि Cue इसे इतनी अच्छी तरह संभाल पाएगा। Cue, Creative Commons लाइसेंस वाले JamendoLyrics MultiLang डेटासेट के गानों के एक हिस्से को अलाइन कर पाया। इसने अंग्रेज़ी, फ़्रेंच, स्पैनिश और जर्मन में—एक ही पास में—हैरान करने वाली सटीकता के साथ ऐसा किया। इसने 92.7% शब्दों को लेबल के 0.3 सेकंड के भीतर रखा, जबकि अगले सबसे अच्छे टूल ने 82.0% शब्दों को रखा।
Cue की औसत शुरुआती त्रुटि 0.82 सेकंड थी, जो उसके सबसे नज़दीकी प्रतिस्पर्धी की लगभग आधी थी। 22 में से कम-से-कम 19 गानों पर यह हर दूसरे टूल से ज़्यादा सटीक था। आपके पसंदीदा नए गाने रिलीज़ होने के दिन ही कराओके में गाने की संभावना बहुत बड़ी है।
आज ही Cue आज़माएं
Cue पहले से ही ElevenLabs पर हर स्पीच टू टेक्स्ट ट्रांसक्रिप्शन के पीछे काम कर रहा है। इसे सीधे इस्तेमाल करने के लिए Forced Alignment API आज़माएं।
आभार
ElevenLabs के अलाइनर मॉडलों पर काम कंपनी भर के कई लोगों के बिना संभव नहीं होता। टीम मॉडल के पिछले और नए वर्शन पर काम करने वाले सभी लोगों का धन्यवाद करना चाहती है, जिनमें सह-संस्थापक और CTO Piotr Dąbkowski, शोधकर्ता Danila Kozlov, Luca Lanzendörfer, Flavio Schneider, Max Levi, Tim von Känel और Angelos Perivolaropoulos; साथ ही डेटा ऑपरेशंस में Ani Janelidze, हमारी Forward Deployed Engineer और सपोर्ट टीमें; और इस ब्लॉग के विज़ुअलाइज़ेशन पर काम के लिए Lorenzo Dossi शामिल हैं।
Mike Murphy ElevenLabs ब्लॉग के मुख्य संपादक और लेखक हैं। वे जटिल रिसर्च और टेक्नोलॉजी को स्पष्ट, दिलचस्प कहानियों में बदलते हैं। ElevenLabs से जुड़ने से पहले, उन्होंने Quartz समेत कई जगहों पर टेक्नोलॉजी रिपोर्टर के रूप में वर्षों काम किया और IBM Research में कंटेंट का नेतृत्व किया। उनके पास Northwestern से पत्रकारिता में मास्टर डिग्री है।