
टाइमस्टैंप और इवेंट टैगिंग के साथ ऑडियो ट्रांसक्रिप्शन कैसे काम करता है?
- लेखक
- Jack Limebear
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
नेटिव वर्ड-लेवल ट्रांसक्रिप्शन मॉडल इनपुट के रूप में ऑडियो रिकॉर्डिंग या रीयल-टाइम स्ट्रीम लेता है और भाषण व गैर-भाषण ध्वनियों को दर्शाने वाले टैग किए गए और टाइमस्टैंप वाले टोकन ऑब्जेक्ट्स की एक संरचित ऐरे आउटपुट करता है। हर टोकन तीन प्रकारों में से एक होता है: word, spacing या audio_event। ऑडियो इवेंट्स में हंसी, तालियां या अन्य बैकग्राउंड ध्वनियां हो सकती हैं।
इस लेख में, हम जानेंगे कि टाइमस्टैंप के साथ ऑडियो ट्रांसक्रिप्शन कैसे काम करता है और यह forced alignment पर निर्भर पारंपरिक ट्रांसक्रिप्शन से अधिक लचीला और शक्तिशाली क्यों है।
सारांश
- वर्ड-लेवल ट्रांसक्रिप्शन सीधे भाषण डेटा और गैर-मौखिक ऑडियो इवेंट्स की संरचित, टाइमस्टैंप वाली ऐरे आउटपुट करता है।
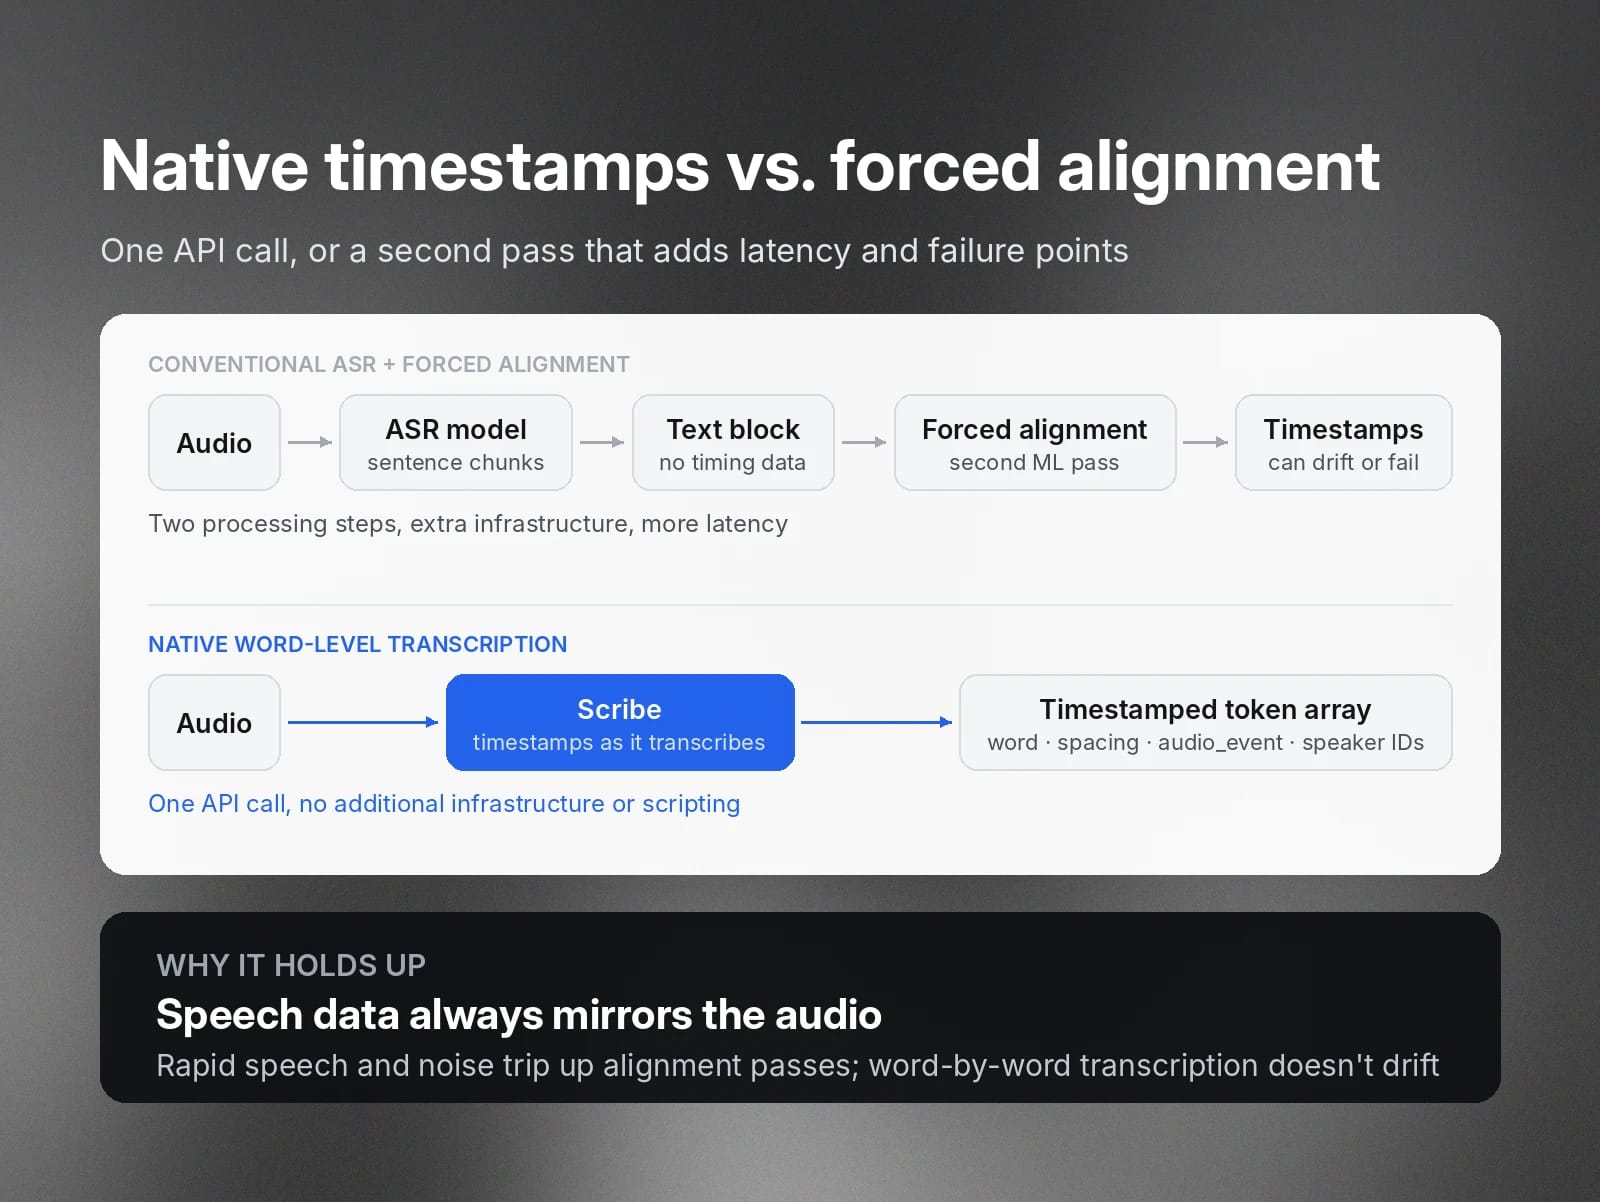
- यह पारंपरिक ऑटोमैटिक स्पीच रिकग्निशन मॉडल से अलग है, जो टेक्स्ट के पूरे ब्लॉक आउटपुट करते हैं। उसे रॉ ऑडियो के साथ टाइमस्टैंप करने के लिए, आपको दूसरा forced-alignment प्रोसेस चलाना पड़ता है, जिसमें अधिक समय और कंप्यूटिंग संसाधन लगते हैं।
- इवेंट टैग्स आपको हंसी या तालियों जैसे गैर-मौखिक कंटेंट को कैप्चर करने में मदद करते हैं। यह डेटा सर्च किया जा सकता है, इसलिए आप ऑडियंस की प्रतिक्रियाओं के आधार पर हाइलाइट्स या वायरल पलों की पहचान कर सकते हैं।
- आप संरचित आउटपुट डेटा को कई उपयोगों के लिए ऐप्लिकेशन्स में भेज सकते हैं, जिनमें बेहद सटीक कैप्शनिंग, सर्च किए जा सकने वाले ऑडियो आर्काइव और ऑटोमेटेड सोशल क्लिपिंग शामिल हैं।
- Scribe का वर्ड-लेवल ट्रांसक्रिप्शन अधिकतम 5 चैनलों को सपोर्ट कर सकता है, जिनमें से हर एक का स्वतंत्र रूप से ट्रांसक्रिप्शन होता है।
टाइमस्टैंप और इवेंट-टैग्स वाला ऑडियो ट्रांसक्रिप्शन क्या है?
टाइमस्टैंप वाला ट्रांसक्रिप्शन ऑटोमैटिक स्पीच रिकग्निशन (ASR) का एक रूप है, जो ट्रांसक्राइब करते समय शब्दों और तालियों जैसे अन्य ऑडियो इवेंट्स के सटीक शुरू और खत्म होने के बिंदुओं को ट्रैक करता है। इसका आउटपुट पूरी तरह संरचित और नेविगेट किया जा सकने वाला डेटा होता है।
पारंपरिक ASR ट्रांसक्रिप्शन ऑडियो को इंसानों द्वारा पढ़े जा सकने वाले टेक्स्ट के बड़े ब्लॉक्स में बदलता है। यह आपको कैप्शन और पाठकों के लिए ट्रांसक्रिप्ट देता है, लेकिन डेटा के रूप में यह बहुत उपयोगी नहीं होता।
अगर आप इसे टाइमस्टैंप के साथ संरचित करना चाहते हैं, तो टेक्स्ट को ऑडियो से मैप करने के लिए आपको इसे एक सेकंडरी मशीन लर्निंग सर्विस से फिर चलाना होगा। आप आखिरकार ऐसा आउटपुट बना सकते हैं, लेकिन यह API से नेटिव रूप से आने के बजाय कई प्रोसेसिंग चरण लेता है, जिससे कुछ लेटेंसी और अतिरिक्त कंप्यूटिंग ओवरहेड जुड़ता है।
ऑडियो में नेविगेशन जोड़ना
टाइमस्टैंप और इवेंट-टैग वाले ट्रांसक्रिप्शन का मुख्य फायदा यह है कि इसे इंसान और मशीन, दोनों पढ़ सकते हैं। इसके कुछ महत्वपूर्ण व्यावसायिक उपयोग हैं:
- अनुपालन ऑडिटिंग: आप ट्रांसक्रिप्शन में कीवर्ड खोज सकते हैं और संवेदनशील डेटा के हर उल्लेख का सटीक टाइमस्टैंप पा सकते हैं।
- वीडियो प्रोडक्शन और एडिटिंग: वीडियो प्रोडक्शन सॉफ़्टवेयर स्क्रीन पर कही जा रही बात के साथ सबटाइटल को मिलीसेकंड तक सिंक्रोनाइज़ कर सकता है। यह ऑडियंस की प्रतिक्रियाओं को सही ढंग से लेबल भी कर सकता है।
- सर्च किए जा सकने वाले आर्काइव: पब्लिक रिलेशंस, सेल्स और ट्रेनिंग टीमें, अन्य टीमों के साथ, ग्राहक इंटरव्यू, ट्रेड शो भाषण, वेबिनार या टाउन हॉल की बड़ी मात्रा को विशाल, सर्च किए जा सकने वाले आर्काइव में ट्रांसक्राइब कर सकती हैं।
- मार्केटिंग एनालिटिक्स और ग्राहक भावना: इवेंट-टैगिंग ऑडियंस की उन प्रतिक्रियाओं को लेबल कर सकती है जो सामान्य टेक्स्ट ट्रांसक्रिप्शन में छूट सकती हैं।
नेटिव वर्ड-लेवल टाइमस्टैंप पाने के क्या फायदे हैं?
मानक स्पीच टू टेक्स्ट मॉडल भाषण को प्रोसेस करते हैं हिस्सों में, आमतौर पर पूरे वाक्यों या पैराग्राफ़ के रूप में। अगर आपको शब्द-दर-शब्द टाइमस्टैंपिंग चाहिए, तो दूसरी पास में forced alignment करने के लिए आपको एक और प्रोसेसिंग लेयर बनानी होगी। इससे इन्फ्रास्ट्रक्चर और लेटेंसी बढ़ती है, साथ ही फेल होने की संभावनाएं भी बढ़ती हैं। उदाहरण के लिए, तेज़ भाषण या तेज़ बैकग्राउंड शोर में दबे भाषण को प्रोसेस करते समय टाइमिंग खिसक सकती है या यह पूरी तरह विफल हो सकता है।
टाइमस्टैंप वाला ट्रांसक्रिप्शन, जैसा Scribe करता है, अधिक बारीकी से शब्द-दर-शब्द ट्रांसक्राइब करके इस समस्या से बचता है। यह एक ही API कॉल में करता है। किसी अतिरिक्त इन्फ्रास्ट्रक्चर या स्क्रिप्टिंग की जरूरत नहीं होती। मॉडल ट्रांसक्राइब करते समय टाइमस्टैंप की गणना करता है, इसलिए भाषण डेटा हमेशा ऑडियो से सटीक रूप से मेल खाता है।
टाइमस्टैंप और इवेंट-टैग वाला ट्रांसक्रिप्शन कैसे काम करता है?
आइए Scribe को उदाहरण के तौर पर लेते हैं।
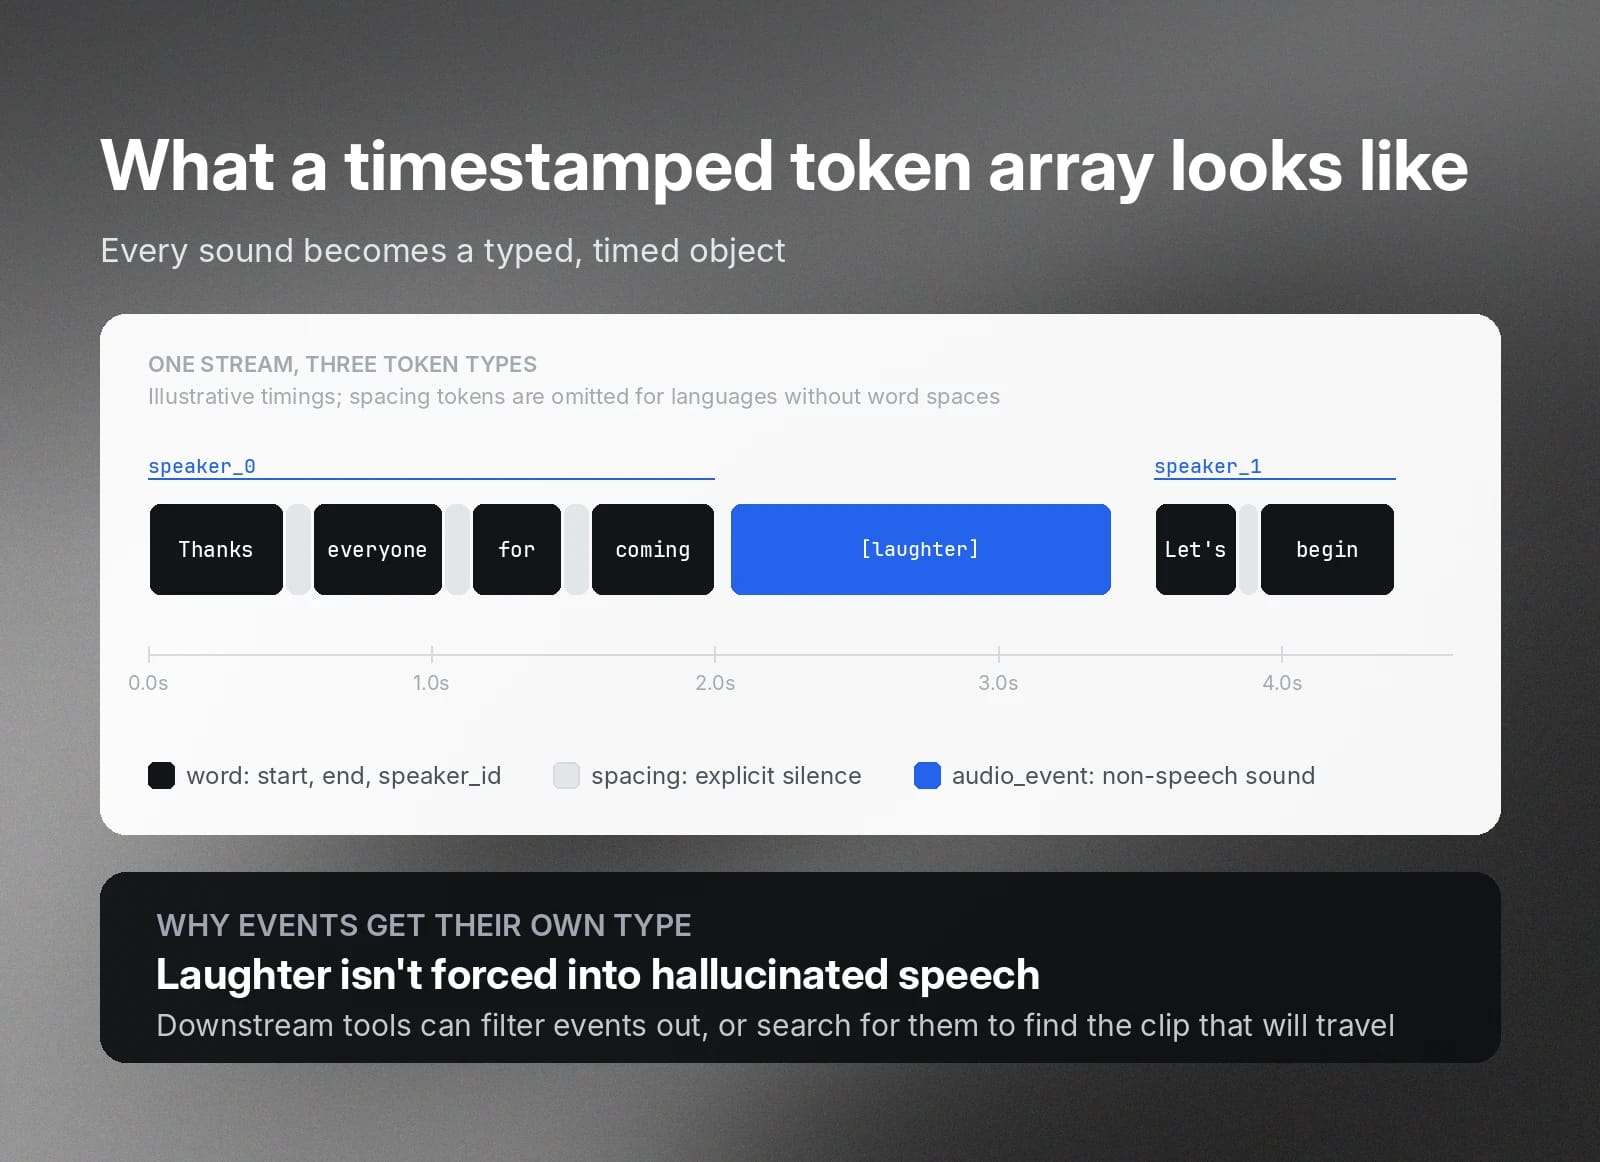
नेटिव वर्ड-लेवल ट्रांसक्रिप्शन मॉडल ऑडियो फ़ीड में मौजूद भाषण ध्वनियों को टोकन ऑब्जेक्ट्स की एक संरचित ऐरे में मैप करता है। यह हर टोकन को तीन में से एक प्रकार के रूप में लेबल करता है: word, spacing या audio_event।
- word: पहचाना गया एक अलग बोला हुआ शब्द, जिसमें शुरू और खत्म होने का समय तथा speaker_id टैग होता है।
- spacing: स्पष्ट रूप से टैग किया गया मौन या बोलते समय का विराम। कैप्शनिंग सर्विसेज़ को सही गति बनाए रखने में मददगार। जापानी, मंदारिन, थाई, लाओ, बर्मी और कैंटोनीज़ जैसी उन पहचानी गई भाषाओं के लिए इस्तेमाल नहीं होता, जिनमें शब्दों के बीच स्पेस नहीं होता।
- audio_event: अर्थपूर्ण गैर-मौखिक ऑडियो, जैसे हंसी या तालियां। मॉडल इन्हें अलग इवेंट प्रकार के रूप में संरचित करता है और ऑडियो को काल्पनिक भाषण में बदलने की कोशिश नहीं करता।
रीयल-टाइम स्ट्रीमिंग पैरामीटर्स
वर्ड-लेवल ट्रांसक्रिप्शन मॉडल लाइव WebSocket ऑडियो ट्रांसक्रिप्शन को सपोर्ट करने के लिए विशेष सुविधाएं भी शामिल कर सकते हैं। उदाहरण के लिए:
- include_timestamps=true: यह पैरामीटर कनेक्शन को हर फ़ाइनलाइज़्ड ऑडियो चंक के अंत में भेजे जाने वाले committed_transcript_with_timestamps JSON मैसेज में वर्ड-लेवल टाइमस्टैंप शामिल करने देता है, ताकि स्ट्रीम चलने के दौरान ही आपको टाइमस्टैंप मिलें। ऑडियो इवेंट टैग्स केवल तभी शामिल होते हैं जब tag_audio_events भी सक्षम हो।
- include_language_detection=true: यह पैरामीटर कनेक्शन को मॉडल के डिटेक्शन कॉन्फिडेंस स्कोर के साथ पहचानी गई अलग-अलग बोली जाने वाली भाषाओं को टैग करने के लिए कहता है। इससे आप लाइव मल्टी-लैंग्वेज कैप्शनिंग चला सकते हैं।
स्पीच टू टेक्स्ट मॉडल गैर-भाषण इवेंट्स को कैसे टैग करता है?
जब आप tag_audio_events पैरामीटर सक्षम करते हैं, तो Scribe ऑडियो इवेंट्स को टैग करेगा। यह शब्दों की तरह ही उनके सटीक शुरू और खत्म होने के समय को टैग और टाइमस्टैंप करेगा। यह कई तरह की प्रतिक्रियाओं को टैग कर सकता है, जिनमें सबसे आम हंसी और तालियां हैं, साथ ही संदर्भ के अनुसार अर्थपूर्ण अन्य परिवेशी ध्वनियां भी, जैसे कदमों की आहट या बैकग्राउंड संगीत।
सीधे तौर पर, यह महत्वपूर्ण संदर्भ जोड़कर ट्रांसक्रिप्ट और कैप्शनिंग को अधिक समृद्ध बनाता है। साधारण, सपाट टेक्स्ट पढ़ते समय पाठक के लिए व्यंग्य समझना कठिन हो सकता है। [laughter] टैग ट्रांसक्रिप्ट को समृद्ध बनाता है और उसे भावनात्मक रूप से अधिक असरदार बनाता है।
बेहतर एनालिटिक्स
इवेंट टैगिंग आपके द्वारा चलाए जाने वाले डाउनस्ट्रीम एनालिटिक्स को भी साफ़-सुथरा बनाती है, क्योंकि उन टूल्स को असंरचित टेक्स्ट के एक ब्लॉक को पार्स नहीं करना पड़ता। नेटिव वर्ड-लेवल ट्रांसक्रिप्शन ऑडियो इवेंट्स को संरचित डेटा के रूप में अलग करता है, इसलिए आपके टूल्स जरूरत पड़ने पर उन्हें फ़िल्टर कर सकते हैं और केवल मौखिक कंटेंट पर काम कर सकते हैं।
spacing टोकन विरामों को दिखाते हैं, इसलिए आप उनका विश्लेषण कर सकते हैं। यह सेंटिमेंट एनालिसिस और QA के उपयोगों में उपयोगी हो सकता है, जैसे किसी कॉल के दौरान कस्टमर सर्विस एजेंट कितनी देर चुप रहा।
टाइमस्टैंप खोजना आसान
या आप उन्हें खास तौर पर खोज सकते हैं। अगर आप किसी प्रोडक्ट टेस्टिंग इंटरव्यू पर सेंटिमेंट एनालिसिस कर रहे हैं, तो आप अर्थपूर्ण भावनात्मक प्रतिक्रियाएं अलग से निकाल सकते हैं। या अगर आप सोशल अकाउंट चला रहे हैं, तो एक घंटे के भाषण में हंसी खोजकर उन क्लिप्स को जल्दी ढूंढ सकते हैं जिनके वायरल होने की संभावना सबसे अधिक लगती है।
संरचित, टाइमस्टैंप वाले ट्रांसक्रिप्ट के व्यावहारिक उपयोग क्या हैं?
ट्रांसक्रिप्शन में नेटिव रूप से संरचित डेटा मिलने के कई महत्वपूर्ण उपयोग हैं।
कैप्शन और सबटाइटल जनरेशन
आप टाइमस्टैंप वाले ट्रांसक्रिप्ट को बिना किसी मध्यवर्ती प्रोसेसिंग के सीधे SRT और VTT सहित प्रोडक्शन कैप्शनिंग फ़ॉर्मैट में एक्सपोर्ट कर सकते हैं। आपका वीडियो एडिटिंग टूल बोले जाते समय कैप्शन में शब्दों को हाइलाइट करने के लिए शब्दों की टाइमिंग का इस्तेमाल कर सकता है।
ट्रांसक्रिप्शन मॉडल तेज़ भाषण को आसानी से पार्स कर सकता है, क्योंकि यह उसे शब्द-दर-शब्द प्रोसेस करता है। जहां पारंपरिक मॉडल बहुत तेज़ भाषण या एक-दूसरे पर चढ़ती आवाज़ों पर अटक सकता है, वहीं Scribe जैसा वर्ड-लेवल मॉडल साफ़ और संरचित ट्रांसक्रिप्शन आउटपुट कर सकता है।
ऑडियो और वीडियो खोज
पारंपरिक ट्रांसक्रिप्शन आपको टेक्स्ट ब्लॉक में कीवर्ड मैच करने देता है, लेकिन forced alignment के बिना आप उस क्षण पर नहीं जा सकते जब कोई वाक्यांश बोला गया था। वर्ड-लेवल ट्रांसक्रिप्शन पर कीवर्ड खोज पूरी तरह इंडेक्स्ड होती है और आपको ऑडियो में उस सटीक सेकंड पर ले जाती है जब वाक्यांश बोला गया था। इससे आपका ऑडियो आर्काइव प्रभावी रूप से पूरी तरह सर्च किया जा सकने वाला रेफ़रेंस कैटलॉग बन जाता है। यह क्षमता बड़ी मीडिया लाइब्रेरी, पॉडकास्ट नेटवर्क और कॉर्पोरेट आर्काइव मैनेज करने में खास तौर पर उपयोगी है।
अनुपालन और जोखिम ऑडिटिंग
कई बार आप संवेदनशील जानकारी वाले ऑडियो को रिकॉर्ड करना चाहेंगे, उदाहरण के लिए QA के लिए कस्टमर सर्विस कॉल रिकॉर्ड करना। इन कॉल्स में संवेदनशील या विनियमित व्यक्तिगत जानकारी होने की संभावना सबसे अधिक हो सकती है।
एनालिटिक्स के लिए ऑडियो डेटा रखते हुए भी अनुपालन में बने रहने के लिए, आपको रीयल टाइम में ट्रांसक्रिप्ट से संवेदनशील डेटा हटाने का तरीका चाहिए। नेटिव वर्ड-लेवल टाइमस्टैंपिंग आपको ElevenLabs' एंटिटी डिटेक्शन जैसी सुविधाओं का लाभ लेने देता है, जो संवेदनशील एंटिटीज़ (जैसे क्रेडिट कार्ड नंबर या नाम) को फ़्लैग करती है और उनके ऑफ़सेट व टाइमस्टैंप लौटाती है, ताकि स्ट्रीम होने के दौरान आप उन्हें अपने ट्रांसक्रिप्ट में छिपा सकें।
उदाहरण के लिए, पहचान सत्यापित करने वाली कॉल पर बोलते समय आप क्रेडिट कार्ड नंबर, मां का विवाह-पूर्व उपनाम, जन्मतिथि और ग्राहक का नाम पहचानकर हटा सकते हैं।
ऑटोमेटेड सोशल मीडिया क्लिपिंग
लंबे कंटेंट में हाइलाइट्स ढूंढने के लिए आप कीवर्ड खोजों को प्रोग्राम के ज़रिए ऑटोमेट भी कर सकते हैं। उदाहरण के लिए, आप किसी चुनावी भाषण या कॉर्पोरेट सेमिनार के महत्वपूर्ण पलों को हाइलाइट कर सकते हैं। इससे आप हालिया कंटेंट को YouTube, LinkedIn या TikTok के लिए प्रोफेशनल ढंग से एडिट किए गए हाइलाइट्स में बदल सकते हैं।
मल्टीचैनल और मल्टी-स्पीकर टाइमिंग
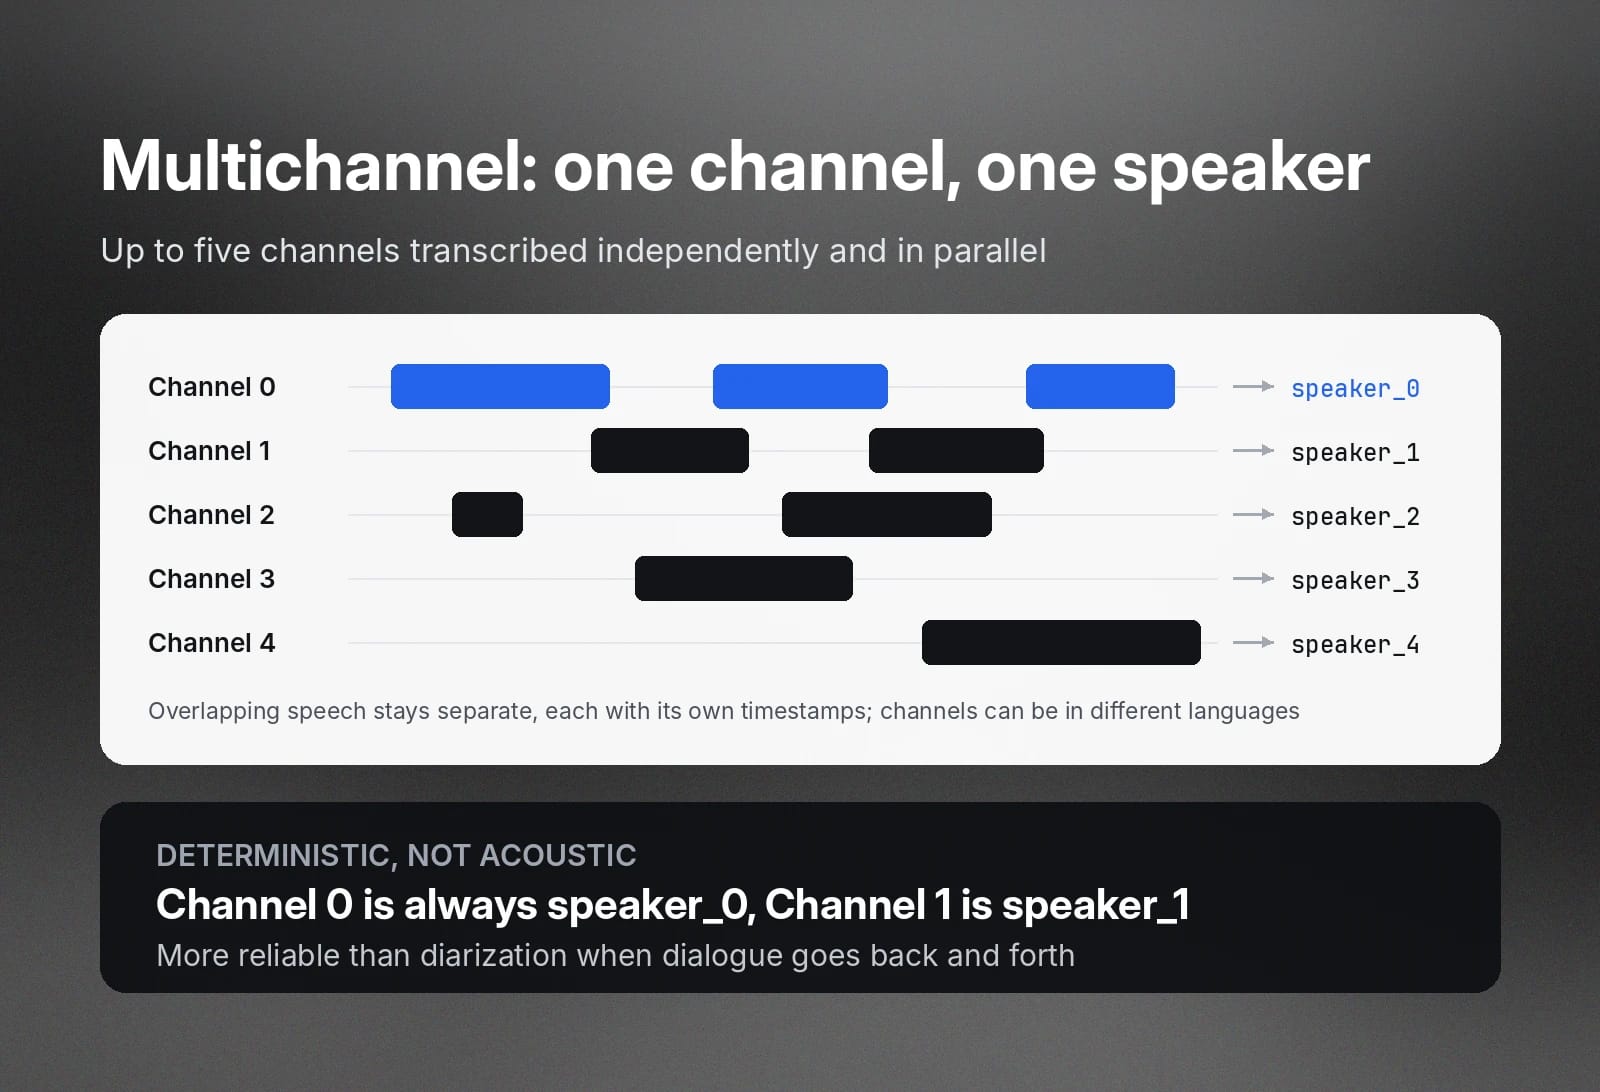
Scribe पांच चैनलों तक को स्वतंत्र और समानांतर रूप से ट्रांसक्राइब कर सकता है। हर चैनल को एक स्पीकर ID और टाइमस्टैंपिंग मिलती है। यह मानक अकॉस्टिक स्पीकर डायरीकरण से अधिक भरोसेमंद है, जिसे अक्सर बारी-बारी होने वाले संवाद में मुश्किल आती है। मल्टीचैनल रिकॉर्डिंग के लिए Scribe का स्पीकर असाइनमेंट पूरी तरह निर्धारित होता है। यानी चैनल 0 speaker_0 से, चैनल 1 speaker_1 से मैप होता है, और इसी तरह आगे।
यह एक साथ बोलने की कोशिश कर रहे स्पीकर्स को पहचान सकता है और फिर भी उनके भाषण के लिए स्वतंत्र टाइमस्टैंप जनरेट कर सकता है। वे अलग-अलग भाषाओं में भी बोल सकते हैं।
ज़रूरत के फ़ॉर्मैट में टाइमस्टैंप वाला डेटा एक्सपोर्ट करना
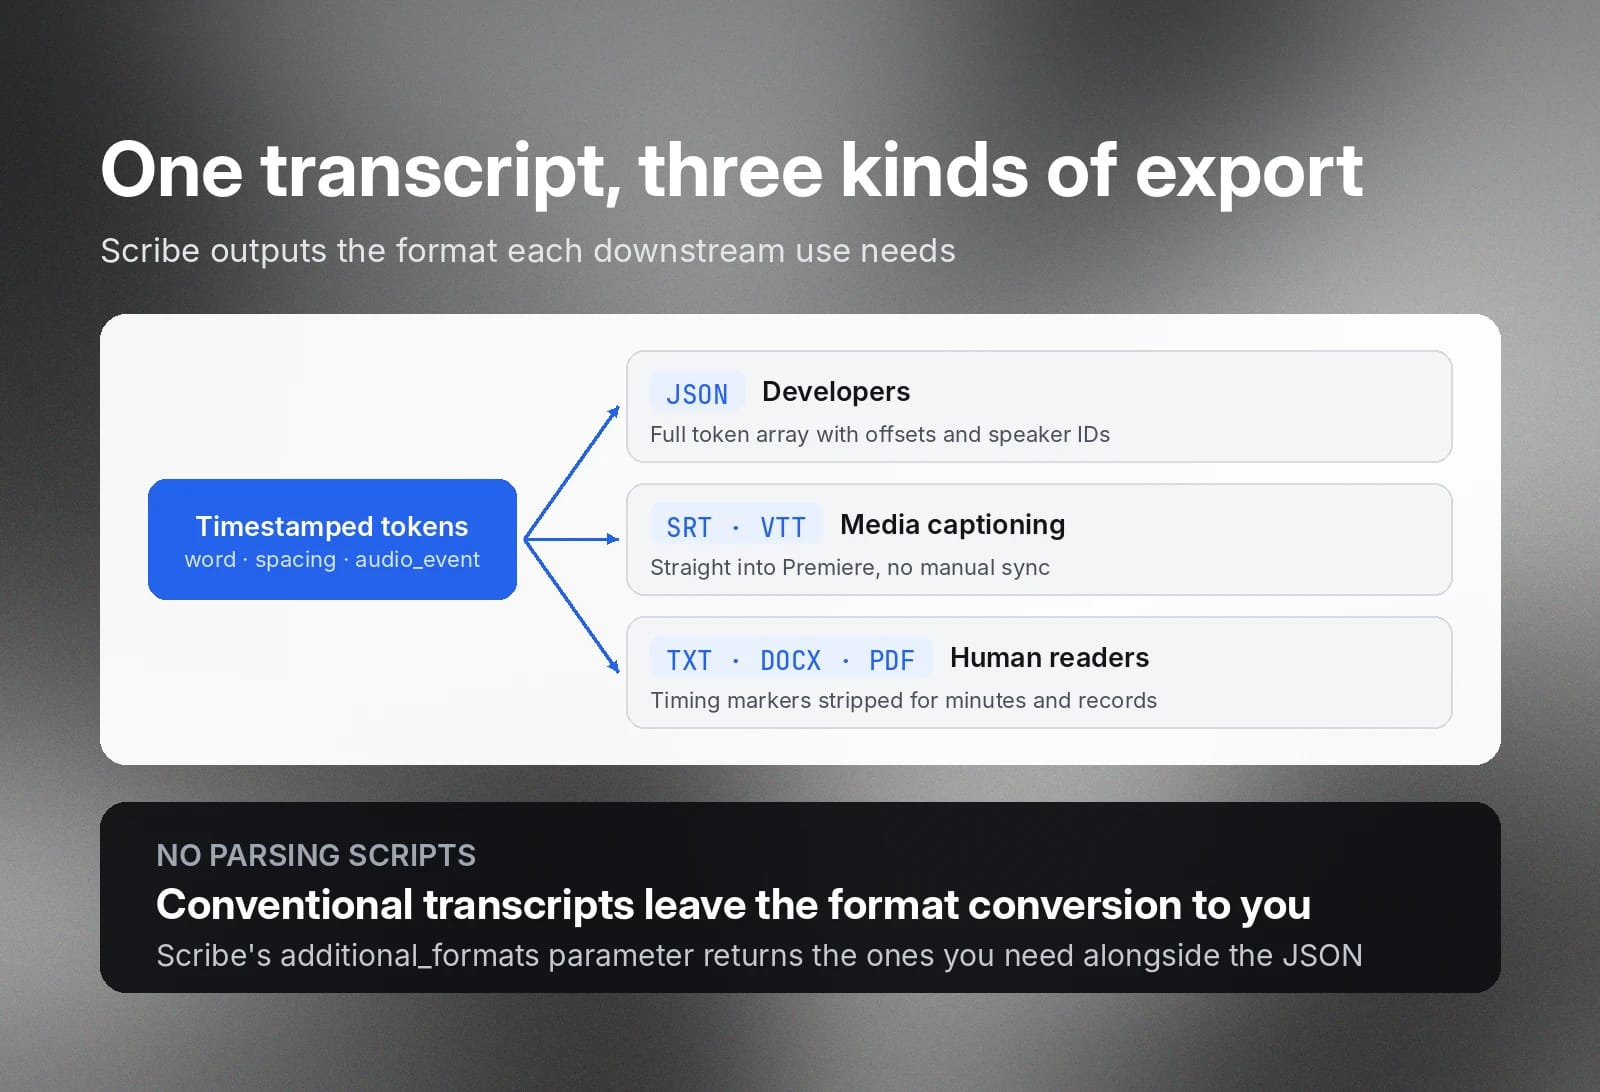
अगर आप पारंपरिक ट्रांसक्रिप्शन को कई फ़ॉर्मैट में बांटना चाहते हैं, तो संभवतः आपको पार्सिंग स्क्रिप्ट खुद लिखनी होगी। Scribe आपके इस्तेमाल के आधार पर ट्रांसक्रिप्शन को कई फ़ॉर्मैट में एक्सपोर्ट कर सकता है। आपको पूरे स्कीमा की परिभाषाएं ElevenLabs Create Transcript API रेफरेंस में मिल सकती हैं।
डेवलपर्स के लिए संरचित डेटा: JSON
Scribe उन डेवलपर्स के लिए JSON में एक्सपोर्ट को सपोर्ट करता है जो डेटा को ऐसे स्कीमा में चाहते हैं जिसे वे डाउनस्ट्रीम ऐप्लिकेशन्स को भेज सकें। उदाहरण के लिए, डेवलपर्स इस JSON डेटा से इंटरैक्टिव मीडिया या अपने संगठन के लिए सेमांटिक सर्च डेटाबेस बना सकते हैं। word, spacing और audio_event टोकन्स की पूरी ऐरे शुरू और खत्म होने के ऑफ़सेट व स्पीकर IDs के साथ आउटपुट होती है।
मीडिया कैप्शनिंग: SRT और VTT
Scribe SRT और VTT ट्रांसक्रिप्ट आउटपुट कर सकता है, जिन्हें आप मैन्युअल सिंक्रोनाइज़ेशन के बिना सीधे Adobe Premiere या अन्य प्रोडक्शन ऐप्लिकेशन्स में डाल सकते हैं।
पढ़ने योग्य: TXT, DOCX और PDF
यह पाठक के अनुकूल फ़ॉर्मैट में भी ट्रांसक्रिप्ट आउटपुट कर सकता है। इन फ़ॉर्मैट में, Scribe टेक्स्ट को अधिक पढ़ने योग्य और कानूनी या ऑडिट दस्तावेज़ों के लिए उपयुक्त बनाने के लिए लो-लेवल टाइमिंग मार्कर्स हटा देता है। उदाहरण के लिए, यह तब उपयोगी है जब आपको किसी सेशन के तुरंत बाद बोर्ड मीटिंग के मिनट्स कुशलता से बांटने हों, SEO के लिए पॉडकास्ट ट्रांसक्रिप्ट प्रकाशित करने हों या कानूनी रिकॉर्ड आर्काइव करने हों।
ElevenLabs के टाइमस्टैंप और इवेंट-टैग वाले ट्रांसक्रिप्शन का इस्तेमाल शुरू करें
नेटिव वर्ड-लेवल ट्रांसक्रिप्शन आपको अपने वर्कफ़्लो के लिए जरूरी संरचित डेटा तेज़ी से और कुशलता से देता है।
आज ही ElevenAPI में Scribe के साथ अपना ऑडियो ट्रांसक्राइब करना शुरू करें या वर्ड-लेवल ट्रांसक्रिप्शन के बारे में और जानें।
टाइमस्टैंप और इवेंट-टैग वाले ट्रांसक्रिप्शन के सामान्य सवाल

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।


