
स्पीकर डायराइज़ेशन क्या है? यह कैसे काम करता है और इसके उपयोग
- लेखक
- Jack Limebear
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
स्पीकर डायरीकरण अज्ञात संख्या में वक्ताओं वाली ऑडियो स्ट्रीम लेता है और लेबल किए गए सेगमेंट की टाइमलाइन बनाता है: 0:00 से 0:42 तक वक्ता A, 0:42 से 1:15 तक वक्ता B, और 1:15 के बाद फिर वक्ता A। सिस्टम यह नहीं जानता कि वक्ता कौन हैं, लेकिन यह जानता है कि वे अलग-अलग लोग हैं और पूरी रिकॉर्डिंग में उनके लेबल एक जैसे रखता है।
यही प्रक्रिया कई वक्ताओं वाले ऑडियो को उपयोगी बनाती है। मीटिंग नोट्स, कॉल सेंटर एनालिटिक्स, इंटरव्यू ट्रांसक्रिप्शन, पॉडकास्ट एडिटिंग और कानूनी रिकॉर्ड—इन सभी के लिए सिर्फ़ क्या कहा गया, यह नहीं बल्कि किसने कहा, यह जानना भी ज़रूरी है।
इस गाइड में बताया गया है कि डायरीकरण कैसे काम करता है, यह सेगमेंटेशन और आइडेंटिफिकेशन जैसी संबंधित तकनीकों से कैसे अलग है, कौन-से ओपन सोर्स टूल इसे संभालते हैं और कैसे मापें कि डायरीकरण सिस्टम अच्छा प्रदर्शन कर रहा है या नहीं।
सारांश
- स्पीकर डायरीकरण किसी ऑडियो रिकॉर्डिंग को यह देखकर सेगमेंट करता है कि कौन बोल रहा है, और किसी की पहचान नाम से किए बिना लेबल किए गए स्पीकर टर्न बनाता है।
- स्पीकर डायरीकरण, स्पीकर सेगमेंटेशन से अलग है, जो वक्ता बदलने का समय ढूंढता है, और स्पीकर आइडेंटिफिकेशन से भी, जो आवाज़ों को असली नामों से मिलाता है।
- डायरीकरण के प्रदर्शन को समग्र सटीकता के लिए डायरीकरण त्रुटि दर (DER) और हर वक्ता के लिए सटीकता बनी रहती है या नहीं, यह जांचने के लिए जैकार्ड त्रुटि दर (JER) से मापा जाता है।
स्पीकर डायरीकरण क्या है और यह कैसे काम करता है?
स्पीकर डायरीकरण किसी ऑडियो स्ट्रीम को कौन बोल रहा है उसके आधार पर सेगमेंट में बांटने की प्रक्रिया है। स्पीकर डायरीकरण वाला ट्रांसक्रिप्ट ऑडियो के हर सेगमेंट को एक स्पीकर पहचान से लेबल करता है। सरल शब्दों में, यह सवाल का जवाब देता है: "किसने कब बोला?"
मीटिंग का रॉ ट्रांसक्रिप्ट आपको शब्द देता है, जबकि डायरीकृत ट्रांसक्रिप्ट बताता है कि वक्ता 1 ने सवाल पूछा, वक्ता 2 ने उसका जवाब दिया और वक्ता 3 ने बीच में टोक दिया।
ज़्यादातर स्पीकर डायरीकरण सिस्टम चार चरणों वाली पाइपलाइन का पालन करते हैं:
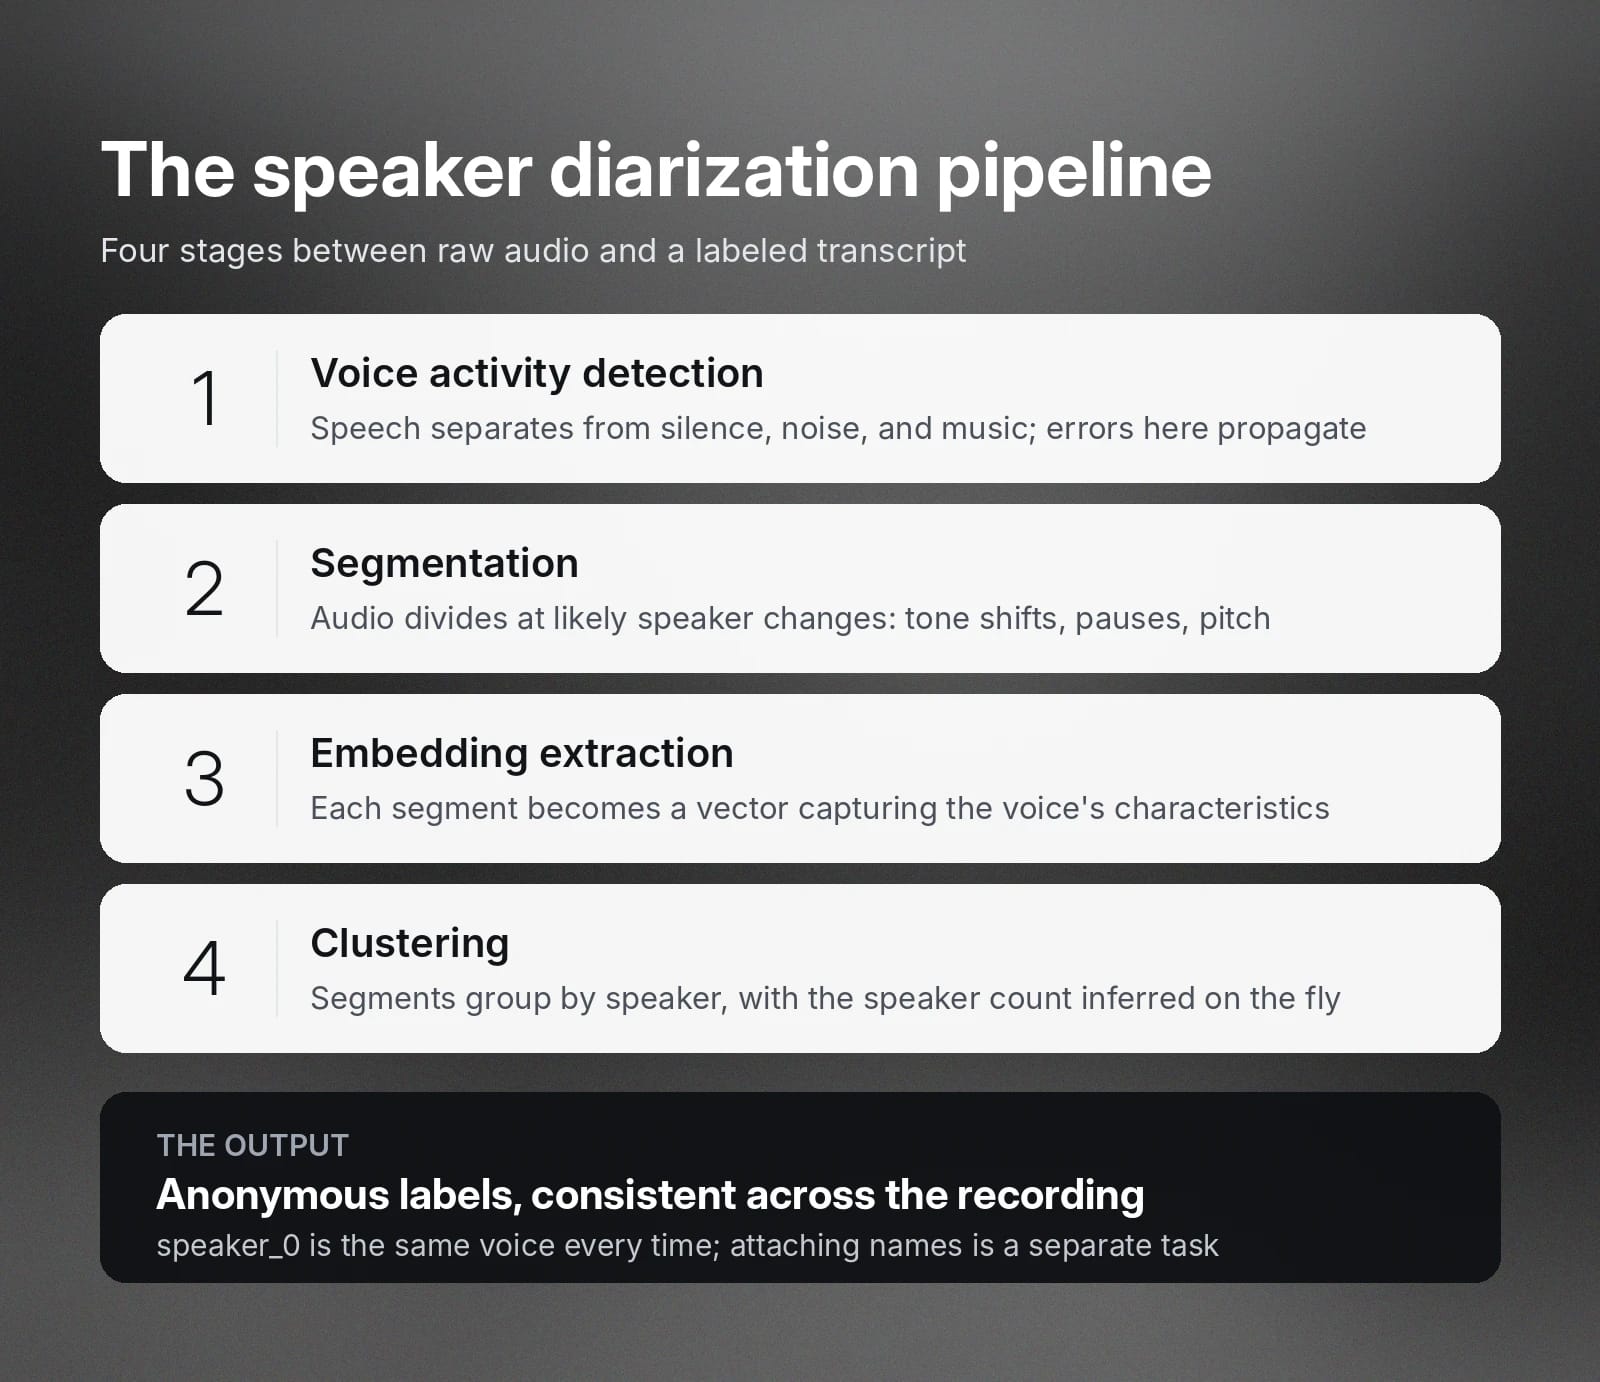
आइए इन चरणों को विस्तार से समझें।
वॉइस एक्टिविटी डिटेक्शन (VAD)
वॉइस एक्टिविटी डिटेक्शन बोलने की आवाज़ को बाकी हर चीज़ से अलग करता है: खामोशी, बैकग्राउंड शोर, संगीत या कीबोर्ड की क्लिक। सिर्फ़ असली बोलने की आवाज़ वाले ऑडियो सेगमेंट अगले चरण में जाते हैं।
इस चरण में कोई भी त्रुटि आगे के सभी चरणों में फैल जाएगी।
सेगमेंटेशन
बोलने की आवाज़ वाले उन सेगमेंट को फिर उन बिंदुओं पर बांटा जाता है जहां वक्ता बदलने की संभावना होती है, जैसे आवाज़ के स्वर में बदलाव, टर्न के बीच का विराम या पिच पैटर्न में बदलाव। ज़्यादातर सिस्टम संभावित सीमा के दोनों ओर की ध्वनिक विशेषताओं की तुलना करके इन चेंज पॉइंट्स का सीधे पता लगाते हैं।
कुछ सेगमेंटेशन टूल ऑडियो को छोटे एकसमान विंडो में काटते हैं, जैसे दो-सेकंड के हिस्से, और फिर एक ही वक्ता की आस-पास की विंडो को मिलाने के लिए क्लस्टरिंग चरण पर निर्भर करते हैं।
एम्बेडिंग एक्सट्रैक्शन
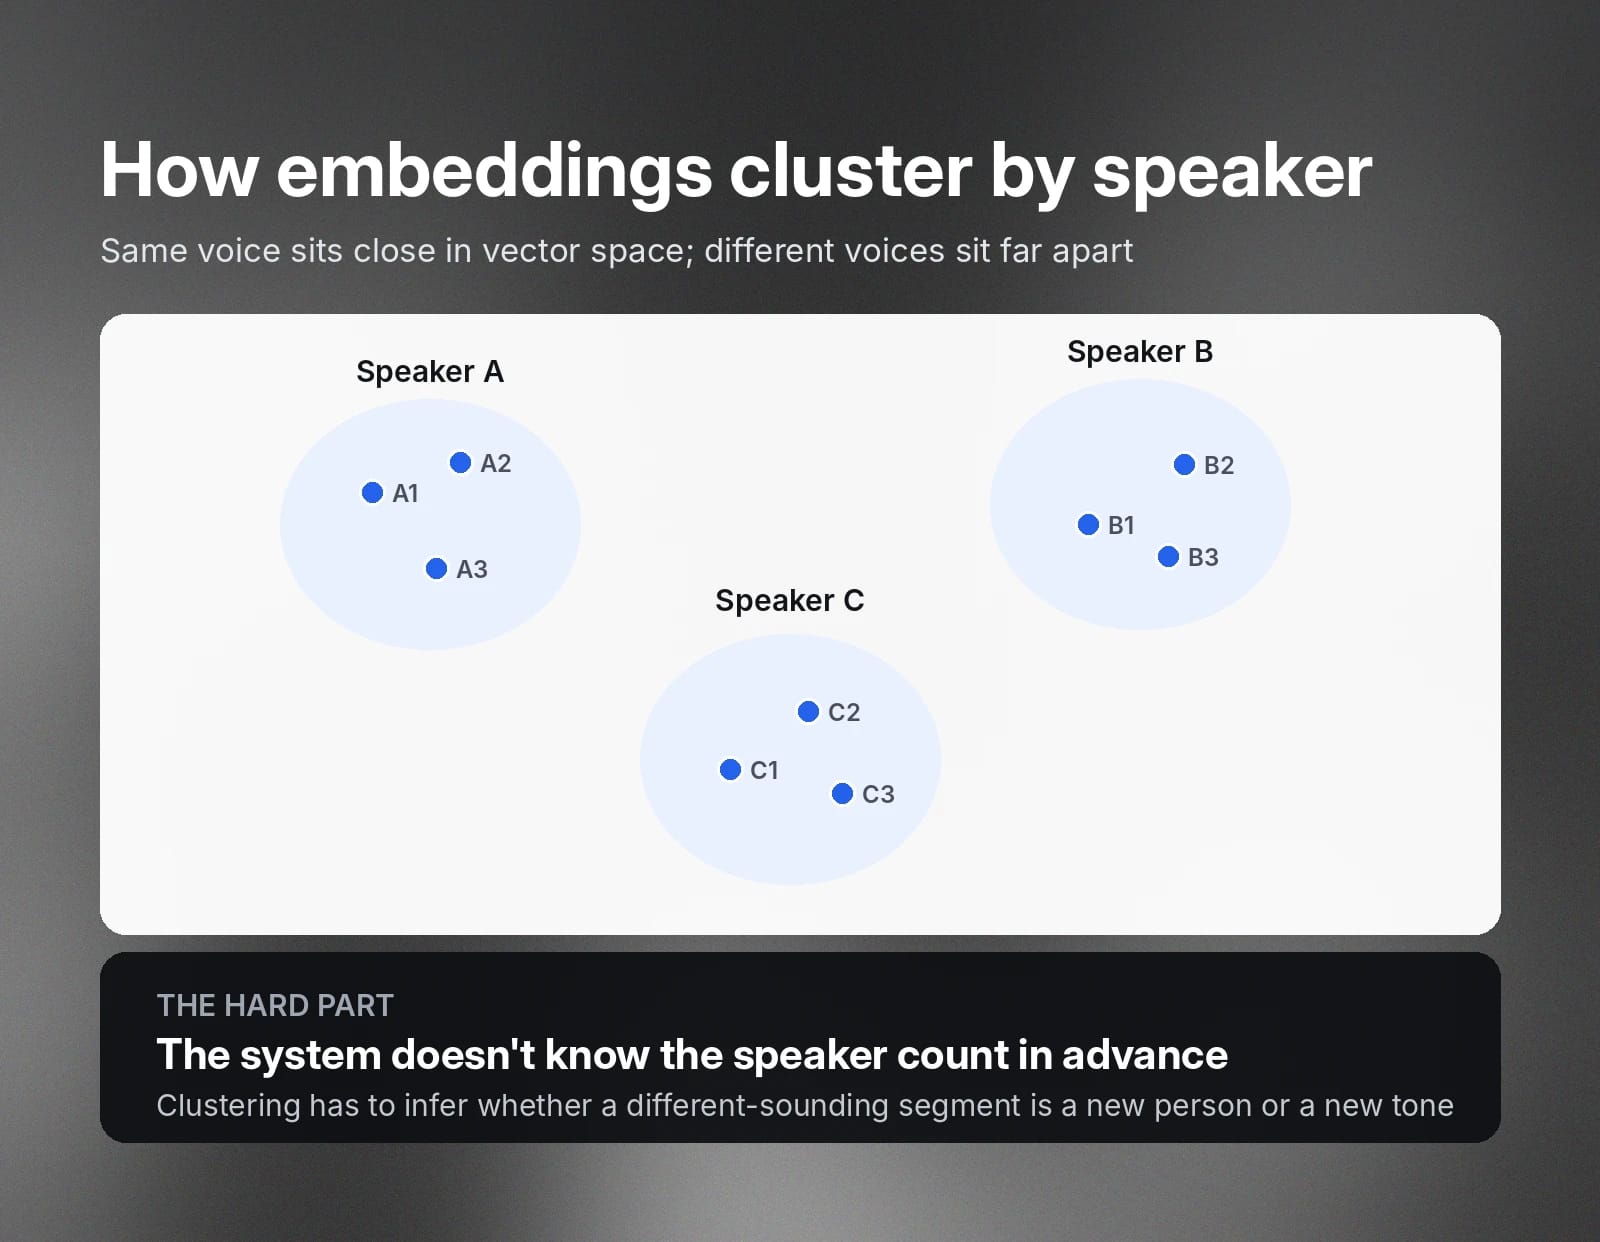
हर स्पीच सेगमेंट को स्पीकर एम्बेडिंग या संख्यात्मक वेक्टर में बदला जाता है, जो उस सेगमेंट में बोल रहे व्यक्ति की आवाज़ की विशेषताओं को कैप्चर करता है। एक ही वक्ता की एम्बेडिंग वेक्टर स्पेस में पास-पास क्लस्टर होती हैं, जबकि अलग-अलग वक्ताओं की एम्बेडिंग दूर होती हैं।
क्लस्टरिंग
फिर एम्बेडिंग को इस तरह ग्रुप किया जाता है कि एक ही वक्ता के सेगमेंट का लेबल एक हो। सिस्टम को आमतौर पर पहले से वक्ताओं की संख्या नहीं पता होती, इसलिए क्लस्टरिंग एल्गोरिदम को इसका अनुमान लगाना पड़ता है और तय करना होता है कि थोड़ा अलग सुनाई देने वाला सेगमेंट नया वक्ता है या अलग टोन में बोल रहा वही व्यक्ति।
आउटपुट टाइम रेंज से जुड़े स्पीकर लेबल का एक सेट होता है, जिसे आमतौर पर ट्रांसक्रिप्ट के साथ जोड़ा जाता है। उदाहरण के लिए, दो लोगों की कॉल का डायरीकृत ट्रांसक्रिप्ट ऐसा दिखता है:
- [speaker_0] कॉल करने के लिए धन्यवाद। मैं आपकी कैसे मदद कर सकता हूँ?
- [speaker_1] नमस्ते, मैं पिछले महीने के अपने इनवॉइस के बारे में कॉल कर रहा हूँ।
- [speaker_0] ज़रूर, मैं उसे खोलता हूँ।
लेबल गुमनाम होते हैं और आंतरिक रूप से एक जैसे रहते हैं। Speaker_0 जब भी दिखाई देता है, वह वही आवाज़ होती है, लेकिन सिस्टम नहीं जानता कि speaker_0 का नाम Fergal है। असली पहचान जोड़ना अलग काम है, जिसकी चर्चा हम नीचे करेंगे।
स्पीकर सेगमेंटेशन और स्पीकर आइडेंटिफिकेशन के बीच मुख्य अंतर
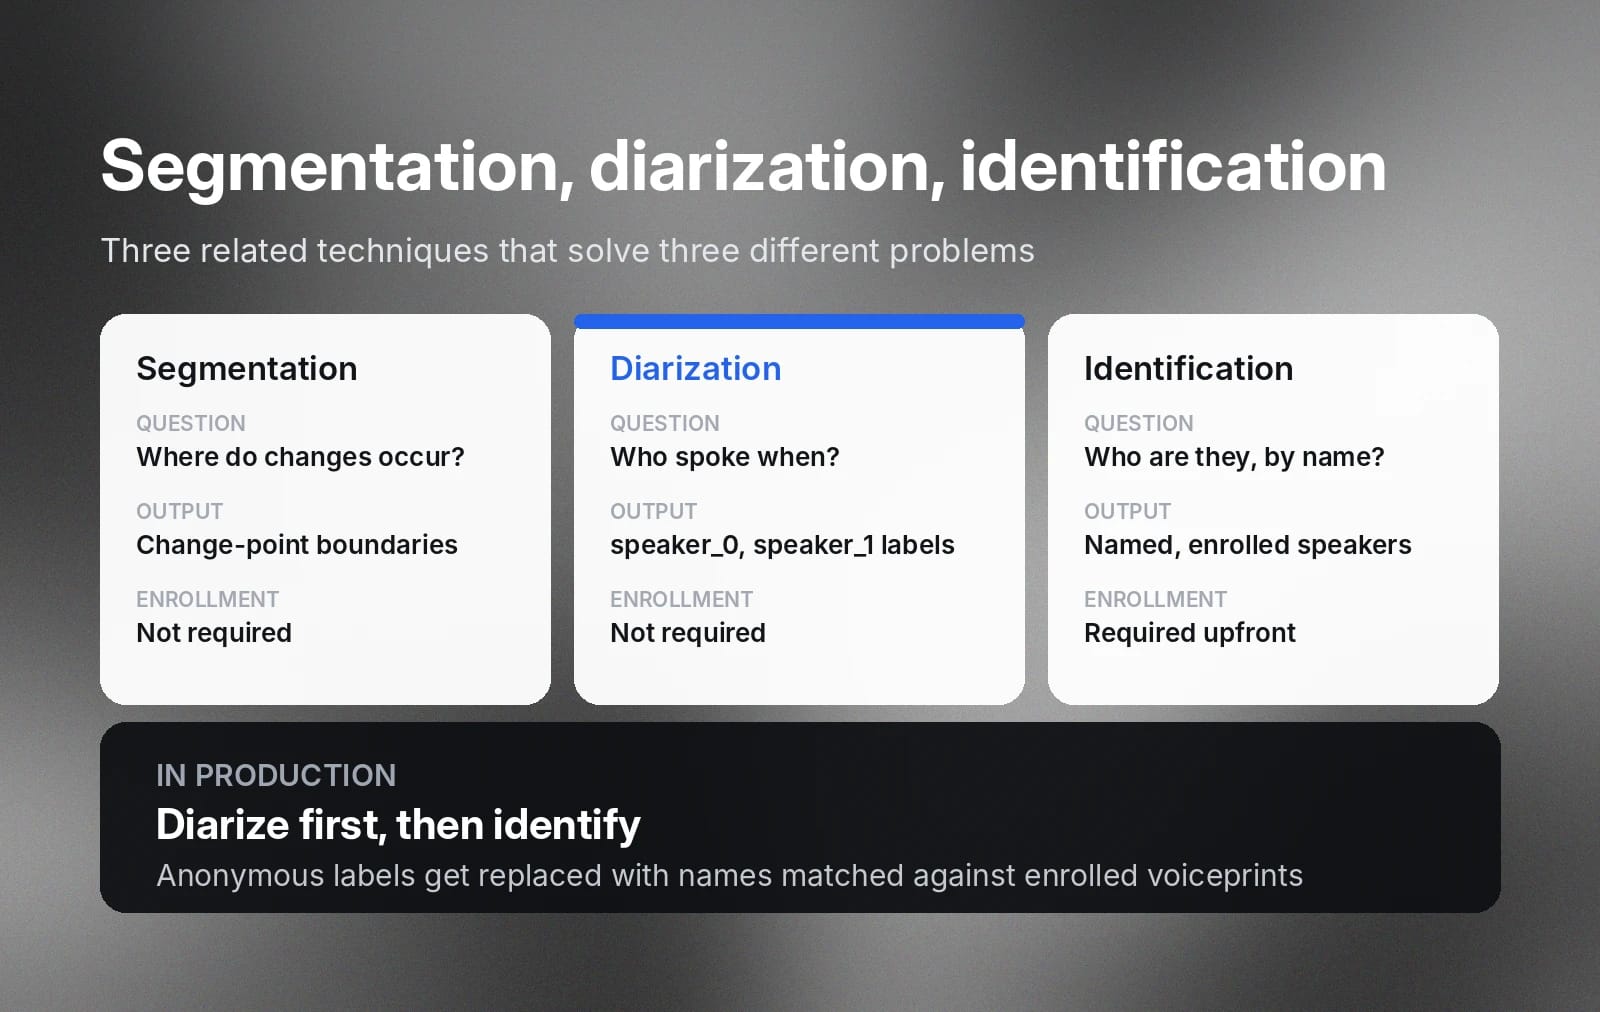
स्पीकर सेगमेंटेशन और स्पीकर आइडेंटिफिकेशन, दोनों डायरीकरण से काफ़ी हद तक जुड़े हैं, इसलिए अक्सर इन तीनों को एक-दूसरे के साथ गड्डमड्ड कर दिया जाता है।
हर एक थोड़ी अलग समस्या हल करता है, इसलिए टूलिंग का आकलन करते समय अंतर समझना ज़रूरी है।
जैसा कि हमने पहले बताया, स्पीकर सेगमेंटेशन डायरीकरण का एक चरण है जो पाइपलाइन में शुरुआत में होता है। यह बिना लेबल दिए उन सीमाओं को ढूंढता है जहां वक्ता एक आवाज़ से दूसरी आवाज़ में बदलता है। सेगमेंटेशन आपको बताता है कि 0:42 पर बदलाव हुआ। डायरीकरण इस पर आगे बढ़ते हुए बने हुए सेगमेंट को ग्रुप करता है और पूरी तरह लेबल किया हुआ आउटपुट देता है, जिससे आपको पता चलता है कि 1:15 पर सुनाई देने वाली आवाज़ वही है जो रिकॉर्डिंग की शुरुआत में बोल रही थी।
स्पीकर आइडेंटिफिकेशन, डायरीकरण से अलग क्षमता है, लेकिन इसे अक्सर उसके साथ जोड़ा जाता है। आइडेंटिफिकेशन तय करता है कि वे वक्ता वास्तव में कौन हैं। आइडेंटिफिकेशन सिस्टम आवाज़ों की नामांकित वॉइसप्रिंट्स से तुलना करता है और ज्ञात वक्ताओं के रेफरेंस का उपयोग करके पहचान लौटाता है। आइडेंटिफिकेशन के बाद speaker_0 और speaker_1, "Fergal" और "Eric" बन जाते हैं।
ज़्यादा व्यापक अंतिम ट्रांसक्रिप्ट बनाने के लिए कई प्रोडक्ट इन टूल्स को मिलाते हैं। कोई मीटिंग टूल यह काम अपने-आप कर सकता है (मुमकिन है कि Teams या Meet में किसी व्यक्ति के सेट किए गए नाम जैसी स्ट्रिंग से भी जानकारी ले) ताकि बिना मैन्युअल रिव्यू के हर प्रतिभागी का योगदान नाम से जोड़ा जा सके।
लोकप्रिय ओपन सोर्स स्पीकर डायरीकरण टूल और लाइब्रेरी
जब आपको नियंत्रण, लचीलापन या लोकल डिप्लॉयमेंट चाहिए, तो ओपन सोर्स स्पीकर डायरीकरण टूल पर विचार करना उपयोगी है। सबसे अच्छा विकल्प आपके ऑडियो के प्रकार (फ़ोन कॉल, मीटिंग, पॉडकास्ट, ब्रॉडकास्ट), लेटेंसी की ज़रूरतों और आपके उपलब्ध इंजीनियरिंग समय पर निर्भर करता है।
यहां कुछ सबसे लोकप्रिय विकल्प दिए गए हैं।
Pyannote.audio
Pyannote.audio स्पीकर डायरीकरण के लिए खास तौर पर बनाया गया PyTorch-आधारित टूलकिट है और सबसे ज़्यादा इस्तेमाल किए जाने वाले ओपन सोर्स विकल्पों में से एक है। यह VAD, सेगमेंटेशन, एम्बेडिंग और क्लस्टरिंग सहित पूरे डायरीकरण स्टैक को कवर करने वाली प्रीट्रेन्ड पाइपलाइन देता है, साथ ही अपने डेटा पर मॉडल ट्रेन या फाइन-ट्यून करने के लिए बिल्डिंग ब्लॉक भी देता है।
इसके प्रीट्रेन्ड मॉडल Hugging Face के ज़रिए वितरित होते हैं और बड़े ट्रांसक्रिप्शन प्रोजेक्ट्स में आमतौर पर डायरीकरण लेयर के रूप में इस्तेमाल किए जाते हैं।
WhisperX
WhisperX OpenAI के Whisper ASR को डायरीकरण और फोर्स्ड अलाइनमेंट के साथ जोड़ता है। Whisper अपने-आप में अच्छे ट्रांसक्रिप्ट बनाता है, लेकिन स्पीकर लेबल नहीं देता और इसके टाइमस्टैम्प केवल अनुमानित होते हैं। WhisperX शब्द-स्तर का टाइमस्टैम्प अलाइनमेंट जोड़ता है और pyannote-आधारित डायरीकरण इंटीग्रेट करता है, जिससे ऐसे ट्रांसक्रिप्ट बनते हैं जिनमें हर शब्द के साथ सटीक टाइमस्टैम्प और स्पीकर लेबल दोनों होते हैं।
NVIDIA NeMo
NVIDIA NeMo अपने व्यापक कन्वर्सेशनल AI फ्रेमवर्क के हिस्से के रूप में डायरीकरण शामिल करता है। यह ओवरलैपिंग स्पीच संभालने वाले एंड-टू-एंड तरीकों सहित ट्रेनेबल डायरीकरण मॉडल देता है और GPU इन्फ्रास्ट्रक्चर पर बड़े पैमाने पर कस्टम स्पीच सिस्टम बनाने वाली टीम्स के लिए डिज़ाइन किया गया है।
इनमें से हर टूल में आपको मॉडल डिप्लॉयमेंट, स्केलिंग, मॉनिटरिंग और अपडेट सहित डायरीकरण इन्फ्रास्ट्रक्चर संभालना पड़ता है। जिन टीम्स को यह ऑपरेशनल ओवरहेड नहीं चाहिए, उनके लिए मैनेज्ड स्पीच डायरीकरण API एक सरल विकल्प हैं। ये मौजूदा वर्कफ़्लो के साथ इंटीग्रेट हो सकते हैं या पूरी डायरीकरण पाइपलाइन संभाल सकते हैं, जिससे ये प्रोडक्शन उपयोग के मामलों के लिए उपयुक्त होते हैं, जैसे कस्टमर सपोर्ट एनालिटिक्स, मीटिंग ट्रांसक्रिप्शन और पॉडकास्ट प्रोसेसिंग।
रियल-टाइम डायरीकरण: चुनौतियां और उपयोग के मामले
रियल-टाइम डायरीकरण, पूरी हो चुकी रिकॉर्डिंग के डायरीकरण से काफ़ी कठिन है, क्योंकि सिस्टम को अधूरे कॉन्टेक्स्ट के साथ फैसले लेने पड़ते हैं।
ऑफ़लाइन सिस्टम किसी भी निर्णय से पहले पूरी रिकॉर्डिंग देखता है। वह मिनट 2 की आवाज़ की तुलना मिनट 40 की आवाज़ से कर सकता है और भरोसे से तय कर सकता है कि वे एक ही वक्ता हैं, क्योंकि दोनों क्षण उसके पास एक साथ उपलब्ध होते हैं। रियल-टाइम सिस्टम को यह सुविधा कभी नहीं मिलती, क्योंकि उसे बोलने की आवाज़ आते ही लेबल करना होता है, आगे क्या कहा जाएगा इसकी कोई जानकारी नहीं होती और एक बार फैसला लेने के बाद उसे बदलने का बहुत कम या कोई मौका नहीं मिलता।
भविष्य के कॉन्टेक्स्ट का न होना ही तीन खास समस्याओं को रियल टाइम में हल करना इतना मुश्किल बनाता है:
- लेटेंसी बनाम सटीकता: पूरी बातचीत में आगे-पीछे देखने की क्षमता के बिना, कम रिस्पॉन्स-टाइम बजट पूरा करने की कीमत सीधे सटीकता को चुकानी पड़ती है।
- ओवरलैपिंग स्पीच: जब लोग एक-दूसरे के ऊपर बोलते हैं, तो ऑडियो को दोबारा प्रोसेस कर सकने वाला सिस्टम उसे अलग कर सकता है। रियल-टाइम सिस्टम को उसे एक ही लेबल में डालना पड़ता है या तुरंत खास ओवरलैप-अवेयर मॉडल का सहारा लेना पड़ता है।
- छोटे कथन: एक छोटा "हां" या "बोलिए" सिस्टम को काम करने के लिए बमुश्किल पर्याप्त आवाज़ देता है और आसपास के कॉन्टेक्स्ट के बिना भी उसे तुरंत लेबल तय करना पड़ता है।
कठिनाई के बावजूद, कुछ एप्लिकेशन रिकॉर्डिंग पूरी होने का इंतज़ार नहीं कर सकते। लाइव कैप्शनिंग को मीटिंग और ब्रॉडकास्ट में लोगों के बोलते ही स्पीकर लेबल चाहिए होते हैं। कॉन्टैक्ट सेंटर सॉफ़्टवेयर जो कॉल के बीच में एजेंट्स को गाइडेंस देता है, उसे रियल टाइम में जानना होता है कि ग्राहक कौन-से शब्द इस्तेमाल कर रहा है। वॉइस एजेंट्स जो कई प्रतिभागियों वाली कॉल संभालते हैं, उन्हें बिना देरी के ट्रैक करना होता है कि कौन क्या पूछ रहा है। हर मामले में, थोड़ा कम सटीक लेकिन तुरंत परिणाम देने वाला सिस्टम, अधिक सटीक लेकिन देरी वाले सिस्टम से बेहतर है।
ऐसे वर्कलोड जिनमें सच में रियल-टाइम लेबल की ज़रूरत नहीं होती, जैसे एनालिटिक्स, कंप्लायंस रिव्यू और ट्रांसक्रिप्ट जनरेशन, उनके लिए बैच डायरीकरण बेहतर विकल्प रहता है क्योंकि यह काफ़ी अधिक सटीक होता है।
स्पीकर डायरीकरण के प्रदर्शन का मूल्यांकन कैसे करें
डायरीकरण की सटीकता मापते समय दो मेट्रिक सबसे अहम हैं: डायरीकरण त्रुटि दर (DER), जो समग्र सटीकता कैप्चर करती है, और जैकार्ड त्रुटि दर (JER), जो जांचती है कि यह सटीकता हर वक्ता के लिए बनी रहती है या नहीं।
DER कुल स्पीच समय के उस अनुपात की गणना करता है जिसे गलत तरीके से जोड़ा गया था। इसमें तीन प्रकार की त्रुटियां शामिल होती हैं:
- फ़ॉल्स अलार्म स्पीच: सिस्टम ने किसी सेगमेंट को स्पीच लेबल किया, जबकि कोई नहीं बोल रहा था।
- मिस्ड स्पीच: कोई बोल रहा था, लेकिन सिस्टम ने उसे खामोशी लेबल किया।
- स्पीकर कन्फ्यूज़न: स्पीच का पता चला, लेकिन उसे गलत वक्ता से जोड़ा गया।
DER = (फ़ॉल्स अलार्म + मिस्ड स्पीच + स्पीकर कन्फ्यूज़न) / कुल स्पीच अवधि
10% DER का मतलब है कि इन तीन प्रकारों में त्रुटियां कुल स्पीच समय के दसवें हिस्से के बराबर हैं। कम होना बेहतर है और स्कोर की तुलना तभी की जा सकती है जब वे एक ही डेटा पर, एक जैसी स्थितियों में मापे गए हों। DER ऑडियो क्वालिटी, वक्ताओं की संख्या और रिकॉर्डिंग में मौजूद ओवरलैप की मात्रा के अनुसार बहुत बदलता है।
जैकार्ड त्रुटि दर (JER) हर वक्ता के लिए अलग-अलग डायरीकरण सटीकता मापती है, फिर सभी वक्ताओं के नतीजों का औसत निकालती है। हर रेफरेंस वक्ता के लिए, इवैल्यूएटर सिस्टम के सबसे नज़दीकी स्पीकर लेबल को मिलाता है और उस समय की तुलना करता है जिसमें दोनों सही तरह से ओवरलैप होते हैं, उस कुल समय से जो किसी भी वक्ता को असाइन किया गया है।
उदाहरण के लिए, 60 मिनट की ऐसी मीटिंग की कल्पना करें जहां वक्ता A 50 मिनट और वक्ता B 10 मिनट बोलता है। कोई डायरीकरण सिस्टम वक्ता A के 50 में से 48 मिनट सही लेबल करता है, लेकिन वक्ता B के 10 में से केवल 4 मिनट सही लेबल करता है। उसका समग्र DER फिर भी अपेक्षाकृत अच्छा लग सकता है क्योंकि मीटिंग का ज़्यादातर हिस्सा वक्ता A का है। JER, वक्ता B के खराब नतीजे को बराबर महत्व देता है, क्योंकि वह स्कोर का औसत निकालने से पहले वक्ता A और वक्ता B का अलग-अलग मूल्यांकन करता है।
JER_speaker = 1 - (correct_overlap / (ref_time + sys_time - correct_overlap))
अंतिम JER, हर वक्ता की इन त्रुटि दरों का औसत होता है:
JER = (1 / N) * Σ[JER_speaker_i] जहां i = 1..N
DER और JER, दोनों ट्रैक करने से डायरीकरण की सटीकता की पूरी तस्वीर मिलती है: समग्र सटीकता के लिए DER और यह जानने के लिए JER कि सटीकता हर प्रतिभागी के लिए बनी रहती है या नहीं, जिनमें कम बोलने वाले लोग भी शामिल हैं।
प्रोडक्शन-जैसे ऑडियो पर टेस्टिंग
स्पीकर डायरीकरण सिस्टम का मूल्यांकन करते समय, DER और JER दोनों की गणना ऐसे ऑडियो पर करें जो आपकी वास्तविक डिप्लॉयमेंट स्थितियों से मेल खाता हो: वक्ताओं की आपकी सामान्य संख्या, आपकी ऑडियो क्वालिटी और क्रॉसटॉक की मात्रा।
प्रकाशित बेंचमार्क स्कोर साफ़, नियंत्रित डेटासेट पर मापे जा सकते हैं, जैसे स्टूडियो रिकॉर्डिंग, जो शायद ही कभी असली कॉल रिकॉर्डिंग या लाइव मीटिंग जैसी सुनाई देती हैं। बेंचमार्क पर अच्छा स्कोर करने वाला सिस्टम भी शोर वाले, ओवरलैपिंग, वास्तविक दुनिया के ऑडियो पर काफ़ी खराब प्रदर्शन कर सकता है। डायरीकरण प्रोडक्ट चुनने से पहले अपने डेटा पर टेस्ट करें।
स्पीकर डायरीकरण के लिए ElevenAPI के साथ शुरुआत करें
अगर आप मल्टी-स्पीकर सपोर्ट वाला ट्रांसक्रिप्शन फ़ीचर बनाने के लिए तैयार हैं, Scribe v2 को ElevenLabs ने स्पीकर डायरीकरण के लिए एक ही स्पीच टू टेक्स्ट API के ज़रिए उपलब्ध कराया है। diarize=true के साथ एंडपॉइंट पर ऑडियो भेजें और JSON रिस्पॉन्स 10 घंटे तक लंबी फ़ाइलों में, 90+ भाषाओं और अधिकतम 32 वक्ताओं के लिए, हर शब्द को स्पीकर ID से लेबल करता है।
दो विकल्प स्टैंडर्ड डायरीकरण आउटपुट को बढ़ाते हैं। कॉल रिकॉर्डिंग के लिए detect_speaker_roles=true गुमनाम नंबरों के बजाय वक्ताओं को एजेंट और ग्राहक के रूप में लेबल करता है। अगर आपके वर्कस्पेस में रजिस्टर्ड स्पीकर प्रोफ़ाइल हैं, तो use_speaker_library=true डिटेक्ट किए गए वक्ताओं को नामांकित आवाज़ों से मिला सकता है, जिससे एक ही रिक्वेस्ट में डायरीकरण और आइडेंटिफिकेशन साथ आ जाते हैं।
एक डायरीकरण थ्रेशोल्ड पैरामीटर आपको वक्ताओं को ज़रूरत से ज़्यादा अलग करने और मर्ज करने के बीच का संतुलन ट्यून करने देता है। और जब वक्ता पहले से अलग ऑडियो चैनलों पर आइसोलेट हों, जैसे स्टीरियो कॉल रिकॉर्डिंग में, मल्टीचैनल ट्रांसक्रिप्शन चैनल के आधार पर वक्ता असाइन करता है और डायरीकरण को पूरी तरह स्किप कर देता है।
स्पीच टू टेक्स्ट क्विकस्टार्ट आपको पहला इंटीग्रेशन चरण-दर-चरण समझाता है। रेगुलेटेड डिप्लॉयमेंट के लिए, प्लेटफ़ॉर्म SOC 2, ISO 27001, PCI DSS L1 और HIPAA के अनुरूप है, और EU डेटा रेजिडेंसी व ज़ीरो रिटेंशन मोड उपलब्ध हैं।
अपने सिस्टम में स्पीकर डायरीकरण जोड़ने के लिए तैयार हैं? शुरुआत करें अपनी API कुंजी पाकर या अधिक जानने के लिए देखें ElevenLabs Docs।
अक्सर पूछे जाने वाले सवाल

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।


