कैस्केडेड बनाम फ्यूज्ड मॉडल: आपकी वॉइस एजेंट की आर्किटेक्चर तय करती है कि वह एंटरप्राइज के लिए तैयार है या नहीं
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
ज़्यादातर लोग मानते हैं कि वॉइस एजेंट कैस्केडेड या फ्यूज़्ड आर्किटेक्चर में से किसी एक का उपयोग करके बनाए जाते हैं। वास्तव में, एजेंट इन दोनों के बीच के स्पेक्ट्रम पर डिज़ाइन किए जाते हैं, और एप्लिकेशन के आधार पर आमतौर पर पाँच आर्किटेक्चर इस्तेमाल होते हैं।
एजेंट का आर्किटेक्चर तय करता है कि वह प्रोडक्शन में कितनी भरोसेमंद तरह से काम करेगा, खास बिज़नेस ज़रूरतों के अनुसार ढलेगा और बातचीत में कितना स्वाभाविक लगेगा। OpenAI के Realtime मॉडल जैसा फ्यूज़न-आधारित आर्किटेक्चर छोटी बातचीत में प्रभावशाली रूप से जीवंत लग सकता है। लेकिन जब टीम्स को अनुपालन गार्डरेल लागू करने हों, किसी असफल जवाब को डीबग करना हो या अगले महीने उपलब्ध होने पर अधिक शक्तिशाली LLM इस्तेमाल करना हो, तो एक अकेला फ्यूज़्ड नेटवर्क बहुत कम विकल्प देता है।
ElevenLabs में हम एक उन्नत कैस्केड-आधारित आर्किटेक्चर का उपयोग करते हैं। उच्च स्तर की बुद्धिमत्ता और विश्वसनीयता के लिए हम स्पीच रिकग्निशन, रीजनिंग और स्पीच जनरेशन के विशेष कंपोनेंट्स का इस्तेमाल करते हैं। हम इसमें कॉन्टेक्स्टुअल प्रोसोडी, कम-लेटेंसी ऑप्टिमाइज़ेशन और बुद्धिमान टर्न-टेकिंग जोड़ते हैं, ताकि बातचीत स्वाभाविक रूप से आगे बढ़े। हमने इसे इस तरह बनाया क्योंकि जिन एंटरप्राइज़ और सरकारी संस्थाओं के साथ हम काम करते हैं, उन्हें ऐसे एजेंट चाहिए जो वास्तविक लगें और जटिल कार्यों के लिए प्रोडक्शन में भरोसेमंद भी हों।
इस लेख में पाँच मुख्य आर्किटेक्चर, उनकी खूबियाँ, उनकी सीमाएँ और महत्वपूर्ण वर्कफ़्लो में तैनात एजेंट्स की नींव के बारे में हमारी सोच को समझाया गया है।
आर्किटेक्चर चुनते समय टीम्स किन बातों का आकलन करती हैं
टीम्स के सवाल आमतौर पर तीन श्रेणियों में आते हैं।
क्या यह जटिल काम संभाल सकता है?
- रीजनिंग और मॉडल लचीलापन: क्या आप अपने उपयोग के लिए सबसे अच्छे मॉडल चुन सकते हैं, जिनमें उपलब्ध सबसे शक्तिशाली LLMs शामिल हों, और बेहतर विकल्प उपलब्ध होने पर अपग्रेड कर सकते हैं?
- एजेंट लॉजिक: क्या आप अपने एजेंट के बातचीत के फ़्लो, निर्णय नियम और एस्केलेशन पाथ तय और नियंत्रित कर सकते हैं?
- टूल उपयोग: क्या आर्किटेक्चर मल्टी-स्टेप टूल कॉलिंग और बाहरी सिस्टम्स के साथ इंटीग्रेशन को सपोर्ट कर सकता है?
क्या यह इंसान जैसा सुनाई और महसूस होगा?
- प्रोसोडी: क्या एजेंट स्वाभाविक लय, उतार-चढ़ाव और भावनात्मक टोन देता है?
- लेटेंसी: क्या जवाब बातचीत जैसा महसूस होने के लिए पर्याप्त तेज़ हैं?
- टर्न-टेकिंग: क्या एजेंट जानता है कि कब बोलना, रुकना या सामने वाले को बोलने देना है?
क्या मैं प्रोडक्शन में इस पर भरोसा कर सकता हूँ?
- विश्वसनीयता: क्या एजेंट अनुमानित और लगातार व्यवहार करता है, या समय के साथ भटकता है?
- गार्डरेल: क्या आर्किटेक्चर अनचाहे जवाबों या दुर्भावनापूर्ण यूज़र्स से बचाव लागू कर सकता है?
- पारदर्शिता: क्या आर्किटेक्चर बीच के आउटपुट देता है, या यह एक ब्लैक बॉक्स है?
कैस्केडेड और फ्यूज़्ड आर्किटेक्चर के बीच समझौते
कैस्केड-आधारित आर्किटेक्चर विशेष कंपोनेंट्स को जोड़कर बनाए जाते हैं: स्पीच टू टेक्स्ट (STT), एक लार्ज लैंग्वेज मॉडल और टेक्स्ट टू स्पीच (TTS)। हर चरण को अलग-अलग ऑप्टिमाइज़, टेस्ट और अपग्रेड किया जा सकता है।
कैस्केडेड आर्किटेक्चर
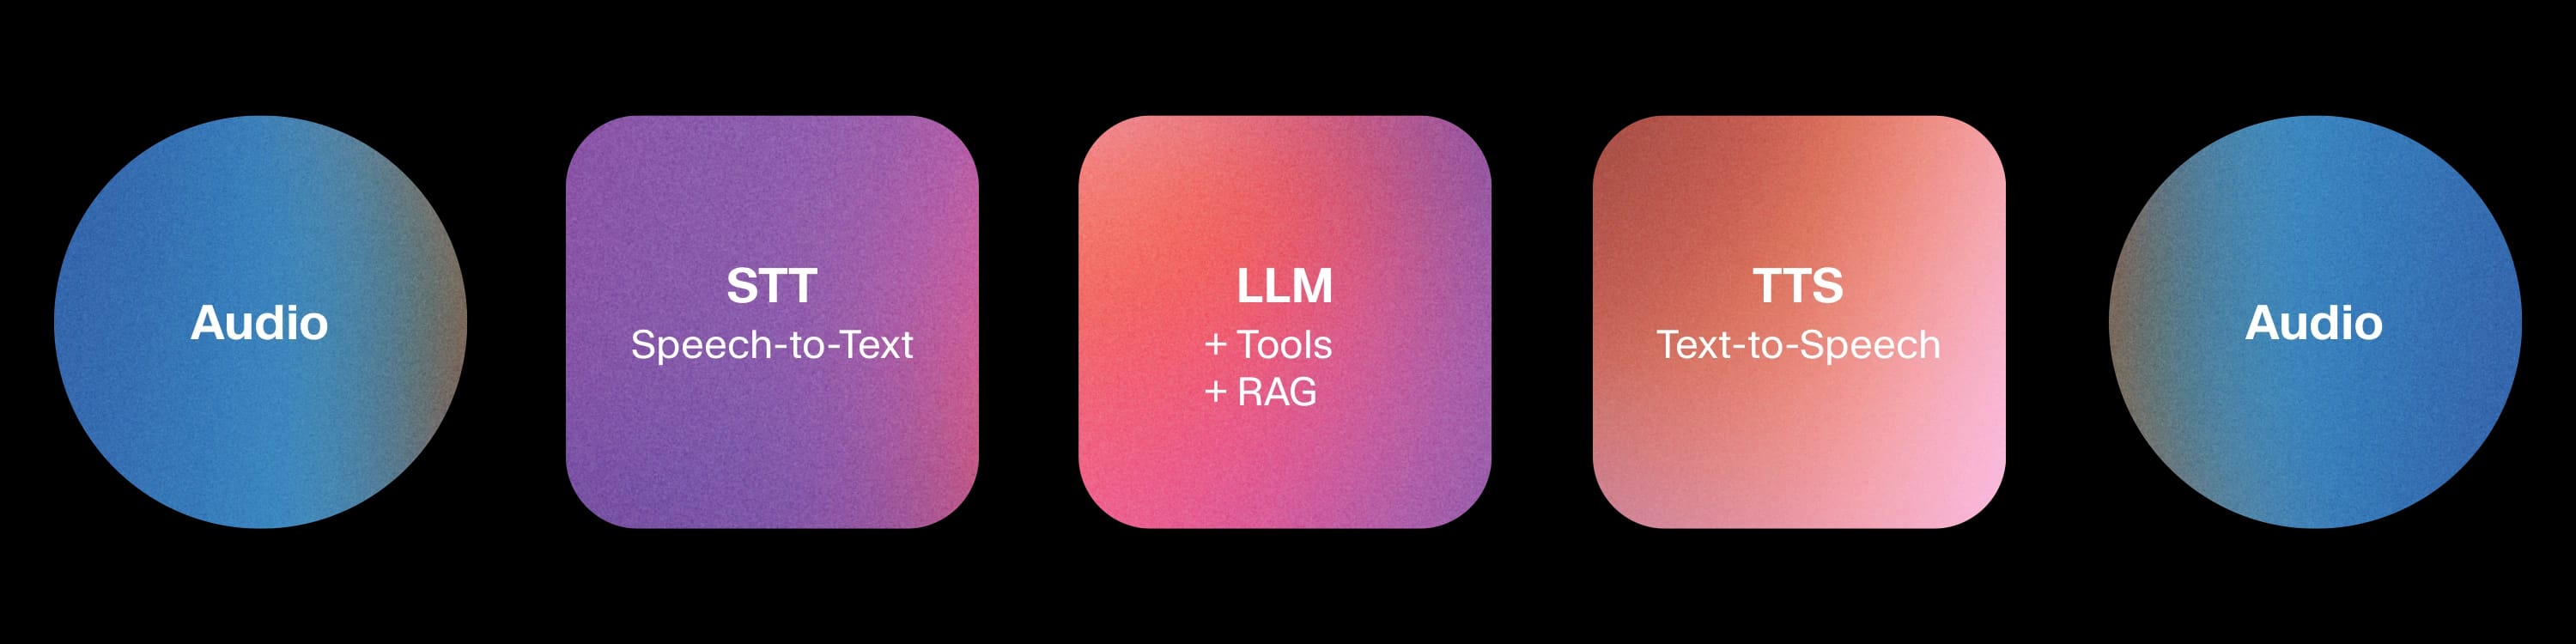
यही मॉड्यूलरिटी कैस्केडेड आर्किटेक्चर को ज़्यादातर एंटरप्राइज़-ग्रेड एजेंट्स की नींव बनाती है। हर चरण निरीक्षण योग्य आउटपुट देता है: STT और LLM के बीच, तथा LLM और TTS के बीच पढ़ा जा सकने वाला टेक्स्ट। टेक्स्ट लेयर पर गार्डरेल लागू किए जा सकते हैं, स्पीच मॉडल बदले बिना नवीनतम फ्रंटियर LLM इंटीग्रेट किया जा सकता है और कुछ विफल होने पर आमतौर पर उसकी वजह पहचानी जा सकती है।
कैस्केडेड आर्किटेक्चर की लंबे समय से आलोचना यह रही है कि वे प्रोसोडिक संकेत खो देते हैं। स्पीच टेक्स्ट में बदल जाती है और आउटपुट में उतार-चढ़ाव, लय व भावना को फिर से बनाना पड़ता है। स्पष्ट मॉडलिंग से इन संकेतों को कुछ हद तक वापस पाया जा सकता है, लेकिन वे फ्यूज़्ड तरीकों जितनी स्वाभाविक तरह से कैप्चर नहीं होते। लेटेंसी और टर्न-टेकिंग जैसे दूसरे पहलुओं को आमतौर पर दोनों तरीकों में समान प्रदर्शन स्तर तक ऑप्टिमाइज़ किया जा सकता है।
फ्यूज़्ड मॉडल
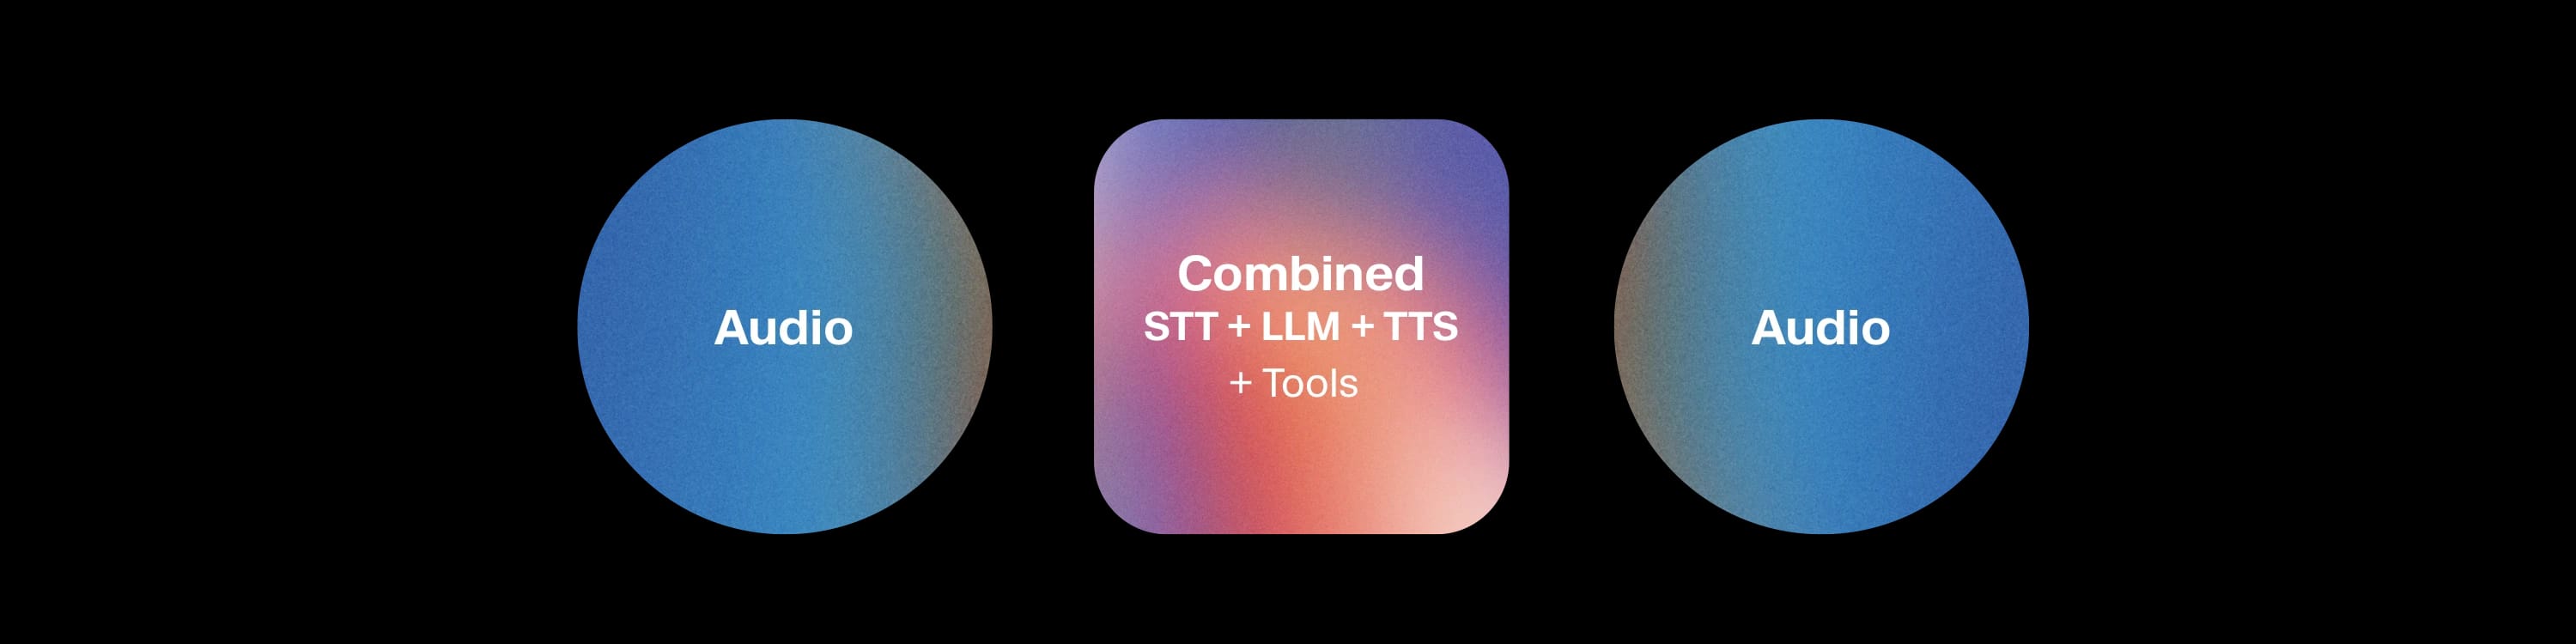
फ्यूज़्ड आर्किटेक्चर बुनियादी रूप से अलग तरीका अपनाते हैं। रिकग्निशन, रीजनिंग और जनरेशन—तीनों एक ही मल्टीमॉडल नेटवर्क के भीतर होते हैं। ऑडियो अंदर जाता है और ऑडियो बाहर आता है; बीच में कोई निरीक्षण योग्य लेयर नहीं होती।
इंटरमीडिएट चरणों का न होना इसकी खासियत भी है और सीमा भी। फ्यूज़्ड आर्किटेक्चर प्रोसोडिक संकेतों को स्वाभाविक रूप से सुरक्षित रख सकता है, क्योंकि स्पीच कभी टेक्स्ट में नहीं टूटती। हालांकि, गार्डरेल लागू करने, अलग-अलग कंपोनेंट्स बदलने या डीबग के लिए इंटरमीडिएट आउटपुट देखने की क्षमता सीमित होती है। इंडस्ट्री-विशिष्ट शब्दावली के लिए STT को फाइनट्यून करने या अधिक मजबूत रीजनिंग और टूल कॉलिंग के लिए कोई दूसरा LLM इंटीग्रेट करने में भी सीमाएँ हैं। सिस्टम एक नेटवर्क होता है और टीम्स उसी रीजनिंग क्षमता तक सीमित रहती हैं, जो इसके साथ आती है। आज इसका मतलब हल्के कोर हैं, जो जटिल कामों में फ्रंटियर LLMs की बराबरी नहीं कर सकते।
पाँच आर्किटेक्चर
1. बेसिक कैस्केडेड
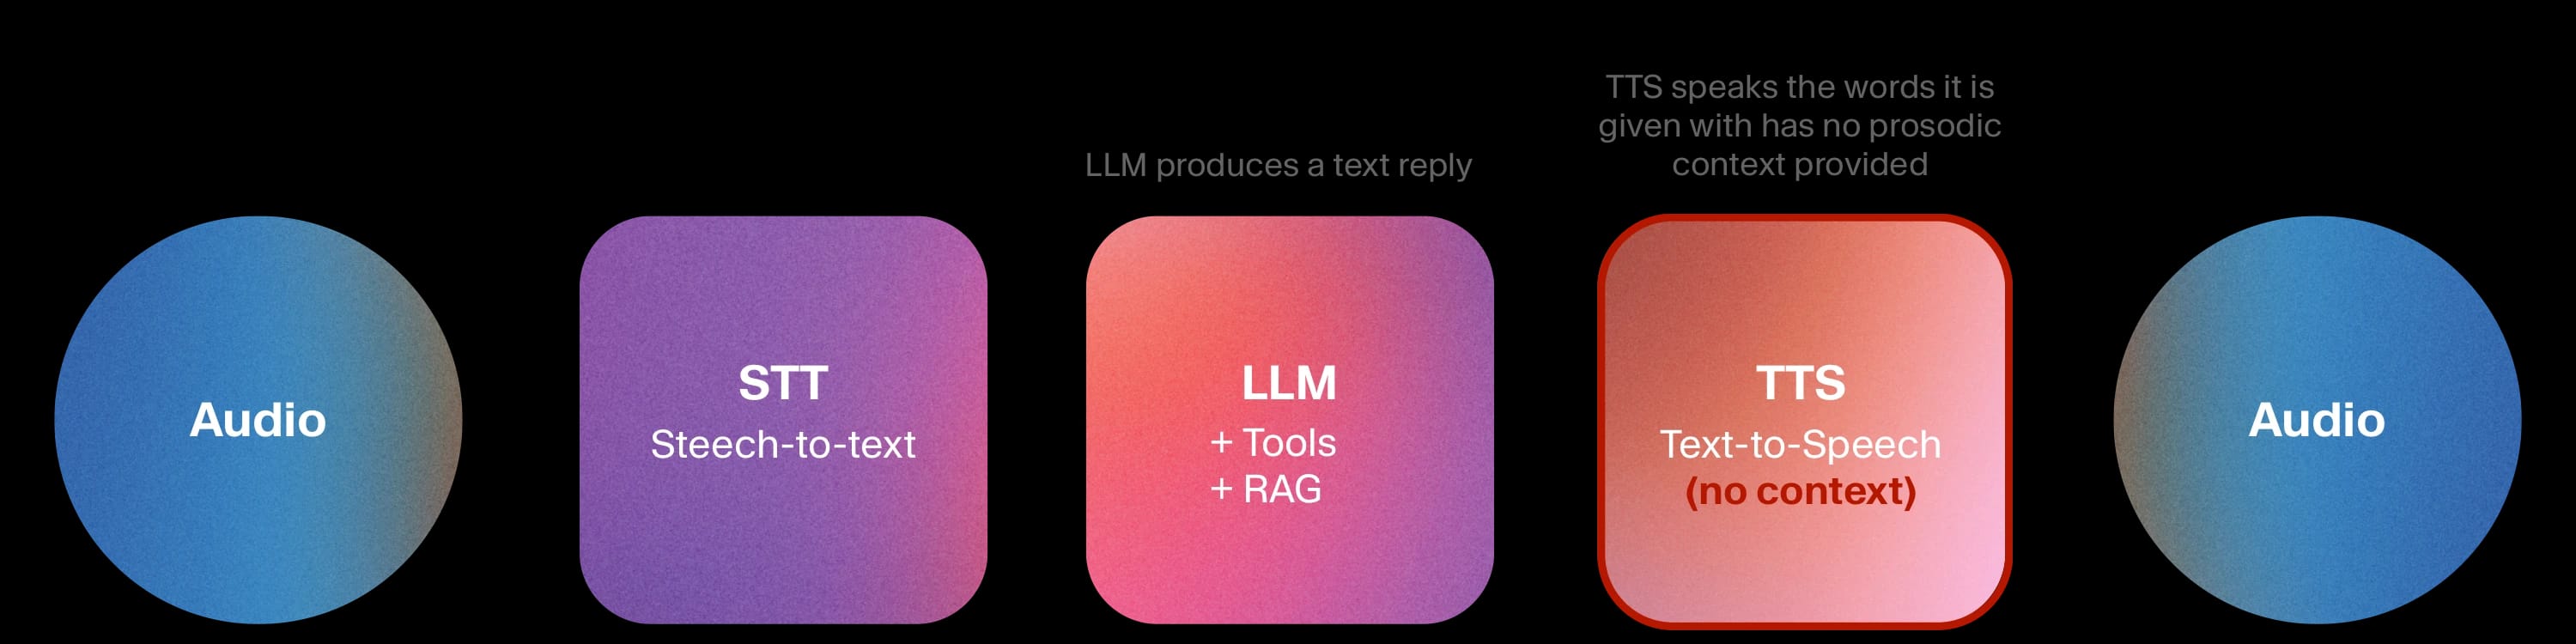
ऑडियो को ट्रांसक्राइब किया जाता है, LLM टेक्स्ट में जवाब बनाता है और TTS उसे बोलता है। हर चरण सामान्य टेक्स्ट पर काम करता है, इसलिए आप सब कुछ देख, टेस्ट और नियंत्रित कर सकते हैं।
भरोसे के फायदे साफ़ हैं: टेक्स्ट लेयर पर गार्डरेल, तय बातचीत फ़्लो और पूरे ऑडिट ट्रेल्स। चूँकि LLM एक अलग कंपोनेंट है, आप एजेंट को सबसे मज़बूत रीजनिंग या टूल-कॉलिंग क्षमता वाले किसी भी फ्रंटियर मॉडल के साथ जोड़ सकते हैं और बेहतर मॉडल आते ही अपग्रेड कर सकते हैं। इसकी कमी बातचीत की गुणवत्ता है: कॉन्टेक्स्टुअल TTS के बिना एजेंट काम का तो लगता है, लेकिन सपाट सुनाई देता है। इसमें न भावनात्मक अनुकूलन होता है, न प्रोसोडिक बदलाव, जो अकाउंट बैलेंस दोहराने के लिए ठीक है, लेकिन परेशान ग्राहक को संभालने के लिए पर्याप्त नहीं।
उदाहरण उपयोग के मामले:
- टेलीकॉम और यूटिलिटीज़ में IVR के विकल्प
- SaaS ऑनबोर्डिंग के लिए FAQ हैंडलिंग
- अपॉइंटमेंट कन्फ़र्मेशन, प्रिस्क्रिप्शन रिमाइंडर और डिलीवरी अलर्ट जैसी आउटबाउंड सूचनाएँ, जहाँ गर्मजोशी से ज़्यादा निरंतरता मायने रखती है
2. एडवांस्ड कैस्केडेड
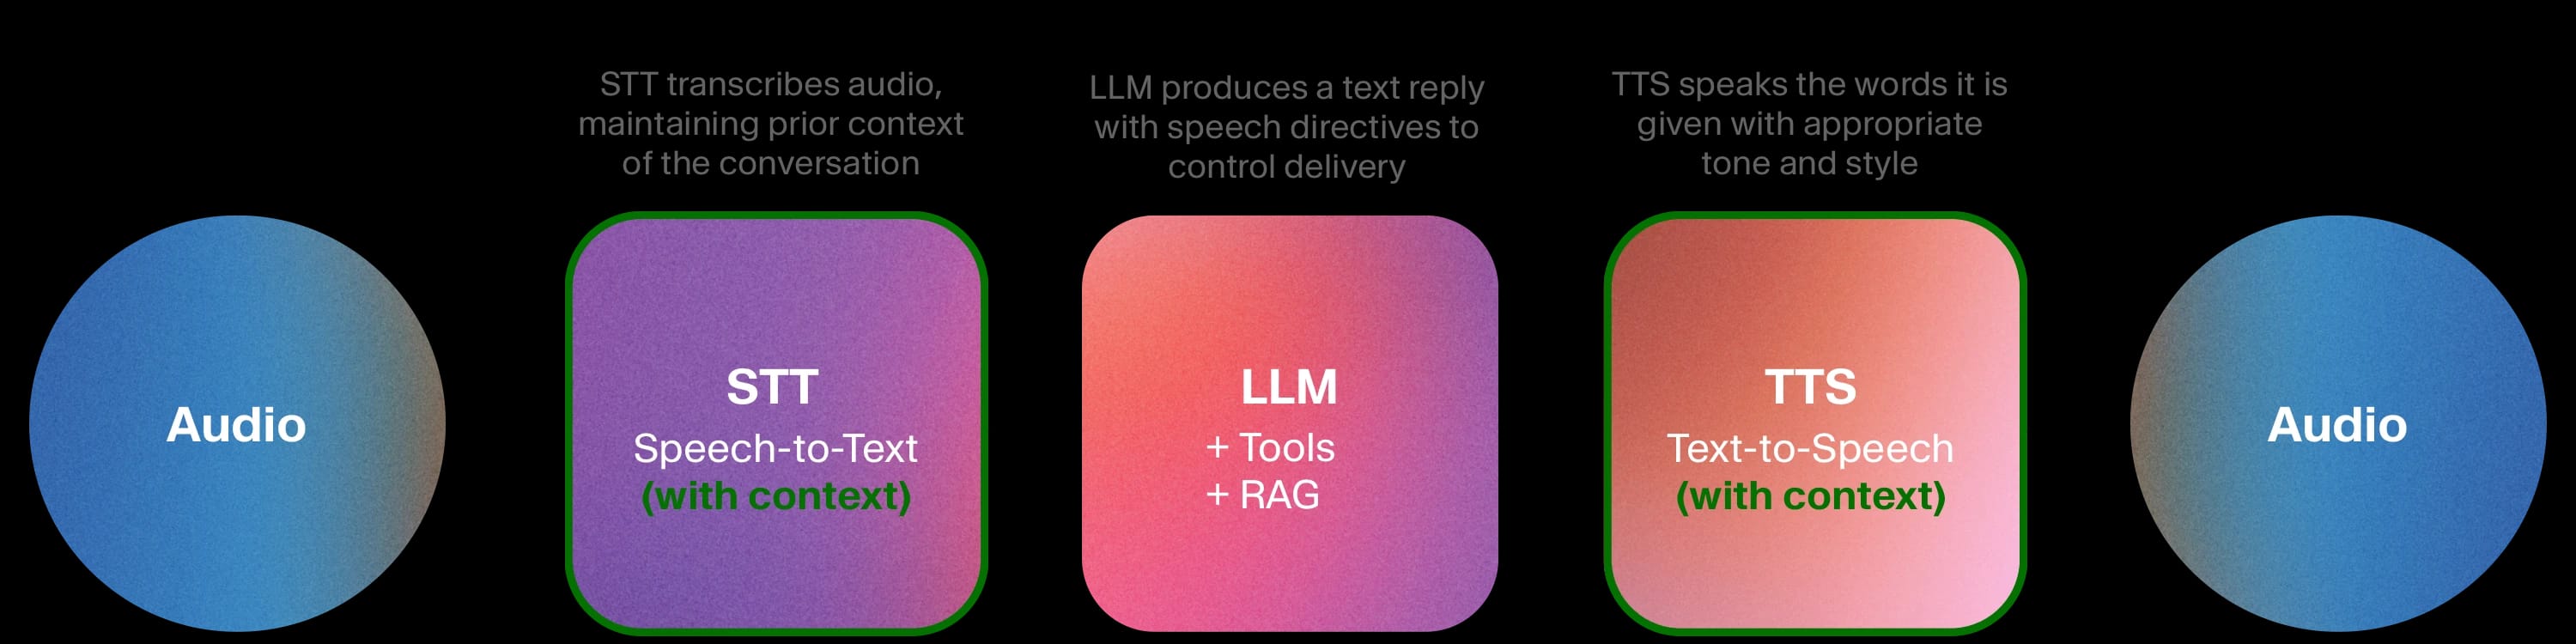
वही मॉड्यूलर आर्किटेक्चर, लेकिन अब कई कंपोनेंट्स अधिक समृद्ध संदर्भ के साथ काम करते हैं। हमने यही एक्सप्रेसिव मोड के साथ ElevenAgents में बनाया है।
Scribe v2 Realtime STT मॉडल बातचीत के पिछले संदर्भ का उपयोग करके तेज़ और सटीक ट्रांसक्रिप्शन बनाता है। टेक्स्ट से LLM, TTS को स्पीच देने का तरीका बताता है—सिर्फ़ क्या कहना है यह नहीं—जैसे "भरोसा दिलाते हुए," "ज़ोर देकर," "तत्कालता के साथ," और पूरी बातचीत में अपने टोन को गतिशील रूप से ढालता है। टर्न-टेकिंग सिस्टम भी इन्हीं संकेतों का उपयोग करता है, जिससे एजेंट तय कर पाता है कि कब जवाब देना है और कब सामने वाले को बोलने देना है। स्पीच मॉडल एक ही स्टैक में साथ होते हैं और कंपोनेंट्स के बीच कोई नेटवर्क हॉप नहीं होता, इसलिए लेटेंसी कम रहती है।
इस आर्किटेक्चर में बेसिक कैस्केडेड की सभी खूबियाँ रहती हैं: पूरी पारदर्शिता, टेक्स्ट-लेयर गार्डरेल, कंपोनेंट बदलने की सुविधा, डोमेन-ट्यूनिंग और उपलब्ध सबसे शक्तिशाली टूल-कॉलिंग व रीजनिंग मॉडल्स तक पहुँच। यह काफी बेहतर प्रोसोडी, लेटेंसी और टर्न-टेकिंग भी जोड़ता है। टीम्स नया फ्रंटियर LLM लॉन्च होने के उसी सप्ताह इंटीग्रेट कर सकती हैं या हेल्थकेयर के लिए STT को मेडिकल शब्दावली के लिए फाइनट्यून कर सकती हैं, बिना किसी दूसरे कंपोनेंट को दोबारा बनाए।
उदाहरण उपयोग के मामले:
- वित्तीय सेवाओं के लिए कस्टमर सपोर्ट, जहाँ विवादित शुल्क संबंधी कॉल में सहानुभूतिपूर्ण जवाब के साथ सख्त अनुपालन गार्डरेल और पूरी इंटरैक्शन लॉगिंग होती है
- मरीज़ों की कॉल को उचित तात्कालिकता से ट्रायेज करने वाले हेल्थकेयर रिसेप्शनिस्ट, जिनमें HIPAA-अनुपालक फ़्लो और मेडिकल शब्दावली के लिए डोमेन-ट्यून्ड स्पीच रिकग्निशन हो
- सेल्स असिस्टेंट्स जो तय प्लेबुक का पालन करते हुए गर्मजोशी और प्रभावी टोन बनाए रखते हैं और CRM में अपडेट भेजते हैं
3. हाइब्रिड कैस्केडेड और फ्यूज़्ड
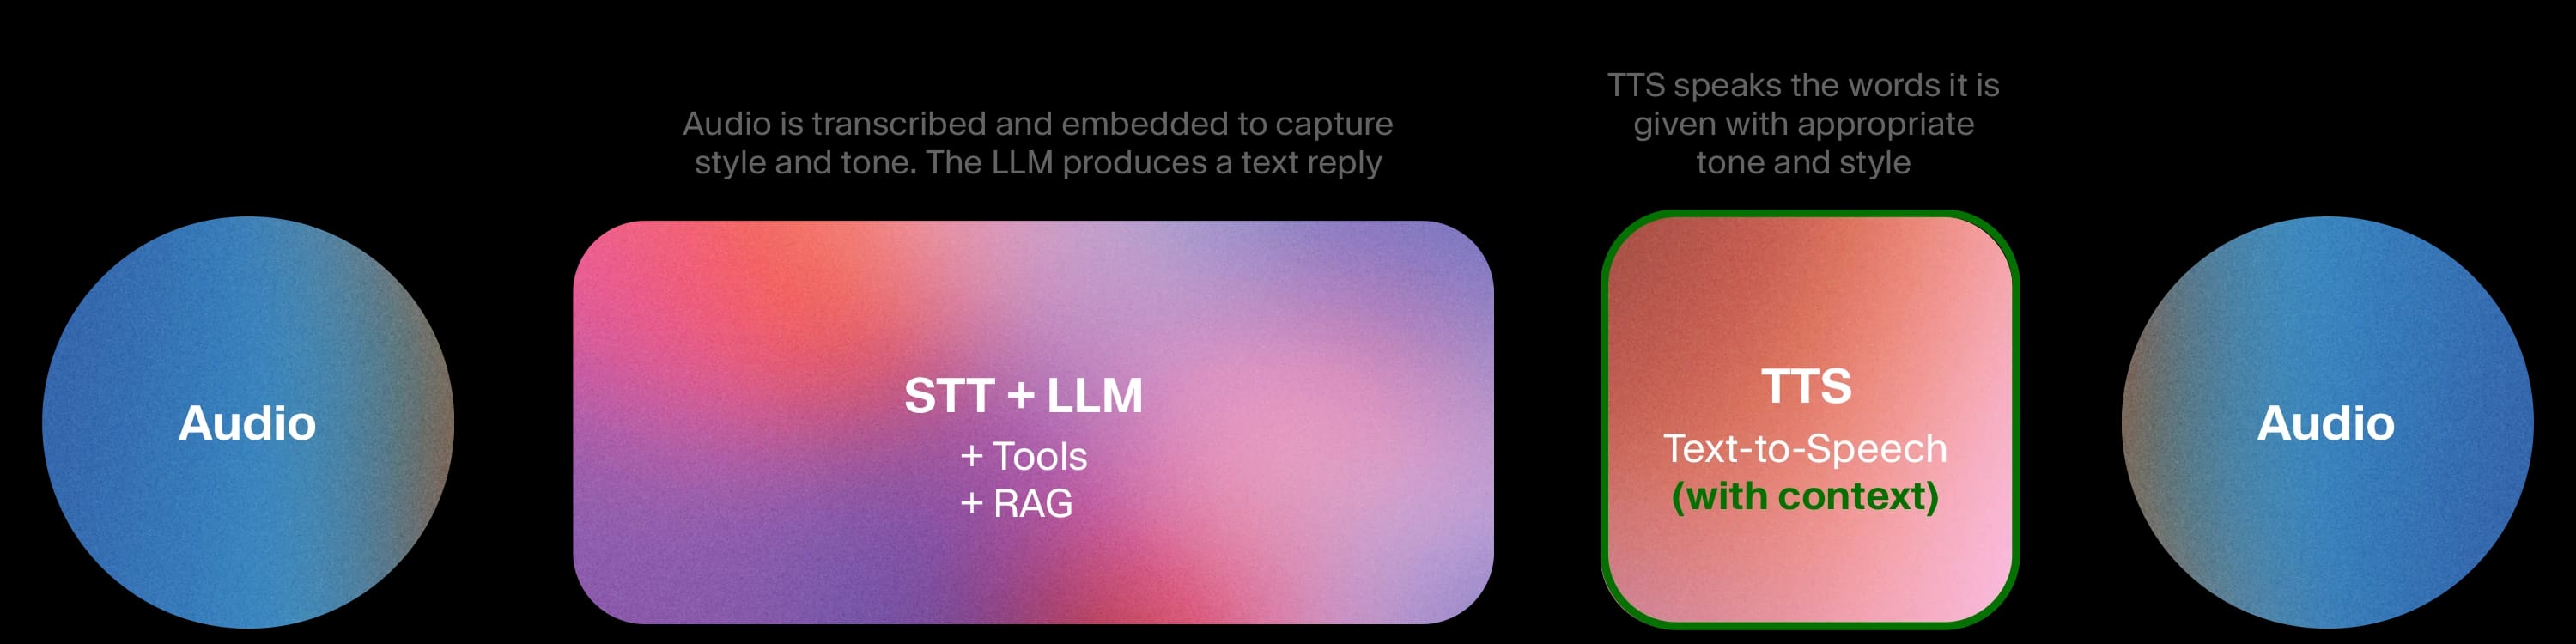
कुछ आर्किटेक्चर इनपुट स्पीच के ध्वनिक फ़ीचर्स—उच्चारण, भावना, टोन—को पहले टेक्स्ट में बदलने के बजाय एम्बेडिंग्स के रूप में सीधे LLM में भेजते हैं। TTS मॉड्यूलर रहता है।
इससे LLM को इस बारे में अधिक समृद्ध इनपुट मिलता है कि कोई बात कैसे कही गई, सिर्फ़ यह नहीं कि क्या कहा गया, जो खास एप्लिकेशंस के लिए उपयोगी है। फ्यूज़्ड ASR+LLM ब्लॉक का ऑडिट करना साफ़ टेक्स्ट हैंडऑफ़ की तुलना में कठिन होता है, क्योंकि इंटरमीडिएट रिप्रेज़ेंटेशन एक एम्बेडिंग होता है, जिसे इंसान पढ़ नहीं सकता। LLM को आसानी से बदला भी नहीं जा सकता, जिससे आपकी रीजनिंग और टूल-कॉलिंग क्षमताएँ उस मॉडल तक सीमित रहती हैं जिसके आधार पर फ्यूज़्ड ब्लॉक बनाया गया था।
उदाहरण उपयोग के मामले:
- भाषा सीखना और उच्चारण कोचिंग, जहाँ यह सुनना कि छात्र कैसे बोलता है, उतना ही महत्वपूर्ण है जितना कि वह क्या कहता है
- कम जटिलता वाला टोन-संवेदनशील सपोर्ट, जहाँ निराशा का पता लगाना ज़रूरी है, लेकिन कार्य खुद सरल है।
4. सीक्वेंशियल फ्यूज़्ड
एक मल्टीमॉडल मॉडल एक समय में एक टर्न में रिकग्निशन, रीजनिंग और जनरेशन संभालता है।
प्रोसोडी मज़बूत हो सकती है। चूँकि स्पीच कभी टेक्स्ट में नहीं टूटती, मॉडल गति, उतार-चढ़ाव और भावनात्मक संकेतों को स्वाभाविक रूप से बनाए रखता है। छोटी बातचीत उल्लेखनीय रूप से सहज लग सकती है।
लेकिन टेक्स्ट लेयर के बिना गार्डरेल लागू करने की क्षमता सीमित होती है, डीबगिंग के लिए इंटरमीडिएट आउटपुट कम मिलते हैं और बेहतर LLM इस्तेमाल करने या अपने डोमेन के लिए STT फाइनट्यून करने का लचीलापन भी सीमित होता है। रीजनिंग कोर आमतौर पर फ्रंटियर LLMs से हल्के होते हैं, इसलिए जटिल टूल-कॉलिंग और मल्टी-स्टेप कार्य प्रभावित होते हैं। जब काम में किसी जटिल समस्या का समाधान चाहिए, तो केवल प्रोसोडी पर्याप्त नहीं होती।
उदाहरण उपयोग के मामले:
- पर्सनल कंपैनियन्स, एंटरटेनमेंट चैटबॉट्स और ऐसे एप्लिकेशन जहाँ अभिव्यक्तिपूर्ण संवाद से जुड़ाव बढ़ता हो और अनुपालन की ज़रूरतें न्यूनतम हों।
5. डुप्लेक्स फ्यूज़्ड
इनपुट और आउटपुट एक साथ प्रोसेस होते हैं, जिसमें मॉडल एक ही समय पर सुनता और बोलता है। इससे छोटी बातचीत वास्तविक ओवरलैपिंग स्पीच और सहज टर्न ट्रांज़िशन के साथ बहुत स्वाभाविक लग सकती है।
इसे नियंत्रित करना सबसे मुश्किल आर्किटेक्चर भी है, गार्डरेल लागू करना बहुत कठिन है और क्रॉसटॉक अप्रत्याशित त्रुटियाँ पैदा करता है। निरीक्षण, लॉगिंग या डीबगिंग बेहद कठिन हैं और सिस्टम काफी हद तक बंद है, जिसमें कंपोनेंट बदलने, डोमेन-ट्यूनिंग या कस्टमाइज़ेशन के बहुत कम विकल्प हैं। रीजनिंग और टूल उपयोग सीक्वेंशियल फ्यूज़्ड मॉडल्स से भी अधिक सीमित हैं, क्योंकि एक साथ होने वाली प्रोसेसिंग जटिल लॉजिक के लिए कम क्षमता छोड़ती है। और वही एक साथ होने वाली प्रोसेसिंग, जो छोटी बातचीत को स्वाभाविक बनाती है, लंबी बातचीत को अस्थिर कर देती है।
उदाहरण उपयोग के मामले:
- प्रयोगात्मक कंपैनियन ऐप्स, सोशल वॉइस प्लेटफ़ॉर्म और रिसर्च डेमो, जहाँ अप्रत्याशित व्यवहार स्वीकार्य हो।
अपने उपयोग के लिए सही आर्किटेक्चर चुनना
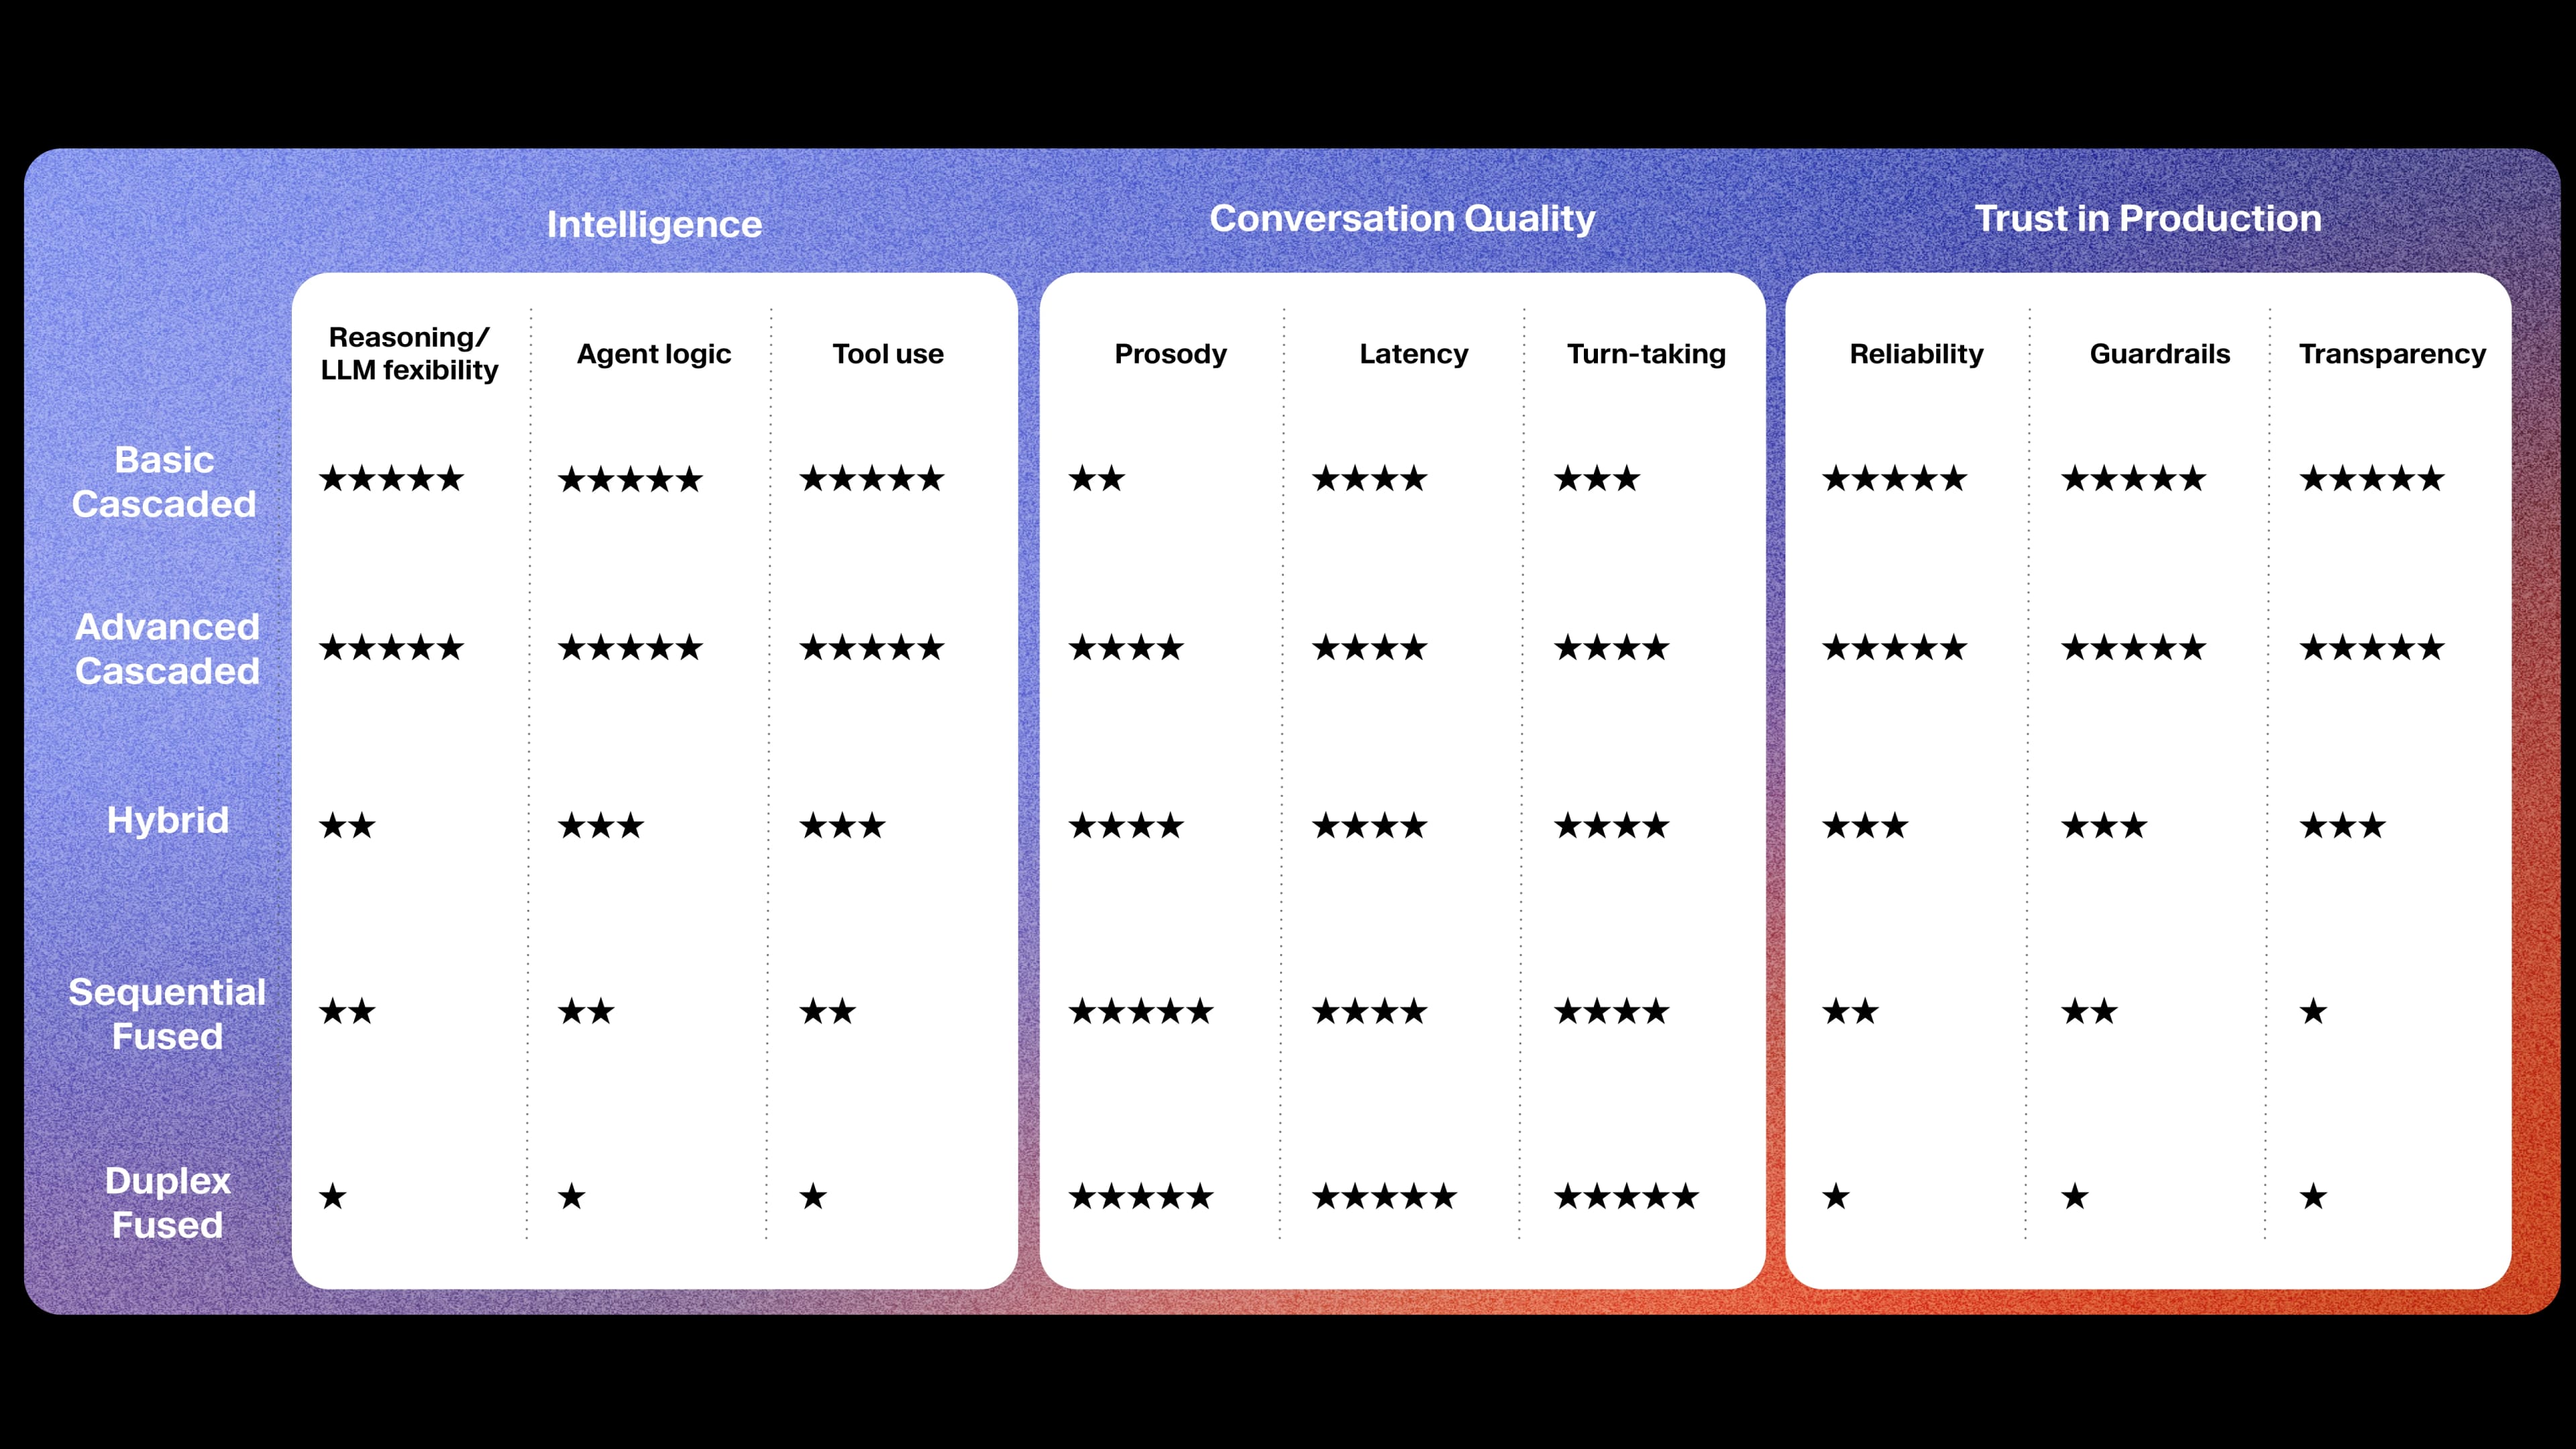
सही आर्किटेक्चर इस बात पर निर्भर करता है कि किसी एप्लिकेशन को क्या चाहिए। यदि आप ऐसा अनुभव बना रहे हैं जहाँ स्वाभाविक सुनाई देने वाली स्पीच मुख्य फ़ीचर है, तो फ्रंटियर रीजनिंग, गार्डरेल और पारदर्शिता से समझौता करने पर फ्यूज़्ड आर्किटेक्चर वास्तविक खूबियाँ देते हैं। प्रोसोडी में फ्यूज़्ड मॉडल आगे हैं, लेकिन एडवांस्ड कैस्केडेड सिस्टम हर तिमाही उनके और करीब आ रहे हैं। वहीं, आर्किटेक्चरल सीमाओं के कारण फ्यूज़्ड मॉडल्स ने जटिल रीजनिंग या भरोसे के मामले में कोई महत्वपूर्ण प्रगति नहीं की है।
ज़्यादातर बिज़नेस और सरकारी संस्थाओं के लिए सबसे अच्छा आर्किटेक्चर वह है जो शानदार सुनाई दे, सक्षम, कस्टमाइज़ेबल और भरोसेमंद हो, और बड़े पैमाने पर तैनाती के लिए तैयार हो। इसलिए हमने ElevenAgents को एक एडवांस्ड कैस्केडेड आर्किटेक्चर के साथ बनाया है, जिसमें एक्सप्रेसिव मोड और स्पीच टू टेक्स्ट व टेक्स्ट टू स्पीच के लिए बेहतरीन, साथ मिलकर ऑप्टिमाइज़ किए गए मॉडल्स में निवेश शामिल है। इससे टीम्स एजेंट बना सकती हैं जिनमें प्राकृतिक, इंसानों जैसी स्पीच के साथ उच्च स्तर की बुद्धिमत्ता, विश्वसनीयता और नियंत्रण हो।
जैसे-जैसे AI एजेंट्स कस्टमर सपोर्ट, शिक्षा, पर्सनल असिस्टेंट्स और अन्य क्षेत्रों में बढ़ते जाएंगे, सफल वही होंगे जिनका आर्किटेक्चर उनके खास एप्लिकेशन के अनुरूप बनाया गया हो।